Les 10 meilleures alternatives à GPT-6.2 Astra en 2026, au prix par tâche

Kurnia Kharisma

Katelin Teen
Dernière modification 17 novembre 2026
La meilleure alternative à GPT-6.2 Astra pour la plupart des équipes est le propre GPT-6.2 Sol d'OpenAI : il obtient 57 contre 62 pour Astra sur Artificial Analysis, pour environ un quart du coût par tâche. Seul Claude Fable 5.2 obtient un score plus élevé (65), pour 6,6 fois le coût par tâche d'Astra. Le piège, c'est le prix affiché : Claude Opus 5.5 facture la moitié du tarif par token d'Astra, mais a coûté 2,5 fois plus par tâche de référence à l'effort maximal. Jugez les alternatives sur le coût par tâche terminée, et routez plutôt que de changer. Pour une file de support, les connaissances et les règles d'escalade autour du modèle comptent plus, ce qu'apporte justement le coéquipier IA d'eesel pour le helpdesk.
Pourquoi les équipes regardent-elles au-delà de GPT-6.2 Astra ?
GPT-6.2 Astra a été lancé le 17 novembre 2026, et c'est un modèle puissant. Artificial Analysis le place à 62 sur son Intelligence Index, juste derrière Claude Fable 5.2, et OpenAI a réduit le prix de 20 % à $8 par million de tokens en entrée et $40 par million en sortie sur sa page de tarifs API. L'entrée en cache est passée de $1,00 à $0,40. Si vos agents font un travail difficile à plusieurs étapes, Astra mérite sa place.
Alors pourquoi chercher ailleurs ? Trois raisons reviennent sans cesse.
- La plupart des tâches n'en ont pas besoin. Dans mon propre test de 15 tickets de support à trois niveaux d'effort, GPT-6.2 Sol a réussi chaque ticket pour environ un quart du coût d'Astra. Plus de détails ci-dessous.
- Les longues exécutions sont plus difficiles à lire. Plusieurs testeurs connus ont aimé le résultat d'Astra mais pas le fait de travailler avec lui sur des exécutions longues et ouvertes. Mon test de GPT-6.2 Astra détaille ces plaintes.
- Un seul fournisseur est un point unique de défaillance. Les équipes qui construisent des produits à base d'agents veulent un repli testé chez un deuxième laboratoire, en cas de changement de prix, de panne ou de limite de débit.
"I care less about the models being good and more on if I can fallback to them if Opus 5.5 gets a massive price hike after the IPO"

J'écris sur ce que les acheteurs recherchent réellement, et la recherche ici est révélatrice. Quand j'ai posé exactement cette question à ChatGPT dans une discussion neuve, il est allé directement aux docs et pages de tarifs de chaque laboratoire, puis a construit toute la réponse autour d'un seul chiffre : le coût par tâche réussie. C'est le bon cadre, et c'est celui que j'ai utilisé ci-dessous. Si vos agents répondent à des tickets de support, le CLI eesel permet à un agent de code de charger des articles d'aide approuvés dans un coéquipier eesel et de tester ses réponses avant même de choisir quoi que ce soit.
Comment j'ai comparé les alternatives
J'ai noté chaque modèle sur trois critères, tous vérifiés le 18 novembre 2026.
- Le prix affiché sur la propre page de tarifs de chaque fournisseur, par million de tokens en entrée et en sortie, plus le tarif de l'entrée en cache, puisque les agents qui renvoient un long prompt système vivent des tokens en cache.
- L'intelligence et le coût par tâche selon Artificial Analysis, qui fait passer les neuf mêmes évaluations à chaque modèle et rapporte ce qu'a coûté chaque tâche terminée au réglage d'effort maximal de ce modèle. Ce chiffre intègre le nombre de tokens qu'un modèle consomme, ce que le prix affiché cache.
- Mon propre test de support. J'ai refait tourner le banc d'essai de 15 tickets de mon décryptage de GPT-6.2 Astra sur Astra et Sol à effort faible, moyen et élevé : 90 exécutions couvrant un calcul de remboursement, une double facturation, une injection de prompt, des tickets en espagnol et en allemand, une recherche de commande cassée et un numéro de commande mal saisi. Je n'avais accès à l'API que chez OpenAI pour cette exécution, donc les autres laboratoires sont jugés sur les données du fournisseur et des benchmarks.
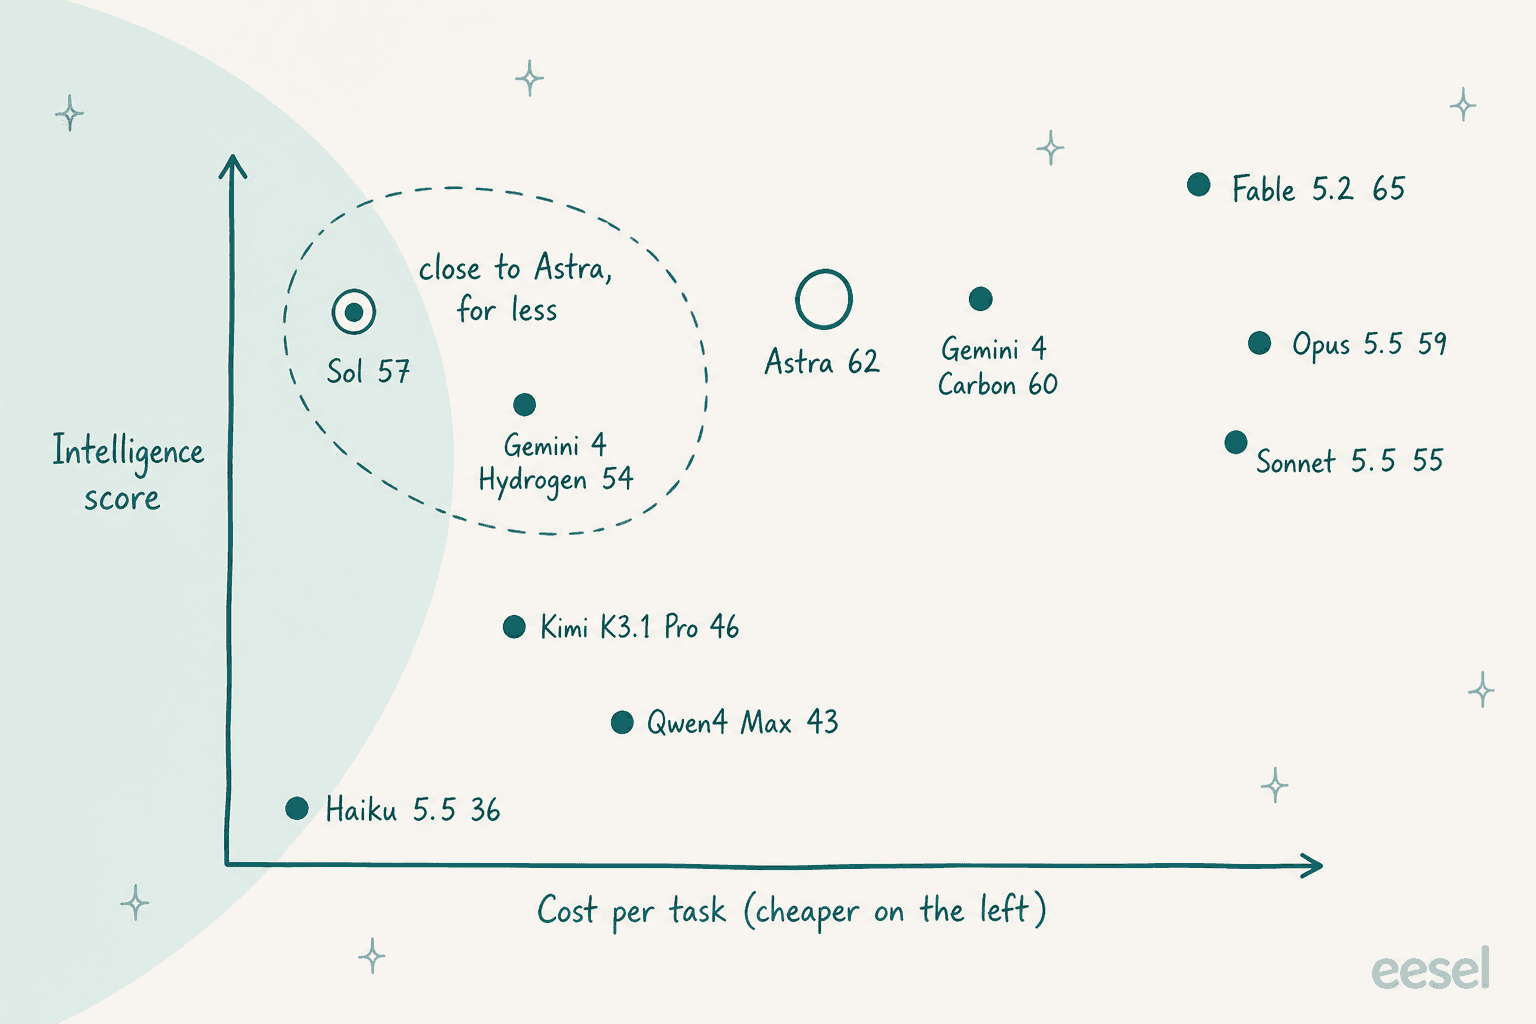
Le graphique résume l'article en une image. Astra se situe haut et au milieu. Fable 5.2 est le seul modèle au-dessus, loin à droite. Sol se situe presque aussi haut, loin à gauche.
Les alternatives à GPT-6.2 Astra en un coup d'œil
Les prix sont par million de tokens aux tarifs standards. Les scores et coûts d'Artificial Analysis correspondent au réglage d'effort maximal de chaque modèle.
| Modèle | Fabricant | Entrée / sortie | Entrée en cache | Contexte | Score AA | Coût AA par tâche | Temps par tâche AA | Idéal pour |
|---|---|---|---|---|---|---|---|---|
| GPT-6.2 Astra (référence) | OpenAI | $8 / $40 | $0,40 | 1,05M | 62 | $4,00 | 10,4 min | Travail d'agent difficile à plusieurs étapes |
| GPT-6.2 Sol | OpenAI | $2 / $10 | $0,10 | 1,05M | 57 | $1,01 | 7,9 min | La majorité du trafic d'agents en production |
| Claude Opus 5.5 | Anthropic | $4 / $20 | $0,20 | 1M | 59 | $10,04 | 24,6 min | Code et écriture sur de longues tâches |
| Claude Fable 5.2 | Anthropic | $8 / $40 | $0,20 | 1M | 65 | $26,54 | 40,8 min | Le score le plus élevé disponible |
| Claude Sonnet 5.5 | Anthropic | $2 / $10 | $0,10 | 1M | 55 | $10,02 | 32,3 min | Anthropic au prix de Sol |
| Gemini 4 Carbon | $2 / $10 jusqu'au 30 nov., puis $4 / $20 | $0,10, puis $0,20 | 1M | 60 | $5,48 | 33,4 min | Score proche d'Astra, deuxième fournisseur | |
| Gemini 3.8 Flash | $0,75 / $3,75 jusqu'au 31 déc. | $0,075 | - | 31 | - | 14,1 min | Étapes bon marché à fort volume | |
| Grok 4.7 | xAI | $2 / $6 | $0,50 | 500K | 35 | - | 24,5 min | Boucles d'agents à sortie longue |
| DeepSeek V4 Pro et Flash | DeepSeek | $0,66 / $1,98 (Pro, hors pointe) | $0,022 | 1M | 23 (Pro) | $1,77 (Pro) | 17,3 min | La facture de tokens la plus basse |
| Kimi K3.1 Pro | Moonshot AI | $2 / $10 | $0,20 | 1M | 46 | $3,68 | 38,7 min | Option non américaine au prix de Sol |
| Qwen4 Max | Alibaba (Qwen Cloud) | $1,50 / $4,50 | $0,075 | 1M | 43 | $3,27 | 31,9 min | Prix de sortie bas à grande échelle |
Deux points à lire avant la liste. Le prix de Gemini 4 Carbon double le 1er décembre, budgétisez donc au tarif ultérieur. Et les prix de DeepSeek doublent pendant les heures de pointe en semaine, ce que je couvre dans sa section.
La moitié du prix par token signifie-t-elle la moitié de la facture ?
Non, et c'est là que la plupart des comparaisons se trompent. Le prix par token d'un modèle vous dit ce que coûte un token. Il ne vous dit pas combien de tokens le modèle dépense pour terminer une tâche, ni combien de temps il réfléchit avant.
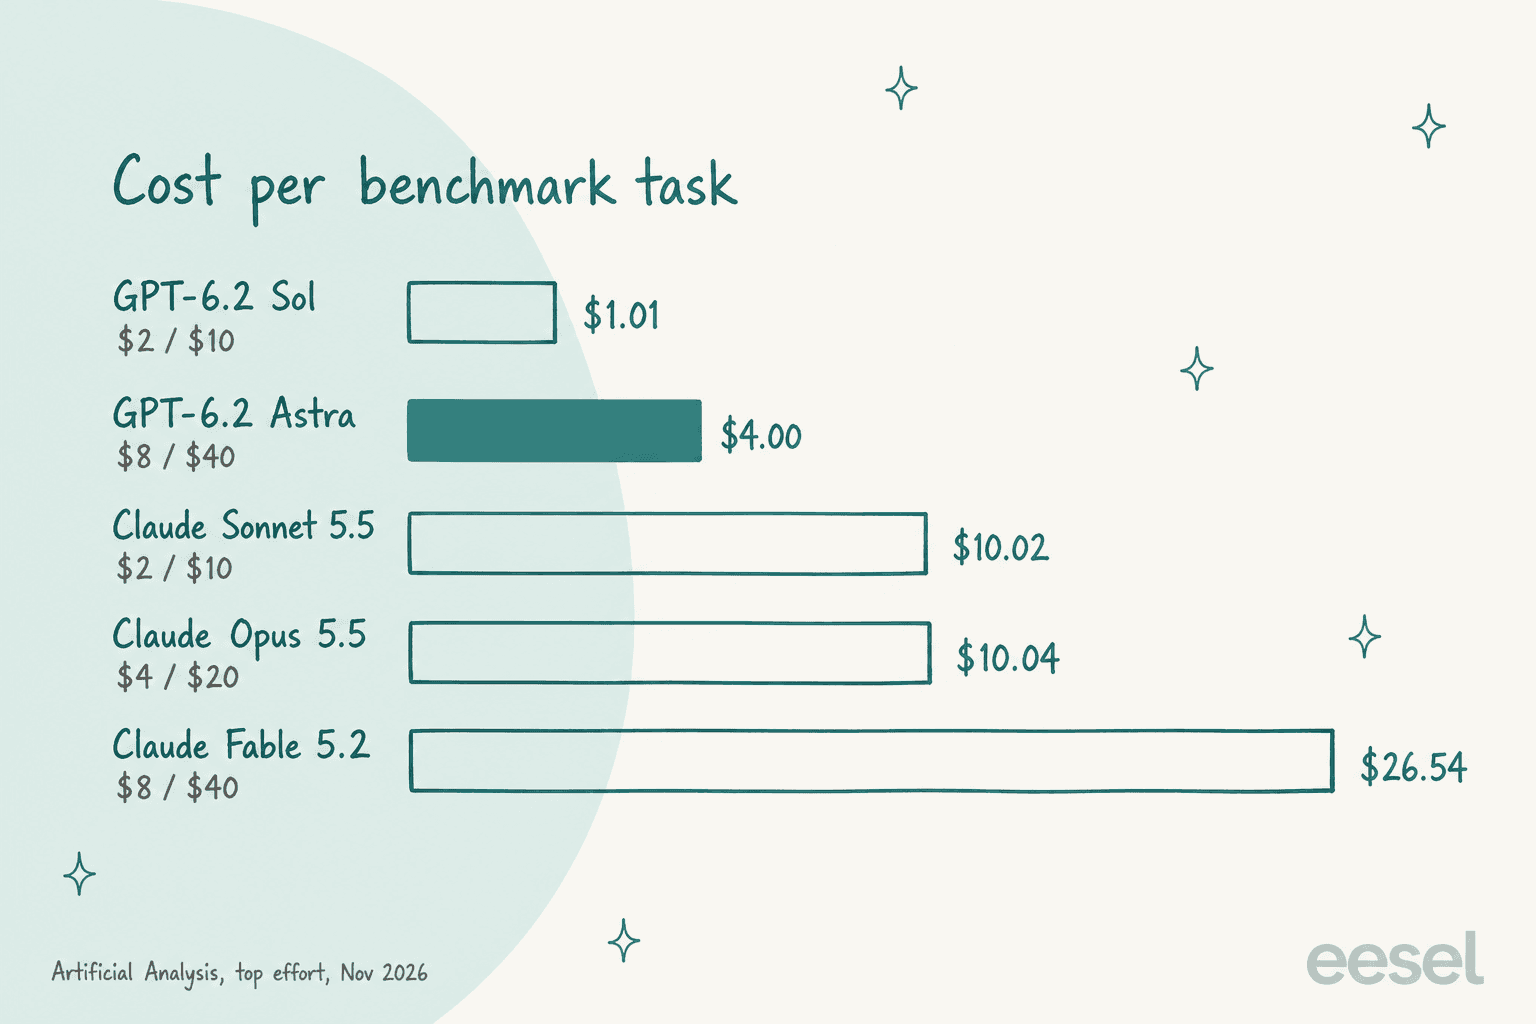
Claude Opus 5.5 facture la moitié du tarif par token d'Astra, $4/$20 contre $8/$40, pourtant Artificial Analysis l'a mesuré à $10,04 par tâche contre $4,00 pour Astra. Sonnet 5.5 a le même prix par token que Sol et a coûté dix fois plus par tâche. La raison apparaît dans la colonne du temps : Opus a passé 24,6 minutes par tâche et Sonnet 32,3 minutes à effort maximal, contre 10,4 pour Astra. Plus de réflexion signifie plus de tokens en sortie, et la sortie est le côté coûteux de toute grille tarifaire.
Deux réserves gardent cela équitable. Artificial Analysis fait tourner chaque modèle à son effort maximal, et la vue d'ensemble des modèles d'Anthropic livre Opus 5.5 avec un effort moyen par défaut, donc votre facture aux réglages par défaut sera plus basse que le chiffre du benchmark. Et une tâche de benchmark n'est pas votre tâche. Traitez le coût par tâche comme un avertissement de direction, puis mesurez sur votre propre travail.
Un commentateur de HN a mis de vrais chiffres sur la même idée à partir de son propre usage en codage :
"Opus cost me about $1 in tokens per task while Haiku costs about 4.6 cents and Luna is about 2.5 cents."
1. GPT-6.2 Sol
Idéal pour : les équipes qui veulent rester chez OpenAI et réduire la facture d'environ 75 %.
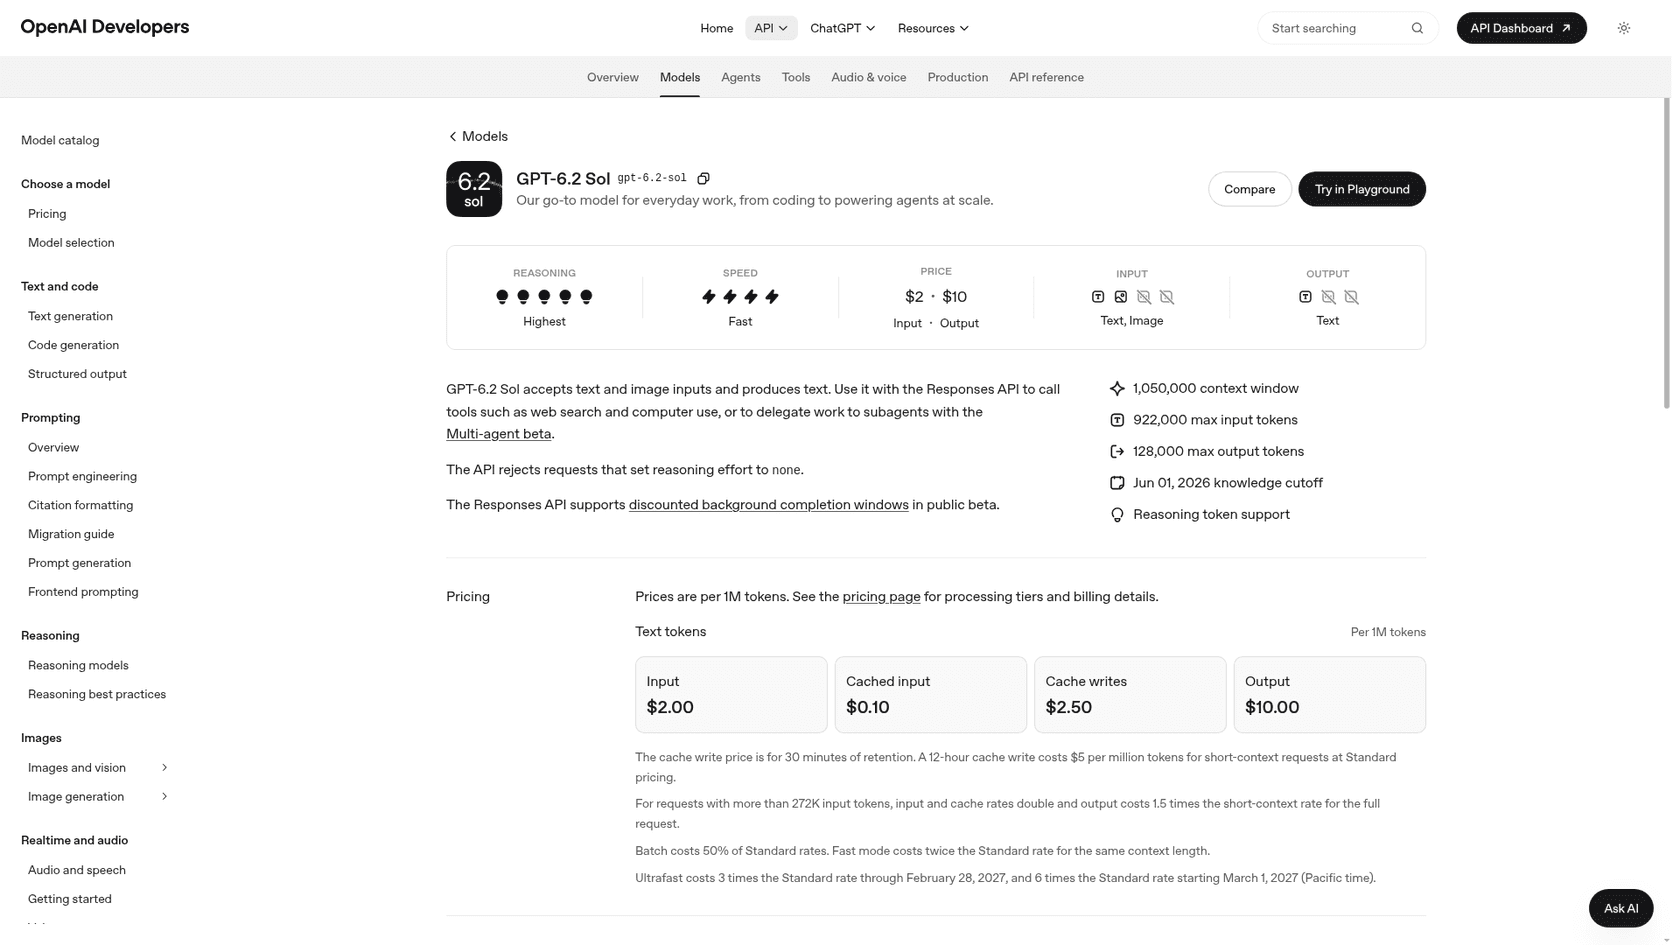
GPT-6.2 Sol a été lancé en même temps qu'Astra et utilise la même API, les mêmes outils et la même fenêtre de contexte de 1 050 000 tokens, avec 922 000 tokens d'entrée et 128 000 de sortie. Changer le nom du modèle, c'est toute la migration. Artificial Analysis le note à 57, au niveau de GPT-6 Astra de la génération précédente, pour environ 15 % du coût par tâche de ce modèle.
C'est dans mon test que Sol a décroché la première place. Sur 45 exécutions à effort faible, moyen et élevé, il a répondu correctement à chaque ticket : le remboursement proportionnel est sorti à $990 chaque fois, l'injection de prompt a reçu un refus poli, la recherche cassée a été escaladée, et les clients espagnols et allemands ont reçu des réponses dans leur propre langue. Astra a fait de même.
| Mon test, 15 tickets | Coût par 1 000 tickets | Temps de réponse médian |
|---|---|---|
| GPT-6.2 Astra, faible / moyen / élevé | $5,75 / $5,79 / $6,57 | 5,4s / 3,3s / 4,5s |
| GPT-6.2 Sol, faible / moyen / élevé | $1,42 / $1,40 / $1,54 | 2,5s / 2,5s / 2,8s |
Mêmes réponses, pour environ un quart du prix, et plus rapide. L'effort n'a presque pas bougé le coût sur des tickets de cette longueur, ce qui vaut le coup de savoir avant de payer un effort élevé par défaut.
"For just doing things or coding things up, Sol all the way."
Avantages
- $2/$10 par million de tokens, avec l'entrée en cache à $0,10
- Même API, mêmes outils et même fenêtre de contexte qu'Astra, le changement se résume donc à une ligne
- A égalé Astra sur mes 15 tickets de support, à tous les niveaux d'effort
Inconvénients
- Artificial Analysis dit qu'il a perdu 3 points sur son Coding Agent Index par rapport à GPT-6.1 Sol, surtout en omettant des faits clés dans ses réponses
- Sur les grandes bases de code, certains développeurs renvoient encore le travail de Sol à Astra pour nettoyage
- L'API refuse l'effort de raisonnement
none
Tarifs : $2 en entrée, $0,10 en cache, $10 en sortie par million de tokens au tarif standard, selon la page de tarifs d'OpenAI. Le mode batch divise ça par deux. Le guide tarifs de l'API OpenAI couvre les paliers.
Verdict : commencez ici. Faites de Sol votre modèle par défaut et gardez Astra pour les tâches où Sol échoue visiblement. Le test de GPT-6.1 Sol couvre la version précédente si vous y êtes aujourd'hui.
2. Claude Opus 5.5
Idéal pour : le code et l'écriture sur de longues tâches, où des explications claires comptent plus que la vitesse brute.
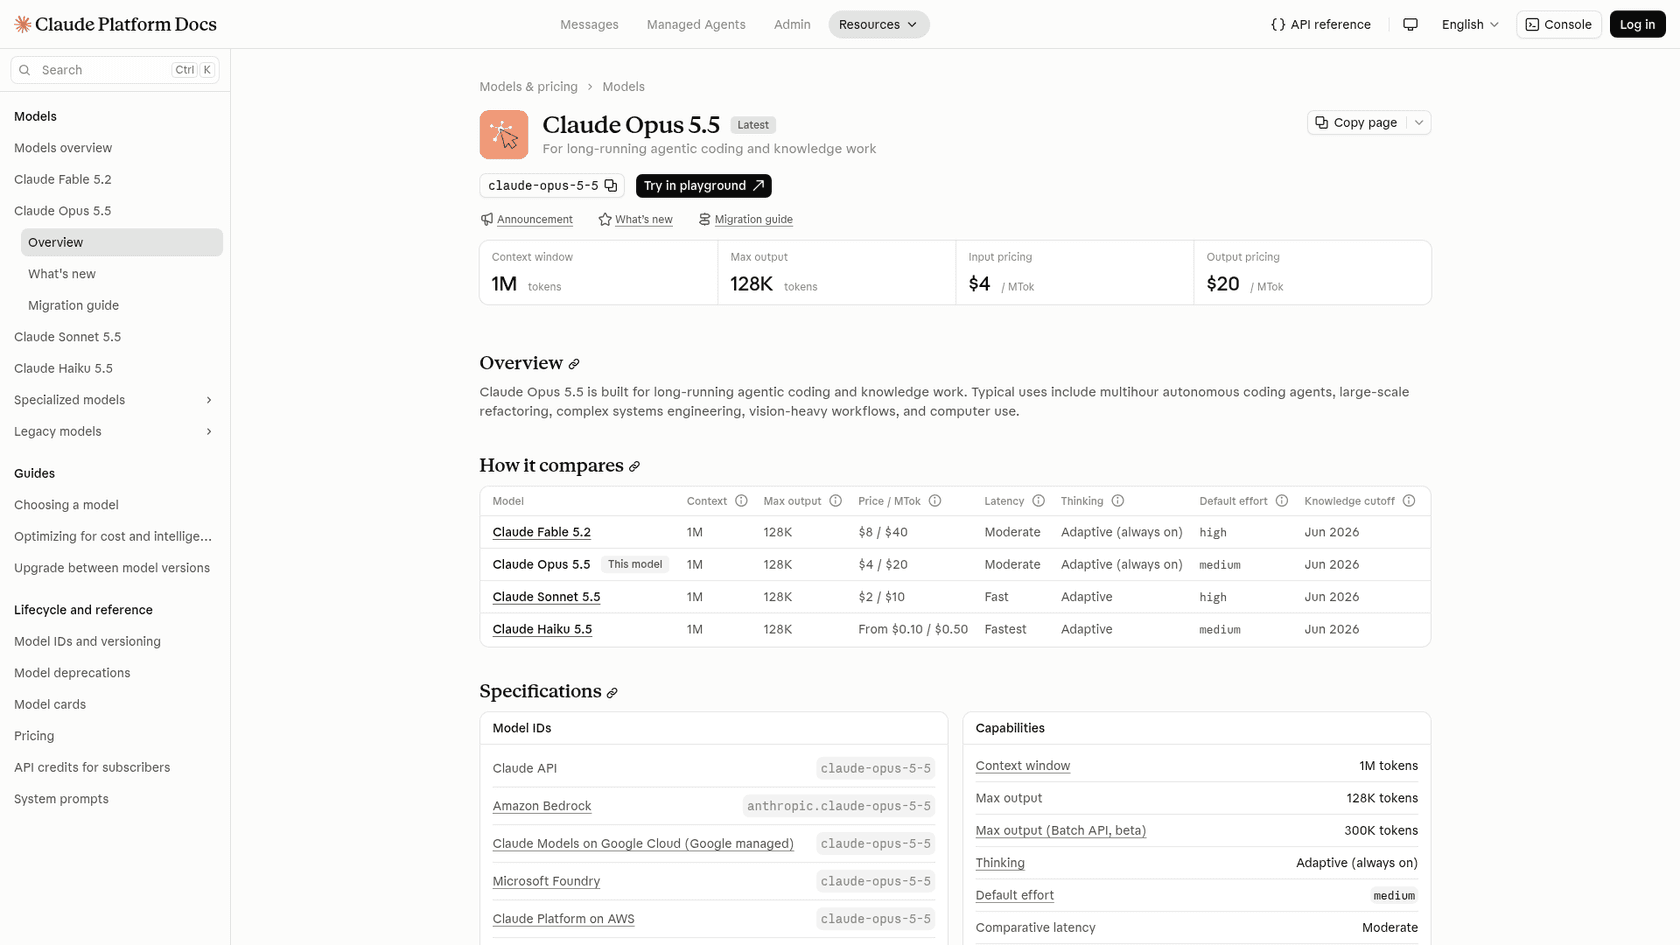
Claude Opus 5.5 est le modèle que Anthropic recommande à la plupart des développeurs pour commencer. Sa documentation le décrit comme conçu "for long-running agentic coding and knowledge work", avec une fenêtre de contexte de 1M tokens, 128K en sortie et un effort moyen par défaut. Il obtient 59 sur Artificial Analysis, trois points sous Astra.
L'argument en sa faveur n'est pas le score. C'est sa façon de communiquer. La plainte la plus fréquente sur Astra est que ses résumés de longues exécutions sont difficiles à suivre, et Opus est ce vers quoi plusieurs testeurs se tournent pour corriger ça.
"I've already built the habit of switching to opus 5.5 at the end of a long 6.2 Astra run, just to get a readable summary of what it said."
Avantages
- La moitié du prix par token d'Astra, à $4/$20, avec des lectures de cache à $0,20
- Les testeurs préfèrent régulièrement ses explications et sa planification sur les tâches longues
- Le mode rapide offre jusqu'à 2,5x la vitesse de sortie avec un supplément, selon la documentation tarifaire d'Anthropic
Inconvénients
- $10,04 par tâche de référence à effort maximal, 2,5 fois le chiffre d'Astra
- 24,6 minutes par tâche à effort maximal, plus du double du temps d'Astra
- Certains développeurs trouvent encore que sa prose demande une seconde passe d'édition
Tarifs : $4 en entrée, $20 en sortie, $0,20 pour les lectures de cache, $5 pour les écritures de cache de 5 minutes. Le guide tarifs de Claude Opus 5.5 détaille le reste.
Verdict : la meilleure option en tant que deuxième fournisseur pour qui lit la sortie de l'agent. Faites-le tourner en effort moyen, pas maximal, et vérifiez la facture par tâche avant de supposer que le prix par token plus bas se répercute. Mon test de Claude Opus 5.5 développe davantage.
3. Claude Fable 5.2
Idéal pour : la rare tâche où le meilleur score compte plus que la facture.
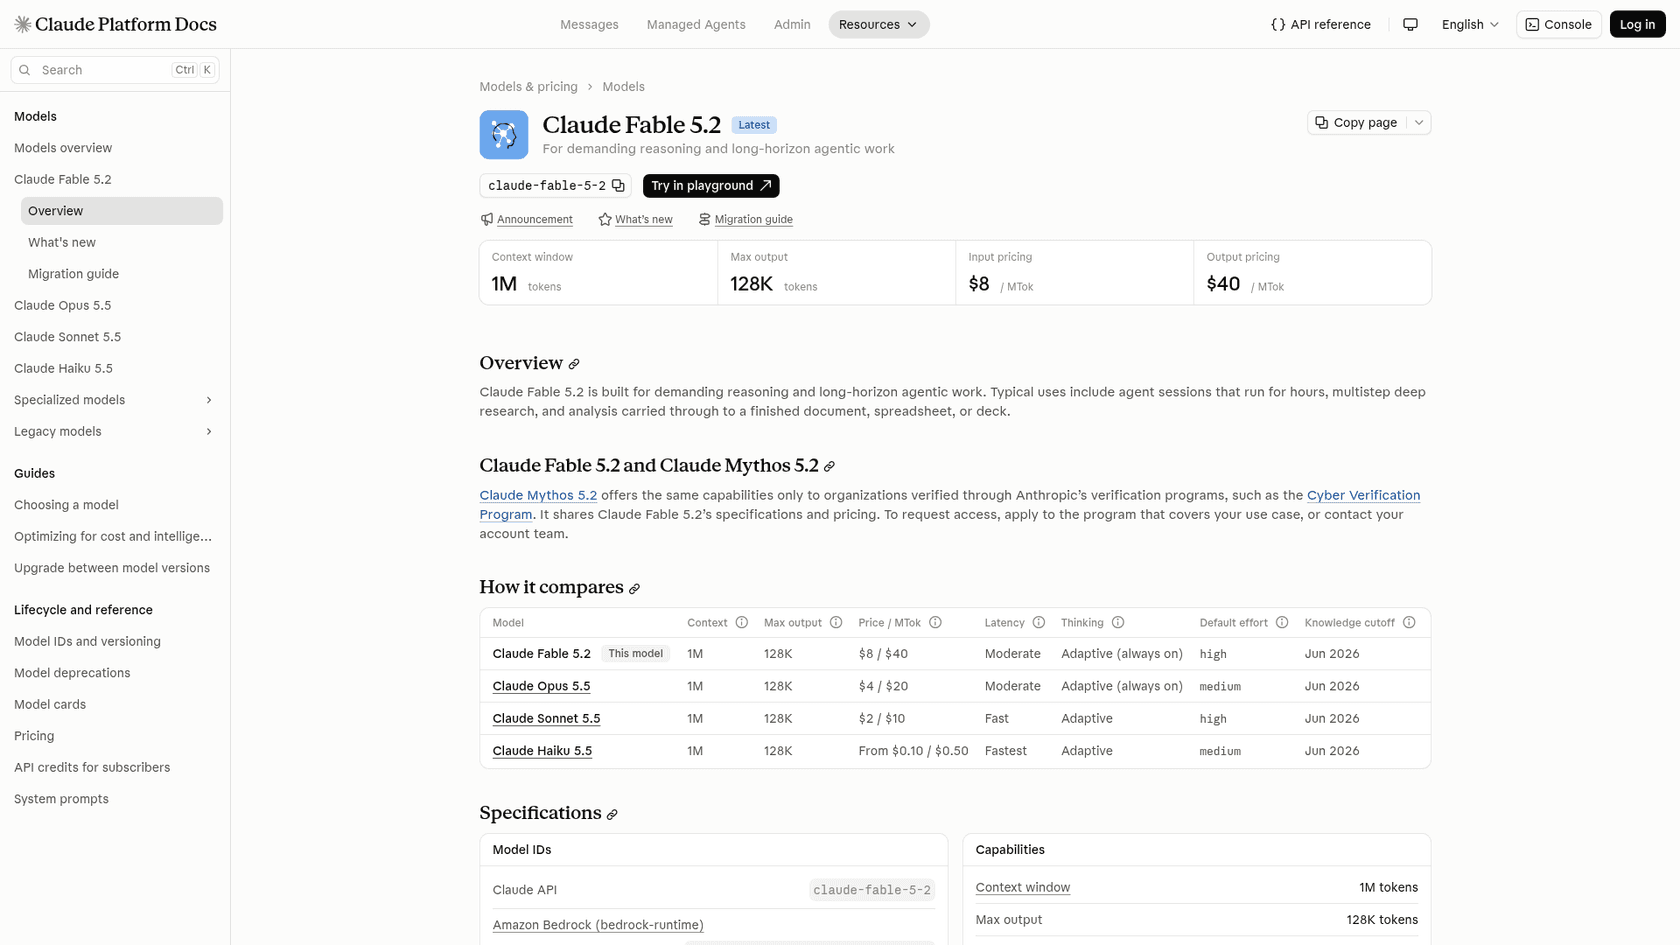
Claude Fable 5.2 est le seul modèle de cette liste qui dépasse Astra au score : 65 contre 62 sur l'Artificial Analysis Intelligence Index. Il a le même prix affiché de $8/$40 qu'Astra, et ses lectures de cache coûtent moitié moins, à $0,20 contre $0,40. Anthropic le décrit comme conçu "for demanding reasoning and long-horizon agentic work".
Puis la facture par tâche arrive. Artificial Analysis a mesuré Fable 5.2 à $26,54 par tâche et 40,8 minutes, contre $4,00 et 10,4 minutes pour Astra. Même prix par token, 6,6 fois le coût par tâche. Un commentateur de HN a résumé le point de vue d'Astra sur cet échange :
"Second place at a sixth the price and in a quarter of the time (both according to Artificial Analysis for Astra 6.2 vs. Fable 5.2, both max effort) definitely has a place."
D'autres ont pensé le contraire après des semaines de tests :
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
Avantages
- Le score Artificial Analysis le plus élevé de tous les modèles, à 65
- Même prix par token qu'Astra, avec des lectures de cache moins chères
- De fortes critiques des testeurs sur le design et les longues tâches d'agent
Inconvénients
- $26,54 par tâche de référence, le modèle le plus cher ici, avec une large marge
- 40,8 minutes par tâche, le plus lent de la liste
- La réflexion est toujours activée, impossible donc de basculer vers un mode sans raisonnement
Tarifs : $8 en entrée, $40 en sortie, $0,20 pour les lectures de cache, $10 pour les écritures de cache de 5 minutes. Le batch coûte moitié moins. Le guide tarifs de Claude Fable 5.2 couvre le mode rapide.
Verdict : une montée en gamme, pas une alternative. Utilisez-le pour les rares tâches où Astra se trompe, et attendez-vous à ce que la facture le montre. Le test de Claude Fable 5.2 détaille tout cela.
4. Claude Sonnet 5.5
Idéal pour : les équipes qui veulent le style d'Anthropic au prix de Sol.
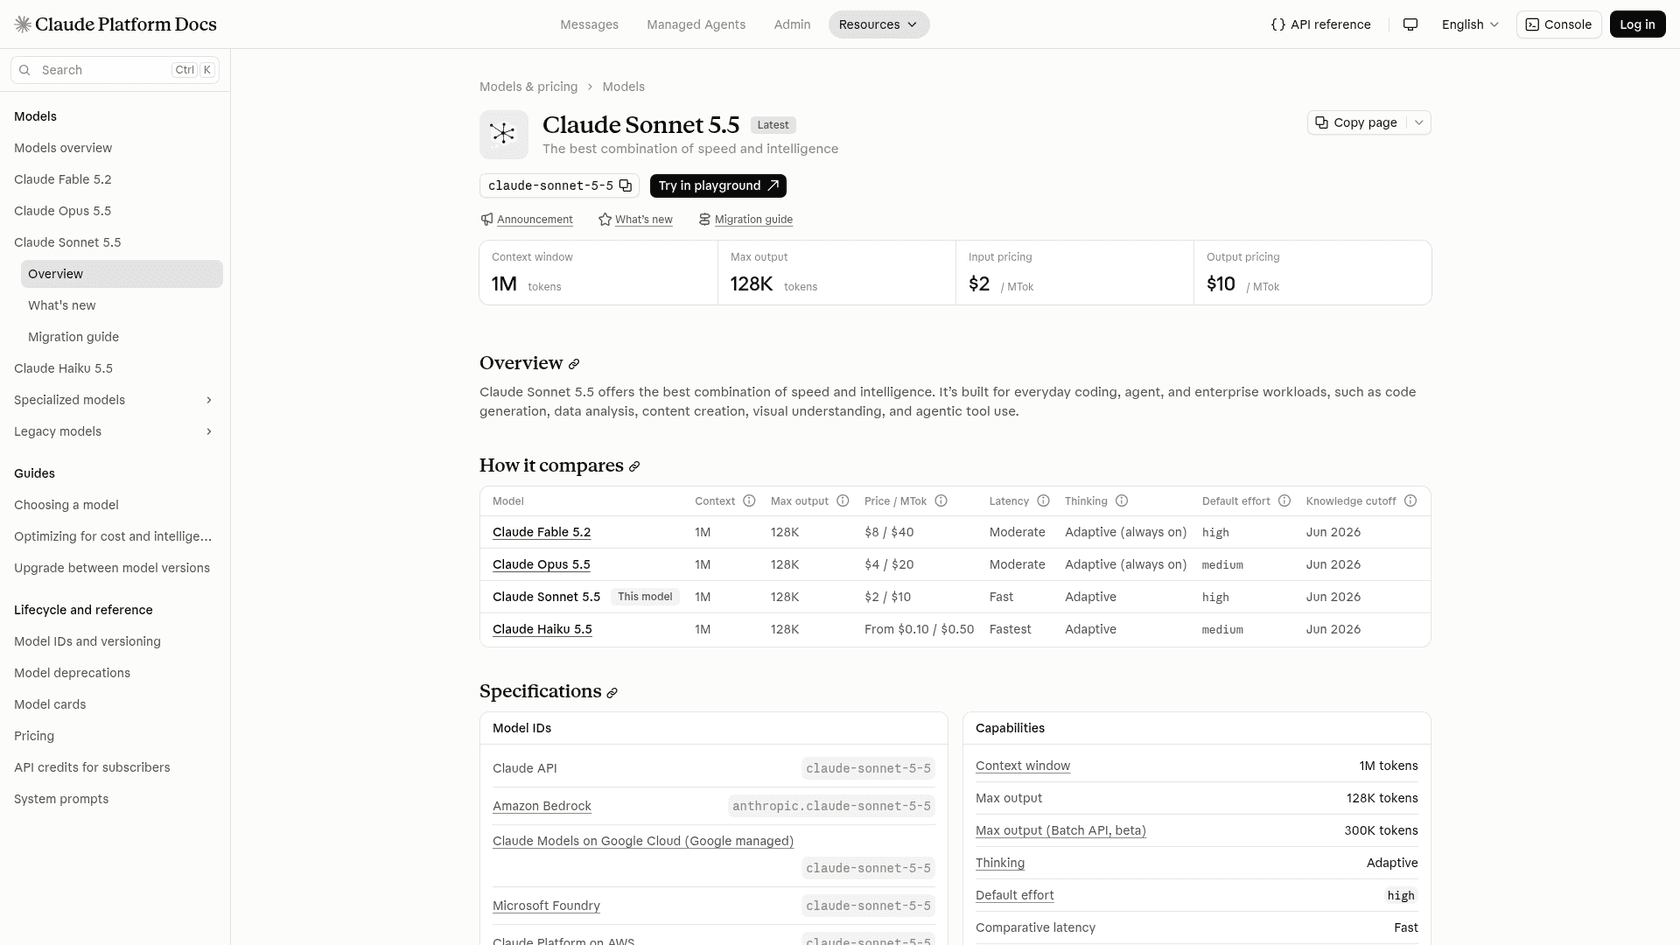
Claude Sonnet 5.5 est ce que Anthropic appelle "the best combination of speed and intelligence". Il coûte $2/$10, comme Sol, avec des lectures de cache à $0,10 et un contexte de 1M. À la différence d'Opus et Fable, sa réflexion est adaptative plutôt que toujours activée, et l'effort par défaut est élevé.
Sur Artificial Analysis, il obtient 55 à effort maximal, avec un coût par tâche de $10,02 et 32,3 minutes par tâche. C'est le même piège de coût par tâche qu'Opus, et ici il mord plus fort, puisque Sol obtient deux points de plus pour un dixième du coût par tâche. La solution est la même : faites-le tourner sous l'effort maximal et mesurez.
Avantages
- $2/$10 avec $0,10 de lectures de cache, comme Sol
- Réflexion adaptative, les demandes simples ne paient donc pas pour une longue réflexion
- Même contexte de 1M et sortie de 128K qu'Opus
Inconvénients
- $10,02 par tâche de référence à effort maximal, dix fois le chiffre de Sol
- 55 sur Artificial Analysis, sous les 57 de Sol
- L'effort par défaut est élevé, le réglage coûteux est donc celui par défaut
Tarifs : $2 en entrée, $10 en sortie, $0,10 pour les lectures de cache, $2,50 pour les écritures de cache de 5 minutes, selon les tarifs d'Anthropic. Voir le guide tarifs de Claude Sonnet 5.5.
Verdict : préférez-le à Sol seulement si vous êtes déjà chez Anthropic ou préférez son écriture, et fixez vous-même le niveau d'effort. Mon test de Claude Sonnet 5.5 couvre les changements cassants.
5. Gemini 4 Carbon
Idéal pour : un score proche d'Astra chez un deuxième fournisseur, si vous budgétisez au prix de décembre.
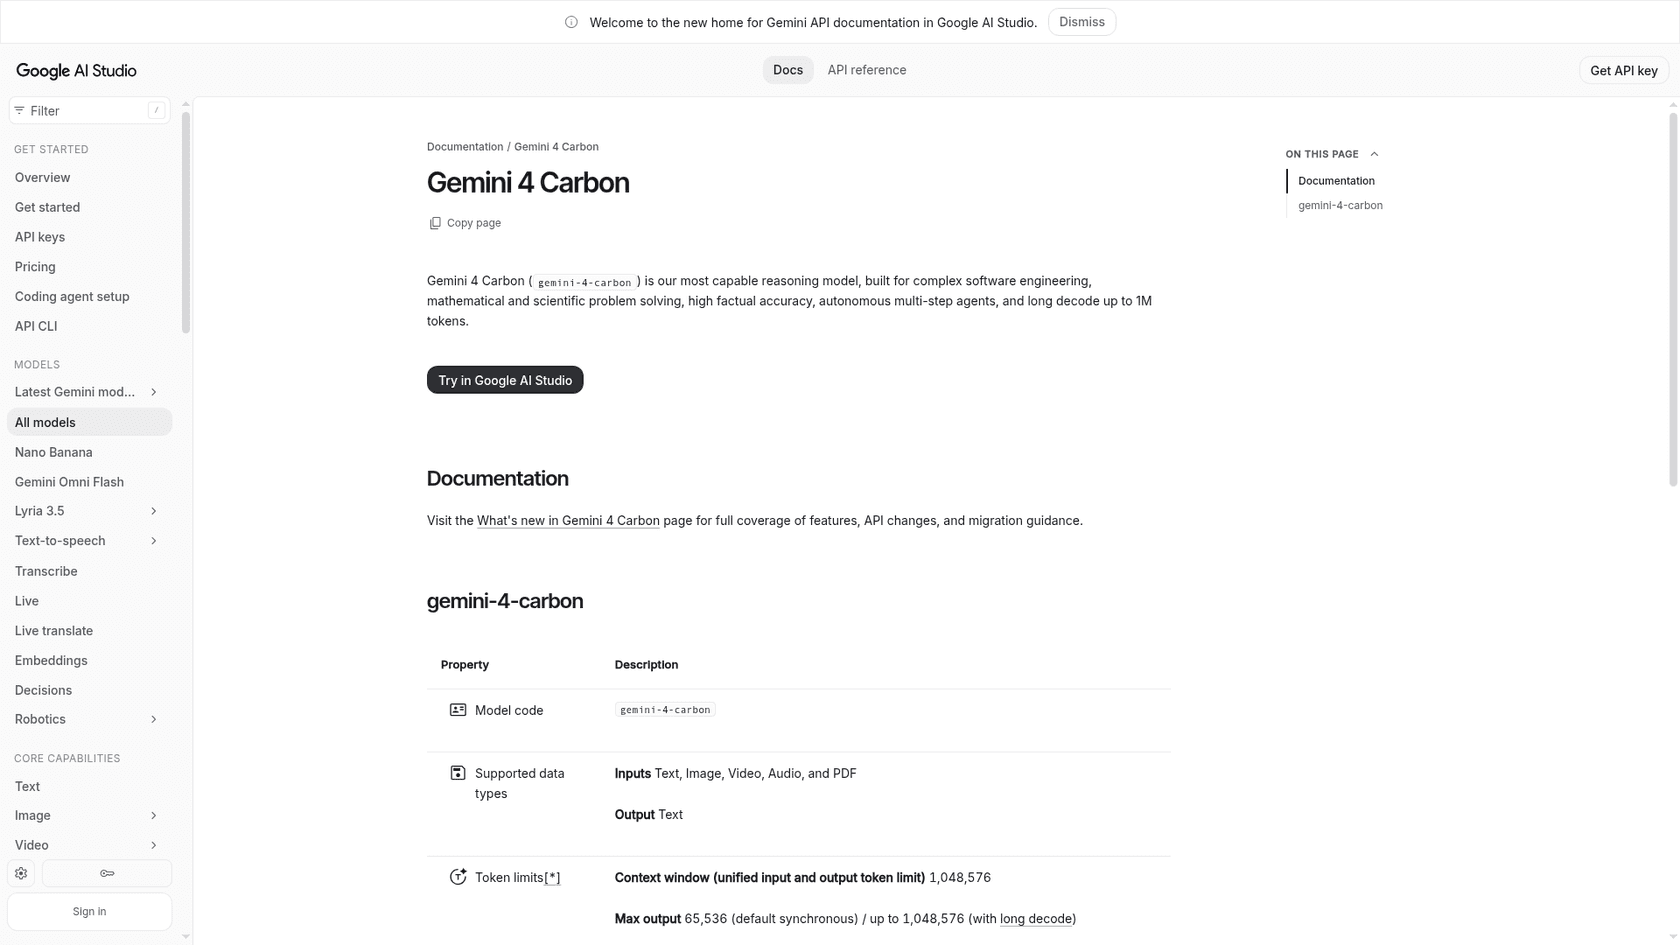
Gemini 4 Carbon est le modèle de raisonnement le plus capable de Google, et il obtient 60 sur Artificial Analysis, deux points sous Astra et un au-dessus d'Opus 5.5. Son coût par tâche est de $5,48, ce qui est la plus proche approche de n'importe quel modèle non-OpenAI vers Astra sur les deux axes à la fois. Il accepte texte, images, vidéo, audio et PDF, avec un contexte de 1 048 576 tokens et jusqu'à 1M tokens de sortie via un décodage long.
Surveillez le calendrier. La page de tarifs de Google liste Carbon à $2/$10 jusqu'au 30 novembre 2026, puis $4/$20 à partir du 1er décembre. Le cache ne fonctionne qu'implicitement, et il n'y a pas de palier gratuit pour Carbon.
Si le prix de Carbon est trop élevé, Gemini 4 Hydrogen de Google est le petit frère moins cher : $1,50/$7,50, un palier gratuit, et un score de 54 à $3,16 par tâche. Et un développeur sur HN a trouvé une autre raison de regarder cette famille :
"My favorite model for this at the moment is Gemini 4 Argon, which writes very naturally and isn't too expensive."
Avantages
- 60 sur Artificial Analysis à $5,48 par tâche, le meilleur équilibre non-OpenAI de cette liste
- Accepte vidéo, audio et PDF en plus de texte et images
- Jusqu'à 1M tokens de sortie avec un décodage long
Inconvénients
- Le prix double à $4/$20 le 1er décembre 2026
- 33,4 minutes par tâche de référence, plus de trois fois le temps d'Astra
- Cache implicite seulement, et aucun palier gratuit
Tarifs : $2/$10 et $0,10 de cache jusqu'au 30 novembre, puis $4/$20 et $0,20. Le grounding de recherche est gratuit pour 5 000 requêtes par mois, puis $14 par 1 000. Le guide tarifs de Gemini 4 Carbon a les paliers batch et flex.
Verdict : le meilleur choix comme deuxième fournisseur si vous avez besoin d'une intelligence proche d'Astra. Budgétisez à $4/$20 dès le premier jour pour que décembre ne vous surprenne pas. Mon test de Gemini 4 Carbon couvre les benchmarks.
6. Gemini 3.8 Flash
Idéal pour : les étapes bon marché à fort volume comme la classification, l'extraction et les premiers brouillons.
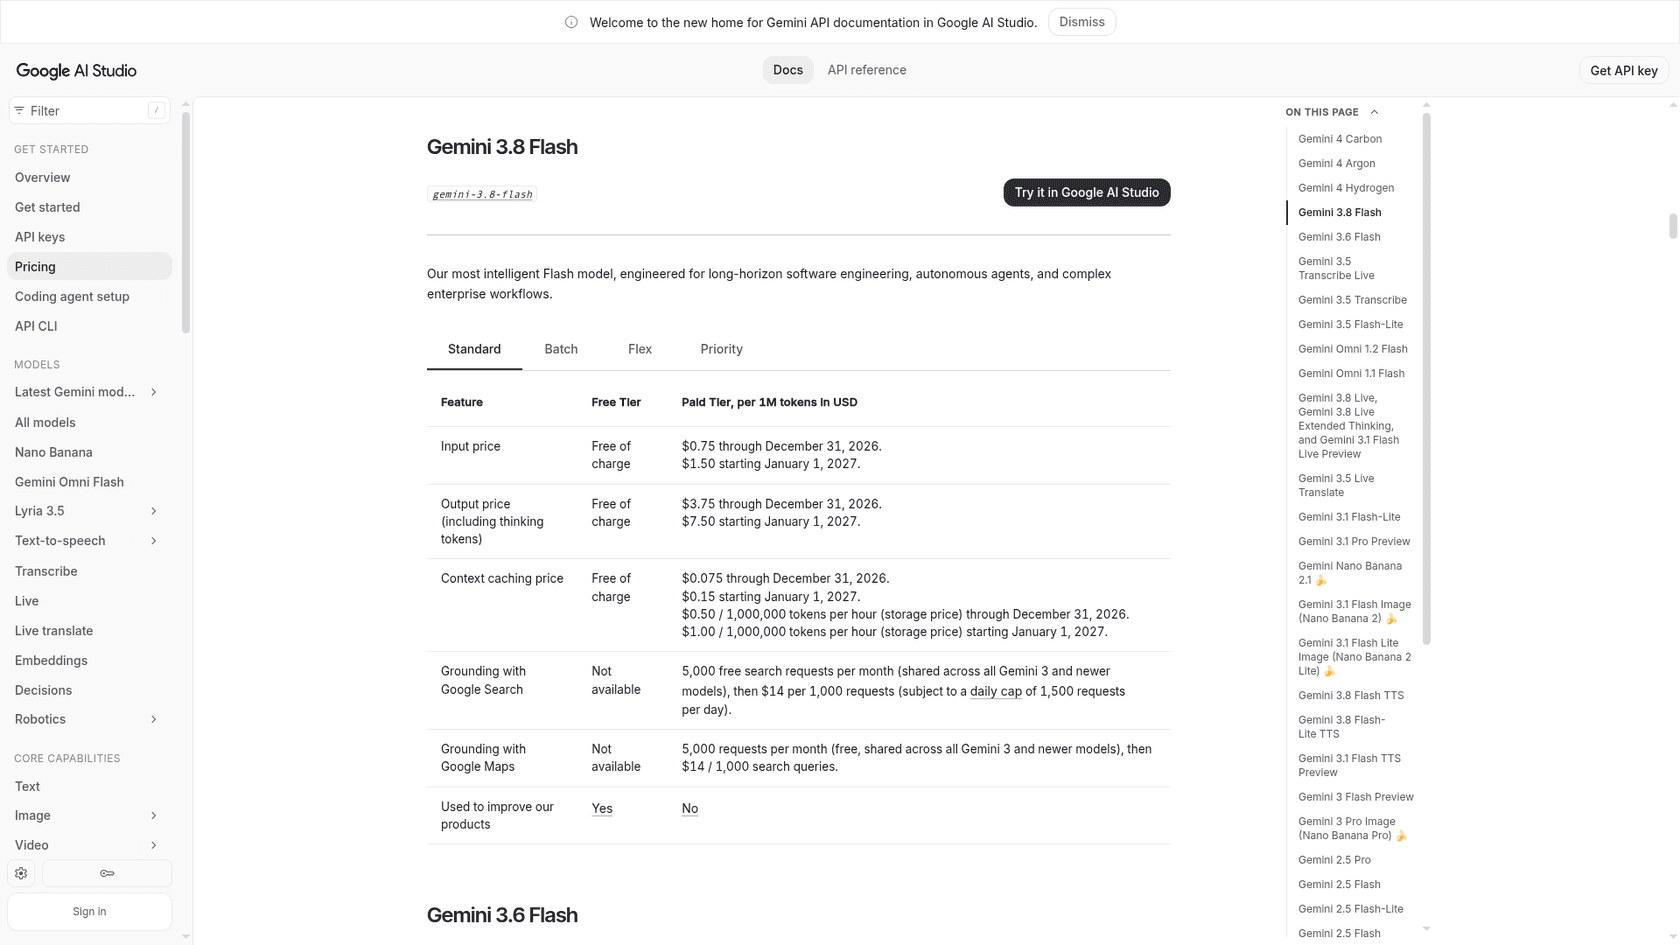
Google décrit Gemini 3.8 Flash comme son modèle Flash le plus intelligent, "engineered for long-horizon software engineering, autonomous agents, and complex enterprise workflows". ChatGPT l'a placé près du sommet de sa propre liste d'alternatives à Astra, à cause du prix : $0,75/$3,75 par million de tokens, environ un dixième de celui d'Astra.
Le score est l'autre moitié de l'histoire. Il se situe à 31 sur l'Artificial Analysis Intelligence Index, la moitié des 62 d'Astra. Ce n'est pas un remplacement pour les tâches difficiles d'Astra. C'est un modèle pour la voie bon marché d'une configuration routée, où la tâche est petite et clairement définie.
Avantages
- $0,75/$3,75, environ un dixième du prix par token d'Astra
- Palier gratuit pour les tests
- Entrée en cache à $0,075
Inconvénients
- 31 sur Artificial Analysis, le deuxième score le plus bas de cette liste
- Le prix double à $1,50/$7,50 le 1er janvier 2027
- 14,1 minutes par tâche de référence, plus lent qu'Astra malgré le fait d'être un modèle Flash
Tarifs : $0,75 en entrée, $3,75 en sortie, $0,075 de cache jusqu'au 31 décembre 2026, selon la page de tarifs de Google. Le guide tarifs de Gemini 3.8 Flash couvre le saut de 2027.
Verdict : un outil de routage, pas un remplacement. Utilisez-le pour la part simple de votre trafic et gardez un modèle plus puissant pour tout ce qui demande du jugement. La liste alternatives à Gemini 3.8 Flash a des options dans la même gamme de prix.
7. Grok 4.7
Idéal pour : les longues boucles d'agents où le volume de sortie rendrait Astra coûteux.
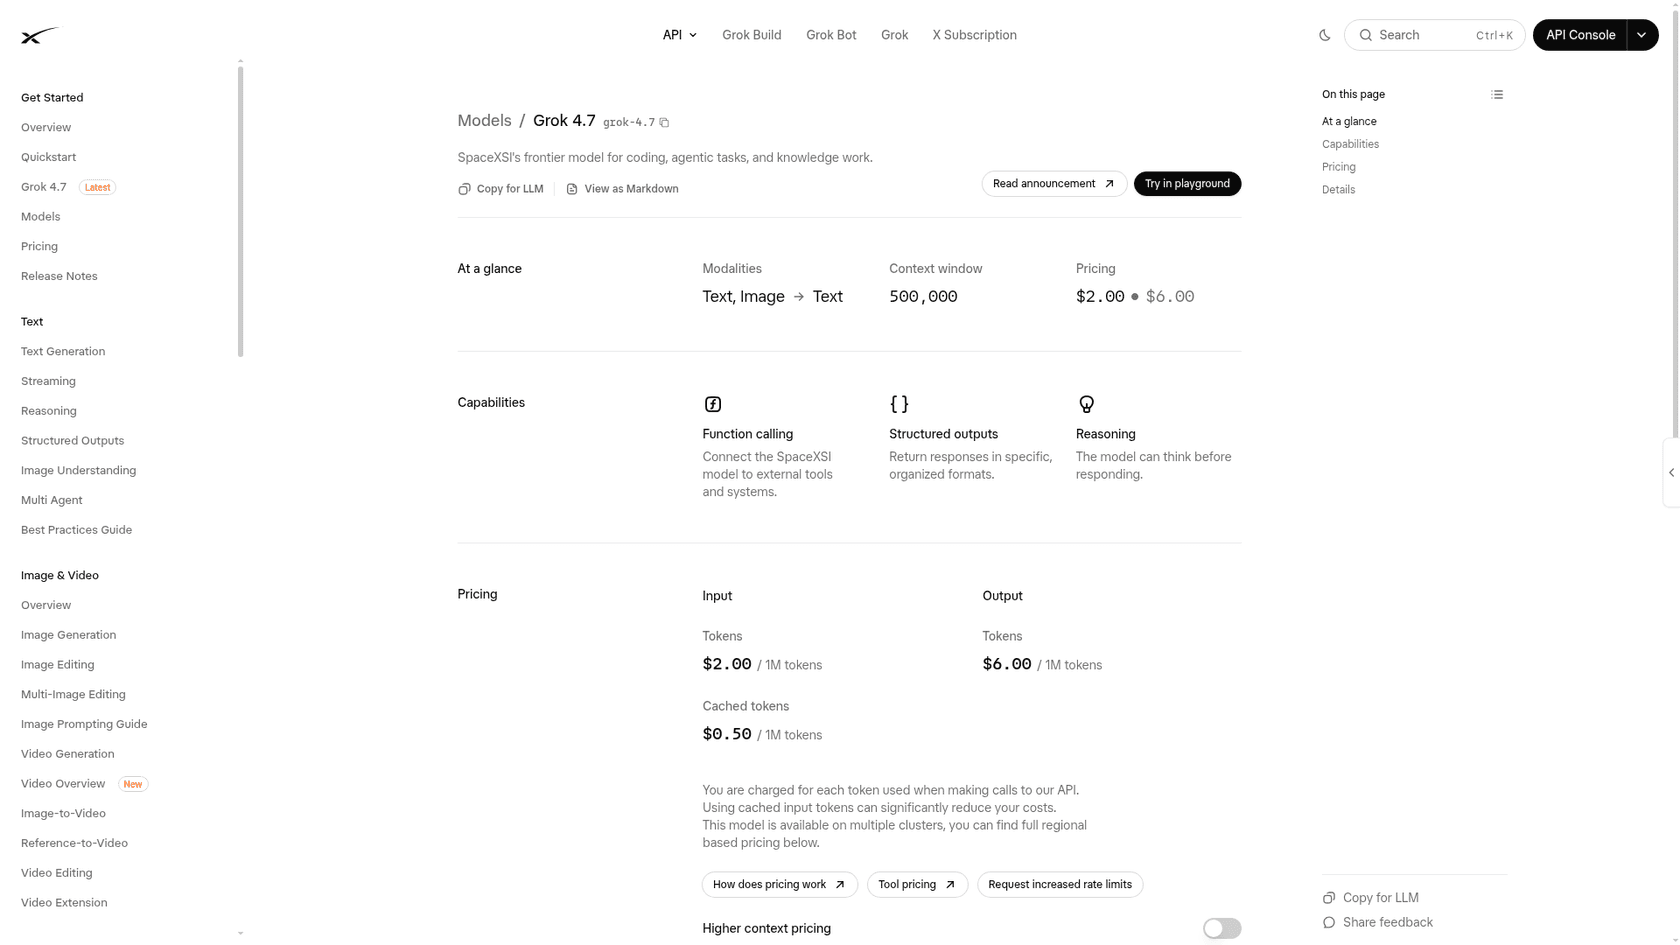
Grok 4.7 facture $6 par million de tokens en sortie, contre $40 pour Astra et $10 pour Sol. L'entrée coûte $2 avec une entrée en cache à $0,50, et la fenêtre de contexte est de 500K tokens. xAI prend aussi en charge l'appel de fonctions, les sorties structurées et le raisonnement sur le modèle.
Son score Artificial Analysis est de 35 à l'effort xhigh, et il a fallu 24,5 minutes par tâche de référence. Cela le place bien en dessous d'Astra sur l'indice général. Les propres benchmarks de lancement de xAI racontent une histoire plus serrée, avec Grok 4.7 obtenant 64,0 sur EEBench contre 56,4 pour Claude Fable 5.1, testez-le donc sur votre propre boucle avant de l'écarter. Le test de Grok 4.7 en dit plus.
Avantages
- $6 par million de tokens en sortie, moins d'un sixième de celui d'Astra
- Fenêtre de contexte de 500K
- Appel de fonctions natif et sorties structurées
Inconvénients
- 35 sur Artificial Analysis, bien en dessous des 62 d'Astra
- Les prompts de 200K tokens ou plus sont facturés à $4/$12
- Les outils côté serveur comme la recherche web ajoutent $5 pour 1 000 appels
Tarifs : $2 en entrée, $0,50 en cache, $6 en sortie sous 200K tokens, selon la page de tarifs de xAI. Le guide tarifs de Grok 4.7 couvre les frais d'outils.
Verdict : vaut le coup d'être testé si les tokens de sortie dominent votre facture. Ne le choisissez pas uniquement sur le score de l'indice, dans aucun des deux sens. L'article alternatives à Grok 4.7 le compare au reste de sa gamme de prix.
8. DeepSeek V4 Pro et Flash
Idéal pour : la facture de tokens la plus basse, si votre charge de travail s'inscrit dans les heures hors pointe et le texte.
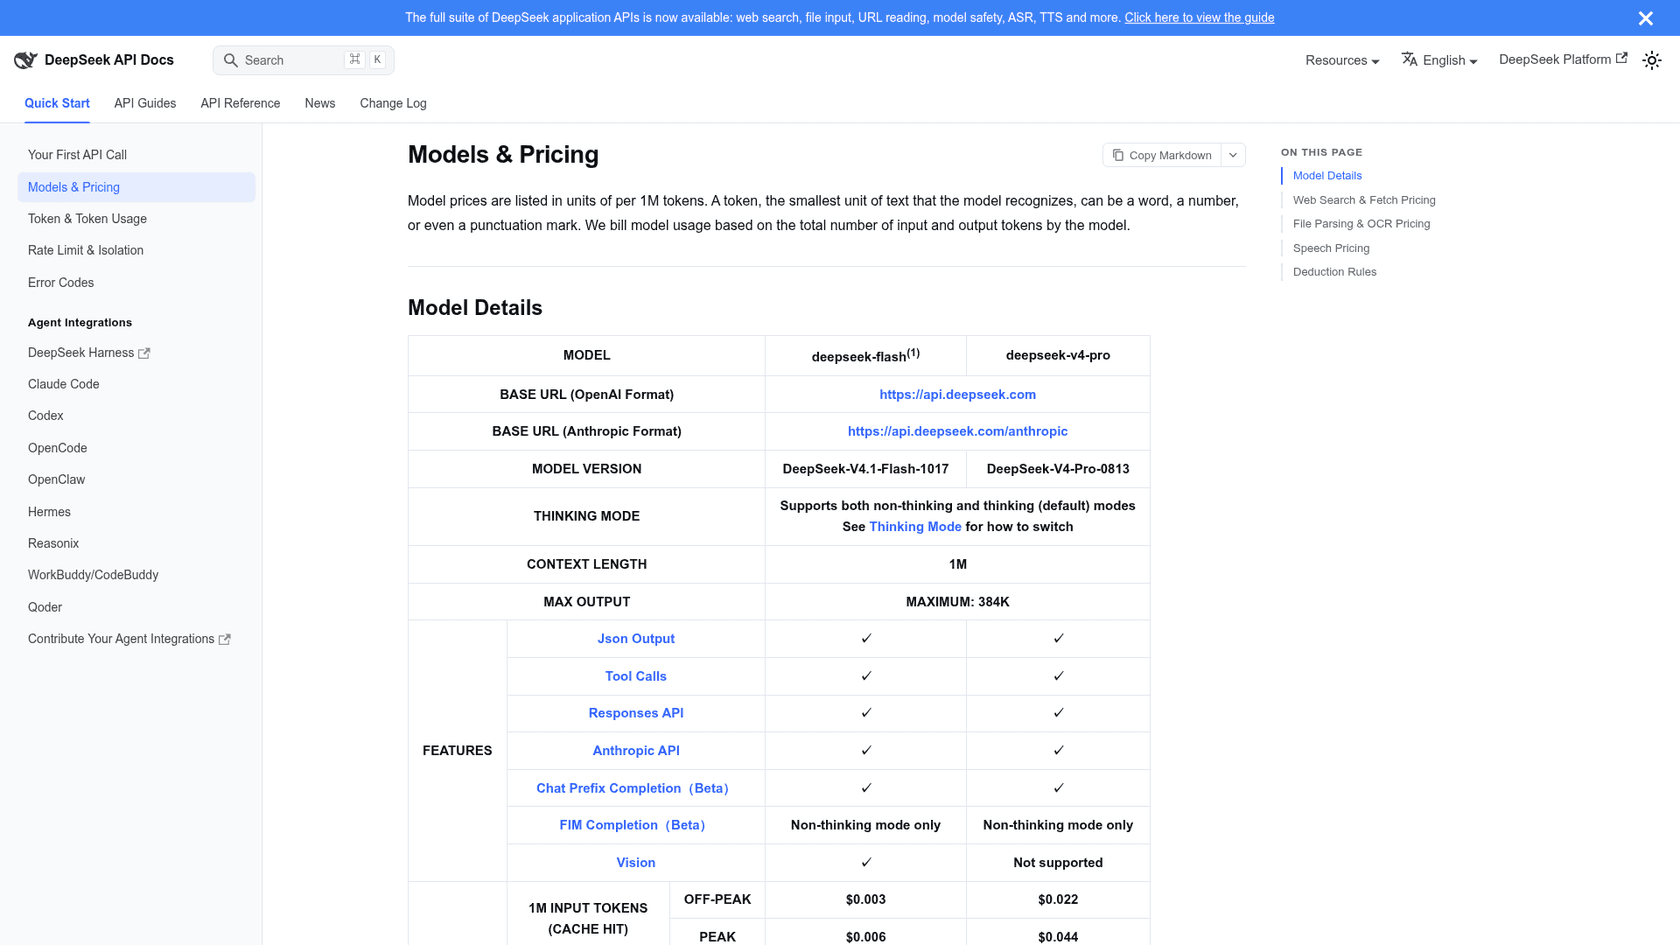
DeepSeek vend deux modèles via une API compatible OpenAI, et accepte aussi le format d'API Anthropic. deepseek-flash sert maintenant DeepSeek V4.1 Flash à $0,15 en entrée et $0,60 en sortie hors pointe. deepseek-v4-pro est à $0,66/$1,98 hors pointe. Les deux ont un contexte de 1M, jusqu'à 384K en sortie, des appels d'outils et une sortie JSON.
Le piège, c'est l'horloge. DeepSeek facture le double pendant les heures de pointe en semaine, de 01h00 à 04h00 et de 06h00 à 10h00 UTC, donc Pro passe à $1,32/$3,96 et Flash à $0,30/$1,20. Les hits de cache sont presque gratuits, de $0,003 à $0,044 par million.
Sur Artificial Analysis, V4 Pro obtient 23 à effort maximal, pour $1,77 par tâche. C'est bien en dessous de tout autre modèle ici, traitez donc DeepSeek comme un coup de pouce sur les coûts pour du travail bien défini. Flash a ses fans, précisément pour ça :
"I used Luna Max a lot, until Deepseek 1017. Then never again."
Avantages
- Flash à $0,15/$0,60 hors pointe est le modèle capable le moins cher de cette liste
- Accepte les formats d'API OpenAI et Anthropic
- Contexte de 1M et jusqu'à 384K en sortie
Inconvénients
- Les prix doublent pendant les heures de pointe en semaine (UTC)
- V4 Pro obtient 23 sur Artificial Analysis, le plus bas ici
- V4 Pro ne prend pas en charge la vision, et la concurrence est limitée à 500 requêtes
Tarifs : par million de tokens hors pointe, Flash $0,15/$0,60, Pro $0,66/$1,98 ; en heure de pointe, c'est le double. La recherche web et le fetch coûtent $0,75 pour 1 000 appels. Le guide tarifs de DeepSeek V4.1 Flash détaille les horaires de pointe.
Verdict : une bonne voie bon marché pour du travail texte uniquement à fort volume, programmé hors pointe si possible. Pas un substitut aux tâches difficiles d'Astra. Voir V4 Flash contre V4 Pro pour choisir entre les deux.
9. Kimi K3.1 Pro
Idéal pour : une option de pointe non américaine au prix de Sol.
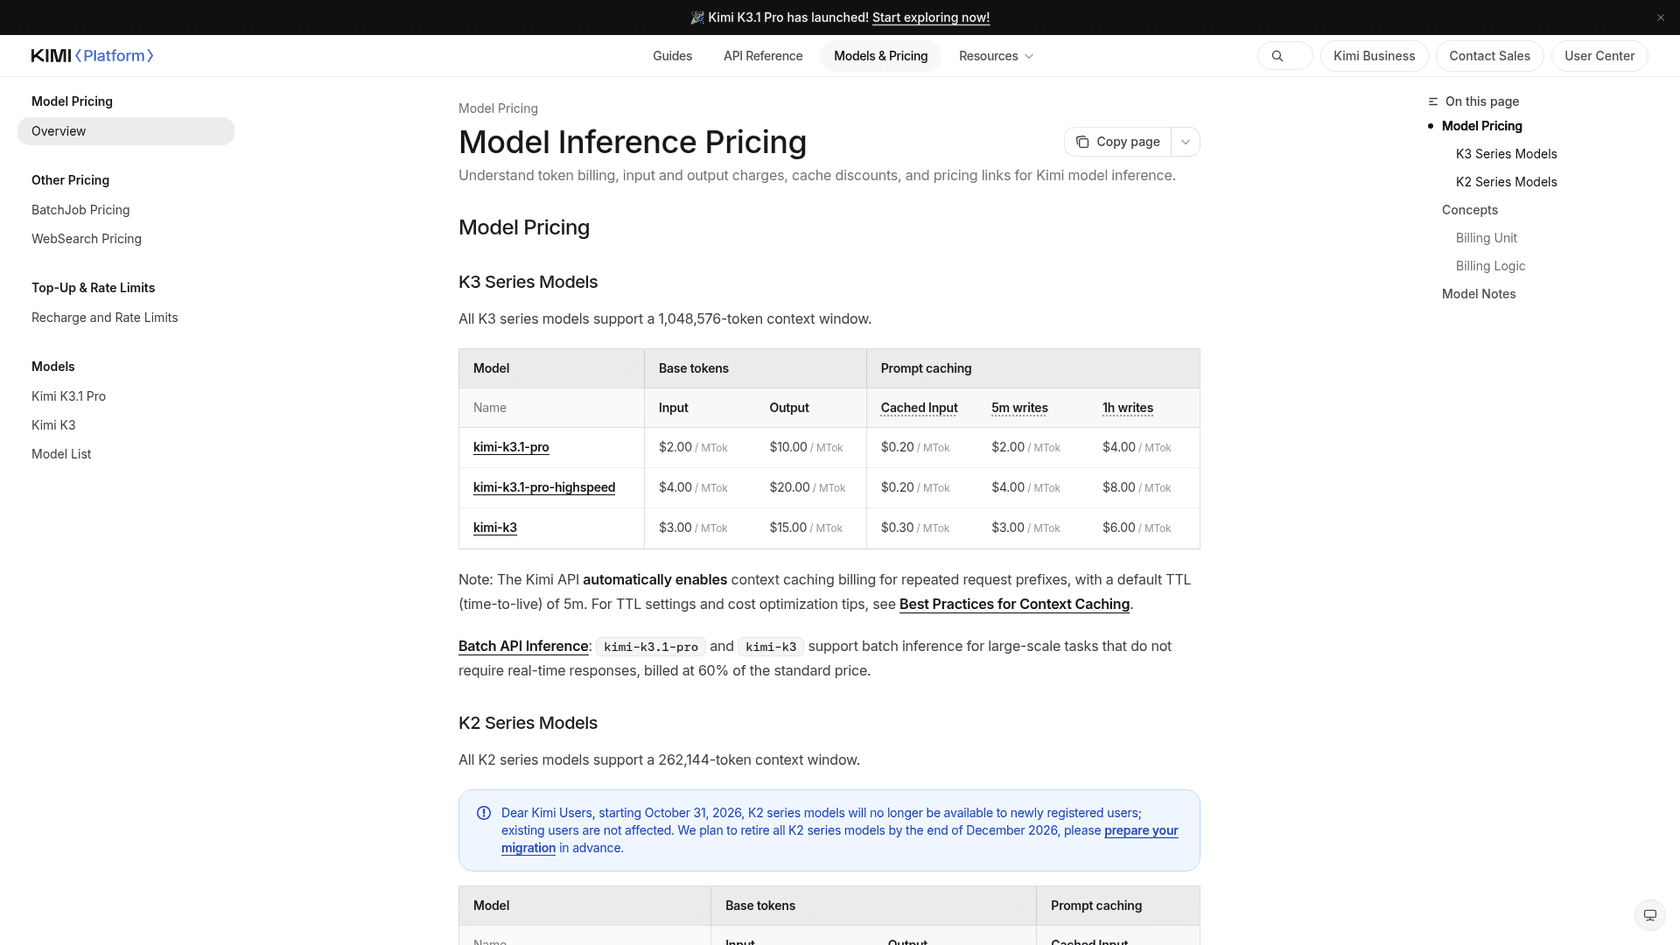
Kimi K3.1 Pro de Moonshot AI coûte $2/$10, comme Sol, avec $0,20 d'entrée en cache et une fenêtre de contexte de 1 048 576 tokens, selon la page de tarifs de Kimi. Une variante haute vitesse coûte le double. Le cache de contexte s'active automatiquement pour les préfixes répétés, avec une durée de vie par défaut de 5 minutes.
Il obtient 46 sur Artificial Analysis à $3,68 par tâche, ce qui le place entre les modèles économiques et le groupe de pointe. Le temps par tâche est long, 38,7 minutes.
Avantages
- $2/$10, comme Sol et Sonnet 5.5
- Cache de contexte automatique sans configuration
- Fenêtre de contexte de 1M tokens
Inconvénients
- 46 sur Artificial Analysis, 11 points sous Sol au même prix par token
- 38,7 minutes par tâche de référence
- Les modèles K2 sont fermés aux nouveaux utilisateurs depuis le 31 octobre 2026, donc d'anciens guides peuvent pointer vers des modèles que vous ne pouvez pas utiliser
Tarifs : $2 en entrée, $10 en sortie, $0,20 en cache, $2 pour les écritures de cache de 5 minutes. Voir tarifs de Kimi K3.1 Pro.
Verdict : vaut le coup d'être testé si vous avez besoin d'un laboratoire non américain. Au même prix, Sol obtient un score plus élevé sur l'indice partagé. Le test de Kimi K3.1 Pro va plus loin.
10. Qwen4 Max
Idéal pour : des prix de sortie bas venant d'un grand modèle généraliste.
Qwen4 Max est devenu disponible pour tous le 16 novembre 2026. Dans la région de Singapour de Qwen Cloud, il coûte $1,50 en entrée et $4,50 en sortie par million de tokens, avec des lectures de cache à $0,075, selon les prix des modèles de Qwen Cloud. La fenêtre de contexte est de 1M tokens.
Artificial Analysis le note à 43 à $3,27 par tâche. C'est plus bas que Kimi K3.1 Pro et bien sous Sol, mais son prix de sortie est environ un neuvième de celui d'Astra.
Avantages
- $4,50 en sortie, plus bas que tout modèle ici sauf DeepSeek et Gemini 3.8 Flash
- Lectures de cache à $0,075
- Modes réflexion et sans réflexion au même prix
Inconvénients
- 43 sur Artificial Analysis
- Les prix varient selon la région, le tarif de Singapour n'est donc pas universel
- 31,9 minutes par tâche de référence
Tarifs : $1,50/$4,50 à Singapour, avec un cache explicite à $1,875 pour les écritures de 5 minutes. Le guide tarifs de Qwen 4 Max couvre les autres régions.
Verdict : un choix économique pour un travail simple. Pour quelque chose de plus proche d'Astra, remontez dans cette liste. L'article alternatives à Qwen 4 Max le compare à ses propres rivaux.
Faut-il router entre les modèles plutôt que de changer ?
Pour la plupart des produits à base d'agents, oui. Passer entièrement d'Astra à un modèle moins cher signifie accepter ses faiblesses sur chaque tâche. Router signifie envoyer chaque tâche au modèle le moins cher qui la gère bien.
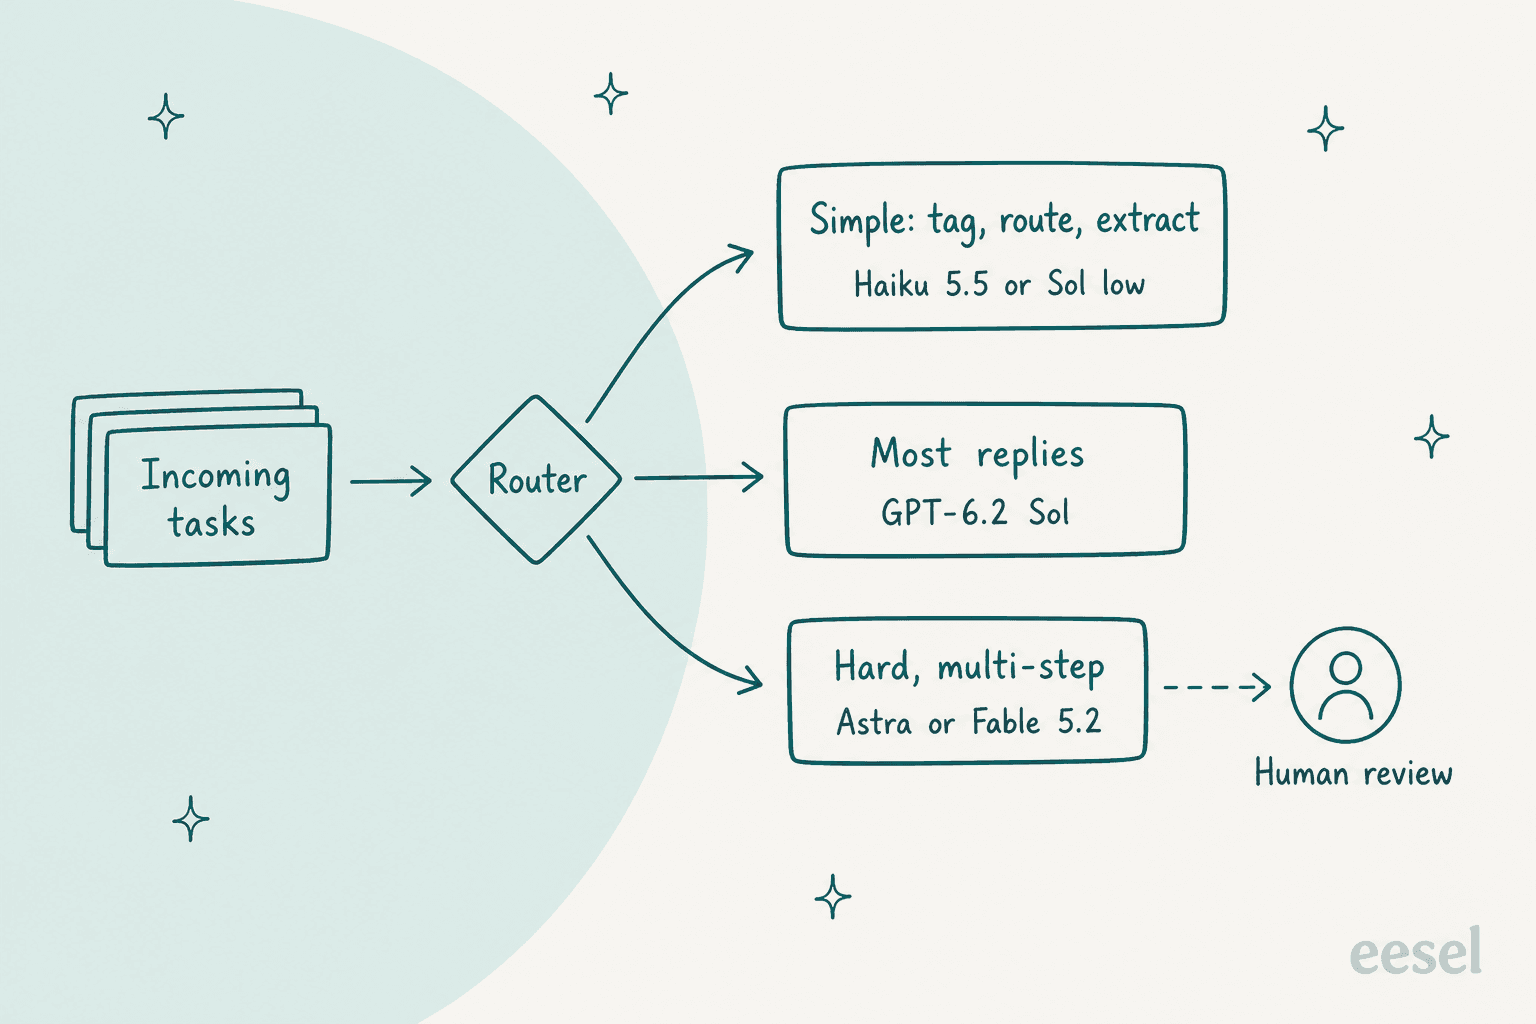
Une configuration par laquelle je commencerais :
- Les tâches simples comme l'étiquetage, le routage et l'extraction vont à un petit modèle. Claude Haiku 5.5 coûte $0,10/$0,50 pour des prompts jusqu'à 100 000 tokens et a coûté $0,41 par tâche Artificial Analysis, ou utilisez Sol à faible effort.
- La plupart des réponses et appels d'outils de routine vont à GPT-6.2 Sol, qui a égalé Astra sur tout mon test.
- Le travail difficile à plusieurs étapes va à Astra, ou à Fable 5.2 quand l'enjeu justifie $26,54 par tâche.
- Tout ce qui est incertain va à une personne.
Des développeurs dans le fil de lancement faisaient déjà une version de cela :
"Opus medium as orchestrator and reviewer, Sol(high/medium)/Terra(max) as implementer."
La même idée vaut pour les files de support. Le routage intelligent envoie les tickets à la bonne personne ; le routage de modèles envoie chaque étape au bon modèle. Le comparatif coût d'un agent IA contre un agent humain montre pourquoi la voie bon marché compte à fort volume.
Comment tester une alternative avant de changer ?
Les benchmarks vous disent quels modèles présélectionner. Seules vos propres tâches vous disent lequel déployer. Voici le processus que j'ai utilisé pour le test de Sol, à plus grande échelle.
- Prenez 100 à 300 tâches réelles dans vos journaux, y compris les gênantes : appels d'outils échoués, demandes vagues, autres langues.
- Gardez tout identique sauf le modèle : même prompt système, mêmes outils, mêmes limites.
- Évaluez le coût par tâche réussie, pas le coût par appel. Un modèle bon marché qui a besoin de deux relances n'est pas bon marché.
- Faites tourner chaque configuration à l'effort que vous déploieriez réellement, car l'effort change la facture plus que le prix affiché.
- Lisez les échecs à la main. Un montant de remboursement erroné compte plus qu'une phrase un peu rigide.
Pour le travail de support spécifiquement, les tests d'agents de support IA explique comment construire cet ensemble de test à partir de tickets passés. Le guide de benchmarking couvre l'évaluation, et revoir les conversations IA couvre le contrôle continu une fois en production.
Qu'est-ce que cela signifie pour une équipe de support ?
Si vos agents répondent aux clients, le choix du modèle est la décision mineure. N'importe quel modèle de cette liste peut écrire une réponse polie. Ce qui décide si c'est la bonne réponse, c'est les connaissances qu'il lit, les actions qu'il a le droit de prendre, et ce qui se passe quand il n'est pas sûr. Mon test l'a montré directement : Astra et Sol ont tous deux correctement escaladé la recherche de commande cassée parce que les instructions le disaient, et tous deux ont bien calculé le remboursement parce que la politique était écrite.
C'est la couche que construit eesel. eesel est une plateforme de coéquipiers IA : vous embauchez des coéquipiers prêts à travailler pour des tâches précises, un coéquipier IA pour le helpdesk pour votre file et un rédacteur de blog IA pour le contenu. Le modèle est le moteur ; le coéquipier est l'employé qui le conduit, avec vos intégrations, vos connaissances et vos garde-fous déjà en place. Avant de répondre à un client réel, il est simulé sur vos tickets passés.
Swiftreg, qui vend des plaques d'immatriculation privées, montre à quoi ressemble cette couche de règles en pratique. Ses agents eesel ont traité 2 100 tickets Zendesk en un mois, en répondant à partir de données de commande réelles selon des règles que Swiftreg a écrites lui-même. Ils ont envoyé 1 500 réponses publiques et laissé 1 050 notes internes là où une étape revient au personnel. SE Ranking fait tourner un agent eesel par produit sur trois produits dans Zendesk, et a traité 4 650 conversations en un mois en parcourant environ 16 800 pages d'aide et de contenu du site avant de répondre.
Si vous préférez travailler depuis le code, le CLI eesel vous permet, à vous ou à un agent de code comme Claude Code ou Codex, de piloter le même coéquipier depuis un terminal : charger des articles d'aide et des macros approuvés, ajuster les instructions de l'agent, et lui poser des questions de test avant que quoi que ce soit ne passe en production. Connecter le helpdesk lui-même nécessite toujours l'approbation d'un administrateur, et les connaissances chargées sont testées avant de compter comme prêtes.
C'est la même idée qu'un CLI d'agent IA, appliquée à un coéquipier de support. Un serveur MCP est l'autre voie courante. Si vous hésitez à câbler cela vous-même sur Sol ou Astra, construire contre acheter expose ce que la facture du modèle laisse de côté.
Essayez eesel
Remplacer Astra par Sol réduit votre facture de tokens. Cela n'écrit pas vos règles d'escalade, n'ancre pas les réponses dans votre centre d'aide, et ne teste pas l'agent sur les tickets du mois dernier. Le coéquipier IA d'eesel pour le helpdesk se connecte à Zendesk, fonctionne de la même façon avec Freshdesk et le reste de votre stack, apprend de vos tickets passés, et vous montre comment il y aurait répondu avant de passer en production.

Essayez eesel gratuitement sur une partie de votre file, ou voyez les offres et tarifs.