Les 9 meilleures alternatives à Meta Muse Wonder en 2026, par usage et par prix

Kira

Katelin Teen
Dernière modification October 14, 2026
Pourquoi regarder au-delà de Muse Wonder
Je commence par ce que Meta a réussi, car il y a beaucoup à dire. Muse Wonder est la première famille de modèles de pointe de Meta Superintelligence Labs, sortie le 12 octobre, et la variante la plus grande, Wonder Full, a terminé deuxième de l'index Artificial Analysis le jour du lancement. Le modèle de l'API a une fenêtre de contexte de 1 048 576 tokens, accepte le texte, l'image, la vidéo, l'audio et le PDF, et vient avec une grille tarifaire claire : pas de surcoût pour le long contexte et 3 000 requêtes par minute dès le premier jour. Le test de Muse Wonder de mon collègue couvre tout cela en détail.
Les raisons de regarder ailleurs sont précises, et toutes les trois sont vérifiables :
- Le modèle que vous pouvez acheter n'est pas celui du graphique. Le tableau de benchmarks de Meta montre Wonder Full gagnant 6 lignes sur 14. Le Wonder standard, le seul sur l'API, en gagne 1 (MemoryBench).
- Il coûte le prix de la pointe. Meta cassait les prix. À
$4/$20, Wonder égale désormais Opus 5.5 au centime près et coûte deux fois plus que GPT-6.1 Sol. - C'est une préversion. La documentation des modèles l'étiquette en preview, le rapport de sécurité est « bientôt disponible », et un testeur précoce a signalé des problèmes de fiabilité de l'API.
"It's ok, intelligent, almost SOTA, but way too expensive [0], and some issues with API failing sometimes at the moment."

Je construis des fonctionnalités et des agents IA chez eesel, et le modèle sous-jacent est la partie de la stack d'eesel dont je m'attends à ce qu'elle change le plus souvent. Ce n'est pas une intuition. Lors d'un appel commercial, une équipe de support matériel B2B traitant environ 250 tickets par mois a dit à l'équipe commerciale d'eesel qu'elle devait remplacer son outil de support IA. Sa raison n'avait rien à voir avec le prix : le fournisseur avait changé de modèle économique, et l'équipe était forcée de migrer. Un modèle en preview est exactement l'endroit où ce genre de changement arrive sans grand préavis, donc je traiterais Wonder comme une option à tester, pas comme une plateforme à câbler en dur.
Même prix, score différent
C'est le graphique à retenir de cet article. Sur le prix de sortie par million de tokens, Muse Wonder est au même niveau qu'Opus 5.5. Sur l'index d'Artificial Analysis, comme le montre le graphique de lancement de Meta lui-même, il est six points en dessous.
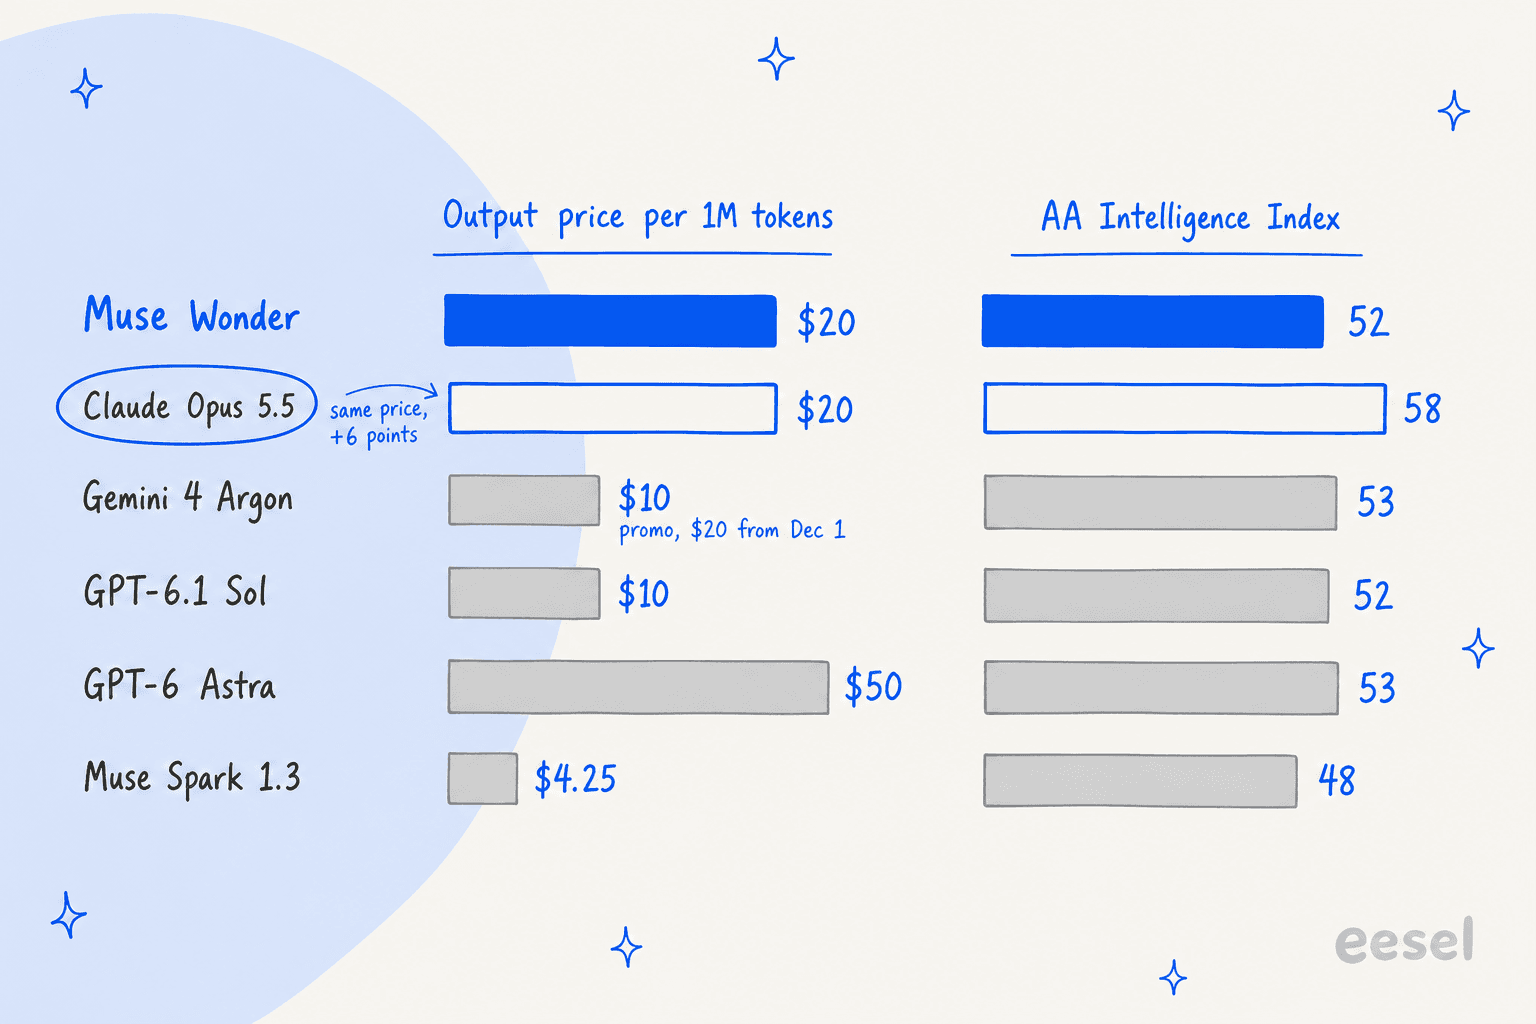
En lisant les lignes, trois choses ressortent. Opus 5.5, c'est la même facture pour 6 points de plus. GPT-6.1 Sol, c'est le même score pour la moitié du prix de sortie. Et GPT-6 Astra facture 2,5 fois le prix de Wonder pour un point de plus. Les benchmarks ne font pas tout (le résultat de Wonder sur MemoryBench est réel, et Meta l'a conçu pour les longues exécutions d'agents), mais à prix identique, la charge de la preuve repose sur le modèle au score le plus bas.
Un commentateur de HN a résumé sans détour la comparaison avec Sol :
"sol 6.1 is 50% cheaper than this. sol pricing$2.00 output $10.00 dont know why the f people downvote for saying sol pricing."
Les alternatives à Muse Wonder en un coup d'œil
Les prix sont les tarifs API standard par million de tokens tirés de la page de tarifs de chaque fournisseur, vérifiés le 14 octobre 2026. Les scores de l'index viennent du graphique de lancement de Meta (12 octobre) quand le modèle y figure, et des pages de modèles d'Artificial Analysis sinon.
| Modèle | Idéal pour | Entrée / cache / sortie par 1M | AA Intelligence Index | Contexte / sortie max. | Poids ouverts | Entraîne sur vos données par défaut | Offre gratuite | Où l'obtenir |
|---|---|---|---|---|---|---|---|---|
| Muse Wonder (référence) | Longues exécutions d'agents, mémoire | $4 / $0.20 / $20 | 52 | 1M / non publié | Non | Non (API) | Non | Meta Model API, OpenRouter, Muse Code |
| Claude Opus 5.5 | Même facture, meilleur score | $4 / $0.20 / $20 | 58 | 1M / 128K | Non | Non | Non | Claude API, Bedrock, Vertex, Foundry |
| Gemini 4 Argon | Longs documents, moins cher jusqu'en déc. | $2 / $0.10 / $10, puis $4 / $0.20 / $20 | 53 | 1M unifié / jusqu'à 1M | Non | Non (payant) | Non | Gemini API, AI Studio |
| Muse Wonder Full | Le meilleur de Meta, code dans Muse Code | $50 ou $200 par mois | 56 | 1M / non publié | Non | Oui (mode Contributor) | Non | Muse Code Power ou Max uniquement |
| GPT-6.1 Sol | Score de Wonder à moitié prix | $2 / $0.10 / $10 | 52 | 1.05M / 128K | Non | Non | Non | OpenAI API, ChatGPT Work, Codex |
| GPT-6 Astra | Palier supérieur d'OpenAI, Ultrafast | $10 / $1 / $50 | 53 | 1.05M / 128K | Non | Non | Non | OpenAI API, forfaits ChatGPT payants |
| Claude Sonnet 5.5 | Code à moitié prix d'Opus | $2 / $0.10 / $10 | 56 (max), 47 (high) | 1M / 128K | Non | Non | Non | Claude API, clouds |
| Muse Spark 1.3 | Gros volume, rester chez Meta | $1.25 / $0.15 / $4.25 | 48 | 1M / non publié | Non (promis) | Seulement sur la variante contributor | Non | Meta Model API, Muse Code |
| Gemini 3.8 Flash | Traitement par lots bon marché, offre gratuite | $0.75 / $0.075 / $3.75 | 41 (high) | 1M / 64K | Non | Offre gratuite uniquement | Oui | Gemini API, AI Studio |
| DeepSeek V4.1 Flash | Poids ouverts, facture la plus basse | $0.15 / $0.003 / $0.60 hors pointe | 39.5 (max) | 1M / 384K | Oui, MIT | Les conditions ne le précisent pas | Non | DeepSeek API, auto-hébergement |
Vous ne savez pas quelle ligne est la vôtre ? Choisissez la raison la plus proche de ce qui vous attirait chez Wonder.
Pourquoi vouliez-vous Muse Wonder ?
Choisissez la raison la plus proche de la vôtre.
Comment j'ai choisi ces alternatives
Je suis parti de la présélection qu'un assistant IA donne à un acheteur qui demande avec quoi comparer Wonder, puis j'ai vérifié chaque nom auprès de sources primaires. Cette présélection reposait sur GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, Wonder Full et un Gemini Flash bon marché. Deux de ces choix demandaient une correction. Gemini 4 Argon venait de sortir, et le Flash suggéré, Gemini 3.5 Flash, est obsolète avec des requêtes désormais redirigées vers 3.6 Flash ; j'ai donc retenu le 3.8 Flash actuel.
J'ai ensuite ajouté les modèles qu'un acheteur de Wonder pèse réellement sur le prix : GPT-6.1 Sol et Claude Sonnet 5.5 à $2/$10, le Muse Spark 1.3 de Meta et une option à poids ouverts. Chaque prix ci-dessous vient de la page de tarifs du fournisseur au 14 octobre. Chaque benchmark vient soit du fournisseur, soit d'Artificial Analysis, et je précise lequel.
Ce que je n'ai pas fait, c'est passer neuf modèles dans mon propre banc de test pour cet article. Wonder a trois jours, et une comparaison équitable demande vos tâches, pas les miennes. La dernière section vous donne donc le test à cinq tâches que je lancerais, et chaque entrée ci-dessous dit laquelle de ces tâches elle devrait gagner.
1. Claude Opus 5.5 : la même facture pour un meilleur score
Idéal pour : les équipes qui voulaient un modèle de pointe à $4/$20 et veulent celui qui score le plus haut à ce prix.
Claude Opus 5.5 est l'échange le plus direct de cette liste, car rien ne change dans votre budget. La documentation tarifaire d'Anthropic indique $4 en entrée, $20 en sortie et $0.20 pour un succès de cache, les trois mêmes chiffres que Wonder. La différence, c'est le score : 58 à l'index d'Artificial Analysis contre 52 pour Wonder, et la première place de cet index au lancement de Wonder.
Le tableau de Meta plaide lui-même pour Opus. Opus 5.5 gagne 6 des 14 lignes, dont l'usage d'ordinateur (OSWorld 81.8 contre 72.6 pour Wonder), le code en terminal (59.6 contre 52.0) et la programmation à partir de zéro. Cette dernière est le plus grand écart de tout le tableau : ProgramBench 70.5 pour Opus 5.5, 50.0 pour le Wonder standard. Là où Wonder tient bon, c'est la mémoire et le code au long cours : il bat Opus 5.5 sur DeepSWE (78.8 contre 74.2) et SWE-Marathon (53.1 contre 46.3).
Les atouts pratiques comptent aussi. Opus 5.5 tourne sur l'API Claude ainsi que sur Bedrock, Vertex et Foundry, Batch réduit le prix de moitié à $2/$10, et l'effort par défaut d'Anthropic est désormais moyen, qui score 51 pour $1.34 par tâche chez Artificial Analysis. Le test d'Opus 5.5 détaille les niveaux d'effort.
Avantages : prix identique à Wonder ; 6 points de plus à l'index ; en tête du tableau de Meta pour l'usage d'ordinateur, le terminal et le code à partir de zéro ; disponible sur trois grands clouds.
Inconvénients : forcer tool_choice (any ou un outil nommé) renvoie une erreur, ce qui compte si votre agent s'y appuie ; l'effort maximal coûte environ $5.98 par tâche chez Artificial Analysis ; pas de poids ouverts.
Tarifs : $4 en entrée, $0.20 succès de cache, $20 en sortie par 1M de tokens ; écriture de cache 5 minutes $5, 1 heure $8 ; Batch $2/$10 ; mode Fast $8/$40. Tableau complet dans les tarifs d'Opus 5.5.
Mon avis : si vous alliez mettre Wonder en production à $4/$20, mettez d'abord Opus 5.5 et faites en sorte que Wonder le batte sur vos propres tâches. À prix égal, le modèle au meilleur score devient le choix par défaut.
2. Gemini 4 Argon : moitié prix de Wonder jusqu'en décembre
Idéal pour : les longs documents, les longues exécutions d'agents et les équipes qui veulent le taux de réponses inventées le plus bas du groupe de pointe.
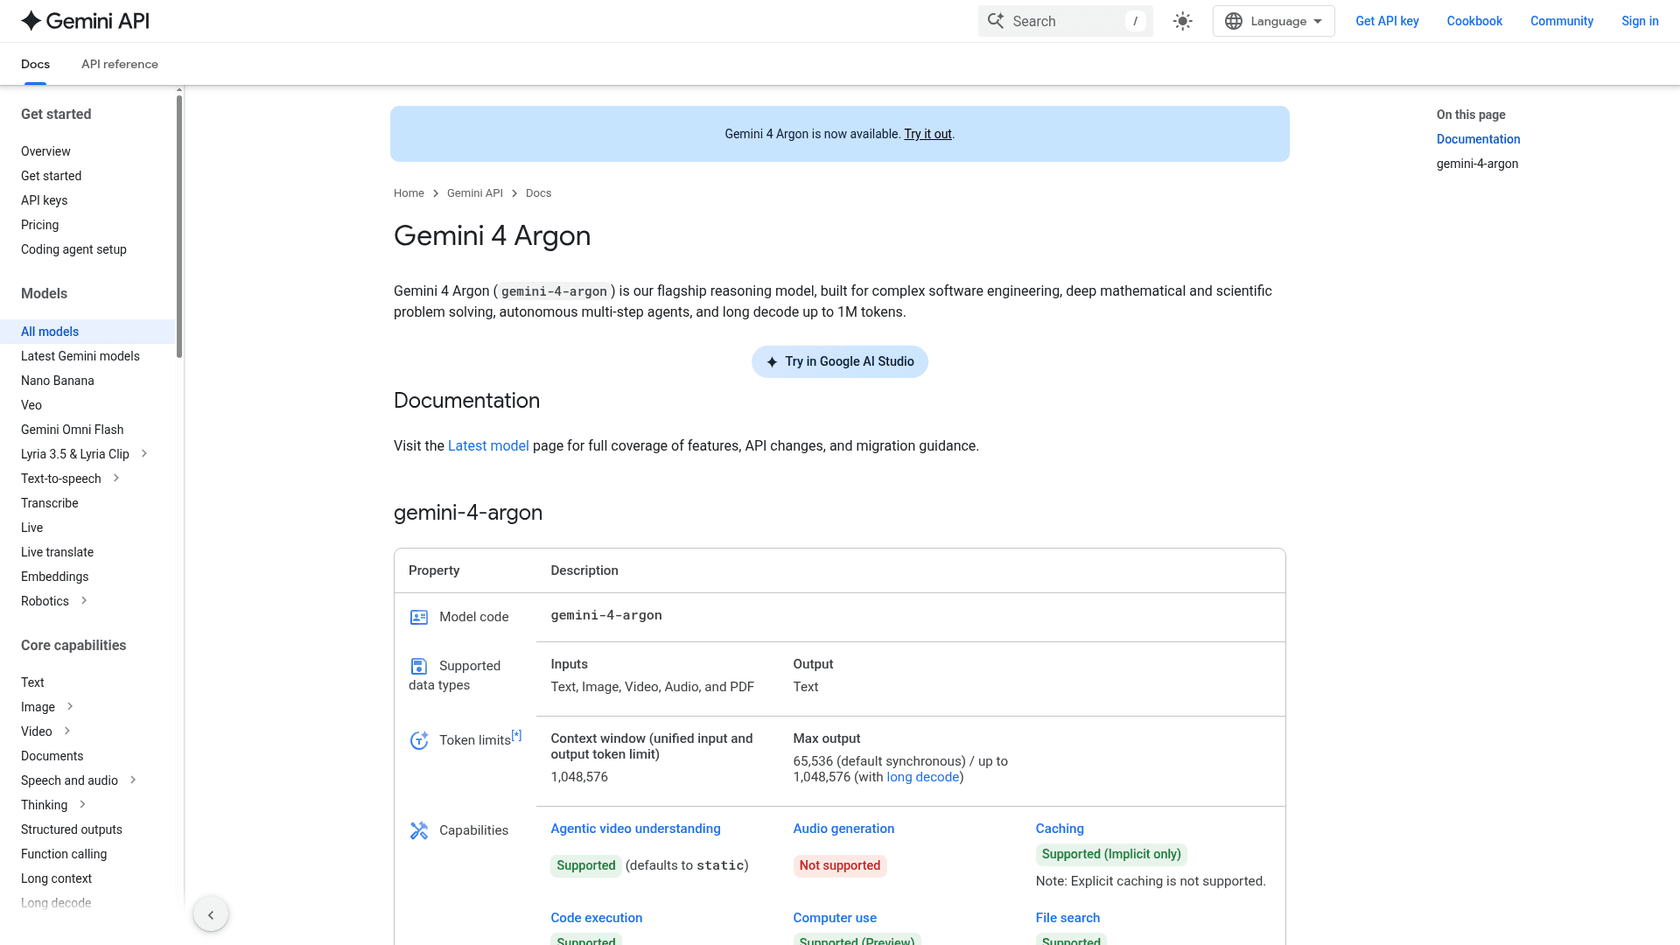
Le jour du lancement de Wonder, un commentateur de HN a félicité Wonder d'être "available unlike Gemini 4 Argon". Ça a duré un jour. Le changelog de Google montre que gemini-4-argon est devenu généralement disponible sur l'API Gemini le 13 octobre, et il est maintenant aussi dans AI Studio. Le test de Gemini 4 Argon a été écrit quand il n'était encore que sur invitation ; les faits ci-dessous viennent de la documentation en ligne de Google.
Le prix est la partie intéressante. La page de tarifs de Google indique $2 en entrée, $0.10 en cache et $10 en sortie jusqu'au 30 novembre, puis $4, $0.20 et $20 à partir du 1er décembre, ce qui est exactement la grille de Muse Wonder. Pendant environ sept semaines, vous avez donc un modèle qui score 53 à l'index (un point au-dessus de Wonder) à moitié prix, et ensuite au même prix.
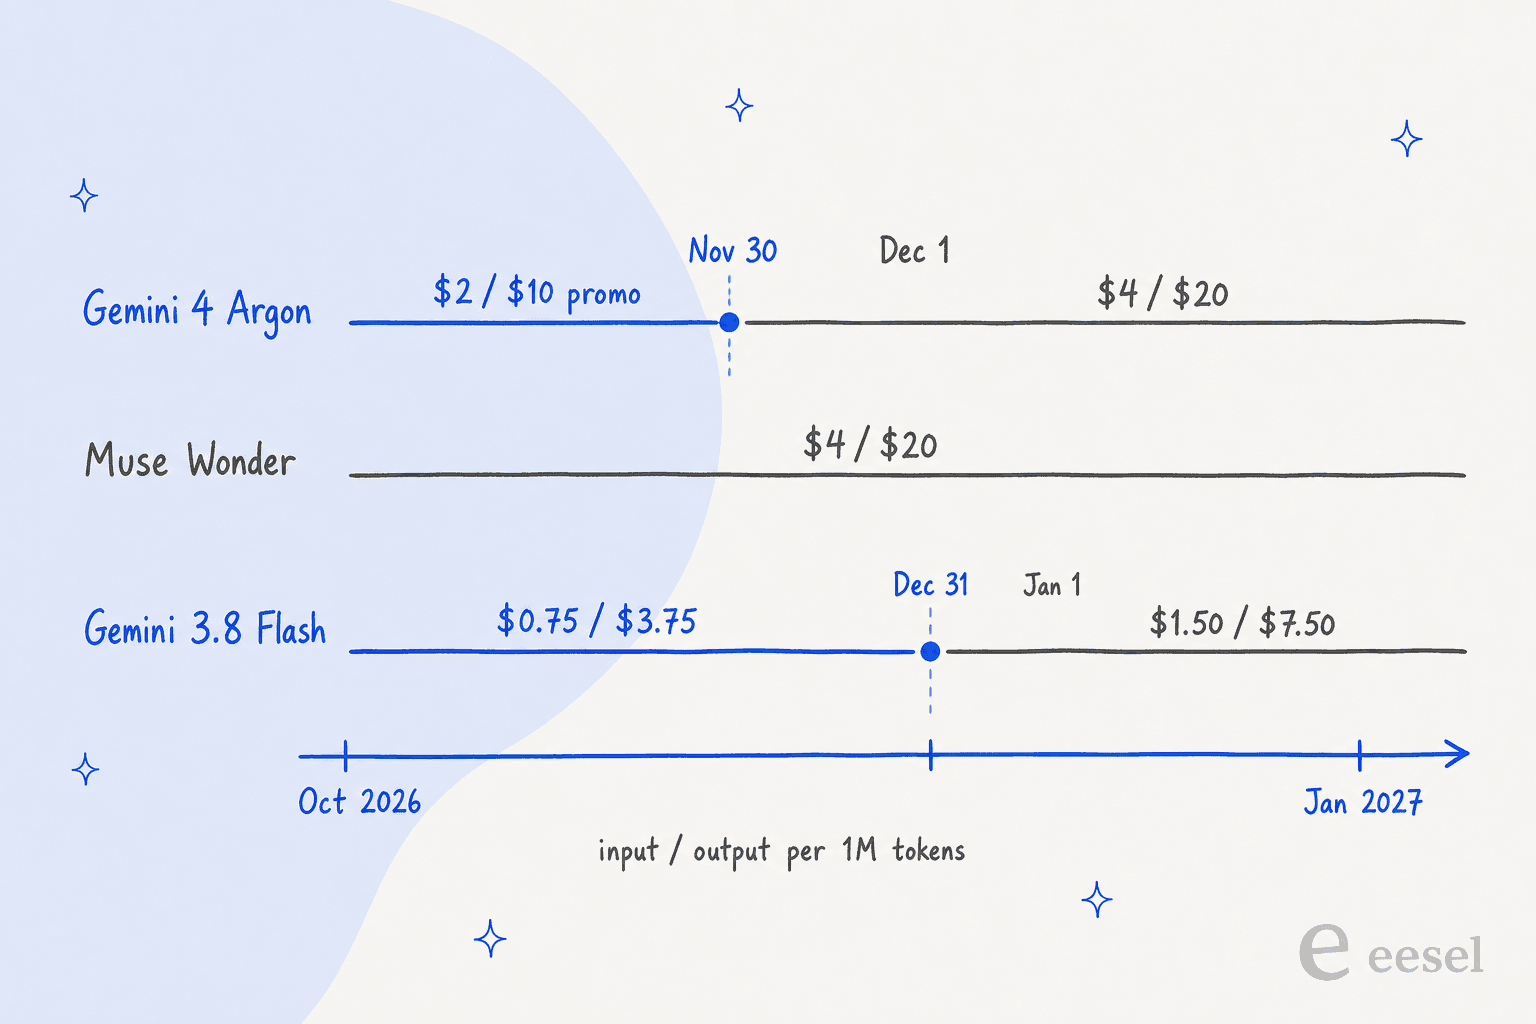
Ce qu'Argon fait le mieux, c'est le travail long. La page du modèle indique une fenêtre unifiée de 1 048 576 tokens, 65 536 tokens de sortie par défaut et jusqu'à 1 048 576 avec décodage long, plus l'usage d'ordinateur en preview, l'exécution de code, la recherche de fichiers et l'ancrage par recherche. Chez Artificial Analysis, son taux d'hallucination est de 15%, le plus bas de tous les modèles de pointe que j'ai vérifiés. Le tableau de benchmarks de Google le montre en tête sur les tâches de finance, de droit et de flux métier, même s'il s'agit des exécutions de Google, pas des versions AA du tableau de Meta.
Avantages : moitié prix de Wonder jusqu'au 30 novembre ; un point de plus à l'index ; taux d'hallucination le plus bas du groupe de pointe ; décodage long jusqu'à 1M de tokens de sortie ; Batch et Flex à moitié prix.
Inconvénients : la promotion se termine le 1er décembre ; pas de cache de contexte explicite (implicite seulement) ; pas d'offre gratuite ; il écrit beaucoup, environ $1.99 par tâche chez Artificial Analysis au prix promo.
Tarifs : $2 / $0.10 / $10 jusqu'au 30 novembre, puis $4 / $0.20 / $20 ; Batch et Flex $1 / $5 (puis $2 / $10) ; Priority $3.60 / $18. Voir les tarifs de Gemini 4 Argon.
Mon avis : si les longs documents et la précision sont la raison pour laquelle vous vouliez Wonder, testez Argon maintenant, tant qu'il est bon marché. Prévoyez simplement le prix du 1er décembre, car ensuite c'est un duel direct à $4/$20 avec Wonder et Opus 5.5.
3. Muse Wonder Full : la montée en gamme dans la même famille
Idéal pour : les développeurs individuels et les petites équipes sur de longs projets de code, de rédaction juridique ou de recherche financière dans l'agent de code de Meta.
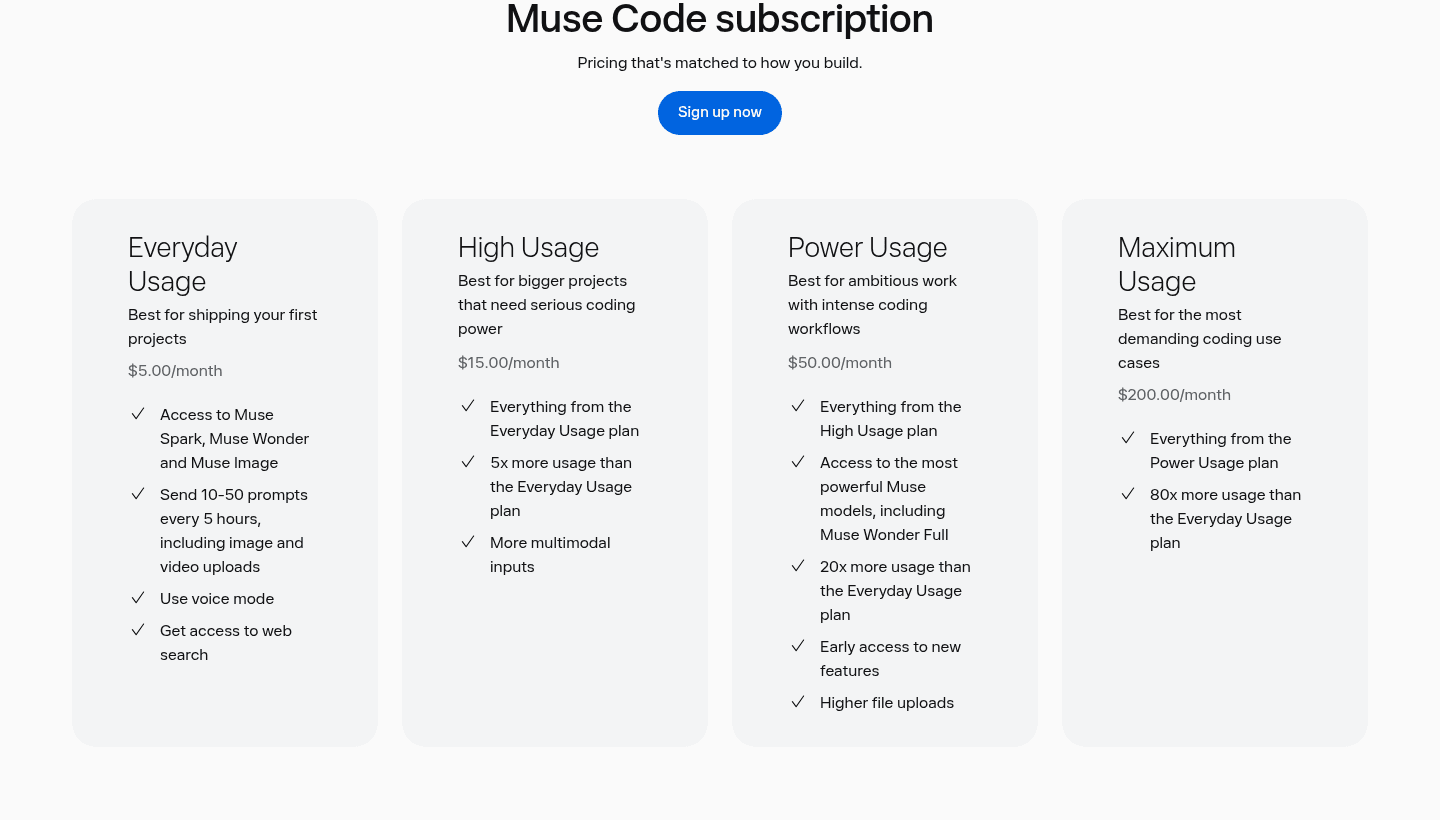
Si Wonder vous a plu grâce au graphique de lancement de Meta, Wonder Full est le modèle qui l'a mérité. Il score 56 à l'index, deuxième derrière Opus 5.5 au lancement, et gagne 6 des 14 lignes de Meta : le composite interne, le juridique (13.1 contre 4.2 pour Opus 5.5), la finance, les flux métier, DeepSWE et SWE-Marathon (57.5 contre 46.3). Aucun autre modèle de cet article ne mène sur autant de tâches longues et riches en documents.
Le hic, c'est l'accès. Full n'est disponible que sur le forfait Power Usage de Muse Code à $50 par mois et sur Maximum Usage à $200. Il n'a pas de prix au token, et la documentation des modèles de Meta indique que régler l'effort sur max pour le Wonder standard ne le sélectionne pas. Une clé d'abonnement ne fonctionne en outre que dans la CLI de Muse Code : vous ne pouvez donc pas y faire passer le trafic de votre produit.
"Super interesting that they're not even making Wonder Full available outside of their own coding harness, and thus not providing an API price to use in comparisons."
Deux autres choses à savoir avant de payer. La documentation des abonnements indique que les forfaits sont par défaut en mode Contributor, qui permet à Meta d'entraîner ses modèles sur vos prompts, votre code et vos fichiers tant que vous ne le désactivez pas. Et les forfaits sont réservés aux plus de 18 ans, sans remboursement et avec une disponibilité variable selon les régions ; un commentateur a rapporté que l'abonnement est pour l'instant réservé à l'Amérique du Nord.
Avantages : le modèle le plus fort de Meta ; en tête sur le juridique, la finance, les flux de travail et le code très long ; prix mensuel fixe au lieu d'une facturation au token.
Inconvénients : abonnement uniquement, dans Muse Code uniquement ; mode Contributor activé par défaut ; limité par région ; impossible de s'en servir pour alimenter une application.
Tarifs : Power Usage $50/mois (20x l'usage Everyday) ou Maximum Usage $200/mois (80x). Les forfaits moins chers Everyday ($5) et High ($15) n'incluent que le Wonder standard. Plus de détails dans les tarifs de Muse Code.
Mon avis : si vous vouliez Wonder pour votre propre code, oubliez l'API et payez $50 pour Full, avec le mode Contributor désactivé dès le premier jour. Si vous vouliez Wonder dans un produit, Full n'est pas une option, regardez donc les points 1 et 2. L'article sur les alternatives à Muse Code couvre les autres agents de code au même budget.
4. GPT-6.1 Sol : le score de Wonder à moitié prix
Idéal pour : les applications en production où le niveau de qualité de Wonder suffit et où la facture compte.
GPT-6.1 Sol score 52 sur le graphique de lancement de Meta, comme Wonder. La page de tarifs d'OpenAI l'affiche à $2 en entrée, $0.10 en cache et $10 en sortie, exactement la moitié de Wonder sur chaque ligne. Pour une équipe produit, c'est l'échange le plus net de cette liste : même niveau de benchmark, moitié de facture.
Il est aussi efficace par tâche. Artificial Analysis a mesuré 6.1 Sol à effort maximal à environ $0.72 par tâche, et l'effort xhigh bat max sur son index d'agents de code. Il a une fenêtre de contexte de 1 050 000 tokens, 128 000 tokens de sortie maximum, et une résidence des données aux États-Unis et dans l'UE. L'affirmation d'OpenAI lors de la DevDay était qu'il égale GPT-6 Astra sur DeepSWE pour environ un cinquième du coût.
Là où il diffère de Wonder, c'est dans la forme de l'API. 6.1 Sol n'a pas d'effort none ni minimal, et Chat Completions ne fonctionne que sans appels d'outils ; les agents devraient donc utiliser la Responses API. Les prompts de plus de 272K tokens en entrée sont facturés à un tarif plus élevé.
Avantages : même score d'index que Wonder à moitié prix ; peu coûteux par tâche ; bons résultats sur les agents de code ; résidence des données dans l'UE.
Inconvénients : pas d'effort none ; les appels d'outils exigent la Responses API ; les longs prompts au-delà de 272K coûtent plus ; pas de poids ouverts.
Tarifs : $2 / $0.10 / $10 par 1M de tokens, écriture de cache $2.50 ; au-delà de 272K en entrée $4 / $0.20 / $15 ; Batch et Flex $1 / $5. Détail dans les tarifs de GPT-6.1 Sol.
Mon avis : si vous comptiez utiliser Wonder comme un cheval de trait fiable plutôt que comme une vitrine, c'est celui-ci. Passez vos tâches dans les deux, et à moins que Wonder ne gagne nettement, la moitié du prix l'emporte.
5. GPT-6 Astra : le palier supérieur d'OpenAI, à 2,5 fois le prix de Wonder
Idéal pour : les équipes déjà chez OpenAI qui ont besoin de son meilleur modèle ou de son palier de vitesse Ultrafast.
GPT-6 Astra était le premier nom de la présélection de l'assistant IA, et c'est un modèle solide : une fenêtre de 1 050 000 tokens, shell hébergé, apply-patch, usage d'ordinateur et MCP intégrés, et le meilleur score sur la ligne GDP.pdf de travail professionnel de Meta (34.2). C'est aussi le premier modèle qu'OpenAI classe « Critical » en cybersécurité, avec un usage cyber avancé restreint.
Mais les chiffres ne plaident pas en sa faveur comme remplaçant de Wonder. Il score 53 sur le graphique de Meta, un point au-dessus de Wonder, pour $10 en entrée et $50 en sortie par million de tokens, 2,5 fois le prix de Wonder. Wonder Full le bat sur 11 des 14 lignes du tableau de Meta. Chez Artificial Analysis, Astra à effort maximal coûte environ $3.26 par tâche.
La seule chose que seul Astra propose actuellement, c'est Ultrafast. La page de tarifs d'OpenAI liste des tarifs Ultrafast pour Astra seul, à $60 en entrée et $300 en sortie par million de tokens. Si votre produit a besoin de ce palier de vitesse ce mois-ci, c'est la seule option de la famille GPT-6.
Avantages : le modèle le plus fort d'OpenAI ; outils d'agent intégrés ; meilleur score GDP.pdf du tableau de Meta ; la seule option Ultrafast.
Inconvénients : 2,5 fois le prix de Wonder pour un point d'index de plus ; les longs prompts au-delà de 272K sont facturés $20 / $75 ; Wonder Full le surpasse sur la plupart des lignes de Meta.
Tarifs : $10 / $1 / $50 par 1M de tokens ; Batch et Flex $5 / $25 ; Fast $20 / $100 ; Ultrafast $60 / $300. Voir les tarifs de GPT-6 Astra.
Mon avis : je ne passerais pas de Wonder à Astra pour la seule qualité. Choisissez-le si vous standardisez sur OpenAI et avez besoin d'Ultrafast, ou si vos propres tests le montrent gagnant sur des documents professionnels.
6. Claude Sonnet 5.5 : la moitié d'Opus, proche en code
Idéal pour : les agents de code et les applications riches en outils qui veulent la qualité Anthropic à moitié prix d'Opus.
Claude Sonnet 5.5 coûte $2 en entrée et $10 en sortie, la moitié de Wonder, et la documentation tarifaire d'Anthropic affiche désormais son succès de cache à $0.10, la moitié des $0.20 de Wonder. Il score 56 chez Artificial Analysis à effort maximal, au-dessus du Wonder standard. Dans les chiffres de lancement d'Anthropic, il bat même Opus 5.5 sur Terminal-Bench 4.0 (70.6 contre 66.4).
La réserve, c'est l'effort. Ce 56 vient de l'effort maximal, où Artificial Analysis a mesuré environ $7.60 par tâche, plus qu'Opus 5.5. À effort élevé, il score 47 pour $1.08, et Anthropic dit elle-même que les économies apparaissent à effort faible et moyen. Mon test de Sonnet 5.5 l'a trouvé excellent en moyen et un piège en max.
Il est aussi arrivé avec des changements incompatibles : forcer tool_choice renvoie une erreur, thinking: disabled renvoie une erreur, et les blocs de réflexion sont liés au modèle, de sorte que l'historique de conversation doit rester en ajout seul.
Avantages : la moitié du prix au token de Wonder, avec un succès de cache moins cher ; bon code en terminal ; même fenêtre de 1M et 128K de sortie qu'Opus.
Inconvénients : l'effort maximal coûte plus cher par tâche qu'Opus 5.5 ; changements incompatibles de l'API depuis Sonnet 5 ; pas d'usage d'outil forcé.
Tarifs : $2 / $0.10 / $10 par 1M de tokens ; écriture de cache 5 minutes $2.50, 1 heure $4 ; Batch $1 / $5. Détail dans les tarifs de Sonnet 5.5.
Mon avis : un bon remplaçant de Wonder pour les agents de code si vous le gardez à effort faible ou moyen. Si vous vous surprenez à le monter à max, passez plutôt à Opus 5.5.
7. Muse Spark 1.3 : la réponse de Meta pour le volume
Idéal pour : le travail à gros volume et sensible à la latence, pour les équipes qui veulent rester sur l'API de Meta.
C'est l'alternative que Meta recommande elle-même. Sa documentation des modèles présente Wonder pour les tâches longues et complexes et oriente le travail à gros volume, sensible à la latence ou au coût vers Muse Spark. Muse Spark 1.3 coûte $1.25 en entrée, $0.15 en cache et $4.25 en sortie par million de tokens, moins d'un quart du prix de sortie de Wonder, et score 48 sur le graphique de Meta.
Les utilisateurs réguliers le jugent bien pour son prix :
"I've been a regular user of muse spark 1.3 ... and I can tell you one thing for sure that this model, muse-spark-1.3 in xhigh mode, is between sol-6-medium and high."
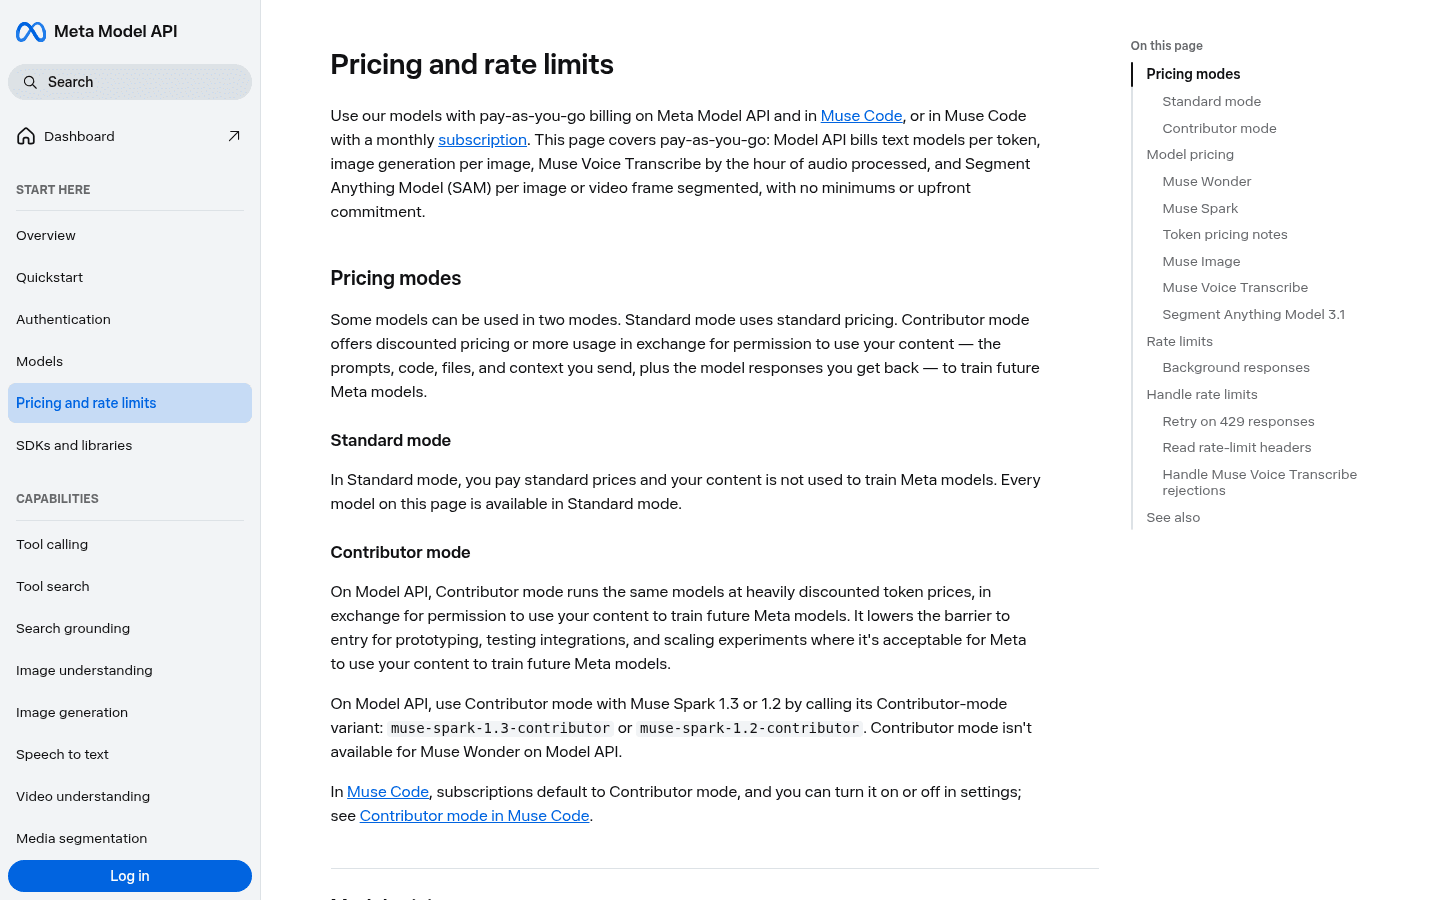
Spark a aussi quelque chose que Wonder n'a pas : une variante Contributor sur l'API. La page de tarifs de Meta explique que muse-spark-1.3-contributor fonctionne à des prix très réduits (environ $0.10/$0.20) en échange du droit pour Meta d'entraîner ses modèles sur votre contenu. Le mode Contributor n'est pas disponible pour Wonder sur l'API. C'est un bon marché pour des prototypes et un mauvais pour des données clients. Un dernier point : Spark 1.3 est verbeux, avec environ 120 millions de tokens de sortie pour terminer l'index d'Artificial Analysis contre une médiane de 72 millions.
Avantages : moins d'un quart du prix de sortie de Wonder ; même API, même fournisseur, facile à router entre les deux ; remise Contributor optionnelle pour le travail non sensible.
Inconvénients : 4 points sous Wonder à l'index ; verbeux, ce qui grignote les économies ; les poids ouverts promis par Meta pour Spark n'ont pas été publiés.
Tarifs : Standard $1.25 / $0.15 / $4.25 par 1M de tokens ; variante Contributor environ $0.10 / $0.20 avec entraînement sur vos données. Voir les tarifs de Muse Spark 1.3.
Mon avis : la bonne configuration chez Meta, c'est le routage, pas le choix : Spark pour l'essentiel des requêtes, Wonder pour les longues et difficiles. Si la majeure partie de votre trafic est simple, cela seul réduit nettement la facture.
8. Gemini 3.8 Flash : l'option bon marché avec offre gratuite
Idéal pour : les traitements par lots, les prototypes et les pipelines axés sur le coût où personne n'attend le premier token.
C'est la place « vitesse et coût » que l'assistant IA a remplie avec Gemini 3.5 Flash, que Google a depuis rendu obsolète. Le modèle actuel, Gemini 3.8 Flash, coûte $0.75 en entrée et $3.75 en sortie par million de tokens, environ un cinquième du prix de Wonder, et c'est le seul modèle de cette liste avec une offre gratuite. Google a aussi rendu 3.7 Flash obsolète le 8 octobre et redirige ses requêtes vers 3.8.
Il score 41 chez Artificial Analysis à effort élevé, bien en dessous de Wonder, pour environ $1.24 par tâche. Deux réserves. D'abord, le prix double à $1.50/$7.50 le 1er janvier 2027. Ensuite, Artificial Analysis a mesuré 13,30 secondes avant le premier token, ce qui le rend mal adapté à tout ce qu'une personne attend, comme un widget de chat.
Pour l'offre gratuite, la page de tarifs de Google dit que votre contenu sert à améliorer ses produits ; sur l'offre payante, non.
Avantages : environ un cinquième du prix de Wonder ; offre gratuite pour tester ; Batch et Flex à moitié prix ; fenêtre de 1M.
Inconvénients : très en dessous de Wonder à l'index ; premier token lent ; le prix double le 1er janvier ; l'offre gratuite entraîne sur vos données.
Tarifs : $0.75 / $0.075 / $3.75 par 1M de tokens jusqu'au 31 décembre, puis $1.50 / $0.15 / $7.50 ; Batch et Flex à -50 %. Voir les tarifs de Gemini 3.8 Flash.
Mon avis : bien pour le traitement par lots nocturne pour lequel vous alliez trop payer avec Wonder. Pas un remplaçant pour les tâches difficiles de Wonder, ni pour quoi que ce soit en direct.
9. DeepSeek V4.1 Flash : poids ouverts et la plus petite facture
Idéal pour : les équipes qui ont besoin de poids ouverts ou du coût par token le plus bas possible.
Muse Wonder n'a pas de poids ouverts, et Meta n'a toujours pas publié les poids qu'elle a promis pour Muse Spark. Si vous avez besoin d'un modèle que vous pouvez faire tourner vous-même, DeepSeek V4.1 Flash est l'option la plus solide ici : poids sous licence MIT sur Hugging Face, fenêtre de contexte de 1M et jusqu'à 384K tokens de sortie.
L'API hébergée est très bon marché. La page de tarifs de DeepSeek affiche deepseek-flash à $0.15 en entrée et $0.60 en sortie par million de tokens hors pointe, et $0.30/$1.20 aux heures de pointe (matins de semaine en UTC). C'est environ 3 % du prix de sortie de Wonder hors pointe. Artificial Analysis le note 39.5 à effort maximal pour environ $0.27 par tâche.
Les compromis sont réels. Son taux d'hallucination chez Artificial Analysis est de 96%, le plus haut que j'aie vu sur un modèle actuel, il faut donc un ancrage strict dans des sources. L'API hébergée traite les données en Chine, et les conditions payantes ne disent pas si vos données servent à l'entraînement. L'auto-hébergement règle la question des données mais demande un vrai matériel pour un modèle de 552B de paramètres.
Avantages : poids ouverts sous MIT ; le prix le plus bas de cette liste ; bons résultats d'usage d'outils pour son coût ; 384K de sortie max.
Inconvénients : 12,5 points sous Wonder à l'index ; taux d'hallucination très élevé ; inquiétudes sur les données avec l'API hébergée ; lourd à auto-héberger.
Tarifs : hors pointe $0.003 succès de cache, $0.15 en entrée, $0.60 en sortie par 1M de tokens ; aux heures de pointe, le double. Voir les tarifs de DeepSeek V4.1 Flash. Kimi K3 est l'autre option à poids ouverts, à $3/$15.
Mon avis : à choisir pour les poids ouverts ou le traitement en masse de texte non sensible. Tenez-le à l'écart de tout ce qui rend coûteuse une réponse fausse donnée avec assurance.
Comment tester votre présélection : les mêmes cinq tâches pour chaque finaliste
C'est la partie que les tableaux de benchmarks ne peuvent pas faire pour vous. Choisissez deux ou trois finalistes ci-dessus, puis faites passer les mêmes cinq tâches dans chacun, plus Wonder lui-même. Notez trois chiffres pour chaque exécution : réussite ou échec, coût et secondes.
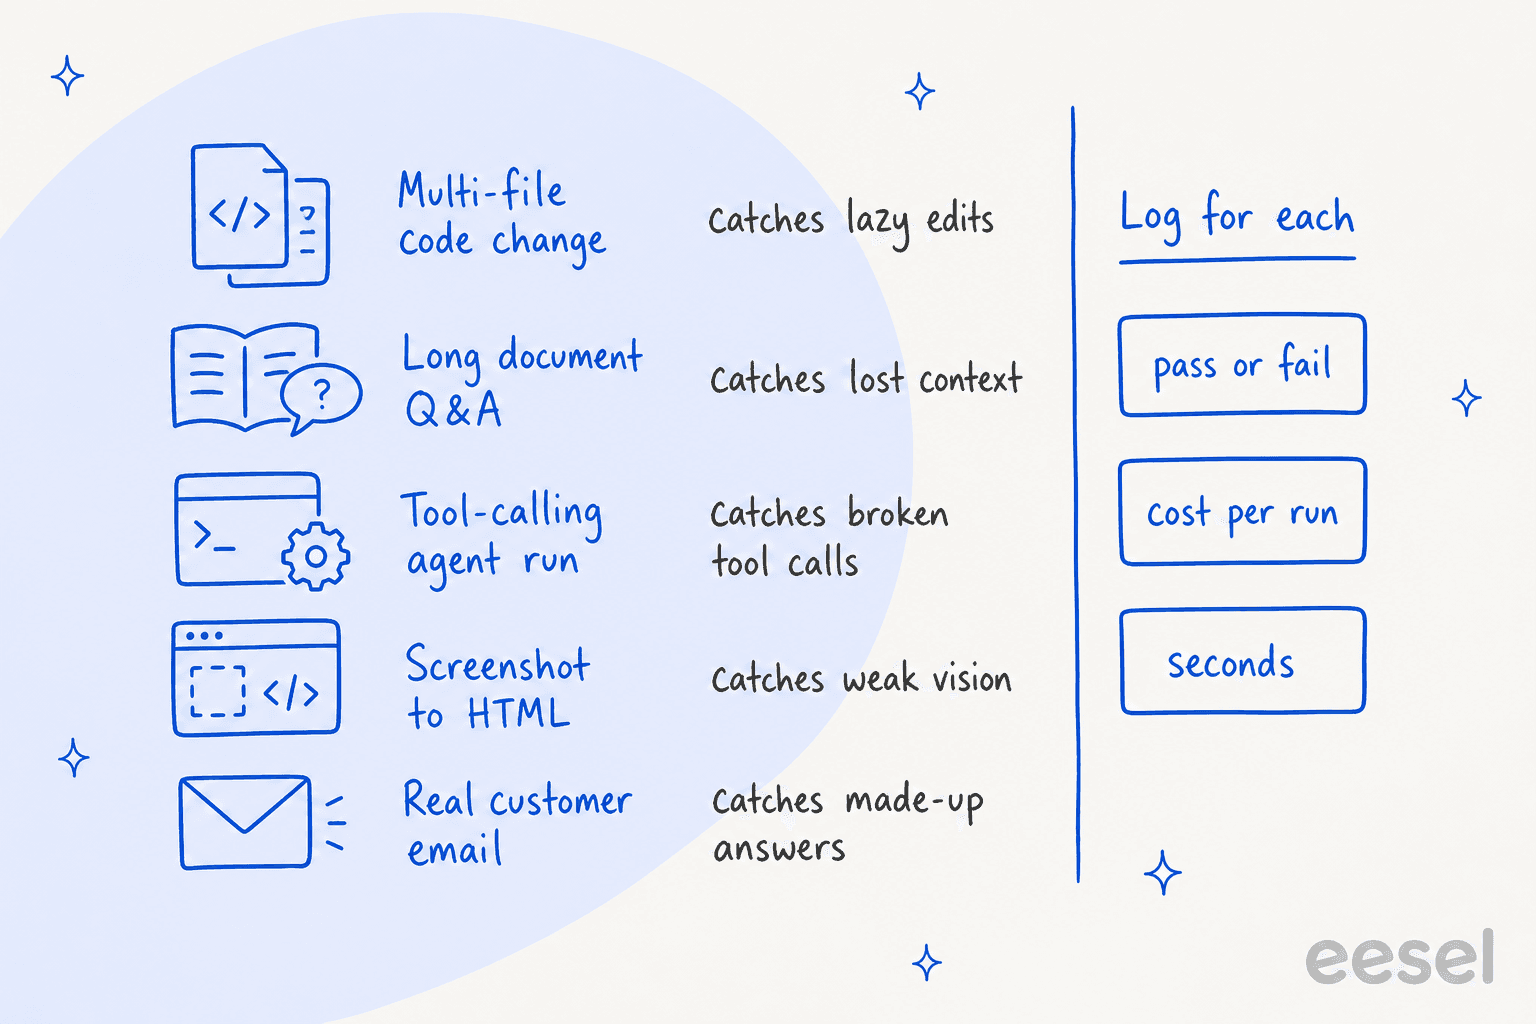
Chaque tâche est là pour détecter un échec précis. Et chaque finaliste a une tâche qu'il devrait gagner, si ses benchmarks sont honnêtes :
| Finaliste | Ce que je testerais en premier | Question principale |
|---|---|---|
| Claude Opus 5.5 | Capture d'écran vers HTML, modification de code sur plusieurs fichiers | Wonder le bat-il sur quoi que ce soit au même prix ? |
| Gemini 4 Argon | Questions sur un long document | Reste-t-il précis sur 500K tokens, et le prix de décembre aura-t-il encore du sens ? |
| Muse Wonder Full | Modification de code sur plusieurs fichiers dans Muse Code | Vaut-il $50 par mois de plus que le Wonder standard ? |
| GPT-6.1 Sol | Exécution d'un agent avec appels d'outils | La moitié du prix suffit-elle en qualité pour la production ? |
| Muse Spark 1.3 ou Gemini 3.8 Flash | Les 80 % les plus simples de votre trafic réel | Le modèle bon marché peut-il prendre la plupart des requêtes ? |
La tâche capture d'écran vers HTML est là pour une raison. Un développeur l'a lancée le jour du lancement et a trouvé le Wonder standard bien plus faible qu'Opus 5.5, plus proche de Sonnet ou de Haiku. C'est le genre d'écart qu'un test d'une heure trouve et qu'un tableau de benchmarks cache.
Gardez le test assez petit pour le relancer. Les prix et versions des modèles bougent toutes les quelques semaines (ceux d'Argon le 1er décembre, ceux de Flash le 1er janvier), et le moyen le moins cher de rester sur le bon modèle est de relancer les mêmes cinq tâches à chaque sortie.
Ce que changer de modèle signifie pour une équipe de support
Si vous êtes développeur, le test ci-dessus est votre prochaine étape. Si vous dirigez un support et que vous êtes arrivé ici par la couverture du lancement de Wonder, la réponse honnête est différente : le modèle est la plus petite partie d'un agent de support IA.
Quel que soit le modèle choisi, quelqu'un doit encore le connecter à votre helpdesk, garder ses réponses dans vos connaissances validées, décider quand il passe la main à un humain et prouver qu'il a raison avant qu'un client le voie. Ce sont les tâches sur lesquelles je passe le plus de temps, et aucune ne change quand le modèle change. Les notes sur Muse pour le support client et Muse pour Zendesk montrent combien de liant il faut avec un modèle brut.
C'est aussi pourquoi les chiffres d'hallucination de DeepSeek et de Gemini Flash ci-dessus comptent plus pour le support que pour le code. Une ligne de code fausse fait échouer un test. Une règle de remboursement fausse arrive à un client. Si vous le construisez de toute façon vous-même, le guide du meilleur modèle pour les tickets de support compare les modèles pour ce travail précis, et l'explication sur les agents IA vs chatbots couvre ce qu'apporte la couche agent.
Essayer eesel
Muse Wonder et chaque modèle de cette liste sont de l'infrastructure ; eesel est l'employé. eesel est une plateforme de coéquipiers IA où vous recrutez des coéquipiers prêts à travailler sur des tâches précises, et aujourd'hui il y a deux rôles : un coéquipier IA pour helpdesk et un rédacteur de blog IA. Chacun fonctionne sur des modèles de pointe, ce qui vous fait profiter des mises à niveau de modèles sans refaire un comparatif de modèles tous les mois.
Le coéquipier helpdesk se branche sur Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, et ne répond qu'à partir de ce que vous avez validé. Avant qu'il réponde à qui que ce soit, vous pouvez le faire tourner sur vos tickets historiques et voir ce qu'il aurait dit. Les forfaits sont un tarif mensuel fixe où un ticket vaut un crédit, à partir de $299 par mois pour 500 crédits, avec 100 crédits gratuits pour commencer, selon la page de tarifs d'eesel.

Puisque vous êtes probablement développeur si vous avez lu jusqu'ici, la CLI d'eesel mérite d'être connue. C'est un paquet npm (@eesel/cli) qui pilote le même coéquipier et le même espace de travail que le tableau de bord, depuis votre terminal, un script ou un agent de code comme Claude Code. eesel activity liste ce que le coéquipier a fait et vous laisse lire n'importe quelle exécution en détail, eesel approvals list montre les actions en attente d'un humain, et --dry-run affiche l'appel exact qu'un changement ferait sans l'envoyer. Chaque commande affiche du JSON, et votre espace de travail fonctionne aussi comme serveur MCP, de sorte qu'un agent peut le gérer comme vous. Le guide pour gérer des agents depuis le terminal vous accompagne pas à pas.
Si Wonder a attiré votre attention parce que vous voulez une IA qui traite votre file de support, sautez la recherche de modèle et essayez eesel sur vos propres tickets.
Comment obtenir Muse Wonder Full ?