

En bref
Muse Spark Open est le premier modèle Muse à poids ouverts de Meta, publié le 15 octobre 2026. Il compte 816B de paramètres dont 42B actifs par token, accepte texte, images, vidéo et audio, gère 1M de tokens de contexte, et partage son modèle de base avec Muse Spark 1.3, fermé. Vous pouvez le télécharger depuis Hugging Face ou le louer auprès de sept hébergeurs.
Voici ce que la couverture du lancement passe sous silence. Hébergé, il coûte 1,25 $ en entrée et 4,25 $ en sortie par million de tokens, exactement le tarif que Meta facture pour Muse Spark 1.3, fermé. Dans le tableau de Meta lui-même, il obtient 39 sur l'index Artificial Analysis, derrière GLM 5.3 (45) et Kimi K3 (44). Les poids ouverts n'achètent donc ici ni un modèle moins cher ni un modèle plus intelligent. Ils achètent du contrôle : où le modèle tourne, qui voit le trafic, et si vous pouvez l'affiner. Il affiche aussi le taux de jailbreak le plus bas de sa comparaison, et de loin.
Je construis les agents IA chez eesel, et cette question du contrôle est celle que j'entends le plus. Une équipe B2B de télématique sous Zendesk a un jour interrompu une démo pour demander si les tickets contenant des numéros de carte et des mots de passe resteraient dans leur propre environnement. Muse Spark Open est le premier modèle Muse pour lequel la réponse honnête peut être « oui, hébergez-le vous-même ». Mais un modèle auto-hébergé reste un modèle, pas un coéquipier. Si vous voulez un coéquipier IA de helpdesk qui connaît déjà votre centre d'aide, c'est la couche que vend eesel.
Ce que Meta a réellement publié le 15 octobre
Le blog de recherche de Meta qualifie Muse Spark Open de « the most capable US open-weight model to date », conçu pour le code et le travail agentique. L'article de l'équipe PyTorch ajoute le détail le plus important : il « shares the same base model as Muse Spark 1.3 », avec un post-entraînement de sécurité supplémentaire pour qu'il tienne « as a standalone model without system guardrails ». C'est un grand changement pour une entreprise qui a passé l'essentiel de 2026 à garder Muse Spark fermé.
La fiche du modèle sur Hugging Face donne les caractéristiques :
| Caractéristique | Muse Spark Open |
|---|---|
| Date de sortie | 15 octobre 2026 |
| Paramètres | 816B au total, 42B actifs par token |
| Architecture | Mélange d'experts, 256 experts, 8 actifs par token, 62 couches |
| Contexte | 1M de tokens à l'inférence |
| Entrée / sortie | Texte, image, vidéo, audio en entrée ; texte en sortie |
| Langues | Entraîné sur des données de plus de 100 langues |
| Effort de raisonnement | low, medium, high, xhigh (xhigh par défaut) |
| Poids | BF16 et NVFP4 |
| Licence | Muse Model License |
Le lancement a fait du bruit. Le fil Hacker News a atteint 914 points et 477 commentaires dès le premier jour, et l'article de recherche ML d'Apple sur son exécution sur des Mac Studio a recueilli 363 points de plus.
Comment fonctionnent 42B actifs sur 816B
C'est la partie que je trouve la plus intéressante, parce qu'elle explique à la fois le matériel et le prix. Muse Spark Open est un modèle à mélange d'experts. Chaque couche contient 256 petits réseaux d'experts, et un routeur en choisit 8 pour chaque token. Le modèle stocke donc 816B de paramètres, mais chaque token n'en traverse qu'environ 42B.
Cette répartition a deux conséquences que l'on confond souvent :
- La mémoire est dictée par les 816B. Chaque expert doit être en mémoire, car n'importe quel token peut avoir besoin de n'importe quel expert. C'est pourquoi les poids BF16 pèsent environ 1,6 To.
- La vitesse est dictée par les 42B. Chaque token ne lit que sa part, donc la génération se rapproche du rythme d'un modèle de 42B. Apple le dit simplement : les 1,2 To/s de bande passante du M5 Ultra sont « fast enough to read the small slice each token needs ».
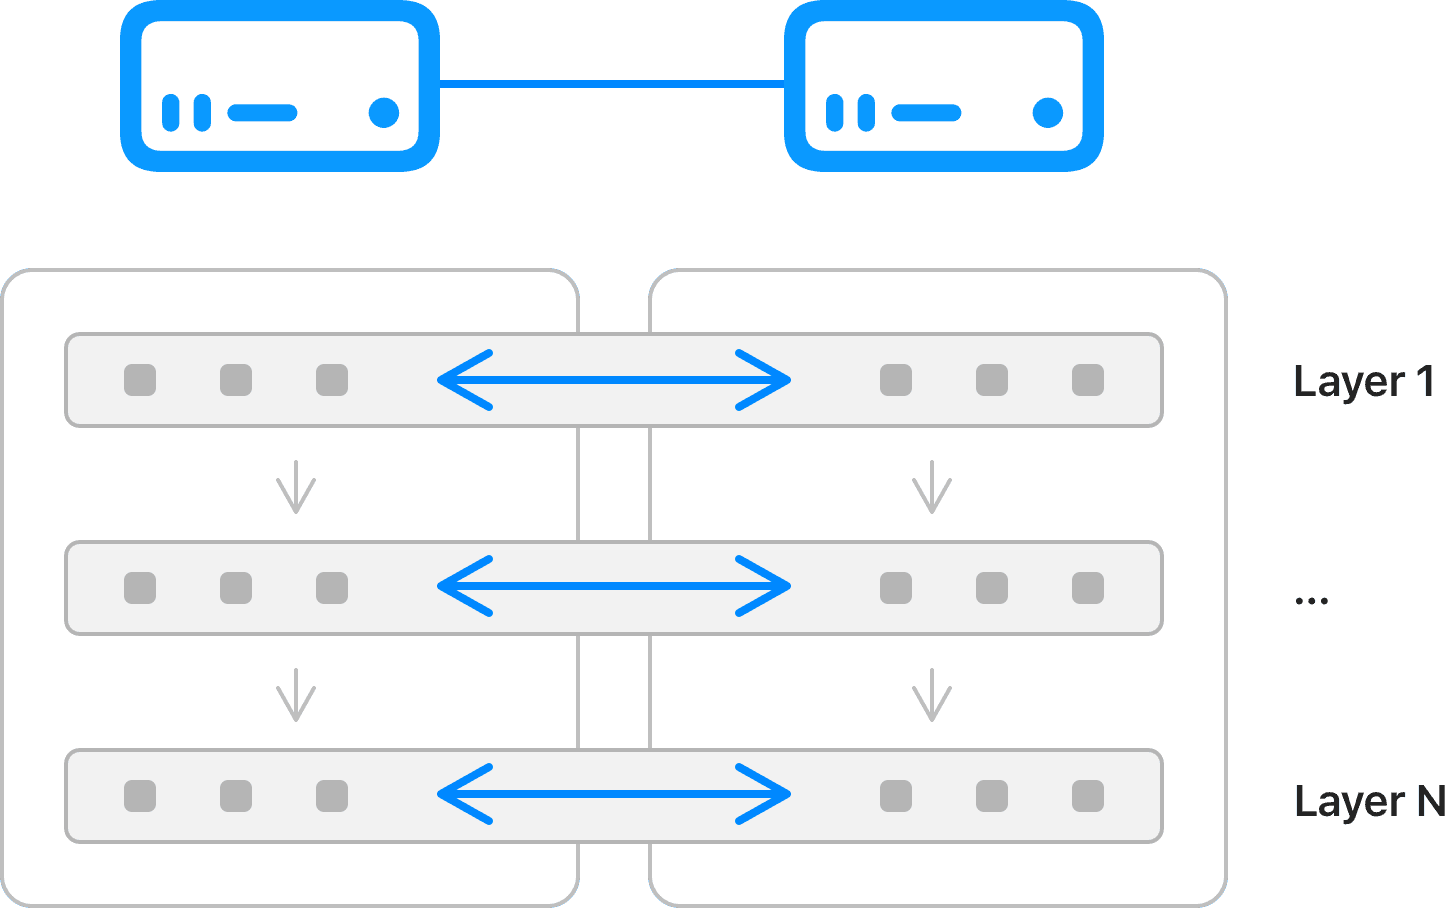
L'article développeur de Meta explique que le checkpoint NVFP4 ne quantifie que les experts, ce qui le ramène à environ 530 Go. C'est encore trop gros pour n'importe quel ordinateur de bureau, donc Meta et Apple le répartissent sur deux machines avec du parallélisme tensoriel : chaque Mac détient la moitié de chaque couche et fait la moitié des calculs pour chaque token.
La fiche du modèle décrit aussi un encodeur de perception distinct de 1,8B de paramètres pour les images et la vidéo. En pratique, vous n'avez pas à greffer un modèle de vision à côté. Un seul checkpoint lit captures d'écran, enregistrements et documents, ce qui compte si vous construisez des agents qui utilisent un ordinateur plutôt qu'une simple fenêtre de chat.
Tarifs de Muse Spark Open : la même grille que le modèle fermé
Les poids sont gratuits. Le chiffre intéressant, c'est le coût de location. Meta ne propose pas Muse Spark Open sur sa propre API ; sa page de tarifs ne liste que Muse Wonder et les modèles Spark fermés. À la place, sept partenaires l'hébergent, et ceux qui publient leurs tarifs sont tous arrivés à la même grille.
| Où | Entrée / 1M | Cache / 1M | Sortie / 1M | Notes |
|---|---|---|---|---|
| OpenRouter | 1,25 $ | 0,15 $ | 4,25 $ | Route entre Modal, Together, Nebius, Fireworks, Baseten ; 262 144 en sortie max |
| Fireworks AI | 1,25 $ | 0,15 $ | 4,25 $ | Entraînement LoRA serverless via API |
| Baseten | 1,25 $ | 0,15 $ | 4,25 $ | NVFP4 avec un drafter spéculatif |
| Groq | Non public | Non public | Non public | Préversion limitée, contexte de 131K |
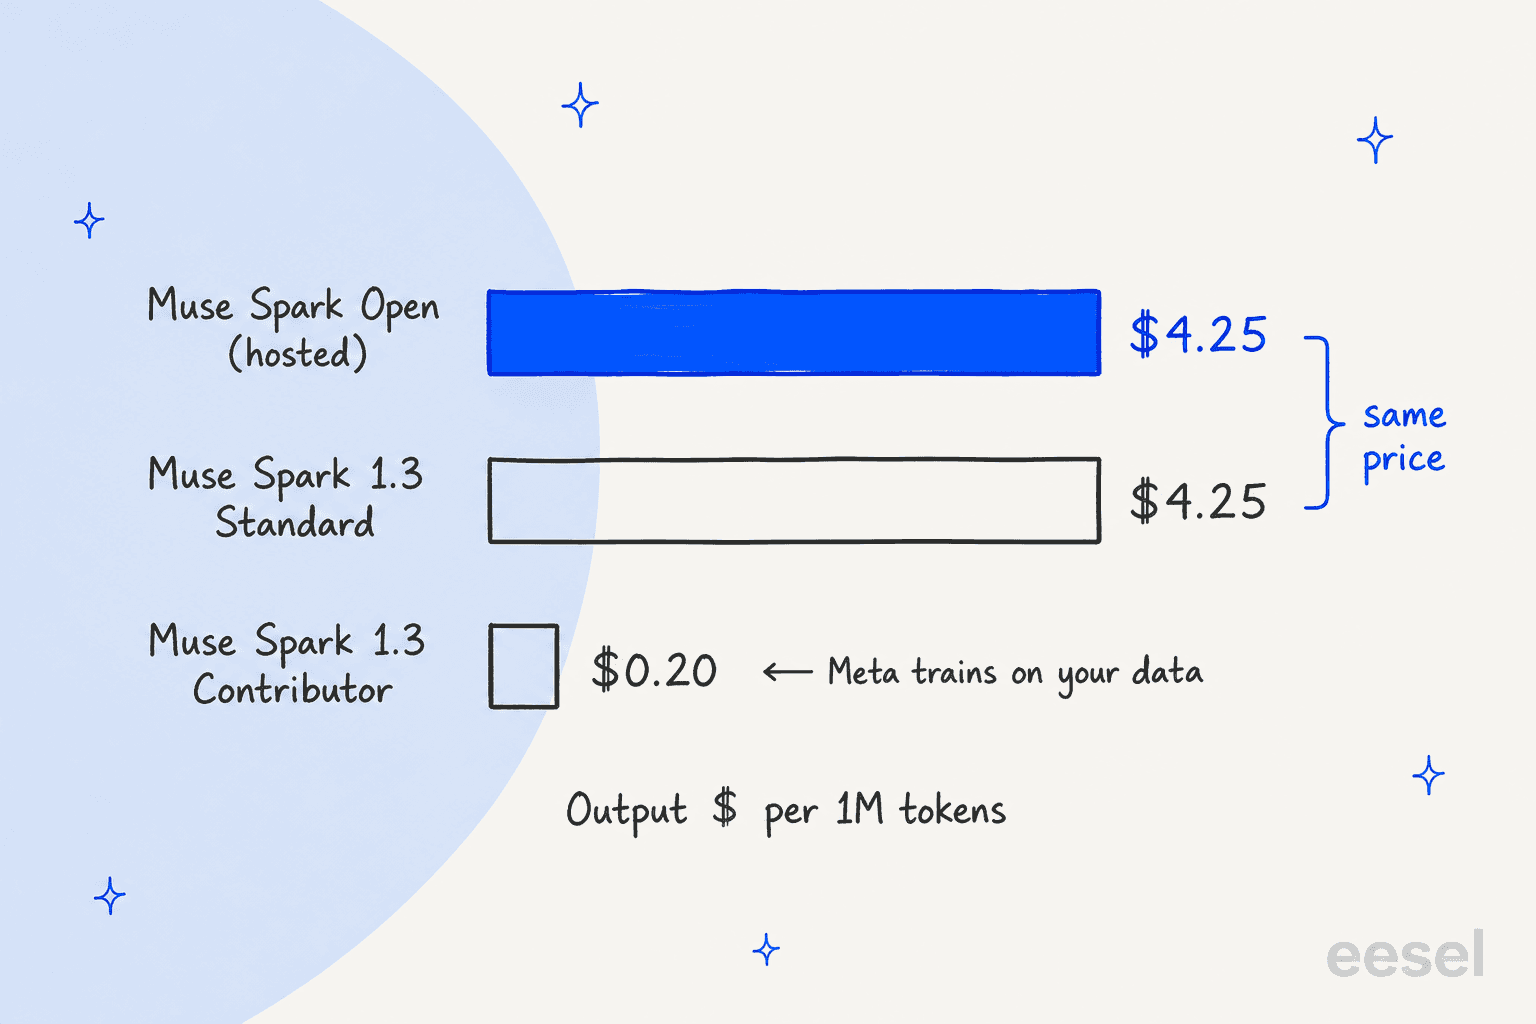
| API Meta : Muse Spark 1.3 Standard | 1,25 $ | 0,15 $ | 4,25 $ | Fermé, tarifs Meta |
| API Meta : Muse Spark 1.3 Contributeur | 0,10 $ | 0,002 $ | 0,20 $ | Fermé, Meta s'entraîne sur vos données |
Le modèle ouvert se loue exactement au prix du modèle fermé. Et le token Meta le moins cher reste l'offre contributeur du modèle fermé, à environ un vingtième du prix de sortie, en échange de l'autorisation donnée à Meta de s'entraîner sur votre trafic. Si vous avez évalué Muse Spark Open en vous attendant à la remise habituelle des poids ouverts, elle n'est pas encore là. Mon article sur les tarifs de Muse Spark 1.3 explique le fonctionnement de ce système à deux niveaux.
Deux éléments atténuent ce constat. Le cache est agressif : OpenRouter rapporte un prix d'entrée moyen pondéré d'environ 0,35 $ par million sur le trafic réel, parce que les taux de succès du cache dépassent 70 % chez la plupart des hébergeurs. Et Artificial Analysis a trouvé le modèle plutôt concis, avec 110M de tokens de sortie pour terminer son index contre une médiane de 130M, à environ 0,84 $ par tâche.
Un commentateur de Hacker News a lu ce prix identique comme un effet de bord de la licence :
"The usual effect of separate licensing is decreased price competition from public providers (like we saw with Kimi K3)."

C'est une lecture juste de la licence, que j'aborde plus bas. Reste à surveiller si les hébergeurs commencent à se sous-coter dans quelques semaines. Pour savoir comment d'autres hébergeurs tarifent les modèles ouverts, voir les tarifs de Together AI et les tarifs de Fireworks AI.
L'argument Mac Studio, et le piège
Le titre de Meta affirme que Muse Spark Open est « the first model in its class to run on your desktop using two Apple M5 Ultra Mac Studios ». C'est réel, et Apple a publié les chiffres. Dans ses tableaux de référence, avec un contexte de 8 192 tokens :
| Configuration | Temps jusqu'au premier token | Vitesse de décodage |
|---|---|---|
| 2 Mac Studio, parallélisme en pipeline | 8,4 s | 15,74 tok/s |
| 2 Mac Studio, parallélisme tensoriel | 8,2 s | 24,99 tok/s |
| 4 Mac Studio, parallélisme tensoriel | 4,8 s | 36,73 tok/s |
Vingt-cinq tokens par seconde, c'est utilisable pour un agent de code qui travaille en arrière-plan. Meta dit avoir livré de vrais correctifs iOS pour le client Mastodon Ice Cubes et piloté DaVinci Resolve de bout en bout de cette façon, le tout sur l'appareil via Muse Code.
Voici le piège. La configuration à deux Mac demande 512 Go de mémoire par machine, et l'Apple Store lui-même indique l'option 512 Go du M5 Ultra comme « coming late October ». À ce jour, vous ne pouvez pas la commander. La page du Mac Studio sur l'Apple Store démarre les configurations M5 Ultra à 5 499 $ avec 96 Go de mémoire, avant toute extension. L'article développeur de Meta propose une voie à quatre Mac avec 256 Go chacun, qui atteint les mêmes 1 To de mémoire mutualisée.
Si vous n'avez pas de matériel Apple, voici l'échelle complète de ce qu'il faut :
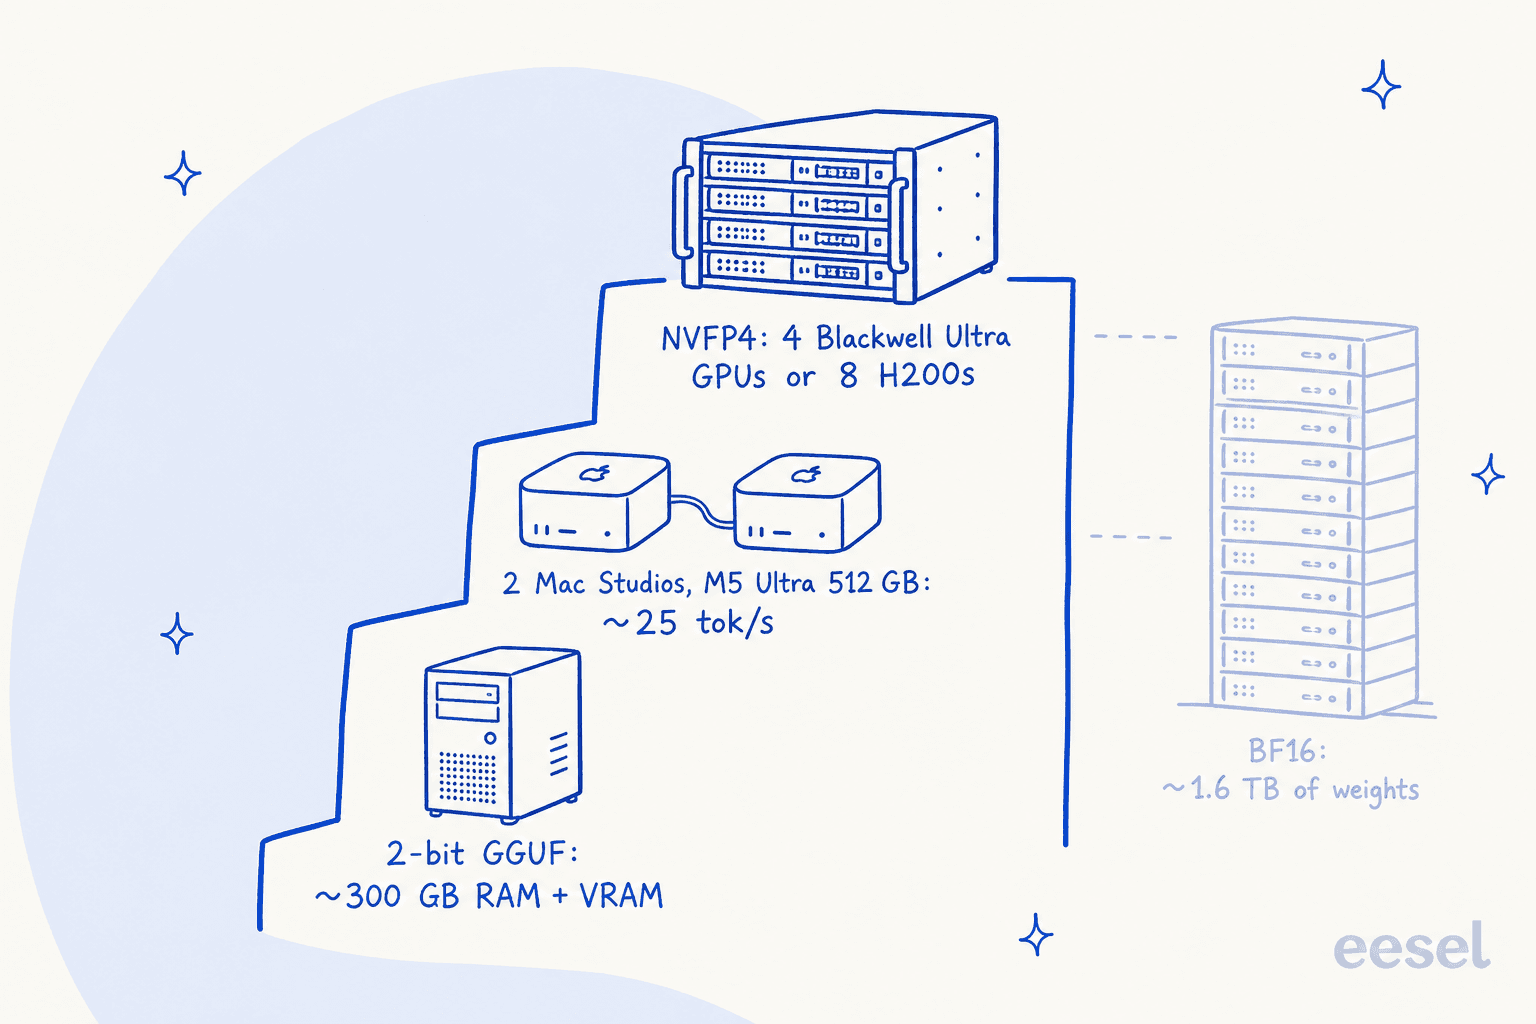
- GPU de datacenter. La fiche du modèle demande au moins 700 Go de mémoire GPU pour NVFP4 et 2 To pour BF16. L'article développeur de Meta indique que NVFP4 tourne sur quatre GPU Blackwell Ultra ou huit H200, via SGLang, vLLM ou TensorRT-LLM.
- Une grosse station de travail. Le GGUF dynamique 2 bits d'Unsloth tient dans environ 300 Go de RAM système et de VRAM combinées, exécuté via llama.cpp. Attendez-vous à une perte de qualité à ce niveau de compression ; la fiche du modèle elle-même avertit que les versions quantifiées peuvent différer dans les cas limites.
- Catalogues cloud. Amazon SageMaker AI, Google Cloud Model Garden et Microsoft Foundry Models proposent les poids si vous voulez une instance privée dans votre propre compte cloud.
Le résumé le plus honnête vient d'un commentateur qui a lu le guide Unsloth : « You & Me won't be running this one » (spwa4, Hacker News). Pour la plupart des équipes, « ouvert » voudra dire louer chez un hébergeur, ou l'exécuter dans leur propre cloud pour des raisons de données.
Comment Muse Spark Open se compare aux autres modèles ouverts
Meta a comparé Muse Spark Open à sept pairs à poids ouverts, dont Kimi K3, Mistral Large 4, Inkling et Beam de Reflection. Meta a fait tourner son propre modèle en effort xhigh. Voici le tableau publié :
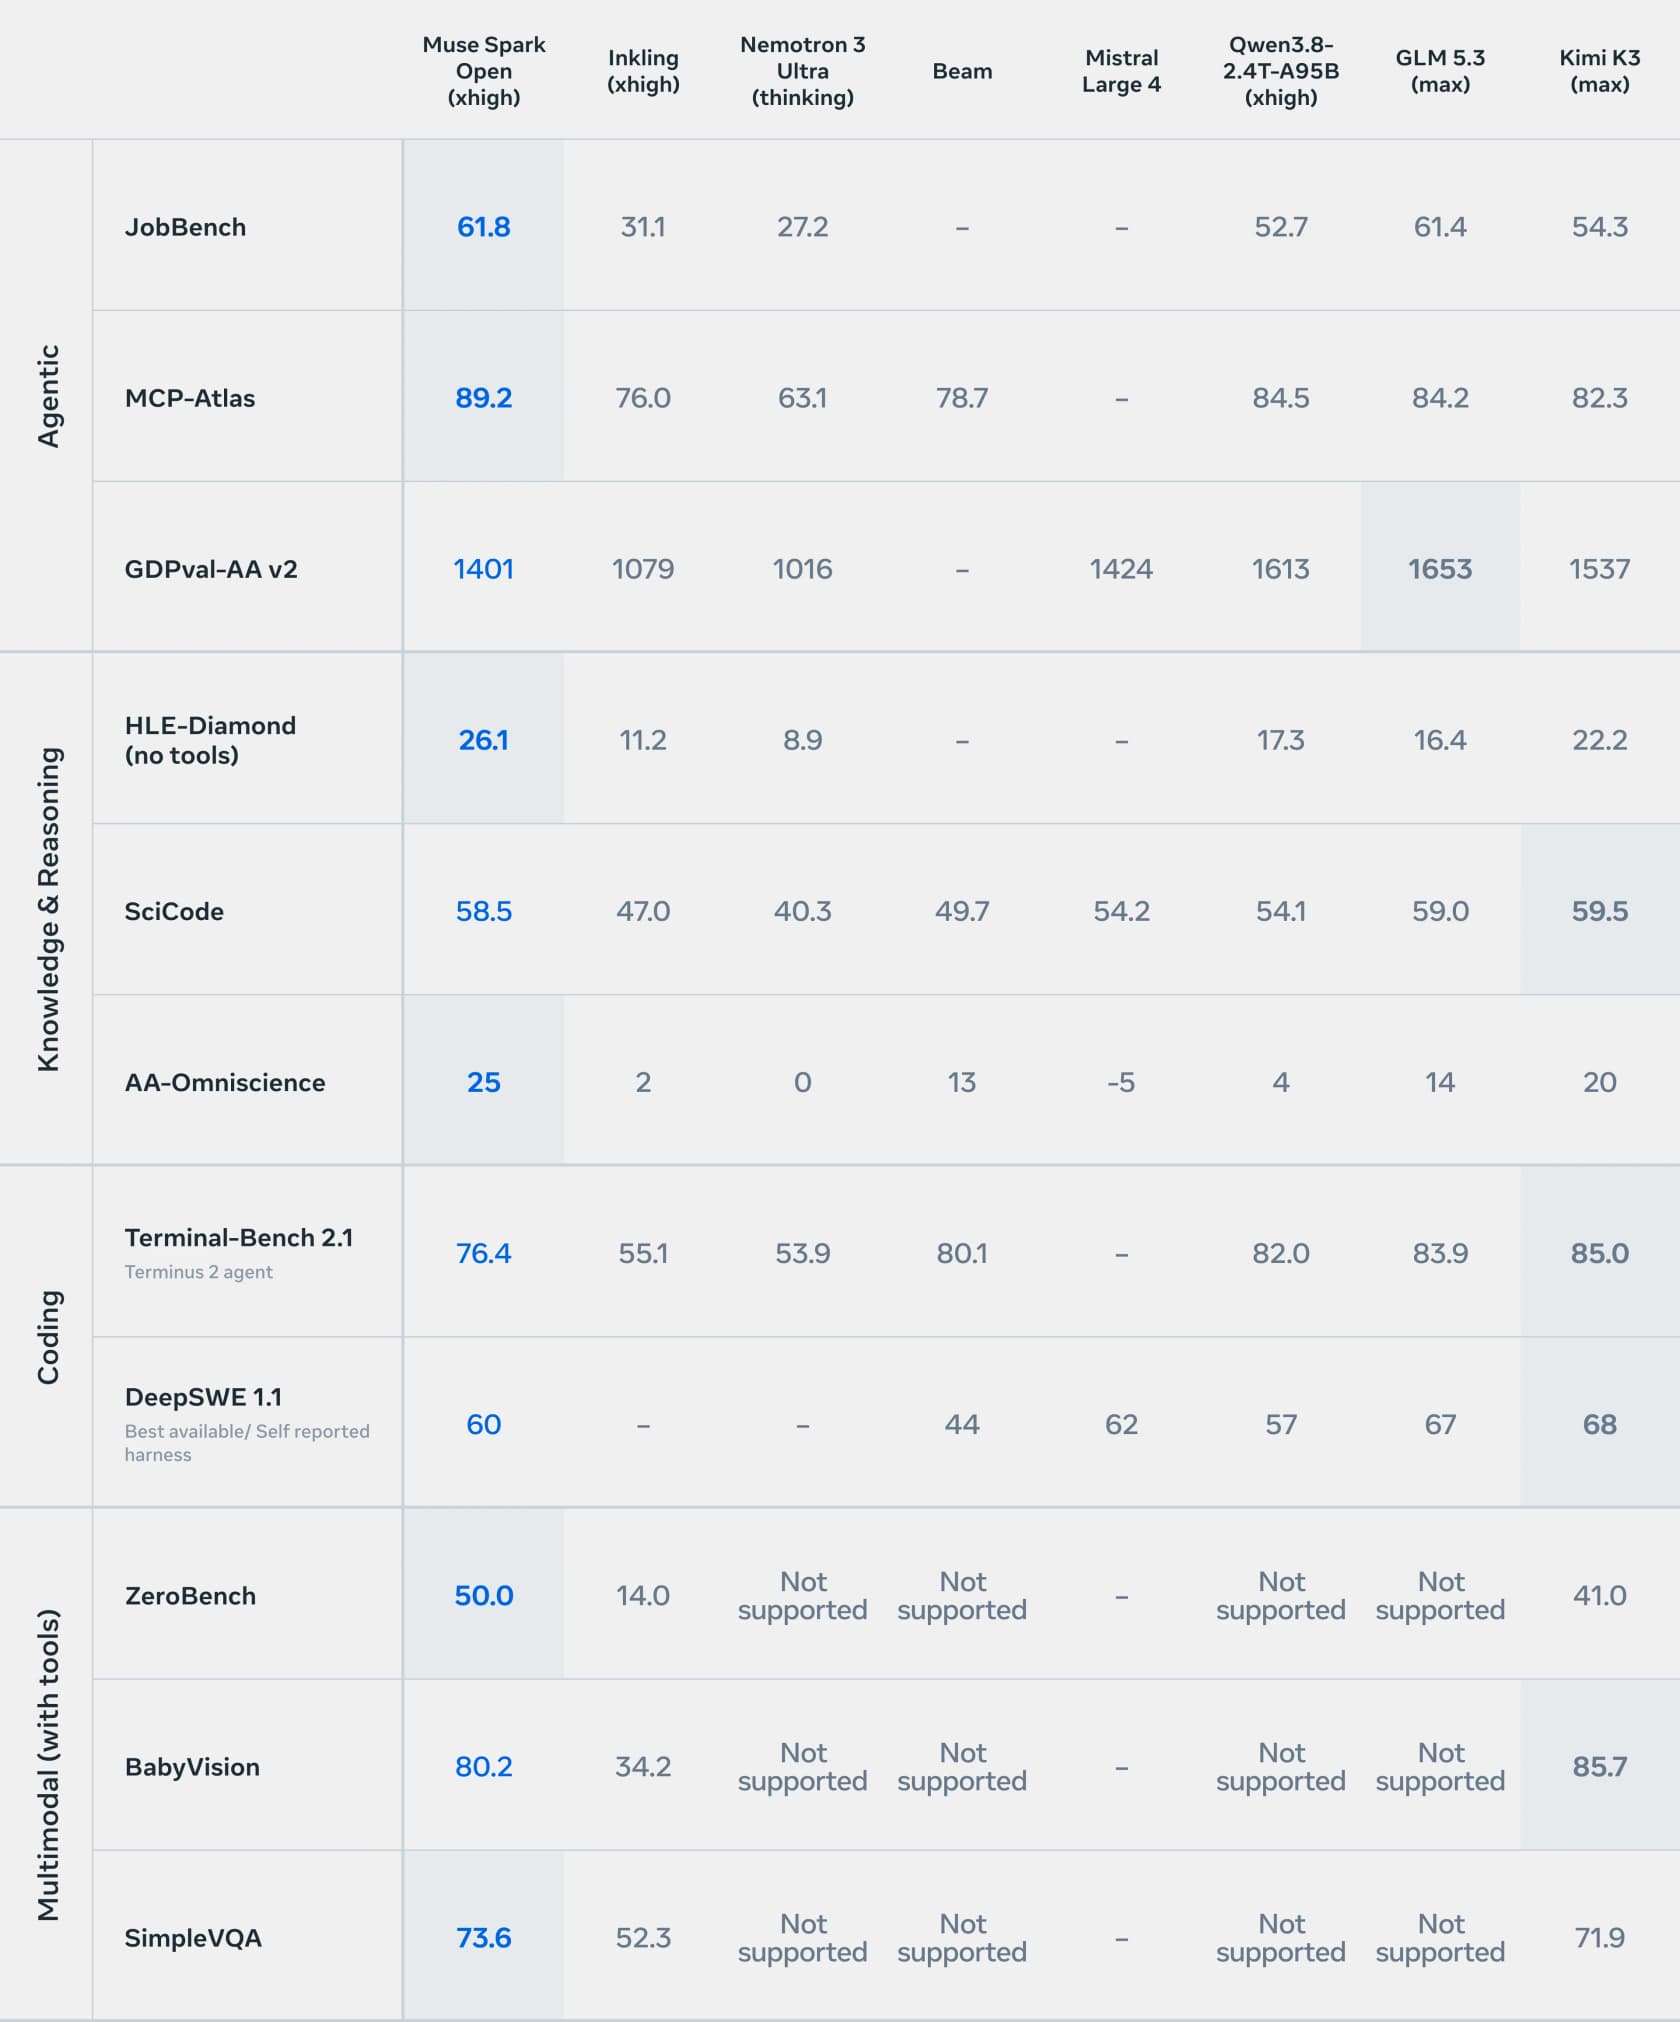
Lisez-le ligne par ligne et une forme claire apparaît :
- Là où il domine : l'utilisation d'outils et les tâches d'agent (MCP-Atlas 89,2, JobBench 61,8), les connaissances sans outils (HLE-Diamond 26,1, AA-Omniscience 25) et plusieurs tests multimodaux (ZeroBench 50,0, SimpleVQA 73,6).
- Là où il est derrière : l'index général et le code. Sur l'Artificial Analysis Index, il obtient 39, derrière GLM 5.3 (45), Kimi K3 (44) et Qwen3.8 (40). Sur Terminal-Bench 2.1, il fait 76,4 contre 85,0 pour Kimi K3 ; sur DeepSWE, 60 contre 68.
- Là où il joue dans une autre catégorie : la sécurité. Sur StrongREJECT, un test de jailbreak adaptatif où plus bas est mieux, il obtient 0,5. Tous les autres modèles testés par Meta se situent entre 62,9 et 86,4.
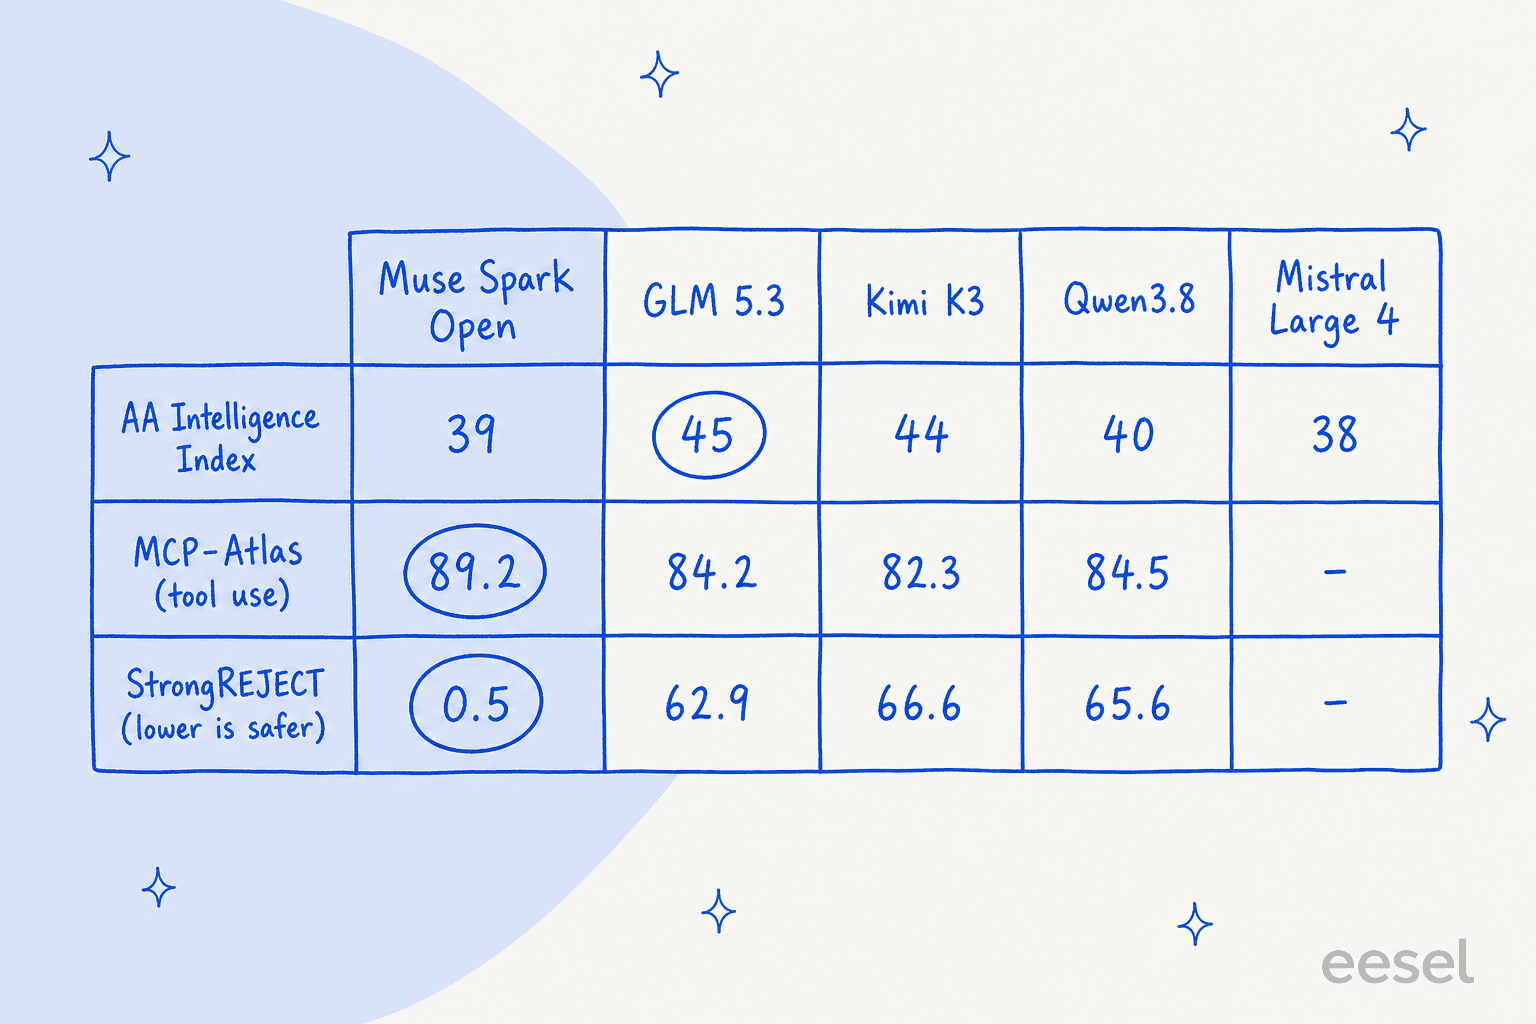
Le chiffre indépendant concorde avec celui de Meta. Artificial Analysis place Muse Spark Open à 39 sur son index, bien au-dessus de la médiane de 19 des modèles comparables, à 131 tokens par seconde. Hacker News a vite remis cela en perspective :
"39 on AA, about the same as Deepseek v4.1 flash and Mimo 2.5 Flash. Behind Glm 5.3 flash and Qwen3.8-Flash-Next"
Cette comparaison pique, car DeepSeek V4.1 Flash et GLM 5.3 Flash sont des modèles bien plus petits. Les retours pratiques jusqu'ici vont dans le même sens : un testeur l'a trouvé « dumber than GLM 5.3 » mais « really fast » sur Fireworks (eknkc, Hacker News), et un autre l'a placé « closer to 1.2 » que 1.3 sur les benchmarks (modeless, Hacker News). Meta n'a pas publié de comparaison directe avec ses propres modèles fermés, alors prenez ce dernier point comme une première impression.
Mon avis : c'est d'abord un modèle d'appel d'outils et de boucles d'agent, avec un comportement de sécurité solide, plutôt que le meilleur codeur ouvert. Les premiers utilisateurs cités dans l'article développeur de Meta disent la même chose, le saluant pour choisir « the right next tool » et pour des sorties structurées propres sur des appels multi-étapes et parallèles. Si votre agent passe sa vie à appeler des outils, l'avance sur MCP-Atlas compte plus que l'écart d'index. S'il passe sa vie à écrire du code, Kimi K3 est le choix ouvert le plus solide d'après ces chiffres.
La licence : gratuite, avec trois conditions
Meta a publié les poids sous la Muse Model License, qu'elle décrit comme comportant des « limited commercial terms ». Elle ressemble à une licence permissive avec des conditions ajoutées. Vous pouvez l'utiliser, la copier, la modifier, l'affiner, la distiller, la fusionner, la publier et la vendre, gratuitement, sous réserve de :
- La politique d'usage. Une longue liste d'usages interdits, des armes aux infrastructures critiques en passant par les faux avis et le fait de présenter des sorties comme écrites par un humain. Elle précise aussi que le modèle n'est pas destiné aux moins de 18 ans.
- L'attribution. Vous devez afficher de façon « prominently display » la mention « Built with Muse Spark Open » dans l'interface de votre produit, sa documentation, son site web ou son menu de paramètres. Cela s'applique aussi à tout modèle que vous entraînez ou distillez à partir de ses sorties.
- La clause de service à 20 M$. Si vous vendez l'accès à des modèles d'IA en tant que service via une API, et que votre groupe d'entreprises gagne plus de 20 millions de dollars sur une période de 12 mois, vous devez en informer Meta et signer d'abord un accord séparé.
La troisième clause fait peur et ne l'est pour l'essentiel pas. Elle exclut explicitement l'usage interne, la recherche et l'utilisation du modèle pour alimenter des fonctionnalités de votre propre produit. Une entreprise SaaS qui fait tourner Muse Spark Open derrière sa boîte de support ne doit rien à Meta en dehors de la ligne d'attribution. La clause vise les fournisseurs d'inférence et les grandes plateformes qui revendent le modèle.
Un autre obstacle pratique : le téléchargement depuis Hugging Face passe par un formulaire d'accès qui demande votre nom légal complet, votre date de naissance et le nom complet de votre organisation avec ses identifiants d'entreprise. Meta ne revendique aussi aucune propriété sur les sorties, c'est la clause que votre service juridique cherchera en premier.
Je l'utilise en interne, pour la recherche, ou pour alimenter des fonctionnalités dans mon propre produit
Gratuit. Aucun accord séparé, même au-dessus de 20 M$ de revenus. Vous devez tout de même respecter la politique d'usage et afficher "Built with Muse Spark Open" à un endroit que les utilisateurs peuvent trouver : l'interface, la documentation, le site web ou un menu de paramètres.
Je vends un accès API à des modèles d'IA, et mon groupe d'entreprises gagne moins de 20 M$ par an
Gratuit pour l'instant, avec les mêmes règles d'attribution et d'usage. Suivez vos revenus : le test porte sur 12 mois consécutifs quelconques, comptés pour vous et vos sociétés affiliées.
Je vends un accès API à des modèles d'IA, et mon groupe d'entreprises gagne plus de 20 M$ par an
Vous devez informer Meta et signer un accord écrit séparé avant de proposer Muse Spark Open, ou tout ce qui en dérive, dans ce service. Les conditions ne sont pas publiques.
J'ai affiné ou distillé un nouveau modèle à partir de lui
C'est un Derivative. La ligne d'attribution et la politique d'usage le suivent, et la clause de service à 20 M$ aussi si vous revendez l'accès.
Résumé de la Muse Model License datée du 15 octobre 2026. Ce n'est pas un avis juridique ; lisez le texte complet sur Hugging Face avant de déployer.
Est-il « ouvert » ? De nombreux commentateurs de Hacker News ont dit non, parce que la licence n'est pas approuvée par l'OSI et que seuls les poids sont publiés, sans données d'entraînement ni code. Je dirais poids ouverts avec un plafond commercial, et pour la plupart des entreprises ce plafond est bien au-dessus de ce qu'elles atteindront. Si vous voulez des briques entièrement open source, mon tour d'horizon des agents IA open source est un meilleur point de départ.
Sécurité : le point fort de cette version
C'est là que Meta a le plus travaillé, et ça se voit. La fiche du modèle rapporte, sans aucune protection au niveau du système :
- Mésusage cyber : 99,2 % de jailbreaks refusés sur le benchmark interne de Meta et 94,8 % sur PolyGuard, RedCode et CyberBench 2024. Kimi K3 en a refusé 75,5 % et 70,2 % dans la même configuration.
- Chimie et biologie : plus de 98 % de refus sur BioTIER de SecureBio, plus de 97 % sur le test de biologie agentique multi-tours de Meta.
- Honnêteté : un taux d'honnêteté de 98,1 % sur le benchmark MASK, et 0 % de comportement déviant sur le benchmark Agentic Misalignment.
Il y a un compromis caché dans le tableau de Meta. Sur le test FORTRESS, Muse Spark Open a le score de risque adverse le plus bas (5,8) mais aussi le score de sur-refus le plus élevé (17,4) du groupe, ce qui veut dire qu'il refuse plus de demandes inoffensives que GLM 5.3 (3,2) ou Kimi K3 (2,7). Pour un bot en contact avec les clients, quelques « Je ne peux pas vous aider » de plus ont un vrai coût. Testez-le sur votre propre trafic avant de faire confiance aux réglages par défaut.
Deux réserves de Meta elle-même. Le rapport d'évaluation complet est encore « available soon ». Et la fiche du modèle avertit que « downstream modifications could degrade safety », donc dès que vous l'affinez, ces chiffres ne sont plus les vôtres. Le conseil de Meta est de le déployer dans un système avec des garde-fous supplémentaires et une « human-in-the-loop confirmation for irreversible actions », ce que je dirais à quiconque place un modèle derrière une file de support.
Affiner dès le premier jour
C'est l'autre chose que les poids ouverts débloquent vraiment. Meta a préparé un support de post-entraînement sur tous les fronts au lancement, d'après son article développeur :
- PyTorch TorchTitan : pré-entraînement, SFT multi-tours, LoRA et apprentissage par renforcement.
- Hugging Face TRL : LoRA avec SFTTrainer sur le checkpoint publié.
- Fireworks AI : entraînement LoRA serverless via une API, avec des séquences jusqu'à 262 144 tokens. Sa page du modèle précise que l'affinage géré dans l'interface n'est pas encore disponible pour ce modèle.
- Together AI : SFT ou apprentissage par renforcement GRPO sur son service de post-entraînement, puis service de plusieurs adaptateurs LoRA sur un même déploiement.
- NVIDIA NeMo AutoModel et Miles de RadixArk pour le travail sur tous les paramètres.
Pour une équipe support, l'affinage est séduisant : lui apprendre votre ton, vos noms de produits, vos règles de remboursement. D'après mon expérience, ce n'est rarement la première correction. La plupart des mauvaises réponses que je vois viennent d'un centre d'aide obsolète ou contradictoire, pas d'un modèle à réentraîner, et la recherche documentaire le corrige plus vite. Mon article RAG vs LLM explique pourquoi. Affinez quand la recherche est solide et que vous voyez encore des problèmes de style ou de format.
Qui devrait vraiment utiliser Muse Spark Open ?
Voici comment je déciderais :
- Vous avez besoin du modèle dans vos propres murs. Données réglementées, revue de sécurité qui bloque les sous-traitants tiers, ou contrat client qui dit « pas d'IA externe ». C'est le cas le plus fort, et les chiffres de sécurité le rendent plus facile à défendre.
- Vous construisez des agents riches en outils. Les avances sur MCP-Atlas et JobBench sont réelles. Associez-le à un serveur MCP et voyez comment il gère votre ensemble d'outils.
- Vous voulez affiner un grand modèle multimodal. Il accepte nativement l'audio et la vidéo, et la pile d'entraînement était prête dès le jour du lancement.
- Vous voulez les tokens Meta les moins chers. Passez votre chemin. Le tarif contributeur de Muse Spark 1.3, fermé, est bien moins cher, si cela ne vous dérange pas que Meta s'entraîne sur ce trafic.
- Vous voulez le meilleur codeur ouvert. Regardez d'abord Kimi K3 ou Qwen, ou passez aux modèles fermés de pointe comme Claude Opus 5.5 et le plus récent Muse Wonder.
Pour le support client en particulier, le choix du modèle est la décision la moins importante. Mon guide des modèles pour le support explique pourquoi la recherche, l'escalade et les tests font plus bouger la qualité de résolution que quelques points d'index. Un écart de 6 points d'index se voit rarement dans une file de tickets. Une réponse assurée tirée d'un article périmé, elle, se voit tous les jours, avec ou sans poids ouverts.
Essayer eesel
Muse Spark Open est de l'infrastructure. Vous obtenez des poids, une licence et une facture de matériel, puis vous construisez vous-même la recherche, les règles d'escalade, les tests et la piste d'audit. eesel, c'est l'employé. Notre coéquipier IA de helpdesk se branche sur Zendesk, Freshdesk, Gorgias et les autres, apprend de vos anciens tickets et de votre centre d'aide, et vous pouvez le tester sur des centaines de vos tickets passés avant qu'il ne réponde à un seul client. Ce rejeu permet d'attraper la réponse trop sûre d'elle avant un client, quel que soit le modèle en dessous.
Si vous préférez le gérer depuis un terminal, comme vous piloteriez un modèle auto-hébergé, la CLI eesel s'en charge. eesel instructions lit et modifie les règles permanentes du coéquipier, eesel approvals liste les actions en attente d'un humain, et eesel activity montre chaque exécution et pourquoi il a agi ainsi. Chaque commande affiche du JSON et les écritures acceptent --dry-run, si bien qu'un agent de code comme Claude Code peut gérer votre coéquipier de support comme il gère votre dépôt. Si vous écrivez du contenu plutôt que de répondre à des tickets, la même équipe compte un rédacteur de blog IA.

Le démarrage est gratuit avec 100 crédits et sans carte. Essayez eesel sur les tickets du mois dernier et voyez ce qu'il aurait répondu, avant de chiffrer le moindre Mac Studio. Les formules sont sur la page des tarifs.
Comment Muse Spark Open se compare-t-il à Kimi K3 et GLM 5.3 ?