

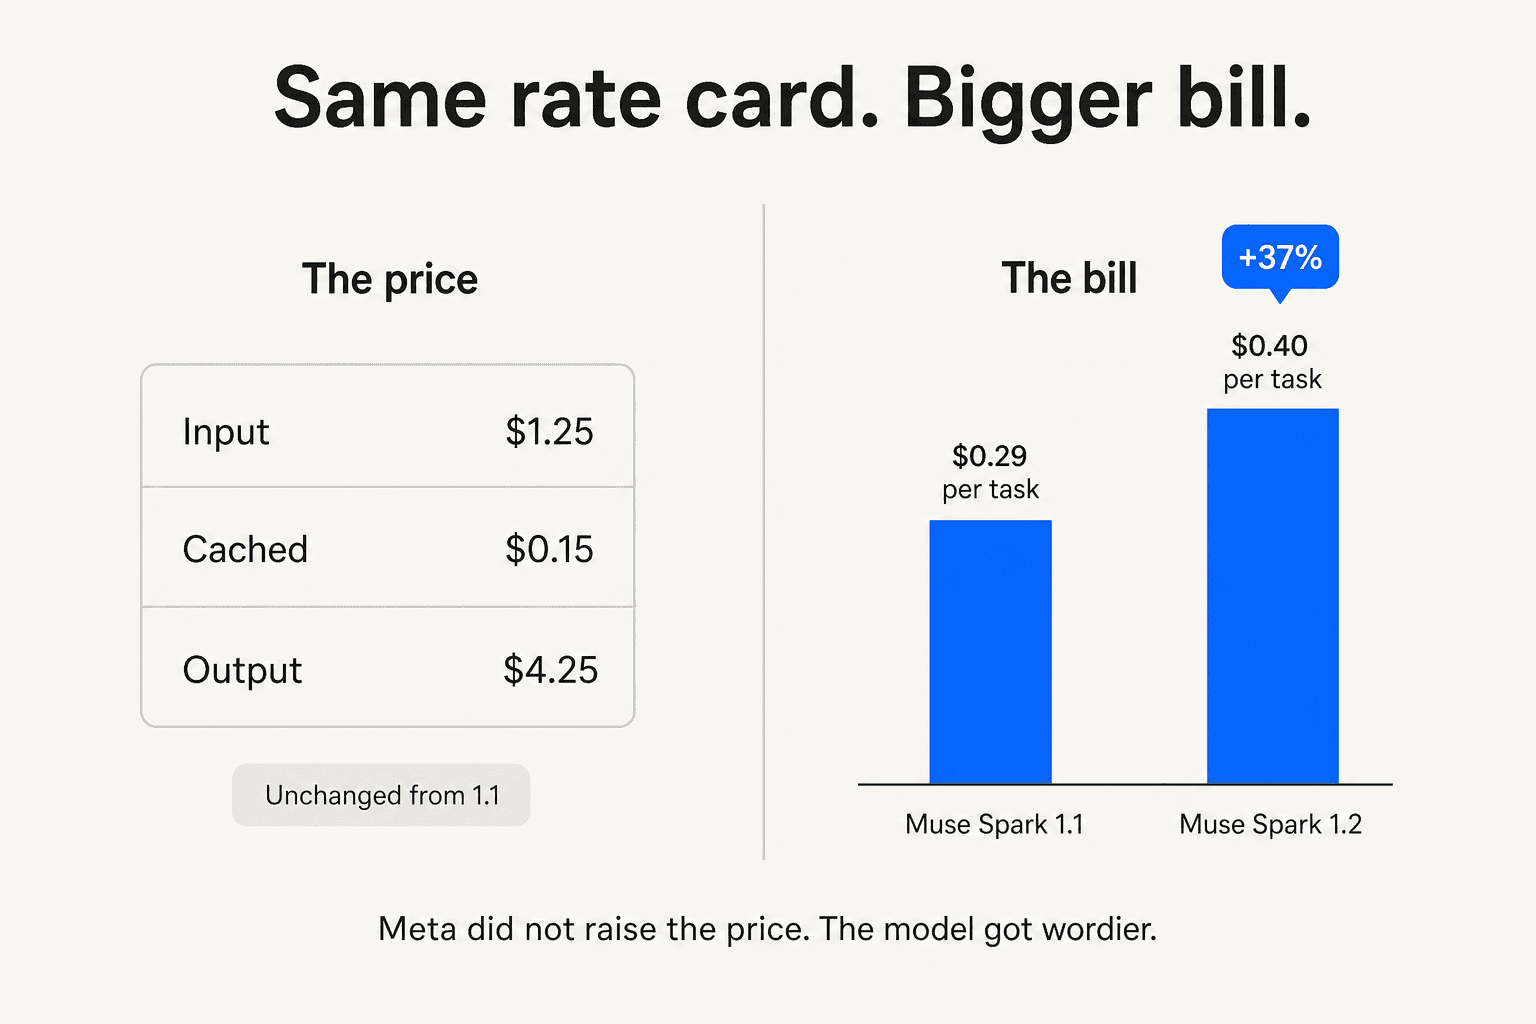
Meta n'a pas changé un seul chiffre de la grille de Muse Spark, et le modèle coûte pourtant 37 % de plus à faire tourner. Le niveau standard coûte 1,25 $ par million de tokens d'entrée, 0,15 $ en cache, 4,25 $ en sortie, exactement ce que coûtait la 1.1. Le niveau contributor coûte 0,10 $ / 0,002 $ / 0,20 $ si vous laissez Meta s'entraîner sur votre trafic. Mais Artificial Analysis a mesuré un coût par tâche de benchmark passé de 0,2923 $ sur la 1.1 à 0,3992 $ sur la 1.2, et la raison n'est pas celle que tout le monde supposait.
Le raisonnement est devenu moins cher. L'argent en plus est parti dans les lectures de cache et dans la réponse elle-même, qui s'est allongée de 78 % par tâche. Le chiffre à surveiller est donc le nombre de tokens que le modèle décide de dépenser en votre nom, et la grille de Meta n'en dit rien.
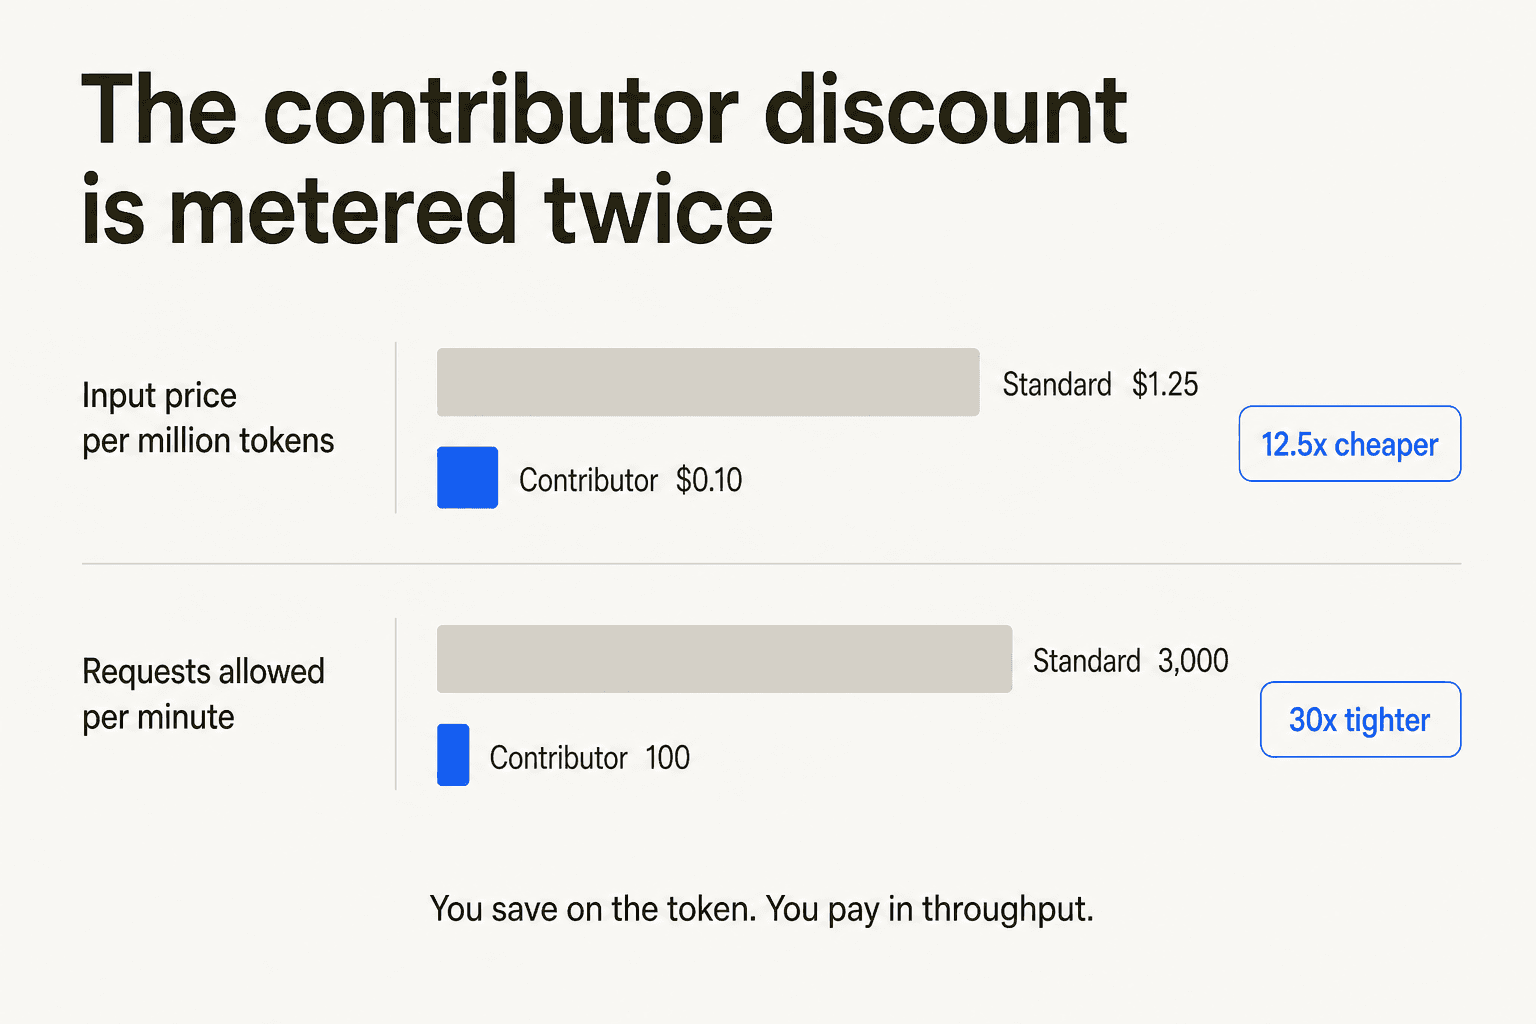
Deux points à vérifier avant de choisir un niveau. La remise contributor est mesurée deux fois : une entrée 12,5 fois moins chère, et un plafond 30 fois plus serré de 100 requêtes par minute contre 3 000. Et rester sur la 1.1 ne vous fait rien économiser, car Meta applique le même tarif aux deux checkpoints.
Si vous chiffrez cela pour une file de support et non pour un projet perso, la réponse honnête est qu'aucune grille au token ne peut prévoir cette facture. Un ticket résolu, ce sont plusieurs appels, de la récupération et des nouvelles tentatives. C'est pourquoi eesel facture 1 crédit par ticket, quelle que soit sa longueur, et vous laisse simuler le coût sur votre propre historique de tickets avant toute mise en production.
Tarifs de Meta Muse Spark 1.2, la grille complète
Voici chaque chiffre publié, vérifié sur les pages de Meta le 17 août 2026. Tous les prix sont en dollars américains par million de tokens.
| ID du modèle | Niveau | Contexte | Entrée | Entrée en cache | Sortie | Formulation de la politique de données de Meta |
|---|---|---|---|---|---|---|
muse-spark-1.2-contributor | Contributor | 1,048,576 | $0.10 | $0.002 | $0.20 | "Used to improve our products." |
muse-spark-1.2 | Standard | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
muse-spark-1.1 | Standard | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
Cette troisième ligne est celle que la plupart des articles ratent. La page Model API de Meta liste le checkpoint précédent exactement au même prix, et la documentation tarifaire confirme que les deux checkpoints partagent le tarif standard. Il n'existe pas de niveau hérité bon marché où se replier. Si le comportement de la 1.2 vous coûte plus cher, revenir en arrière ne récupère pas l'argent, ce qui change par rapport à la lecture des tarifs de Muse Spark 1.1 au lancement, quand c'était le seul checkpoint de la grille.
Quelques points méritent d'être dits clairement avant d'aborder ce que la grille cache.
Il n'y a aucune prime pour le contexte long. Meta le dit sans détour sur la page des tarifs et limites de débit : vous payez pareil que la fenêtre soit presque vide ou presque pleine. Plusieurs fournisseurs relèvent le prix au-delà d'un seuil de contexte, et si vous placez un grand préfixe stable dans chaque appel, cet écart s'accumule vite.
Le prompt caching est automatique et gratuit à activer. Le prefix caching de Meta n'a "no flag or key to manage", il n'y a pas de frais d'écriture de cache sur la grille, et les tokens en cache sont un sous-ensemble remisé de l'entrée plutôt qu'un supplément. Vous pouvez demander une rétention prolongée avec prompt_cache_retention: "24h", mais Meta parle d'une indication et non d'une garantie.
Et l'échafaudage de Meta est gratuit. La documentation note que Meta injecte une petite quantité de contexte d'orientation dans chaque prompt, et que ces tokens "are not billed and are excluded from the token counts reported in your usage." C'est une petite courtoisie, mais c'est le genre de chose qui apparaît discrètement sur d'autres factures.
La grille n'a pas bougé. La facture a grimpé de 37 %.
C'est ce qui rend étrange l'écriture sur les tarifs de Muse Spark 1.2. Meta a sorti un nouveau modèle le 5 août, gardé le même prix, et le coût d'un même travail a augmenté de plus d'un tiers.
Artificial Analysis exécute la même suite de neuf évaluations sur chaque modèle de pointe, la comparaison d'une version à l'autre est donc aussi contrôlée que les données publiques le permettent. Elle publie deux mesures de coût distinctes, et il vaut mieux les garder séparées car elles n'évoluent pas ensemble.
Le coût pondéré par tâche est passé de 0,2923 $ sur la 1.1 à 0,3992 $ sur la 1.2, soit une hausse de 36,6 %. Le total pour exécuter une fois toute la suite est passé de 547,32 $ à 639,27 $, soit une hausse de 91,96 $ ou 16,8 %. Le premier chiffre prédit ce que coûte un travail donné, et c'est celui par lequel je commence. Le second dit où l'argent est parti, et je le détaille dans la section suivante.
Je tiens à être précis sur ce que sont ces 37 % et ce qu'ils ne sont pas. C'est une charge de benchmark, pas la vôtre. Mais c'est le même benchmark sur les deux versions, valorisé avec la même grille, ce qui donne une lecture propre d'une question : combien de plus ce modèle dépense-t-il pour une unité de travail ? Plus d'un tiers de plus, gratuitement, sans que personne n'annonce de changement de prix.
C'est le mode d'échec dans lequel je vois sans cesse des équipes tomber, et il n'a rien de propre à Meta. Un prospect s'est un jour assis avec moi lors d'un appel pour faire ses propres calculs, est arrivé à environ 30 000 $ par mois pour une entreprise qui montait vers 150 000 tickets, et toute la confusion venait de l'écart entre l'unité qu'il comptait et celle sur laquelle il était facturé. Un autre s'est vu proposer une enveloppe mensuelle de 3 000 interactions alors qu'il traitait environ 500 tickets par jour à quatre échanges chacun, ce qui épuise l'enveloppe en un jour et demi. Aucun des deux n'était mauvais en arithmétique. Dans les deux cas, le multiplicateur entre "ce que je compte" et "ce que vous facturez" est resté invisible jusqu'à l'arrivée de la facture. La grille de Muse Spark a exactement cette forme.
Où sont réellement passés les 92 $ en plus
Presque tout le monde, y compris une version antérieure de ma propre analyse de Muse Spark 1.2, a supposé que la hausse venait d'une réflexion accrue. Les modèles de raisonnement coûtent plus cher en raisonnant davantage, et la 1.2 était présentée comme le checkpoint plus intelligent. C'est une hypothèse raisonnable.
Elle est aussi fausse, et la ventilation des coûts publiée le dit.
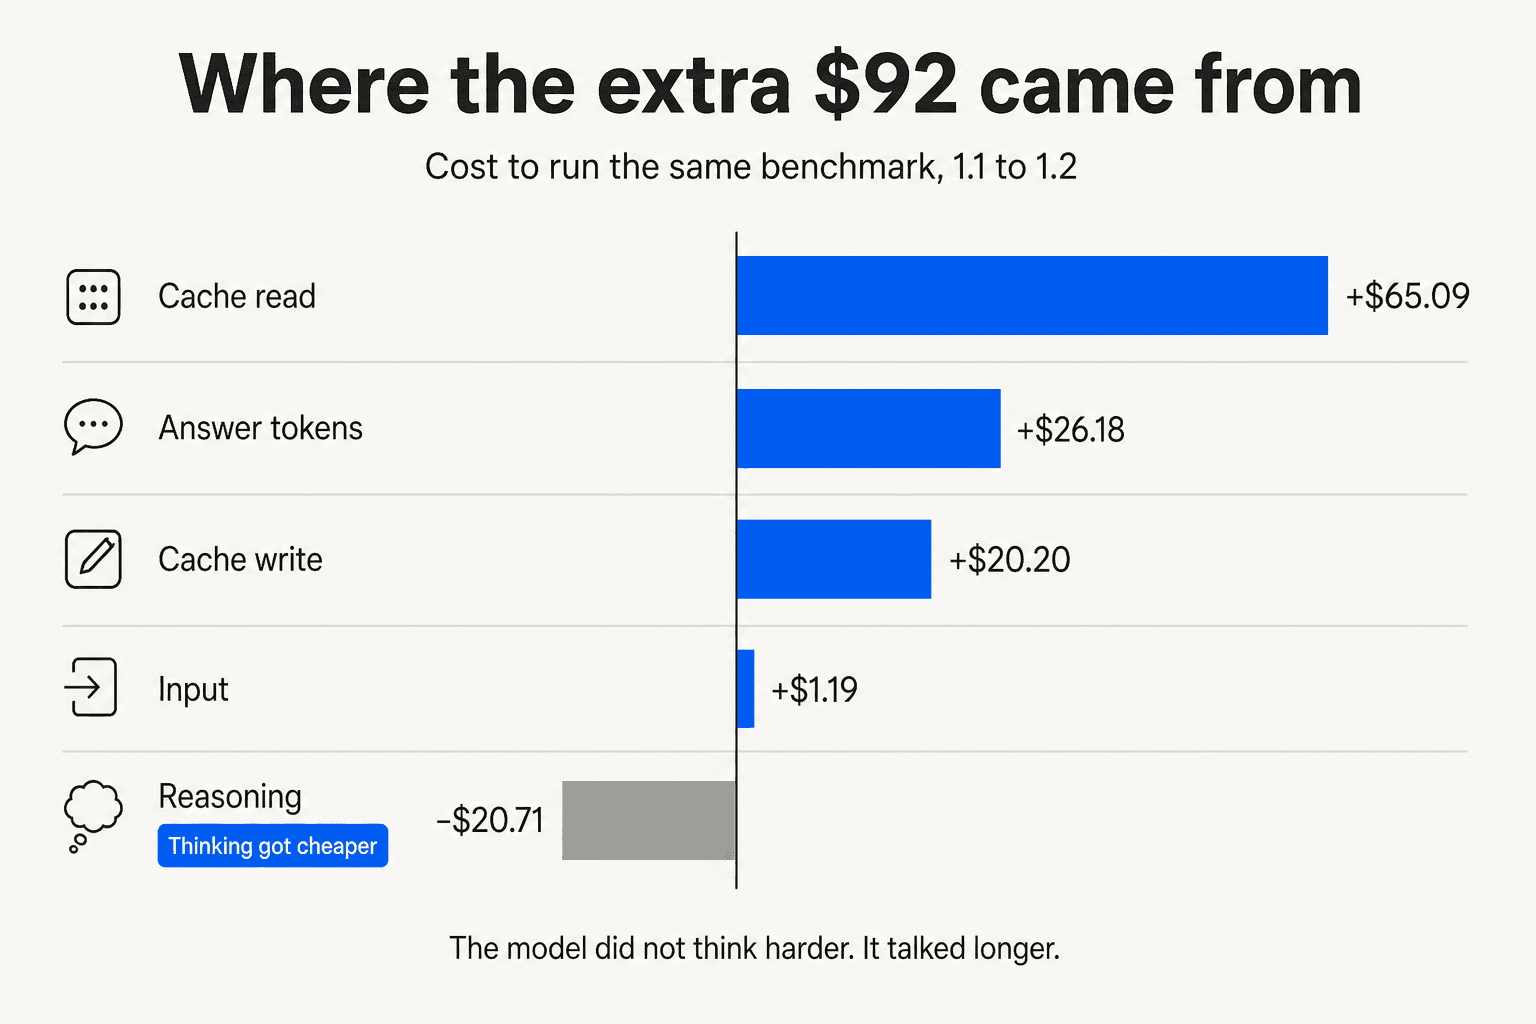
| Type de token | Muse Spark 1.2 | Muse Spark 1.1 | Variation |
|---|---|---|---|
| Raisonnement | $339.82 | $360.53 | -$20.71 |
| Lecture de cache | $136.85 | $71.76 | +$65.09 |
| Écriture de cache | $82.21 | $62.01 | +$20.20 |
| Réponse (sortie) | $63.61 | $37.42 | +$26.18 |
| Entrée hors cache | $16.78 | $15.59 | +$1.19 |
| Total | $639.27 | $547.32 | +$91.96 |
Le raisonnement est la seule ligne qui a baissé. La 1.2 a dépensé 20,71 $ de moins en tokens de réflexion cachée que la 1.1. La hausse vient de tout le reste, et la lecture de cache est le plus gros moteur, presque le double.
Les comptes de tokens par tâche expliquent pourquoi. Les tokens de réponse par tâche sont passés de 7 237 à 12 874, un bond de 78 %. Les tokens de raisonnement par tâche n'ont augmenté que de 16 %, de 15 158 à 17 557. Pendant ce temps, l'ensemble de l'indice a tourné avec à peu près le même budget total de sortie, 95 M de tokens contre 94 M.
La traduction pratique est la suivante : Muse Spark 1.2 ne réfléchit pas plus fort que la 1.1, il écrit plus long. Si votre charge fait tourner des agents IA sur plusieurs tours, des réponses plus verbeuses retournent directement dans le contexte de l'appel suivant, exactement le mécanisme qui a doublé la ligne de lecture de cache. La verbosité s'accumule d'une façon que la simple réflexion ne fait pas.
C'est un levier sur lequel vous pouvez agir. Demandez des réponses plus courtes, plafonnez les tokens de sortie et élaguez les parties de votre chaîne de prompts qui reportent les réponses précédentes. C'est de l'optimisation de LLM ordinaire, la même discipline qui rend les tarifs de l'API Anthropic prévisibles, et la même raison pour laquelle l'API OpenAI surprend ceux qui ne regardent jamais la longueur de sortie.
Le niveau contributor est 12,5 fois moins cher et 30 fois plus serré
La structure à deux prix est ce que tout le monde cite à propos de Muse Spark, et on la cite généralement mal, car la remise diffère sur l'entrée et la sortie. L'entrée baisse de 12,5 fois. La sortie de 21,25 fois. L'entrée en cache de 75 fois.
La présentation de Meta est étonnamment directe. La documentation décrit contributor comme "heavily discounted token pricing in exchange for permission" d'entraîner de futurs modèles sur vos prompts et vos réponses, destiné au "prototyping, testing integrations, and scaling experiments where training on your data is acceptable." Et le niveau n'est pas un réglage de compte que l'on bascule. Selon les mots de Meta, "Tier is a model attribute". Vous vous retirez de l'entraînement en appelant un autre ID de modèle.
Le fil Hacker News du jour du lancement a presque entièrement porté sur la question de savoir si cet échange est équitable, et les avis étaient tranchés.
"What are you talking about? This is one of the most honest offers ever made by a corporation. "We'll use your data, and we'll compensate you for it." Where is the problem?"

Tout le monde n'était pas d'accord pour dire que la promesse du niveau standard vaut la prime. Quand un commentateur a soutenu que Meta s'entraîne sur tout quelle que soit la facture, Simon Willison a répliqué par un portrait sarcastique de ce que cette accusation implique, à savoir qu'une entreprise imprimerait deux politiques de données et en violerait sciemment une. La différence contractuelle, c'est le produit.
Mais l'argument que personne ne faisait est celui qui compte le plus pour un budget de production. Voici les limites publiées :
| Niveau | Requêtes par minute | Tokens par minute |
|---|---|---|
| Standard | 3,000 | 4,000,000 |
| Contributor | 100 | 3,000,000 |
Le niveau contributor coûte 12,5 fois moins par token d'entrée et autorise 30 fois moins de requêtes par minute. Le plafond de tokens ne baisse que de 25 %, la limitation est donc volontairement inégale. Meta a serré spécifiquement le chemin des requêtes. Contributor est tarifé pour le volume et bridé pour le prototypage, une décision produit cohérente et une mauvaise surprise si on la découvre après avoir construit dessus.
Un utilisateur de X s'y est directement heurté et l'a dit en cinq mots : les requêtes par minute "seem to be severely limited". C'est le seul retour concret sur les limites de débit que j'aie pu trouver sur une plateforme vérifiable, ce qui montre combien peu de gens ont poussé contributor au-delà d'une charge de loisir.
Deux mécaniques de plus à connaître avant de planifier autour de ces chiffres. Les limites sont mutualisées par équipe, pas par clé d'API, ajouter des clés n'ajoute donc aucune marge. Et les réponses en arrière-plan ont un plafond distinct de 600 soumissions par minute et par équipe, en plus du RPM et du TPM.
Déterminez quel niveau vous pouvez réellement utiliser
Le prix est la deuxième question. Le débit est la première, car aucune remise n'aide si le plafond est sous votre plancher. Réglez vos chiffres ici et la réponse en découle.
Les compteurs à côté du compteur de tokens
Les tarifs au token font la une, mais ne sont pas toute la facture. Quatre autres éléments facturent ou vous limitent.
Le grounding par recherche web est mesuré séparément à 2,50 $ pour 1 000 requêtes de recherche, facturé en plus des tokens de la requête. Si votre agent ancre chaque réponse par une recherche, c'est un second compteur qui tourne en parallèle du premier, et c'est celui qui manque le plus probablement dans un tableur construit à partir de la page du modèle.
Il n'y a ni API de traitement par lots ni remise sur les lots. La navigation de la documentation ne liste aucune surface de traitement par lots. Le seul chemin asynchrone, ce sont les réponses en arrière-plan, un mode de soumission avec son propre plafond et non un niveau remisé. Si vous prévoyiez avec les remises sur les lots que publient d'autres fournisseurs, cette économie n'existe pas ici.
Il n'y a pas d'offre de fine-tuning pour Muse Spark. La documentation des modèles liste trois ID de modèles d'inférence et rien d'autre. Le fine-tuning sur le site développeur de Meta relève des poids de Llama, un produit différent avec une autre structure de coûts.
Il n'y a pas de plafond de dépenses strict, et c'est la plainte qui a réellement empêché des gens de s'inscrire. Deux utilisateurs distincts de Hacker News ont dit la même chose le même jour.
"Unfortunately I find this too high risk, I entered my credit card, but can not set a limit. The best I can do is get an email alert. I feel like I am one oopsie away from getting a 100 dollar bill."
C'est un défaut d'expérience de facturation plutôt que de prix, et il se corrige en une après-midi, mais il faut savoir que sur un modèle dont tout l'argument repose sur des tokens bon marché, ce qui bloque la conversion est l'absence de plafond.
Comment se comparent les tarifs de Muse Spark 1.2
Les prix catalogue flattent et trompent dans les deux sens, la colonne qui compte est donc le coût mesuré par tâche sur un benchmark fixe. Voici Muse Spark face aux modèles avec lesquels il rivalise réellement, d'après le classement d'Artificial Analysis.
| Modèle | Intelligence Index | Coût par tâche | $/Mtok mixte | Entrée | Sortie |
|---|---|---|---|---|---|
| Claude Opus 5 (max) | 63.05 | $2.34 | $3.85 | $5.00 | $25.00 |
| GPT-5.6 Sol (max) | 60.93 | $1.23 | $4.35 | n/a | n/a |
| Kimi K3 (max) | 59.70 | $0.84 | $2.31 | $3.00 | $15.00 |
| Qwen3.8 Max | 58.08 | $1.13 | $1.18 | $2.00 | $6.00 |
| Muse Spark 1.2 (xhigh) | 56.76 | $0.40 | $0.78 | $1.25 | $4.25 |
| GPT-5.6 Terra (max) | 56.58 | $0.51 | $1.74 | n/a | n/a |
| Gemini 3.7 Flash (high) | 56.03 | $0.40 | $0.58 | $0.75 | $3.75 |
| GPT-5.6 Luna (max) | 52.32 | $0.05 | $0.17 | n/a | n/a |
| DeepSeek V4 Flash (max) | 51.77 | $0.11 | $0.23 | $0.44 | $1.32 |
La lecture côté acheteur est simple, et c'est une bonne nouvelle pour Meta. Muse Spark 1.2 est le modèle le moins cher de ce tableau avec un score supérieur à 56. Tout ce qui est plus intelligent coûte au moins 2,8 fois plus par tâche. Opus 5 coûte 5,9 fois plus. La comparaison la plus directe est GPT-5.6 Terra, qui score pratiquement pareil et coûte 0,51 $ contre 0,40 $ pour Muse Spark, Meta est donc 22 % moins chère à intelligence égale.
Une correction à signaler, car elle perturbe les comparaisons entre publications. Artificial Analysis mixe à 7:2:1 entre succès de cache, entrée et sortie sur ces pages, et non selon l'ancien ratio 3:1 entrée-sortie très répandu. Le calcul tient : (0.7 × $0.15) + (0.2 × $1.25) + (0.1 × $4.25) = $0.78. Si vous voyez un chiffre mixte cité avec une hypothèse 3:1, il n'est pas comparable à ce tableau.
Et GPT-5.6 Luna est la ligne qui casse toute histoire simple où bon marché signifierait faible : 0,05 $ par tâche, huit fois moins cher que Muse Spark, à 52,3 sur l'indice. Mon article sur GPT-5.6 Luna détaille ce à quoi il renonce pour y arriver.
Pour les lignes juste au-dessus de Muse Spark, les tarifs de Kimi K3 donnent la grille complète. L'option à poids ouverts à l'extrémité bon marché du tableau figure dans mon test de DeepSeek V4 Flash.
Ce que la grille tarifaire laisse de côté
Un article sur les tarifs doit être aussi clair sur les lacunes que sur les chiffres, car c'est dans les lacunes qu'un budget déraille.
La vitesse et la latence ne sont pas publiées pour la 1.2. Artificial Analysis n'a aucune mesure de vitesse de sortie, de délai avant le premier token ni de temps de réponse de bout en bout pour ce checkpoint, et le classement affiche un tiret dans les trois colonnes. Muse Spark 1.1 les a, à 225,9 tokens par seconde et 1,38 seconde avant le premier token, mais elles appartiennent à l'ancien checkpoint et ne doivent pas être attribuées à la 1.2. Si le temps de réponse entre dans votre analyse de coût, vous attendez des données qui n'existent pas encore.
Il n'y a pas de programme de rétention zéro des données. J'ai vérifié toute la navigation de la documentation et n'ai trouvé aucune page sur la rétention des données, la confidentialité ou le ZDR, ni en libre-service ni réservée aux ventes. Le contrôle le plus proche est un indicateur de stockage des réponses : store: false sur la Responses API empêche GET /v1/responses/{id} de renvoyer votre réponse, et Meta précise que cela "does not disable caching." Le niveau est le seul levier sur les données.
L'API est toujours en préversion publique. La page produit de Meta s'ouvre désormais sur "Public preview. Now available with expanded global access", ce qui vaut mieux que la formulation à restriction géographique du lancement, mais une préversion reste une préversion. Les tarifs et limites d'une surface en préversion sont susceptibles de changer, contrairement à une grille en disponibilité générale.
Et un point plus mineur qui compte si vous testez le niveau bon marché : l'accès peut être retiré. Un développeur a publié un 403 en plein travail, sans avertissement préalable, avec le message "Your access has been restricted due to repeated policy violations". Contributor est tarifé comme une promotion et verrouillé comme une promotion.
Ce qu'un développeur a réellement payé
Tout ce qui précède, ce sont des prix catalogue et des exécutions de benchmark. Le point de données le plus utile que j'aie trouvé est celui de quelqu'un qui rapporte le coût réel de sa session, ce qui est plus rare qu'il ne devrait.
"even with this subsidized pricing, less than an hour of usage resulted in slightly over $1 of cost (fig. 1). if i do this all month it'll be more expensive than the highest Anthropic/OpenAI subscription"
C'était sur le niveau contributor, le bon marché, celui que les gens qualifiaient d'absurdement sous-tarifé le jour du lancement. Une heure de travail de codage agentique a coûté plus d'un dollar à 0,10 $ par million de tokens d'entrée.
Le même constat est ressorti chez un praticien sur LinkedIn dans la journée suivant le lancement, présenté comme un avertissement et non comme un reçu.
"But token price isn't the full picture. What matters is cost per task. Different models burn different amounts of tokens to solve the same problem. We don't have that data yet for Muse Spark 1.2. Cheap tokens mean nothing if the model takes twice as many shots to get there."

Il l'a écrit avant que les données de coût par tâche n'existent. Les données sont arrivées et lui ont donné raison, dans une direction que personne n'avait prédite : la 1.2 brûle plus de tokens que son prédécesseur en répondant plus long, tandis que sa réflexion est devenue un peu moins chère.
Pourquoi les tokens sont la mauvaise unité pour une file de support
Cela fait trois ans que je regarde, chez eesel, l'IA travailler sur des files de support en direct, et en tout ce temps je n'ai jamais vu une équipe prévoir avec succès une facture de support à partir d'une grille au token. L'arithmétique est assez simple. C'est l'unité qui ne survit pas au contact d'un vrai ticket.
Un ticket résolu n'est pas un prompt. C'est de la récupération dans un centre d'aide et une bibliothèque de macros, une passe de classification de tickets, une passe de rédaction, généralement une nouvelle tentative quand le premier brouillon est faux, parfois un appel d'outil pour consulter une commande, puis toute la conversation reportée comme contexte quand le client répond. Chacune de ces étapes multiplie. Un tarif bas par token multiplié par un nombre inconnu d'étapes n'est pas un budget, c'est un espoir. Le modèle que vous choisissez compte bien moins que cette structure, comme je l'ai soutenu en choisissant le meilleur modèle pour les tickets de support.
Et on peut voir cela déraper sur des chiffres réels. Les équipes de support sous-estiment régulièrement d'un facteur, et celles qui s'en mordent le plus les doigts sont celles qui ont le plus gros volume, précisément parce que le multiplicateur s'accumule. C'est le même piège structurel que l'histoire de Muse Spark 1.2 : le tarif est resté fixe et la consommation a bougé. Mon analyse du coût du service client par IA donne un tableau plus complet de ce que les équipes finissent par payer.
C'est pourquoi eesel facture 1 crédit par ticket, quelle que soit sa longueur, plutôt qu'au token ou au siège, et c'est la première chose que je dis à quiconque arrive avec une grille au token en main. Une résolution est l'unité que l'entreprise compte déjà, elle correspond à quelque chose qu'un responsable du support peut défendre en réunion budgétaire, et elle ne se retarife pas en silence quand un modèle se met à écrire des réponses plus longues. Le même argument sous-tend mon approche du coût par résolution.
C'est aussi pourquoi le compteur doit se trouver sur le système de ticketing plutôt que sur le modèle, et pourquoi la comparaison honnête pour un responsable du support se fait avec une personne et non avec une API. Je l'ai développé dans le coût de l'IA face à un agent humain.
L'autre moitié consiste à connaître le chiffre avant de s'engager. Je simule chaque déploiement d'abord sur les tickets historiques du client, ce qui donne un taux de résolution et un coût sur du trafic réel plutôt que sur un benchmark. Cette habitude vient de ce que j'ai vu des bots à l'air sûr d'eux donner discrètement de mauvaises réponses en production, une discipline à part couverte dans prévenir les hallucinations de l'IA, et qui résout aussi, par la même occasion, le problème de prévision. On en parle davantage dans le guide construire ou acheter, qui est la décision que prennent réellement la plupart des lecteurs d'une grille tarifaire.
Essayer eesel
Si vous chiffrez Muse Spark 1.2 parce que vous prévoyez de construire de l'automatisation du support sur une API de modèle brute, le tarif au token est le chiffre le moins intéressant du projet. eesel se place sur votre helpdesk, lit votre base de connaissances existante et vos tickets passés, et commence à résoudre les conversations de première ligne en quelques minutes, à 1 crédit par ticket, de sorte que la facture suit le travail accompli et non les tokens dépensés.
La partie à essayer en premier est la simulation. Pointez-la sur votre historique de tickets, et avant que quoi que ce soit n'approche un client, vous obtenez un taux de résolution et un coût projeté sur votre propre trafic, soit la prévision qu'une grille au token ne peut structurellement pas vous donner.

Un responsable technique passé exactement par cette décision a exposé son raisonnement simplement. Anonymisé, il dirige une entreprise de matériel de distributeurs de Bitcoin avec une base de connaissances de plus de 300 articles sur Confluence et Telegram :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Essai gratuit, et vous voyez les chiffres simulés avant de décider quoi que ce soit.
Le verdict sur les tarifs de Muse Spark 1.2
À 1,25 $ en entrée et 4,25 $ en sortie, Muse Spark 1.2 est le meilleur rapport qualité-prix du classement de pointe au-dessus de 56 sur l'indice d'intelligence, et Meta mérite des félicitations pour ne pas avoir retarifé lors de la mise à niveau, pour ne rien facturer en plus sur le contexte long et pour avoir rendu le caching automatique plutôt que source de configuration.
Ce qu'il faut intégrer dans la planification, c'est que le modèle est devenu 37 % plus cher à faire tourner sans changement de prix, parce qu'il répond 78 % plus long que la 1.1. Plafonnez vos tokens de sortie, surveillez ce que votre chaîne de prompts reporte, et vérifiez votre pic de requêtes par minute avant de supposer que le niveau contributor vous est ouvert.
Et si la charge est une file de support, chiffrez-la en résolutions. C'est la seule unité qui ait jamais survécu à une vraie facture.