Les tarifs de Gemini 4 Argon en un coup d'œil
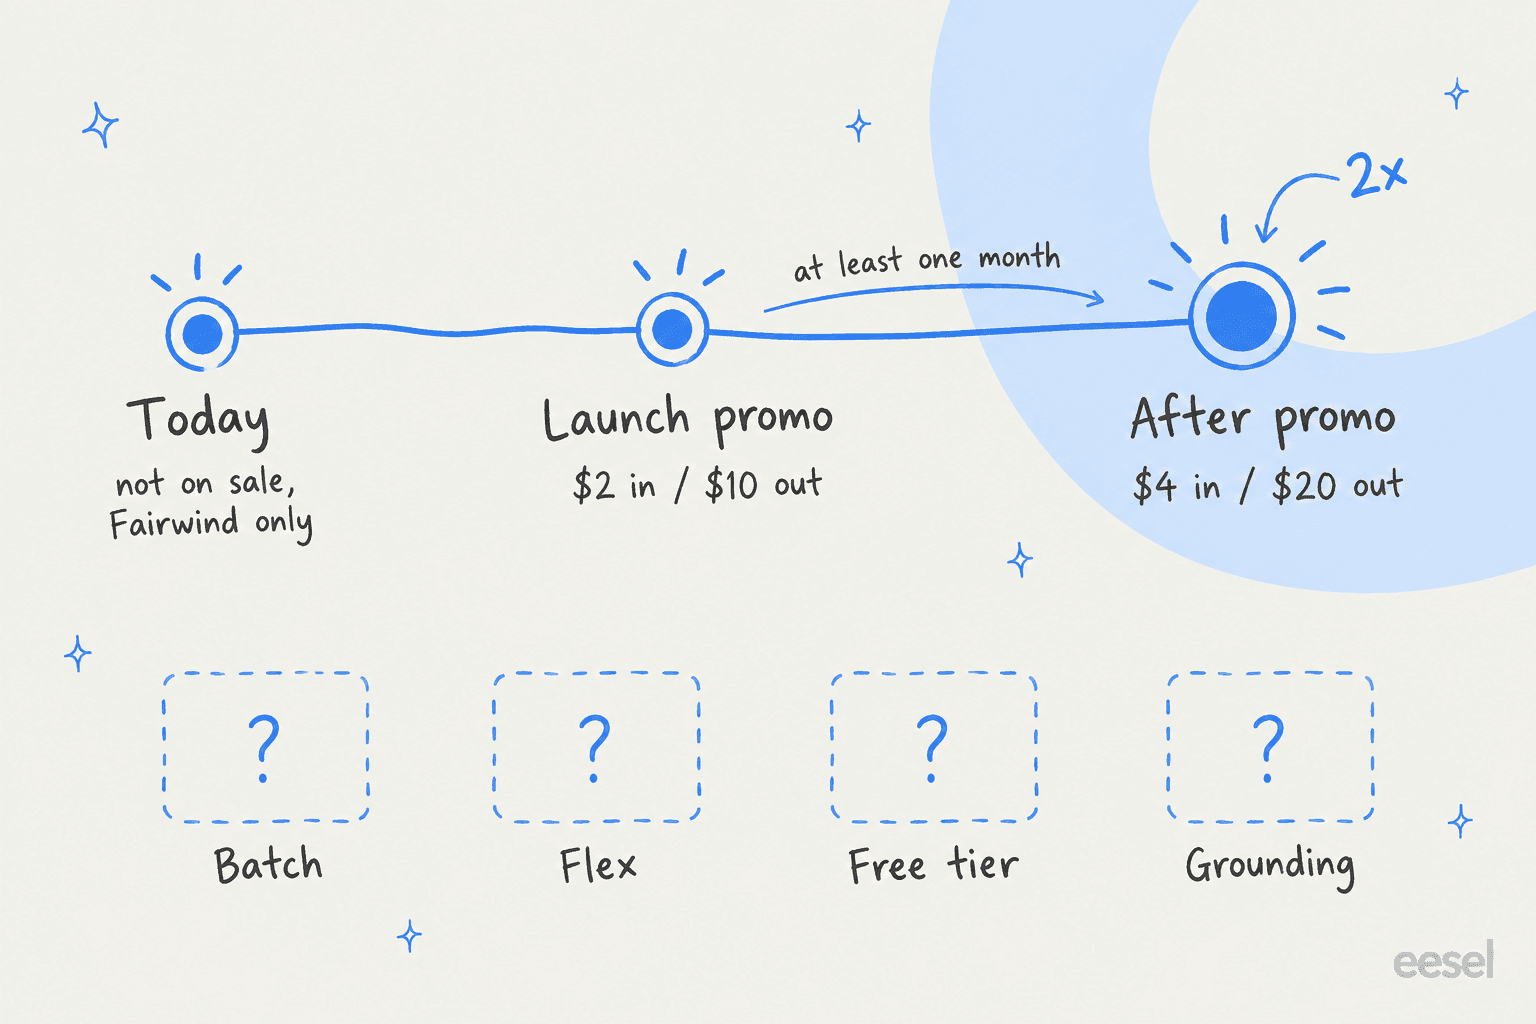
Google a annoncé Argon le 30 septembre 2026. Tout le prix tient en une seule ligne de l'article de lancement plus une note de bas de page. Voici tout ce que Google a publié jusqu'ici, dans un tableau :
| Tarif de lancement | Après la promo | |
|---|---|---|
| Entrée, par 1M de tokens | 2,00 $ | 4,00 $ |
| Entrée en cache, par 1M de tokens | 0,10 $ (95 % de remise) | 0,20 $ (95 % de remise) |
| Sortie, par 1M de tokens (raisonnement inclus) | 10,00 $ | 20,00 $ |
| Supplément contexte long | Aucun publié | Aucun publié |
| Batch / Flex / Priority | Non publié | Non publié |
| Offre gratuite | Non publiée | Non publiée |
| Fenêtre de contexte / sortie max | 1M / 1M de tokens | 1M / 1M de tokens |
| Qui peut acheter | Personne pour l'instant | Clients payants de l'API d'abord |
La note de bas de page dit : "After the introductory period expires, the price of $4 per 1M input tokens and $20 per 1M output tokens will apply." Le tarif de cache de 0,20 $ post-promo vient de mon propre calcul à partir du « 95% off input token price » de Google, et il correspond au chiffre du détail des coûts d'Artificial Analysis. Artificial Analysis décrit la remise comme une promotion de 50 % « pour au moins un mois » et note aussi que la remise sur le cache est passée de 90 % sur Gemini 3.8 Flash.
Si vous voulez les caractéristiques derrière le prix (benchmarks, sécurité et qui fait partie du Fairwind Program), mon aperçu de Gemini 4 Argon les couvre. Ici, je m'en tiens à l'argent.
Peut-on vraiment le payer déjà ?
Non. C'est bon à savoir avant de saisir le moindre chiffre dans un tableur. Argon est "rolling out to a set of trusted cyber defenders" via le Fairwind Program de Google. Les clients payants de l'API et les abonnés Google AI Ultra sont les suivants, et Google n'a donné de date pour aucun des deux groupes.
Je l'ai revérifié le 1er octobre 2026. Un appel generateContent vers gemini-4-argon avec ma clé d'API Gemini a renvoyé 404 NOT_FOUND, et aucun Argon n'apparaissait dans la liste des modèles. La page des tarifs de l'API Gemini pour développeurs s'arrête toujours à 3.8 Flash et 3.1 Pro :
Côté grand public, ce n'est pas plus proche. La page des abonnements Gemini liste Google AI Plus à 4,99 $ par mois, Google AI Pro à 19,99 $ et Ultra à 99,99 $ (5 fois les limites de Pro) ou 199,99 $ (20 fois), et le meilleur modèle qu'elle cite reste 3.1 Pro. Si c'est un accès grand public que vous visez, Ultra est la seule offre que Google ait nommée. Pourtant, rien sur cette page ne promet Argon à qui que ce soit.
Comment Gemini 4 Argon se compare au prix par token
Rien que sur la grille tarifaire, Argon se retrouve à une place étrange : son prix promo est celui de GPT-6.1 Sol, et son prix standard est celui de Claude Opus 5.5. Ci-dessous figurent les tarifs d'API publiés pour chaque modèle du tableau comparatif de Google, ainsi que pour les moins chers auxquels on le compare souvent. Les guides complets des tarifs de l'API OpenAI et des tarifs de l'API Anthropic donnent le reste :
| Modèle | Entrée / 1M | Entrée en cache / 1M | Sortie / 1M | Source |
|---|---|---|---|---|
| Gemini 4 Argon (promo) | 2,00 $ | 0,10 $ | 10,00 $ | |
| Gemini 4 Argon (standard) | 4,00 $ | 0,20 $ | 20,00 $ | |
| GPT-6.1 Sol | 2,00 $ | 0,10 $ | 10,00 $ | OpenAI |
| GPT-6 Astra | 10,00 $ | 1,00 $ | 50,00 $ | OpenAI |
| Claude Opus 5.5 | 4,00 $ | 0,20 $ | 20,00 $ | Anthropic |
| Claude Fable 5.1 | 10,00 $ | 0,25 $ | 50,00 $ | Anthropic |
| Claude Sonnet 5.5 | 2,00 $ | 0,20 $ | 10,00 $ | Anthropic |
| Gemini 3.8 Flash | 0,75 $ | 0,075 $ | 3,75 $ |
Deux ou trois choses ressortent. D'abord, la réaction sur Hacker News ("5x cheaper than Astra") est juste au token, et c'est exactement la comparaison que Google veut vous voir faire. À côté de GPT-6 Astra et de Claude Fable 5.1, Argon en promo coûte un cinquième.
Ensuite, l'écart se referme vite. Au tarif standard, Argon reste à 40 % du tarif au token d'Astra, mais il est au même niveau qu'Opus 5.5, qui se situe environ 5 points plus haut sur l'indice d'Artificial Analysis à effort maximal. Gemini 3.8 Flash a aussi sa propre horloge : la page des tarifs de Google indique que ses 0,75 $/3,75 $ doublent à 1,50 $/7,50 $ le 1er janvier 2027. Donc, pour quiconque construit un budget 100 % Google pour l'an prochain, les deux lignes montent.
Un détail plus modeste compte si vous travaillez sur de longs documents. Gemini 3.1 Pro facture 4 $/18 $ dès qu'un prompt dépasse 200K tokens, et OpenAI facture les prompts de plus de 272K au double en entrée. Google n'a publié aucun supplément contexte long pour Argon. C'est peut-être une vraie caractéristique, peut-être simplement pas encore écrit. Vérifiez la grille finale avant de compter dessus.
Le chiffre qui compte : le coût par tâche
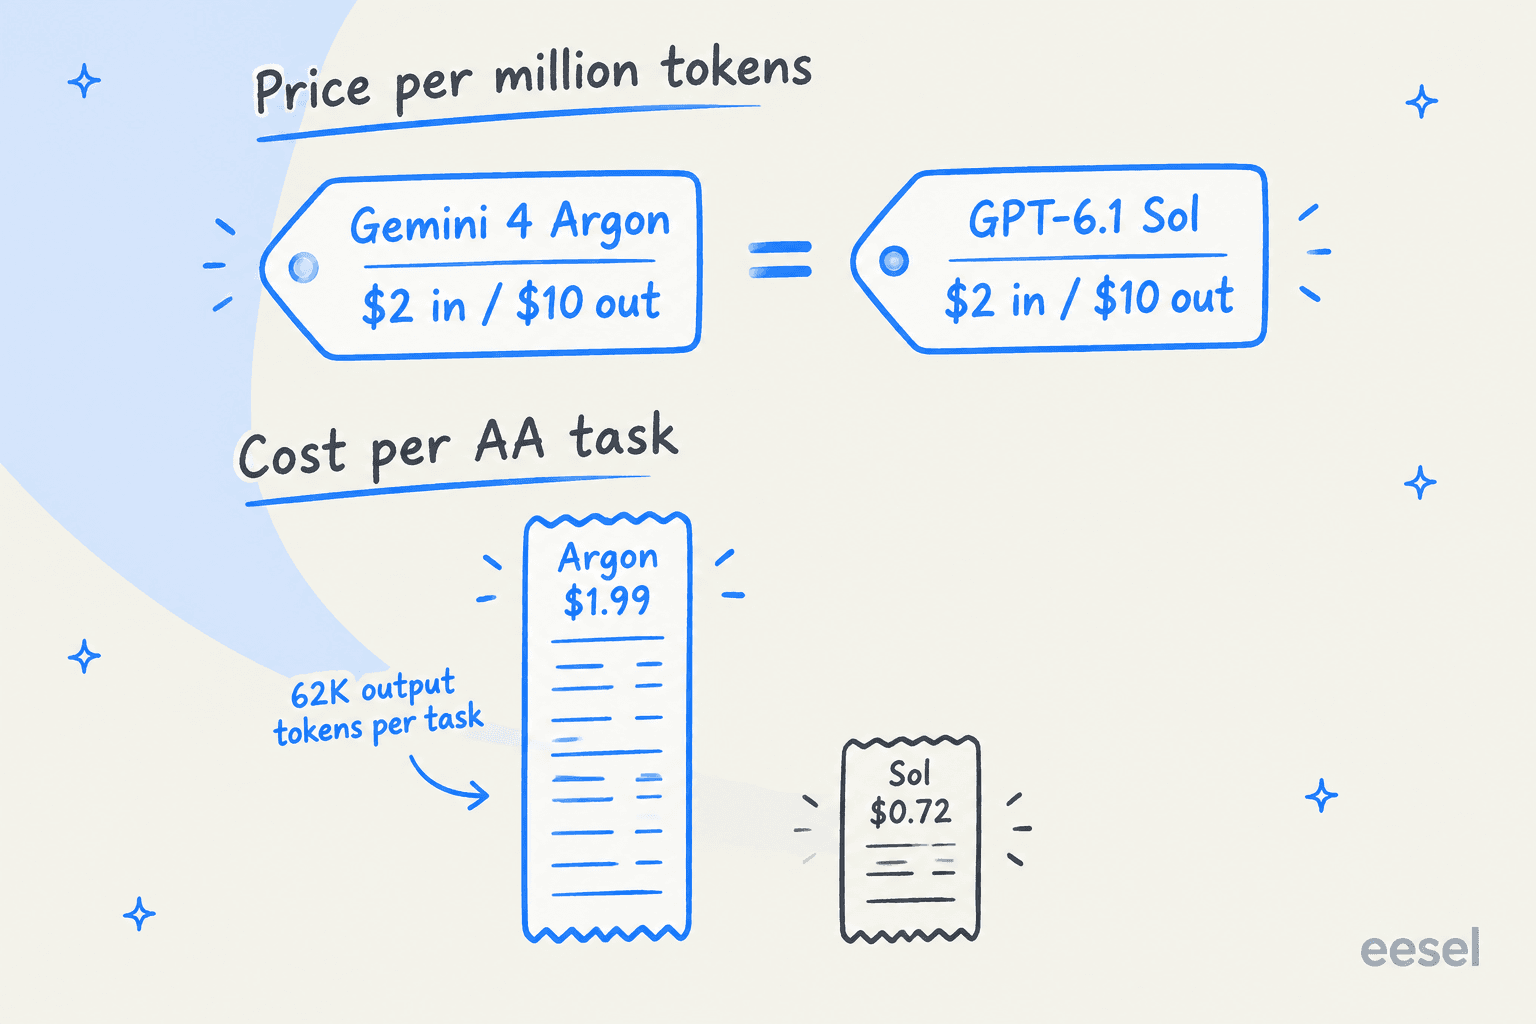
Un prix par token vous dit ce que coûte un mot. Il ne dit rien sur le nombre de mots que le modèle utilise, et Argon en utilise beaucoup. Artificial Analysis a passé son indice complet sur Argon et a relevé 62K tokens de sortie par tâche, contre 27K pour GPT-6 Astra. Sur l'ensemble de l'indice, il a produit 110M de tokens, quand le modèle médian en utilise 82M.
C'est ainsi qu'une même grille tarifaire donne des factures très différentes. Voici ce qu'Artificial Analysis a mesuré pour chaque tâche de l'indice :
| Modèle et réglage | AA Intelligence Index | Coût par tâche |
|---|---|---|
| GPT-6.1 Sol (max) | 52 | 0,72 $ |
| Claude Opus 5.5 (high) | 54 | 1,82 $ |
| Gemini 4 Argon (high), prix promo | 53 | 1,99 $ |
| GPT-6 Astra (max) | 53 | 3,26 $ |
| Gemini 4 Argon (high), prix standard | 53 | 3,98 $ |
Les lignes Sol, Astra et Argon proviennent de l'article d'Artificial Analysis ; la ligne Opus 5.5 high est le chiffre qu'un commentateur de Hacker News a tiré du même graphique AA le jour du lancement. Ma lecture : Argon et Sol paient des prix identiques par token, donc l'écart de 2,7x vient presque entièrement du fait qu'Argon écrit davantage.
Artificial Analysis a aussi publié un graphique en cascade montrant d'où vient le coût d'Argon. Il part de Gemini 3.1 Pro Preview à 0,67 $ par tâche :
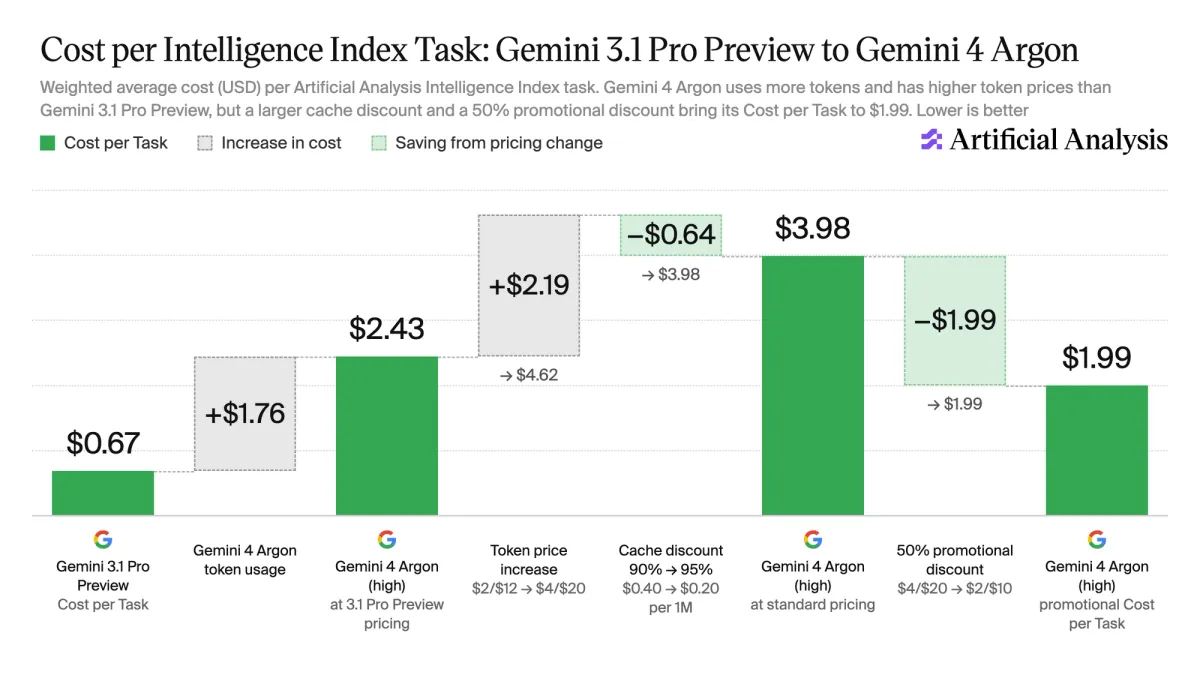
La première barre est celle que je montrerais à un responsable financier. Même aux anciens prix de 3.1 Pro, les tokens supplémentaires à eux seuls feraient passer une tâche de 0,67 $ à 2,43 $. Ensuite, la promo masque l'essentiel de la hausse de prix. Sans la promo, une tâche coûte environ 6 fois ce que coûtait le précédent modèle Pro.
Un commentateur de Hacker News l'avait anticipé avant même la sortie des chiffres AA :
"watch it somehow use 20x more tokens tho"

Ce n'est pas 20x, plutôt 2,3x la sortie d'Astra. L'instinct était pourtant bon, et il correspond à ce que j'ai vu avec Gemini 3.8 Flash, lui aussi bavard sur l'indice.
Exemples chiffrés : ce que coûte Argon sur des charges réelles
Les prix affichés prennent du sens quand on met quelques exécutions concrètes à côté. Chaque exemple ci-dessous utilise les tarifs publiés par Google et les mêmes nombres de tokens pour tous les modèles. Cela avantage un peu Argon, puisqu'il a tendance à écrire davantage.
1. Une exécution d'agent lourde. Imaginez un agent qui lit 200K tokens de contexte et écrit 60K tokens de sortie, proche de la moyenne de 62K d'Argon. Au prix promo, cela fait 0,40 $ en entrée plus 0,60 $ en sortie, soit 1,00 $ par exécution. Si vous mettez le contexte en cache, la partie entrée tombe à 0,02 $ et l'exécution coûte 0,62 $. À 1 000 exécutions par mois, la fin de la promo vous fait passer de 620 $ à 1 240 $.
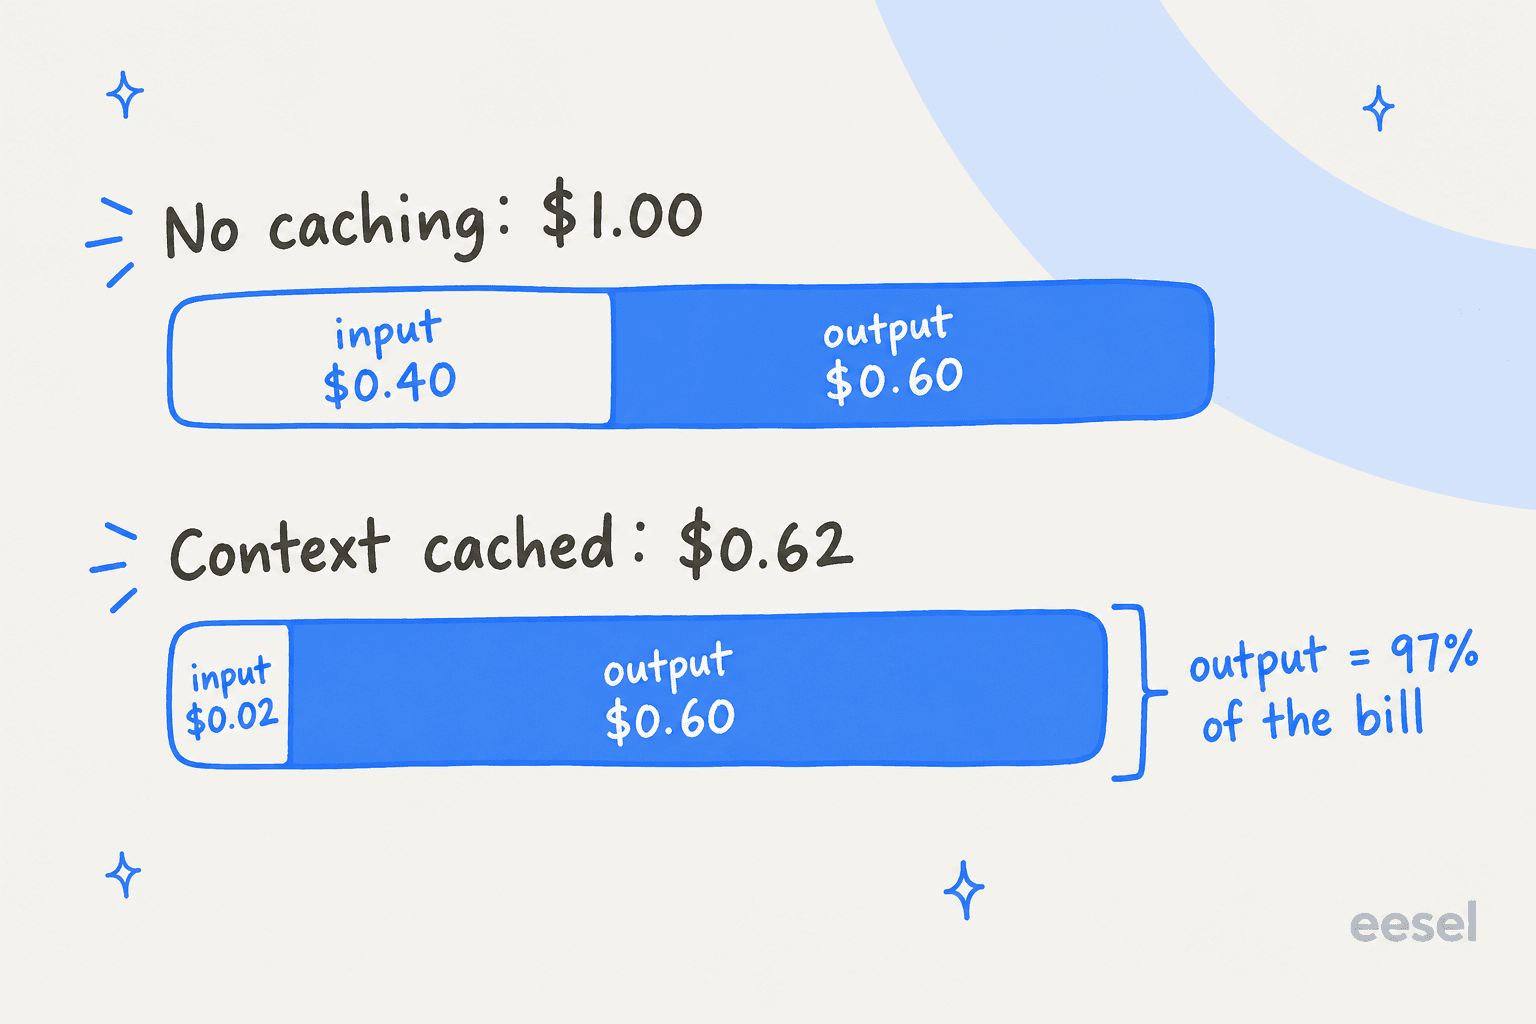
C'est le schéma habituel du travail d'agent : une fois le cache en place, la sortie représente environ 97 % de la facture. La remise de 95 % sur le cache est généreuse, mais elle ne s'applique qu'à la partie de la facture qui était déjà petite. Pour rendre Argon moins cher, visez des sorties plus courtes, pas plus de cache.
2. Une revue de documents longs. Imaginez envoyer un lot de contrats de 800K tokens et recevoir un résumé de 10K tokens, 500 fois par mois. Argon en promo : 1,60 $ + 0,10 $ = 1,70 $ par exécution, 850 $ par mois. Au tarif standard, 1 700 $. Aux tarifs de Gemini 3.1 Pro au-delà de 200K, la même exécution coûte 3,38 $, et le tarif de GPT-6.1 Sol au-delà de 272K donne 3,35 $. Donc, si Google maintient Argon sans supplément contexte long, c'est là qu'il est le moins cher face à la concurrence, même au prix plein.
3. Un ticket de support. Celui-ci, je peux l'appuyer sur un vrai test. Plus tôt cette semaine, j'ai passé 15 tickets de support dans GPT-6.1 Sol pour mon test de GPT-6.1 Sol. En moyenne, chacun a utilisé environ 545 tokens en entrée et 70 en sortie, et le lot a coûté environ 1,80 $ pour 1 000 tickets. Argon en promo a exactement la même grille, donc ces mêmes tokens coûtent les mêmes 1,80 $. Si Argon écrit 2,7 fois plus en sortie, comme le suggère l'écart AA, on arrive à environ 3 $ pour 1 000 tickets. Après la promo, doublez les deux chiffres. À titre de comparaison, GPT-6 Astra a mesuré 9,09 $ pour 1 000 dans le même test.
Je n'ai pas pu exécuter Argon lui-même, puisque l'API renvoie 404. Considérez donc le troisième exemple comme un repricing et non comme un résultat de test. Quand l'accès payant ouvrira, je relancerai les mêmes tickets.
Calculateur de coût de Gemini 4 Argon
Saisissez vos propres nombres de tokens. Les préréglages correspondent aux trois exemples ci-dessus. Les prix suivent les grilles publiées par Google, OpenAI et Anthropic, pour des prompts de moins de 200K tokens.
Quelques points à surveiller en jouant avec. Montez les tokens de sortie et Argon en promo égale Sol et coupe Opus 5.5 de moitié, mais cochez la case 2,3x et l'essentiel de cette avance disparaît. Sur le préréglage document long, l'absence de supplément publié pour Argon aide plus la facture que n'importe quelle remise.
Les coûts cachés et les questions ouvertes
La grille est courte, donc une plus grande part du coût réel reste inconnue. Voici ce que je surveillerais avant d'engager un budget :
- La date de fin de la promo. « Au moins un mois » selon Artificial Analysis, aucune date de la part de Google. Toute prévision qui dépasse la fin octobre devrait utiliser 4 $/20 $.
- La verbosité. 62K tokens de sortie par tâche AA. Votre charge peut être différente, mais la facture se trouve dans la sortie, donc mesurez d'abord cela.
- Les offres manquantes. Pas encore de tarif Batch, Flex ou Priority. Sur Gemini 3.8 Flash, Batch et Flex sont à moitié prix et Priority est à 1,8x, donc les tâches hors ligne pourraient devenir bien moins chères une fois que Google les publiera.
- Le grounding. Le grounding Google Search sur Gemini 3.x, c'est 5 000 requêtes gratuites par mois, puis 14 $ pour 1 000. Pour Argon, aucun tarif n'est encore publié.
- Le stockage du cache. Gemini 3.8 Flash facture un tarif par million de tokens et par heure de stockage du cache, en plus des lectures de cache. Le tarif de stockage d'Argon n'est pas sorti non plus, et avec un contexte de 1M de tokens, cela peut s'accumuler.
Le fil Hacker News a vite abordé la question de la promo. Quelqu'un a salué le prix de sortie de 10 $, et la réponse a été brève :
"That is a promotional price. The regular price is double that."
D'autres sont allés directement au coût par tâche, ce qui me semble le meilleur réflexe :
"It's also more token hungry than similar models, so does it really make a big difference in the end?"
Gemini 4 Argon vaut-il son prix ?
Pour certaines charges, oui, même à 4 $/20 $. Le travail sur de longs documents est le cas le plus clair : Argon domine le tableau de Google sur la récupération avec un contexte de 256K à 1M (84,2 % contre les 60 et quelques et les 70 bas de la concurrence) et n'a aucun supplément contexte long publié, donc une chaîne de traitement de contrats ou de dépôts réglementaires obtient un meilleur modèle et aussi une facture plus basse qu'avec 3.1 Pro. Les agents juridiques et financiers ont aussi un argument, car Argon devance d'environ 3x le Legal Agent Benchmark de Harvey.
Pour le travail d'agent général et le code, j'attendrais de vrais chiffres. Aux prix promo, vous payez 2,7x GPT-6.1 Sol par tâche pour gagner un point sur l'indice AA. Aux prix standard, vous payez la grille d'Opus 5.5 pour un modèle qui reste 9 points derrière Opus 5.5 sur Terminal-Bench 4.0 dans le tableau de Google lui-même. Si vous avez besoin d'un modèle de pointe moins cher aujourd'hui, les comparatifs des alternatives à GPT-6.1 Sol et des alternatives à Gemini couvrent ce qui est en vente aujourd'hui.
Pour le support client, le prix d'Argon importe à peine. À quelques dollars pour 1 000 tickets, le modèle est la plus petite ligne d'une décomposition du coût du service client par IA. Le taux d'hallucination d'Argon de 15 % sur AA-Omniscience, contre 51 % pour GPT-6 Astra, est le chiffre le plus intéressant pour le support. Même celui-ci n'aide que si l'agent autour lit les bonnes connaissances et passe la main quand il ne connaît pas la réponse. Le guide sur les hallucinations de l'IA dans le support couvre cette partie.
Ce que cela signifie si vous dirigez une équipe de support
J'ai passé beaucoup de temps à mettre de l'IA sur des files de support en production chez eesel, et le prix du modèle a presque jamais décidé si un déploiement réussissait. Ce qui décide, c'est tout ce qui entoure le modèle : le centre d'aide et les anciens tickets dont il apprend, la façon dont il se connecte à Zendesk ou à Freshdesk, et s'il a été testé sur de vrais tickets avant de toucher un client. Le coût par résolution tient surtout aux personnes et aux processus, pas aux tokens.
Là où une promo comme celle d'Argon change quelque chose, c'est la prévisibilité. Si vous construisez votre propre bot sur des tokens bruts, vous possédez désormais une facture qui double à une date que personne n'a annoncée, et vous suivez en plus quel modèle est le meilleur ce mois-ci. Pour une équipe d'ingénierie qui fait tourner des agents, c'est acceptable. Pour un responsable support qui a besoin d'un chiffre pour le budget du trimestre prochain, c'est mal adapté.

Essayez eesel
Si vous évaluez le prix de Gemini 4 Argon parce que vous voulez qu'une IA réponde aux tickets, vous pouvez sauter le calcul de tokens. Argon est de l'infrastructure ; eesel est l'employé. Le coéquipier IA de helpdesk d'eesel apprend de vos anciens tickets et de votre centre d'aide et se branche sur le helpdesk que vous utilisez déjà. Il lance aussi une simulation sur vos vrais anciens tickets pour que vous puissiez vérifier ses réponses avant qu'il ne réponde à un client.
La tarification est un forfait de crédits mensuel fixe où un ticket ou un chat vaut un crédit. Toutes les fonctionnalités et des sièges illimités sont inclus, et il existe un forfait gratuit avec 100 crédits et sans carte. Si la promo d'un modèle se termine sous vos pieds, votre facture reste la même. Essayez eesel sur une tranche de votre file et voyez comment il traite vos propres tickets.
Questions fréquentes
Combien coûte Gemini 4 Argon ?
Quand le prix promo de Gemini 4 Argon se termine-t-il ?
Peut-on payer Gemini 4 Argon aujourd'hui ?
gemini-4-argon et le modèle ne figure pas sur la page des tarifs de l'API de Google. Il est déployé d'abord auprès de défenseurs cyber, puis des clients payants de l'API et des abonnés Google AI Ultra, sans date.Gemini 4 Argon est-il moins cher que GPT-6.1 Sol ?
Gemini 4 Argon est-il moins cher que Claude Opus 5.5 ?
Gemini 4 Argon a-t-il des tarifs batch ou une offre gratuite ?
Combien coûterait Gemini 4 Argon pour le support client ?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.