

GPT-6.2 Astra coûte 8 $ par million de tokens en entrée, 0,40 $ en cache et 40 $ en sortie, 20 % sous le tarif catalogue de GPT-6 Astra. Le plus grand changement est l'entrée mise en cache, en baisse de 60 %. Sur un agent de support qui réutilise un prompt de 12 500 tokens, cela le rend environ 35 % moins cher par ticket (21,80 $ contre 33,50 $ pour 1 000), mais seulement si le cache touche vraiment : un échec coûte plus de 5 fois plus.
Surveillez trois compteurs : les prompts de plus de 272 000 tokens, le mode Fast, et Ultrafast, qui passe de 3x à 6x Standard le 1er mars 2027. Pour la plupart du travail de support, GPT-6.2 Sol fait le même travail pour un quart du prix.
Combien coûte GPT-6.2 Astra ?
GPT-6.2 Astra coûte 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie au palier Standard, avec une entrée mise en cache à 0,40 $. OpenAI l'a lancé le 17 novembre 2026 avec GPT-6.2 Sol, le successeur de GPT-6.1 Sol. Le billet de lancement décrit le prix comme « une remise de 20 % sur les tokens d'entrée et de sortie, et une remise plus profonde de 60 % sur les tokens d'entrée mis en cache » face à GPT-6 Astra.
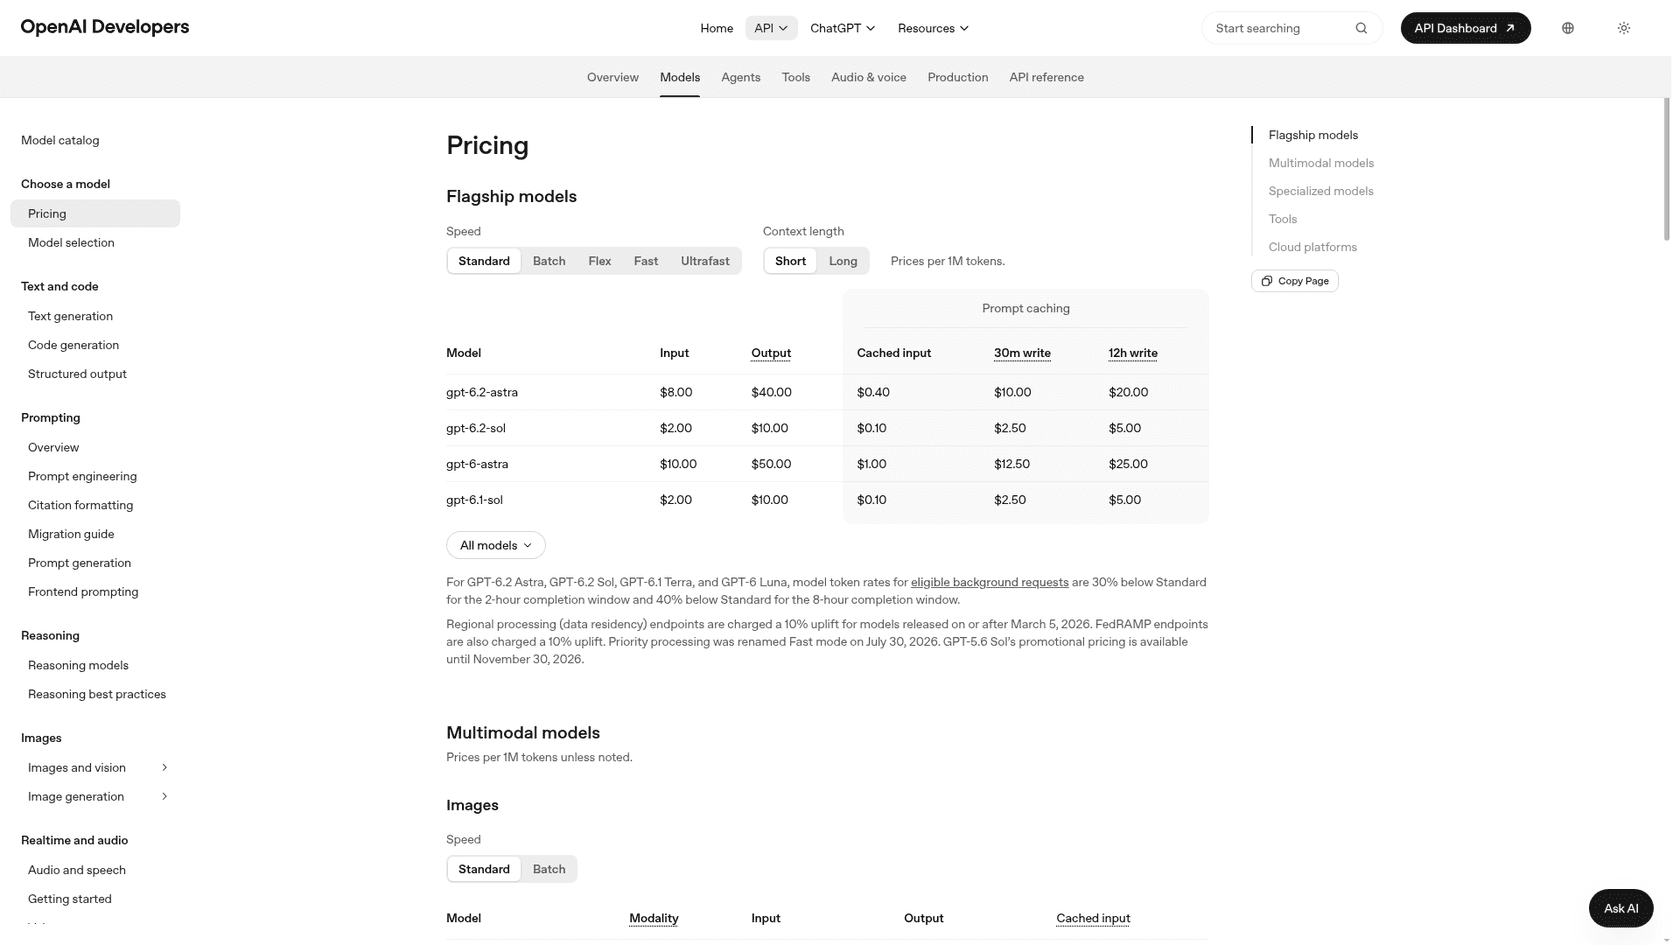
Je construis des intégrations et la connexion aux API chez eesel, et je mets des agents IA sur des files de support en direct depuis plusieurs années, donc la première chose que je fais avec le prix d'un nouveau modèle, c'est de le convertir en coût par ticket. Le tarif catalogue par million de tokens ne dit presque rien tant qu'on ne sait pas sur quel compteur chaque token tombe. Voici chaque compteur de la page tarifaire d'OpenAI et de la page du modèle GPT-6.2 Astra, par million de tokens :
| Palier | Entrée | Entrée mise en cache | Écriture de cache 30 min | Écriture de cache 12 h | Sortie |
|---|---|---|---|---|---|
| Standard | 8,00 $ | 0,40 $ | 10,00 $ | 20,00 $ | 40,00 $ |
| Standard, plus de 272 000 en entrée | 16,00 $ | 0,80 $ | n/a | n/a | 60,00 $ |
| Batch | 4,00 $ | 0,20 $ | 5,00 $ | 10,00 $ | 20,00 $ |
| Fast | 16,00 $ | 0,80 $ | 20,00 $ | 40,00 $ | 80,00 $ |
| Ultrafast (jusqu'au 28 fév. 2027) | 24,00 $ | 1,20 $ | 30,00 $ | 60,00 $ | 120,00 $ |
| Ultrafast (à partir du 1er mars 2027) | 48,00 $ | 2,40 $ | 60,00 $ | 120,00 $ | 240,00 $ |
| Flex | Non proposé |
La ligne contexte long vient de la page du modèle, qui indique qu'au-delà de 272 000 tokens en entrée, « les tarifs d'entrée et de cache doublent et la sortie coûte 1,5 fois le tarif contexte court pour toute la requête ». Elle ne liste pas de tarifs d'écriture de cache en contexte long, donc j'ai laissé ces cases vides plutôt que de deviner.
Le modèle lui-même a une fenêtre de contexte de 1 050 000 tokens, 922 000 tokens d'entrée maximum, et 128 000 tokens de sortie maximum. Une autre ligne de la page du modèle affecte le coût : l'API rejette les requêtes qui fixent l'effort de raisonnement à none, donc vous ne pouvez pas désactiver le raisonnement pour économiser des tokens de sortie comme le faisaient certaines équipes sur d'anciens modèles. Les tokens de raisonnement sont facturés comme de la sortie, selon le guide du raisonnement d'OpenAI.
De quoi êtes-vous exactement facturé ?
Vous êtes facturé par token sur quatre compteurs distincts, et ils coûtent des montants très différents. Chaque requête se divise en :
- Tokens d'entrée à 8 $ par million : tout ce qui est nouveau dans le prompt, comme le message du client.
- Entrée mise en cache à 0,40 $ par million : le début du prompt qui correspond exactement à une requête récente, comme vos instructions et le texte du centre d'aide.
- Écritures de cache à 10 $ (30 minutes) ou 20 $ (12 heures) par million : la première fois qu'un préfixe réutilisable est enregistré.
- Tokens de sortie à 40 $ par million : la réponse, plus tout raisonnement que le modèle fait avant.
Le guide de cache des prompts d'OpenAI précise qu'une écriture de cache « n'est pas des frais additionnels ». Chaque token d'entrée est facturé une seule fois, au tarif non mis en cache, mis en cache, ou d'écriture. Le préfixe minimal pouvant être mis en cache est de 1 024 tokens pour GPT-5.6 et les modèles suivants.
L'écart entre ces compteurs est toute l'histoire. Un token mis en cache coûte un vingtième d'un token d'entrée frais et un centième d'un token de sortie. La forme de votre prompt compte donc plus que le prix catalogue affiché.
De combien est-il moins cher que GPT-6 Astra en pratique ?
Sur toute charge qui réutilise un long prompt, GPT-6.2 Astra est environ 35 % moins cher que GPT-6 Astra, pas 20 %. L'économie supplémentaire vient de la baisse sur l'entrée mise en cache.
Pour vérifier, j'ai calculé le prix d'un appel typique d'agent de support. Chaque ticket envoie un préfixe de 12 500 tokens (instructions plus contenu du centre d'aide, de la même taille que le test de cache que j'ai fait le jour du lancement), 600 tokens d'entrée nouvelle, et 300 tokens de sortie incluant le raisonnement. En supposant que le préfixe touche le cache :
| Modèle | Entrée mise en cache | Entrée | Sortie | Par ticket | Pour 1 000 tickets |
|---|---|---|---|---|---|
| GPT-6 Astra | 1,00 $ | 10 $ | 50 $ | 0,0335 $ | 33,50 $ |
| GPT-6.2 Astra | 0,40 $ | 8 $ | 40 $ | 0,0218 $ | 21,80 $ |
| GPT-6.2 Sol | 0,10 $ | 2 $ | 10 $ | 0,0055 $ | 5,45 $ |
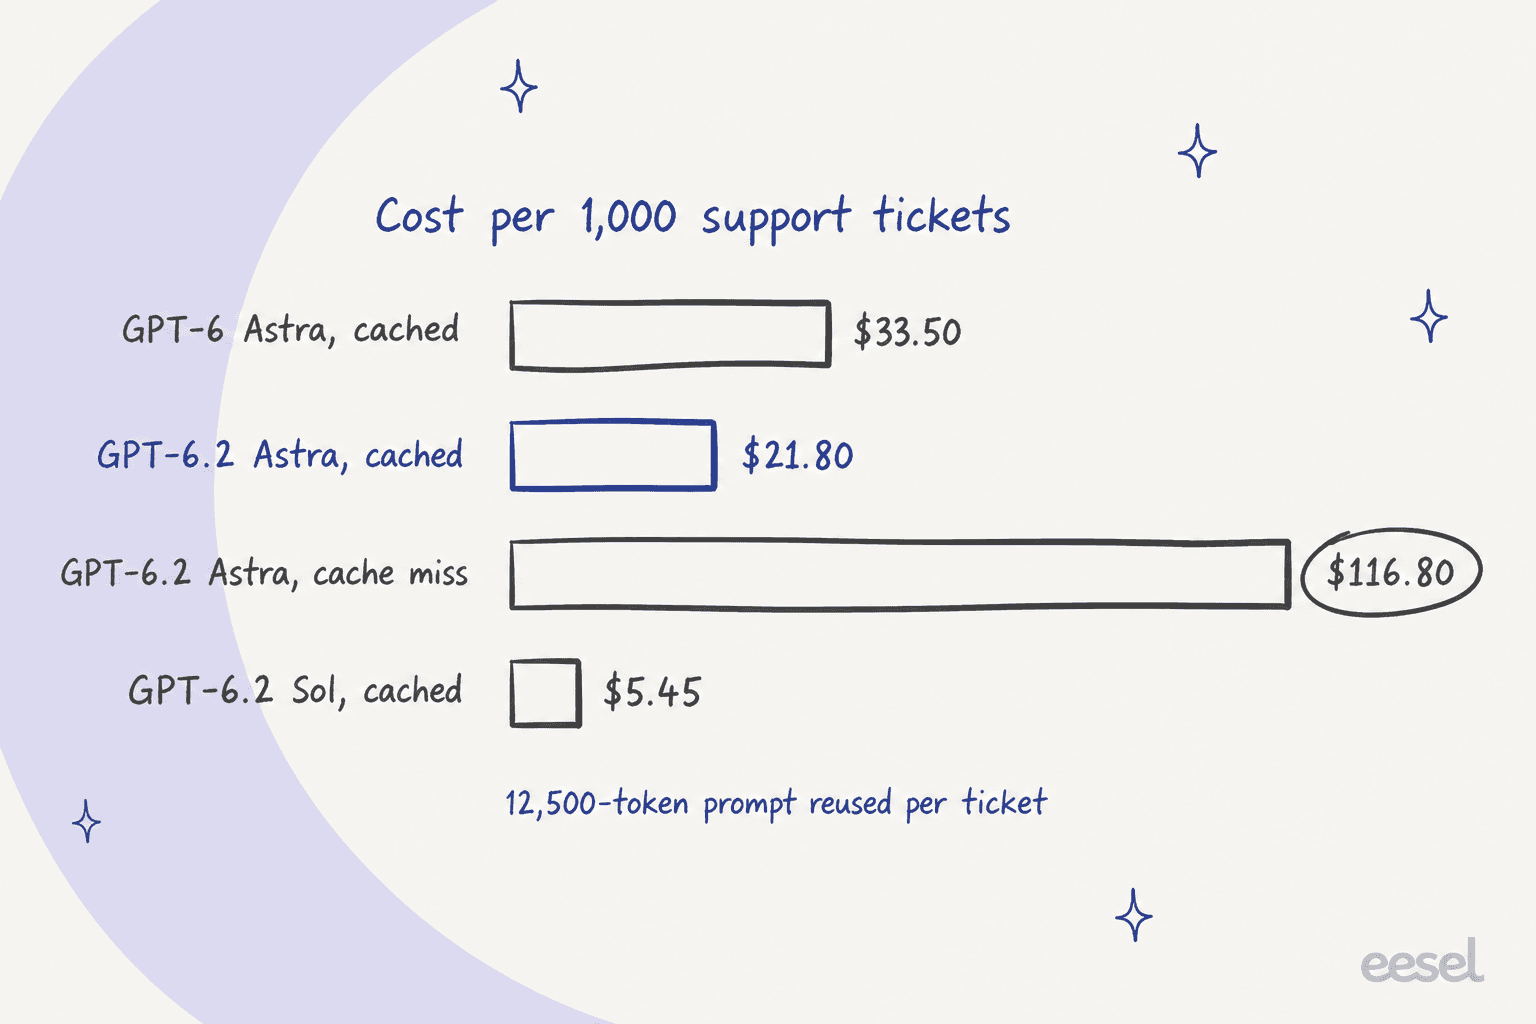
Deux choses ressortent. La première, c'est que le prompt réutilisé domine la facture. Dans mon test du jour de lancement de GPT-6.2 Astra, avec un minuscule prompt de 278 tokens sans centre d'aide, 1 000 tickets ont coûté 5,79 $ à effort moyen. Ajoutez les connaissances dont un agent a vraiment besoin, et le prix monte d'environ 4 fois, même avec un cache qui fonctionne.
La seconde, c'est la barre de l'échec de cache. Si ce même préfixe est facturé comme entrée fraîche à chaque ticket, GPT-6.2 Astra coûte 116,80 $ pour 1 000 tickets, plus de 5 fois le prix en cache et plus que GPT-6 Astra avec un cache qui fonctionne. Un cache manqué efface toute la remise de la mise à niveau, et plus encore.
Artificial Analysis voit la même direction au niveau des benchmarks : son Intelligence Index complet coûte 4,00 $ par tâche sur GPT-6.2 Astra contre 6,24 $ sur GPT-6 Astra, une baisse de 36 %. Cela vient de tokens moins chers plus moins de tokens, puisque OpenAI indique que le modèle utilise moins de tokens de sortie sur les tâches exigeantes.
Que vous coûte réellement un échec de cache ?
Un échec de cache coûte environ 5 fois plus par ticket sur GPT-6.2 Astra, et il est plus facile à déclencher qu'on ne le pense. Dans mon test du jour de lancement, j'ai mis un centre d'aide de 12 500 tokens dans le champ instructions de premier niveau de l'API Responses. Trois appels de suite ont montré zéro token en cache et zéro écriture de cache. Déplacer le même texte dans un message developer a résolu le problème : le premier appel a écrit 12 513 tokens dans le cache, et les deux suivants en ont lu 12 501 chacun.
Le guide de mise en cache d'OpenAI explique une partie de la raison. « Les instructions de premier niveau ne peuvent pas contenir de point de rupture explicite », dit-il, et les instructions developer réutilisables vont « dans un bloc input_text à l'intérieur d'un message developer ». Le billet de lancement recommande aussi, pour les deux modèles 6.2, de « garder les préfixes de prompt inchangés et d'ajouter les nouvelles instructions à la fin ». Si votre intégration réécrit le prompt système à chaque tour pour injecter des données client, vous payez le tarif d'entrée complet sur chaque token de ce prompt.
Les écritures de cache ont leurs propres calculs. Une écriture de 30 minutes d'un préfixe de 12 500 tokens coûte 0,125 $, contre 0,10 $ pour l'envoyer une fois sans cache. L'écriture perd donc de l'argent si personne ne réutilise le préfixe, et se rentabilise dès le deuxième accès. Aux tarifs de GPT-6.2 Astra, une écriture et neuf lectures coûtent 1,70 fois le prix d'entrée normal, contre 10 fois sans aucun cache.
L'écriture de 12 heures coûte le double (0,25 $ pour ce préfixe). Elle vaut le coup pour une file calme : si les tickets arrivent à plus de 30 minutes d'écart pendant la nuit, un cache de 30 minutes expire sans cesse, et vous payez pour le réécrire chaque fois. Une file très active n'en a pas besoin, parce que chaque lecture renouvelle la fenêtre de 30 minutes. Vous pouvez observer les taux d'accès dans le tableau de cache des prompts d'OpenAI avant de décider.
Quels paliers et multiplicateurs changent la facture ?
Huit multiplicateurs s'ajoutent au tarif Standard, et deux sont assez grands pour compter plus que le choix du modèle. Les voici sur une seule échelle :
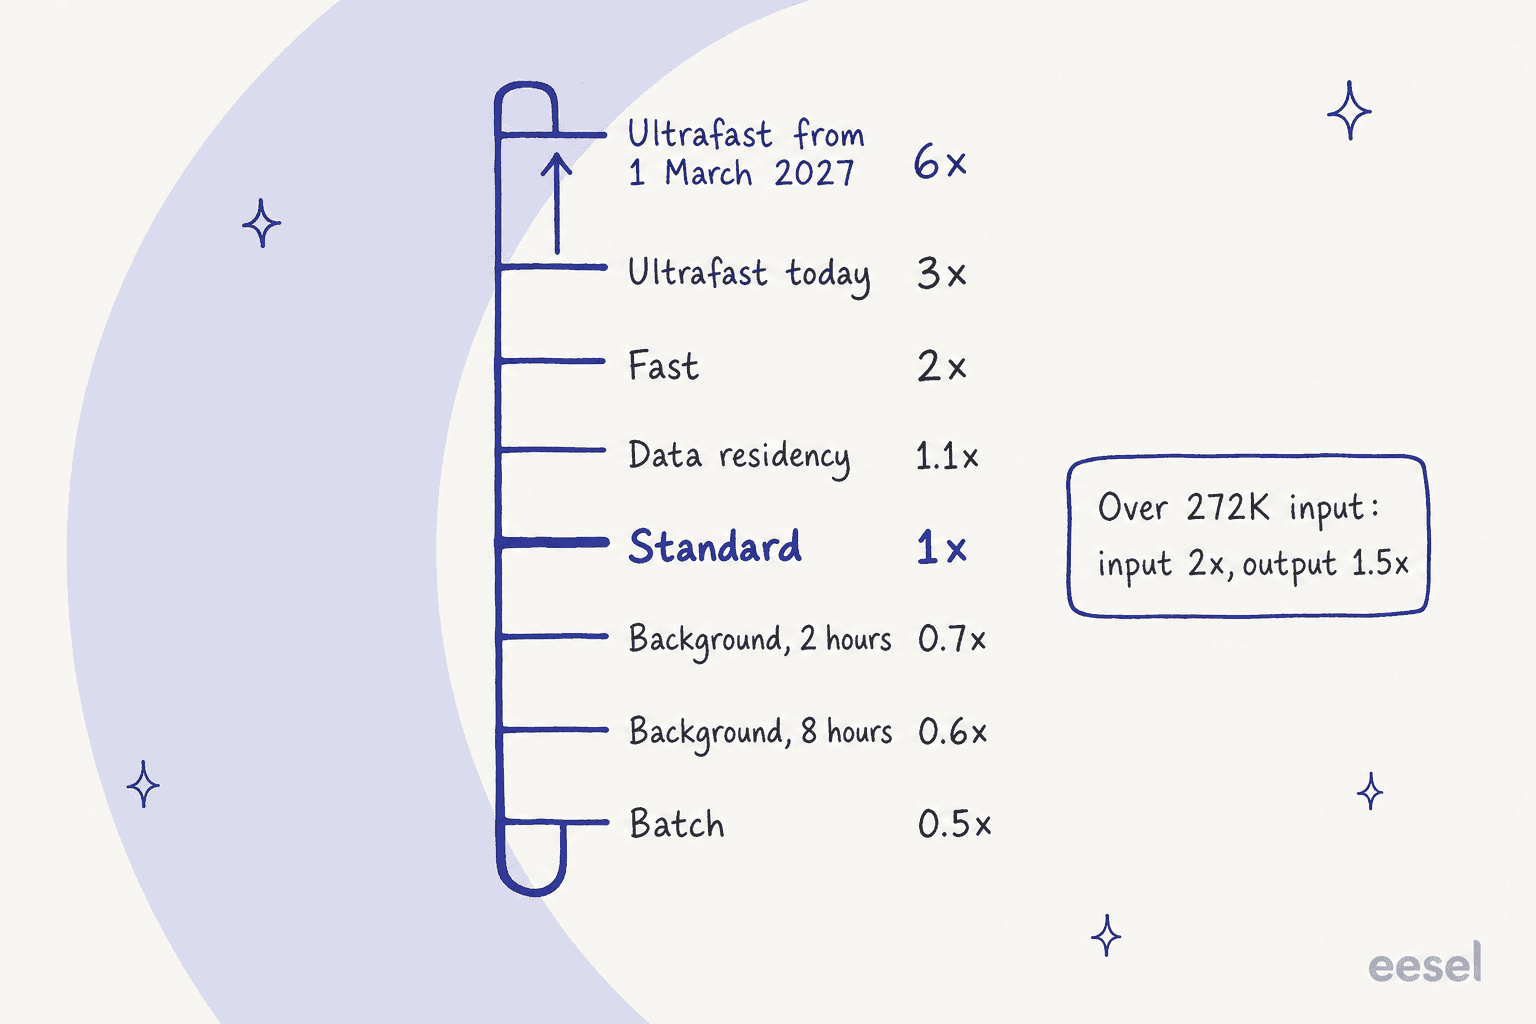
- Batch (0,5x). L'API Batch réduit de moitié chaque tarif, y compris l'entrée mise en cache et les écritures. Elle convient aux travaux de nuit comme étiqueter les tickets du mois dernier ou réécrire des articles d'aide, pas aux réponses en direct.
- Requêtes en arrière-plan (0,6x à 0,7x). Selon la page tarifaire, les requêtes en arrière-plan éligibles dans l'API Responses tournent « 30 % sous Standard pour la fenêtre de 2 heures et 40 % sous Standard pour la fenêtre de 8 heures ». C'est en bêta publique.
- Résidence des données (1,1x). Les points de terminaison de traitement régional portent « une majoration de 10 % pour les modèles lancés à partir du 5 mars 2026 », ce qui inclut GPT-6.2 Astra. Les points de terminaison FedRAMP portent la même majoration de 10 %.
- Fast (2x). Le mode Fast, renommé par OpenAI depuis Priority Processing le 30 juillet 2026, double chaque tarif.
- Ultrafast (3x, puis 6x). Ultrafast coûte 3 fois Standard jusqu'au 28 février 2027 et 6 fois Standard à partir du 1er mars 2027. Si vous construisez dès maintenant une fonctionnalité sensible à la latence dessus, votre facture double à cette date sans aucun changement de code.
- Contexte long (2x entrée, 1,5x sortie). Au-delà de 272 000 tokens en entrée, toute la requête passe au tarif supérieur, pas seulement les tokens au-delà de la limite.
Le seul palier que vous pourriez attendre et ne trouverez pas, c'est Flex. La page tarifaire liste Flex pour GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra et GPT-6 Luna, mais pas pour GPT-6.2 Astra. Batch et les requêtes en arrière-plan sont, pour l'instant, les routes de réduction.
La règle de contexte long est la plus sournoise. Une seule révision de contrat de 400 000 tokens avec une réponse de 4 000 tokens coûte 6,64 $ sur GPT-6.2 Astra. Les mêmes tokens aux tarifs contexte court coûteraient 3,36 $. Si vous pouvez découper un document en morceaux de moins de 272 000, vous réduisez de moitié la facture d'entrée.
Que coûterait GPT-6.2 Astra pour votre volume ?
Entrez ci-dessous votre propre volume de tickets et la forme de votre prompt. Il calcule la même charge sur GPT-6.2 Astra, GPT-6 Astra et GPT-6.2 Sol, avec les tarifs de la page tarifaire d'OpenAI. Les échecs de cache sont facturés comme des écritures de cache de 30 minutes, ce qui est ce qui se passe avec la mise en cache implicite quand le préfixe n'est pas déjà enregistré.
Faites glisser le taux d'accès au cache de 95 % à 0 %, et la facture GPT-6.2 Astra à 8 000 tickets bondit de 222,40 $ à 1 134,40 $ par mois, environ 5 fois plus. Ce seul réglage change la facture plus que la mise à niveau du modèle.
Que coûte-t-il selon la taille de l'équipe ?
Voici la même charge de support à trois volumes mensuels, aux tarifs Standard avec un taux d'accès au cache de 95 %. Les échecs sont facturés comme des écritures de cache de 30 minutes :
| Tickets par mois | GPT-6.2 Astra | GPT-6.2 Astra, Batch | GPT-6 Astra | GPT-6.2 Sol |
|---|---|---|---|---|
| 1 000 | 27,80 $ | 13,90 $ | 40,69 $ | 6,95 $ |
| 8 000 | 222,40 $ | 111,20 $ | 325,50 $ | 55,60 $ |
| 50 000 | 1 390,00 $ | 695,00 $ | 2 034,38 $ | 347,50 $ |
Pour l'échelle, le client eesel SamCart fait tourner un agent sur les tickets Freshdesk et un autre sur le chat de son site, répondant à partir d'environ 280 articles du centre d'aide, sur un forfait qui couvre 8 000 interactions par mois. Cette ligne du milieu correspond à peu près à ce volume. En tokens bruts seuls, la facture du modèle est de quelques centaines de dollars par mois, avant même que quiconque ait écrit la récupération, les appels de fonction pour les recherches de commande, les règles d'escalade, ou l'observabilité pour voir ce qu'il a dit.
C'est la forme honnête du coût du service client IA : les tokens sont la petite ligne, et la couche de récupération fait partie de la grande. L'ingénierie et la maintenance autour des deux sont le gros poste, ce qui explique pourquoi le coût d'un agent IA dépend bien plus de construire ou acheter que du modèle choisi.
GPT-6.2 Astra est-il moins cher que Claude Fable 5.2 ?
Token pour token, non : ils ont le même tarif catalogue, et le cache de Fable est moins cher. Par tâche terminée, GPT-6.2 Astra est bien moins cher. La page tarifaire d'Anthropic liste Claude Fable 5.2 à 8 $ en entrée et 40 $ en sortie par million de tokens, exactement comme Astra, avec des accès cache à 0,20 $.
| Par million de tokens | GPT-6.2 Astra | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|---|
| Entrée | 8,00 $ | 8,00 $ | 4,00 $ | 2,00 $ |
| Sortie | 40,00 $ | 40,00 $ | 20,00 $ | 10,00 $ |
| Lecture de cache | 0,40 $ | 0,20 $ | 0,20 $ | 0,10 $ |
| Écriture de cache la moins chère | 10,00 $ (30 min) | 10,00 $ (5 min) | 5,00 $ (5 min) | 2,50 $ (30 min) |
| Prompts longs | 2x entrée, 1,5x sortie au-delà de 272 000 | Même tarif jusqu'à 1M | Même tarif jusqu'à 1M | 2x entrée, 1,5x sortie au-delà de 272 000 |
| AA Intelligence Index | 62 | 65 | 59 | 57 |
Sur ma charge de support avec un préfixe en cache, Fable 5.2 revient en fait un peu moins cher (19,30 $ contre 21,80 $ pour 1 000 tickets) grâce à cette lecture de cache à 0,20 $. Et pour une seule requête de 400K tokens, Fable coûte 3,36 $ là où Astra coûte 6,64 $, parce qu'Anthropic facture « le même tarif par token » sur toute sa fenêtre de contexte de 1M.
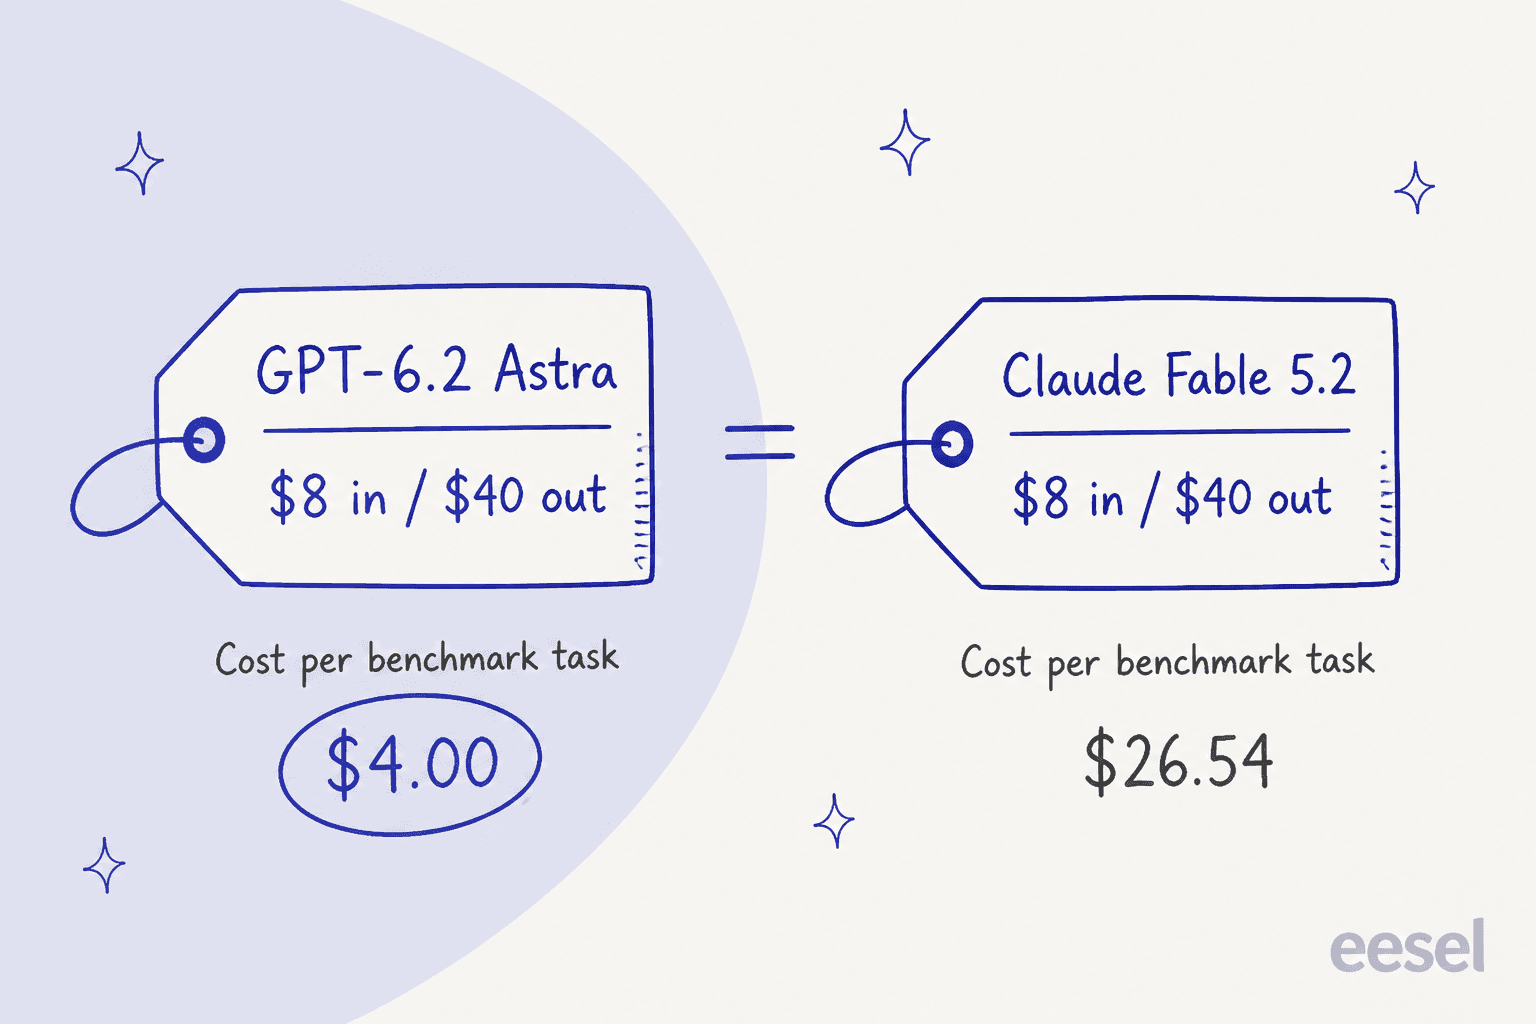
La vue par tâche inverse tout. Artificial Analysis chiffre le coût pour exécuter son Intelligence Index à 4,00 $ par tâche pour GPT-6.2 Astra contre 26,54 $ pour Claude Fable 5.2, parce qu'Astra utilise bien moins de tokens pour arriver à une réponse. Fable obtient quand même le meilleur score, 65 contre 62 pour Astra. Sur les longues tâches d'agent où le modèle écrit et raisonne beaucoup, le nombre de tokens compte plus que le tarif. Sur les appels courts et riches en cache comme les réponses de support, le tarif compte plus.
La bonne comparaison dépend donc de votre charge. Pour des réponses courtes avec un grand prompt réutilisé, comparez les tarifs de cache. Pour un travail long et ouvert, comparez le coût par tâche. Claude Opus 5.5 se situe entre les deux, à la moitié du prix par token d'Astra et avec un score plus bas. Le tour d'horizon alternatives à GPT-6 Astra couvre le reste du terrain.
Que coûte GPT-6.2 Astra dans ChatGPT ?
Dans ChatGPT, vous payez un abonnement fixe, pas par token. OpenAI indique que GPT-6.2 Astra et Sol sont « disponibles pour tous les utilisateurs Plus, Pro, Enterprise et Edu dans ChatGPT Work et Codex », avec un accès Enterprise et Edu une fois qu'un admin du workspace l'active.
| Forfait | Prix | Accès à GPT-6.2 Astra |
|---|---|---|
| Free | 0 $ | Non listé dans le billet de lancement |
| Go | 8 $/mois | Non listé dans le billet de lancement |
| Plus | 20 $/mois | Oui, dans ChatGPT Work et Codex |
| Pro | À partir de 100 $/mois (Pro 100, Pro 200, Pro 500) | Oui ; Pro 500 obtient aussi Ultrafast avec lui |
| Enterprise et Edu | Contacter les ventes | Oui, une fois qu'un admin l'active |
Les prix viennent de la page tarifaire de ChatGPT. Les paliers Pro incluent aussi des crédits API mensuels : 100 $ avec Pro 100, 200 $ avec Pro 200, ou 500 $ avec Pro 500. À mon tarif de support en cache de 21,80 $ pour 1 000 tickets, 500 $ de crédits couvrent environ 22 900 tickets GPT-6.2 Astra par mois, à condition de remplir les conditions d'éligibilité d'OpenAI pour les crédits. La répartition complète des forfaits se trouve dans le guide tarifs ChatGPT.
GPT-6.2 Astra vaut-il son prix pour le support client ?
Pour la plupart des files de support, GPT-6.2 Astra est plus de modèle que le travail n'en demande. Dans mon test du jour de lancement, GPT-6.2 Sol et GPT-6.2 Astra ont tous deux traité correctement les 15 tickets de test, y compris des calculs de remboursement, une injection de prompt, et une recherche de commande échouée, et Sol a coûté environ un quart du prix. Les outils d'évaluations d'agents d'OpenAI peuvent faire tourner le même type de test sur vos propres tickets. Astra justifie son prix sur du travail long et à plusieurs étapes comme les modèles financiers, la recherche juridique, et la construction de tableurs, ce qui est là où OpenAI le positionne.
Il y a aussi une raison, au-delà du coût, de garder Astra loin des réponses clients non supervisées. Artificial Analysis a trouvé que son taux d'hallucination sur des faits inconnus est passé de 50 % à 59 % à effort maximal comparé à GPT-6 Astra. Cela rend la couche d'ancrage et de prévention des hallucinations plus importante que le choix du modèle, quel qu'il soit.
La question budgétaire plus large est de savoir si vous voulez une facture de tokens du tout. Le prix des tokens bouge à chaque changement de prompt, chaque échec de cache, et chaque mise à jour tarifaire comme le changement Ultrafast en mars. Un responsable ingénierie d'une entreprise de matériel crypto avec une base de connaissances de plus de 300 articles a résumé le choix ainsi en choisissant eesel :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
C'est le compromis construire ou acheter en une phrase. Si vous construisez sur GPT-6.2 Astra, budgétisez les tokens et la maintenance. Si vous achetez, budgétisez un chiffre mensuel fixe et passez votre temps à tester l'agent sur de vrais tickets à la place.
Essayer eesel
Si vous regardez le prix de GPT-6.2 Astra parce que vous voulez de l'IA sur votre file de support, eesel vous donne ça sans facture de tokens à surveiller. Le coéquipier IA du helpdesk se connecte au helpdesk que vous utilisez déjà, comme Zendesk ou Freshdesk, apprend de vos tickets passés et de votre centre d'aide, et tourne sur un forfait mensuel fixe. Avant de répondre à un vrai client, vous pouvez le faire tourner sur vos tickets historiques et lire chaque réponse.

Les développeurs peuvent piloter la même configuration depuis la CLI eesel : un agent de code IA comme Claude Code ou Codex peut téléverser des connaissances approuvées comme des articles d'aide et des macros exportés, poser des questions de test à l'agent, et vérifier les réponses avant que quoi que ce soit passe en direct. Connecter le helpdesk lui-même nécessite toujours quelqu'un avec un accès admin pour l'approuver.
Vous pouvez essayer eesel gratuitement sur une partie de votre file, voir les forfaits et tarifs, ou le comparer à utiliser ChatGPT directement si vous hésitez encore à le construire vous-même.