Pourquoi on regarde au-delà de GPT-6 Astra
Commençons par être justes envers GPT-6 Astra, car c'est un modèle vraiment impressionnant. Il embarque une fenêtre de contexte de 1 050 000 tokens, un shell hébergé, apply-patch, l'usage d'ordinateur et le support MCP en natif, selon la page modèle d'OpenAI. Sur les benchmarks agentiques, le bond est réel : OpenAI rapporte que Terminal-Bench 4.0 grimpe à 57,9% contre 37,3% pour Sol, et c'est le premier modèle qu'OpenAI a classé « Critique » en cybersécurité au titre de son Preparedness Framework. Si vous construisez des agents de code autonomes ou des pipelines d'usage d'outils de longue durée, c'est important.
Voici le hic, et c'est la raison pour laquelle vous lisez ceci. OpenAI a tarifé Astra à $10 par million de tokens en entrée et $50 par million en sortie, 2,5 fois les $4/$20 que coûtait GPT-5.6 Sol. Pour ce prix, on s'attendrait à un bond équivalent en intelligence. Ce n'est pas le cas. L'index d'Intelligence indépendant d'Artificial Analysis place Astra à 61,2 contre 60,9 pour Sol, ce qui reste dans la marge de bruit. L'avis le plus tranchant sur Hacker News était que cela ressemble « davantage à un 5.7 qu'à un 6 », et le chiffre confirme cette impression (nous avons creusé le sujet dans notre test de GPT-6 Astra).

Il y a d'autres raisons pour lesquelles les équipes cherchent ailleurs :
- Ce n'est pas sur le niveau gratuit. Astra est réservé à Plus/Pro/Business/Enterprise et à l'API, et sur Enterprise il est désactivé par défaut par espace de travail. (Si vous cartographiez la gamme de modèles OpenAI au sens large, Astra est tout en haut.)
- La surveillabilité a baissé. OpenAI note franchement dans la fiche système que le modèle peut influencer sa propre chaîne de pensée, ce qui les a poussés à ajouter une surveillance du désalignement pouvant mettre en pause un usage légitime d'outils.
- Les prompts longs coûtent plus cher. Les requêtes au-delà de 272K tokens sont facturées à 2x le tarif en entrée et 1,5x en sortie, donc la fenêtre de contexte phare d'Astra n'a pas un tarif plat comme certains concurrents.
Rien de tout cela ne rend Astra mauvais. Cela en fait un spécialiste pour lequel vous payez des tarifs de vaisseau amiral. Voyons donc ce qui existe d'autre.
Les alternatives à GPT-6 Astra en un coup d'œil
Voici tout le paysage côte à côte. Les prix sont par million de tokens sur l'API standard de chaque fournisseur, et les scores d'intelligence viennent de l'index Artificial Analysis (ils bougent de semaine en semaine, donc à considérer comme une estimation, pas une vérité absolue).
| Modèle | Entrée / sortie ($/M) | Contexte | Index d'intelligence (approx.) | Poids ouverts ? | Idéal pour |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 / $50 | 1,05M | ~61 | Non | Agents autonomes, code, cyber |
| Claude Fable 5.1 | $10 / $50 | 1M | ~66 | Non | Capacité mesurée la plus élevée |
| Claude Opus 5 | $5 / $25 | 1M | ~61 | Non | Remplacement le plus proche, moitié prix en sortie |
| Claude Sonnet 5 | $2 / $10 | 1M | ~53 | Non | Rapport valeur/volume en production |
| Gemini 3.8 Flash | $0.75 / $3.75 | 1M | ~59 | Non | Le moins cher hébergé, tâches par lots |
| Kimi K3 | $3 / $15 | 1M | ~57 | Oui | Capacité à poids ouverts |
| Qwen 3.8 Max | $2 / $6 | 1M | ~58 | Partiel | Base ouverte + forte préférence humaine |
| DeepSeek V4 Flash | ~$0.22-0.44 / $0.66-1.32 | 1M | ~50 | Oui (MIT) | Le moins cher par tâche, auto-hébergeable |
| Grok 4.6 | $2 / $6 | 500K | ~54 | Non | Rapide, flux natifs xAI |
Un mot rapide sur la façon de lire ce tableau. Le prix affiché et le coût par tâche ne sont pas la même chose. Un modèle qui brûle deux fois plus de tokens en sortie pour terminer un travail peut coûter plus cher qu'un modèle « plus cher » qui y arrive en un seul passage. Utilisez donc le tableau pour présélectionner, puis faites passer vos vrais prompts sur deux ou trois finalistes pour mesurer la vraie facture. Le meilleur modèle d'IA pour les tickets de support est rarement celui avec le plus gros score de benchmark, et quel LLM gagne dépend généralement de vos données.

1. Claude Opus 5
Idéal pour : les équipes qui veulent une capacité de niveau Astra sans la facture d'Astra.
Claude Opus 5 est le remplacement un-pour-un le plus naturel de cette liste. Il égale la fenêtre de contexte de 1M d'Astra, et Anthropic facture toute la fenêtre aux tarifs standard sans surcoût de contexte long, donc une requête de 900K tokens coûte le même prix par token qu'une requête de 9K. Sur l'index Artificial Analysis, il se situe juste à côté d'Astra (tous deux autour de 61), et pendant un moment il a occupé seul la première place.
La particularité intéressante est le curseur d'effort. Opus 5 active la réflexion par défaut et permet de monter l'effort de raisonnement jusqu'à max, ce qui est là où réside une grande partie de sa qualité, mais aussi où va le coût. Le consensus de la communauté est qu'Opus 5 dépense environ deux fois plus de tokens en sortie qu'Opus 4.8 à effort égal, donc le coût par tâche a augmenté même si le prix affiché n'a pas bougé.

Voici un avis réel d'un développeur après son passage à Opus 5 :
"Opus 5 matched Fable 5 on my agent tasks, and it was faster and cheaper to run."

- Avantages : moitié du prix en sortie d'Astra, tarification plate sur 1M de contexte, raisonnement de premier plan, son propre quota de limite de débit.
- Inconvénients : la réflexion est activée par défaut et ne peut pas être désactivée au-delà de l'effort
high, et la consommation de tokens par tâche peut grimper vite. - Tarifs : $5 en entrée / $25 en sortie par million ; mode rapide $10/$50 ; lot à -50% ; lectures de cache $0.50.
Verdict : si vous quittez Astra parce que le rapport prix-qualité vous a agacé, commencez ici. Vous obtenez essentiellement le même niveau d'intelligence à moitié prix en sortie. Surveillez le curseur d'effort, car une habitude d'effort max peut discrètement effacer les économies.
2. Claude Fable 5.1
Idéal pour : le modèle le plus capable que vous puissiez acheter au prix d'Astra.
Si le problème d'Astra est de facturer un prix de vaisseau amiral pour un score quasi stagnant, Claude Fable 5.1 est la réponse cinglante : il coûte exactement les mêmes $10/$50 et domine l'index d'intelligence avec environ 65,7, plusieurs points devant Astra. Il se positionne au-dessus d'Opus 5 dans la gamme d'Anthropic et arrive en tête de tous les évals publiés par Anthropic au lancement, y compris Terminal-Bench-Science, où il a plus que doublé le score précédent.
Deux détails en font un achat vraiment différent d'Astra. D'abord, les lectures de cache ont chuté de 75% à $0.25 par million, moins cher par token que les $0.50 d'Opus 5, ce qui s'accumule vite sur des charges de travail agentiques qui relisent un gros system prompt. Ensuite, Fable 5.1 appose désormais un filigrane statistique sur sa sortie pour se conformer à l'AI Act européen, ce que certaines équipes apprécient pour la traçabilité et que d'autres trouvent étrange. Bon à savoir avant de s'engager.
- Avantages : intelligence mesurée la plus élevée de la liste au prix d'Astra, lectures de cache très bon marché, tarification plate sur 1M de contexte, prose et code solides.
- Inconvénients : même $50/M en sortie qu'Astra (ce n'est pas le choix économique), quelques refus faux positifs signalés sur du code lié à la sécurité, et le filigrane en sortie ne conviendra pas à tout le monde.
- Tarifs : $10 en entrée / $50 en sortie ; lecture de cache $0.25 ; lot $5/$25 ; pas de niveau gratuit.
Verdict : si vous alliez payer les prix d'Astra de toute façon, Fable 5.1 vous donne plus de capacité mesurée au même tarif. C'est l'alternative « même prix, plus de modèle ».
3. Claude Sonnet 5
Idéal pour : le travail de production à fort volume où la valeur par tâche prime sur la capacité maximale.
Tous les travaux n'ont pas besoin d'un vaisseau amiral. Claude Sonnet 5 est le cheval de trait de la famille Claude 5 à $2/$10 par million, un cinquième du prix en sortie d'Astra, et Anthropic a confirmé en août 2026 qu'il s'agit du tarif standard permanent, pas d'une promotion temporaire. Il obtient environ 53 sur l'index d'intelligence, plus bas que les vaisseaux amiraux, mais largement suffisant pour la classification, le routage, le résumé et la longue traîne de génération de routine.
Le piège à surveiller est le nombre d'échanges par tâche. Moins cher par token ne signifie pas toujours moins cher par travail, car un modèle plus petit demande parfois plus d'allers-retours pour arriver au même résultat. Sur une tâche bien cadrée cependant, Sonnet 5 est l'un des meilleurs modèles en valeur par token à pointer vers le trafic de production.
- Avantages : une fraction du prix d'Astra, 1M de contexte à tarif plat, rapide, vraiment bon sur les tâches du quotidien.
- Inconvénients : ce n'est pas un raisonneur de pointe, et peut consommer des échanges supplémentaires sur du travail ambigu.
- Tarifs : $2 en entrée / $10 en sortie par million ; lecture de cache $0.20 ; lot à -50%.
Verdict : le modèle vers lequel je me tournerais pour les 80% du trafic qui n'ont pas besoin d'un vaisseau amiral. Associez-le à Opus 5 ou Fable 5.1 pour les 20% difficiles et vous obtenez une structure de coûts qu'Astra ne peut pas égaler.
4. Google Gemini 3.8 Flash
Idéal pour : les tâches par lots bon marché et à fort débit où personne n'attend la réponse.
Gemini 3.8 Flash est le modèle hébergé le moins cher ici qui reste dans la conversation des modèles de pointe, à $0.75 en entrée / $3.75 en sortie jusqu'à fin 2026 (il double à $1.50/$7.50 le 1er janvier 2027, prévoyez-le dans votre budget). Il obtient environ 59 sur l'index d'intelligence et dispose d'un niveau gratuit, ce qu'Astra n'a pas.
Une réserve honnête que la plupart des articles omettent : Artificial Analysis mesure son délai avant premier token à 13,30 secondes contre une médiane de catégorie d'environ 3 secondes, alors même que son débit brut se classe parmi les tout premiers modèles testés. Le débit n'est pas la réactivité. Cela le rend excellent pour des pipelines de traitement par lots la nuit et le disqualifie pour tout ce qu'un humain attend activement, comme une réponse de chat en direct. Google lui-même suggère même de rester sur l'ancien 3.7 Flash pour les charges de travail axées sur l'efficacité, puisque 3.8 « travaille plus dur » et peut consommer plus de tokens.
- Avantages : option hébergée la moins chère, niveau gratuit, énorme entrée multimodale (texte, image, audio, vidéo, PDF), débit très élevé.
- Inconvénients : délai lent avant premier token, le prix double en janvier 2027, et deux métriques de sécurité ont légèrement reculé par rapport à 3.7.
- Tarifs : $0.75 / $3.75 par million jusqu'au 31 déc. 2026, puis $1.50 / $7.50 ; lot et Flex à -50%.
Verdict : un modèle superbe pour le traitement par lots et hors ligne à un prix que les vaisseaux amiraux ne peuvent pas égaler. Ne le mettez simplement pas devant un client qui regarde un indicateur de frappe.
5. Kimi K3
Idéal pour : les équipes qui veulent une forte capacité avec des poids ouverts qu'elles peuvent auto-héberger.
Kimi K3 est le vaisseau amiral de Moonshot AI, un modèle mixture-of-experts de 2,8 billions de paramètres avec 104B actifs, et ses poids ouverts sont sortis à temps à la date promise, ce que tous les labos ne réussissent pas. Il obtient environ 57 sur l'index d'intelligence, dépassant d'anciens vaisseaux amiraux comme Opus 4.8, et dispose de la vision native (mais accepte seulement le base64 ou les IDs de fichiers, pas les URLs d'images publiques).
Le tarif est la surprise : à $3/$15 par million, il se situe dans la même tranche que Claude Sonnet, pas le choix ultra-économique auquel l'ère K2 avait habitué les gens. Le raisonnement est toujours activé et ne peut être désactivé à aucun niveau d'effort, c'est donc un réglage de latence, pas un niveau de coût. Si votre raison de vouloir K3 est l'auto-hébergement, les poids ouverts sont tout l'intérêt ; si vous allez simplement utiliser l'API hébergée, le calcul de valeur est moins évident face à Sonnet 5.
- Avantages : poids vraiment ouverts, benchmarks solides, vision native, 1M de contexte.
- Inconvénients : le prix hébergé est de milieu de gamme, pas économique, le raisonnement ne peut pas être désactivé, les URLs d'images publiques ne sont pas acceptées.
- Tarifs : $3 en entrée / $0.30 en cache hit / $15 en sortie par million.
Verdict : le meilleur choix de cette liste si les poids ouverts sont une exigence incontournable et que vous allez réellement les faire tourner. En tant qu'API hébergée seule, Sonnet 5 l'emporte généralement en valeur.
6. Qwen 3.8 Max
Idéal pour : un généraliste solide avec une base ouverte permissive et des scores de préférence humaine dans le top cinq.
Le Qwen 3.8 Max d'Alibaba est passé en disponibilité générale en août 2026, un MoE de 2,4T de paramètres avec 95B actifs, tarifé à $2 en entrée / $6 en sortie par million. Il obtient environ 58 sur l'index d'intelligence, et sur les classements de préférence humaine de LMArena il est vraiment fort, dans le top cinq en texte et le top deux en vision, donc l'index automatisé et les votes humains à l'aveugle pointent dans des directions légèrement différentes. Quand ils divergent, je ne me fierais à aucun des deux chiffres seul et je testerais.

Sur la question des poids ouverts, c'est un « oui » partiel. Le checkpoint lourd Qwen3.8-2.4T-A95B est sorti sous une licence Qwen restreinte, tandis qu'un modèle permissif Apache-2.0 de 27B est celui que vous pouvez réellement réutiliser librement. Le Max hébergé n'est pas non plus équivalent en fonctionnalités à la base ouverte, puisqu'il ajoute l'entrée vision, un mode sans réflexion et des outils intégrés.
- Avantages : prix hébergé bas, classements de premier plan en préférence humaine, 1M de contexte, un modèle ouvert plus petit et permissif.
- Inconvénients : les gros poids sont sous licence restreinte, les versions hébergée et ouverte diffèrent, et la résidence des données est en Chine sur l'API de premier niveau.
- Tarifs : $2 en entrée / $6 en sortie par million ; lecture de cache implicite $0.25.
Verdict : un généraliste légitimement solide et bon marché, surtout si vous accordez plus de valeur à la qualité de préférence humaine qu'aux scores de benchmark. Lisez attentivement la licence avant de prévoir d'auto-héberger le gros modèle.
7. DeepSeek V4 Flash
Idéal pour : les charges de travail à fort volume où le coût par tâche est l'enjeu principal.
Si votre priorité est de dépenser le moins possible par token, rien ici n'approche DeepSeek V4 Flash. Sur la grille tarifaire en direct, il est autour de $0.22-$0.44 par million en entrée et $0.66-$1.32 en sortie, selon qu'on est en heure pleine ou creuse. Comme la fenêtre de pointe de DeepSeek (01h00-04h00 et 06h00-10h00 UTC) correspond aux heures ouvrées chinoises, une file américaine ou européenne est majoritairement facturée au tarif creux moins cher, une particularité réelle (bien que fragile) à connaître.

Deux choses pour rester honnête. D'abord, « pas cher » et « bon » sont des exécutions différentes des mêmes poids : les propres chiffres de DeepSeek montrent un grand écart entre la qualité sans réflexion et celle en effort maximal, et les tokens de raisonnement sont facturés au tarif de sortie, donc la configuration économique n'est pas celle qui domine les classements. Ensuite, sur les données clients, les conditions de l'API payante restent silencieuses sur l'usage pour l'entraînement plutôt que de l'exclure explicitement, il n'existe pas d'option de rétention zéro publiée, et les données résident en RPC sous droit chinois. C'est donc un moteur de coût fantastique pour du travail à fort volume non sensible, mais pas un remplacement direct pour des données clients réglementées.
- Avantages : de loin le moins cher, poids ouverts sous licence MIT (~167Go), 1M de contexte, 384K de sortie maximale.
- Inconvénients : la configuration économique est en retrait sur la qualité, consommation de tokens verbeuse, texte seulement (pas d'entrée image documentée), et conditions de traitement des données inadaptées aux données sensibles.
- Tarifs : heures creuses / heures pleines, par million : entrée ~$0.22 / $0.44, sortie ~$0.66 / $1.32 ; entrée en cache hit une fraction de centime.
Verdict : le champion de la valeur, de loin. Utilisez-le pour la classification, l'extraction et le résumé en masse sur des données non sensibles. Gardez les données personnelles clients hors de l'API de premier niveau tant que les conditions et la résidence des données ne correspondent pas à vos exigences.
8. Grok 4.6
Idéal pour : les équipes déjà dans l'écosystème xAI qui veulent des réponses rapides et une grande fenêtre de contexte.
Grok 4.6 complète la liste à $2 en entrée / $6 en sortie par million pour les prompts sous 200K tokens, avec une fenêtre de contexte de 500K. Il est rapide, et si vous construisez déjà sur xAI ou voulez la recherche en direct X/web intégrée, c'est un choix sensé. Une chose que la grille tarifaire précise : les requêtes à contexte long (prompts à 200K ou plus) refacturent l'intégralité de la requête à $4/$12, pas seulement le dépassement, donc un gros prompt coûte plus cher que ne le suggère le tarif affiché.
Grok mesure aussi des choses au-delà des tokens : la recherche web, la recherche X et l'exécution de code coûtent $5 pour 1 000 appels, et la recherche de pièces jointes coûte $10 pour 1 000. Les prix effectifs mesurés par OpenRouter sont la lecture la plus fine du terrain ici, montrant une moyenne en entrée bien en dessous des $2 affichés grâce à un taux de cache hit d'environ 90%, avec une sortie légèrement au-dessus du tarif affiché car une partie du trafic bascule dans le palier contexte long. Si les achats vous poussent vers une marketplace cloud, notez qu'Azure et Bedrock ne proposent que d'anciennes générations de Grok, donc vous n'y trouverez pas 4.6.
- Avantages : rapide, 500K de contexte, recherche en direct native, prix effectif souvent inférieur au tarif affiché grâce à un bon caching.
- Inconvénients : les requêtes à contexte long refacturent tout le prompt, des compteurs supplémentaires par appel pour la recherche et les outils, pas de remise lot sur 4.6.
- Tarifs : $2 / $6 par million (≤200K) ; $4 / $12 pour les prompts ≥200K ; compteurs d'outils/recherche en plus.
Verdict : un modèle solide et rapide avec un vrai avantage si vous voulez une recherche intégrée ou êtes déjà dans l'univers xAI. La refacturation en contexte long et les compteurs par appel signifient qu'il faut modéliser votre usage réel avant de supposer que c'est l'option économique.
Ce que toute comparaison de modèles rate : un modèle n'est pas un coéquipier
Voici ce que j'aurais aimé qu'on me dise avant de passer une semaine à faire des benchmarks. Si vous choisissez un modèle pour répondre à des tickets de support, écrire des articles de blog ou faire tourner n'importe quel flux de travail métier réel, le modèle n'est que le moteur. C'est de l'intelligence brute qui n'a aucune idée de votre politique de remboursement, de la vue Zendesk à consulter, ou du moment où il doit s'arrêter et demander à un humain.
Chaque modèle de cette liste, Astra inclus, a le même écart. Les scores de connaissance d'Artificial Analysis plafonnent bien en dessous de 50 sur 100, ce qui est une façon élégante de dire qu'aucun modèle ici ne connaît votre entreprise. Pour transformer un modèle en quelque chose qui fait réellement le travail, il faut l'intégrer à votre centre d'aide et à vos tickets passés, le connecter à vos outils, et l'entourer de garde-fous, de tests et d'approbations. C'est le travail derrière toute vraie IA pour le service client, et c'est le même travail quel que soit le modèle qui gagne votre benchmark.

C'est là aussi que la conversation sur les prix bascule. Payer $50 par million de tokens en sortie fait le plus mal quand vous le dépensez sur les 80% de tickets routiniers que n'importe quel modèle de milieu de gamme pourrait gérer. La structure la plus intelligente consiste à laisser autre chose décider quand une question difficile a vraiment besoin d'un vaisseau amiral, et à payer pour le résultat plutôt que pour les tokens. C'est la différence entre louer un moteur et embaucher un coéquipier IA, et cela change aussi le coût comparé à un agent humain.
Essayez eesel
La raison pour laquelle je reviens sans cesse au cadrage « moteur contre coéquipier » est que c'est exactement ce que nous construisons. eesel est une plateforme de coéquipiers IA : plutôt que de vous remettre un modèle brut et une clé API, vous embauchez un coéquipier prêt à travailler pour un poste précis, comme le coéquipier IA de helpdesk qui rejoint votre file de support ou le rédacteur de blog IA. Chacun arrive en sachant déjà utiliser le modèle, vos intégrations et le contexte de votre entreprise, donc ce n'est pas vous qui collez GPT-6 Astra à Zendesk à 2h du matin.

Deux choses comptent pour quiconque compare des coûts de modèles. D'abord, eesel facture par ticket à $0.40, pas par token, donc vous êtes isolé exactement de la guerre des prix dont il est question dans cet article ; que le meilleur modèle soit Astra, Opus 5 ou autre chose de moins cher le mois prochain, votre coût par conversation résolue ne bouge pas. Ensuite, comme Astra est fondamentalement une histoire d'agents et d'API, il est utile de savoir qu'eesel expose le même coéquipier via une véritable interface en ligne de commande et un serveur MCP : vous pouvez le piloter depuis un terminal, le scripter en CI, ou le connecter via MCP à un agent de code comme Claude Code et l'exploiter sans interface. La documentation dit littéralement que tout ce que vous pouvez faire dans le tableau de bord, vous pouvez le faire depuis le terminal.
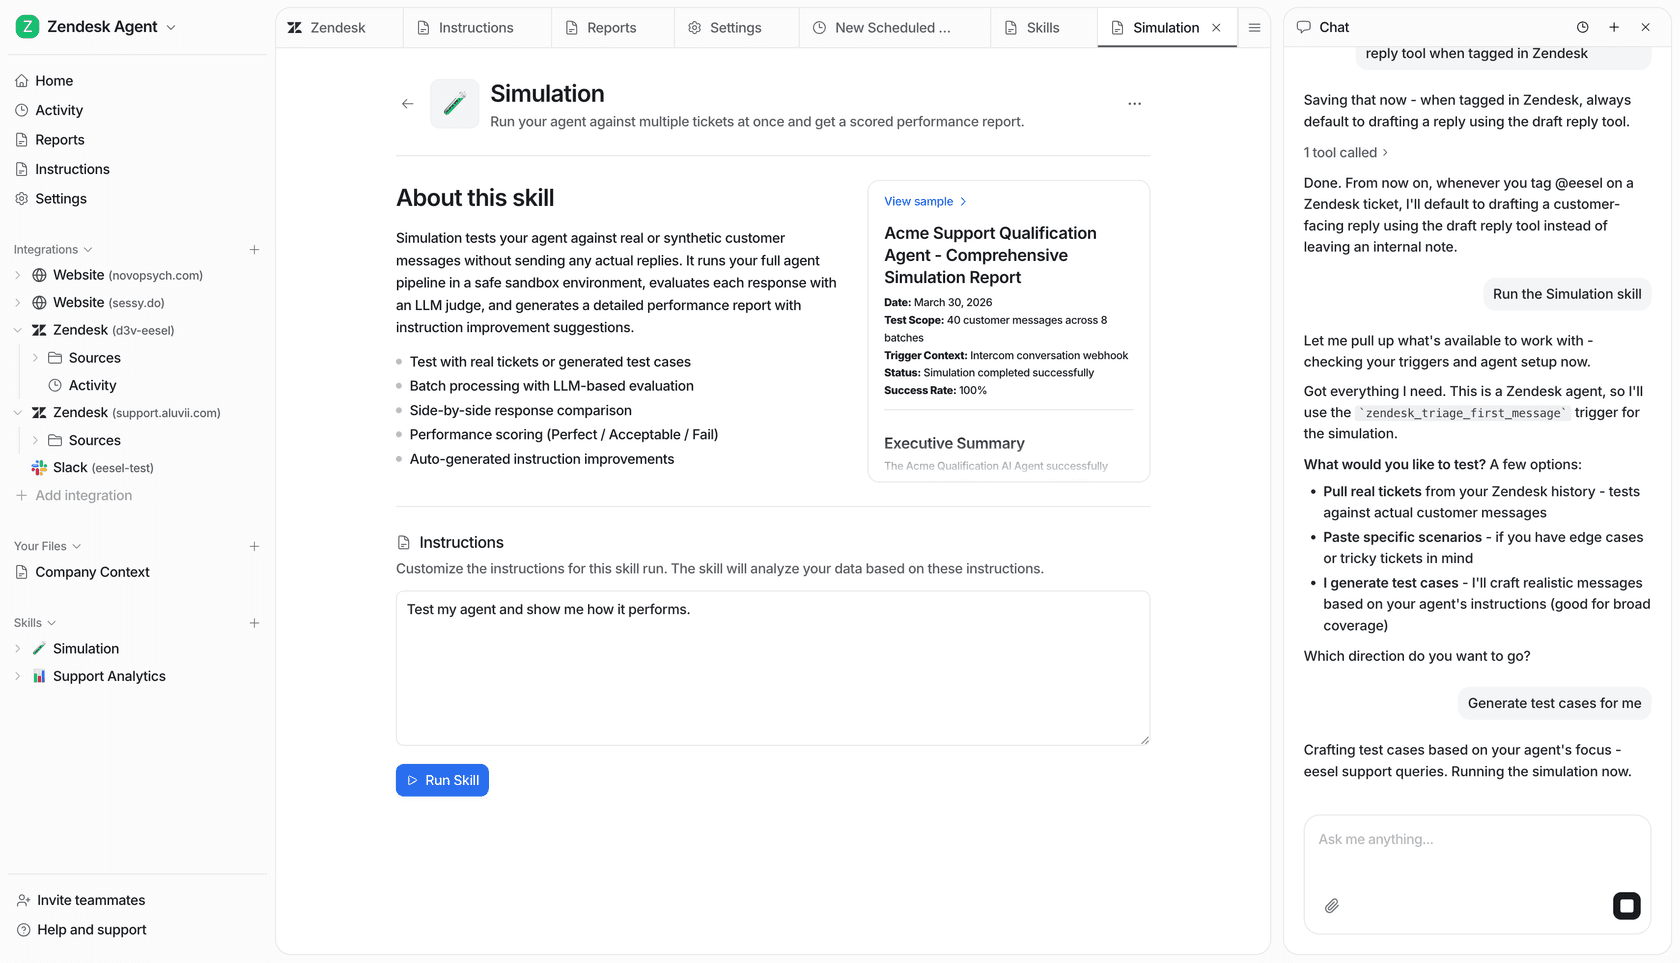
Avant de passer en production, eesel peut simuler le coéquipier sur vos tickets passés et noter ses réponses par rapport à ce que votre équipe a réellement envoyé, afin que vous trouviez les lacunes lors d'un test sûr plutôt que devant un client. Vous pouvez démarrer avec $50 d'usage gratuit et sans carte bancaire. Si vous hésitez sur quel modèle utiliser pour bâtir votre support, c'est cette couche qui rend le choix du modèle bien moins important. Essayez eesel gratuitement.
Questions fréquentes
Quelle est la meilleure alternative à GPT-6 Astra ?
Combien coûte GPT-6 Astra comparé aux alternatives ?
Existe-t-il une alternative moins chère à GPT-6 Astra pour le support client ?
Quelles alternatives à GPT-6 Astra ont des poids ouverts ?
Que se passe-t-il si j'attends simplement que le prix baisse plutôt que de changer ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.