Le prix, d'entrée de jeu
Voici l'intégralité de la grille tarifaire de Claude Mythos 5.1. Chaque chiffre ci-dessous s'applique aussi, au centime, à Fable 5.1, un point sur lequel je reviendrai.
| Mesure | Prix (par million de tokens) | Notes |
|---|---|---|
| Entrée de base | 10,00 $ | Inchangé depuis Fable 5 |
| Sortie de base | 50,00 $ | Inchangé depuis Fable 5 |
| Entrée batch | 5,00 $ | 50 % de réduction, Message Batches API |
| Sortie batch | 25,00 $ | 50 % de réduction |
| Écriture de cache (5 minutes) | 12,50 $ | 1,25x l'entrée de base |
| Écriture de cache (1 heure) | 20,00 $ | 2x l'entrée de base |
| Lecture de cache | 0,25 $ | 2,5 % de l'entrée de base, le changement principal |
Les spécifications derrière ces chiffres méritent d'être mentionnées pour que vous puissiez estimer une facture : fenêtre de contexte de 1M de tokens, 128K de sortie maximale, un thinking adaptatif toujours actif, un réglage d'effort high par défaut, et une date limite de connaissances de juin 2026. Mythos 5.1 fonctionne sur l'API Claude, Amazon Bedrock, Google Cloud et Microsoft Foundry, et ces plateformes fixent leurs propres tarifs régionaux par-dessus.
Remarquez ce qui n'est pas là : aucun frais par siège, aucun minimum mensuel, aucun palier d'abonnement. C'est une tarification brute du modèle, facturée au token, donc votre coût réel dépend de la quantité de texte qui entre, de ce qui sort, et de la part de l'entrée que vous pouvez servir depuis le cache. Cette dernière variable est l'enjeu central de cette sortie.
La lecture de cache est la vraie information
Tous les autres modèles Claude actuels tarifent un hit de cache à 10 % de leur tarif de base en entrée. Mythos 5.1 et Fable 5.1 le tarifent à 2,5 %. Sur un modèle à 10 $ en entrée, cela fait 0,25 $ par million de tokens au lieu de 1,00 $.
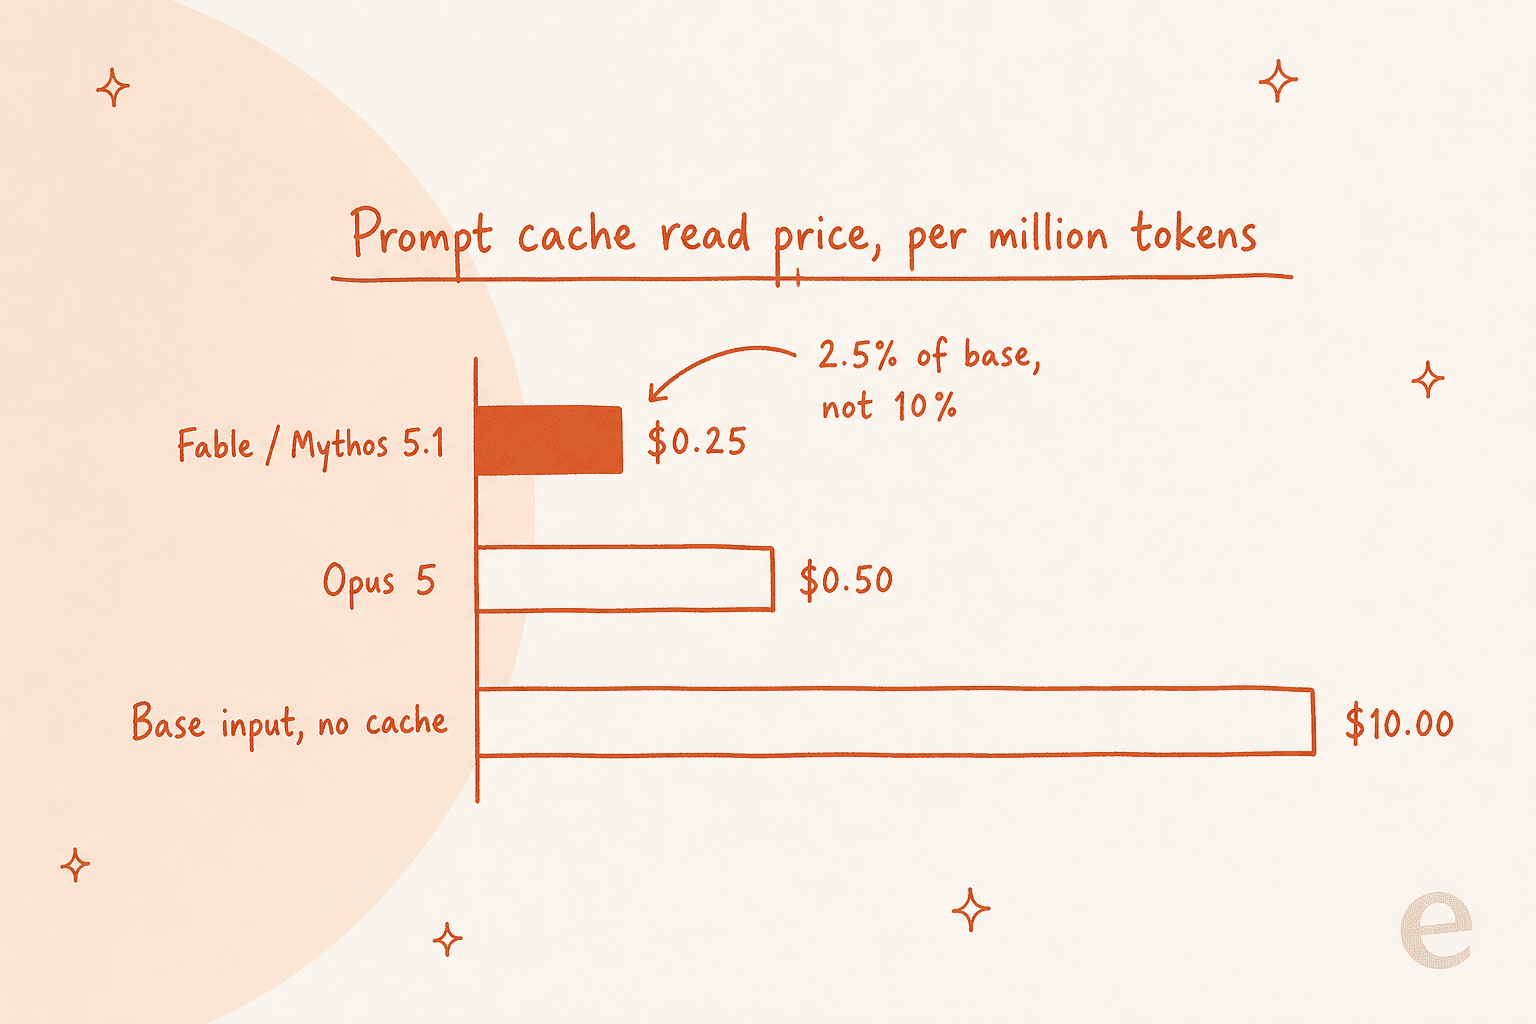
Le chiffre qui fait faire un double regard : une lecture de cache de Mythos 5.1 coûte la moitié d'une lecture de cache d'Opus 5 (0,25 $ contre 0,50 $), même si Mythos coûte deux fois plus cher par token d'entrée de base. Anthropic dit en substance : la partie coûteuse consiste à réfléchir sur de nouveaux tokens, et relire des tokens déjà traités devrait être presque gratuit.
Cela compte à cause de l'endroit où vont les tokens dans un agent réel. Une CLI de codage ou un agent de support de longue durée renvoie l'intégralité de sa transcription à chaque tour. Le tour 20 peut porter un million de tokens de contexte, dont la quasi-totalité est un hit de cache. Quand la lecture de cache chute d'un facteur 4, le poste dominant de ce type de facture chute avec elle. Comme l'a formulé Simon Willison sur Hacker News :
"Bit of a discount if you're using caching... This should impact any long-running agent since subsequent calls can benefit from cached reads for previous transcripts."

Anthropic a donné des chiffres concrets après avoir mesuré quatre semaines d'utilisation en août 2026 : environ 25 % moins cher pour des charges de travail typiques, et jusqu'à environ 45 % moins cher pour des charges très agentiques. L'écart dépend entièrement de l'intensité d'utilisation du cache dans le travail.
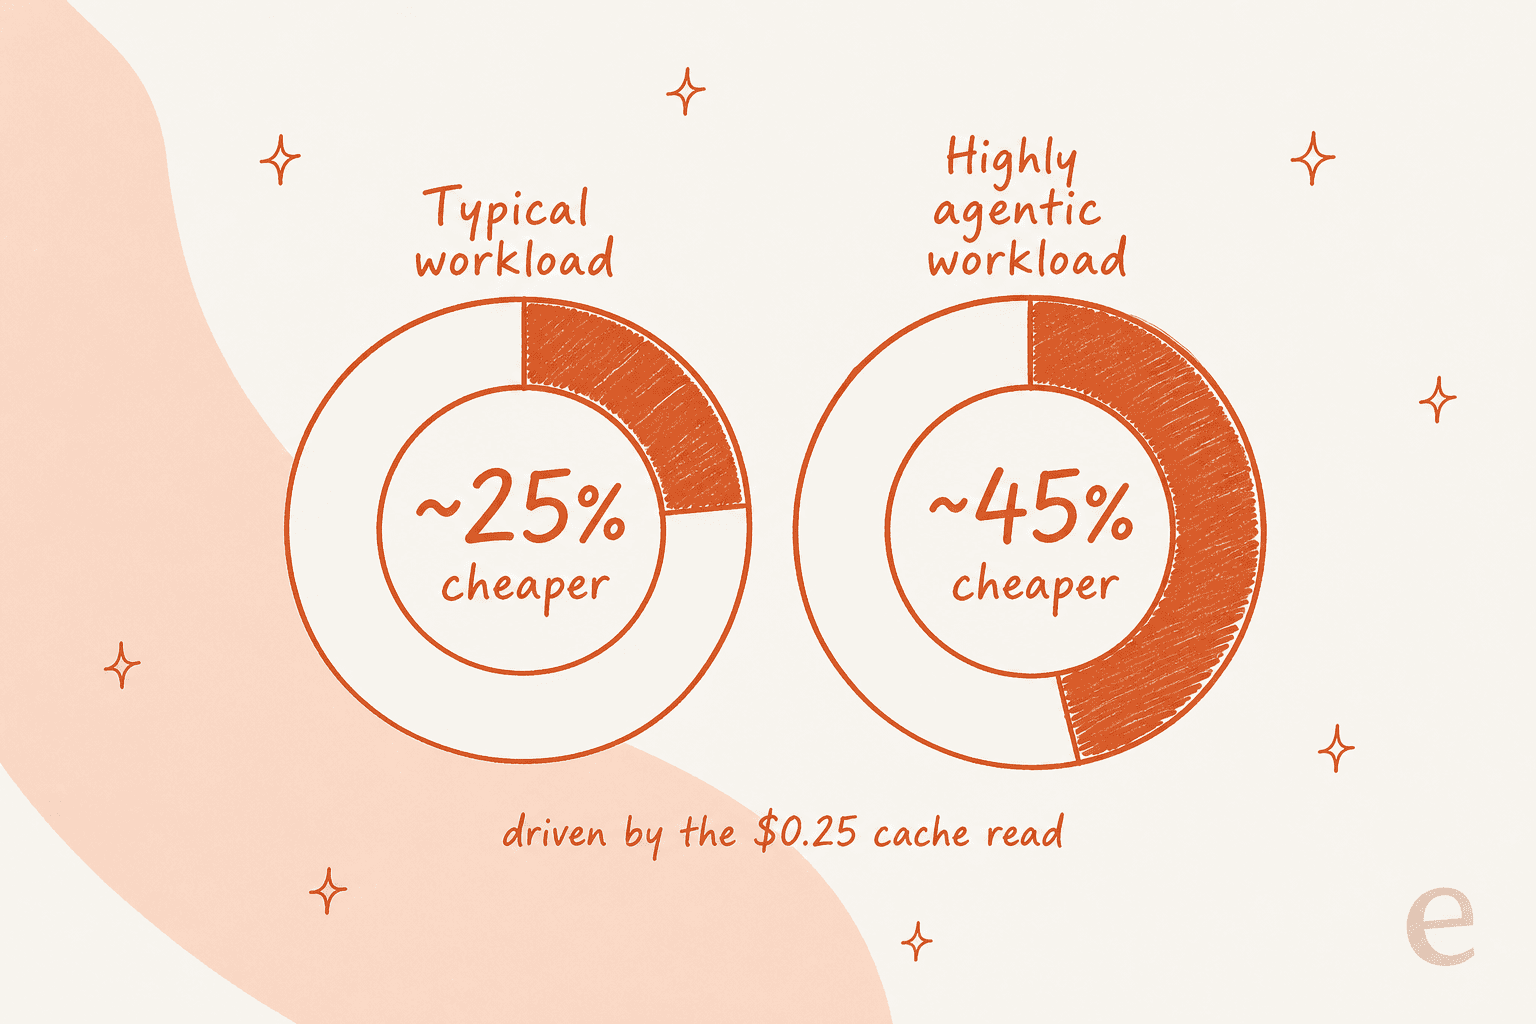
Voici le contrepoids honnête, car un article sur les tarifs doit aussi quelque chose aux sceptiques. La lecture de cache moins chère ne joue un rôle que si les lectures de cache représentent une grande part de votre dépense. Les tokens de sortie coûtent toujours 50 $ par million et n'ont pas changé. Un commentateur de Hacker News, fastball, a fait le calcul sur un exemple de 20 tours : une conversation se terminant à 1M de tokens de contexte revenait à 72,00 $ sur Fable 5 et 64,88 $ sur Fable 5.1, parce que les 50 $ de tokens de sortie étaient identiques dans les deux cas. Moins cher, mais pas les 25 % que l'on pourrait attendre en survolant le titre. Et un autre utilisateur a été plus direct : « This is just cache reads. In real usage it costs 15% more than Fable 5. » La leçon est de faire le calcul avec votre propre mix de tokens, plutôt que de supposer que le pourcentage affiché en titre vous concerne.
Pour faciliter cela, entrez vos propres chiffres :
Mythos et Fable coûtent le même prix parce que c'est le même modèle
C'est le fait qui recadre toute la question tarifaire. Mythos 5.1 et Fable 5.1 sont le même modèle sous-jacent, avec les mêmes poids. La seule différence est la couche de sécurité : Fable 5.1 est benchmarké avec les garde-fous de production activés, et lorsqu'un garde-fou se déclenche, il confie la tâche à un autre modèle. Mythos 5.1 fonctionne sans cette intervention.
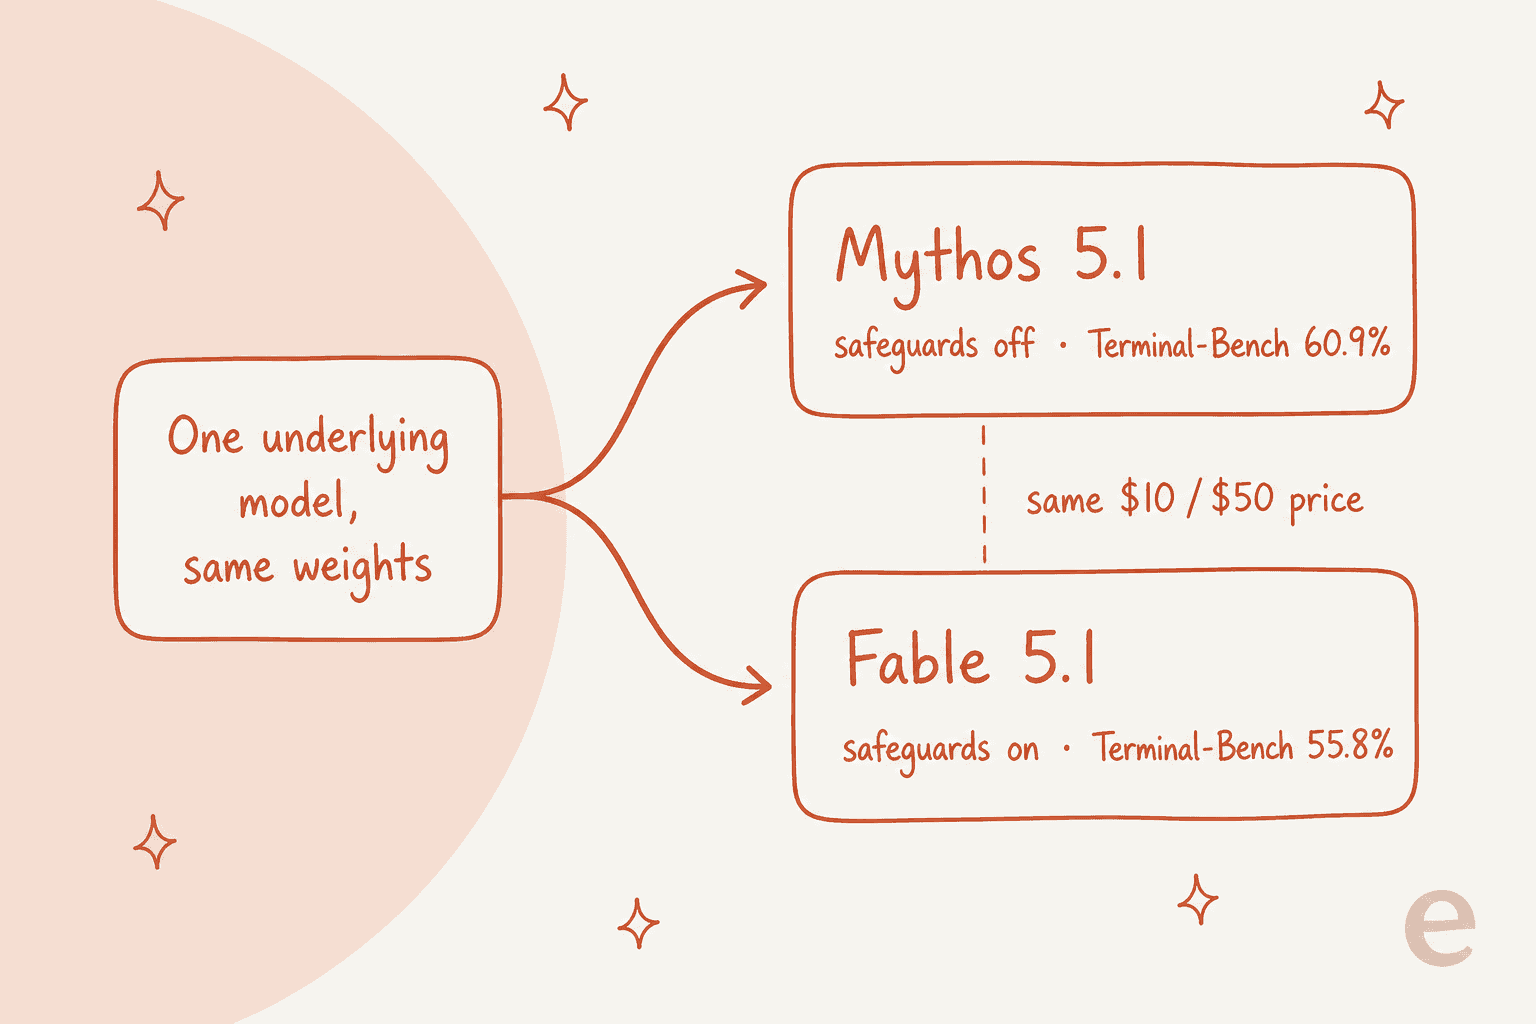
Donc, quand vous voyez Mythos 5.1 obtenir 60,9 % sur Terminal-Bench 4.0 contre 55,8 % pour Fable 5.1, cet écart n'est pas un modèle plus intelligent. C'est la taxe que prélèvent les garde-fous lorsqu'ils interviennent et redirigent une tâche. Anthropic s'attend à ce que cet écart se réduise à mesure que les garde-fous deviennent plus précis. Les tarifer de façon identique est la démarche honnête, puisque vous payez pour les mêmes poids dans les deux cas.
Cela explique aussi pourquoi le tarif de base n'a pas baissé malgré une version mineure. Sur Hacker News, GodelNumbering a interprété la baisse de la lecture de cache comme un signal de demande plutôt que de générosité :
"This gives a lot of credit to the theory that Anthropic did not get much bite on Fable at its original pricing, which in turn likely places a ceiling on LLM pricing in general."
Que cette lecture soit juste ou non, la conclusion pratique pour un acheteur est claire : vous ne choisissez pas entre deux niveaux de prix. Vous choisissez entre deux configurations de garde-fous à un seul niveau de prix.
Le tarif à planifier est celui de Fable, car vous ne pouvez pas utiliser Mythos
Voici la partie que la plupart des articles sur les tarifs passent sous silence. Un chiffre sur une grille tarifaire n'est réel que si vous pouvez appeler le modèle. Pour Mythos 5.1, la plupart des équipes ne le peuvent pas.
L'accès est aujourd'hui réservé aux États-Unis, et passe par une de trois portes : le Cyber Verification Program d'Anthropic (où l'accès à Mythos est promis « dans un futur proche » mais n'est pas encore actif), le Life Sciences Verification Program (une bêta sur invitation uniquement, construite avec le gouvernement américain), ou une conversation directe avec votre équipe de compte Anthropic, AWS ou Google Cloud. En plus de cela, utiliser Mythos 5.1 exige d'accepter par défaut une conservation des données de 30 jours, ce qui constitue une ligne à part dans toute revue d'achat.
Pour tous les autres, le modèle que vous pouvez réellement mettre en production est Fable 5.1, disponible sur l'API Claude, Bedrock, Google Cloud et Foundry sans aucune barrière de vérification. Et puisque ce sont les mêmes poids, « lequel offre le meilleur rapport qualité-prix » est la mauvaise question. Vous achetez Fable 5.1, vous planifiez autour du tarif de Fable 5.1, et le fait que les deux grilles tarifaires soient identiques signifie que vous ne perdez rien en n'ayant pas accès à Mythos. La grille tarifaire de Mythos se lit mieux comme une confirmation de ce que vous paierez pour Fable, et non comme quelque chose de séparé à comparer.
Trois changements d'API qui affectent votre facture et votre workflow
La tarification ne se résume pas au tarif par token, c'est aussi ce que votre intégration doit faire pour atteindre ce tarif. Trois changements d'API qui cassent la compatibilité arrivent avec cette génération et s'appliquent aussi à Fable 5.1, donc intégrez-les dans toute migration :
- L'utilisation forcée d'outil renvoie désormais une erreur. Si votre agent s'appuyait sur le fait de forcer un appel d'outil spécifique, ce schéma casse, et vous devrez revoir le flux d'utilisation d'outils.
- Les blocs de thinking sont liés au modèle qui les a produits. Vous ne pouvez plus rejouer librement une transcription de thinking issue d'un autre modèle.
- Les nouveaux comptes API ne peuvent pas modifier un contexte antérieur tout en conservant la transcription de thinking. C'est une mesure anti-distillation, et elle change la manière dont vous pouvez structurer de longues boucles d'agents.
Aucun de ces changements ne modifie le prix affiché, mais ils peuvent modifier le temps d'ingénierie, qui est le véritable coût total de possession de toute migration de modèle. Budgétez le travail d'adaptation, pas seulement les tokens.
Comment il se positionne face au reste de la gamme
En plaçant Mythos 5.1 à côté des modèles avec lesquels vous le comparerez réellement, le tableau est moins « palier premium, prix premium » que ne le suggère le tarif de base, une fois que le cache entre en jeu.
| Modèle | Entrée / sortie (par M) | Lecture de cache (par M) | Contexte |
|---|---|---|---|
| Mythos 5.1 / Fable 5.1 | 10 $ / 50 $ | 0,25 $ | 1M |
| Opus 5 | 5 $ / 25 $ | 0,50 $ | 1M |
| Sonnet 5 | 2 $ / 10 $ | 0,20 $ | 1M |
| Haiku 4.5 | 1 $ / 5 $ | 0,10 $ | 200K |
Opus 5 coûte moitié moins cher en tarif de base, mais sa lecture de cache est deux fois plus chère. Donc, sur une charge de travail majoritairement composée de hits de cache, l'écart effectif entre Opus 5 et Mythos/Fable 5.1 se réduit nettement, ce qui est exactement le cas pour lequel Anthropic optimise. Pour une charge de travail majoritairement composée d'entrée et de sortie nouvelles, Opus 5 reste clairement moins cher. Il n'existe pas de réponse unique de « modèle le moins cher », c'est pourquoi le calculateur ci-dessus compte davantage que n'importe quel classement.
Il vaut la peine de nommer l'éléphant dans la pièce, comme l'a fait le fil Hacker News : des modèles ouverts et chinois moins chers tarifent désormais les lectures de cache à quelques centimes, et plusieurs commentateurs ont soutenu que cela impose un plafond à ce que les laboratoires de pointe peuvent facturer. Le tarif de Mythos 5.1 est une réponse à cette pression, pas une immunité contre elle.
Essayez eesel
Si vous lisez une page de tarifs de modèle, vous essayez généralement de répondre à une question qui vient après : combien cela va-t-il réellement coûter de résoudre des tickets de support ou d'écrire du contenu. C'est une question différente de « quel est le tarif par token », et c'est celle à laquelle eesel est conçu pour répondre.
Le modèle est de l'infrastructure. eesel est l'employé que vous embauchez au-dessus. Vous n'avez pas à provisionner Mythos ou Fable, à compter les lectures de cache, ou à réserver de la capacité. Vous engagez un coéquipier IA prêt à l'emploi pour une tâche spécifique, et aujourd'hui l'équipe comprend un coéquipier IA de helpdesk qui rejoint votre file de support existante, ainsi qu'un rédacteur de blog IA. Chacun arrive avec les compétences, les intégrations et le contexte de l'entreprise nécessaires à son rôle, et le prix est fixé par résultat résolu, pas par token, donc une facture prévisible remplace le calcul par token de cette page.
Et parce que les ingénieurs le demandent : eesel se pilote depuis la CLI eesel, donc le même coéquipier que vous configurez dans le tableau de bord peut être manipulé depuis un terminal, automatisé dans des scripts, ou piloté par un agent de codage comme Claude Code, Codex ou Cursor. Si votre intérêt pour le tarif de Mythos 5.1 portait en réalité sur l'intégration d'un modèle dans un workflow de support ou de contenu, c'est cette couche qui transforme un modèle brut en travail réellement accompli. C'est gratuit à essayer.
Questions fréquentes
Combien coûte Claude Mythos 5.1 ?
Pourquoi Claude Mythos 5.1 coûte-t-il le même prix que Fable 5.1 ?
Quel est le prix de la lecture de cache de Claude Mythos 5.1 ?
Puis-je réellement accéder à Claude Mythos 5.1 ?
Le tarif de Claude Mythos 5.1 en vaut-il la peine face à Opus 5 ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.