

Sakana AI a fixé le prix de Fugu Max à $2 par million de tokens d'entrée et $6 par million de sortie, au forfait quelle que soit la longueur du contexte, plus $0,25 par million d'entrée en cache et $0,007 par appel de recherche web ou de fetch. Si vous préférez payer au mois, il y a trois abonnements, à $20, $100 et $200, et chacun inclut tous les modèles Fugu.
Le tarif affiché est bas, mais une page de prix ne raconte jamais toute l'histoire. Deux choses font bouger la facture réelle : Fugu Max est un modèle d'orchestration qui répartit une requête sur un ensemble de modèles plus petits, et tout ce trafic interne tombe sur votre compteur, si bien qu'une requête peut coûter plus cher qu'un appel à un seul modèle. Dans l'autre sens, le cache fait beaucoup de travail : sur le panneau en direct d'OpenRouter, le prix d'entrée effectif des premiers jours de Fugu Max s'est situé autour de $0,61 par million contre $2 au catalogue.
Je regarde depuis plus de trois ans des équipes choisir des modèles pour le support client, et le schéma est toujours le même : le tarif par token est le chiffre le plus facile à comparer et le mauvais à optimiser. Ce que vous payez pour résoudre un ticket dépend de tout le système autour du modèle. C'est le vide que comble un teammate IA comme eesel, et c'est là que se trouve le vrai calcul de coût.
Tarifs de Sakana Fugu Max : la grille complète
Voici le tableau complet du paiement à l'usage pour le modèle, tiré de la FAQ de Sakana et de la page du modèle sur OpenRouter. L'identifiant du modèle est fugu-max (v1.0).
| Poste | Tarif Fugu Max |
|---|---|
| Entrée / 1M tokens | $2.00 |
| Sortie / 1M tokens | $6.00 |
| Entrée en cache / 1M tokens | $0.25 |
| Supplément selon la longueur du contexte | Aucun, forfaitaire à toute longueur |
| Recherche web / fetch | $0.007 par appel |
Le tarif forfaitaire est ce qu'il y a de plus net. Selon Sakana, le tarif de $2/$6 reste valable « quelle que soit la longueur du contexte » : un prompt de 900K tokens coûte donc le même prix par token qu'un prompt court, quelle que soit la capacité de la fenêtre de contexte. La plupart des modèles de pointe ajoutent un supplément pour contexte long au-delà d'un seuil : si vous envoyez régulièrement de gros documents à un modèle, c'est un avantage réel et vérifiable.
Par contraste, son cousin Fugu Ultra v2 augmente bien avec le contexte long, ce qui fait ressortir le tarif forfaitaire du niveau Max, même au sein de la même famille :
| Poste | Fugu Ultra v2 (standard) | Fugu Ultra v2 (>272K) |
|---|---|---|
| Entrée / 1M | $5.00 | $10.00 |
| Sortie / 1M | $30.00 | $45.00 |
| Entrée en cache / 1M | $0.50 | $1.00 |
Les deux façons de payer, et un piège de nom
Vous pouvez acheter Fugu de deux façons, et on les confond facilement.
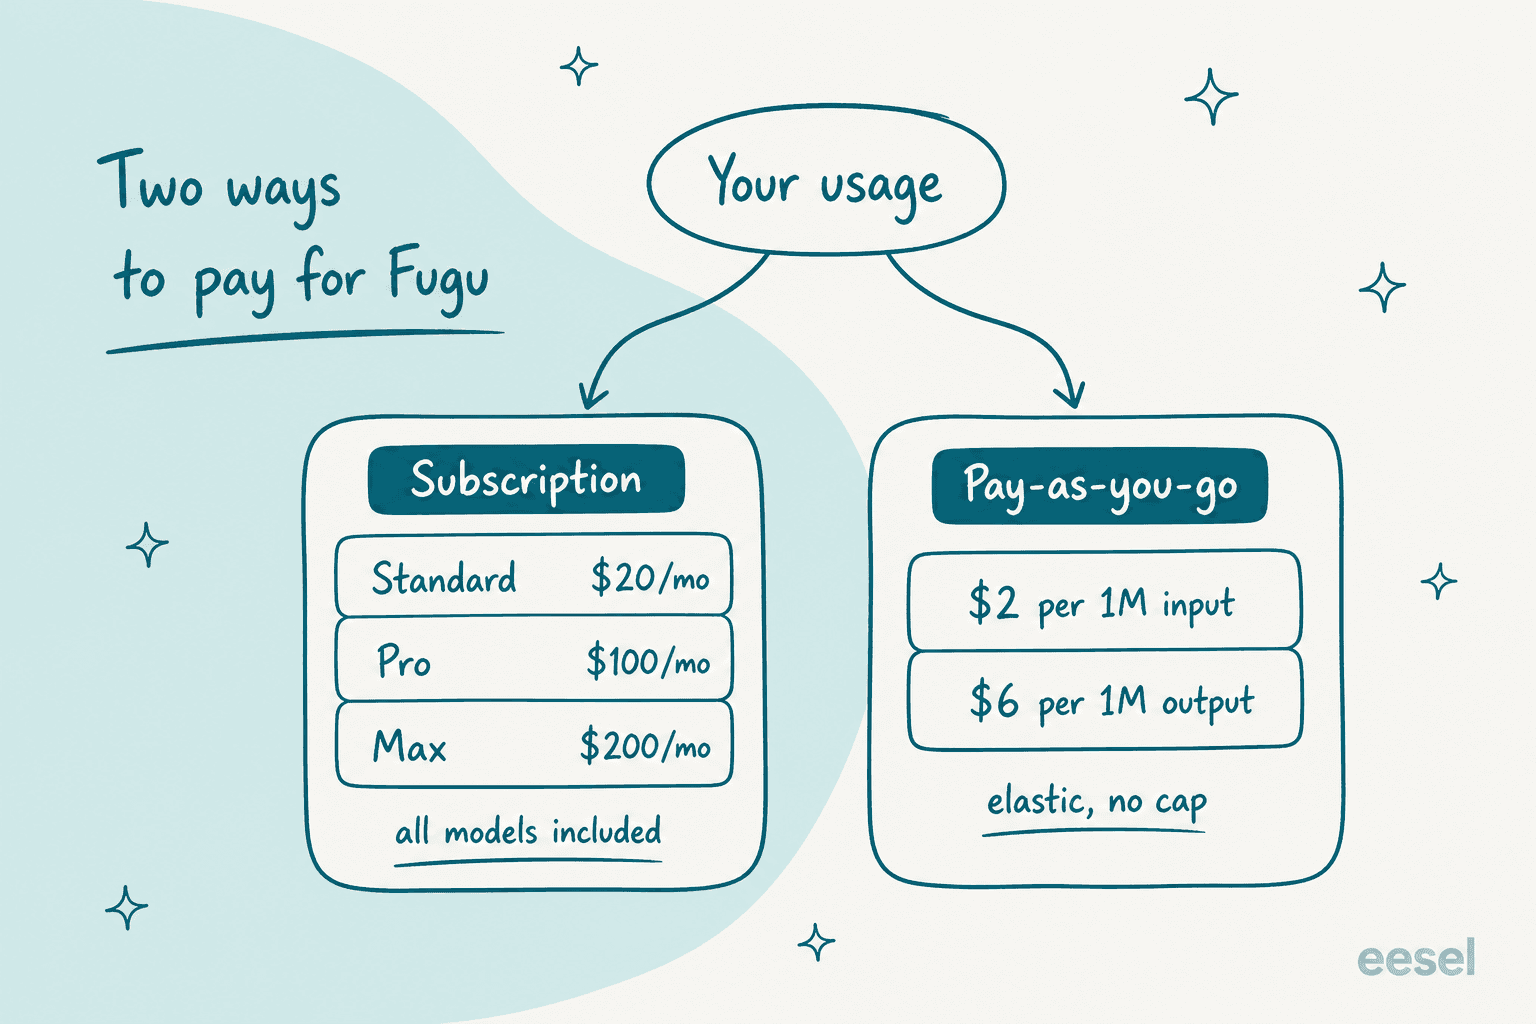
Les abonnements sont une enveloppe mensuelle, et chaque niveau donne accès à tous les modèles Fugu, pas seulement à Max :
| Offre | Prix | Enveloppe |
|---|---|---|
| Standard | $20/mois | De base |
| Pro | $100/mois | 10x Standard |
| Max | $200/mois | 20x Standard |
Le paiement à l'usage, lui, « facture selon la consommation de tokens plutôt qu'une enveloppe mensuelle, offrant une capacité élastique pour les pics et les gros travaux », ce que Sakana destine aux entreprises qui ne peuvent pas plafonner leur usage à l'avance.
Voici maintenant le piège. L'abonnement « Max Plan » n'est pas la même chose que le modèle « Fugu Max ». L'offre à $200 est une enveloppe d'usage qui inclut tous les modèles de la famille ; Fugu Max est l'un des modèles qu'elle contient. Vous pouvez très bien utiliser le modèle Fugu Max avec l'offre Standard à $20 ou en paiement à l'usage, sans avoir besoin de l'abonnement à $200. C'est un petit chevauchement de mots qui piège presque tous ceux qui lisent la page de prix pour la première fois.
Le piège des tokens d'orchestration
C'est la partie des tarifs de Sakana Fugu Max qu'une grille de prix cache, et c'est la chose la plus importante à comprendre avant de budgéter.
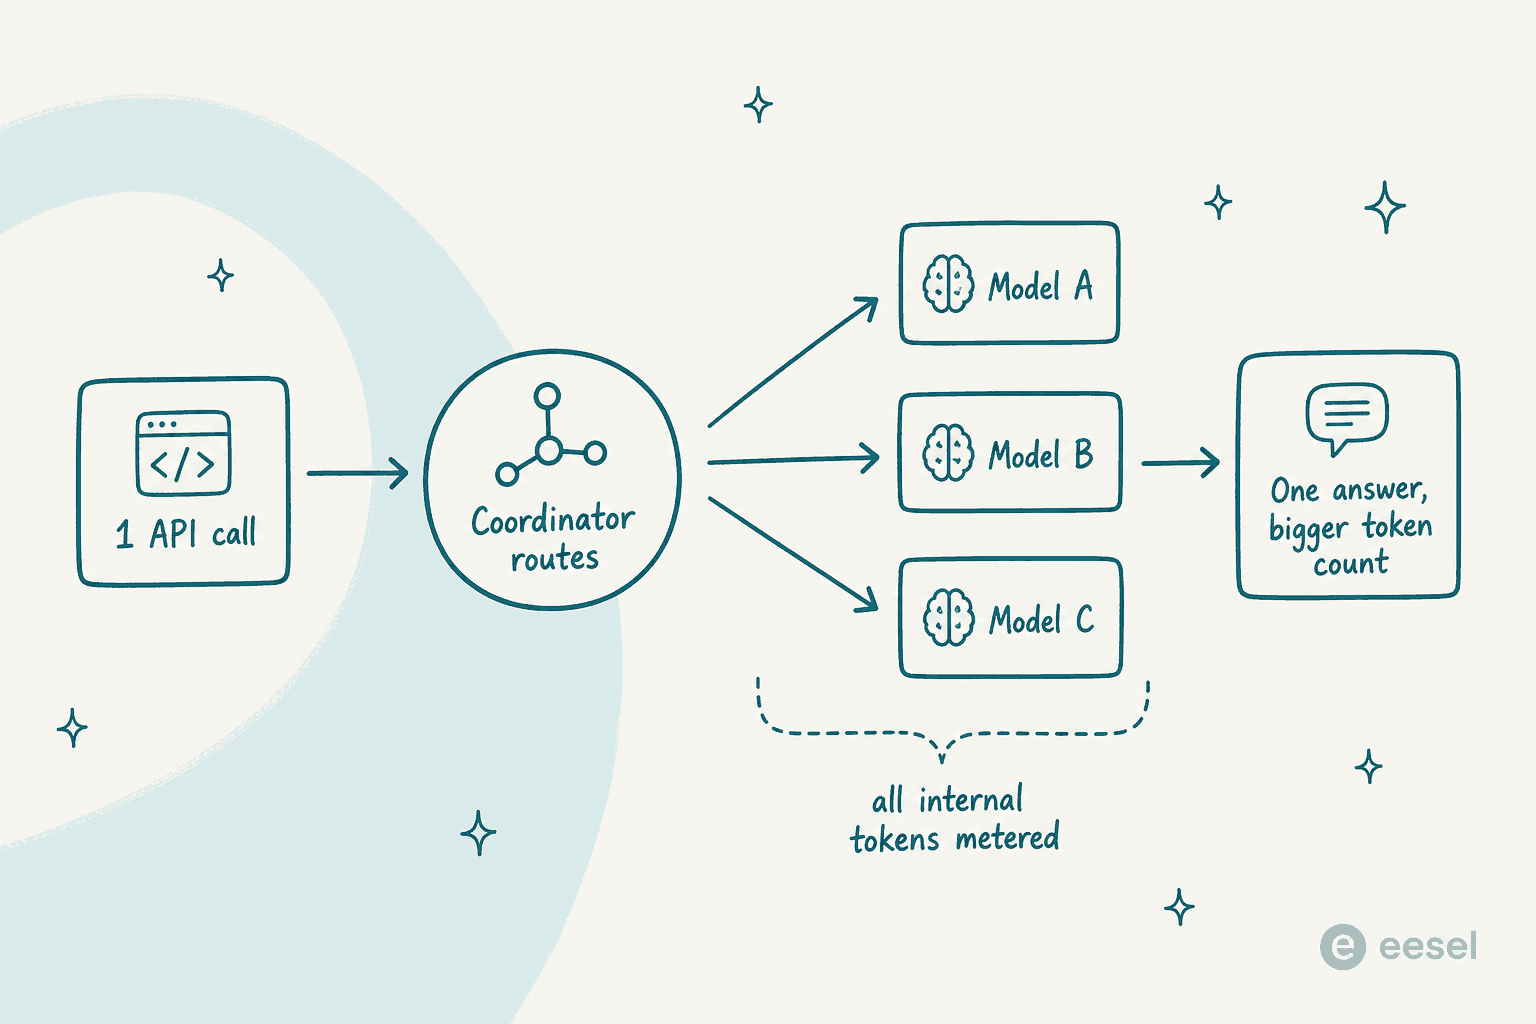
Quand vous appelez Fugu Max, vous ne parlez pas à un seul modèle. Vous parlez à un coordinateur entraîné qui lit votre requête, la route vers un ensemble de modèles à poids ouverts et spécialisés, puis synthétise une réponse. C'est tout l'intérêt de la famille Fugu : vous obtenez un système multi-agents, un vrai modèle d'agent IA, sans le construire.
La conséquence sur la facturation est énoncée sur OpenRouter : « Orchestration tokens consumed by the system are billed as standard input/output tokens. » En clair, les échanges internes entre les modèles passent sur votre compteur, ils ne sont pas gratuits. Une seule requête qui se répartit sur trois ou quatre modèles peut donc brûler nettement plus de tokens qu'un appel direct à un seul modèle, et le faible tarif de sortie de $6 ne se traduit pas automatiquement par une faible facture par réponse.
Sakana atténue cela, et il faut citer le mécanisme honnêtement. Selon sa FAQ, lorsque plusieurs agents sont actifs, « we never stack fees: you pay a single rate based on the top-tier model involved. » Ajouter des agents à une requête ne multiplie donc pas le tarif facturé : cela fait simplement circuler plus de tokens à ce tarif unique. Conclusion : votre coût suit le total de tokens, et l'orchestration gonfle ce total. Budgétez en tokens par réponse, pas selon le tarif affiché.
Ce que les acheteurs ont réellement payé les premiers jours
Prix catalogue et factures réelles sont deux chiffres différents, et pour une fois nous avons une fenêtre publique sur l'écart. Sur le panneau de prix en direct d'OpenRouter, les premiers jours de Fugu Max après son lancement du 11 septembre, les chiffres ressemblaient à ceci :
- Au catalogue : $2 en entrée / $6 en sortie par million.
- Prix d'entrée effectif : ~$0,61 par million, bien en dessous des $2 du catalogue.
- Prix de sortie effectif : $6 par million, inchangé.
- Taux de succès du cache : 79,4%, ce qui tire le prix d'entrée effectif vers le bas.
- Débit d'environ 29 tokens par seconde, un seul fournisseur, 100% de disponibilité.
Le cache fait donc fortement baisser le coût d'entrée, tandis que la sortie reste au prix catalogue. Cela indique où concentrer l'effort d'optimisation : Fugu Max récompense le cache intensif et pénalise la génération bavarde, lourde en sortie. Si votre charge réutilise beaucoup le même contexte (un prompt système fixe, un corpus de documents stable), le tarif d'entrée effectif peut n'être qu'une fraction du tarif affiché. Si chaque appel est neuf et lourd en sortie, vous vivrez plus près de la ligne des $6.
Comment le coût se compare à d'autres modèles
C'est ici que le tarif obtient son titre. Sakana affirme dans son article de lancement que Fugu Max fournit une sortie « 40-60% moins chère » que Sonnet 5, GPT-5.6 Terra et Kimi K3, tout en restant « within striking distance of elite models ». Aligné sur les tarifs catalogue de chaque fournisseur, l'écart en sortie est réel :
| Modèle | Entrée / 1M | Sortie / 1M |
|---|---|---|
| Fugu Max | $2.00 | $6.00 |
| GPT-5.6 Terra | $2.00 | ~$12.00 |
| Sonnet 5 | $3.00 | ~$15.00 |
| Kimi K3 | $3.00 | ~$15.00 |
Deux réserves honnêtes avant de faire une capture de ce tableau. D'abord, ce sont des tarifs catalogue au moment de la rédaction, et les fournisseurs les modifient : prenez ces valeurs comme un instantané, pas comme un contrat. Ensuite, la comparaison porte sur le tarif brut par token, qui, comme le montre la section sur l'orchestration, n'est pas la même chose que votre coût par réponse sur Fugu Max. Un modèle qui répartit le travail dépensera plus de tokens pour parvenir à la même réponse qu'un modèle qui ne le fait pas : un tarif plus bas peut donc donner une facture similaire.
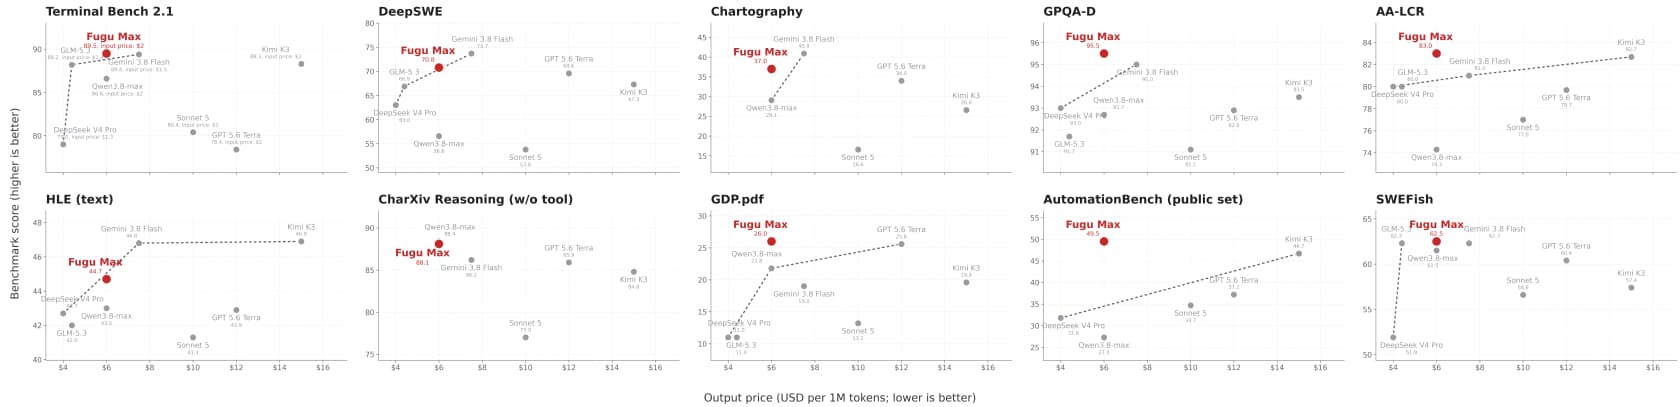
L'argument d'efficacité est le vrai discours de vente, et je trouve qu'il est honnête : une performance proche des modèles d'élite pour un coût de sortie plus bas, vérifiée pour l'instant uniquement par les benchmarks de Sakana. Les modèles propriétaires les plus puissants, comme Fable 5, ne font pas partie du pool de Fugu, ce qui est précisément le propos de Sakana et aussi une limite à la portée de la comparaison. Comme pour toute affirmation sur un modèle d'IA, la grille du fournisseur est un point de départ, pas une preuve.
Estimez votre propre facture Fugu Max
Les calculs ci-dessus se sentent mieux qu'ils ne se lisent : voici donc une calculatrice rapide. Entrez votre volume mensuel approximatif et votre comportement de cache, et elle estime la facture en paiement à l'usage et indique à partir de quand l'abonnement Max à $200 devient pertinent.
Le levier qui saute aux yeux en déplaçant les curseurs : le taux de succès du cache fait plus bouger la ligne d'entrée que le volume brut. Cela correspond aux données d'OpenRouter, et c'est la première chose que j'ajusterais avant de me soucier du niveau d'abonnement.
Où s'arrête la facture d'un modèle et où commence le coût réel
Voici la distinction à laquelle je reviens sans cesse, car un article sur les prix la fait facilement oublier : la facture de tokens n'est pas le coût qui compte pour la plupart des tâches. C'est le coût du moteur, pas celui du travail.
Prenons le support client, le domaine que je connais le mieux. Un modèle, aussi bon marché que soient ses tokens, vous renvoie du texte. Pour en faire des tickets résolus, il faut encore le connecter à votre helpdesk, lui enseigner votre base de connaissances et vos politiques, lui donner la permission de consulter une commande ou d'étiqueter un ticket, décider quand il escalade vers un humain et prouver qu'il est sûr avant qu'il touche un vrai client. Ce travail représente l'essentiel du projet, et rien de tout cela n'apparaît dans un tarif au million de tokens.
C'est exactement pourquoi je compare le coût d'un agent IA à celui d'un agent humain sur la résolution, pas sur les tokens, et pourquoi une comparaison de coût avec une équipe de support offshore repose sur le même calcul par résolution.
C'est la même logique qui rend Fugu lui-même séduisant : la plupart des équipes ne veulent pas construire elles-mêmes la plomberie multi-agents, alors elles achètent de l'orchestration gérée. Un cran plus haut, pour le support, vous ne voulez probablement pas non plus construire à la main tout l'employé autour d'un modèle.
Essayer eesel : fixez le prix du ticket, pas du token
C'est ce vide que comble eesel. eesel est une plateforme de teammates IA : vous embauchez des teammates prêts à travailler pour des missions précises, et chacun arrive avec les compétences, les intégrations et le contexte d'entreprise de son rôle. Le teammate IA de helpdesk rejoint votre file existante, consulte commandes et dossiers, étiquette les tickets et rédige ou envoie des réponses, le tout dans le helpdesk que vous utilisez déjà.

Ce qui compte dans un article sur les prix : vous ne faites jamais de calcul par modèle. eesel fonctionne sur des modèles de pointe en coulisses et gère ce choix pour vous, et facture un crédit par ticket ou chat (offres à partir de $299/mois pour 500 crédits), pas des tokens : le chiffre que vous prévoyez est celui qui correspond au travail accompli. Il s'entraîne sur vos tickets passés et votre base de connaissances, se branche à plus de 1000 outils comme Zendesk, Freshdesk et Gorgias, et vous laisse simuler sur des tickets historiques pour voir à la fois le taux de résolution et le coût avant qu'il réponde à un client, la répétition générale que le routage opaque de Fugu ne peut pas offrir.

Si vous vivez dans un terminal, eesel expose aussi une vraie surface programmable. La CLI eesel (@eesel/cli) et son serveur MCP permettent à une personne, un script ou un agent de code comme Claude Code de piloter le même teammate que le tableau de bord : connecter des intégrations, modifier les instructions permanentes du teammate, lancer eesel activity pour inspecter chaque exécution, et approuver ou refuser des actions, le tout en JSON, avec un indicateur --dry-run qui affiche l'appel exact qu'une écriture ferait avant de l'envoyer. C'est l'accès agentique qu'une API de modèle seule vous laisse construire vous-même.
Fugu Max est une réponse solide à « quel modèle doit alimenter mon appli, et combien coûteront les tokens ». Si votre vraie question est « combien coûtera-t-il de résoudre plus de tickets », vous pouvez essayer eesel gratuitement, sans carte bancaire et sans appel commercial, et fixer le prix du travail plutôt que du token.
Questions fréquentes
Combien coûte Sakana Fugu Max ?
Le tarif de Sakana Fugu Max est de $2 par million de tokens d'entrée, $6 par million de tokens de sortie et $0,25 par million de tokens d'entrée en cache, au forfait quelle que soit la longueur du contexte, d'après la FAQ de Sakana. Les appels de recherche web et de web fetch coûtent $0,007 chacun. Si vous préférez un abonnement mensuel, les offres sont à $20 (Standard), $100 (Pro) et $200 (Max), et chaque niveau inclut tous les modèles Fugu.
Quel est le tarif de Fugu Max par million de tokens ?
D'après OpenRouter et Sakana, l'identifiant de modèle fugu-max est listé à $2 en entrée, $6 en sortie et $0,25 en entrée en cache par million de tokens. Ce tarif ne varie pas avec la fenêtre de contexte : un prompt de 900K tokens est facturé au même prix par token qu'un prompt court.
Le « Max Plan » est-il la même chose que le modèle Fugu Max ?
Non, et c'est la confusion la plus courante sur les tarifs de Sakana Fugu Max. Le Max Plan à $200 est une enveloppe d'usage par abonnement qui inclut tous les modèles Fugu. Fugu Max est un modèle précis de la famille. Vous pouvez utiliser le modèle Fugu Max avec l'offre Standard à $20 ou en paiement à l'usage.
Fugu Max facture-t-il un supplément pour le contexte long ?
Non. Contrairement à Fugu Ultra v2, dont le prix augmente au-delà de 272K tokens, Fugu Max maintient un tarif forfaitaire de $2/$6 quelle que soit la longueur du contexte, selon Sakana. C'est prévisible pour les charges de travail avec de gros documents, là où d'autres modèles ajoutent un supplément pour contexte long.
Combien coûtent les tokens d'orchestration sur Fugu Max ?
Ils sont facturés comme des tokens d'entrée et de sortie normaux, selon OpenRouter. Comme un seul appel à Fugu Max peut se répartir entre plusieurs modèles internes, une requête consomme plus de tokens qu'un appel à un seul modèle : un faible tarif par token ne garantit donc pas toujours une faible facture par réponse. Sakana indique ne jamais cumuler les frais et appliquer un tarif unique, fixé d'après le modèle de plus haut niveau impliqué.
Où accéder à Fugu Max et consulter ses tarifs ?
Fugu Max est une API hébergée, disponible via console.sakana.ai, OpenRouter, le Vercel AI Gateway et opencode. Il n'est pas encore disponible dans l'UE ni dans l'EEE. Pour le support, un teammate IA masque le modèle et ses tarifs derrière un prix mensuel fixe.
Fugu Max est-il moins cher que de construire sa propre orchestration ?
Cela dépend de si vous devriez sinon construire et maintenir une couche de routage, le genre de choix abordé dans Assistants API vs LangChain. Fugu Max vend de l'orchestration gérée : vous payez la coordination que vous n'avez pas à construire. Pour le support client en particulier, vous pouvez sauter toute cette décision : un teammate IA comme eesel s'occupe du choix du modèle et vous permet de simuler sur des tickets passés pour voir le coût avant de vous engager. Comparez avec un chatbot à règles.
Comment les tarifs de Fugu Max se comparent-ils à Sonnet 5 et GPT-5.6 ?
En sortie, Fugu Max a le tarif catalogue le plus bas : $6 par million contre environ $12 pour GPT-5.6 Terra et $15 pour Sonnet 5. Sakana affirme que la sortie est 40-60% moins chère que Sonnet 5, GPT-5.6 Terra et Kimi K3, pour une qualité proche de la frontière. Ce sont des chiffres du fournisseur sur des benchmarks du fournisseur : testez sur vos propres tâches.