

Pourquoi un modèle de vision m'intéresse
Je construis les intégrations d'eesel, le code qui récupère tickets, pièces jointes et articles de centre d'aide dans des outils comme Zendesk et Freshdesk. L'essentiel de ce qui transite par cette tuyauterie est du texte, mais pas tout. Une demande est revenue sans cesse cette année dans les appels commerciaux d'eesel : des équipes de support de produits techniques voulaient que l'IA lise les schémas dans leurs PDF et les photos que les clients joignent aux tickets. Une société informatique du secteur public qui traite environ 3,000 tickets complexes par mois nous a dit que sa documentation technique était surtout composée d'images.
Alors, quand NVIDIA a sorti un modèle ouvert dont tout l'argument est « un seul modèle qui lit graphiques, tableaux, mises en page et vidéo, puis appelle des outils », j'ai lu la fiche du modèle ligne par ligne. Voici ce qu'il y a vraiment dedans, où les affirmations du lancement tiennent et où elles demandent une note de bas de page.
Qu'est-ce que Nemotron 3.5 Super VL ?
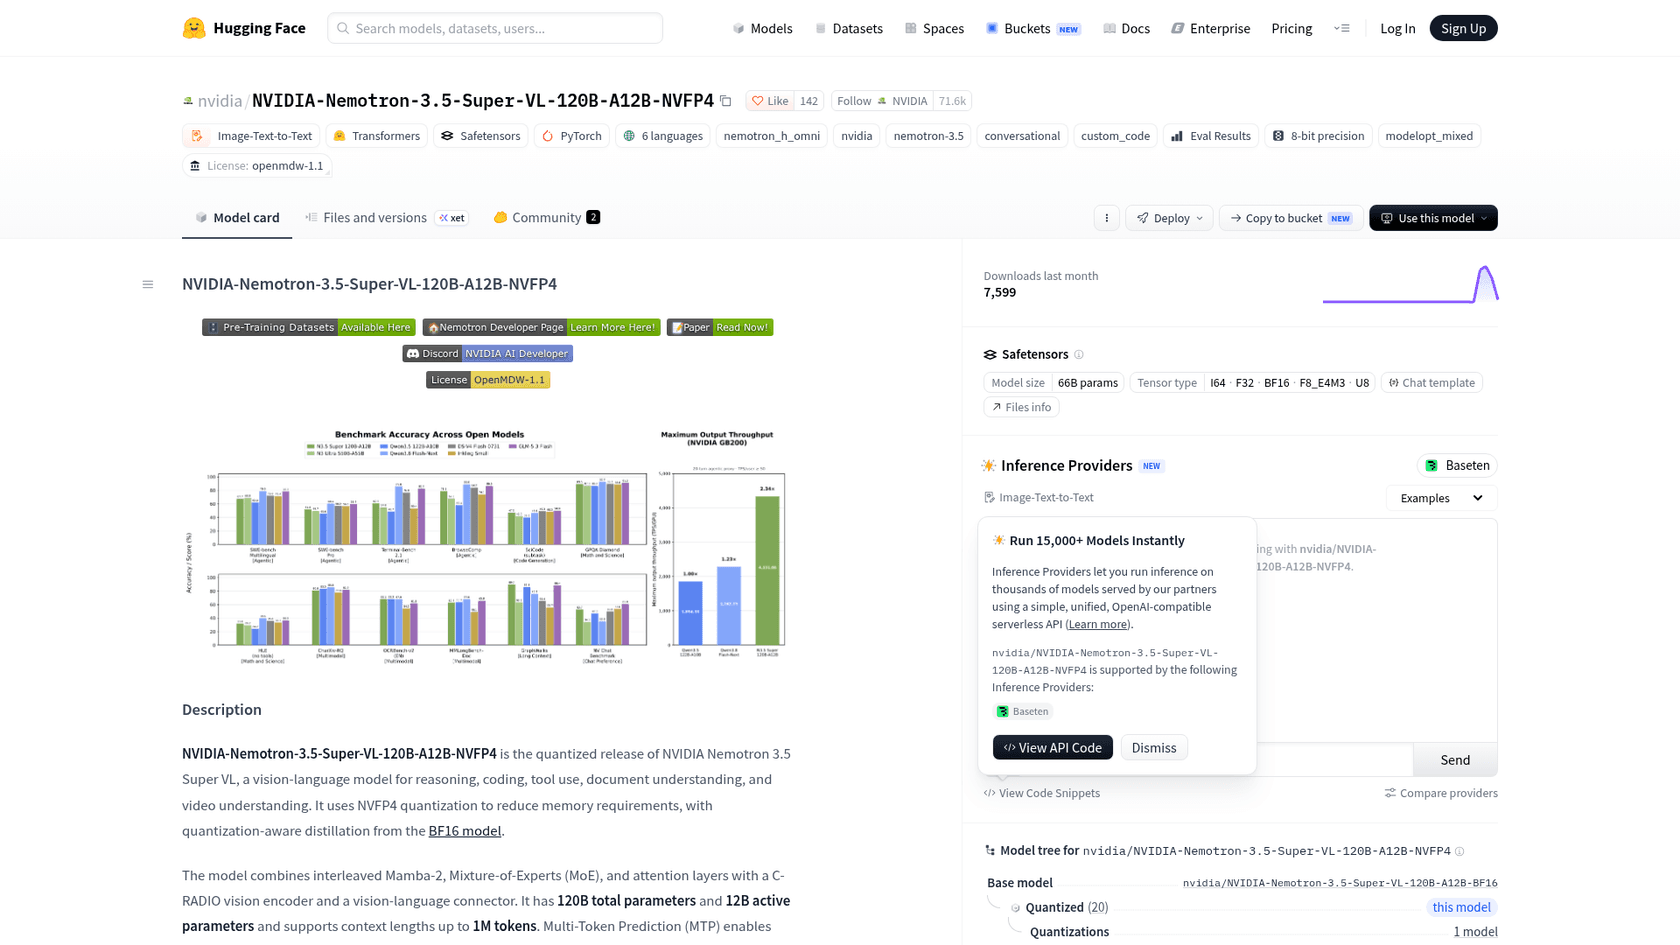
Nemotron 3.5 Super VL est le membre vision-langage de la famille Nemotron 3.5 de NVIDIA. La fiche du modèle BF16 le décrit comme un modèle pour « reasoning, coding, tool use, document understanding, and video understanding », et le mot clé est un. Au lieu d'enchaîner un modèle de texte avec un modèle de vision séparé et de se passer le contexte entre eux, les mêmes poids gèrent les deux.
Il est sorti avec deux petits frères. D'après l'annonce de NVIDIA, Bolt 74B-A9B utilise une quantification native 2 bits pour tenir dans 24GB pour des agents locaux, et Bolt E4B (4GB) arrive le 23 octobre pour la voix et l'embarqué.
Voici les specs qui comptent :
| Spec | Nemotron 3.5 Super VL |
|---|---|
| Publication | 15 octobre 2026 |
| Paramètres | 120B au total, 12B actifs par token |
| Architecture | Mélange d'experts hybride Mamba-2 et Transformer, 512 experts routés par couche MoE |
| Vision | Encodeur de vision C-RADIO plus un connecteur vision-langage |
| Entrées | Texte, images (JPEG, PNG), vidéo (MP4 jusqu'à 2 minutes) |
| Sortie | Texte |
| Fenêtre de contexte | Jusqu'à 1M de tokens (262,144 de sortie max sur OpenRouter) |
| Raisonnement | Désactivé, moyen ou activé, réglé dans le modèle de chat |
| Checkpoints | Base, post-entraîné BF16, NVFP4 |
| Licence | OpenMDW-1.1 |
La fiche du modèle indique qu'il est « ready for commercial or non-commercial use », et NVIDIA publie aussi les données d'entraînement et les recettes. Ce dernier point compte si vous prévoyez un fine-tuning. Vous voyez ce qui est entré dedans, ce qui n'est pas possible avec la plupart des modèles à poids ouverts, dont Kimi K3 et Mistral Large 4.
Comment ça marche sous le capot ?
En bref : c'est un modèle de taille moyenne conçu pour faire beaucoup de travail par GPU. Quelques choix de conception expliquent sa rapidité.
- Couches hybrides. Le réseau entrelace des couches Mamba-2 (une conception à espace d'états qui traite les longues séquences à faible coût) avec des blocs de mélange d'experts et un plus petit nombre de couches d'attention. Cela maintient la mémoire basse pour un long contexte, ce qui permet à une seule machine de tenir une fenêtre de 1M de tokens.
- Distillé depuis un modèle plus gros. NVIDIA indique que la base est partie de Nemotron 3 Super Base, puis a reçu 1T de tokens de distillation depuis Nemotron 3 Ultra Base. C'est ainsi qu'un modèle de 120B finit par battre son enseignant de 550B sur certains benchmarks d'agents.
- Brouillon intégré. Une tête de prédiction multi-tokens propose plusieurs tokens à la fois que le modèle principal vérifie, ce qui demande moins de passes coûteuses. Sur DGX Spark, le brouillonneur LiLiCorr de NVIDIA ajoute « up to 2.3x faster token generation ».
- 4 bits sans grande perte. Le checkpoint NVFP4 a été entraîné pour égaler le modèle en pleine précision. Artificial Analysis a constaté qu'il obtient à moins de 0.1 point de BF16 sur son indice.
Le pipeline d'entraînement explique aussi l'orientation agent : 67B de tokens de pré-entraînement intermédiaire en génie logiciel à 256K de contexte, puis fine-tuning supervisé sur des séquences empaquetées allant jusqu'à 524,288 tokens, puis apprentissage par renforcement et distillation multi-enseignants. Si vous avez suivi la façon dont les agents IA sont construits, c'est la recette qu'on attend pour un modèle destiné à des tâches longues et riches en outils.
Où il se place dans la gamme de modèles de NVIDIA
NVIDIA précise que Super VL n'est pas censé tout faire. Dans son article pour développeurs, elle décrit un « system of models » : Nemotron 3.5 Lightning gère les tâches de texte à gros volume, Nemotron 3 Ultra gère la planification et l'orchestration, et Super VL se place au milieu pour le travail spécialisé et multi-étapes qui exige vision et outils.
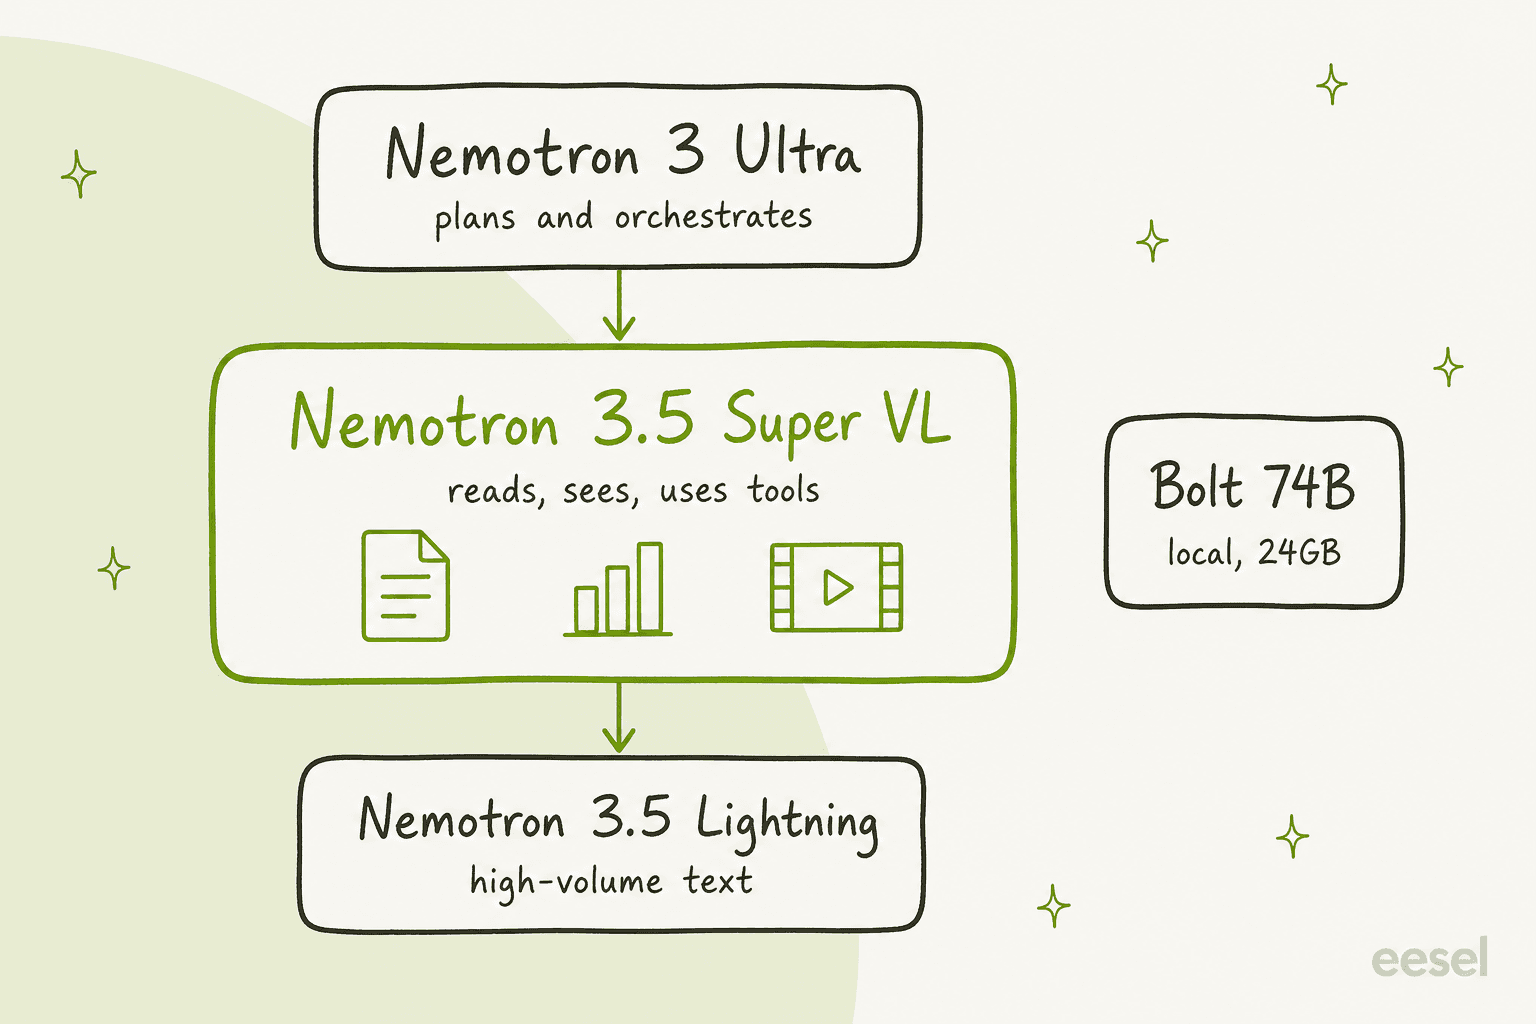
Ce cadrage est utile parce qu'il dit comment NVIDIA s'attend à ce que vous l'utilisiez. Super VL est l'ouvrier à qui vous confiez un PDF de 40 pages et un tableur, pas le modèle le moins cher pour classer un million de messages courts. Pour ce genre de classification de tickets, Lightning ou un petit modèle fermé comme Claude Haiku 5.5 convient mieux côté coût.
Est-il vraiment bon ?
Il faut ici lire deux tableaux de scores côte à côte.
Sur Artificial Analysis, le site de benchmarks indépendant, Nemotron 3.5 Super VL obtient 26.5 sur l'Intelligence Index, n° 1 sur 67 modèles à poids ouverts dans la catégorie de taille 40B à 150B. C'est le double de son prédécesseur Nemotron 3 Super (13), devant Nemotron 3 Ultra (22.9) et juste devant Inkling Small de Thinking Machines (25.7). Il a aussi tourné à 409 tokens de sortie par seconde, le plus rapide de sa catégorie.
Mais si l'on élargit la focale, le tableau change. Des modèles ouverts plus gros, qui coûtent à peu près pareil par token, obtiennent des scores bien plus élevés :
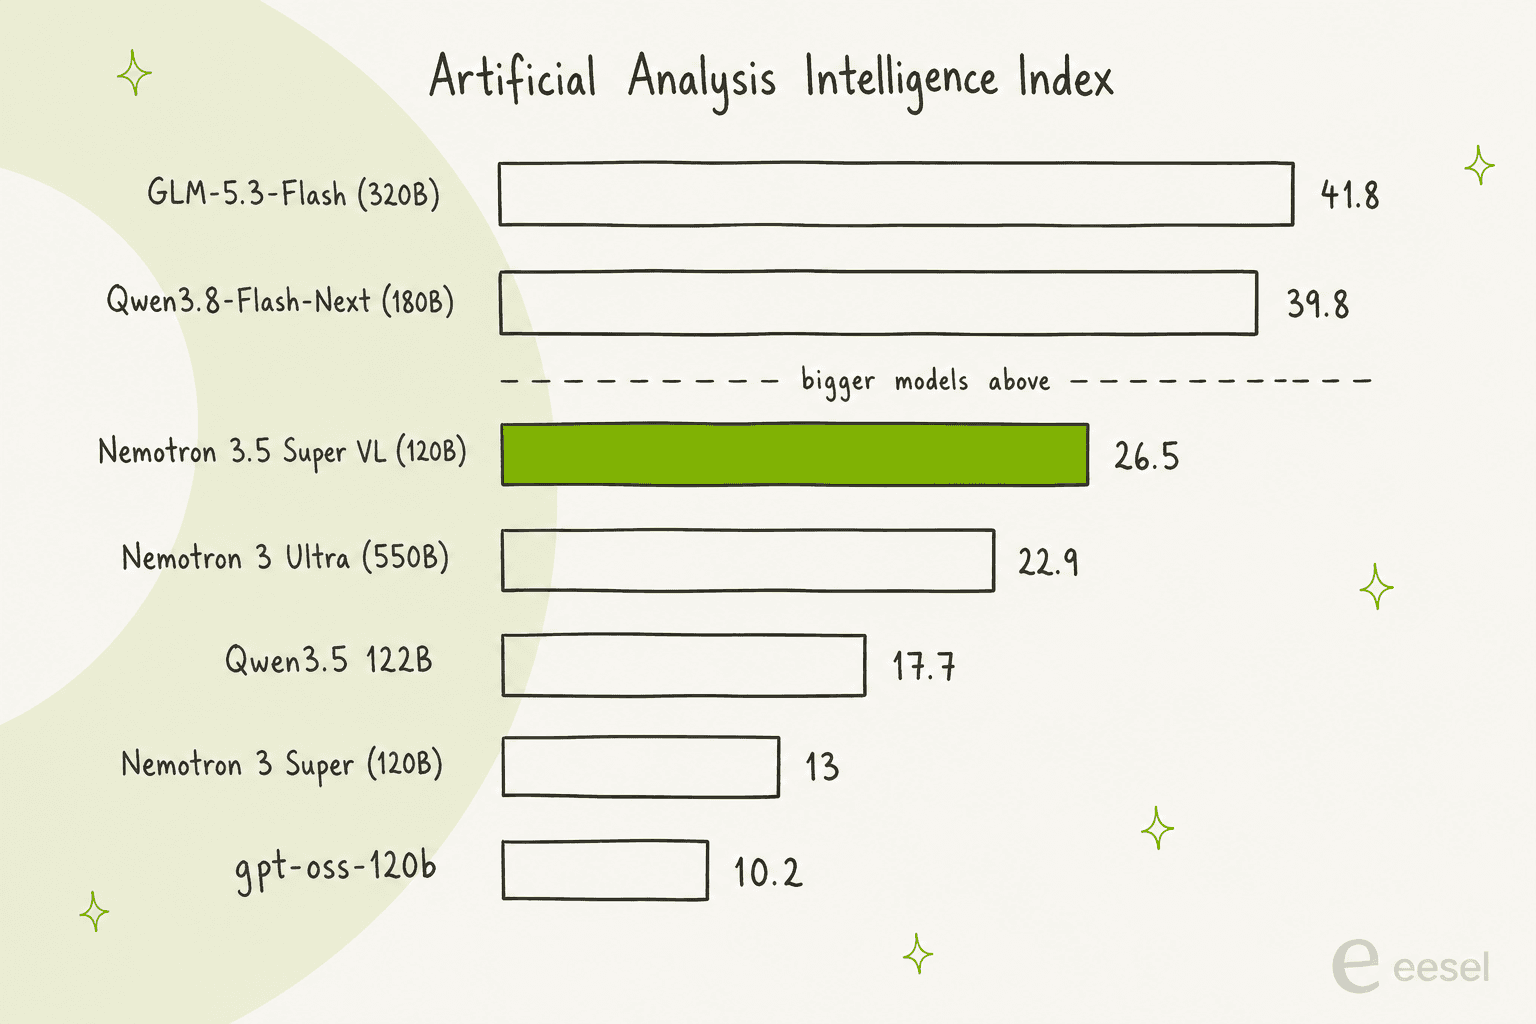
GLM-5.3-Flash (320B au total) obtient 41.8 et Qwen3.8-Flash-Next (180B au total) obtient 39.8. Le tableau de la fiche de modèle de NVIDIA elle-même inclut les deux, et ils battent Super VL sur la plupart des lignes, dont SWE-bench Verified (78.7 et 79.10 contre 71.10) et Terminal-Bench 2.1 (85.80 et 82.70 contre 60.67). Artificial Analysis note elle-même que les États-Unis restent derrière le MiMo-V2.6-Pro chinois (46) en intelligence à poids ouverts.
Alors, sur quoi Super VL gagne-t-il ? La vitesse, et le « quadrant le plus attractif » du graphique de NVIDIA, où la précision rencontre le débit :
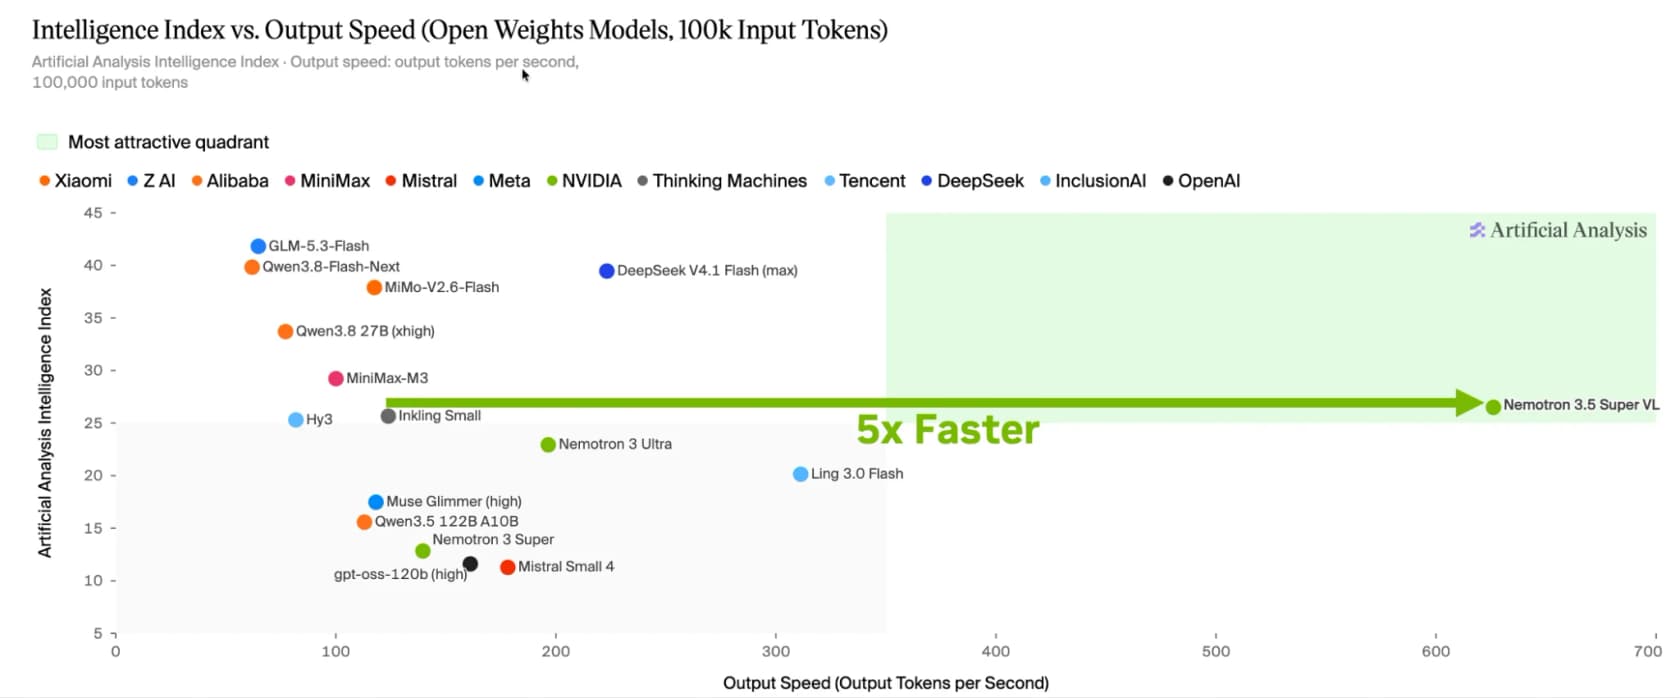
Sur les harnais d'agents en particulier, NVIDIA indique qu'il bat Ultra sur Hermes Bench (63.44 % contre 56.33 %) et sur les évaluations comportementales de LangChain (87.05 % contre 84.3 %). Et il est fort sur les documents : 80.8 % sur le benchmark de raisonnement sur graphiques CharXiv (84 % avec interprétation de code Python) et 68.12 sur OCRBench v2 en anglais.
Mon avis : Super VL n'est pas le modèle ouvert le plus intelligent, c'est le plus rapide des bons qui sache voir. Si votre agent écrit surtout du code, les plus gros modèles flash valent la mémoire supplémentaire. S'il lit des documents toute la journée et que le débit par GPU vous importe, Super VL est le premier à tester.
L'histoire du post-entraînement que NVIDIA met en avant
L'argument phare de NVIDIA, repris par la plupart de la couverture du lancement, est que Super VL post-entraîné bat Claude Opus 5, GPT-6.1 Sol et d'autres modèles de pointe sur des tâches spécialisées. Le graphique est réel. Regardez-le de près, cependant :
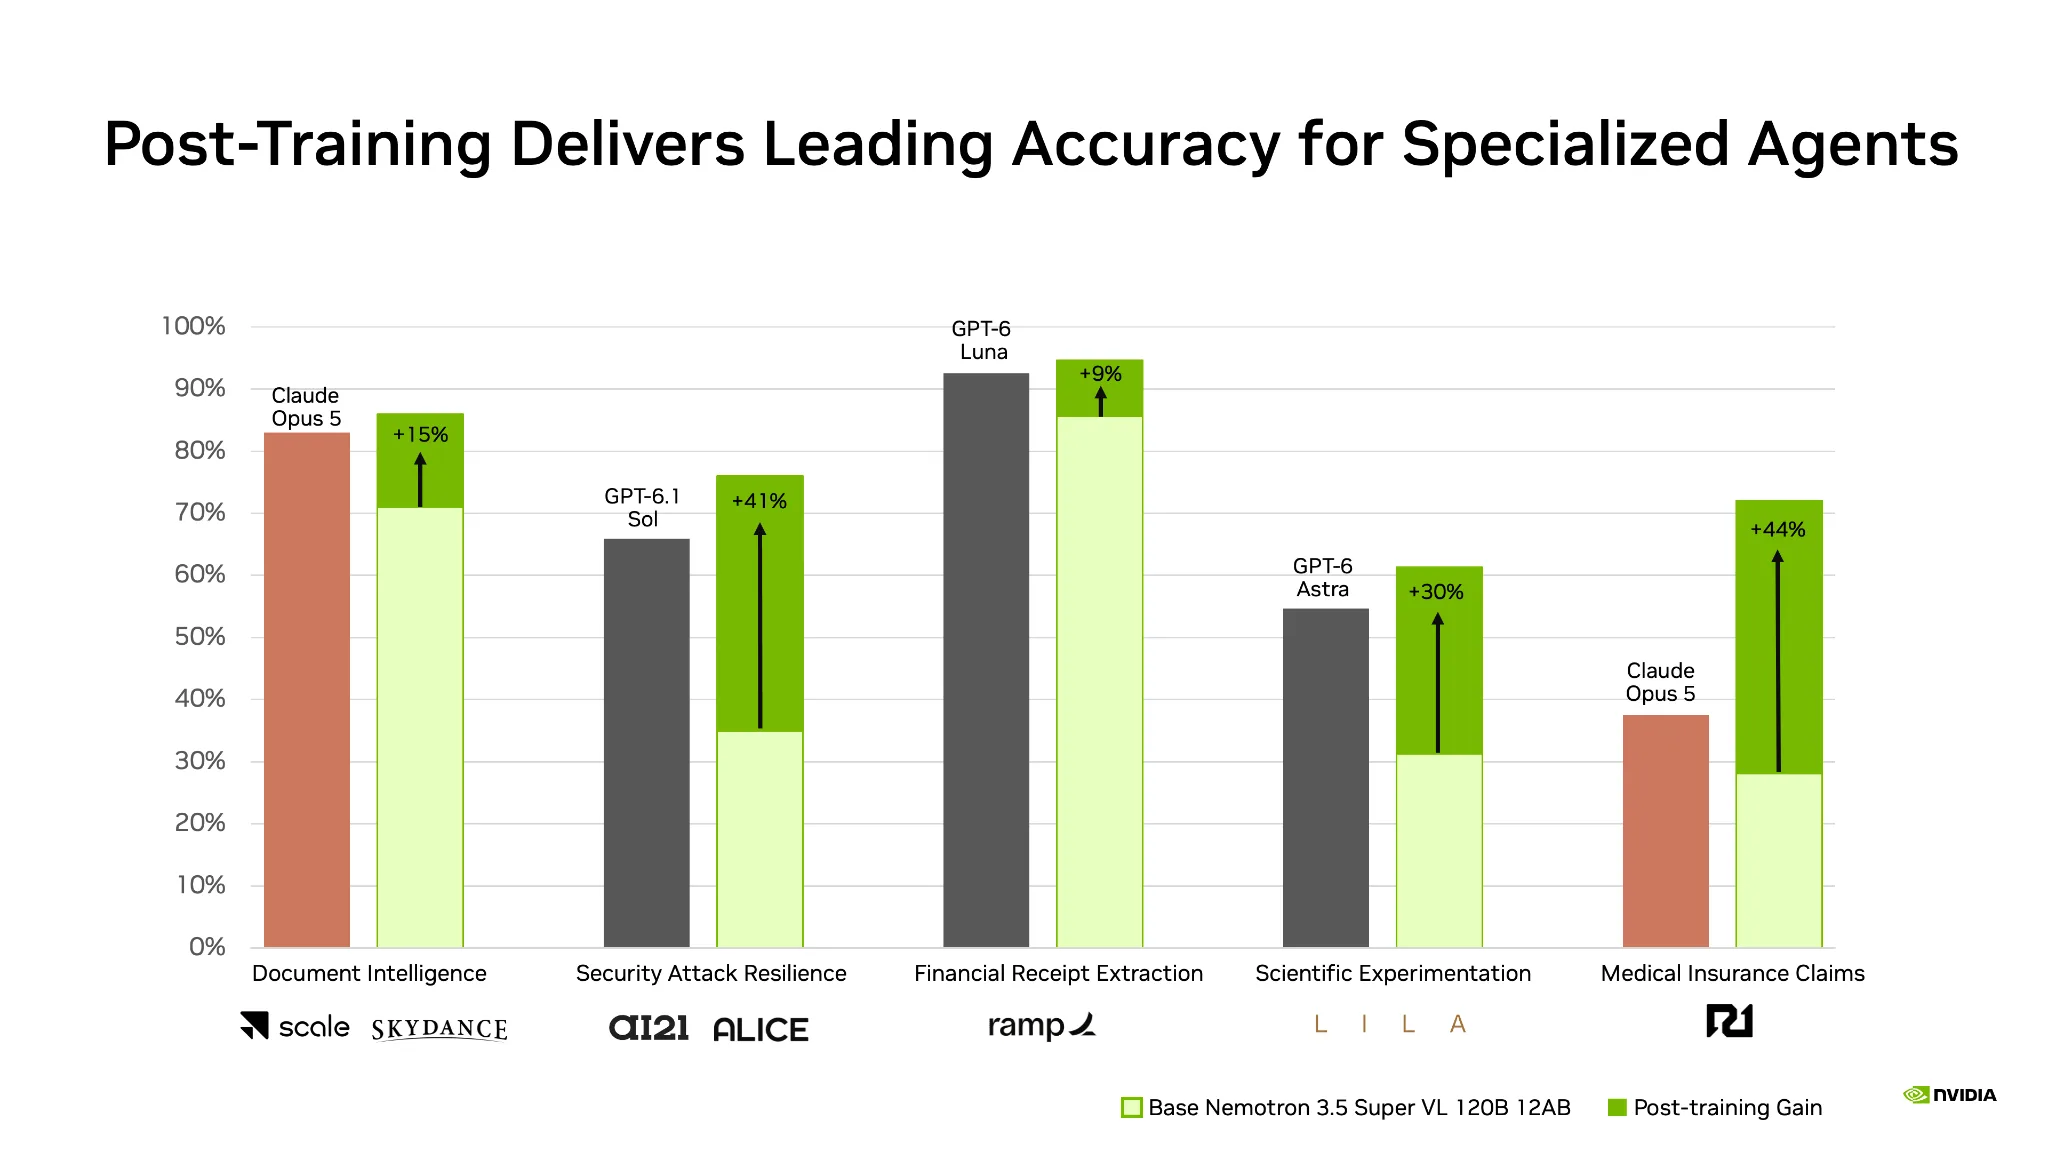
Sur les cinq tâches, le modèle de base en vert clair démarre sous le modèle de pointe. Sur la résistance aux attaques de sécurité, il démarre vers 35 % contre 66 % pour GPT-6.1 Sol, et ne le dépasse qu'après un gain de post-entraînement de +41 % par AI21 et Alice. La victoire vient de l'entraînement sur vos propres données, ce que permet justement un modèle ouvert avec des recettes ouvertes.
Les chiffres des partenaires sont concrets. Scale AI l'a post-entraîné pour le traitement des avoirs fournisseurs chez Skydance et s'attend à ce que le coût d'inférence baisse de 40x et la latence de 5x. Ramp transforme des images de reçus en JSON structuré et s'attend à un débit jusqu'à 50 % supérieur et une latence 10x plus faible.
La leçon pour les acheteurs : si vous prenez un modèle sur étagère et le pilotez par prompt, comparez les scores de base. Si vous avez une équipe et des données étiquetées pour post-entraîner avec NVIDIA NeMo, la recette ouverte de Super VL est le vrai produit.
Combien coûte Nemotron 3.5 Super VL ?
Les poids sont gratuits. En hébergé, c'est l'un des modèles performants les moins chers du marché :
| Fournisseur | Entrée / 1M tokens | Entrée en cache / 1M | Sortie / 1M |
|---|---|---|---|
| DeepInfra | $0.10 | $0.08 | $0.40 |
| Crusoe (via OpenRouter) | $0.10 | $0.08 | $0.40 |
| Together (via OpenRouter) | $0.15 | $0.02 | $0.50 |
| CoreWeave (via OpenRouter) | $0.15 | $0.02 | $0.50 |
| Venice (via OpenRouter) | $0.25 | $0.125 | $1.25 |
| Endpoint gratuit NVIDIA (via OpenRouter) | Gratuit | Gratuit | Gratuit |
Les lignes OpenRouter viennent de la page du modèle sur OpenRouter au 18 octobre. Un avertissement sur l'endpoint gratuit : la mention d'OpenRouter indique que votre usage « is logged for security purposes and to improve NVIDIA products », et demande de ne pas envoyer de données confidentielles ou personnelles. Cela l'exclut pour de vrais tickets clients.
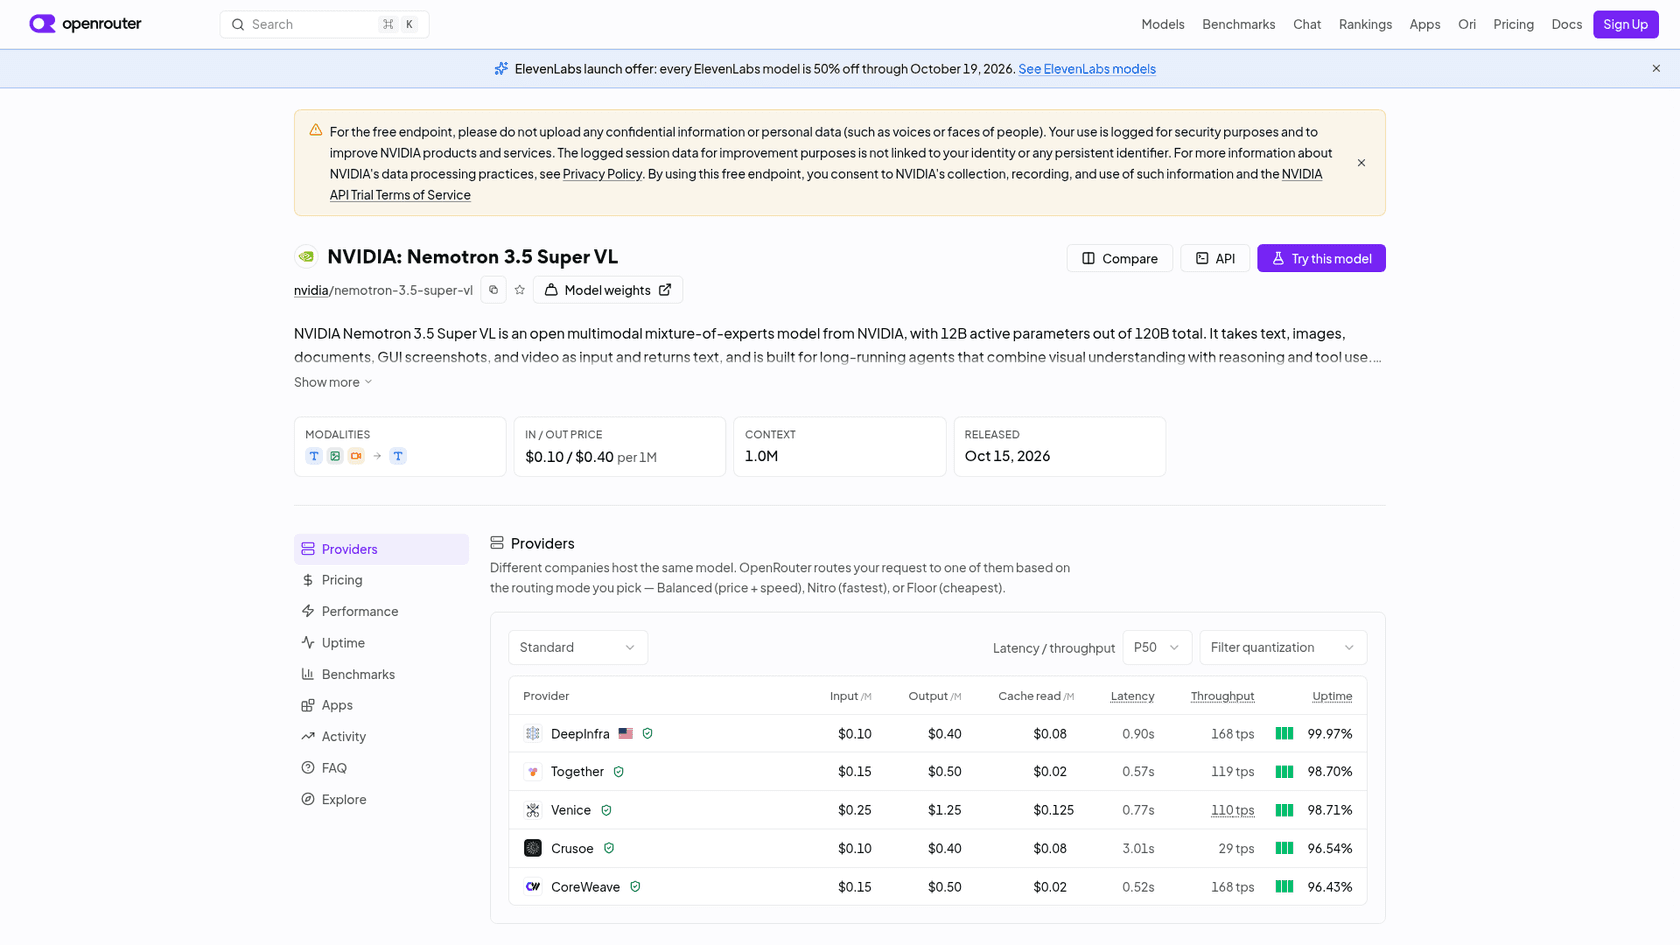
Le prix catalogue n'est pas toute la facture, car les modèles de raisonnement consomment des tokens de sortie. Artificial Analysis a mesuré $0.19 par tâche de l'Intelligence Index, moins cher que GLM-5.3-Flash ($0.28) et Qwen3.8-Flash-Next ($0.37) malgré des prix catalogue similaires, car Super VL a utilisé environ 46,000 tokens de sortie par tâche. C'est environ 60 % de moins que Nemotron 3 Super.
Pour voir ce que cela donne sur une charge de support, saisissez vos propres chiffres :
Avec les valeurs par défaut, 10,000 tickets coûtent environ $13 par mois en tokens chez DeepInfra. C'est ce que je voudrais qu'un responsable support retienne : la facture du modèle est le petit chiffre. Ce qui coûte cher, c'est tout ce qui l'entoure, comme la recherche d'information, les règles d'escalade, les tests et la mise à jour des réponses, ce qui est la même conclusion que celle de mon guide des modèles pour le support pour les modèles fermés.
Peut-on l'exécuter soi-même ?
Oui, et c'est là que Super VL se démarque. NVIDIA a conçu le checkpoint NVFP4 pour tenir sur un seul DGX Spark, et la liste des hébergeurs le jour du lancement était longue : Hugging Face, ModelScope, NIM, plus LM Studio, Ollama, vLLM, SGLang et Unsloth pour les exécutions locales.
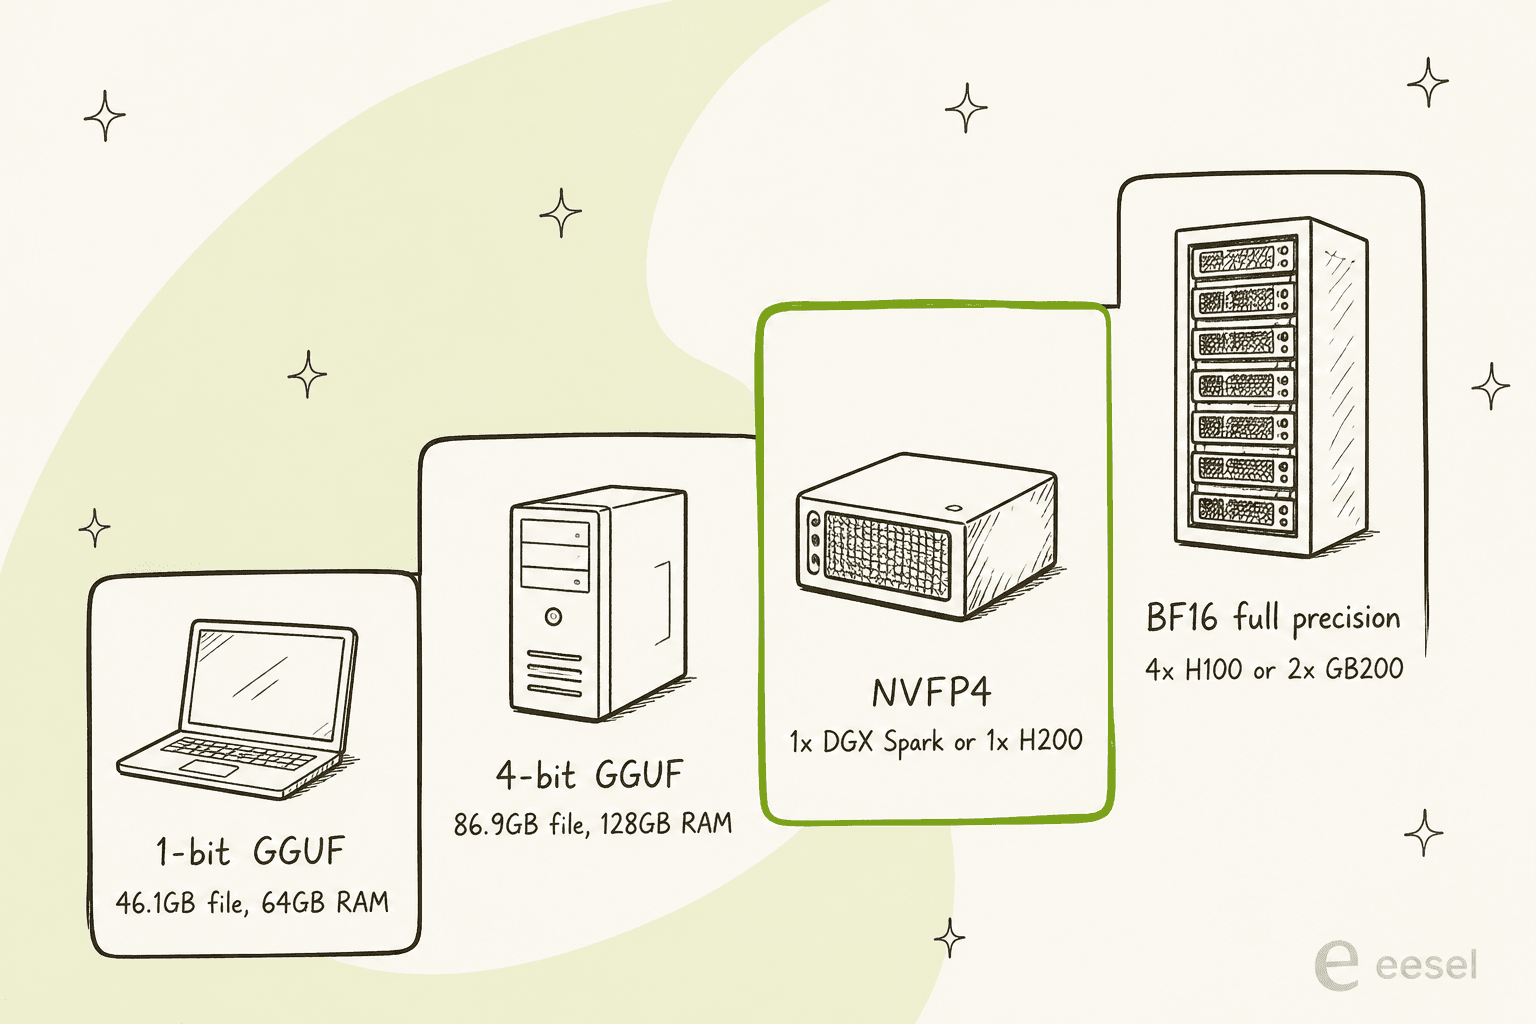
Les chiffres viennent de la fiche du modèle NVFP4 et du guide d'Unsloth, qui liste des versions GGUF de 46.1GB (1 bit) à 132GB (8 bits). La qualité tient bien en 4 bits. Le tableau comparatif de NVIDIA montre NVFP4 à moins d'un point de BF16 sur la plupart des benchmarks, même si WebVoyager passe de 77.72 à 66.31, donc testez les agents de navigation sur la version quantifiée avant de lui faire confiance.
Pour la production, NVIDIA le propose en microservice NIM et affirme que sa recette de serving Dynamo, sur 16 GPU B200, « serves up to 8x as many users while reducing first-token latency by 85%. » Si vous l'hébergez vous-même pour des raisons de résidence des données, associez-le à un bac à sable comme l'Open Agent Safety Platform de NVIDIA ou le runtime NemoClaw plutôt que de lui donner un accès brut aux outils.
La licence est la partie la plus nette de l'histoire. OpenMDW-1.1 accorde des droits « without restriction », demande seulement de conserver la licence et les mentions lors de la redistribution, et dit qu'elle n'impose aucune restriction sur les sorties. Il n'y a ni seuil de chiffre d'affaires ni obligation de mention « Built with », contrairement à Muse Spark Open.
Que disent les premiers testeurs ?
La première vague de réactions se partage nettement : impressionnée par la vitesse et le classement américain, plus prudente dès qu'on le compare à Qwen.
Artificial Analysis a présenté le lancement sous l'angle de son classement national :
"Nvidia's Nemotron 3.5 Super VL is now the leading US open weight model, scoring 26 on the Artificial Analysis Intelligence Index"
Harrison Kinsley, qui anime la chaîne Sentdex, le testait pour du code en local :
"This one may very well be a solid choice for a speedy local coding agent model"
Le test le plus utile que j'aie trouvé vient de Peter Dedene, qui a fait passer Super VL et Qwen3.8-Flash-Next dans son propre benchmark d'agents avec la réflexion désactivée. L'appel d'outils et le suivi d'instructions sont ressortis proches. L'injection de prompt, non : sur AgentDojo, où une instruction malveillante se cache dans la sortie d'un outil, Qwen l'a suivie dans 2 exécutions sur 200 et Nemotron dans 37.
"For an agent that touches untrusted input, I'd still pick Qwen. For long documents, Nemotron."
Il prend soin de noter que Nemotron est conçu pour raisonner et qu'il l'a testé avec le raisonnement désactivé, ce n'est donc pas le meilleur cas du modèle, et il prévoit une seconde série. Sur Hacker News, la réaction a été plus brève :
"this 3.5 Super is still below Qwen 3.8 next as they state themsleves"

Cela correspond au tableau de NVIDIA lui-même, donc c'est juste. NVIDIA n'a jamais prétendu battre Qwen sur les scores bruts. Elle revendique la vitesse, l'ouverture et la marge de progression par post-entraînement.
Convient-il au support client ?
C'est la question qui m'importe le plus, et la réponse est « ça dépend de ce que vous entendez par convenir ».
La vision convient vraiment. Les clients envoient des captures de messages d'erreur, des photos de produits endommagés et des PDF de factures. Un modèle texte seul voit « voir pièce jointe » et rien d'autre. Super VL lit la pièce jointe dans la même passe que le ticket, exactement le manque que ces équipes de support technique soulevaient dans les appels d'eesel. Si vous construisez votre propre pipeline avec quelque chose comme LangChain, cela supprime toute une étape de votre pipeline RAG de support.
Les benchmarks de support sont moyens. La fiche de modèle de NVIDIA rapporte tau2-bench, le benchmark simulé de service client où un agent doit suivre la politique d'une entreprise en parlant à un client simulé :
| Benchmark | Nemotron 3.5 Super VL | Qwen3.8-Flash-Next | GLM-5.3-Flash | Nemotron 3 Ultra |
|---|---|---|---|---|
| tau2-bench retail | 69.24 | 71.6 | 78.2 | 73.7 |
| tau2-bench airline | 76.50 | 80.8 | 81.8 | 79.8 |
| tau2-bench telecom | 73.19 | 90.4 | 98.5 | 83.0 |
| tau3-bench banking | 18.88 | 44.5 | 34.8 | 18.4 |
Super VL est derrière les trois concurrents sur chaque ligne sauf banking, où il devance de peu Ultra. Son taux d'hallucination sur AA-Omniscience (30.0 % dans l'exécution de NVIDIA) est meilleur que celui de la plupart des modèles du tableau, ce qui compte en support, où une réponse fausse et assurée est le pire résultat.
L'injection de prompt est le vrai risque. Chaque message client est une entrée non fiable. Le résultat de Dedene, 37 sur 200, vient d'un seul test avec le raisonnement désactivé, mais il rejoint une leçon qu'eesel a apprise à ses dépens : on ne peut faire confiance à aucun modèle pour se surveiller lui-même sur une file en direct. C'est pourquoi nous simulons chaque déploiement sur des tickets historiques avant qu'une IA réponde à un vrai client, et pourquoi des actions comme les remboursements sont derrière des règles d'approbation. Notre guide sur les hallucinations de l'IA en support approfondit les garde-fous.
Mon verdict pour les équipes de support : Super VL est un modèle intéressant sur lequel construire si vous avez des ingénieurs, du matériel NVIDIA et une raison de garder les données en interne. Ce n'est pas quelque chose que vous branchez lundi sur la file de votre agent IA Zendesk. Si vous comparez plutôt des solutions toutes faites, mon comparatif des logiciels de helpdesk IA est un meilleur point de départ.
Qui devrait utiliser Nemotron 3.5 Super VL ?
Voici comment je déciderais :
- Vous exploitez des agents riches en documents. Factures, contrats, reçus, graphiques dans des rapports. C'est pour cela qu'il a été entraîné, et Ramp et Scale AI le font déjà.
- Vous avez besoin de poids ouverts sur votre propre matériel. Données réglementées, un DGX Spark sous le bureau, ou un contrat qui interdit les prestataires d'IA externes. La licence et la version NVFP4 pour une seule machine en font le gros modèle ouvert le plus facile à justifier.
- Vous prévoyez de post-entraîner. Données ouvertes, recettes ouvertes et prise en charge de NeMo dès le premier jour. Les meilleurs chiffres de NVIDIA viennent tous après fine-tuning.
- Vous voulez le modèle ouvert le plus intelligent. Regardez d'abord GLM-5.3-Flash ou Qwen3.8-Flash-Next, ou passez à des modèles fermés comme GPT-6 Luna et Gemini 3.8 Flash.
- Votre agent lit des entrées non fiables avec des outils branchés. Attendez davantage de tests d'injection avec le raisonnement activé, et mettez-le dans un bac à sable dans tous les cas.
Pour ceux qui comparent, DeepSeek V4 Flash est l'alternative la moins chère centrée sur le texte, et son expérience de vision est le rival ouvert le plus proche sur les images.
Essayer eesel
Nemotron 3.5 Super VL est une infrastructure : des poids, une licence et une facture de GPU. Il vous resterait à construire vous-même la recherche d'information, les règles d'escalade, les tests et la piste d'audit. eesel est l'employé. Notre coéquipier de helpdesk IA se branche sur Zendesk, Freshdesk, Gorgias et le reste, apprend de vos anciens tickets et de votre centre d'aide, et vous pouvez le lancer sur des centaines de vos tickets historiques avant qu'il réponde à un seul client. C'est dans ce rejeu que vous repérez la réponse victime d'une injection de prompt ou la réponse trop assurée avant un client, quel que soit le modèle en dessous.
Si vous préférez le piloter depuis un terminal, comme vous piloteriez un modèle auto-hébergé, la CLI eesel s'en charge. eesel instructions lit et modifie les règles permanentes du coéquipier, eesel approvals liste les actions en attente d'un humain, et eesel activity montre chaque exécution et pourquoi il a agi ainsi. Chaque commande affiche du JSON et les écritures acceptent --dry-run, si bien qu'un agent de code comme Claude Code peut gérer votre coéquipier de support comme il gère votre dépôt. Si vous écrivez du contenu plutôt que de répondre à des tickets, la même équipe compte un rédacteur de blog IA.

Le démarrage est gratuit avec 100 crédits et sans carte. Essayez eesel sur les tickets du mois dernier et voyez ce qu'il aurait répondu, avant de chiffrer un seul DGX Spark. Les offres sont sur la page des tarifs.
Comment Nemotron 3.5 Super VL se compare-t-il à Qwen3.8-Flash-Next et GLM-5.3-Flash ?