

Nemotron 3.5 Transcribe est le modèle vocal gratuit à poids ouverts de NVIDIA, publié le 28 octobre 2026, et un seul checkpoint fait quatre métiers : des transcriptions en 40 langues, des étiquettes « qui a dit quoi » pour jusqu'à huit locuteurs, de la traduction en 31 langues et des réponses sur l'audio. Vous lui indiquez le métier voulu avec un simple prompt en langage courant.
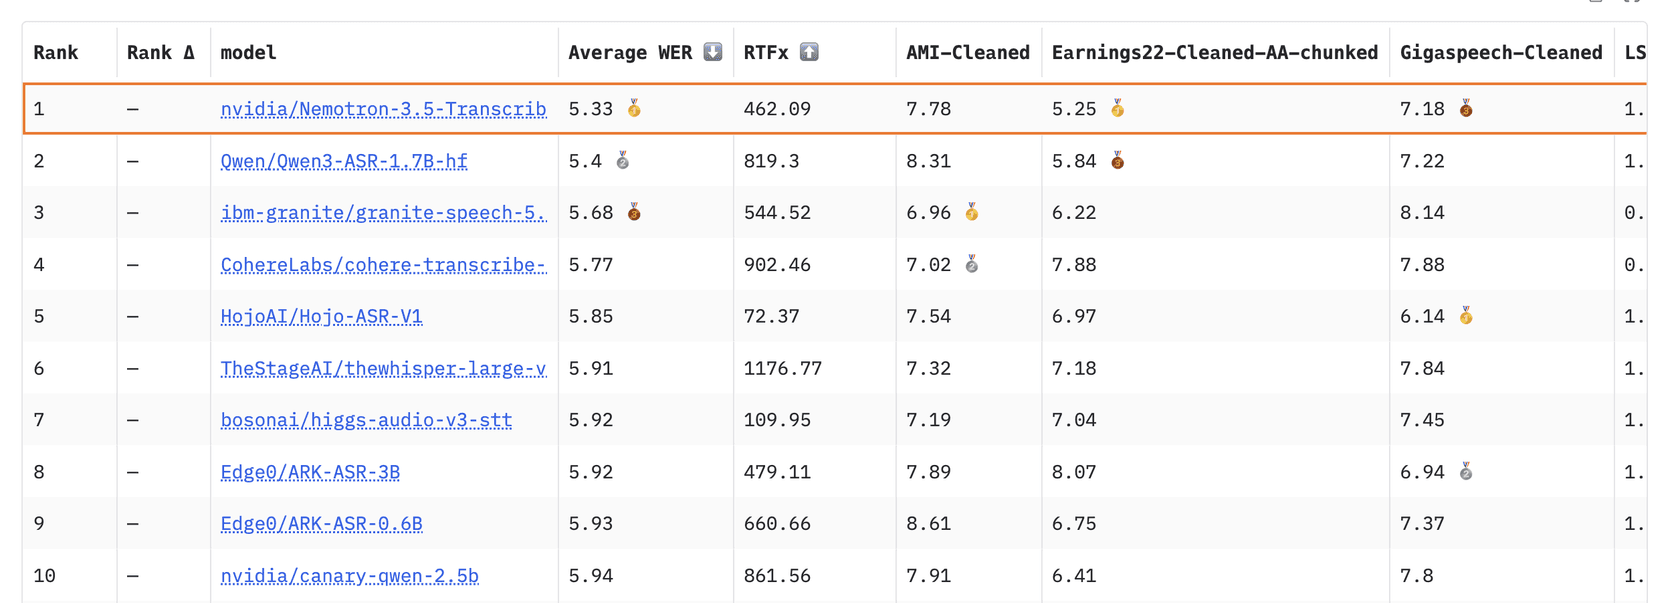
Il est précis pour un modèle ouvert : 2,81 % de taux d'erreur sur les mots sur Artificial Analysis, deuxième parmi les modèles ouverts, et premier sur le classement ouvert anglais de Hugging Face avec 5,33 %. Le hic, ce sont la taille et le moment. Il faut aujourd'hui un GPU de centre de données de 80 Go, et il ne fonctionne que sur des enregistrements, pas sur des appels en direct. Si vous ne voulez pas du matériel, DeepInfra l'héberge à 0,002 $ la minute, environ la moitié de ce que facturent la plupart des API de transcription.
Pour une équipe support, une transcription est la première étape, pas la dernière. Je travaille chez eesel, et le coéquipier IA du helpdesk que je contribue à construire est celui qui reprend le ticket issu d'un appel ou d'un message vocal et y répond dans la langue du client, comme il le fait pour Koffer.ch en allemand, français, anglais et italien.
Qu'est-ce que Nemotron 3.5 Transcribe ?
Nemotron 3.5 Transcribe est un modèle vocal à poids ouverts de NVIDIA. Il prend un fichier enregistré et le transforme en texte, puis en n'importe quel type de texte que vous demandez. NVIDIA l'appelle un modèle de langage augmenté par la voix : un encodeur audio alimente un modèle de langage, ce qui vous permet de piloter la sortie avec des instructions plutôt que des réglages (fiche du modèle).
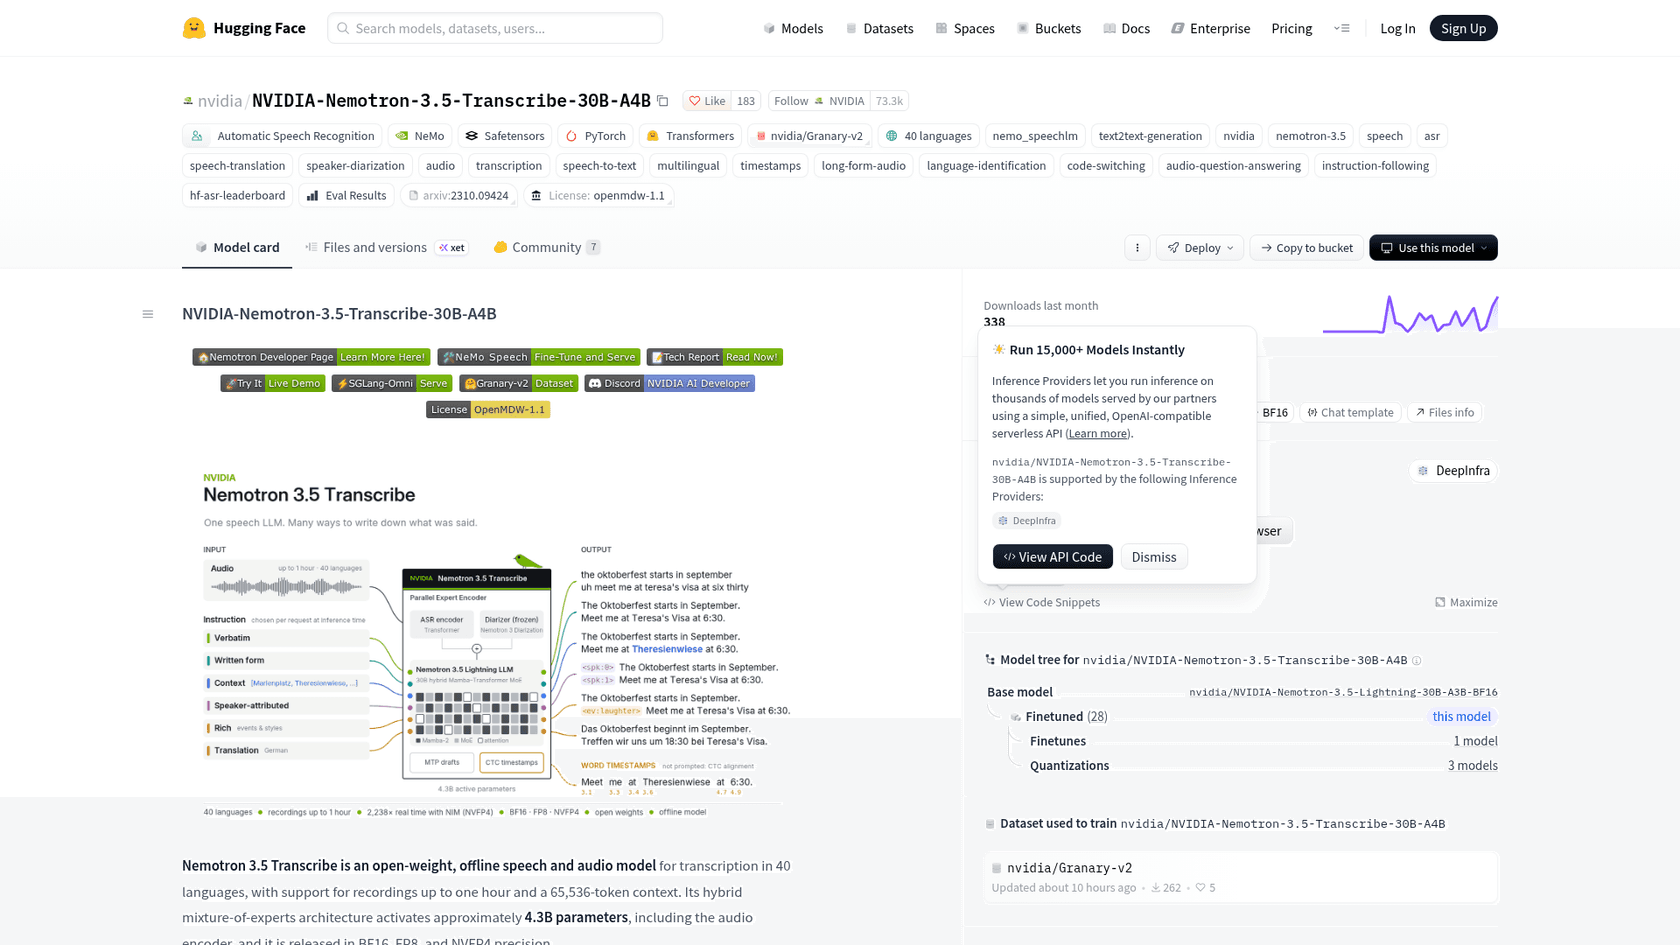
Les chiffres clés, tous tirés du blog de lancement de NVIDIA et de la fiche du modèle :
| Caractéristique | Nemotron 3.5 Transcribe |
|---|---|
| Publication | 28 octobre 2026 |
| Taille | Mélange d'experts de classe 30B, environ 4B actifs par token (la fiche compte 34B au total, 4,3B actifs, avec l'encodeur audio) |
| Transcription | 40 langues |
| Traduction | 31 langues, vers ou depuis l'anglais |
| Étiquettes de locuteur | 13 langues, jusqu'à 8 locuteurs |
| Enregistrement le plus long | 1 heure (contexte de 65 536 tokens) |
| Streaming en direct | Non, audio enregistré uniquement |
| Licence | OpenMDW-1.1, usage commercial autorisé |
| Précisions | BF16 pour l'instant ; FP8 et NVFP4 annoncés |
Le « environ 4B actifs » est en fait la raison pour laquelle un modèle de cette taille est utilisable. C'est un mélange d'experts hybride Mamba-Transformer, bâti sur le modèle de langage Nemotron 3.5 Lightning de NVIDIA, donc seule une petite partie des poids travaille à chaque token. C'est la même astuce que le reste de la famille, comme Nemotron 3.5 Super VL.
Il y a un piège de nom à signaler. « Nemotron 3.5 ASR » est un autre modèle de streaming, minuscule, donc quand vous voyez un prix ou une vitesse en ligne, vérifiez de quel modèle il s'agit.
Que peut-on lui demander ?
Vous pouvez demander une transcription mot à mot, une version nettoyée, une avec étiquettes de locuteur, une traduction ou une réponse, le tout à partir du même fichier. Seule une ligne de prompt change d'un cas à l'autre. Les exemples de NVIDIA sont aussi simples que « Transcribe this recording and label each speaker » ou « What decisions were made in this meeting? » (blog de lancement).
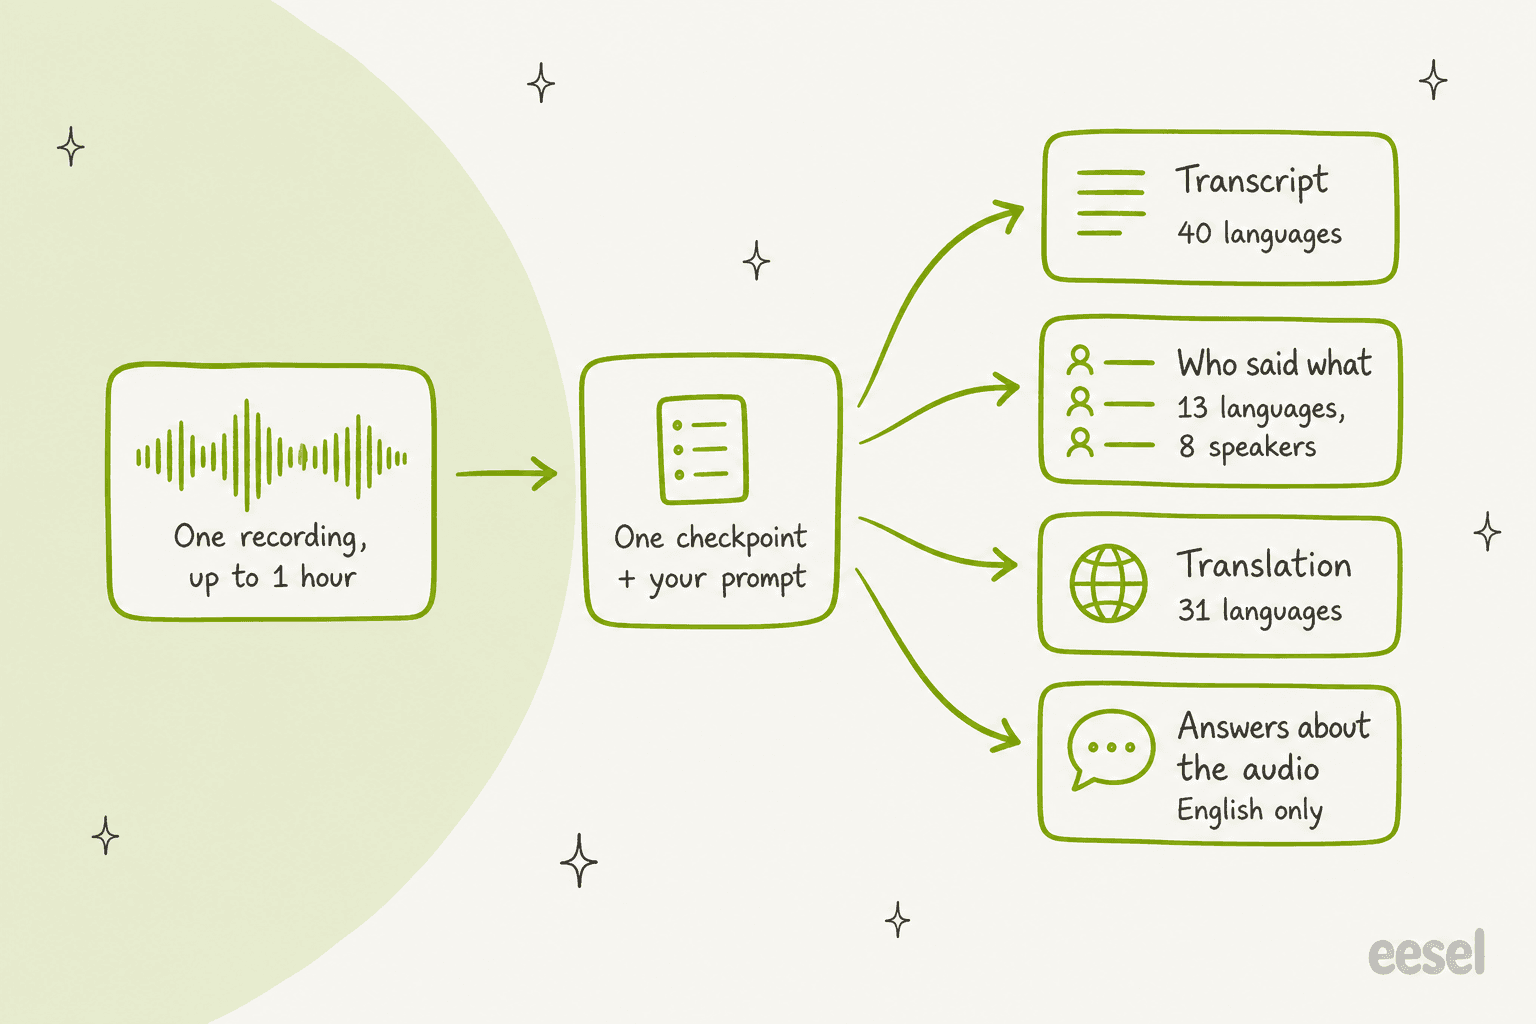
Les prompts qui comptent le plus en situation réelle, d'après la fiche du modèle :
- Mot à mot ou propre. Garder chaque « euh » et chaque répétition, ou les supprimer en laissant le reste intact.
- Termes de contexte. Listez d'avance les noms de produits, de personnes ou le jargon. Sur le test contextuel d'appels de résultats de NVIDIA, le rappel des mots-clés est passé de 58,16 % à 96,05 % une fois les termes fournis.
- Locuteurs et horodatages. Demandez les étiquettes de locuteur et les temps de mots en une seule passe, au lieu de lancer ensuite un outil de diarisation séparé.
- Valeurs exactes. Un préréglage garde les e-mails, URL, chemins de fichiers et numéros de commande écrits comme ils ont été dits, ce qu'une transcription de support ne peut pas se permettre de rater.
- Marquage des données personnelles. Le modèle a été entraîné à marquer ou masquer les informations personnelles, utile si vous masquez les transcriptions de support avant que quelqu'un ne les lise.
La fiche cite même les « support recordings » comme cas adapté au prompt de termes de contexte et liste le service client comme domaine d'application. Les centres d'appels sont donc clairement dans l'esprit de NVIDIA avec ce modèle.
Quelle est vraiment sa qualité ?
Sur les tests publics, c'est le meilleur ou le deuxième meilleur modèle vocal ouvert, et il reste un cran derrière les meilleurs modèles fermés. Voici ce que disent les chiffres, et aussi où ils ne s'accordent pas entre eux.
Classement Open ASR de Hugging Face (anglais). Premier parmi les modèles à poids ouverts avec un taux d'erreur moyen sur les mots de 5,33 %, juste devant Qwen3-ASR-1.7B à 5,4 % (classement). Le taux d'erreur sur les mots est la part de mots qu'un modèle rate, donc plus il est bas, mieux c'est.
Artificial Analysis. 2,81 % sur son indice d'erreur, deuxième parmi les modèles ouverts, de justesse derrière Voxtral Small à 2,77 %, qui utilise environ six fois plus de paramètres actifs (Artificial Analysis). Le blog de NVIDIA parle d'une égalité pour la première place. Les modèles fermés mènent toujours dans l'ensemble : MAI-Transcribe-2 est à 2,04 % et Gemini 3.5 Transcribe à 2,60 %. Sur le jeu pour agents vocaux, AgentTalk, il obtient 1,78 %, près du sommet de tout le tableau.
Je mettrais pourtant deux astérisques sur ce chiffre. Le point d'accès public de DeepInfra mesure 3,4 % sur le même indice, donc les 2,81 % viennent d'une configuration que la plupart ne peuvent pas encore atteindre. Et sur les appels de résultats, il obtient 5,69 %, derrière ElevenLabs Scribe v2 à 3,95 %.
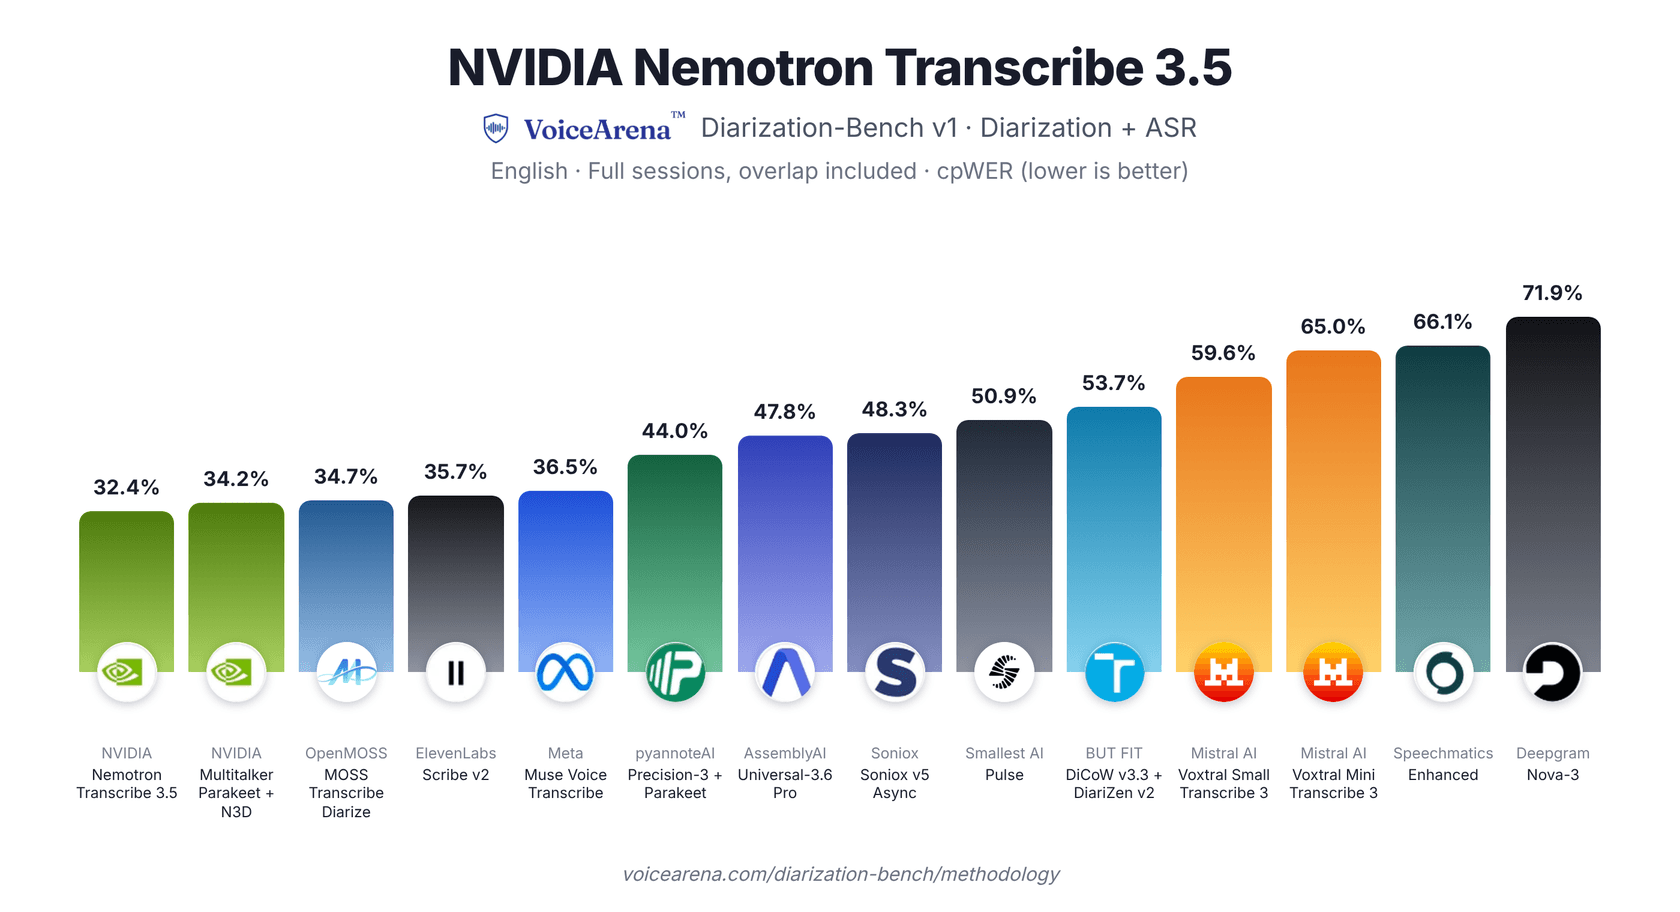
Qui a dit quoi. C'est là qu'il est le plus fort. Sur le benchmark de diarisation de VoiceArena, avec des sessions complètes en anglais et des paroles qui se chevauchent, il est arrivé premier sur 14 systèmes avec 32,4 % d'erreur après appariement des locuteurs, et a omis bien moins de mots que les autres : 8,32 % contre une médiane d'environ 31 % (blog de lancement).
Les langues ne se valent pas. NVIDIA classe 13 langues comme « leading », dont l'anglais, l'espagnol, l'allemand, le français, l'hindi et le coréen, et 15 autres comme prêtes pour la production. Certaines sont très en retrait : l'erreur sur FLEURS est de 26,93 % pour le grec et de 20,97 % pour l'hébreu, et le norvégien, à 63,76 %, n'a aucune prise en charge de la transcription (fiche du modèle). Si vos clients appellent en norvégien, ce modèle n'est donc pas encore pour vous.
Que disent les gens après le premier jour ?
Les premières réactions sont enthousiastes sur la liste de fonctions, mais mitigées dès que les gens l'essaient. Le fil de r/LocalLLaMA a dépassé 193 votes en un jour, et son commentaire le plus voté a donné le ton :
"Holy! This might be the holy grail of OS ASR models I have been looking for - something to dethrone venerable Qwen ASR."

Le seul vrai test à ce jour, sur Hacker News, vient de quelqu'un qui a fait tourner une quantification communautaire en 4 bits sur de l'audio japonais, en précisant que ce n'était peut-être pas la précision maximale :
"testing it against parakeet right now for ASR, it's slower, heavier, and has a higher error rate. but i'm doing a pass with the embedded translation to see if that's any good, it might be worth it."

Son retour suivant sur la traduction n'a pas été plus tendre (« disappointing model »), donc considérez les victoires en benchmark comme les chiffres de NVIDIA jusqu'à l'arrivée de tests indépendants sur les poids en pleine précision. L'autre sujet qui revient est la taille. Comme l'a dit un commentateur Reddit, « 30b for ASR is such a luxury », alors que le Parakeet de 0,6B de NVIDIA tourne sur presque tout (Reddit).
Le cas d'usage que les gens semblaient préférer est bien connu des équipes support et ops : les réunions et appels brouillons où tout le monde parle en même temps.
"finally a model that can follow a standup where everyone unmutes at once"
Comment exécuter Nemotron 3.5 Transcribe ?
Il y a trois façons d'y accéder pour l'instant. Vous pouvez essayer une démo gratuite ou appeler une API hébergée, et si vous avez le matériel, l'exécuter sur votre propre GPU.
- Essayer la démo. Le Hugging Face Space de NVIDIA accepte un envoi et un prompt. C'est un bon moyen de tester votre propre audio avant de vous engager.
- Appeler une API hébergée. DeepInfra le propose à 0,002 $ la minute avec zéro rétention de données. Baseten et Simplismart l'hébergent aussi, mais vendent du temps GPU ou des devis sur mesure plutôt qu'un prix à la minute.
- L'héberger soi-même. La fiche du modèle donne une recette vLLM 0.32.0 sur un H100 80 Go, ainsi que des options Transformers et SGLang-Omni. Le serveur vLLM parle le format de chat d'OpenAI, donc le code écrit pour l'API audio d'OpenAI se porte avec de petites modifications.
La fiche contient aussi quelques pièges faciles à manquer :
- La version rapide n'est pas encore ouverte. L'annonce de NVIDIA de 100 heures d'audio en moins de trois minutes utilise les poids NVFP4 non publiés et son propre serveur optimisé. La configuration vLLM ouverte est « expected to be roughly two times slower ».
- SGLang-Omni ne fait que transcrire. Cette voie omet les horodatages, les étiquettes de locuteur et la traduction, qui sont la moitié de la raison de choisir ce modèle.
- Les GPU plus petits attendent. Le support de la RTX 5090 est en NVFP4 uniquement et celui de la L40S en FP8 uniquement, et aucun des deux dépôts n'était public le 29 octobre.
- Il peut boucler. NVIDIA fournit une regex de nettoyage pour le rare cas où la sortie ne s'arrête pas, et met en garde contre la parole hallucinée. Vérifiez par sondage les noms et les changements de locuteur.
Si l'exécution de modèles ouverts sur votre propre matériel est nouvelle pour vous, le guide Hugging Face couvre les bases du hub par lequel NVIDIA distribue le modèle.
Combien ça coûte ?
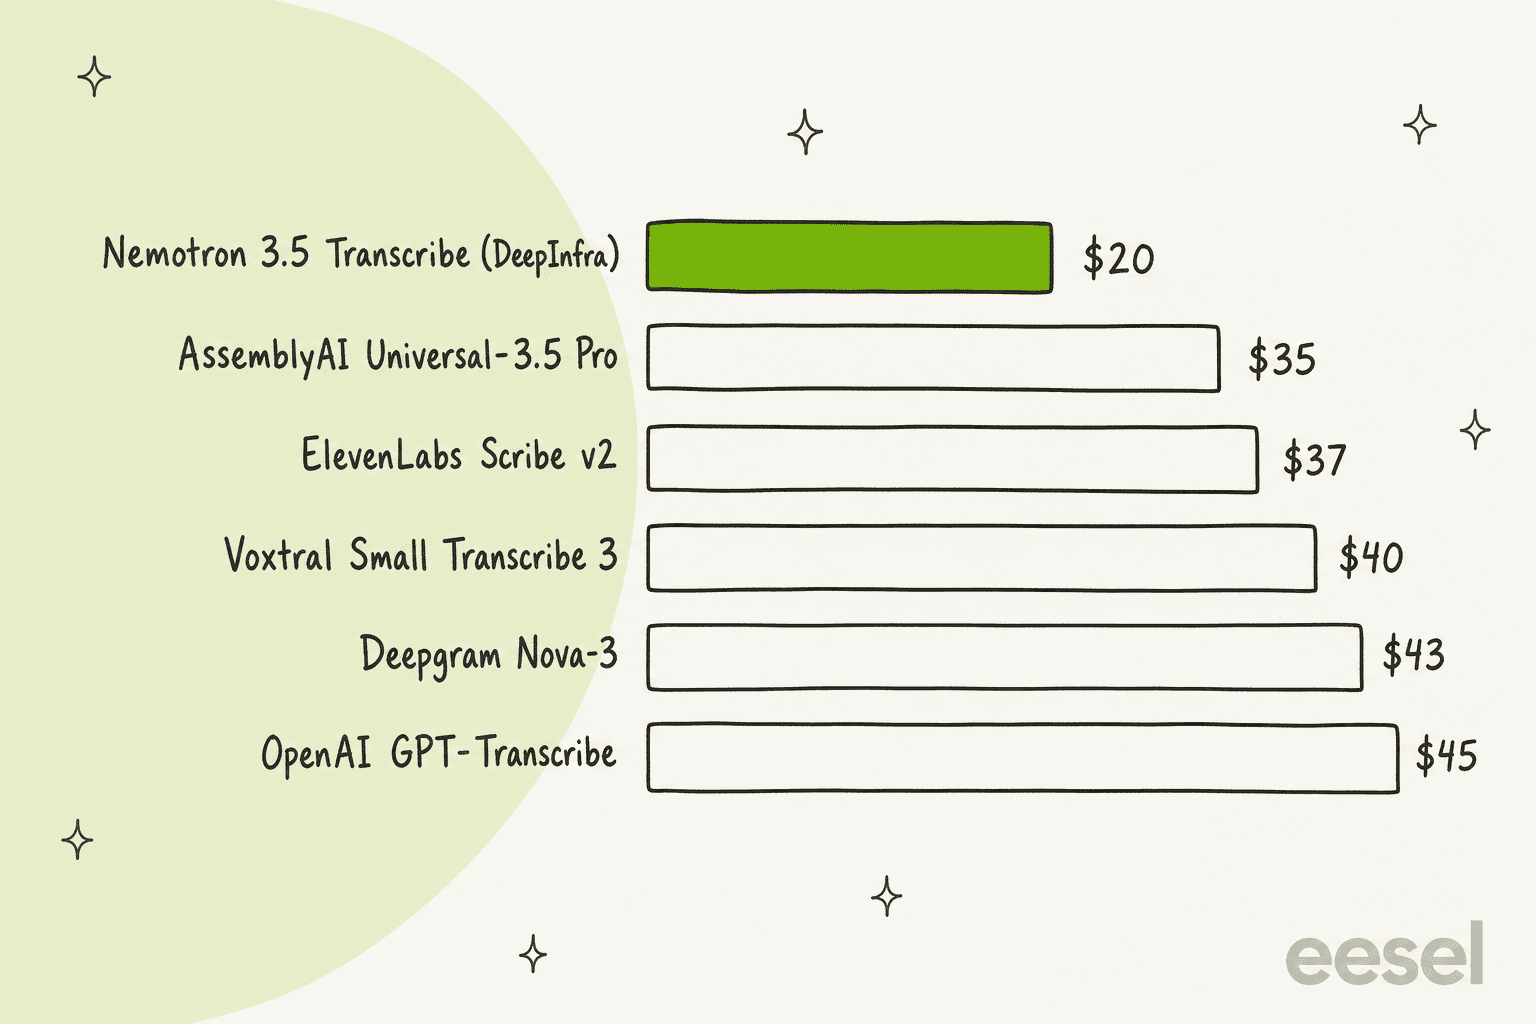
Les poids ne coûtent rien, donc le vrai prix est ce que vous payez pour le GPU ou l'API. Aux tarifs hébergés, c'est l'option précise la moins chère que j'ai trouvée. Voici 10 000 minutes d'appels enregistrés par mois, environ 167 heures, chiffrées d'après la page de chaque fournisseur :
| Modèle | Prix par lot | 10 000 minutes | Source |
|---|---|---|---|
| Nemotron 3.5 Transcribe (DeepInfra) | 0,002 $/min | 20 $ | DeepInfra |
| AssemblyAI Universal-3.5 Pro | 0,21 $/h | 35 $ | AssemblyAI |
| ElevenLabs Scribe v2 | 0,22 $/h | environ 37 $ | ElevenLabs |
| Mistral Voxtral Small Transcribe 3 | 0,004 $/min | 40 $ | Mistral |
| Deepgram Nova-3, préenregistré | 0,0043 $/min | 43 $ | Deepgram |
| OpenAI GPT-Transcribe | 0,0045 $/min | 45 $ | OpenAI |
| Gemini 3.5 Transcribe | environ 0,005 $/min | environ 50 $ |
L'écart se creuse quand on compare à fonctions égales. Nemotron inclut le prompting, les termes de contexte et les étiquettes de locuteur dans l'appel de base. Chez AssemblyAI, ajouter le prompting (0,05 $/h) et la diarisation (0,02 $/h) à Universal-3.5 Pro le porte à 0,28 $ l'heure, plus du double des 0,12 $ de Nemotron. Pour un examen plus poussé des concurrents, voir les analyses de Gemini 3.5 Transcribe et de Voxtral 3.
L'auto-hébergement n'est moins cher par heure d'audio que si le GPU reste occupé. Baseten loue un H100 à 0,10833 $ la minute (Baseten), soit environ 6,50 $ l'heure. NVIDIA mesure de 260 à 410 fois le temps réel sur cette carte pour de l'anglais par lots, donc une heure de GPU couvre de 260 à 410 heures d'audio. D'après mes calculs, cela donne environ 2 à 3 centimes par heure d'audio, contre 12 centimes chez DeepInfra, mais seulement avec un flux de lots régulier. Une équipe avec 167 heures par mois paierait un GPU surtout inactif, donc l'API gagne tant que le volume n'est pas sérieux.
Où s'intègre-t-il pour une équipe support ?
Il s'intègre partout où vous avez déjà des enregistrements et voulez du texte que vous pouvez chercher, noter ou exploiter. Les conversations en direct sont là où il ne convient pas.
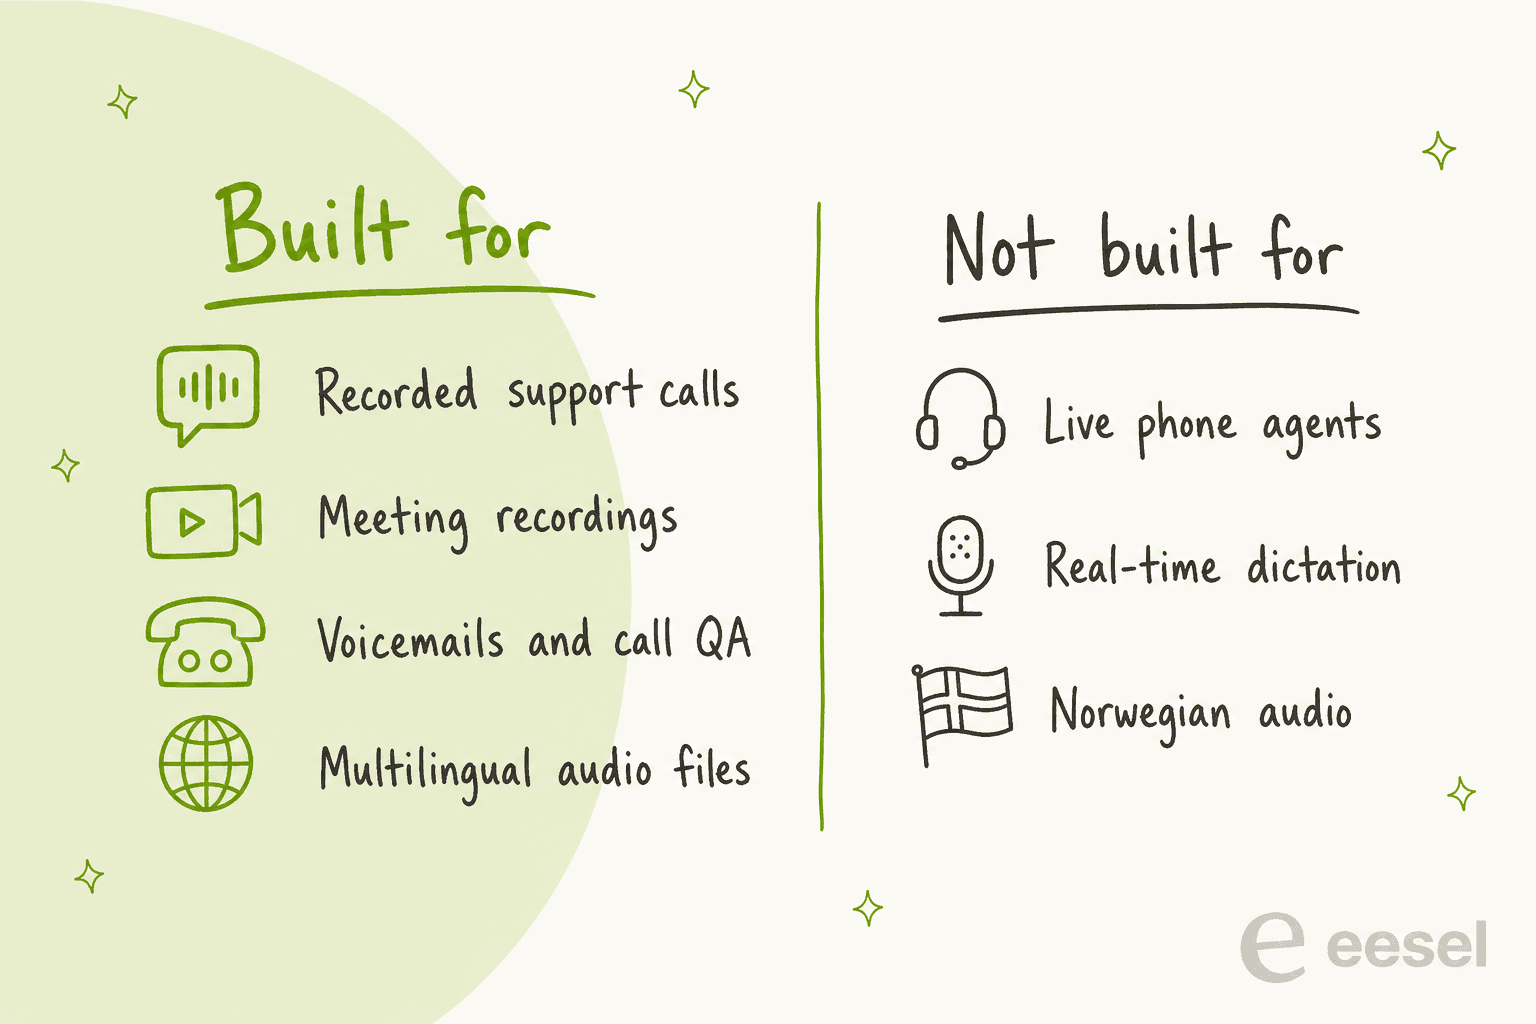
- Contrôle qualité des appels. Les transcriptions avec étiquettes de locuteur facilitent la notation de la façon dont les agents traitent les appels, la partie ingrate du contrôle qualité en centre d'appels. Associez-le au QA de support par IA pour évaluer le texte.
- Messages vocaux et rappels. Transcrivez, puis laissez le ticket porter le texte, pour que la personne qui le prend n'ait pas à écouter d'abord.
- Résumés et sentiment. La transcription alimente le résumé de tickets et l'analyse de sentiment, comme les transcriptions de chat.
- Files multilingues. Un modèle couvrant 40 langues vaut mieux qu'un outil distinct par marché, ce qui est la moitié du combat du support client multilingue.
Ce qu'il ne fera pas, c'est parler à l'appelant. Pour cela, il faut un modèle de streaming dans un agent vocal IA, ou l'un des outils de ma liste des meilleurs agents vocaux IA. Il ne décidera pas non plus quoi répondre. Une transcription parfaite d'une demande de remboursement a encore besoin de quelqu'un, ou de quelque chose, qui connaisse votre politique de remboursement.
Cette seconde partie est celle où je passe le plus clair de mes journées. Dans les années où eesel fait tourner de l'IA sur de vraies files de support, le plus dur n'a jamais été de transformer des mots en texte. C'était de répondre correctement à partir des politiques propres à l'entreprise et de savoir quand passer la main, et c'est la raison pour laquelle chaque déploiement est testé sur les anciens tickets d'une équipe avant de répondre à qui que ce soit.
Pourquoi Nemotron 3.5 Transcribe compte
Il compte parce qu'il rend « envoyer l'audio au cloud de quelqu'un d'autre » optionnel. Jusqu'ici, les modèles vocaux précis avec étiquettes de locuteur et traduction intégrées étaient des API fermées, et les ouverts étaient de petits modèles à usage unique qu'il fallait enchaîner. Nemotron 3.5 Transcribe met tout cela dans un seul checkpoint ouvert que vous pouvez exécuter dans votre propre centre de données, avec une licence commerciale et les données d'entraînement Granary v2 de NVIDIA (463 062 heures dans 48 langues) publiées avec lui.
L'autre changement est que l'adapter est désormais peu coûteux. L'étude de cas médicale de NVIDIA l'a affiné sur de la parole clinique à accent indien et a réduit les erreurs de 30,8 % d'origine à 11,8 %, en environ 14 heures de GPU sur un seul GB300 (étude de cas).
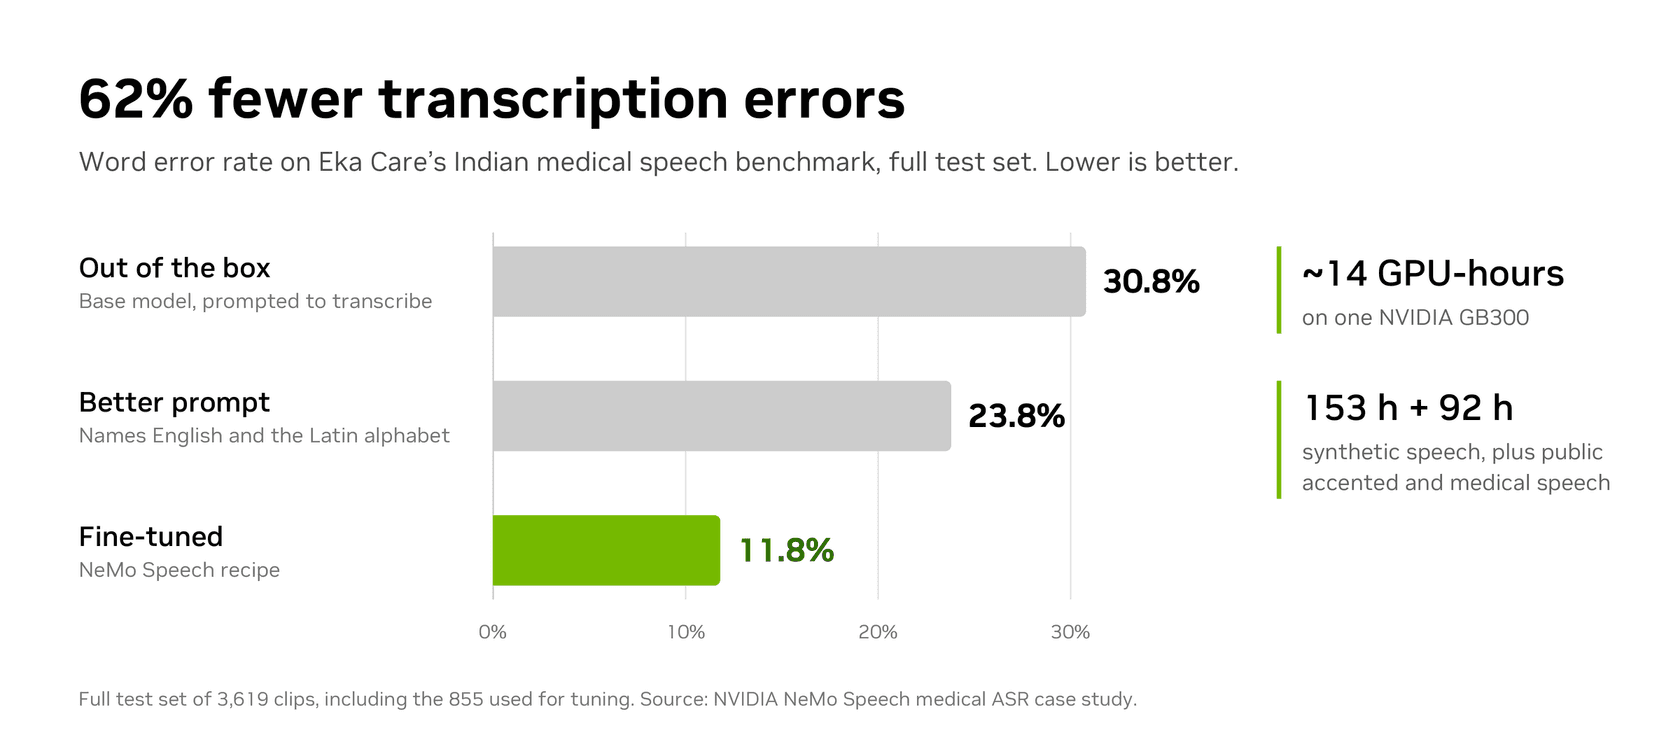
La barre du milieu est celle qui compte. Un meilleur prompt seul l'a fait passer de 30,8 % à 23,8 % avant tout entraînement. Mon avis : essayez le prompt avant d'essayer l'affinage. Indiquer au modèle la langue et l'alphabet, ainsi que les noms de vos produits, ne coûte rien et, pour la plupart des équipes support, c'est l'essentiel du gain.
Si vous le comparez à d'autres modèles ouverts pour une pile plus large, la plateforme ouverte de sécurité des agents de NVIDIA et ma liste des agents IA open source couvrent les éléments autour.
Essayer eesel
Nemotron 3.5 Transcribe est de l'infrastructure : d'excellentes oreilles, mais pas de fiche de poste. Il transforme un appel en texte. Ce qui vient ensuite, lire le ticket, vérifier la commande, répondre dans la langue du client, escalader le client en colère, c'est un métier, et c'est ce que fait le coéquipier IA du helpdesk d'eesel. Il s'intègre à Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, et vous pouvez le tester sur des centaines de ces tickets avant qu'il ne réponde à quiconque.

C'est sur la langue que cela rapporte le plus. Chez smava, il a traité 27 000 tickets Zendesk en un mois, en étiquetant la langue et la catégorie de chacun et en rédigeant des réponses en allemand. Chez Koffer.ch, il rédige des réponses Freshdesk dans celle des quatre langues dans laquelle le client a écrit, avec l'orthographe suisse pour l'allemand.
Si vous aimez piloter les modèles depuis un terminal, la CLI eesel fait fonctionner le même coéquipier : lire et modifier ses instructions, approuver les actions en attente d'un humain et consulter le journal d'activité de chaque exécution, avec sortie JSON et simulations sur les écritures. Un agent de code comme Claude Code peut gérer votre coéquipier support à côté de votre pipeline de transcription. Essayez eesel gratuitement, ou réservez une démo pour le voir sur vos propres tickets.
Comment Nemotron 3.5 Transcribe se compare-t-il à Whisper ?