

En bref
Cactus Whistle est un modèle de reconnaissance vocale gratuit et ouvert qui tient dans un seul fichier de 16,9 Mo et tourne sur un simple processeur. Sur un extrait de 10 secondes, il atteint le premier mot en 11,1 ms, et sur de la parole lue et propre, il devance légèrement Whisper base, un modèle 8,6 fois plus gros.
Le revers figure dans le graphique de Cactus lui-même : Whisper base reste devant sur les réunions, les conférences TED et la moyenne multilingue MLS, et un testeur de Hacker News a mesuré une précision en parole libre de seulement 70 commandes sur 170. Le même testeur est passé à 164 sur 170 en limitant Whistle à une liste fixe de commandes. C'est la vraie leçon : Whistle est une interface d'entrée pour commandes vocales, pas un remplaçant de Wispr Flow.
Si vous êtes dans une équipe support et que la voix vous tente, la transcription est désormais la partie bon marché. Le vrai travail, c'est de répondre à ce que le client a dit, et c'est là qu'intervient un coéquipier IA de helpdesk comme eesel.
Qu'est-ce que Cactus Whistle ?
Whistle est un modèle de reconnaissance vocale de Cactus Compute, une startup de San Francisco issue de la promotion été 2025 de Y Combinator, avec une équipe de 8 personnes. Cactus est dirigée par le CEO Roman Shemet et le CTO Henry Ndubuaku, et toute sa proposition tient en une phrase : de l'IA pour les appareils sans GPU, comme les téléphones d'entrée de gamme, les montres, les lunettes, les robots, les voitures et les cartes de type microcontrôleur.
Whistle est le volet vocal de ce pari, et un bon exemple des progrès accomplis par les petits modèles de langage. Il est sorti le 2 octobre 2026, et le fil de lancement sur Hacker News a atteint 549 points et 121 commentaires le 8 octobre, ce qui explique pourquoi on en parle partout. La fiche du modèle sur Hugging Face affiche 2 594 téléchargements le premier mois et une licence Apache 2.0.
Je développe des intégrations et des API pour eesel, donc une annonce de modèle me fait me poser d'abord une seule question : que récupère concrètement le développeur après un appel ? Avec Whistle, la réponse est d'une netteté rafraîchissante, alors commençons par là.
Que fait vraiment Whistle ?
Cactus liste trois fonctions, toutes exécutées sur l'appareil :
- Transcription. Audio mono 16 kHz, jusqu'à 30 secondes en une passe, en anglais, allemand, français, espagnol, italien, néerlandais et polonais. La langue est détectée sauf si vous l'indiquez.
- Horodatage des mots. Chaque mot avec son début, sa fin et sa probabilité, pour qu'une application puisse surligner, se déplacer ou couper sur un mot.
- Embedding vocal. La sortie brute de l'encodeur, une ligne pour 80 ms d'audio, pour de la mise en correspondance et de la recherche sans produire de transcription du tout.
Deux fonctions plus modestes comptent plus qu'il n'y paraît. Le biais par mots-clés permet de passer les noms que vos utilisateurs prononcent vraiment (« Siobhan », « Krzysztof », les noms de vos produits) et oriente la recherche vers eux. Et le silence renvoie une transcription vide au lieu d'une phrase inventée, une pique directe à une habitude connue des modèles de type Whisper.
Cette affirmation a été testée en public. Un utilisateur de Hacker News a passé Whistle sur un épisode de série télé et rapporte ceci :
« J'ai essayé sur un épisode de série au hasard et il semble parfois se bloquer en sortant "Thank you." par défaut, à un moment pendant 60 s de dialogue »

Le silence est donc géré, mais un audio long et brouillon qui ne tient pas dans la fenêtre de 30 secondes de Whistle peut encore produire du remplissage. Gardez-le en tête pour les benchmarks.
Comment Whistle fonctionne-t-il en interne ?
En bref : Whistle est un étage d'entrée audio greffé sur le modèle de texte existant de Cactus, Needle, avec lequel il partage presque tout. Needle est le minuscule modèle d'appel d'outils qui a fait la réputation de Cactus (son lancement de mai sur Hacker News s'intitulait « We Distilled Gemini Tool Calling into a 26M Model »). Needle 3 pèse désormais de 8 à 29 Mo selon la profondeur.
D'après l'article de lancement, le pipeline se déroule ainsi :
- L'audio devient 80 bins log-mel avec un pas de 10 ms, soit 3 000 trames pour 30 secondes.
- Un étage convolutif réduit cela à 375 trames, une toutes les 80 ms.
- Un encodeur de 8 blocs lit toutes les trames à la fois (il n'est pas causal : un mot à 12 secondes peut donc éclairer un mot à 3 secondes).
- Un décodeur de forme Needle lit l'encodeur via une attention croisée à portes à chaque couche, et 5 faisceaux (beams) choisissent la transcription.
L'astuce d'ingénierie que je préfère : les clés et valeurs de l'encodeur sont calculées une seule fois par extrait et partagées par tous les faisceaux, donc cinq faisceaux coûtent cinq petits caches de texte, pas cinq passes sur l'audio. Le décodeur est aussi « en échelle » : chaque profondeur à partir de 2 couches a été entraînée comme un modèle à part entière, et vous en choisissez une au chargement avec --audio-depth.
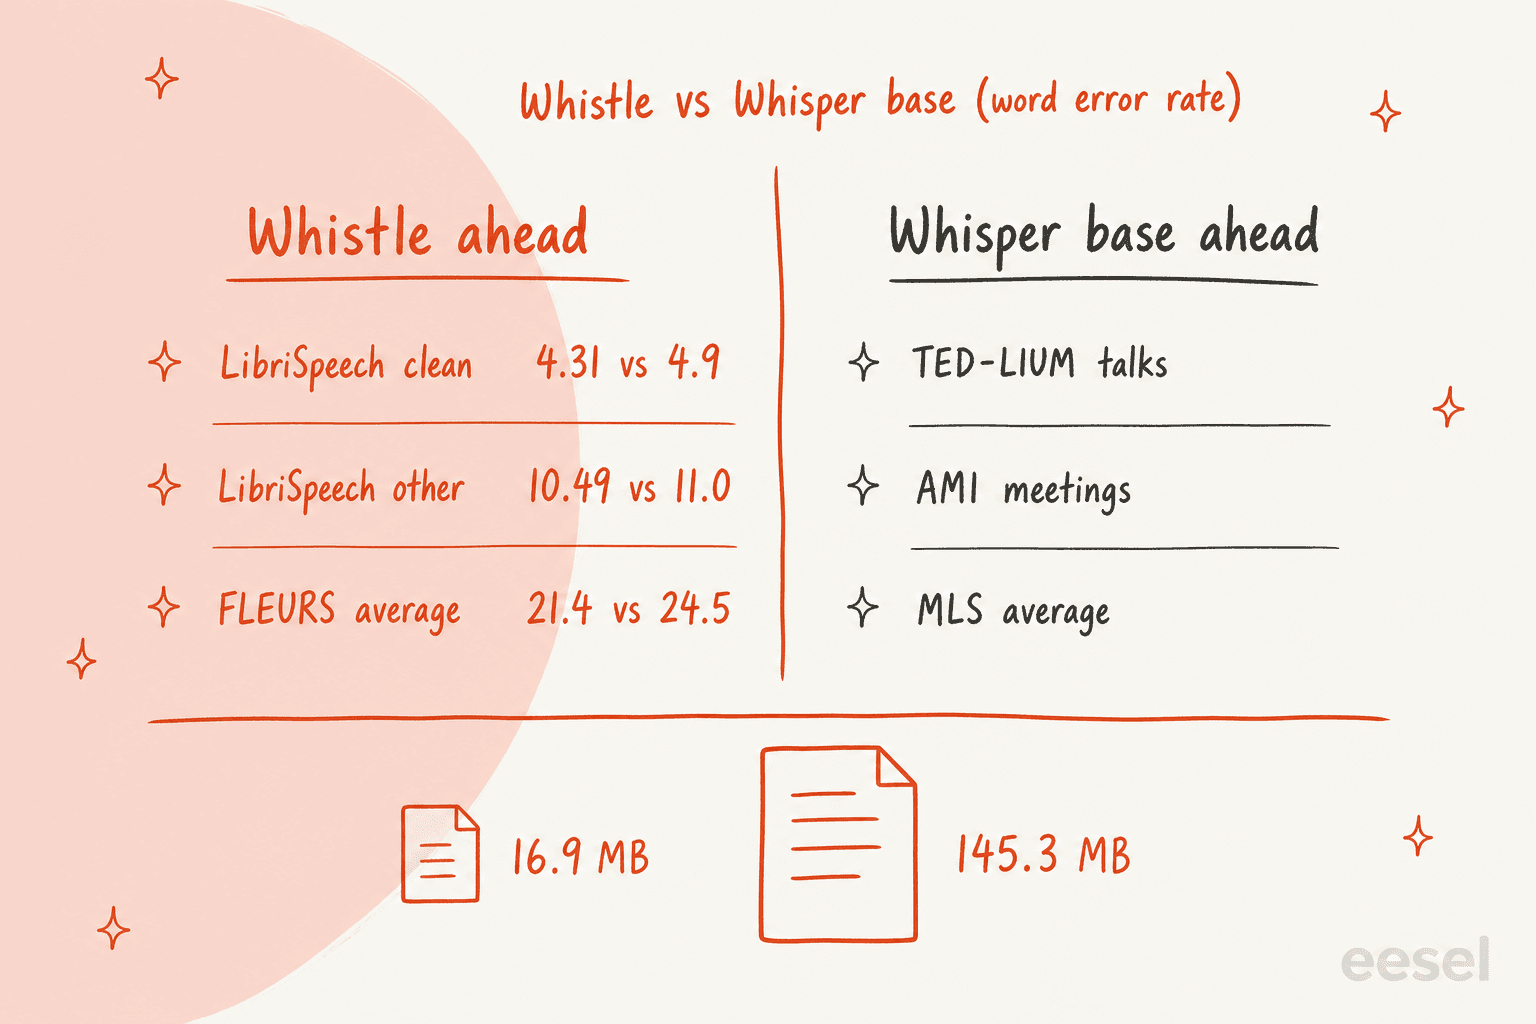
Ce moteur partagé est le vrai produit. Chargez les deux modèles dans le même binaire et un seul appel prend de l'audio en entrée et renvoie un appel de fonction en sortie. Voici l'exemple exact de l'article de Cactus :
needle --model needle3.cact --model whistle.cact --tools tools.json --audio clip.wav
{"function_calls":[{"name":"set_lights","arguments":{"room":"kitchen","on":false}}],
 "confidence":0.94,
 "audio_text":"turn off the kitchen lights",
 "audio_language":"en"}
Aucune transcription ne passe jamais par le code de votre application. Si vous avez déjà branché des appels d'outils en temps réel sur une API cloud, vous remarquerez ce qui manque ici : l'aller-retour réseau, la clé d'API et la facture.
Les benchmarks de Whistle face à Whisper base et Moonshine
Cactus compare Whistle à deux modèles : Whisper base d'OpenAI (le checkpoint multilingue, 145,3 Mo) et Moonshine tiny v2 (41,9 Mo). Le taux d'erreur sur les mots (WER) est la part de mots que le modèle se trompe à transcrire : plus il est bas, mieux c'est.
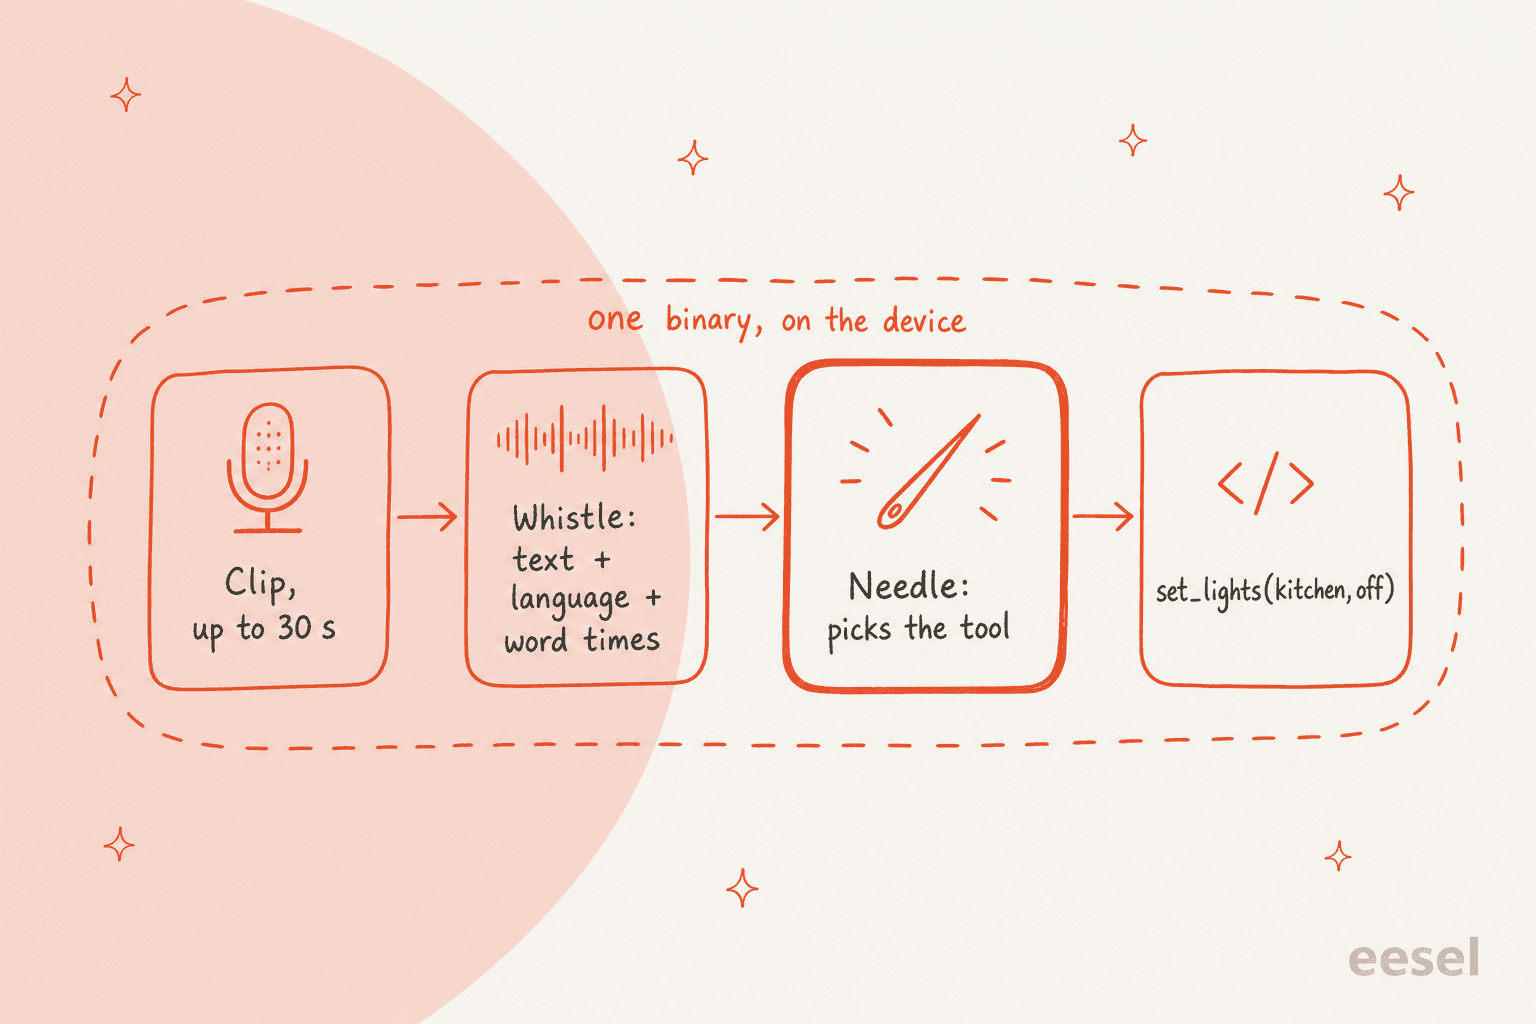
Voici le tableau complet des taux d'erreur, avec les chiffres de Whistle tirés de la fiche du modèle et ceux de Whisper base cités par Cactus dans son fil de lancement sur X :
| Benchmark | Type d'audio | WER Whistle | WER Whisper base | Qui est devant |
|---|---|---|---|---|
| LibriSpeech test-clean | Lecture de livre audio propre | 4,31 % | 4,9 % | Whistle |
| LibriSpeech test-other | Lecture de livre audio plus difficile | 10,49 % | 11,0 % | Whistle |
| SPGISpeech | Appels financiers | 7,65 % | Non publié | Whistle (face à Moonshine) |
| Earnings-22 | Appels de résultats, accents | 19,01 % | Non publié | Whistle (face à Moonshine) |
| FLEURS (moyenne sur 7 langues) | Phrases lues, nombreuses langues | 21,4 % | 24,5 % | Whistle |
| TED-LIUM | Conférences enregistrées | 7,61 % | Plus bas | Whisper base |
| AMI | Enregistrements de réunions | 26,07 % | Plus bas | Whisper base |
| MLS (moyenne sur 6 langues) | Livres audio, hors anglais | 24,9 % | Plus bas | Whisper base |
L'article de lancement énonce clairement ce partage, et je respecte le fait qu'il le fasse. Lisez le tableau par type d'audio et un schéma apparaît : Whistle est le plus fort sur la parole lue, propre, à un seul locuteur, et le plus faible sur les réunions, où les gens se coupent la parole. Un taux d'erreur de 26 % sur AMI signifie qu'environ un mot sur quatre est faux.
La vitesse et la taille, c'est une autre histoire, et c'est là que Whistle file loin devant. Dix secondes d'audio sur un processeur Apple M4 Pro :
| Whistle | Whisper base | Moonshine tiny v2 | |
|---|---|---|---|
| Taille du fichier | 16,9 Mo | 145,3 Mo | 41,9 Mo |
| Temps jusqu'au premier token | 11,1 ms | 73,2 ms | 22,8 ms |
| Vitesse de décodage | 1 319 tokens/s | 266 tokens/s | 262 tokens/s |
| Précision | 2 à 4 bits | fp32 | int8 |
Le titre de Cactus dit « 9x moins de taille de fichier et 6x plus rapide ». J'ai vérifié l'arithmétique : l'écart de taille est de 8,6x, l'écart de temps jusqu'au premier token de 6,6x, et le décodage environ 5x. Arrondi honnête. Le temps jusqu'au premier token de Whistle varie aussi avec la durée de l'extrait, de 5,9 ms à 5 secondes à 36,3 ms à 30, alors que Whisper complète tout jusqu'à 30 secondes, donc l'écart est le plus large sur les extraits courts pour lesquels Whistle est conçu.
Une comparaison que Cactus ne fait pas : celle avec les modèles ouverts plus gros que les gens font réellement tourner sur leurs portables. Sur Hacker News, les utilisateurs ont sans cesse posé la question de Parakeet de NVIDIA, et la réponse la plus utile a bien cadré le compromis :
« Il n'est peut-être pas aussi bon que Parakeet, mais il vous amène à 80 % du chemin. »
Que disent les gens après l'avoir essayé ?
Le fil Hacker News est le meilleur test en conditions réelles à ce jour, car Cactus a mis un bac à sable dans le navigateur sur la page de lancement et des centaines de personnes ont parlé dedans. Les réactions se répartissent exactement selon les lignes que prédisent les benchmarks.
Anglais clair, phrases courtes, termes techniques : les gens ont été impressionnés. Un développeur a trouvé qu'il battait la dictée de son propre téléphone sur le jargon :
« Ça fonctionne beaucoup mieux que la reconnaissance vocale d'iOS quand on utilise des termes techniques. »
La parole naturelle dans les six autres langues a reçu des avis plus durs. Un hispanophone de Madrid a écrit qu'il ne tenait la route qu'en dictant lentement :
« Si j'utilise un rythme plus naturel/conversationnel (sans argot, sans abréviations...), il confond facilement les mots. »
Un testeur polonais a dit à peu près la même chose, et un autre commentateur a souligné ce que la démo ne montre pas : la sortie en streaming pendant que vous parlez encore, sur laquelle reposent la plupart des applications de dictée en direct. Une équipe concurrente a aussi pris position sur Reddit, affirmant sur son propre benchmark que Whistle plus Needle atteignait 20,7 % de précision d'outil à partir de la parole brute. C'est le test d'un rival, à prendre avec prudence, mais il va dans le même sens que tout le reste ici.
Côté développeurs, l'un d'eux avait déjà branché Whistle dans un plugin de reconnaissance vocale pour DeepSeek Harness quelques jours après le lancement.
La vraie leçon : réduire le vocabulaire
Le commentaire le plus utile de tout le fil venait de quelqu'un qui avait déjà mis Whistle en production. Il l'a utilisé pour couper un Amazon Echo Show du cloud d'Amazon, en remplaçant l'assistant vocal d'origine par une domotique qui tourne en local, et il a partagé des chiffres.
En transcription libre, Whistle a réussi 70 commandes parlées sur 170, contre 168 pour le modèle vocal 1,7B de Qwen tournant sur un GPU RTX 5080. Puis il a cessé de demander à Whistle de transcrire tout ce qu'une personne pourrait dire, et a entraîné un minuscule réseau pour faire correspondre la sortie de Whistle à un ensemble fixe de modèles de commandes. Son résultat : 164 sur 170, avec une configuration conçue pour tourner sur le processeur de l'Echo lui-même.
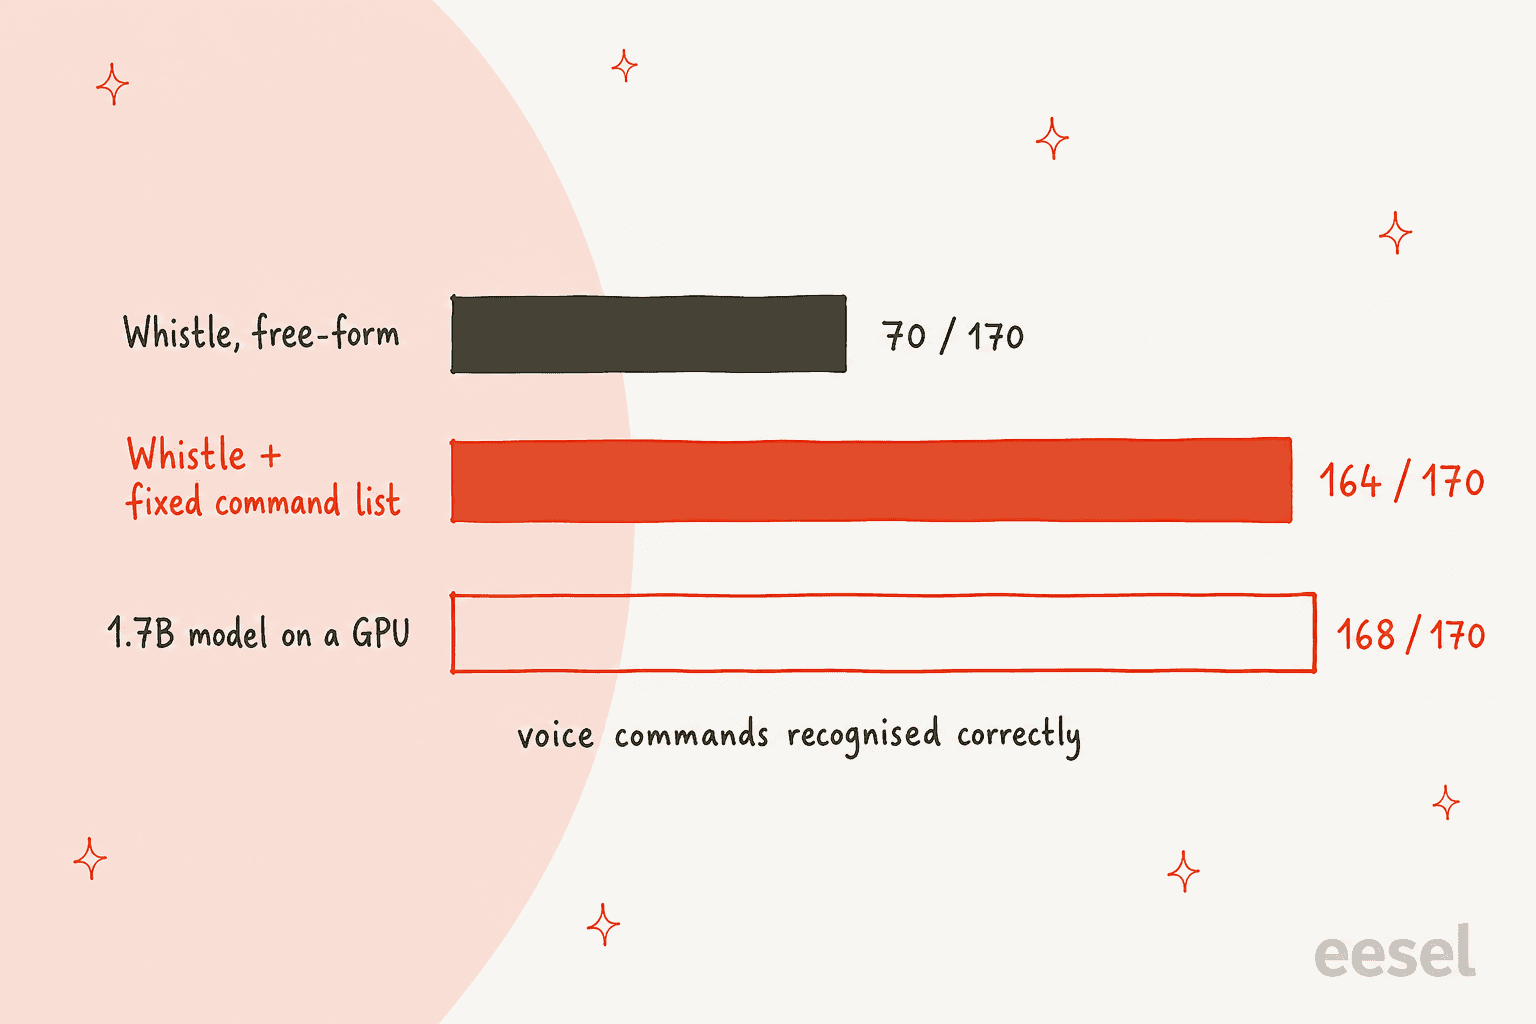
C'est le changement de perspective que je retiens. Un modèle de 16,9 Mo n'a pas la place de connaître tous les mots de sept langues, donc plus vous pouvez lui dire à quoi s'attendre, plus il se rapproche de modèles bien plus gros que lui. Cactus a construit des outils pour exactement cela : le biais par mots-clés pour les noms et termes de produits, et la liste d'outils de Needle, qui est elle-même un vocabulaire fixe d'actions. Le même testeur a ensuite passé 208 phrases et en a obtenu 206 justes, devant les configurations Vosk et Kaldi sur le même jeu.
Donc si vous jugez Whistle en lui parlant de votre week-end dans le bac à sable, vous testez la mauvaise chose. Jugez-le sur les 20 commandes que votre appareil doit réellement comprendre.
Faut-il livrer Whistle ?
Voici comment je déciderais, d'après les benchmarks et les retours du terrain ci-dessus. Choisissez le cas d'usage que vous avez en tête :
Que voulez-vous que Whistle fasse ?
Comment essayer Whistle en cinq minutes
Le chemin le plus rapide est le bac à sable dans le navigateur de l'article de lancement : la première pression télécharge le modèle de 16,9 Mo dans l'onglet et rien ne quitte votre machine. Pour un vrai test, le paquet Python tient en une ligne :
pip install cactus-needle
import needle

print(needle.transcribe("clip.wav")["text"])
Ensuite, d'après la fiche du modèle :
word_timestamps=Trueajoute le début, la fin et la probabilité de chaque mot.keywords=[...]oriente la recherche vers les noms que prononcent vos utilisateurs.language="de"force une langue au lieu de la détecter.needle whistle comparepasse le même extrait dans Whistle, Whisper et Moonshine avec les temps, ce qui est la commande la plus utile pour se décider.
Le moteur est livré précompilé pour dix-sept cibles, de macOS, Windows et Linux (y compris RISC-V et MIPS) à Android, iOS, watchOS, tvOS et le navigateur via WebAssembly. Chaque dossier de plateforme native contient un binaire needle, une bibliothèque statique et un en-tête. Le code source est sur GitHub. Si vous construisez une pile entièrement locale, il s'intègre à côté des agents IA open source que les gens font déjà tourner sur leur propre matériel.
Le coût est simple : les poids et le moteur sont sous licence Apache 2.0, et Hugging Face ne liste aucun fournisseur d'inférence hébergé pour Whistle, vous l'exécutez donc vous-même. Comparez cela à la tarification à la minute de Gemini 3.5 Transcribe ou de MAI-Transcribe 2, qui sont le bon choix quand la précision sur un audio long et brouillon compte plus que la taille.
Où Whistle cesse d'être le bon outil
Pour être juste envers Cactus, ils n'ont jamais prétendu que Whistle remplace Whisper large ou un service de transcription cloud. Voici tout de même les limites que je signalerais avant que quiconque construise dessus :
| Limite | Ce que cela signifie en pratique |
|---|---|
| Extrait limité à 30 secondes | Un audio plus long doit être découpé par votre application (un utilisateur HN a buté sur « audio limit is 30 s » d'emblée) |
| Pas de sortie en streaming | Le texte apparaît après la fin de l'extrait, pas pendant que quelqu'un parle |
| 7 langues | Ni japonais, ni norvégien, ni hindi, ni portugais, etc. |
| Audio de réunion | 26,07 % de WER sur AMI, derrière Whisper base |
| Étiquettes de locuteurs | La documentation ne mentionne pas la séparation des locuteurs (diarisation) |
Rien de tout cela n'est un bug. C'est le prix à payer pour faire tenir un modèle vocal dans 16,9 Mo, et Cactus publie assez de détails pour que vous les voyiez avant de livrer. Pour la plupart des usages longs, Otter et les outils de ma liste d'alternatives à Otter restent le choix pratique.
Ce que Whistle change pour les équipes de support client
Voici où je ramène le sujet au travail que je fais. La voix en support, ce sont surtout des appels téléphoniques, des messages vocaux et des démonstrations enregistrées, et ceux-ci sont longs, impliquent deux locuteurs et s'écartent du script. C'est le côté AMI du tableau de benchmarks de Whistle, pas le côté LibriSpeech. Pour l'automatisation du support téléphonique ou les agents IA de centre d'appels, Whistle n'est pas la couche de transcription que je choisirais aujourd'hui. Les agents vocaux IA conçus pour les appels utilisent des modèles plus gros, en streaming, pour de bonnes raisons.
Le point plus important est que la transcription devient toujours moins chère et plus petite, et qu'elle n'a jamais été la partie difficile. Lors d'un appel commercial eesel, une marque de compléments alimentaires en vente directe, sur Gorgias et Shopify, traitant environ 7 000 tickets par mois, a dit vouloir que l'IA résolve automatiquement la moitié de ses questions sur le suivi de commande, les abonnements et les produits. Le blocage n'était pas de transformer la voix en texte. Ses réponses étaient dispersées entre des outils de procédures, des macros périmées et des démonstrations Loom que personne n'avait mises par écrit. La transcription d'une vidéo Loom n'est que du texte de plus ; il faut encore que quelque chose lise le ticket, trouve la bonne réponse et réponde avec la voix de la marque.
Voilà la ligne que je tracerais : Whistle est de l'infrastructure, et eesel est l'employé. Un modèle comme Whistle entend les mots. Un coéquipier IA de helpdesk travaille la file : il apprend de votre base de connaissances et de vos anciens tickets, rédige ou envoie des réponses dans Zendesk ou Gorgias, et passe la main sur les tickets qu'il ne doit pas toucher.
Si vous avez déjà des transcriptions d'appels qui arrivent dans votre helpdesk, mes guides sur le résumé de transcriptions d'appels et la suppression des données personnelles dans les transcriptions couvrent les étapes après le modèle vocal.
Et comme tout l'attrait de Whistle est qu'on le pilote depuis un terminal : eesel fonctionne aussi comme ça. Le CLI eesel (npm i -g @eesel/cli) permet de connecter un helpdesk, de modifier les instructions permanentes du coéquipier, d'approuver ou de refuser ses actions en attente et de lire son journal d'activité, chaque commande affichant du JSON et un drapeau --dry-run montrant l'appel exact qu'une écriture ferait. Des agents de code comme Claude Code, Codex et Cursor peuvent le piloter comme le ferait une personne, de sorte que le même coéquipier que vous voyez dans le tableau de bord peut être scripté depuis la CI.
Essayer eesel
Si la voix figure sur votre feuille de route parce que vous voulez moins de tickets en attente de réponse, commencez par la partie qui y répond. Le coéquipier IA de helpdesk d'eesel se branche à Zendesk, Gorgias ou Freshdesk en quelques minutes, apprend de votre centre d'aide et de vos anciens tickets, et est testé sur vos propres tickets passés avant de répondre à un vrai client. Vous pouvez essayer eesel gratuitement sans carte bancaire, ou le comparer d'abord à d'autres coéquipiers IA.
