

En bref
DeepInfer est le moteur qui fait tourner l'API de DeepSeek, et depuis le 20 octobre 2026 il est gratuit sur GitHub sous licence Apache 2.0. Le code ne coûte rien ; le ticket d'entrée pour le faire tourner efficacement, c'est environ 128 GPU Blackwell, que DeepSeek désigne lui-même comme la plus petite unité efficace. Au tarif Blackwell le moins cher listé par AWS, cela fait environ 32 500 $ par jour, soit le prix de 54 milliards de tokens de sortie sur l'API DeepSeek aux tarifs heures creuses.
Cette publication compte donc, mais pas comme un kit pour « faire tourner DeepSeek soi-même ». Elle prend en charge un modèle (V4.1 Flash), deux familles de puces, et sort sans le système de cache KV ni les répartiteurs de charge qui rendent possibles les chiffres de DeepSeek. Son vrai public, ce sont les fournisseurs d'inférence et les laboratoires, et son vrai effet se joue sur les prix d'API de tous les autres.
Si vous lisez sur DeepInfer parce que vous voulez une IA qui répond à vos clients, vous pouvez sauter entièrement le calcul des GPU. Je construis les agents derrière eesel, et SE Ranking en fait tourner trois sur Zendesk, avec 4 650 conversations traitées en un mois sans aucune pile d'inférence propre.
Qu'est-ce que DeepInfer ?
DeepInfer est le framework d'inférence interne de DeepSeek : le logiciel qui prend un modèle entraîné et le sert à des millions d'utilisateurs rapidement et à bas coût. Le README GitHub l'appelle "the high-performance inference framework that powers DeepSeek's large-scale production services." DeepSeek l'a annoncé sur X le 20 octobre 2026, et le fil Hacker News a atteint 2 353 points et 892 commentaires en quelques jours.
Si « framework d'inférence » est nouveau pour vous : l'entraînement construit le modèle, l'inférence est chaque fois que quelqu'un lui pose une question. Des moteurs open source comme vLLM et SGLang font déjà ce travail pour la plupart des modèles ouverts. DeepInfer est la version maison de DeepSeek de cette idée, et le README dit clairement qu'il "was originally built primarily on vLLM, with additional inspiration from SGLang and TensorRT-LLM."
Voici la version courte de ce qui a été publié, directement tirée du README :
| DeepInfer, version d'octobre 2026 | |
|---|---|
| Licence | Apache 2.0 |
| Modèles pris en charge | DeepSeek-V4.1-Flash uniquement |
| Matériel pris en charge | GPU NVIDIA SM100, NPU Huawei Ascend 950 |
| Logiciel | Linux, GCC 13+, Python 3.12, CUDA 13 ou CANN 9.2 |
| Mode | Inférence hors ligne (par lots), pas un serveur d'API prêt à l'emploi |
| Langage | Python 89,1 %, C++ 10,6 % |
| Publication associée | deepseek-recipe, l'encodeur d'API vers tokens |
Le modèle qu'il sert est DeepSeek V4.1 Flash, un modèle à contexte de 1M avec vision et appels d'outils, que j'ai traité dans mon test de V4.1 Flash 1017. DeepSeek dit que l'"inference code for future DeepSeek models" arrivera dans le même dépôt.
Qu'est-ce que DeepSeek a réellement publié ?
Le titre dit « entièrement open source ». Le README est plus prudent, et cet écart est la chose la plus utile pour comprendre DeepInfer.
Ce qu'il y a dans la boîte, selon le README :
- Des kernels optimisés issus des précédentes publications ouvertes de DeepSeek : FlashMLA, DeepGEMM, DeepEP, TileKernels et DeepSelect, plus des kernels TileLang sur mesure.
- Parallélisme : parallélisme de données pour l'attention, parallélisme d'experts MoE avec équilibrage de charge des experts (EPLB).
- Décodage spéculatif DSpark avec vérification planifiée selon la confiance.
- SWA bounded replay, une astuce qui réduit le travail de prefill (plus de détails ci-dessous).
- Ordonnancement asynchrone, pour que le GPU n'attende jamais le CPU entre les étapes.
- Inférence invariante au lot et échantillonnage déterministe, NVIDIA uniquement. Même entrée, même sortie, quel que soit le reste du lot.
- Sorties structurées : contraintes par regex, schéma JSON ou grammaire EBNF.
Et ce qui n'y est pas. Le README liste trois éléments "required for a complete inference service (not included in this release)" :
- Un système de cache KV.
- La désagrégation encodeur de vision / prefill / decode ("most required engine functionality is already implemented").
- L'équilibrage de charge entre les réplicas en parallélisme de données, pour le prefill comme pour le decode.
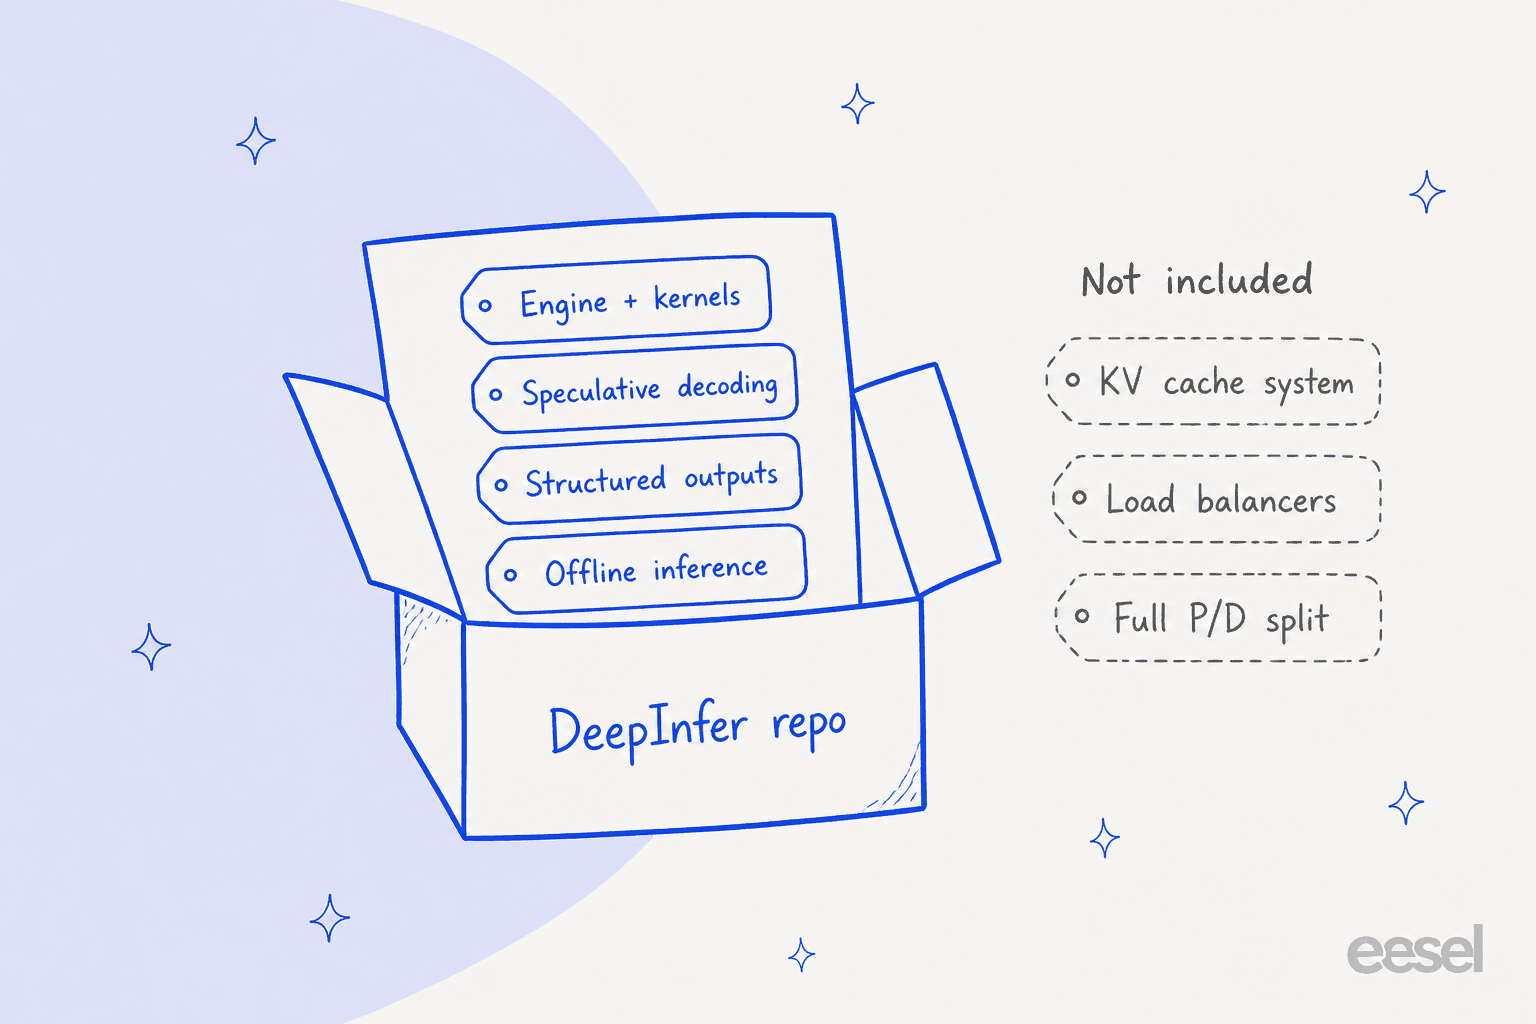
Le Q&R de déploiement de DeepSeek explique pourquoi : les éléments de cache KV et d'équilibrage de charge "are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced." Le même document décrit ensuite en détail le fonctionnement de ces pièces manquantes, ce qui est généreux. C'est un document de conception pour les parties que vous devriez construire vous-même.
Hacker News l'a vu rapidement. La version la plus compacte :
"Notably missing their kv cache system"

C'est important parce que le cache KV est la source des bas prix de DeepSeek. Son API facture 0,003 $ par million de tokens d'entrée en cache en heures creuses contre 0,15 $ sans cache, un écart de 50x, et le moteur qui crée cet écart est la partie que vous n'obtenez pas.
Comment fonctionne DeepInfer ?
DeepInfer découpe le service en étapes distinctes qui tournent sur des groupes de GPU distincts, puis les relie avec des répartiteurs de charge et un cache partagé. Voici l'architecture publiée par DeepSeek dans son Q&R :
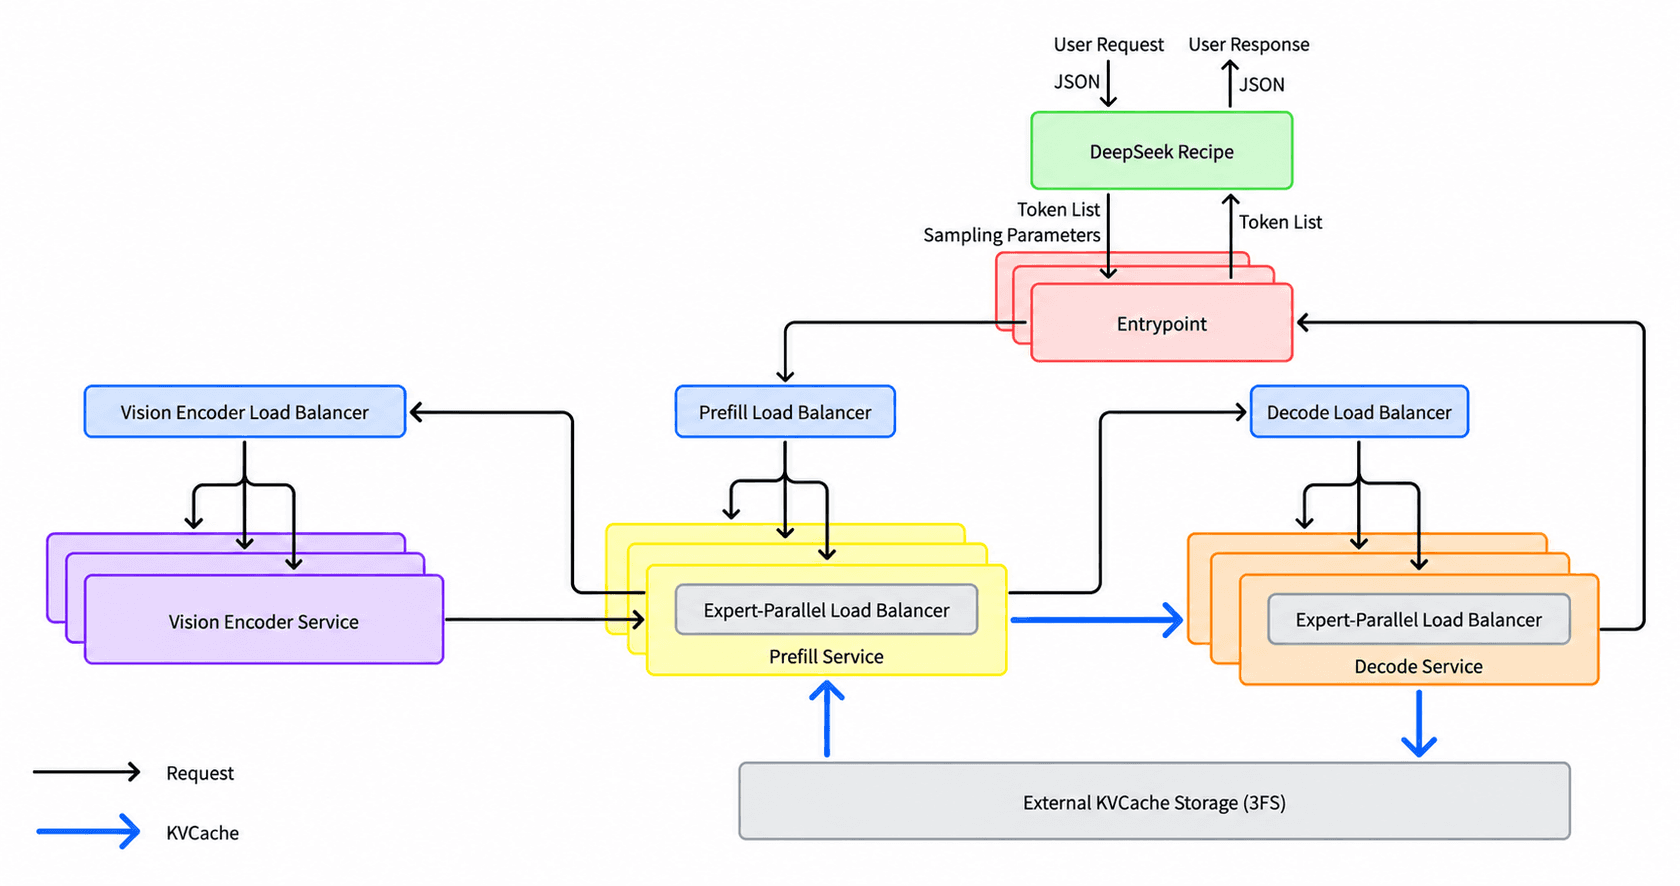
Lecture de haut en bas :
- DeepSeek Recipe transforme une requête JSON entrante (au format Chat Completions, Responses ou Messages API) en tokens, et retransforme les tokens de sortie en réponse en streaming. Il est écrit en Rust avec des bindings Python.
- Le point d'entrée vérifie dans le cache s'il existe un préfixe correspondant, puis route la requête.
- Le prefill lit l'intégralité du prompt et construit l'état d'attention. DeepSeek l'exécute sur des "ordinary 8-GPU machines", avec un parallélisme d'experts de 2 à 8.
- Le decode génère la réponse token par token. Il tourne en largeur : parallélisme d'experts de 64 à 128 GPU.
- Le cache KV est écrit dans un cluster de stockage dédié pour que la requête suivante avec le même préfixe saute le prefill.
La séparation existe parce que les deux tâches sollicitent le matériel différemment. Le prefill est une grosse rafale de calcul sur un long prompt ; le decode est un long filet de minuscules étapes où le trafic mémoire est le goulot d'étranglement. Les exécuter sur des groupes de GPU distincts permet à DeepSeek de régler chacun, de sorte que le délai avant le premier token et la vitesse de chaque token suivant se pilotent indépendamment.
Parallélisme d'experts large
V4.1 Flash est un modèle à mélange d'experts : chaque token n'active que certains des sous-réseaux « experts » du modèle. Répartir ces experts sur 64 GPU au lieu de 8 signifie que chaque GPU détient moins d'experts et déplace moins de mémoire par étape. Le graphique de DeepSeek montre le gain :
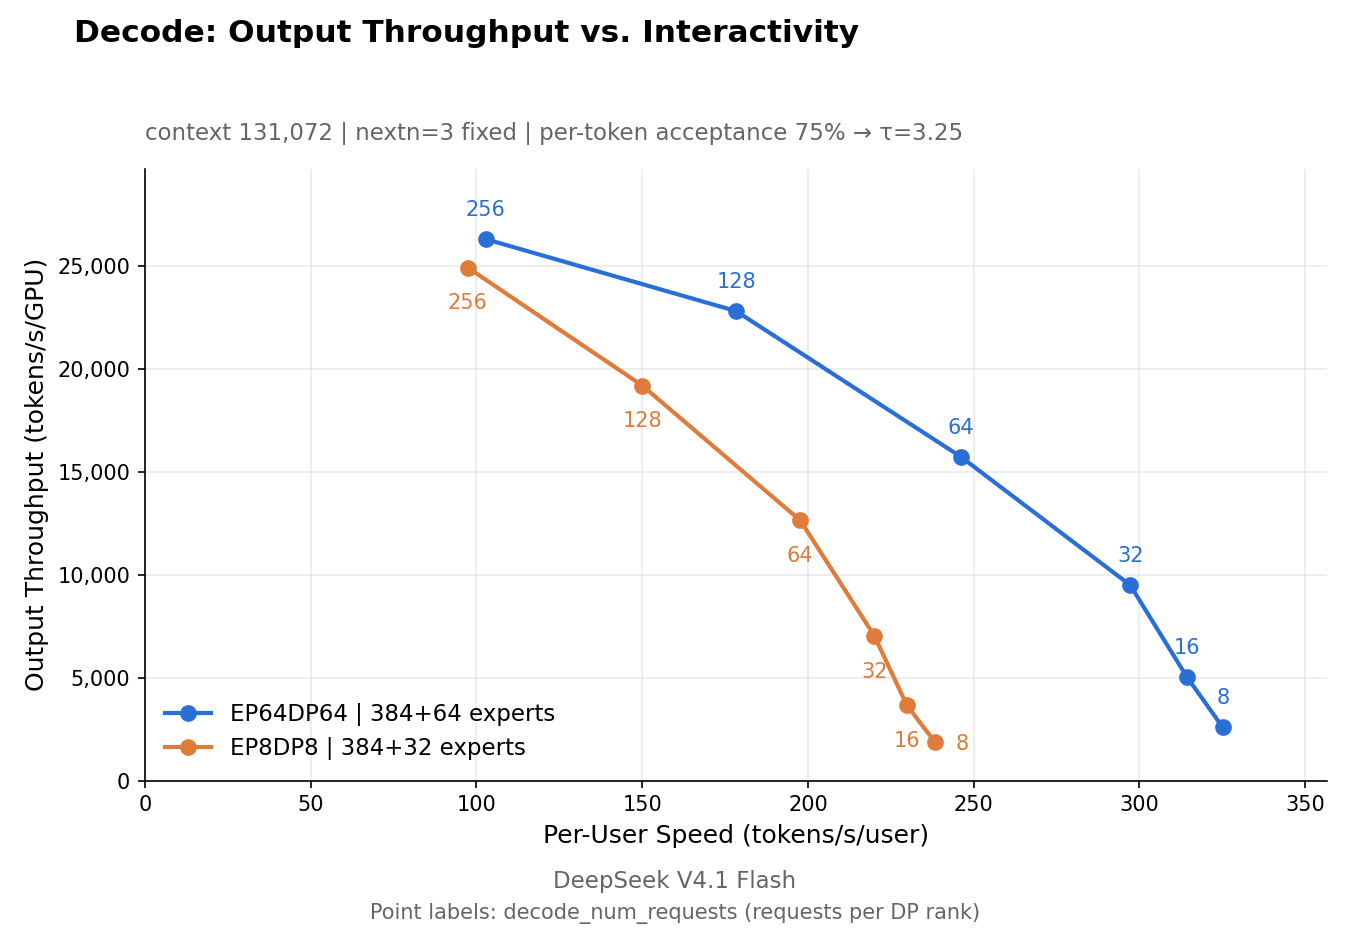
À 64 requêtes par rank, la configuration EP64 fait environ 15 700 tokens par seconde et par GPU à environ 246 tokens par seconde par utilisateur. EP8 atteint environ 12 600 à 198 par utilisateur, plus lent. Aller en largeur est ce qui permet à DeepSeek d'être rapide et bon marché à la fois, et c'est aussi pourquoi le déploiement minimum est si grand.
Décodage spéculatif DSpark
Le décodage spéculatif fait deviner les prochains tokens par un petit modèle brouillon, puis le modèle principal les vérifie en une seule passe. L'astuce de DeepSeek est qu'une « Confidence Head » prédit quelles hypothèses sont probablement justes, de sorte que le calcul de vérification n'est dépensé que sur les plus prometteuses. D'après le Q&R, cela réduit d'environ 30 % les tokens brouillon vérifiés par étape (de 5,00 à 3,2-4,4) avec presque aucun changement de la longueur acceptée (3,29 contre 3,20). Le résultat est +4-7 % de débit au point de fonctionnement en production. Modeste, mais à 155 000 milliards de tokens par jour, 5 %, ça fait beaucoup de GPU.
SWA bounded replay
C'est le morceau le plus astucieux. Quand un préfixe en cache a perdu une partie de son état d'attention à fenêtre glissante, DeepInfer ne recalcule que les 128 derniers tokens au lieu de toute la fenêtre. Le Q&R dit que le coût de recalcul devient "a constant, independent of context length and layer count", et que la version côté décodeur est "nearly halving total prefill computation". Dans le README, on l'active avec DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact.
Le cache KV que vous devriez construire
La couche de cache de DeepSeek est énorme. Le Q&R décrit environ 100 PiB de stockage SSD sur son système de fichiers 3FS, avec des prompts en cache conservés 3 jours pour le trafic d'agents et 7 jours pour le trafic de chatbots, et environ 14,4 To de cache logique par GPU en ligne. Cette longue rétention explique pourquoi une conversation qui revient chez DeepSeek coûte si peu, et c'est la pièce "tightly coupled to our internal infrastructure."
Que faut-il pour faire tourner DeepInfer ?
Deux chiffres décident si DeepInfer est fait pour vous : la liste du matériel et la taille minimale du cluster.
Matériel. Uniquement les GPU NVIDIA SM100 (Blackwell) et les NPU Huawei Ascend 950. Pas de Hopper (H100/H200), pas de cartes grand public. Un dépôt communautaire, Deepinfer-SM80, porte déjà les idées vers de plus anciens GPU Ampere, ce qui montre la demande pour une version qui tourne sur le matériel que les gens possèdent vraiment.
Installation. Le parcours de démarrage est court si vous avez les machines :
# Use `ascend` instead for the Ascend platform
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
python examples/offline_inference.py --ep 8
Le premier lancement télécharge le checkpoint deepseek-ai/DeepSeek-V4.1-Flash-1017 depuis Hugging Face. C'est de l'inférence hors ligne (par lots) : vous lui donnez des prompts, il rend des sorties. Il n'y a pas de serveur compatible OpenAI dans la boîte.
Cluster minimum. C'est le point que la plupart des articles omettent. D'après le Q&R : "the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode." On peut techniquement faire tourner un nœud de prefill et un de decode, mais le decode est réglé pour EP64 et plus, et les chiffres d'efficacité ci-dessus le supposent.
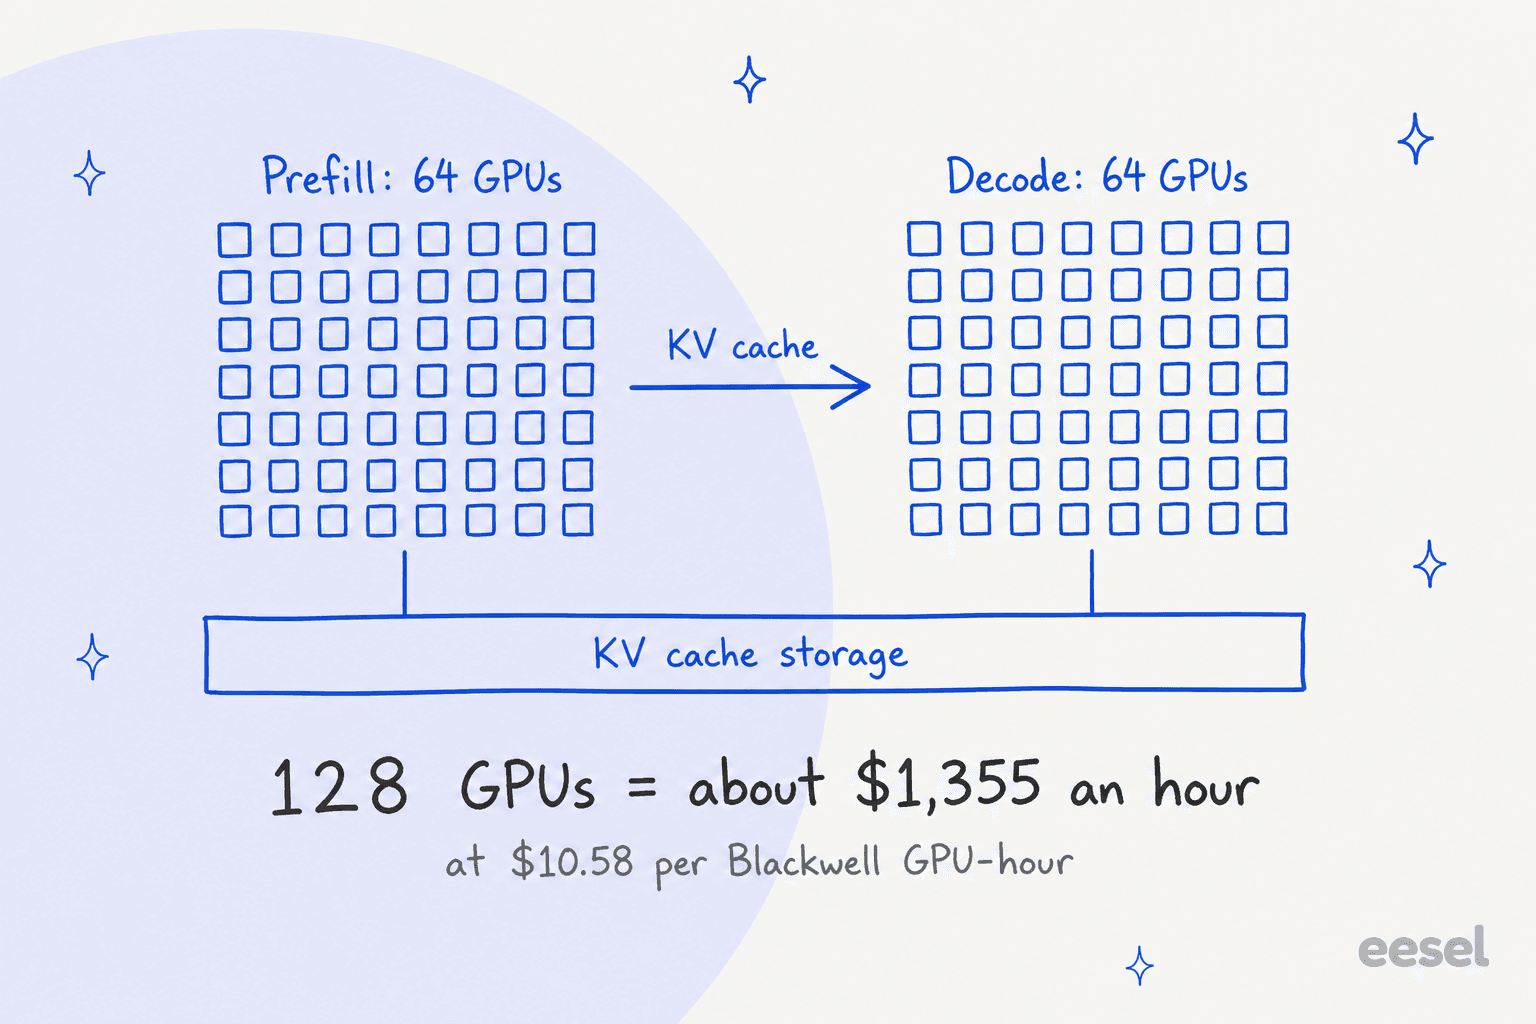
Plus le stockage. DeepSeek recommande 20 SSD de 30,73 To par serveur de stockage de cache KV, chacun offrant au moins 40 Go/s en lecture, dimensionnés pour contenir 24 heures de données. La plupart des équipes qui lisent le README n'ont pas cela de côté.
Combien coûte DeepInfer ?
DeepInfer lui-même coûte 0 $. Tout le reste est du matériel, et la comparaison honnête se fait avec un simple appel à l'API DeepSeek.
Voici ce que DeepSeek facture pour le même modèle que sert DeepInfer, d'après sa page de tarifs :
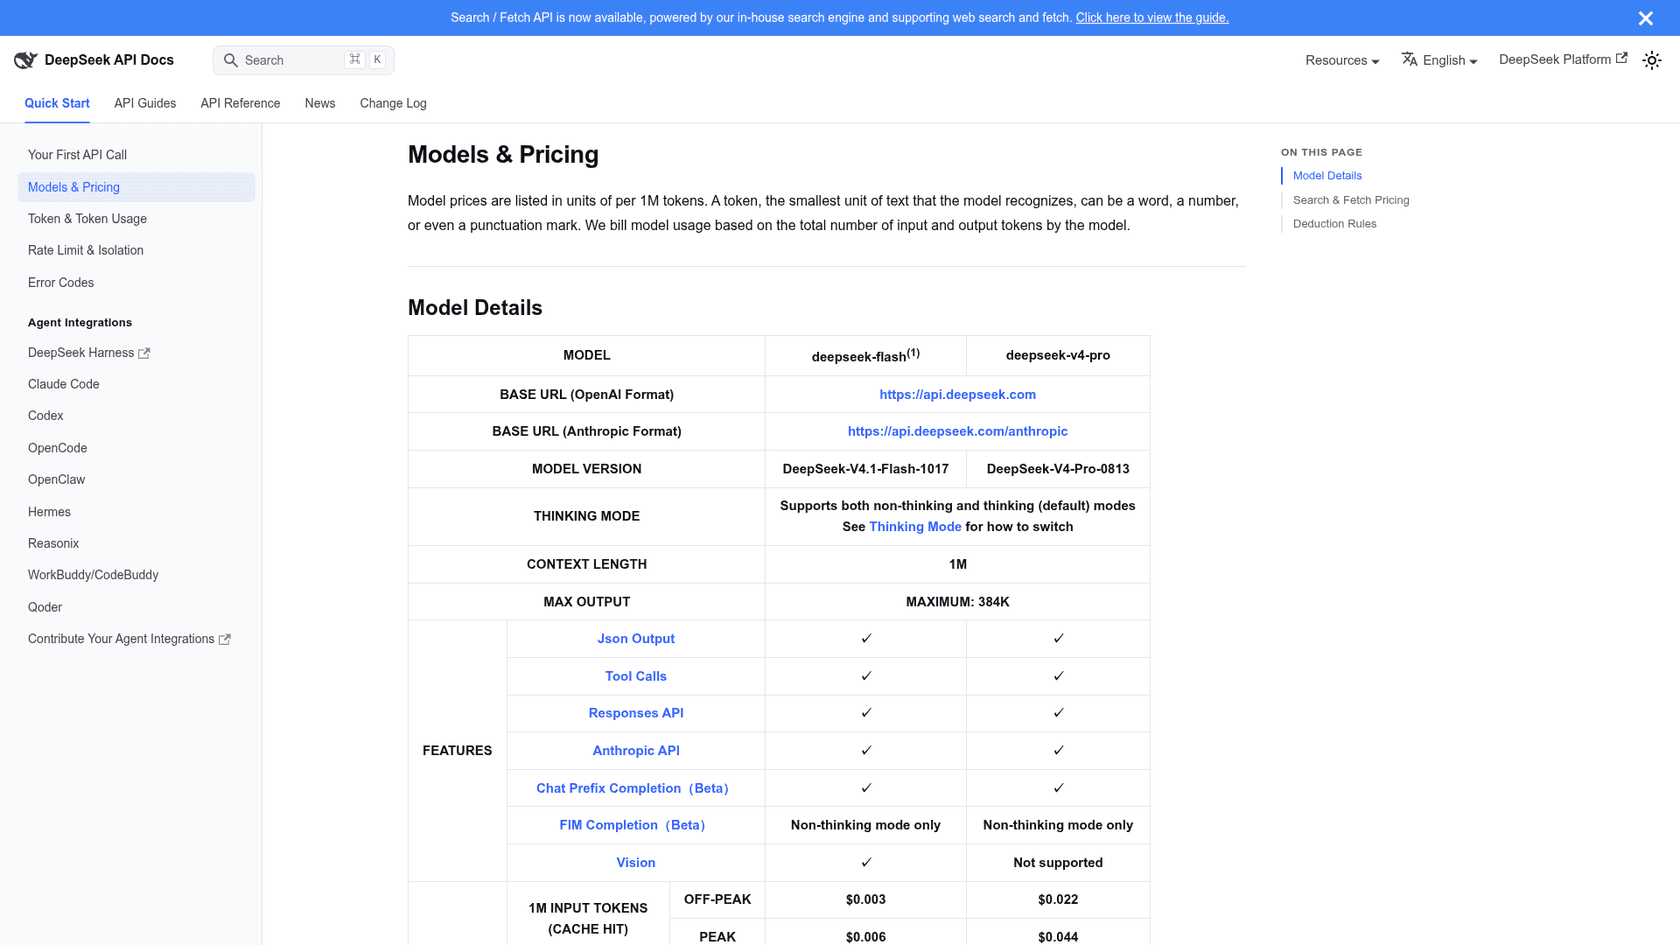
| Par 1M de tokens | V4.1 Flash, heures creuses | V4.1 Flash, heures de pointe | V4 Pro, heures creuses | V4 Pro, heures de pointe |
|---|---|---|---|---|
| Entrée, cache trouvé | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrée, cache manqué | $0.15 | $0.30 | $0.66 | $1.32 |
| Sortie | $0.60 | $1.20 | $1.98 | $3.96 |
Les heures de pointe sont 01:00-04:00 et 06:00-10:00 UTC en semaine ; tout le reste, week-ends compris, est à moitié prix. Mon guide des tarifs de V4.1 Flash détaille ces plages, et la comparaison V4 Flash vs V4 Pro explique quand le plus gros modèle vaut le coup.
Passons à l'auto-hébergement. Les AWS EC2 Capacity Blocks listent le GB200 à 10,582 $ par heure d'accélérateur (US East Dallas Local Zone) et le B200 à 14,208 $ (Ohio, Virginie, Oregon et autres). Les deux sont des SM100 Blackwell.
| Cluster de 128 GPU | Par heure | Par jour | Par 30 jours |
|---|---|---|---|
| GB200 à $10.582/heure de GPU | $1,354 | $32,508 | $975,240 |
| B200 à $14.208/heure de GPU | $1,819 | $43,647 | $1,309,402 |
Et c'est avant les serveurs de stockage, le réseau et les ingénieurs pour construire le cache KV et les répartiteurs de charge manquants. 32 508 $ par jour achètent 54,2 milliards de tokens de sortie chez DeepSeek aux tarifs heures creuses, ou 27 milliards en heures de pointe.
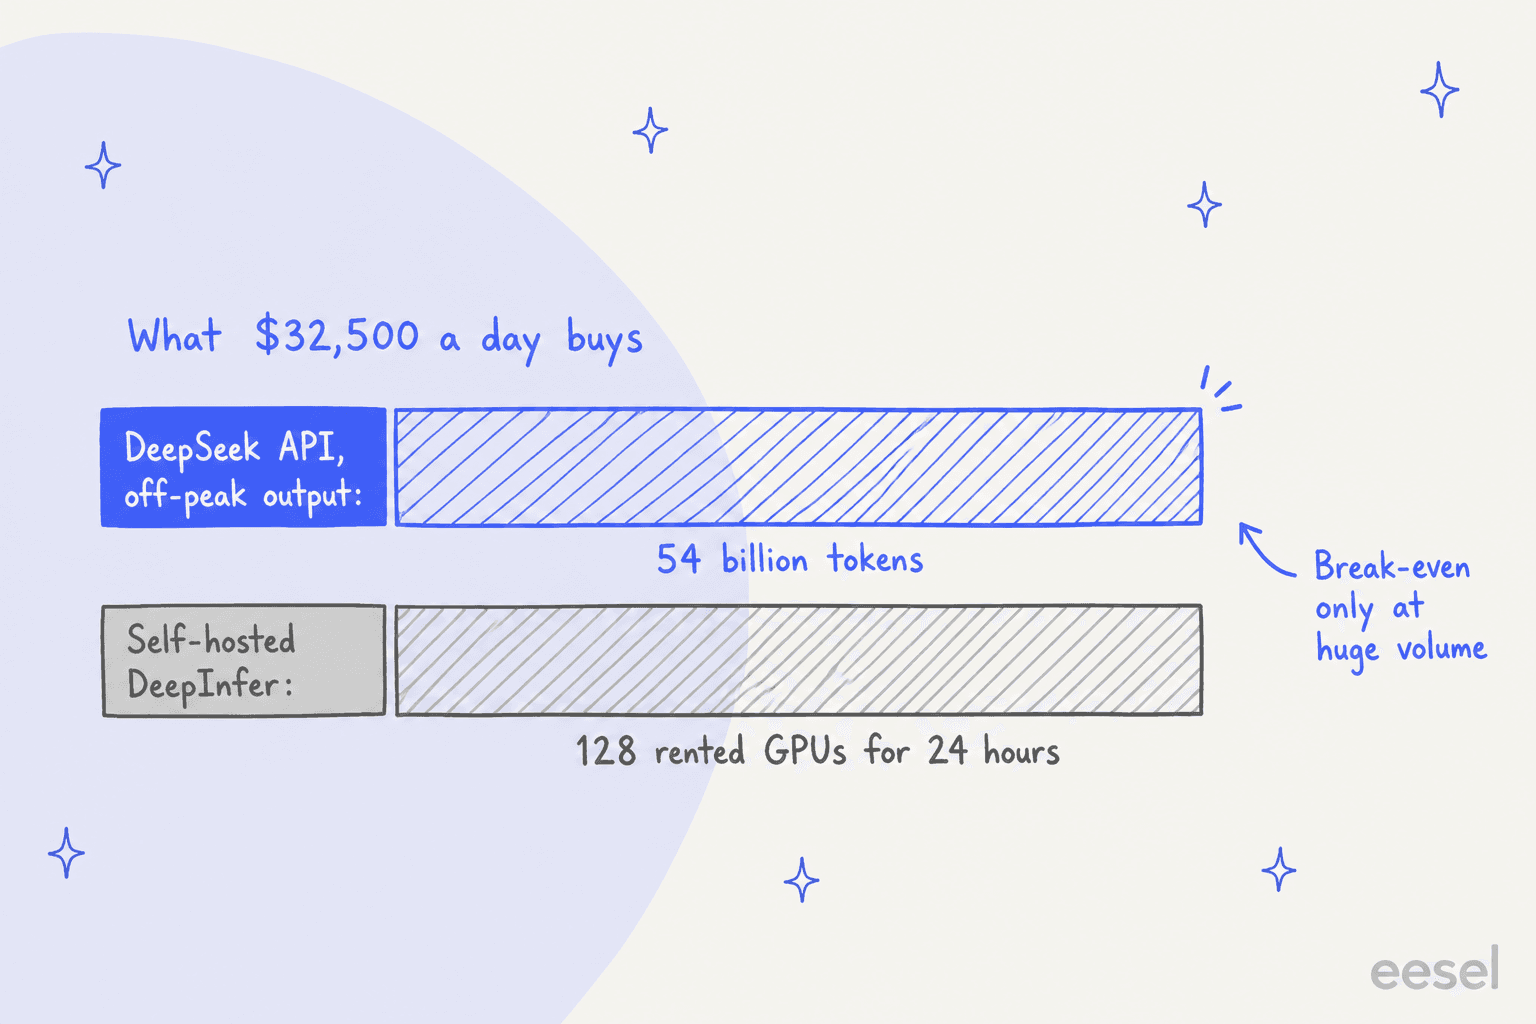
128 GPU peuvent-ils seulement produire autant ? D'après le benchmark de decode de DeepSeek (environ 15 700 tokens par seconde et par GPU à 64 requêtes par rank) sur 64 GPU de decode, le plafond est d'environ 87 milliards de tokens de sortie par jour. DeepSeek dit que son équilibrage de charge atteint "roughly 80% of a perfectly balanced offline benchmark", ce qui ramène à environ 69 milliards. L'auto-hébergement ne bat donc l'API en heures creuses que si vous gardez le cluster à environ 80 % de l'efficacité de production de DeepSeek, jour et nuit, avec une infrastructure que DeepSeek n'a pas publiée. C'est un plafond approximatif, pas un devis, mais il montre la forme de la décision.
Entrez votre propre volume :
Avec les valeurs par défaut, un produit très sollicité utilisant 500 millions de tokens de sortie et 3 milliards de tokens d'entrée par jour, l'API coûte environ 680 $ par jour contre 32 508 $ pour les GPU. Il faudrait environ 48 fois ce trafic pour que le cluster l'emporte sur le seul matériel.
Ce que le chiffre de 38 $ par heure de GPU nous apprend
La phrase la plus citée du lancement n'est pas dans le README. Elle est dans le Q&R : "A single cluster currently serves 155 trillion tokens per day, with overall revenue of US$38 per GPU-hour (at valley pricing)." Valley pricing désigne le tarif heures creuses.
Mis à côté des tarifs AWS ci-dessus, DeepSeek encaisse environ 2,7 à 3,6 fois ce que coûterait la location d'un GPU Blackwell pour la même heure, tout en facturant 0,60 $ le million de tokens de sortie en heures creuses. DeepSeek ne dit pas de quelle carte il s'agit, et n'indique pas ses propres coûts : traitez donc ce chiffre comme un revenu, pas comme une marge. HN a aussi remarqué l'écart :
"For comparison, rental prices seem to be ~$2.75/ per H-100-hour [1]. Meanwhile, Deepseek says "38 USD per hour per card". They haven't specified which card as far as I can tell."
L'enjeu n'est pas que DeepSeek soit riche. C'est que des prix d'API bas peuvent constituer une vraie activité quand la pile de service est aussi efficace. Cela met la pression sur tous les fournisseurs qui facturent plus cher les mêmes poids ouverts, et DeepInfer leur donne le mode d'emploi.
Que disent les développeurs de DeepInfer ?
Les réactions se sont réparties en trois : enthousiasme pour l'ouverture, scepticisme sur ce qui manque, et une remarque tranchante sur qui en profite.
Le camp sceptique, tiré du fil HN :
"Deepseek released just enough to stir the pot but not enough to cook your own from scratch. Wake me up when we can clone, point it at a dozen H100s we own, and get a working production service."
C'est juste sur les deux points : les H100 ne sont pas prises en charge, et les éléments de production n'y sont pas. En contrepoint, les hébergeurs tiers rivalisaient déjà durement sur les modèles de DeepSeek avant cette publication :
"Together.ai, Baseten, and others have already achieved higher throughput, lower latency, and lower E2E latency for DeepSeek V4.1 Flash 1017 than DeepSeek's own inference service."
Des fournisseurs comme Together AI, Baseten et Fireworks AI sont ceux qui peuvent réellement utiliser les kernels de DeepInfer et l'encodeur deepseek-recipe, que DeepSeek dit "fully aligned with the official DeepSeek API, so third-party deployments get the same API behavior as the official one." Pour un développeur, cela signifie qu'un modèle DeepSeek chez un hébergeur tiers devrait interpréter les appels d'outils et le raisonnement comme chez DeepSeek. C'est une correction discrète mais réelle.
Et une remarque sur les modèles de tarification qui n'a rien à voir avec les moteurs :
"Even though their API price is cheap compared to OpenAI/Anthropic, I still can't "afford" to use their API because the subscriptions from OAI/Anthropic provide far higher value and peace of mind. I know for sure how much I need to pay each month."
L'annonce de DeepSeek présentait l'objectif comme aider "the community lower compute costs, reduce energy use, and make AI more affordable." Le post a récolté 43 339 j'aime sur X.
Comment DeepInfer se compare-t-il à vLLM et SGLang ?
DeepInfer n'est pas encore un rival généraliste de vLLM ou SGLang. C'est un spécialiste construit à partir d'eux. Voici comment les trois se situent, d'après le README de chaque projet :
| DeepInfer | vLLM | SGLang | |
|---|---|---|---|
| Modèles | DeepSeek V4.1 Flash uniquement | Nombreuses familles de modèles ouverts | Nombreuses familles de modèles ouverts |
| Matériel | Blackwell (SM100), Ascend 950 | Plusieurs fabricants de GPU et d'accélérateurs | Plusieurs fabricants de GPU et d'accélérateurs |
| Serveur d'API en ligne | Pas dans cette version | Oui, compatible OpenAI | Oui, compatible OpenAI |
| Origine | Construit principalement sur vLLM | Projet d'origine | Projet d'origine |
| Idéal pour | Étudier ou réutiliser les astuces de production de DeepSeek | Servir la plupart des modèles ouverts | Servir la plupart des modèles ouverts |
Si vous choisissez cette semaine un moteur pour servir un modèle ouvert, vLLM ou SGLang reste la réponse. DeepInfer est l'endroit où chercher des idées (EP large, DSpark, bounded replay) qui apparaîtront probablement ensuite dans ces projets. TorchTPU de Google est sorti le même jour et a la même nature : de la plomberie importante pour ceux qui exploitent des puces, invisible pour tous les autres.
Qui devrait s'intéresser à DeepInfer ?
Réponse courte : moins de monde que le nombre d'étoiles ne le laisse penser.
- Fournisseurs d'inférence et grands laboratoires : oui. C'est une référence fonctionnelle pour servir à bas coût un modèle MoE de taille frontière, avec la conception des éléments manquants écrite noir sur blanc.
- Chercheurs et ingénieurs d'infrastructure : oui, comme guide d'étude. Le document Q&R est l'un des comptes rendus publics les plus détaillés du service de LLM en production que j'aie lus.
- Équipes soumises à des règles de données strictes qui veulent DeepSeek sur leur propre matériel : peut-être, si vous exploitez déjà Blackwell ou Ascend à grande échelle. Le mode d'échantillonnage déterministe est un vrai plus pour les audits.
- Startups et créateurs d'applications : non. Utilisez l'API, ou un hébergeur comme Fireworks AI qui sert des modèles ouverts pour vous. Comparez avec Kimi K3.1 Pro ou Qwen 3.8 Max avant de vous engager sur une famille de modèles.
- Équipes support et opérations : non. Vous avez besoin de réponses, pas d'un moteur.
DeepInfer abaisse le plancher de ce que coûte le service de l'IA ; il n'abaisse pas ce que vous coûte de faire tourner l'IA vous-même. Ce sont deux choses différentes, et la plupart de la couverture enthousiaste les confond.
Où se place eesel : ceci est de l'infrastructure, eesel est l'employé
DeepInfer est de l'infrastructure : il rend les tokens moins chers à produire. eesel est l'autre bout de cette pile, un coéquipier IA que vous embauchez pour un poste. Aujourd'hui, ce sont le coéquipier IA pour le helpdesk et le rédacteur de blog IA, chacun avec les compétences, intégrations et contexte d'entreprise de son rôle déjà intégrés.
Pour une équipe support, le coût du modèle n'a jamais été le plus difficile. Aux tarifs heures creuses de DeepSeek, un ticket de 6 000 tokens d'entrée sans cache et 800 tokens de sortie coûte environ 0,0014 $, environ un septième de centime. Ce qui coûte vraiment du temps, c'est de faire répondre l'agent comme le ferait votre meilleur agent : lire votre centre d'aide et vos tickets passés, savoir quand passer la main, et le prouver sur l'historique réel avant que les clients ne le voient. J'ai vu des bots sûrs d'eux donner de mauvaises réponses sur des files en direct, c'est pourquoi chaque déploiement d'eesel est d'abord simulé sur des tickets historiques.
SE Ranking en donne une bonne image. L'entreprise vend trois produits depuis une seule équipe support, elle fait donc tourner trois agents eesel sur trois connexions Zendesk, chacun répondant pour son propre produit à partir d'environ 16 800 pages de connaissances. Sur un mois (du 8 août au 8 septembre 2026), ils ont traité 4 650 conversations : 2 554 tickets Zendesk et 2 102 chats en direct, dont environ 2 100 chats d'abord traités par eesel. Aucun cluster de GPU impliqué.

Si vous voulez comparer ce que coûte l'IA dans votre helpdesk, mon analyse des tarifs de Zendesk AI et le guide du support client par IA sont de meilleurs points de départ que n'importe quel moteur d'inférence. Et si vous voulez savoir quels modèles sont vraiment bons en support, je tiens un avis à jour sur le meilleur LLM pour le support.
Pour les développeurs qui aiment le terminal, eesel propose une CLI qui pilote le même coéquipier et le même espace de travail que le tableau de bord. Vous, un script ou un agent de code comme Claude Code pouvez connecter un helpdesk, ajouter des connaissances et tester l'agent sur des tickets passés sans ouvrir de navigateur. C'est l'accès adapté aux agents que la plupart des équipes veulent vraiment d'une « infrastructure ouverte ».
Essayer eesel
DeepInfer s'adresse à ceux qui exploitent des clusters de GPU. Si votre objectif est une IA qui répond aux clients dans Zendesk, Freshdesk ou Gorgias, eesel est un coéquipier helpdesk qui apprend de vos tickets passés et de votre centre d'aide, est testé sur votre historique réel avant sa mise en ligne, et démarre à 299 $ par mois pour 500 tickets ou chats sur la page des tarifs. Essayez eesel gratuitement avec 100 crédits, ou démarrez depuis le terminal avec npx @eesel/cli.
