

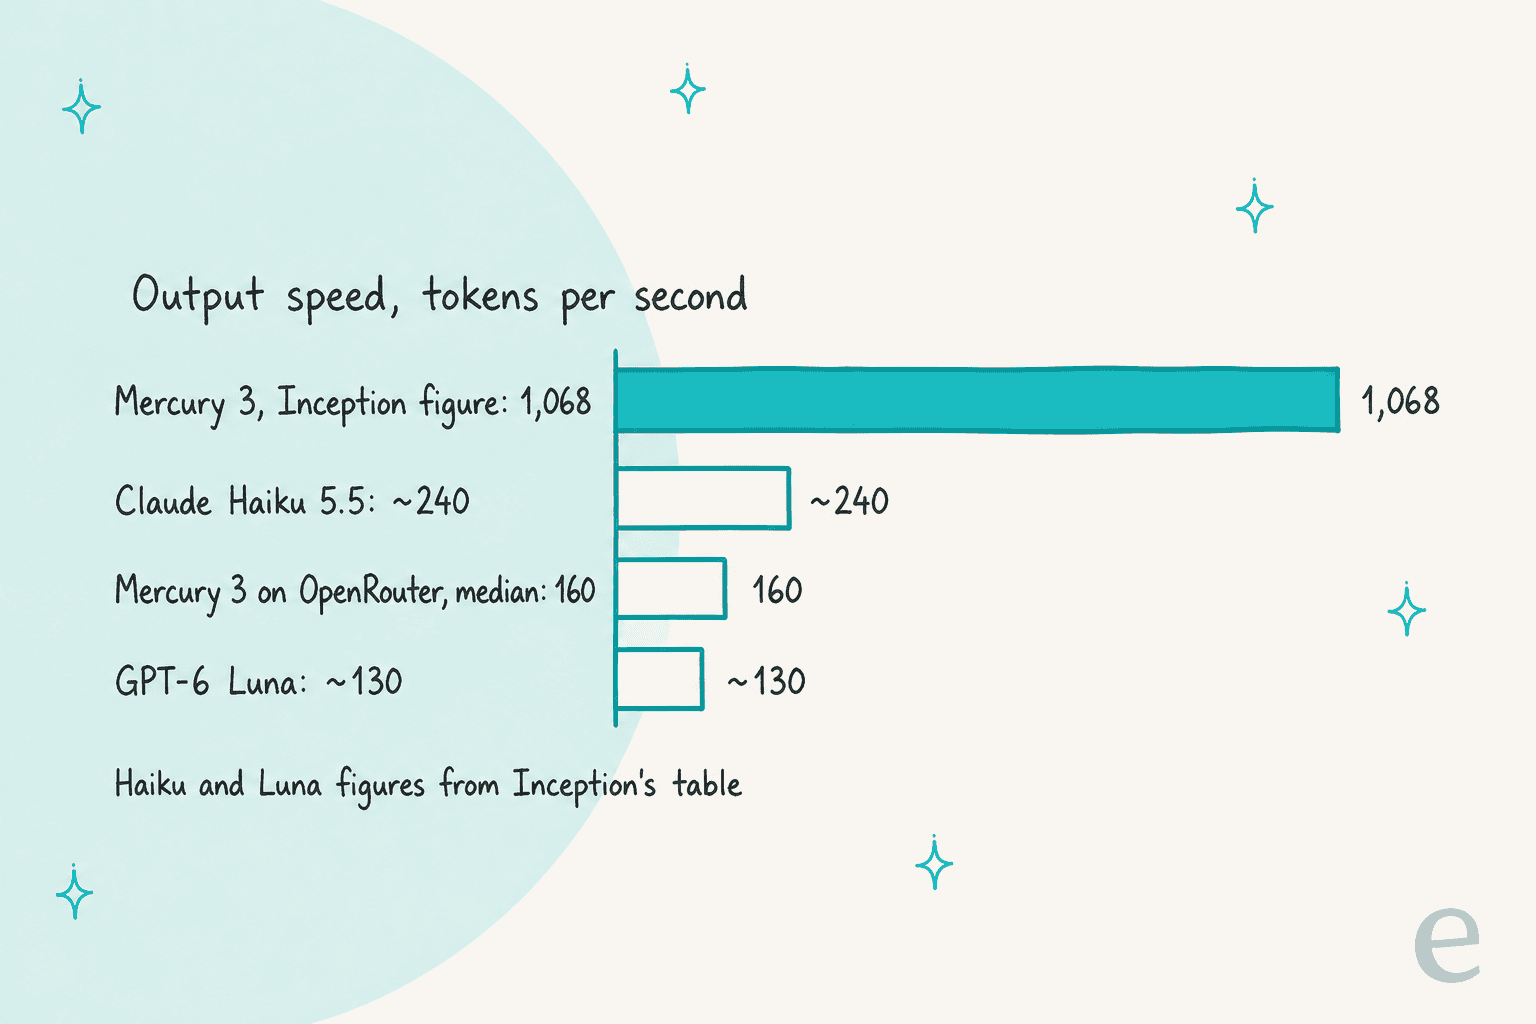
Mercury 3 est le tout dernier modèle d'Inception, lancé le 19 octobre 2026. C'est un modèle de langage à diffusion : au lieu de taper un token à la fois, il rédige la réponse entière et l'affine en quelques passes. Inception le chronomètre à 1,068 tokens par seconde, avec une fenêtre de contexte de 1 M de tokens, l'appel d'outils et des sorties structurées.
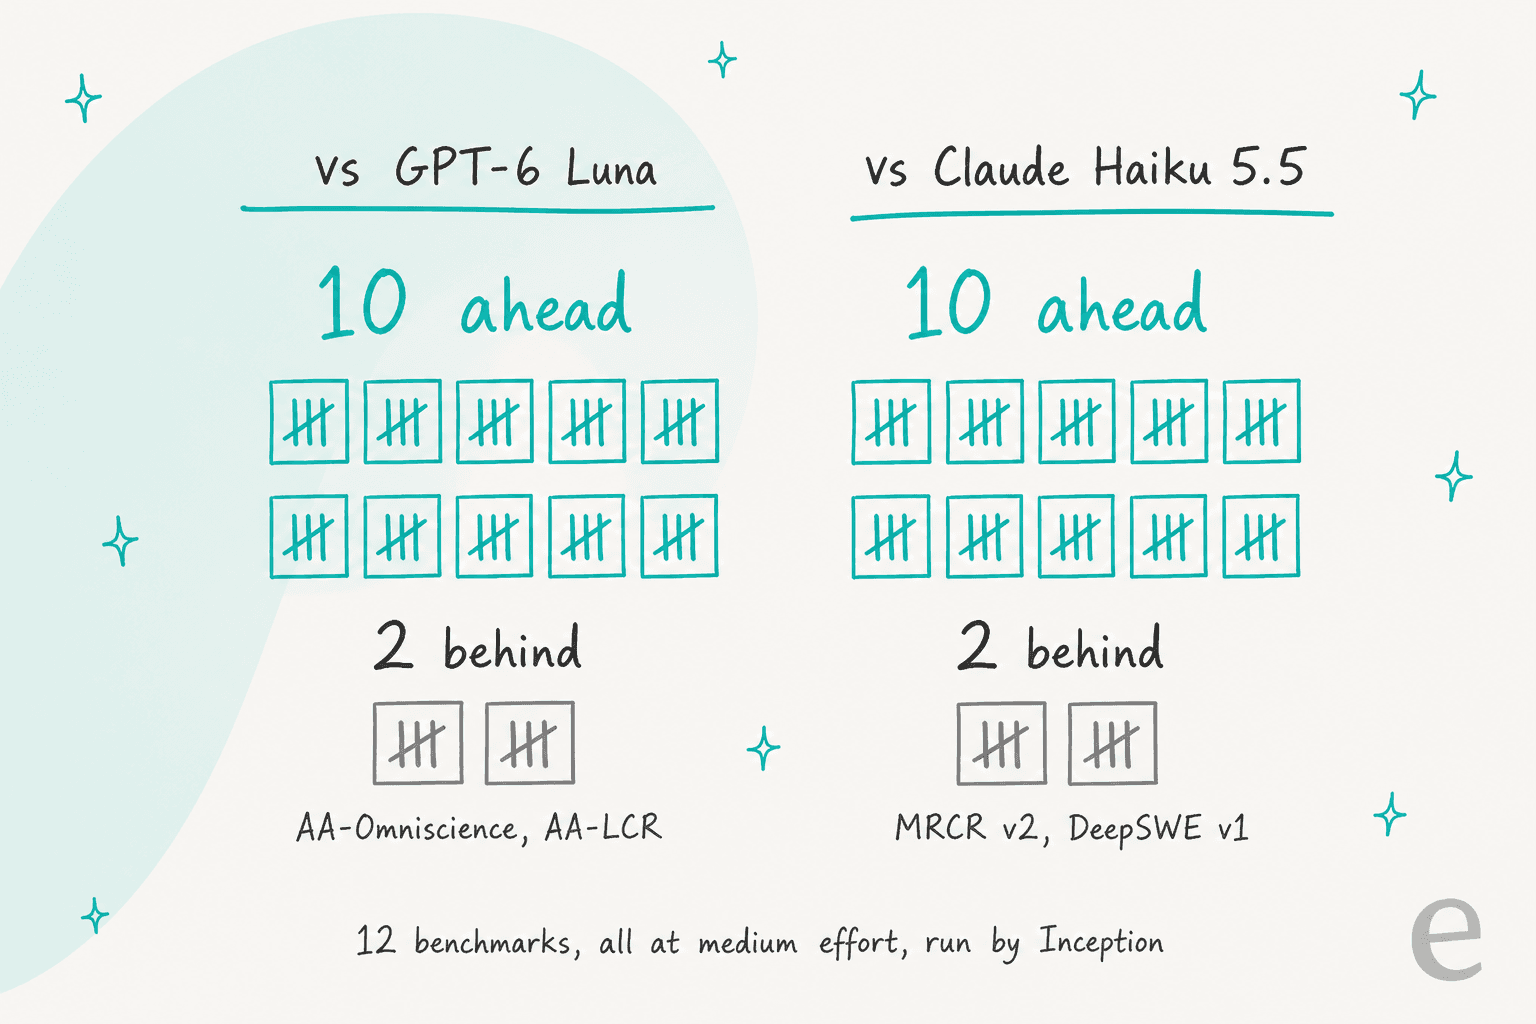
Dans le tableau de benchmarks d'Inception lui-même, il bat GPT-6 Luna et Claude Haiku 5.5 sur 10 tests sur 12, tous à effort moyen. Il coûte $0.20 en entrée et $0.70 en sortie par million de tokens, moitié moins au lancement ($0.10 / $0.35), et les nouvelles clés reçoivent 100 millions de tokens gratuits.
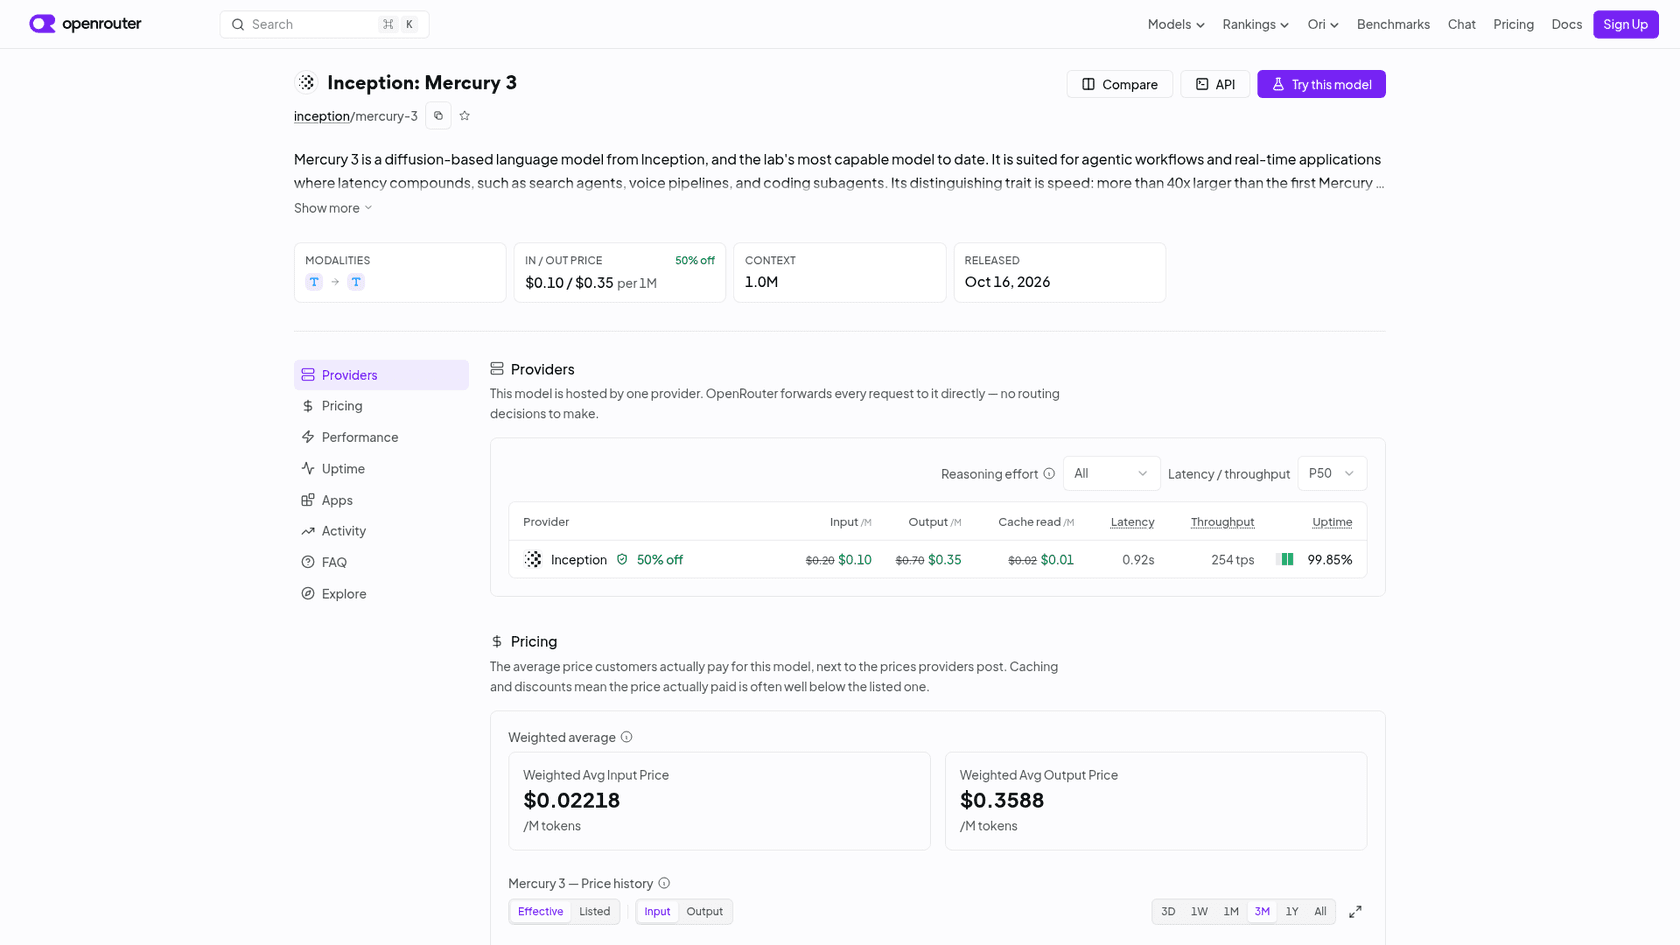
Le hic, c'est la vitesse que vous verrez réellement. OpenRouter, qui envoie chaque requête Mercury 3 à Inception, a mesuré une médiane de 160 à 254 tokens par seconde la semaine du lancement, rapide mais très loin de 1,068, et des testeurs de Hacker News ont signalé un premier token lent. Servez-vous-en pour les boucles d'agents et les sous-agents, où l'attente s'accumule. Pour les équipes de support, c'est un moteur solide, mais c'est de l'infrastructure : eesel est l'employé, et son coéquipier IA pour le helpdesk est ce qui transforme un modèle comme celui-ci en tickets résolus.
Pourquoi j'ai regardé ce lancement de près
Je passe une grande partie de ma semaine à lire ce que les gens recherchent et ce qu'ils veulent vraiment dire. « Mercury 3 » est une recherche sur la vitesse : les gens veulent savoir si le chiffre de 1 000 tokens par seconde survit au contact d'une vraie API. J'ai donc lu le lancement ainsi, avec les pages d'Inception ouvertes à côté des chiffres en direct d'OpenRouter et du fil de lancement sur Hacker News.
Il y a une deuxième raison. eesel place des modèles d'IA sur de vraies files de support depuis des années, et la leçon qui revient sans cesse est que les chiffres de laboratoire d'un modèle ne décident jamais s'il fonctionne sur vos tickets. C'est pourquoi eesel simule chaque déploiement sur les tickets historiques d'un client avant que l'IA ne réponde à qui que ce soit. J'ai appliqué la même habitude ici : vérifiez l'affirmation avec une mesure externe avant de vous organiser autour d'elle.
Qu'est-ce qu'Inception Mercury 3 ?
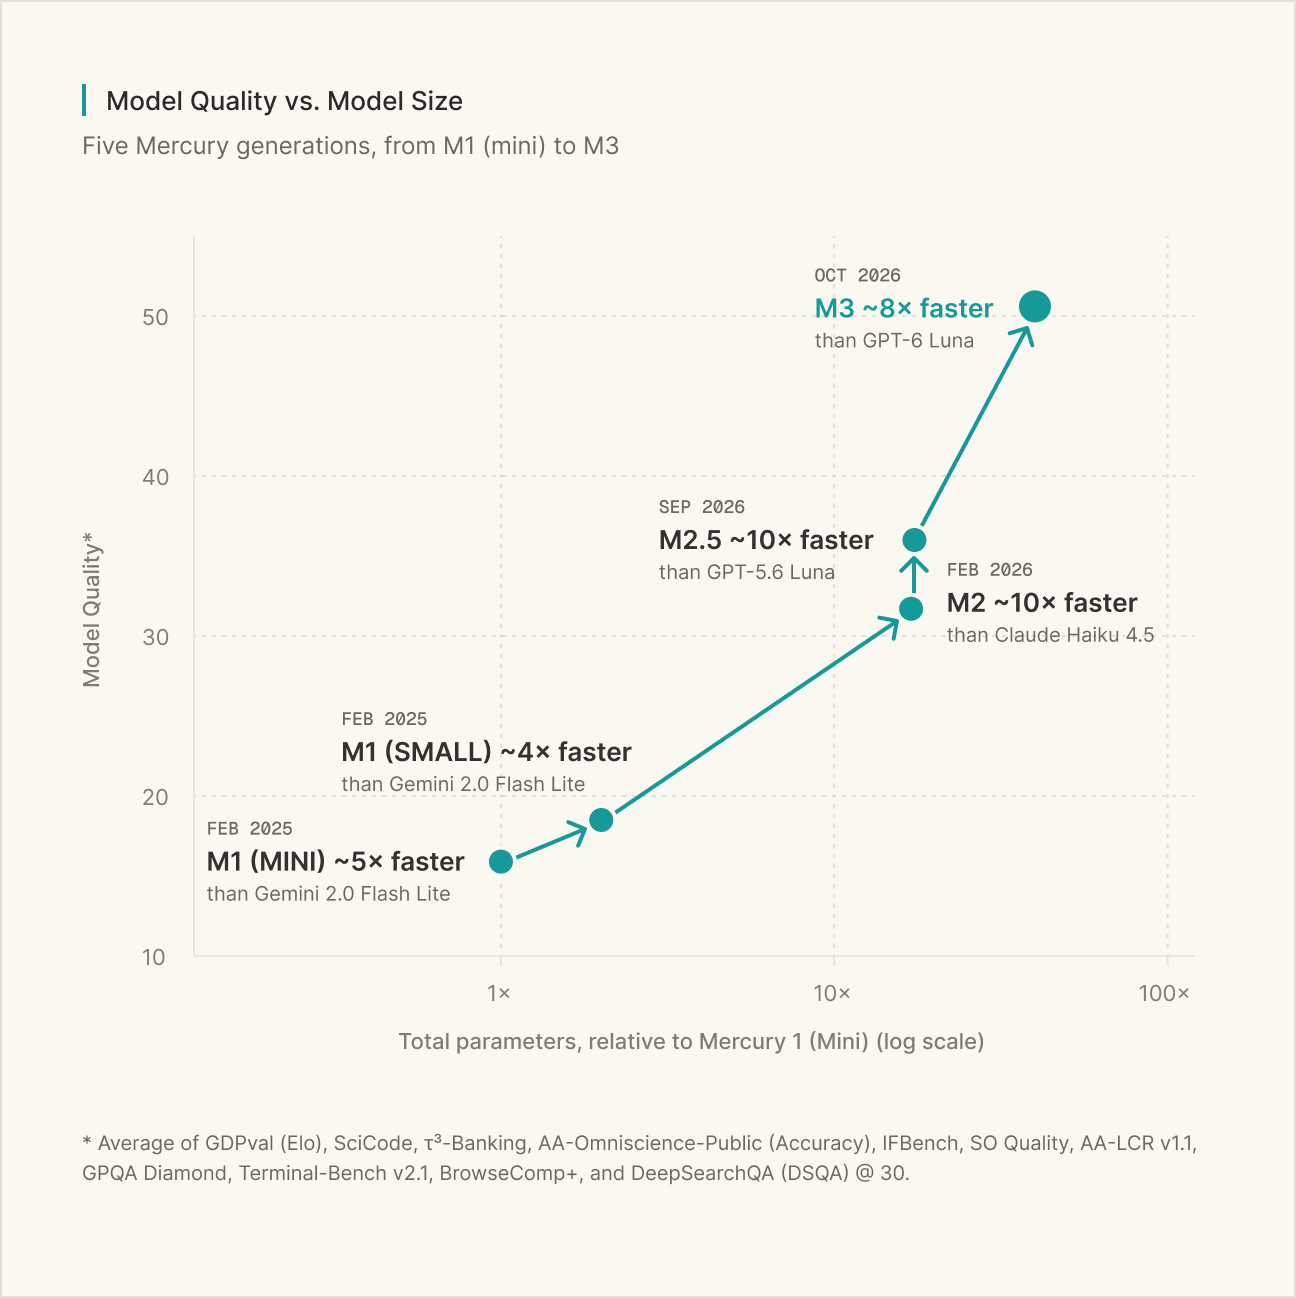
Mercury 3 est le modèle phare d'Inception, un laboratoire qui construit ce qu'il appelle des LLM à diffusion (dLLM). L'article de lancement d'Inception le qualifie de "the most capable diffusion-based LLM released to date" et affirme qu'il est plus de 40 fois plus gros que Mercury 1 tout en tournant à la même vitesse. Il remplace Mercury 2.5, sorti seulement le mois dernier.
Voici ce que vous obtenez, directement de la documentation des modèles d'Inception :
| Caractéristique | Mercury 3 |
|---|---|
| Date de lancement | 19 octobre 2026 |
| Type | LLM à diffusion, poids fermés |
| Vitesse de sortie (chiffre d'Inception) | 1,068 tokens par seconde sur GPU NVIDIA |
| Fenêtre de contexte | 1M de tokens (contre 260K sur Mercury 2.5) |
| Sortie maximale | 131,072 tokens |
| Effort de raisonnement | instant, low, medium, high |
| Fonctions | Appel d'outils, sorties structurées |
| Entrée et sortie | Texte uniquement |
| API | Compatible OpenAI, ID de modèle mercury-3 |
| Prix (catalogue) | $0.20 entrée / $0.70 sortie par 1M de tokens |
| Prix (lancement, 50 % de remise) | $0.10 entrée / $0.35 sortie par 1M de tokens |
| Quota gratuit | 100 millions de tokens sur les nouvelles clés d'API |
Deux choses que le tableau ne dit pas. Inception n'a pas publié le nombre de paramètres ; son cofondateur a écrit sur Hacker News qu'ils sont "not publicly announcing the model size right now." Et il n'y a pas de poids à télécharger. Si cela compte pour vous, DiffusionGemma de Google est le modèle à diffusion ouvert à comparer.
En quoi un LLM à diffusion est-il différent ?
Presque tous les modèles que vous utilisez aujourd'hui, de GPT-6.1 Sol à DeepSeek V4.1 Flash, sont autorégressifs. Ils prédisent le token suivant, l'ajoutent et recommencent, de gauche à droite. C'est pourquoi les longues réponses prennent du temps : une réponse de 2,000 tokens, ce sont 2,000 étapes à la suite, quelle que soit la rapidité de chaque étape.
Un modèle à diffusion fonctionne à l'inverse. Il part d'un brouillon grossier et bruité de toute la réponse et affine l'ensemble en parallèle en un petit nombre de passes. L'article de lancement de Mercury 2 d'Inception l'a bien formulé : "Less typewriter, more editor revising a full draft at once." Si vous avez vu des générateurs d'images faire émerger une image nette du bruit, c'est la même idée appliquée au texte. Mon explication sur les modèles d'IA à diffusion approfondit le côté image.
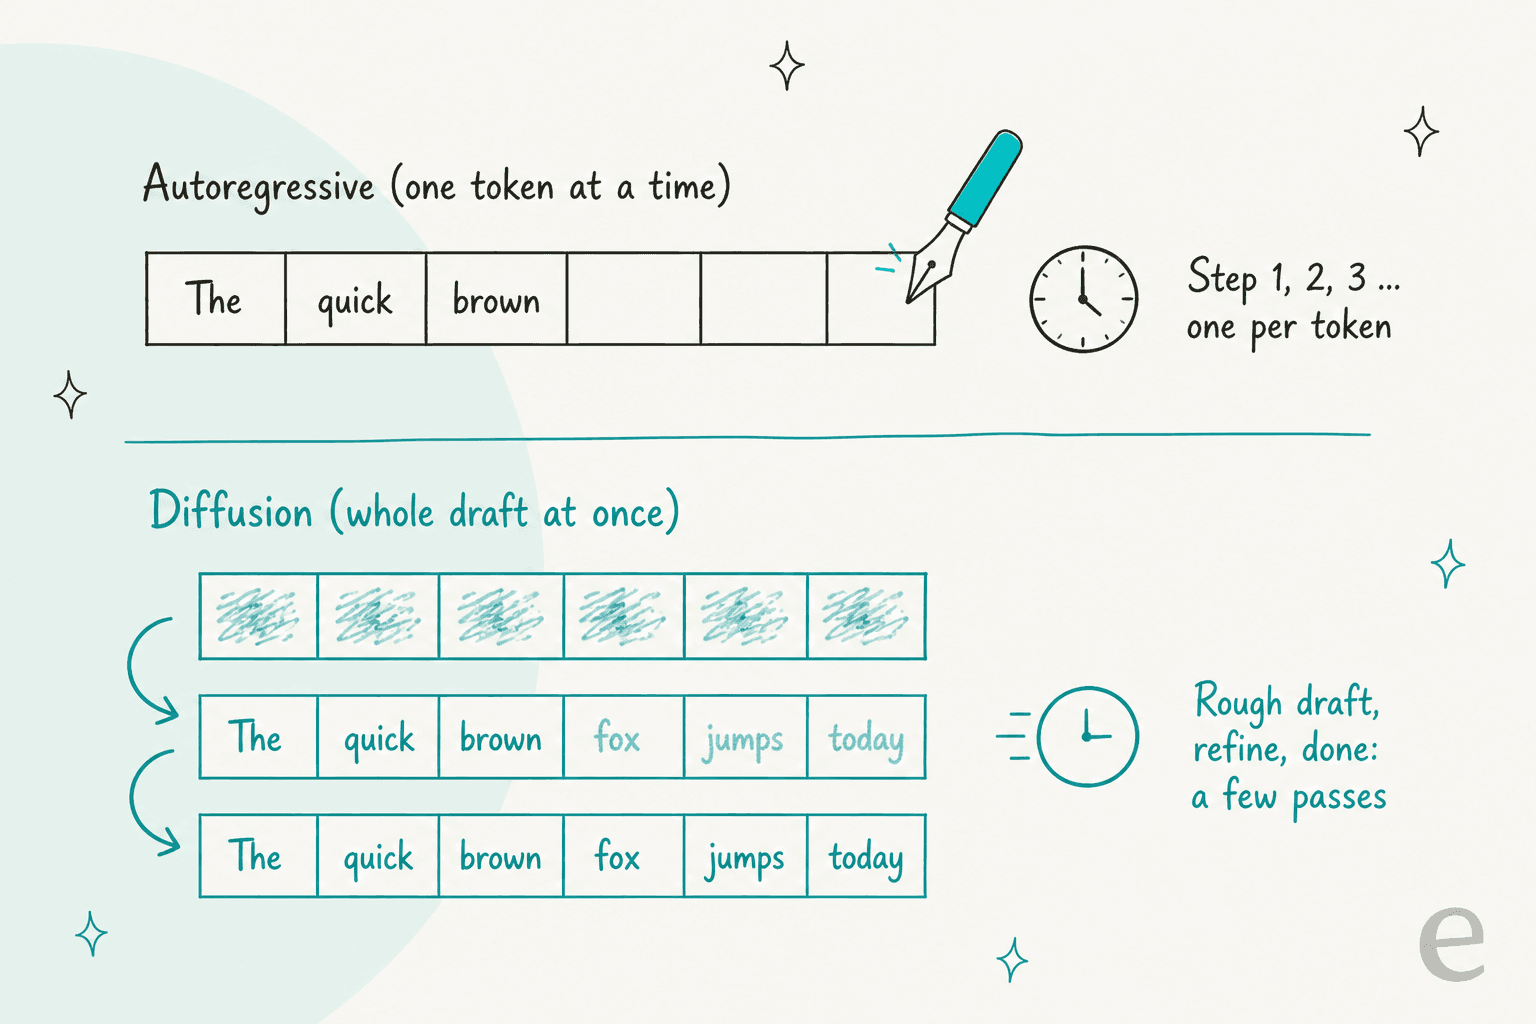
Pourquoi cela compte davantage aujourd'hui : les modèles de raisonnement réfléchissent avant de répondre, et réfléchir, ce sont des tokens de sortie. Le cofondateur et directeur scientifique d'Inception, Volodymyr Kuleshov, l'a souligné dans le fil de lancement : comme la diffusion écrit les tokens en parallèle, l'écart de vitesse se creuse à mesure que les modèles réfléchissent plus longtemps.
"Diffusion generates tokens in parallel through iterative denoising rather than one at a time, so as reasoning models think longer per answer, the speed advantage over autoregressive models of the same size grows."

Pendant des années, la question ouverte était de savoir si les LLM à diffusion pouvaient devenir intelligents, pas seulement rapides. La réponse d'Inception est un graphique de mise à l'échelle : cinq générations de Mercury, du début 2025 à aujourd'hui, avec une qualité qui monte à mesure que le modèle grandit.
Benchmarks de Mercury 3 : ce que montre le tableau d'Inception
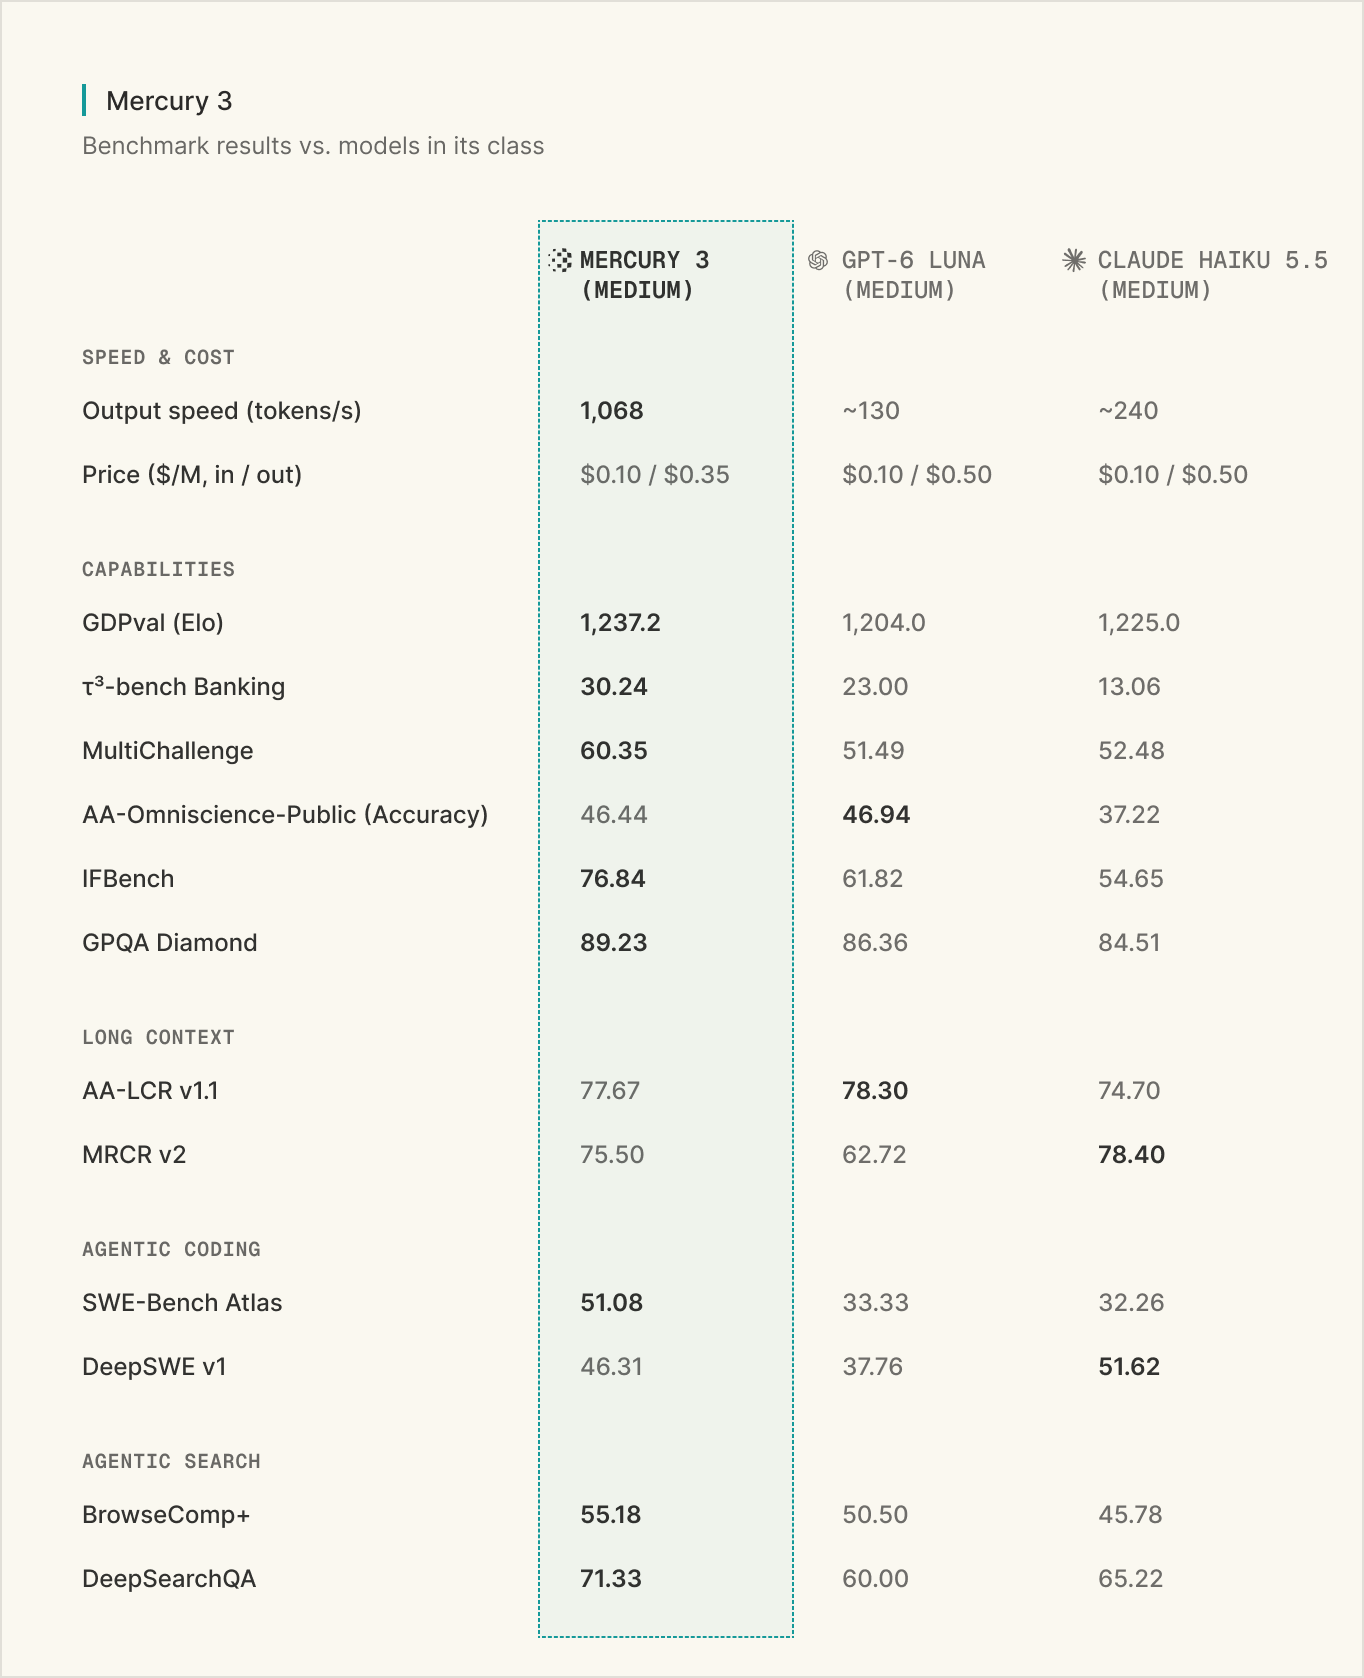
Inception compare Mercury 3 aux deux modèles qu'il vise à remplacer : GPT-6 Luna d'OpenAI et Claude Haiku 5.5 d'Anthropic, tous deux à effort moyen. Voici le tableau complet de l'article de lancement :
| Benchmark | Ce qu'il teste | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|---|
| GDPval (Elo) | Tâches de travail réelles | 1,237.2 | 1,204.0 | 1,225.0 |
| τ³-bench Banking | Agent de service client | 30.24 | 23.00 | 13.06 |
| MultiChallenge | Chat multi-tours | 60.35 | 51.49 | 52.48 |
| AA-Omniscience (Accuracy) | Rappel factuel | 46.44 | 46.94 | 37.22 |
| IFBench | Respect des instructions | 76.84 | 61.82 | 54.65 |
| GPQA Diamond | Sciences de niveau universitaire avancé | 89.23 | 86.36 | 84.51 |
| AA-LCR v1.1 | Raisonnement en contexte long | 77.67 | 78.30 | 74.70 |
| MRCR v2 | Rappel en contexte long | 75.50 | 62.72 | 78.40 |
| SWE-Bench Atlas | Programmation agentique | 51.08 | 33.33 | 32.26 |
| DeepSWE v1 | Programmation agentique | 46.31 | 37.76 | 51.62 |
| BrowseComp+ | Recherche agentique | 55.18 | 50.50 | 45.78 |
| DeepSearchQA | Recherche agentique | 71.33 | 60.00 | 65.22 |
En parcourant le tableau, Mercury 3 a le meilleur score sur 8 lignes sur 12. En face-à-face, il bat chaque rival sur 10 sur 12.
Trois choses à garder en tête avant de citer ce tableau :
- Chaque chiffre vient de l'exécution d'Inception. Il n'y a pas encore de page Artificial Analysis pour Mercury 3, et Kuleshov a dit sur Hacker News que les benchmarks par des tiers sont en cours.
- Tout est à effort moyen. Un commentateur a demandé pourquoi, puisque beaucoup de gens utilisent les modèles économiques à effort élevé ou maximal. Il n'y a pas de courbe du faible à l'élevé, donc on ne sait pas dans quelle mesure Luna ou Haiku comblent l'écart avec plus de réflexion.
- Les plus grosses victoires sont sur les tests d'agents. SWE-Bench Atlas (51 contre 33) et τ³-bench Banking (30 contre 23 et 13) montrent de larges écarts. Les défaites concernent le rappel en contexte long et un test de programmation, où Haiku 5.5 est devant.
Le résumé honnête vient d'Inception elle-même. Interrogé sur la victoire de Haiku à DeepSWE, Kuleshov n'a pas survendu le modèle :
"overall we have found the model to be Haiku- or Luna-level in our own daily usage. That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
C'est le cadre que j'adopterais : une intelligence de classe Luna, une sortie bien plus rapide. Les résultats de partenaires dans l'article de lancement vont dans le même sens. TinyFish affirme que Mercury 3 a réalisé la moitié de 50 tâches de navigation web réelles de Mind2Web, "significantly more than GPT-6.1-Sol", et Octen a mesuré un temps de génération médian de 0.9 seconde dans ses tests de recherche pour lunettes connectées.
Quelle est la vitesse de Mercury 3 en pratique ?
C'est la partie que la plupart des articles sur le lancement passent sous silence. Le chiffre de 1,068 est la mesure d'Inception sur son propre matériel NVIDIA. Le seul chiffre indépendant que j'ai trouvé vient d'OpenRouter, qui n'a qu'un seul fournisseur pour Mercury 3 (Inception elle-même) et publie le débit en direct.
Quand j'ai vérifié le 20 octobre 2026, OpenRouter affichait une médiane de 160 tokens par seconde, et une seconde capture plus tard le même jour montrait 254. Sa moyenne hebdomadaire de la médiane est de 203, avec une latence médiane d'environ une seconde. C'est toujours plus rapide que les ~130 qu'Inception indique pour Luna, mais c'est environ un cinquième du chiffre d'annonce.
Pourquoi cet écart ? Le débit d'OpenRouter est mesuré sur du trafic réel, à l'effort de raisonnement que choisissent les appelants, sous la charge que supportent les serveurs. L'avantage de vitesse de la diffusion est le plus fort à faible concurrence, le compromis qu'un commentateur a décrit pour le modèle de diffusion expérimental de Google :
"It doesn't benefit from batching to reduce memory bandwidth in the same way that a "standard" autoregressive model does, which ends up meaning that it's great at reducing latency for individual/low-concurrency users and delivers better outcomes on certain tasks but much more expensive per token at scale."
Kuleshov dit que Mercury passe bien à l'échelle avec la taille de lot, et les prix d'Inception suggèrent qu'il peut être servi en volume. Mais Simon Willison, qui a fait son test habituel du pélican, a trouvé la vitesse "a bit disappointing", et appeler directement l'API d'Inception plutôt que de passer par OpenRouter "didn't seem to speed it up."
La vitesse réelle compte-t-elle encore ? Cela dépend du nombre d'appels au modèle enchaînés. Un chatbot qui fait un appel par message remarque à peine 1,068 contre 160. Un agent qui enchaîne 12 appels les ressent tous. Saisissez votre propre tâche dans le calculateur ci-dessous pour voir à partir de quand l'écart de vitesse cesse d'avoir de l'importance.
Modifiez le nombre d'étapes et de tokens par étape pour voir combien d'attente du modèle Mercury 3 économise par tâche, à la vitesse d'Inception et à la médiane mesurée par OpenRouter.
Avec les valeurs par défaut (12 appels de 600 tokens), Mercury 3 termine sa génération en 6.7 secondes à la vitesse d'Inception et en 45 secondes à la médiane d'OpenRouter, contre 55 secondes pour Luna. Même le chiffre le plus lent fait gagner du temps sur les longues chaînes. Avec un seul appel, toute la différence tombe sous la seconde, et c'est pourquoi Mercury 3 est un choix pour les boucles, pas pour les réponses isolées.
Les tarifs de Mercury 3 en un coup d'œil
Inception publie une seule grille tarifaire, identique sur sa propre API et sur OpenRouter. La page des modèles liste toute la famille :
| Modèle | Entrée (catalogue → lancement) | Entrée en cache | Sortie (catalogue → lancement) | Contexte | Idéal pour |
|---|---|---|---|---|---|
| Mercury 3 | $0.20 → $0.10 | $0.02 → $0.01 | $0.70 → $0.35 | 1M | Raisonnement général, agents |
| Mercury Voice | $0.40 → $0.20 | $0.04 → $0.02 | $1.50 → $0.75 | 128K | Agents vocaux, TTFT sous 170 ms |
| Mercury Decide | $0.04 → $0.02 | $0 | $0 (non facturé) | n/d | Classification, notation |
| Mercury Edit 2 | $0.25 | $0.025 | $0.75 | 32K | Autocomplétion de code, prochaine modification |
Tous les prix sont par million de tokens. L'accès se décline en trois formules : Free (100 millions de tokens, tous les modèles), Developer (à l'usage) et Enterprise (limites de débit sur mesure, SLA, tarifs de volume). Inception n'a pas dit quand la remise de lancement se termine.
Comparaison avec les modèles qu'il vise, selon la grille de chaque fournisseur :
| Modèle | Entrée par 1M | Sortie par 1M | Remarque |
|---|---|---|---|
| Mercury 3 (lancement) | $0.10 | $0.35 | 50 % de remise pour l'instant |
| Mercury 3 (catalogue) | $0.20 | $0.70 | Après la remise |
| GPT-6 Luna | $0.10 | $0.50 | API standard d'OpenAI |
| Claude Haiku 5.5 | $0.10 | $0.50 | Prompts jusqu'à 100K tokens ; 5 fois au-delà |
| DeepSeek V4.1 Flash | $0.15 | $0.60 | Heures creuses, sans cache ; double aux heures de pointe |
Au lancement, Mercury 3 est donc le token de sortie le moins cher de ce groupe. Au prix catalogue, c'est le plus cher en sortie. Un commentateur de Hacker News a exprimé l'inquiétude sans détour : "I'm wondering if it'll still be useful once the discount is lifted?" Mon avis : si vous l'achetez pour la vitesse, $0.70 reste bon marché. Si vous l'achetez parce qu'il est bon marché, budgétez au prix catalogue. Mon guide des tarifs de GPT-6 Luna couvre intégralement le côté OpenAI, et les règles des heures de pointe de DeepSeek sont détaillées dans mon article sur les tarifs de V4.1 Flash.
Un autre détail tarifaire à connaître : Mercury 2 et Mercury 2.5 sont fermés aux nouveaux utilisateurs. Les clients existants gardent l'accès jusqu'au 15 novembre 2026, donc si vous utilisez l'un des deux, planifiez dès maintenant la bascule.
Comment accéder à Mercury 3
Vous avez quatre moyens d'y accéder, d'après l'article de lancement :
- Inception API Platform. Inscrivez-vous sur platform.inceptionlabs.ai, créez une clé et obtenez 100 millions de tokens gratuits.
- OpenRouter. Même prix, acheminé vers Inception, pratique si vous facturez déjà via OpenRouter.
- Baseten. Listé dans la bibliothèque de modèles de Baseten, mais il faut contacter Baseten pour y accéder. Mon avis sur Baseten couvre la plateforme.
- Vercel. Inception cite aussi Vercel comme partenaire de lancement.
L'API est compatible OpenAI, donc basculer consiste surtout à changer une URL de base et un nom de modèle. Voici l'appel tiré de la documentation d'Inception :
curl https://api.inceptionlabs.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $INCEPTION_API_KEY" \
  -d '{
    "model": "mercury-3",
    "messages": [{"role": "user", "content": "What is a diffusion model?"}],
    "reasoning_effort": "medium",
    "max_completion_tokens": 8192
  }'
La documentation d'intégrations d'Inception couvre les outils de programmation (Cursor, Kilo Code, OpenCode), des frameworks comme LangChain et des plateformes vocales comme ElevenLabs et Vapi.
Pour la programmation, le conseil de Kuleshov lui-même est de l'utiliser comme assistant, pas comme chef de file. Un modèle rapide convient aux sous-agents Claude Code et aux tâches annexes pendant qu'un modèle plus gros mène le travail principal.
Ce que disent les premiers utilisateurs
Le fil de lancement sur Hacker News a recueilli 85 commentaires dès le premier jour. L'ambiance était impressionnée mais sceptique sur l'affirmation de vitesse.
Les avis positifs venaient de gens qui l'ont essayé sur du vrai travail :
"If their benchmarks are to be believed they've made some real progress. [...] EDIT: just trying this out on a repo and it's actually pretty good so far. Pleasantly surprised."
La plainte la plus courante concernait l'attente avant le premier token, qu'un chiffre en tokens par seconde ne reflète pas :
"Hmm at least in Openrouter, deepseek v4.1 flash via together/baseten/fireworks still beat mercury 3 on latency and intelligence Ttft is quite slow with mercury"
Un autre testeur a constaté la même chose mais a quand même aimé le prix : "the issue with speed seems to be that ttft is still high," a-t-il écrit, ajoutant que c'"was as cheap as deepseek for a few tasks I tried." Et un commentateur a remis en cause l'économie : "Pricing can always be set at a loss, however, particularly for a private company." C'est une question légitime, sans réponse publique pour l'instant.
Où Mercury 3 est en retrait
- Pas encore de benchmarks indépendants. Chaque score vient d'Inception, à effort moyen uniquement.
- La vitesse réelle est inférieure au chiffre d'annonce. La médiane d'OpenRouter était de 160 à 254 tokens par seconde la semaine du lancement, et les testeurs signalent un premier token lent.
- Texte uniquement. Pas d'entrée image ou audio. Inception dit avoir des prototypes multimodaux internes, ouverts aux premiers testeurs par e-mail.
- Poids fermés, taille non communiquée. Vous ne pouvez ni l'auto-héberger ni l'inspecter.
- Derrière Haiku 5.5 sur deux tests. Rappel en contexte long (MRCR v2) et programmation DeepSWE, donc testez-le sur de longs documents avant de lui faire confiance là-dessus.
- Le prix est une promotion. La sortie au prix catalogue coûte $0.70, le double du tarif de lancement, sans date de fin annoncée.
- La sortie structurée n'est pas parfaite. OpenRouter affiche un taux d'erreur de sortie structurée de 2.78 % sur son trafic, gardez donc une vérification de schéma dans votre pipeline.
Mercury 3 est-il bon pour le support client ?
Le support est l'un des quatre usages en production qu'Inception cite au lancement, et le plus grand écart de benchmark pour le travail de support est τ³-bench Banking, qui simule un agent gérant des clients de banque : 30.24 pour Mercury 3 contre 23.00 pour Luna et 13.06 pour Haiku 5.5. Lorikeet, un éditeur d'IA de support, a dit à Inception que lors des premiers tests "Mercury 3 beat other models on latency while also performing higher on evals and in production." Si vous comparez des éditeurs de support, mon article sur les alternatives à Lorikeet couvre ce marché.
La vitesse compte surtout sur les canaux en direct. Sur le chat de site web et les agents vocaux, un client regarde les points de saisie ou écoute le silence. Sur les tickets par e-mail, quelques secondes ne changent rien. C'est là que vise Mercury Voice, avec un temps jusqu'au premier token sous 170 millisecondes, et il mérite un coup d'œil à côté des outils de mon comparatif des meilleurs agents vocaux IA.
Mais une réponse rapide et fausse reste une réponse fausse. Ce qu'eesel a appris en faisant tourner l'IA sur de vraies files, c'est qu'on ne peut faire confiance à aucun modèle sur une file en direct avant de l'avoir vu traiter vos propres tickets passés. Un score de 30 au benchmark bancaire signifie aussi qu'il a échoué à la plupart de ces tâches, donc le modèle a besoin de garde-fous, d'escalade et de tests autour de lui. Mon guide de la prévention des hallucinations de l'IA couvre ces garde-fous, et la classification de tickets par IA est un premier travail à faible risque pour un modèle rapide et économique comme celui-ci.
Qui devrait utiliser Mercury 3 ?
Voici comment je déciderais :
- Les concepteurs d'agents avec de longues chaînes d'appels. Agents de navigation, agents de recherche, sous-agents de programmation. C'est là que la vitesse se cumule et que les résultats de partenaires d'Inception sont les plus solides. Essayez-le en premier.
- Les équipes voix et chat en temps réel. Regardez Mercury Voice pour la latence du premier token, et testez Mercury 3 pour les étapes de raisonnement derrière. Comparez avec Retell AI si vous voulez une pile vocale complète.
- Les équipes qui paient Luna ou Haiku sur des appels à fort volume et faible enjeu. Au prix de lancement, il est moins cher en sortie et plus rapide. Refaites le calcul au prix catalogue avant de vous engager.
- Quiconque a besoin de vision, de poids ou de rappel sur de longs documents. Attendez, ou choisissez un autre modèle. Gemini 3.8 Flash gère les images, et DeepSeek V4.1 Flash a des poids ouverts.
- Les équipes dont le goulot d'étranglement n'est pas le modèle. Si une seule réponse prend une seconde de toute façon, la vitesse ne changera pas vos chiffres. Regardez d'abord votre configuration d'API d'agent IA ou la recherche d'information.
Si vous cartographiez encore le terrain, mon panorama des meilleurs agents IA et le guide du meilleur modèle pour les tickets de support sont de bonnes lectures suivantes.
Essayer eesel
Mercury 3 est de l'infrastructure : un modèle rapide, une API et une facture au token. Pour le mettre sur votre file de support, il vous faudrait encore construire la connexion au helpdesk, la recherche sur votre centre d'aide, les règles d'escalade et le banc de test. eesel est l'employé. Son coéquipier IA pour le helpdesk rejoint la file que vous gérez déjà, apprend de vos tickets et documents passés, et vous pouvez le rejouer sur vos conversations historiques avant qu'il ne réponde à un seul client.
SamCart est un bon exemple de rencontre entre vitesse et canaux. L'entreprise fait tourner un agent eesel sur les tickets Freshdesk et un autre, distinct, dans la bulle de chat de son site web, chacun avec son propre message d'accueil et son propre ton, tous deux répondant à partir d'environ 280 articles du centre d'aide. L'agent de tickets ne répond que jusqu'à ce qu'un coéquipier prenne le ticket, et un vendeur qui demande une personne met fin à son rôle.
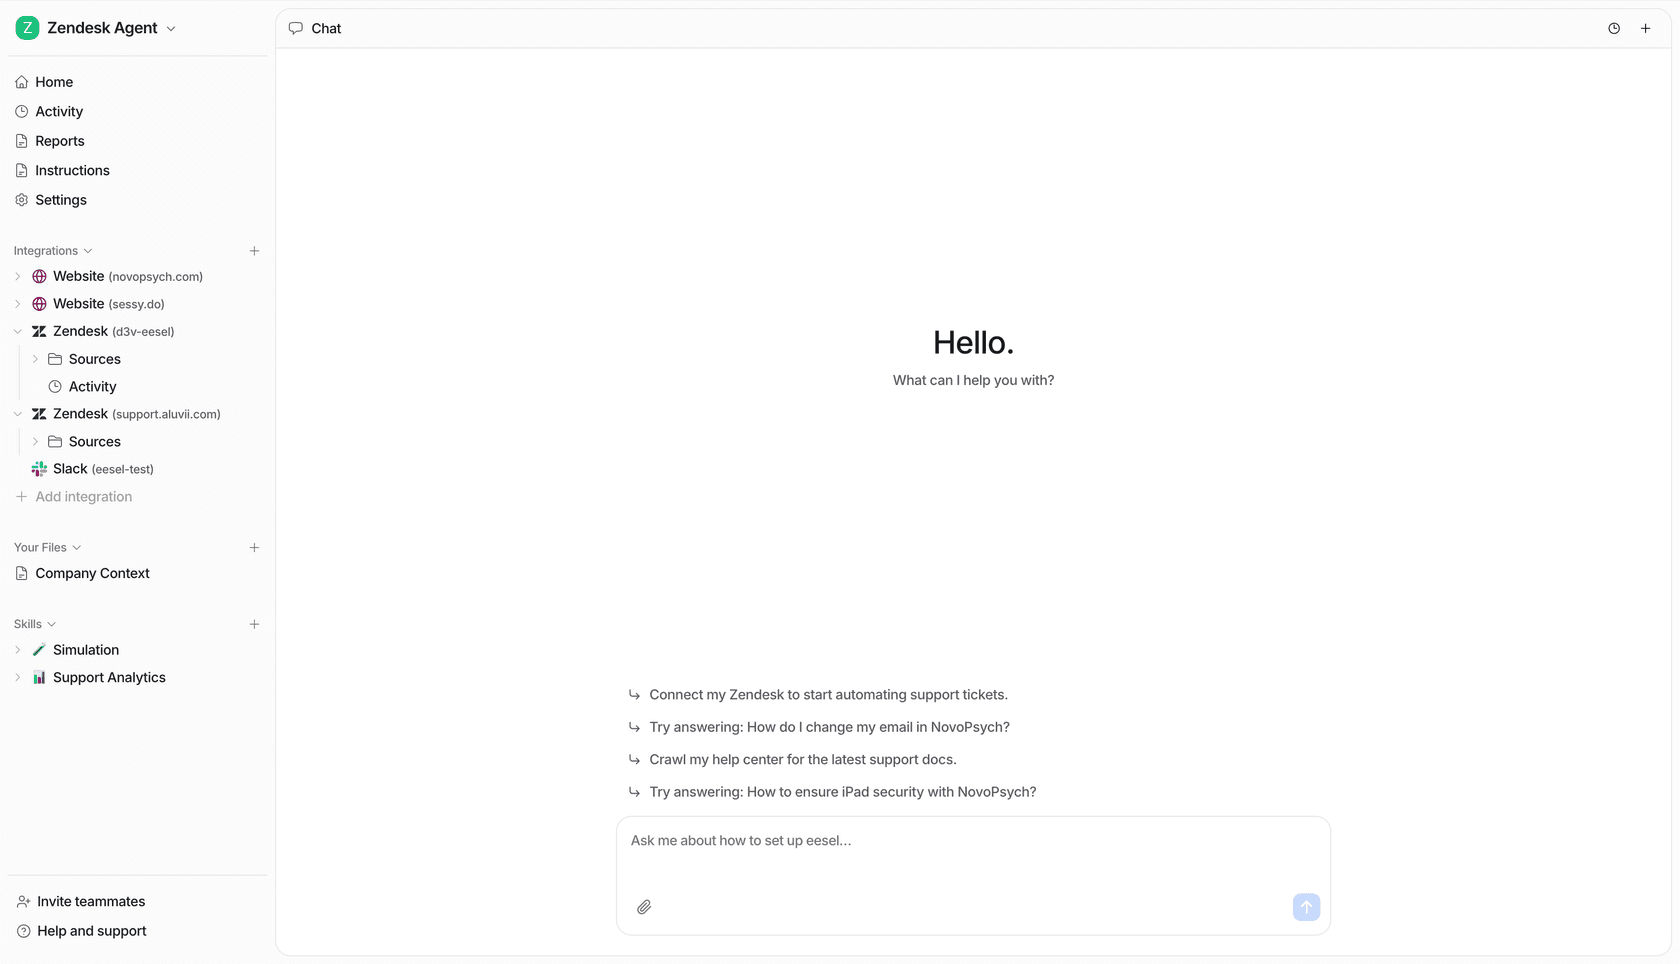
Si vous êtes du genre à tester de nouveaux modèles depuis un terminal, la CLI eesel pilote le même coéquipier. eesel init chat-bubble --site https://your-site.com configure un agent de chat web qui lit vos pages, eesel instructions modifie ses règles permanentes, et eesel approvals liste les actions en attente d'un humain. Chaque commande affiche du JSON, donc un agent de programmation comme Claude Code peut exécuter la configuration pour vous. Plus de détails dans mon guide de la CLI d'agent IA.
Les formules démarrent à $299 par mois pour 500 crédits, où un ticket ou un chat vaut un crédit, et l'essai gratuit offre 100 crédits sans carte. Essayez eesel sur les tickets du mois dernier, ou consultez d'abord la page des tarifs. Si vous rédigez du contenu plutôt que de répondre à des tickets, l'équipe compte aussi un rédacteur de blog IA.
Comment utiliser Mercury 3 avec Cursor ou LangChain ?