

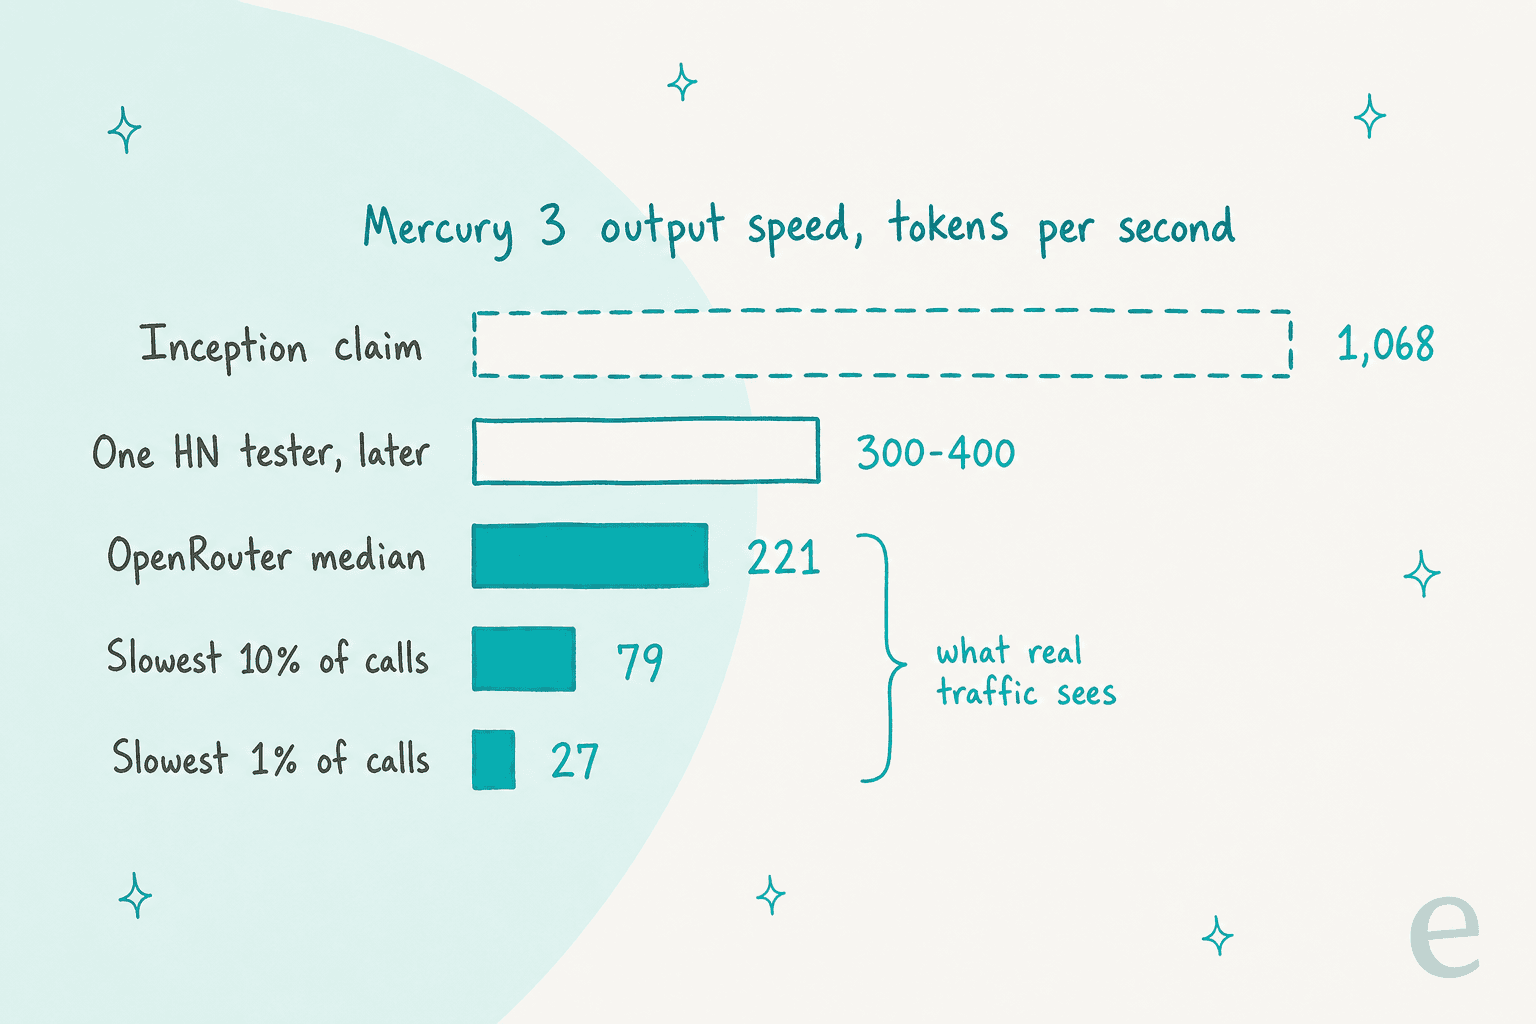
Mon verdict : 3,7 sur 5. Mercury 3 est le meilleur argument à ce jour qu'un modèle de langage à diffusion peut être intelligent en plus d'être rapide. Dans le tableau d'Inception lui-même, il bat GPT-6 Luna et Claude Haiku 5.5 sur 10 benchmarks sur 12, et sur le trafic en direct d'OpenRouter il tourne à une médiane de 221 tokens par seconde, plus vite que les deux rivaux mais à un cinquième des 1 068 annoncés par Inception.
Ce qui freine la note : les 10 % de requêtes réelles les plus lentes rampent à 79 tokens par seconde ou moins, tous les benchmarks ont été exécutés à effort moyen alors que l'API utilise low par défaut, il n'existe pas encore de classement indépendant, et il n'accepte que du texte avec un plancher de température de 0,5. Au lancement, il coûte 0,10 $ en entrée et 0,35 $ en sortie par million de tokens ; budgétez au tarif public de 0,20 $ / 0,70 $.
Pour qui : les développeurs d'agents avec de longues chaînes d'appels au modèle, les agents de recherche et de navigation, et les sous-agents de code. Qui devrait attendre : ceux qui ont besoin d'images, de poids ouverts, de sorties déterministes ou d'un rappel prouvé sur de longs documents. Pour les équipes de support, c'est un moteur solide, mais ce n'est qu'un moteur. Le coéquipier IA pour le helpdesk d'eesel est l'employé qui transforme un modèle en tickets traités, comme Lesson Pro lui fait annoter et rédiger environ 1 900 tickets Zendesk par mois.
Comment j'ai testé Mercury 3
Je construis des fonctionnalités et des agents IA chez eesel, donc je lis le lancement d'un modèle autrement qu'un tableau de benchmarks. Ce qui m'intéresse, ce sont les jointures : ce que l'API fait par défaut, comment la sortie est diffusée, ce qui se passe sur les requêtes lentes, et où un agent casse quand le modèle est le maillon faible. eesel fait tourner de l'IA sur de vraies files de support depuis des années, et l'habitude qui est restée, c'est que aucun modèle n'approche un client avant d'avoir rejoué de vrais tickets passés. Les chiffres de laboratoire ne nous ont jamais dit si quelque chose fonctionne.
Cet avis repose donc sur quatre sources. L'article de lancement d'Inception et sa documentation d'API. La page de performance d'OpenRouter, qui publie des percentiles sur du trafic réel. Le fil de lancement sur Hacker News, où des gens l'ont testé sur leur propre travail en quelques heures. Et l'application de chat d'Inception, qui montre le processus de diffusion à l'écran.
Si vous voulez d'abord les bases du lancement (spécifications, tableau complet des benchmarks, voies d'accès), commencez par mon aperçu de Mercury 3. Si seul le coût vous intéresse, la décomposition des tarifs de Mercury 3 de Rama le chiffre par tâche. Cet article est le verdict.
Fiche de notation de Mercury 3
Voici comment je l'ai noté, et pourquoi.
| Catégorie | Note | Pourquoi |
|---|---|---|
| Vitesse réelle | 4,0 / 5 | La médiane de 221 tok/s sur OpenRouter bat Luna et Haiku, mais la queue est lente |
| Qualité pour sa catégorie | 4,0 / 5 | En tête sur 10 des 12 benchmarks du constructeur, au niveau de Luna ou Haiku au quotidien |
| Prix | 3,5 / 5 | La sortie la moins chère de sa catégorie au lancement, la plus chère au tarif public |
| Fiabilité | 3,5 / 5 | 0,58 % d'erreurs d'appel d'outil, 2,51 % d'erreurs de sortie structurée sur OpenRouter |
| Maturité et ouverture | 3,5 / 5 | Pas de benchmarks indépendants, texte uniquement, poids fermés, taille non divulguée |
| Global | 3,7 / 5 | Un vrai pas pour les LLM à diffusion, à utiliser de préférence comme modèle auxiliaire rapide |
La note monterait vite si deux choses se produisent : un classement indépendant comme Artificial Analysis confirme le tableau de benchmarks, et la queue lente d'OpenRouter se resserre à mesure qu'Inception ajoute de la capacité. Ni l'un ni l'autre n'est vrai le jour du lancement.
Ce que la diffusion change en pratique
Presque tous les modèles que vous avez utilisés, de GPT-6.1 Sol à DeepSeek V4.1 Flash, écrivent un token à la fois, de gauche à droite. Mercury 3 rédige toute la réponse sous forme de texte bruité et l'affine en quelques passes. Mon explication des modèles de diffusion couvre la théorie. Pour un avis, ce qui compte, c'est l'effet sur votre code et vos utilisateurs.
Le texte arrive par blocs, pas par tokens
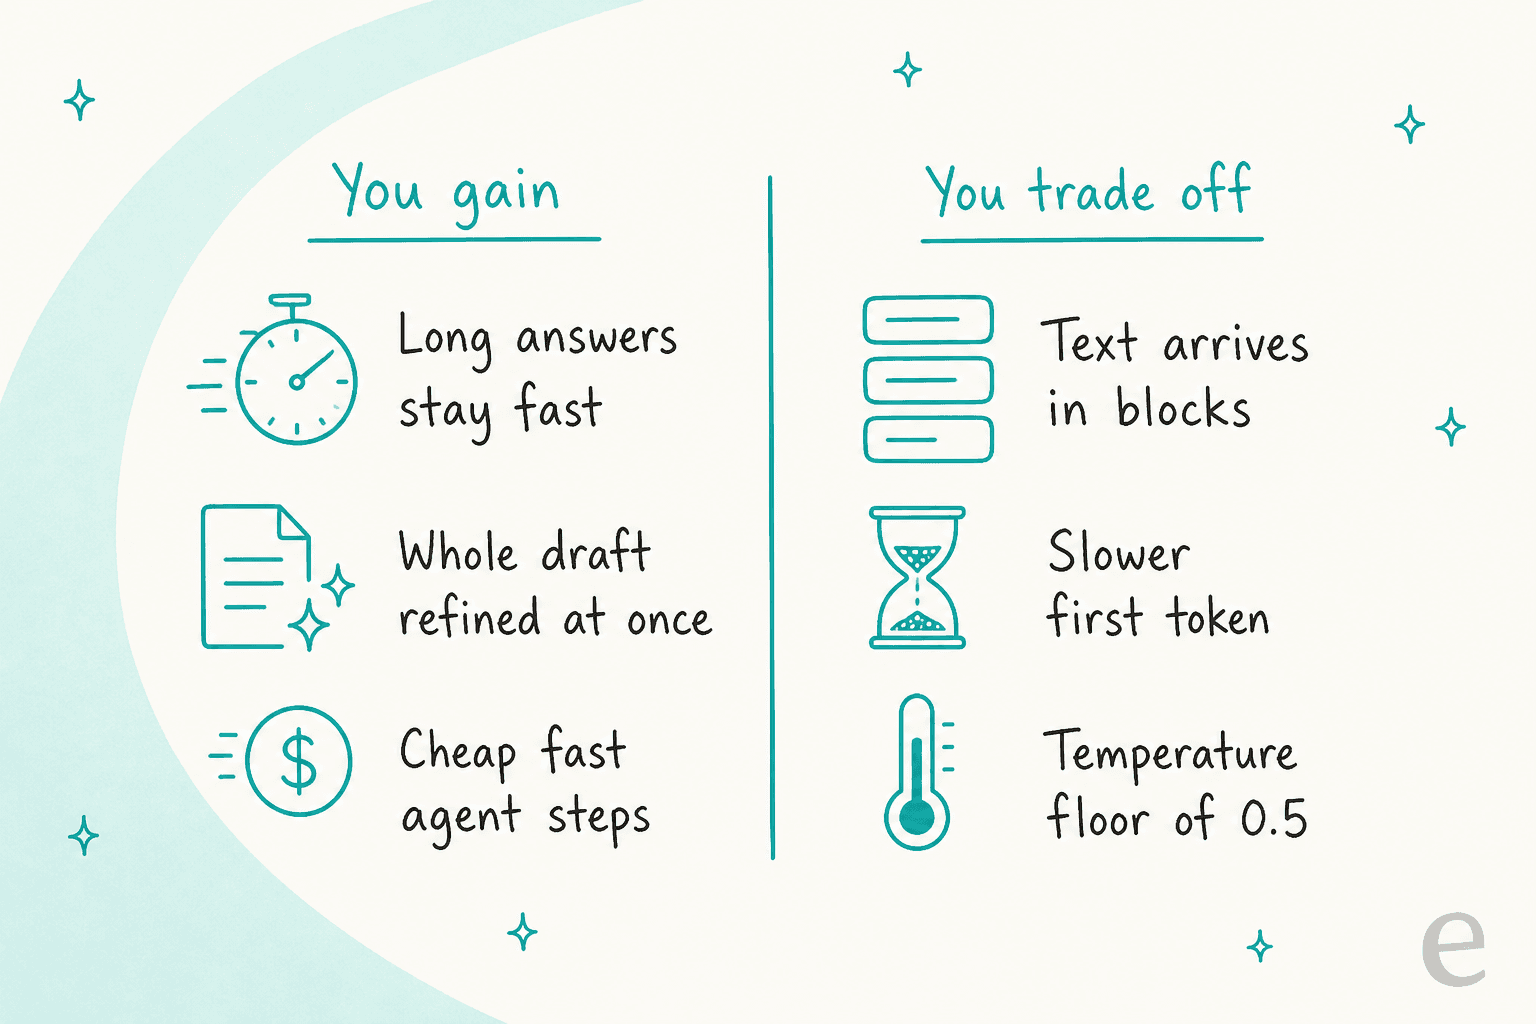
La documentation de streaming d'Inception indique que les réponses sont diffusées "block-by-block", un bloc étant un morceau de texte affiné, pas un seul token. Dans une fenêtre de chat, cela ne ressemble pas au filet de mots habituel : rien, puis une phrase, puis la suivante. Il existe aussi un mode optionnel diffusing où chaque morceau est la réponse complète jusque-là, si bien que votre interface doit écraser le texte à chaque étape au lieu d'y ajouter. C'est une belle démo et un bug facile si votre front end suppose qu'on ajoute.
C'est aussi ma meilleure hypothèse pour expliquer pourquoi les testeurs de Hacker News mentionnaient sans cesse le temps jusqu'au premier token. L'un a écrit "Ttft is quite slow with mercury" dans le fil de lancement, et un autre testeur a dit "the issue with speed seems to be that ttft is still high." Les tokens par seconde disent à quelle vitesse la réponse se termine, pas à quel moment l'utilisateur voit quelque chose.
Les réponses longues coûtent à peine plus de temps
L'avantage est l'envers de la médaille. Un modèle token par token met deux fois plus de temps pour écrire deux fois plus. Un modèle de diffusion affine tout le bloc en parallèle, donc l'écart se creuse à mesure que les réponses et le raisonnement s'allongent. Le cofondateur d'Inception, Volodymyr Kuleshov, l'a souligné le jour du lancement : plus les modèles de raisonnement réfléchissent longtemps par réponse, plus l'avantage de vitesse grandit. C'est pourquoi le modèle convient mieux aux agents en plusieurs étapes qu'aux réponses d'une ligne.
Les valeurs par défaut ne sont pas le modèle évalué
C'est le détail que je signalerais à toute équipe qui l'essaie. Chaque score du tableau de lancement d'Inception a été obtenu avec un effort de raisonnement medium. Mais la documentation sur l'effort de raisonnement dit que si vous omettez reasoning_effort, mercury-3 utilise low par défaut. Mercury 2 et 2.5 utilisaient medium.
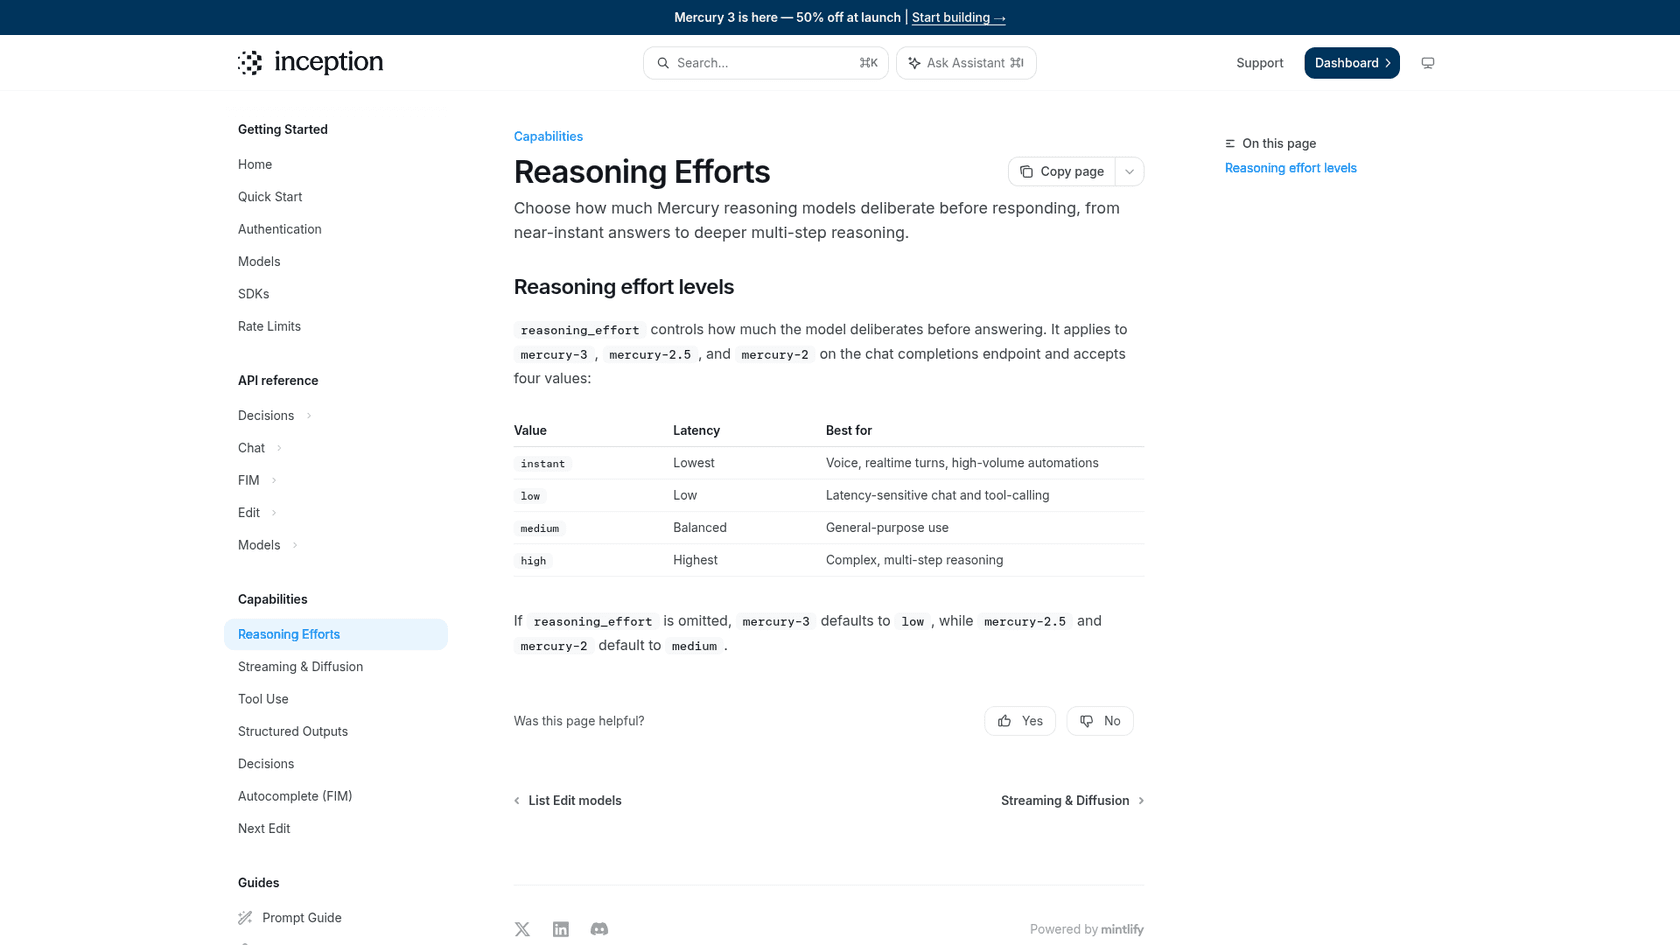
Un test rapide sans effort défini teste donc un réglage plus rapide et plus léger que celui du tableau. C'est un défaut raisonnable pour la vitesse, mais définissez medium explicitement avant de comparer la qualité. Et ne supposez pas que high est meilleur : un testeur a remarqué, dans les dessins de pélicans de Simon Willison, que "the medium pelican is better than the high". C'est un gribouillis, pas un benchmark, mais c'est une bonne raison de tester chaque niveau sur votre propre tâche.
La température commence à 0,5
La documentation des modèles d'Inception indique une température réglable de 0,5 à 1,0 pour Mercury 3. Si votre pipeline fixe la température à 0 pour des sorties reproductibles (classification, extraction, jeux de test), c'est impossible ici. Associez-le plutôt à des sorties structurées et à une vérification de schéma. Pour les tâches d'étiquetage pur, le modèle distinct d'Inception, Mercury Decide, est conçu pour la classification.
Vitesse annoncée contre vitesse mesurée
Le chiffre d'Inception est de 1 068 tokens de sortie par seconde sur GPU NVIDIA. Mon aperçu couvrait l'écart sur la médiane. Ce que je voulais pour cet avis, c'était la dispersion, car l'attente totale d'un agent est fixée par ses appels lents, pas par les moyens.
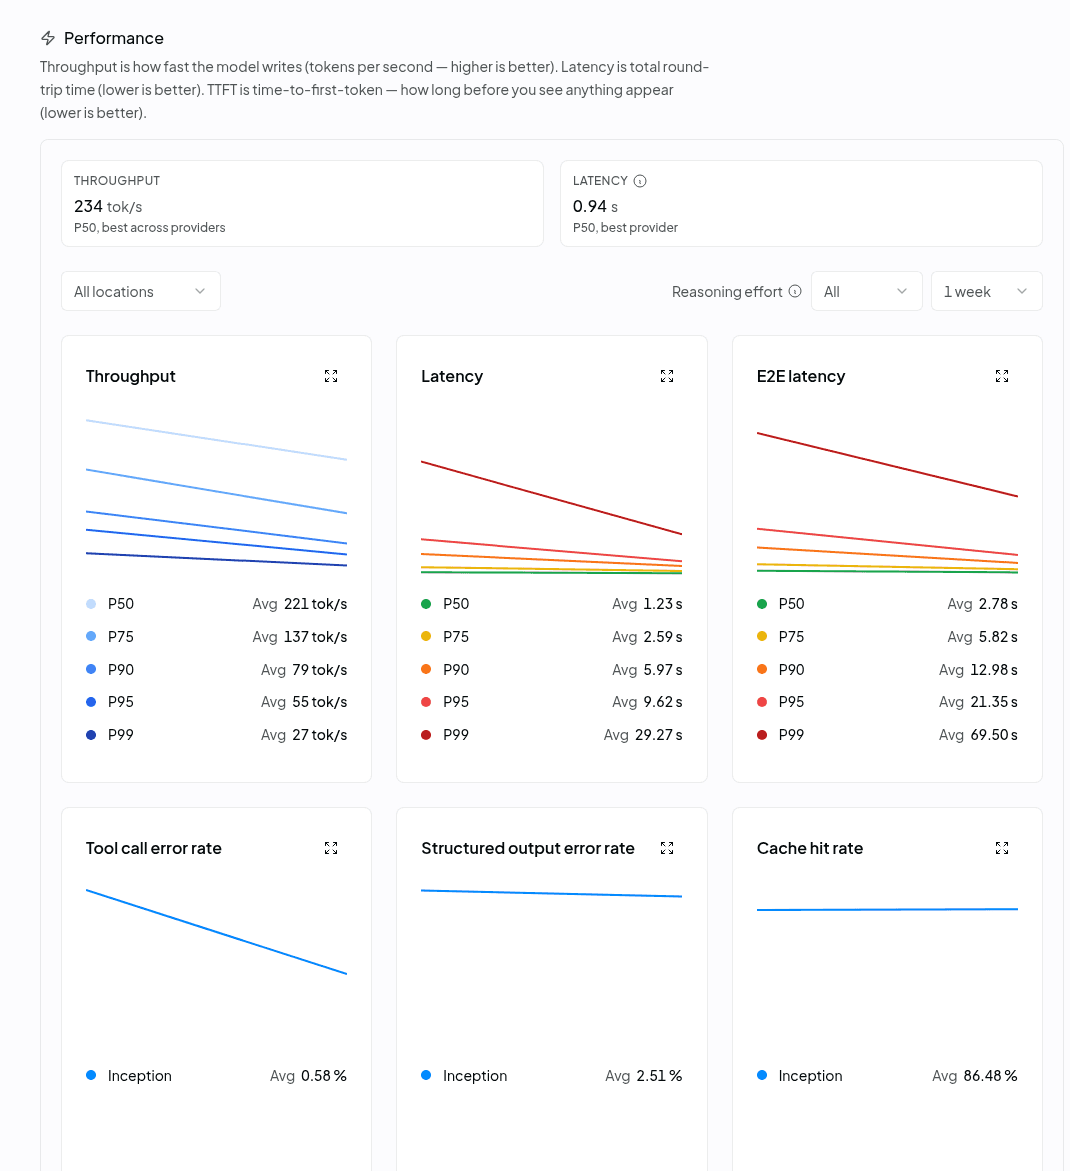
OpenRouter achemine chaque requête Mercury 3 vers Inception et publie des percentiles. Voici ce que sa page de performance montrait le 20 octobre 2026, en moyenne sur une semaine :
| Percentile | Débit | Latence | Bout en bout |
|---|---|---|---|
| P50 | 221 tok/s | 1,23 s | 2,78 s |
| P75 | 137 tok/s | 2,59 s | 5,82 s |
| P90 | 79 tok/s | 5,97 s | 12,98 s |
| P95 | 55 tok/s | 9,62 s | 21,35 s |
| P99 | 27 tok/s | 29,27 s | 69,50 s |
La médiane est bonne. Le tableau d'Inception place GPT-6 Luna à environ 130 tokens par seconde et Haiku 5.5 à environ 240, donc Mercury 3 sur du trafic réel se situe à peu près au niveau de Haiku et bien devant Luna. Le problème, c'est la queue : une requête sur dix tourne à 79 tokens par seconde ou moins, et une sur cent prend plus d'une minute de bout en bout.
Deux réserves gardent cela équitable. OpenRouter mélange tous les niveaux d'effort choisis par ses utilisateurs, et le trafic de la semaine de lancement est irrégulier. Les vitesses s'amélioraient déjà pour certains utilisateurs à la fin du premier jour :
"I've been trialing this for the last few hours. It was quite slow at first, but now I'm getting around 300-400tps. Still nowhere near 1000tps, but it's still incredibly fast compared to what I'm used to with other models."

Simon Willison, lui, a trouvé la vitesse "a bit disappointing" et n'a vu aucun gain en appelant l'API d'Inception directement plutôt que via OpenRouter. Ma lecture : la médiane est réelle et utile aujourd'hui, le chiffre de 1 068 est un meilleur cas sur le matériel d'Inception, et la queue est le chiffre à surveiller le mois prochain. Si vous comparez des options de vitesse pure, mon article sur Groq 3 LPX couvre la voie du matériel plutôt que celle du modèle.
Vérification des benchmarks
Le tableau de lancement est solide. Mercury 3 bat Luna et Haiku 5.5 sur 10 tests sur 12 chacun, et les plus grands écarts concernent le travail d'agent : SWE-Bench Atlas à 51,08 contre 33,33 pour Luna, et τ³-bench Banking à 30,24 contre 23,00 et 13,06. Le tableau complet est dans mon aperçu de Mercury 3, je me concentre donc ici sur le poids qu'il peut porter.
- C'est l'exécution d'Inception. Il n'y a pas encore de page Artificial Analysis pour Mercury 3, et Kuleshov a dit sur Hacker News que les benchmarks tiers et les temps d'exécution des tâches restent à venir.
- Un seul niveau d'effort. Les 12 lignes sont à medium. Un commentateur a demandé pourquoi, notant qu'il n'y a pas de courbe de low à max. On ne sait pas si Luna ou Haiku comblent l'écart à un effort plus élevé.
- Les défaites sont serrées ; certaines victoires sont larges. Il est derrière Luna de peu sur AA-Omniscience (46,44 vs 46,94) et AA-LCR (77,67 vs 78,30), et derrière Haiku 5.5 sur MRCR v2 (75,50 vs 78,40) et DeepSWE (46,31 vs 51,62). Le rappel sur de longs documents est le domaine que je testerais le plus durement.
- Le constat du constructeur est modeste. Kuleshov l'a décrit comme de niveau Haiku ou Luna au quotidien, ce qui me semble le cadrage honnête.
"That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
Les retours pratiques vont dans le même sens. Un développeur a construit avec lui une petite application macOS de bout en bout :
"I made it come up with a plan for this tool and had it implement the thing end to end in about 8 or 9 steps. It originally messed up the coordinate calculation but quickly corrected that when I pointed it out and other than that it one-shotted all the other steps."
Le même testeur a indiqué que le travail avait utilisé 26 millions de tokens, dont 1,3 million hors cache, à environ 160 tokens par seconde. C'est un bon aperçu du réel : un harnais de code renvoie beaucoup de contexte, c'est pourquoi le prix du cache compte autant que le tarif affiché. Un autre testeur a reconstruit un moteur de rendu UML en trois tours et a dit qu'il avait mis à jour le HTML correctement.
Forces et limites
Voici la version équilibrée, dans l'ordre où je les pèserais.
Où il est fort :
- Boucles d'agents. La vitesse se cumule quand une tâche enchaîne une douzaine d'appels au modèle. TinyFish, partenaire de lancement d'Inception, dit avoir terminé la moitié de 50 tâches web en direct de Mind2Web, "significantly more than GPT-6.1-Sol."
- Travail auxiliaire et sous-agents. Compactage de contexte, routage, résumé des sorties d'outils. Avec l'ancien Mercury 2, Augment Code a rapporté une baisse de 82 % de la latence de compactage et de 90 % du coût par rapport à son modèle précédent. C'est Mercury 2, mais Mercury 3 reprend le même argument avec un modèle plus gros.
- Longs contextes à prix fixe. Une fenêtre de 1M de tokens à un seul tarif, là où Haiku 5.5 facture 5 fois plus au-delà de 100K tokens. Mon guide des tarifs de Haiku 5.5 donne les détails.
- Facile à essayer. Il est compatible OpenAI, avec 100 millions de tokens gratuits sur les nouvelles clés et des guides de configuration pour Cursor, LangChain et Vapi.
Où il est limité :
- La queue lente. Débit P90 de 79 tok/s et temps de bout en bout P99 de 69,5 secondes sur la vue d'une semaine d'OpenRouter.
- La sortie structurée n'est pas parfaite. OpenRouter affiche un taux d'erreur de 2,51 % en sortie structurée, gardez donc un validateur dans la boucle.
- Texte uniquement, poids fermés, taille non divulguée. Inception dit que le multimodal est dans des prototypes internes. Pour des poids de diffusion ouverts, l'alternative est DiffusionGemma.
- Le prix après la promo. À 0,70 $ par million de tokens de sortie, le tarif public dépasse les 0,50 $ de Luna et Haiku, et Inception n'a pas annoncé de date de fin pour la remise de 50 %.
- La disponibilité se stabilise encore. La disponibilité sur trois jours d'OpenRouter était de 99,26 %, avec des creux visibles le jour du lancement.
Mercury 3 convient-il à votre charge de travail ?
La décision « changer ou non » se résume surtout à trois questions : combien d'appels s'enchaînent, si une personne attend, et si vous avez besoin de quelque chose que Mercury 3 n'offre pas. Le sélecteur ci-dessous vous guide.
Répondez à trois questions pour voir si Mercury 3 convient à une charge de travail et ce qu'il faut tester avant de changer.
Le principe est simple : plus il y a d'appels à la suite et plus une personne attend, plus Mercury 3 mérite sa place. Pour un seul appel en arrière-plan, la vitesse ne changera rien, et au tarif public Luna ou Haiku sont le choix le moins cher. Ma décomposition des tarifs de GPT-6 Luna donne leur côté du calcul.
Comment Mercury 3 s'intègre à une charge de support
Le support est l'un des quatre usages en production cités par Inception, et le lancement cite Lorikeet, un éditeur d'IA de support, qui dit que Mercury 3 "beat other models on latency while also performing higher on evals and in production." Le benchmark qui se rapproche le plus du support, τ³-bench Banking, est aussi celui où l'avance de Mercury 3 est la plus large.
Mais lisez ce score avec attention. Un 30,24 signifie que le modèle a échoué sur la plupart de ces tâches bancaires simulées, simplement moins souvent que ses rivaux. C'est normal pour des modèles petits et rapides, et c'est la raison pour laquelle un modèle n'est jamais l'agent de support complet. La vitesse aide surtout sur les canaux en direct comme le chat en direct IA et les agents vocaux, où un client regarde l'écran. Sur les tickets par e-mail, un écart de deux secondes ne change rien.
Là où un modèle auxiliaire rapide s'intègre le mieux en support, c'est dans la pile de petites tâches autour de chaque réponse. Pensez au tri des tickets, à l'étiquetage, au résumé de longs fils et à la récupération des détails de commande. C'est le même schéma de sous-agents qu'Inception décrit pour le code. C'est aussi à quoi ressemble un vrai déploiement de support quand on l'ouvre.
Lesson Pro, qui gère des marques de cours particuliers dont GOSKATE, en est un bon exemple. Ses agents eesel travaillent sur deux comptes Zendesk. Sur chaque ticket, l'agent détermine d'abord à quelle marque appartient le client, puis laisse une note interne et rédige une réponse signée de cette marque. Les candidatures, les messages vocaux et les bons de commande sont volontairement ignorés. Entre le 8 août et le 8 septembre 2026, il a traité environ 1 900 tickets, laissé environ 1 700 notes et rédigé environ 560 réponses que l'équipe a pu envoyer. Quand un collègue écrit "@eesel find instructors near this lesson", il cherche dans les tickets passés des villes voisines les moniteurs qui y ont donné des cours.
Rien de cela ne dépend du fait que le modèle derrière écrive à 221 ou à 1 068 tokens par seconde. Cela dépend de la règle de marque, de la liste d'exclusion, des brouillons qui passent d'abord par une personne et des tests. C'est la différence à laquelle je reviens sans cesse : Mercury 3 est une infrastructure ; eesel est l'employé. Si vous choisissez vous-même la couche modèle, mes guides sur le meilleur modèle pour les tickets de support et la prévention des hallucinations de l'IA couvrent les garde-fous, et tester un agent IA couvre l'étape que la plupart des équipes sautent.
Qui devrait utiliser Mercury 3 et qui devrait attendre
Utilisez-le maintenant si vous :
- Construisez des agents avec de longues chaînes d'appels : agents de navigation, agents de recherche, boucles de recherche approfondie. C'est là que sa vitesse se cumule.
- Faites tourner des harnais de code et voulez un assistant rapide. Le conseil de Kuleshov lui-même, ce sont les sous-agents, pas le modèle principal, ce qui convient aux configurations Claude Code ou Cursor où un modèle plus gros planifie.
- Payez Luna ou Haiku pour des appels à fort volume et faible enjeu et pouvez vivre plus tard avec le tarif public. Testez à effort medium avant de remplacer.
Attendez ou choisissez autre chose si vous :
- Avez besoin d'entrée d'images, de poids ouverts ou de température 0. Gemini 3.8 Flash gère les images, et les petits modèles de langage couvrent l'auto-hébergement.
- Comptez sur un rappel exact sur de longs documents. Faites d'abord votre propre évaluation.
- Faites un appel au modèle par requête sans que personne n'attende. La vitesse ne changera pas vos chiffres, choisissez donc selon la qualité et le prix.
- Avez besoin d'une latence garantie. Tant que P90 et P99 ne se resserrent pas, gardez un modèle de secours ou un délai d'expiration autour.
Si vous cartographiez encore les options, mon panorama des meilleurs agents IA et l'avis sur Claude Haiku 5.5 sont les lectures suivantes naturelles.
Essayer eesel
Un modèle rapide vous donne un token rapide. Il ne vous donne ni connexion Zendesk, ni règle de marque, ni liste de tickets à ignorer, ni moyen de rejouer les conversations du mois dernier avant que quoi que ce soit ne passe en production. Le coéquipier IA pour le helpdesk d'eesel arrive avec tout cela. Il rejoint votre Zendesk ou un autre helpdesk existant, lit votre centre d'aide, vos macros et vos anciens tickets, et s'exécute sur les déclencheurs que vous activez, comme une mention @eesel dans une note interne.
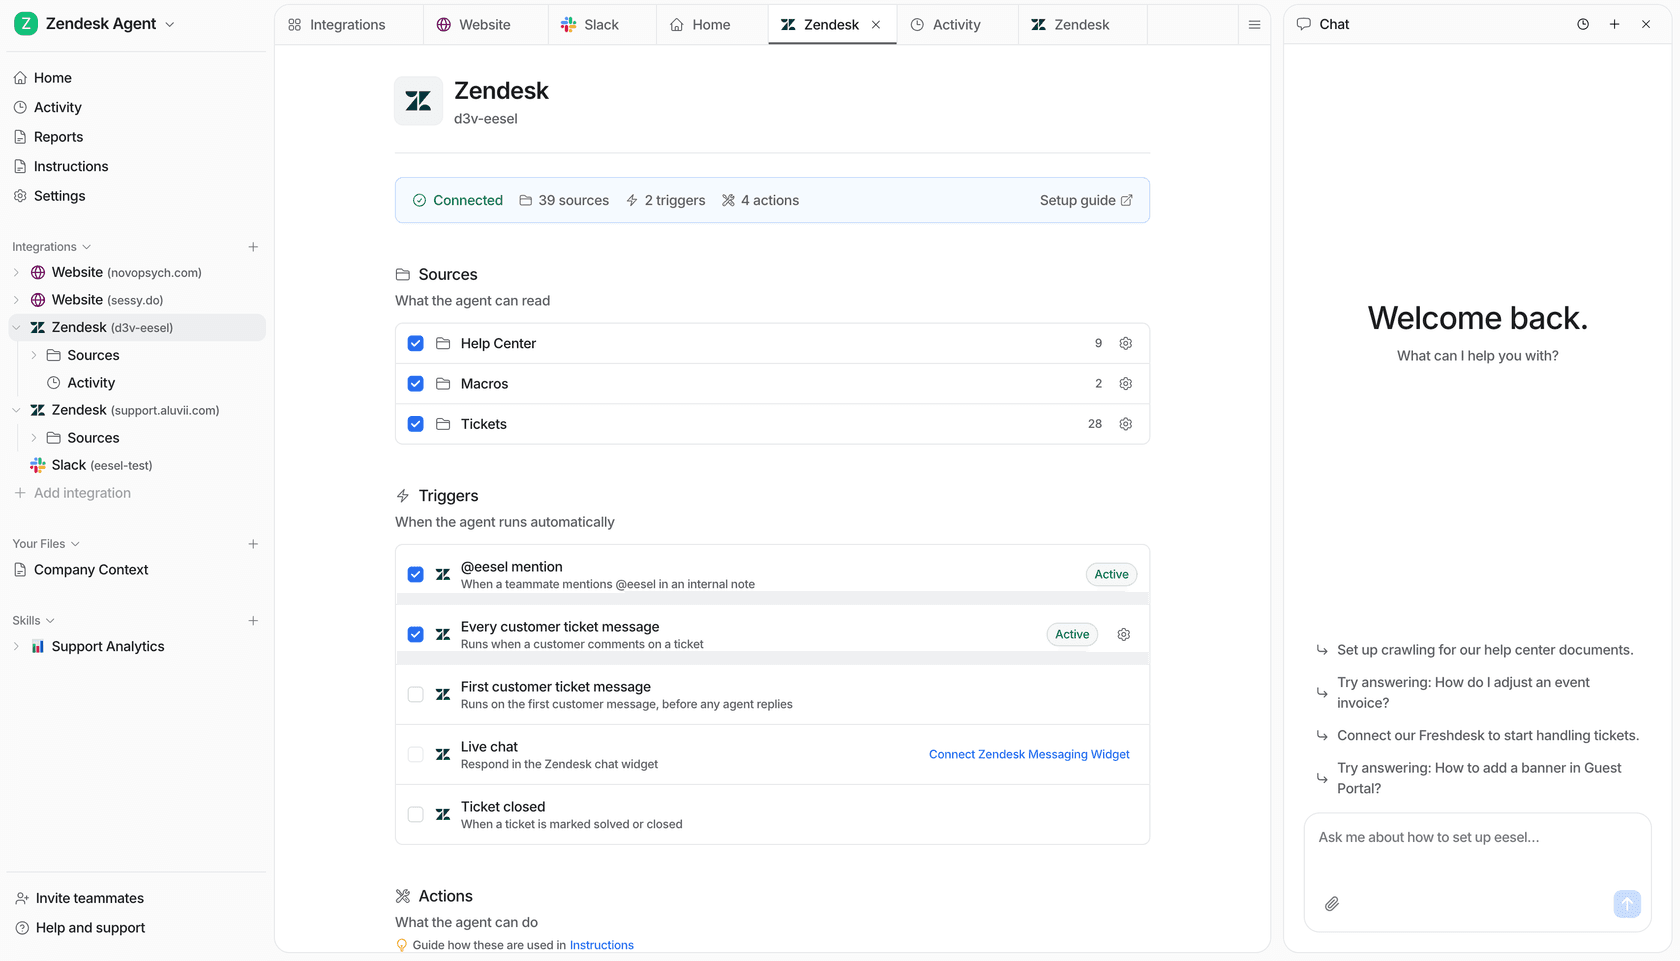
Si vous testez des modèles depuis un terminal, vous apprécierez la CLI eesel. Elle pilote le même coéquipier que le tableau de bord : eesel integrations connect zendesk lance la connexion au helpdesk, eesel automations liste et active ce que l'agent fait seul, et eesel chat "how do I reset a password?" lui pose une question et diffuse la réponse. Chaque commande affiche du JSON, un agent de code peut donc exécuter la configuration pour vous. Mon guide de la CLI d'agent IA va plus loin.
Les forfaits commencent à 299 $ par mois pour 500 crédits, et l'essai gratuit inclut 100 crédits sans carte. Essayez eesel sur vos propres tickets passés, ou consultez d'abord la page des tarifs. Si votre besoin concerne le contenu plutôt que les tickets, l'équipe compte aussi un rédacteur de blog IA.