

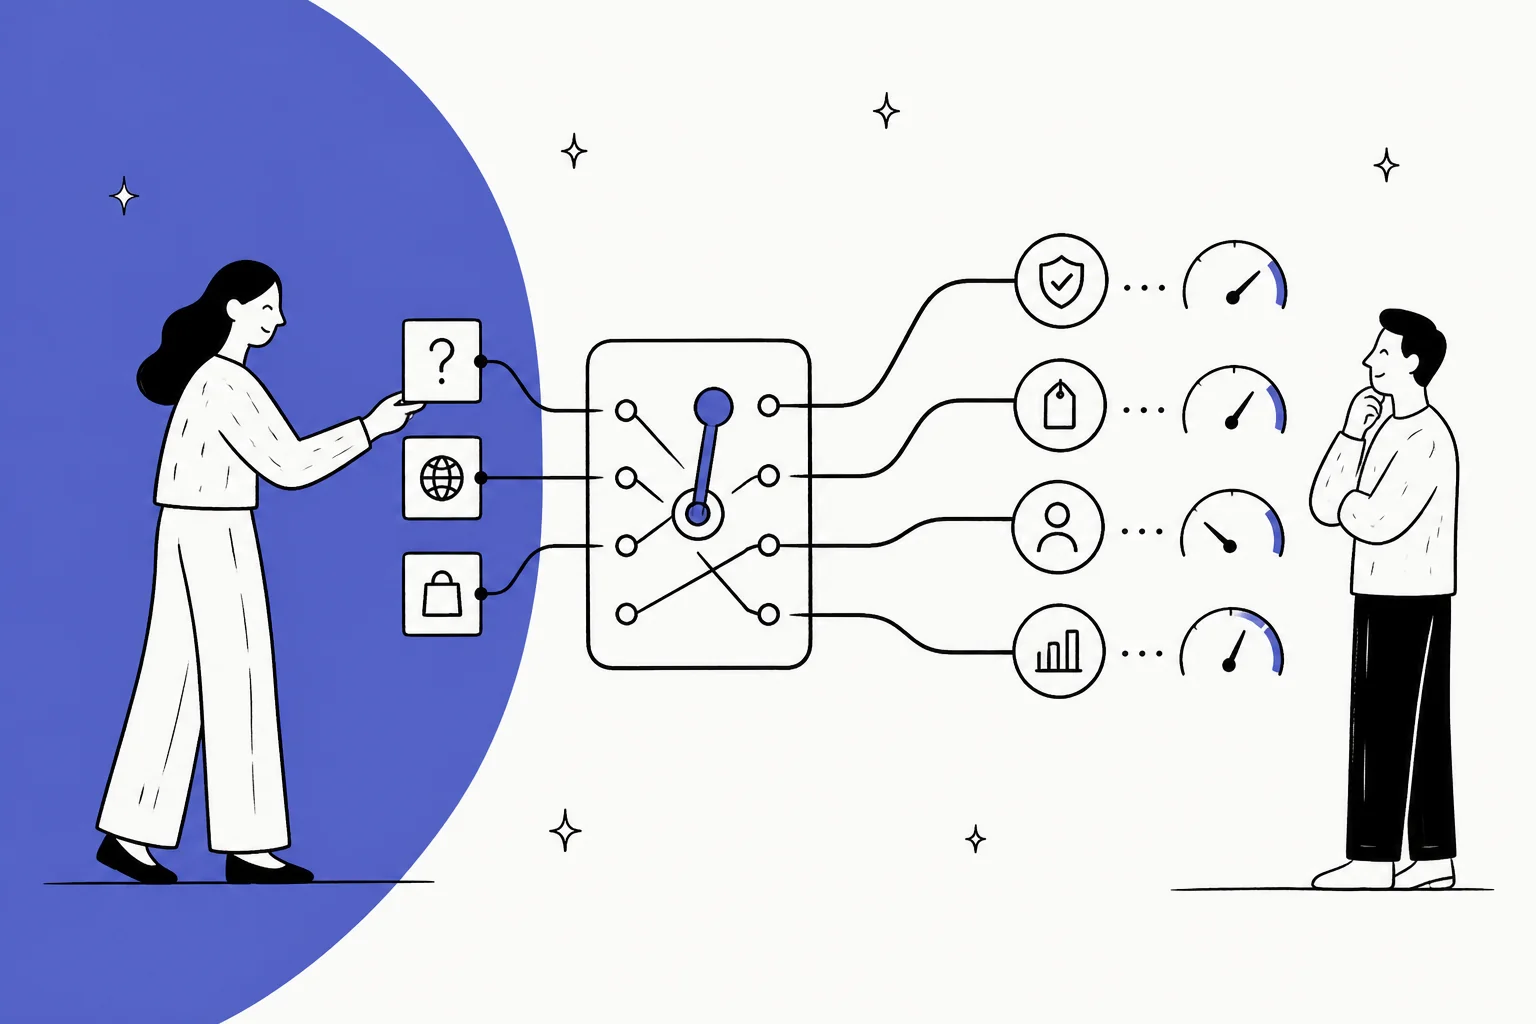
Qu'est-ce qu'un modèle de décision ?
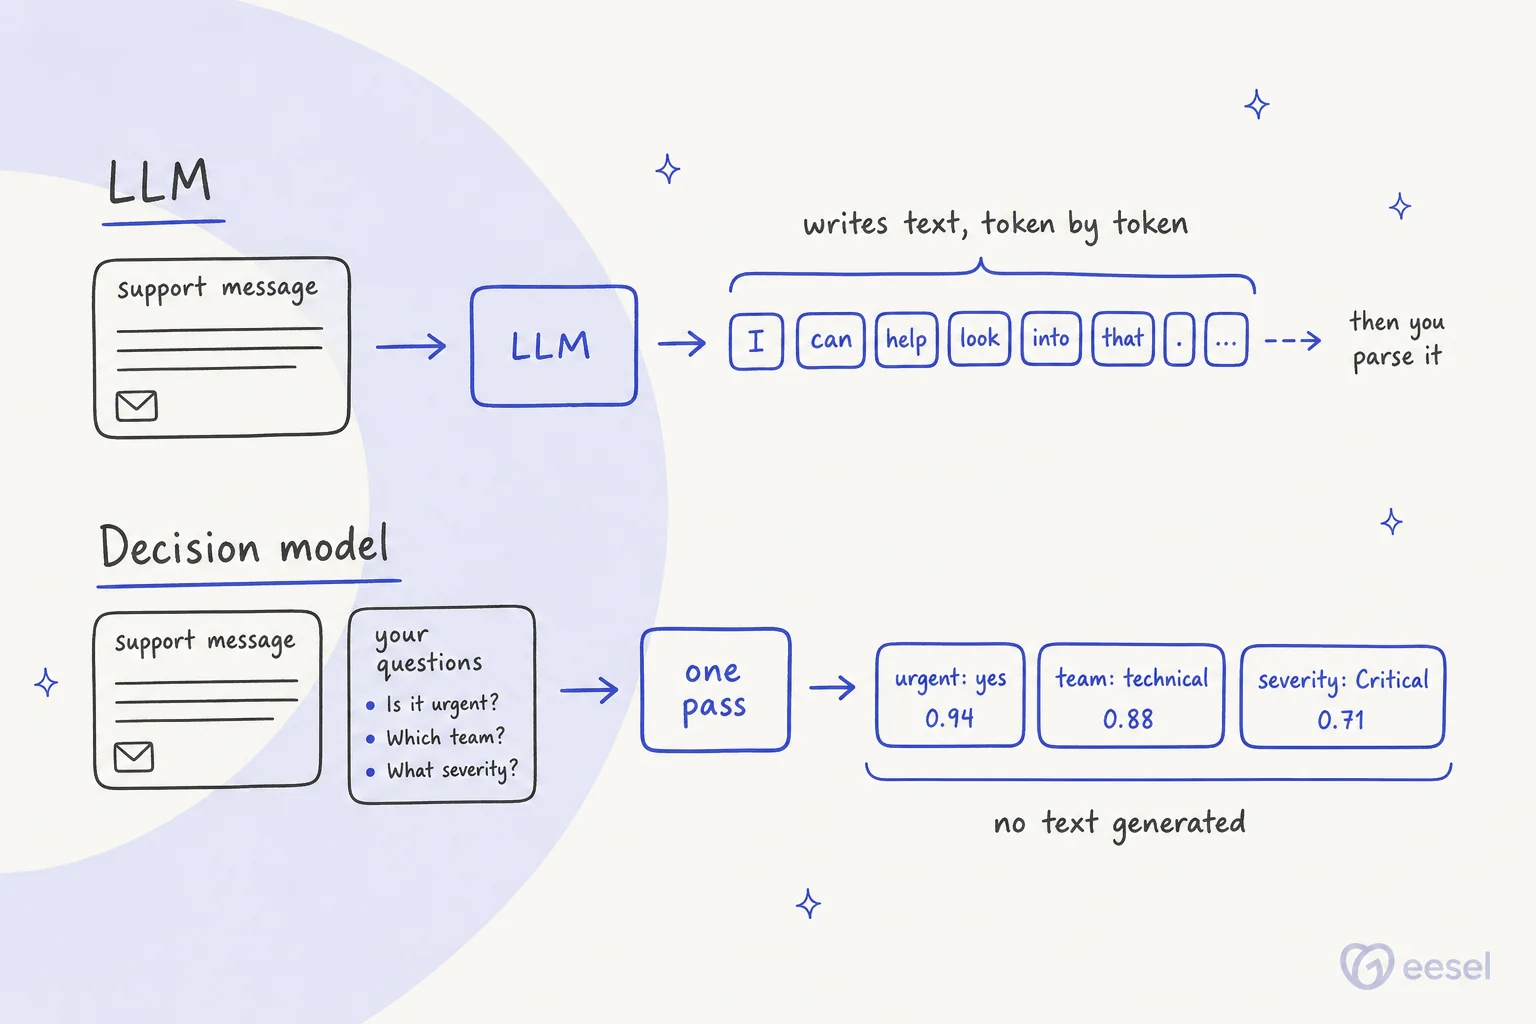
Un modèle de décision prend deux choses : un état (l'entrée brute, comme un e-mail de support, un bloc JSON ou une capture d'écran) et un ensemble de questions typées sur cet état. Il renvoie une réponse typée par question, chacune avec une probabilité. Pas de paragraphe, pas de JSON à analyser, pas de « Bien sûr ! Voici mon analyse. »
La documentation de TypeSafe décrit bien le problème résolu : quand vous demandez à un LLM un jugement que votre code va consommer, « vous forcez un système de génération de texte à produire des décisions structurées, puis vous analysez les résultats en retour ». Un modèle de décision évite complètement le texte.
Presque tous les modèles de la catégorie se sont fixés sur les trois mêmes types de questions, que TypeSafe appelle des primitives :
| Type de question | Ce qu'elle demande | Ce qui revient | Exemple en support |
|---|---|---|---|
| Noul | Cette affirmation est-elle vraie ? | Une probabilité, de 0 à 1 | « Cette demande est-elle urgente ? » |
| Choice | Quelle option convient ? | Le choix, une probabilité par option, une confiance | « Facturation, technique ou ventes ? » |
| Score | Où se situe-t-on sur cette échelle ? | Un niveau, une probabilité par niveau, une confiance | « Aucun impact, mineur, majeur ou critique ? » |
Vous pouvez mélanger les trois dans une même requête, et chaque question est évaluée en parallèle sur le même état. TypeSafe indique qu'« ajouter des questions modifie à peine le temps de réponse », et le README de Strands Decider dit la même chose : le texte est lu une seule fois et « chaque question n'ajoute que ses propres tokens ».
Voici ce que cela donne en pratique, avec l'exemple de lancement de Cloudflare. Un seul appel pose trois questions sur un même message de support :
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/cloudflare/clef \
  -X POST \
  -H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN" \
  -d '{
    "model": "clef",
    "state": "Checkout has been failing for every customer for the last hour.",
    "questions": {
      "urgent": { "type": "noul", "instructions": "Is this support request urgent?" },
      "team": {
        "type": "choice",
        "instructions": "Which team should handle this request?",
        "criteria": {
          "billing": "Payments, invoices, and refunds",
          "technical": "Outages, errors, and configuration",
          "sales": "Plans and upgrades"
        }
      },
      "severity": {
        "type": "score",
        "instructions": "How severe is the customer impact?",
        "criteria": ["No impact", "Minor", "Major", "Critical"]
      }
    }
  }'
Si vous avez déjà fait du tri de tickets à la main, cette requête vous sera familière. Ce sont l'urgence, l'équipe et la gravité, les trois mêmes champs qu'un trieur humain remplit, et la même répartition que celle qui sous-tend l'urgence et l'impact dans la plupart des helpdesks.
Comment un modèle de décision fonctionne-t-il en interne ?
C'est la partie que je trouve la plus intéressante, car l'astuce est plus simple que ne le laisse croire le marketing.
La plupart des modèles de décision ouverts partent d'un LLM ouvert ordinaire (souvent une base Qwen ou Gemma) et changent la manière dont il répond. L'article de lancement de Cloudflare décrit Clef comme exécutant « une passe de prefill seulement, puis une notation en parallèle des choix valides du schéma ». Strands a retiré entièrement la tête du modèle de langage : Strands Decider 2B ne peut donc physiquement pas générer de texte, et son blog de lancement indique que la tête de notation ajoutée compte « un peu plus d'un million de paramètres au total ».
Concrètement, trois choses se passent :
- Le modèle lit l'état et les questions une fois. C'est l'étape de « prefill » que tout LLM exécute avant d'écrire. Les modèles de décision s'arrêtent là.
- Une petite tête note chaque réponse autorisée. Au lieu de générer « technical » lettre par lettre, elle note facturation, technique et ventes par rapport à ce qu'elle vient de lire, le tout en une fois.
- Les scores sont entraînés pour être honnêtes. TypeSafe appelle sa méthode d'entraînement Reinforcement Learning for Calibrated Decisions (RLCD). Cloudflare a conçu sa propre version du RLCD pour Clef et l'associe à une perte de Brier, une pénalité standard pour les probabilités trop sûres d'elles (Cloudflare).
Cette troisième étape est le vrai produit. Une confiance de 0.9 n'est utile que si les réponses à 0.9 sont justes environ 90% du temps. Strands rapporte que, sur des tâches de classification courtes inédites, « les réponses avec une confiance de 0.9 ou plus sont justes environ 95% du temps ». C'est pourquoi les modèles de décision sont présentés comme adaptés à la priorisation des tickets et aux autres décisions pour lesquelles on veut un seuil sûr. C'est cette propriété qui permet d'écrire if confidence > 0.9: auto-route, else: send to a human.
Comme rien n'est généré, le coût de sortie tombe à zéro ou presque. Comparez avec l'appel de fonctions sur un LLM, où chaque accolade et chaque guillemet est un token de sortie facturé. Il en va de même pour le mode JSON. Jev ne facture rien pour la sortie, et Clef n'affiche aucun prix de sortie. C'est aussi pourquoi la page d'accueil de Jev insiste autant sur l'angle « plus proche du code » : une requête, une réponse typée, à chaque fois.
Modèles de décision vs LLM vs classifieurs classiques
La critique la plus bruyante sur Hacker News est que ce n'est qu'un classifieur sous une nouvelle étiquette. Un commentateur l'a résumé ainsi : « modèle de décision = classifieur ». Ils n'ont pas tort sur les mathématiques. Là où ils se trompent, c'est sur ce qui a changé pour la personne qui met cela en production.
"LLM as judges - generalized, but too slow. ... traditional classifiers, very specific 1 trick pony, super fast and cheap once built. ... decision models/jev - are generic, you can throw them at most generic classification problems, and they are good enough."

C'est la version honnête. Voici comment les trois options se comparent pour une tâche typique de routage de tickets par IA :
| LLM avec schéma strict | Modèle de décision | Classifieur classique entraîné | |
|---|---|---|---|
| Nouvelles étiquettes | Modifier le prompt | Modifier la requête | Collecter des données, réentraîner |
| Sortie | Texte à analyser | Réponse typée + probabilité | Étiquette + probabilité |
| Latence typique | 1 à 3 secondes (mon test avec Luna : 1.3 à 2.6 s) | 39 à 524 ms en médiane | Moins de 10 ms |
| Coût des tokens de sortie | Facturé (Luna : $0.50/M) | Gratuit ou non facturé | Aucun (auto-hébergé) |
| Confiance calibrée | Faible après le post-entraînement | La fonctionnalité centrale | Possible, difficile à bien faire |
| Peut écrire une réponse | Oui | Non | Non |
| Idéal pour | Travail ouvert, réponses, raisonnement | De nombreux petits appels zero-shot | Une tâche fixe à fort volume |
Les chiffres de latence de Luna proviennent d'un test que j'ai mené avec GPT-6 Luna, raisonnement désactivé, pour mon article sur les tarifs de la Decisions API. La fourchette des modèles de décision est celle du benchmark de Cloudflare ci-dessous, Laya exclu. La ligne du classifieur reflète Laya, un encodeur de 421M qui se comporte à peu près comme un classifieur classique et que Cloudflare a chronométré à 5.8 ms.
La colonne sur laquelle je me concentrerais est « Nouvelles étiquettes ». Un autre commentateur a formulé l'argument pratique mieux que n'importe quel éditeur : « Pouvoir régler n'importe quel problème de classification arbitraire en quelques minutes plutôt qu'en une semaine, c'est un gros avantage. » Si votre équipe support ajoute chaque trimestre une nouvelle gamme de produits et une nouvelle catégorie de routage, réentraîner un classifieur chaque trimestre est le coût caché qu'un modèle de décision supprime.
Quels modèles de décision peut-on utiliser aujourd'hui ?
La catégorie a avancé à une vitesse absurde. Le Jev Decision Index, géré par la communauté, a démarré le 22 septembre avec 31 participants ouverts et listait 70 modèles ouverts lors de sa mise à jour du 28 septembre. La plupart sont des reproductions de passionnés. Voici ceux qui ont un véritable éditeur ou un score notable derrière eux :
| Modèle | Créateur | Taille | Poids ouverts | Hébergé | Prix | Entrées | Decision Index |
|---|---|---|---|---|---|---|---|
| Jev | TypeSafe | Non communiquée | Non | API TypeSafe, Workers AI | $0.042/M en entrée, sortie gratuite | Texte | 57.9 |
| Clef | Cloudflare | 27B | Oui, Apache 2.0 | Workers AI | $0.24/M en entrée | Texte, JSON, images, vidéo | 61.2 (auto-déclaré) |
| Clef-flash | Cloudflare | 9B | Oui, Apache 2.0 | Workers AI | $0.09/M en entrée | Texte, JSON, images, vidéo | 57.1 (auto-déclaré) |
| pplx-decider-v1-27b | Perplexity | 26B | Oui | Non vérifié | Auto-hébergé | Texte, images | 56.4 |
| Strands Decider 2B | AWS Strands Labs | 1.9B | Oui, Apache 2.0 | Non | Gratuit (auto-hébergé) | Texte (images expérimental) | Absent du classement |
| Bespoke-Nimble-9B-v2 | Bespoke Labs | Adaptateur 9B | Oui | Non | Auto-hébergé | Texte | 39.6 |
| Kev 9B | Jared Palmer | Adaptateur 9B | Oui, Apache 2.0 | Non | Auto-hébergé | Texte | 38.5 |
| Tev1-4B | Together AI | 4B | Oui, licence non définitive | Together serverless | Non relevé | Texte | 29.0 |
| Laya | Convai Innovations | 421M | Oui, Apache 2.0 | Non | Auto-hébergé | Texte, plus de 100 langues | 6.0 |
| Decisions API | OpenAI | Basé sur GPT-6 Luna | Non | Aperçu limité | Non publié | Texte, images | Absent du classement |
Sources : le Decision Index, le classement auto-déclaré de Cloudflare et la page propre à chaque modèle, liée dans les sections ci-dessous. L'Index est corrigé du hasard sur 38 benchmarks : 0 correspond donc à des réponses au hasard.
Voici les quatre que je regarderais en premier.
TypeSafe Jev
Jev est l'original et reste la référence à laquelle tout le monde se compare. C'est un modèle fermé de TypeSafe AI, une équipe de San Francisco dirigée par Diogo Almeida, qui a co-inventé les méthodes RLHF et InstructGPT derrière ChatGPT. Le 27 septembre, TypeSafe a supprimé sa liste d'attente : tout le monde peut désormais créer un compte.
Le prix mis en avant dans l'article de lancement est de $0.042 par million de tokens d'entrée avec une sortie gratuite, et TypeSafe annonce des temps de réponse de bout en bout de 70 à 500 ms. Il ne traite que le texte, avec un contexte de 32K. Deux choses à savoir avant de vous engager : l'architecture et les poids de Jev ne sont pas publics, et TypeSafe reconnaît lui-même qu'il « ne peut pas prouver qu'il n'est pas subventionné ».
Pour les calculs à votre volume, consultez mon détail des tarifs de Jev. Si vous voulez un retour pratique, je l'ai couvert dans mon test de Jev. Il existe aussi un palier distinct à plus faible latence, que j'ai présenté sous le nom de Jev Ultrafast.
Cloudflare Clef et Clef-flash
Clef est le modèle ouvert qui prétend battre Jev. Cloudflare l'a construit sur Qwen3.8-27B (Clef-flash sur Qwen3.5-9B), a publié les deux sous Apache 2.0 et les a rendus entièrement compatibles avec l'API de Jev : changer revient surtout à modifier une URL.
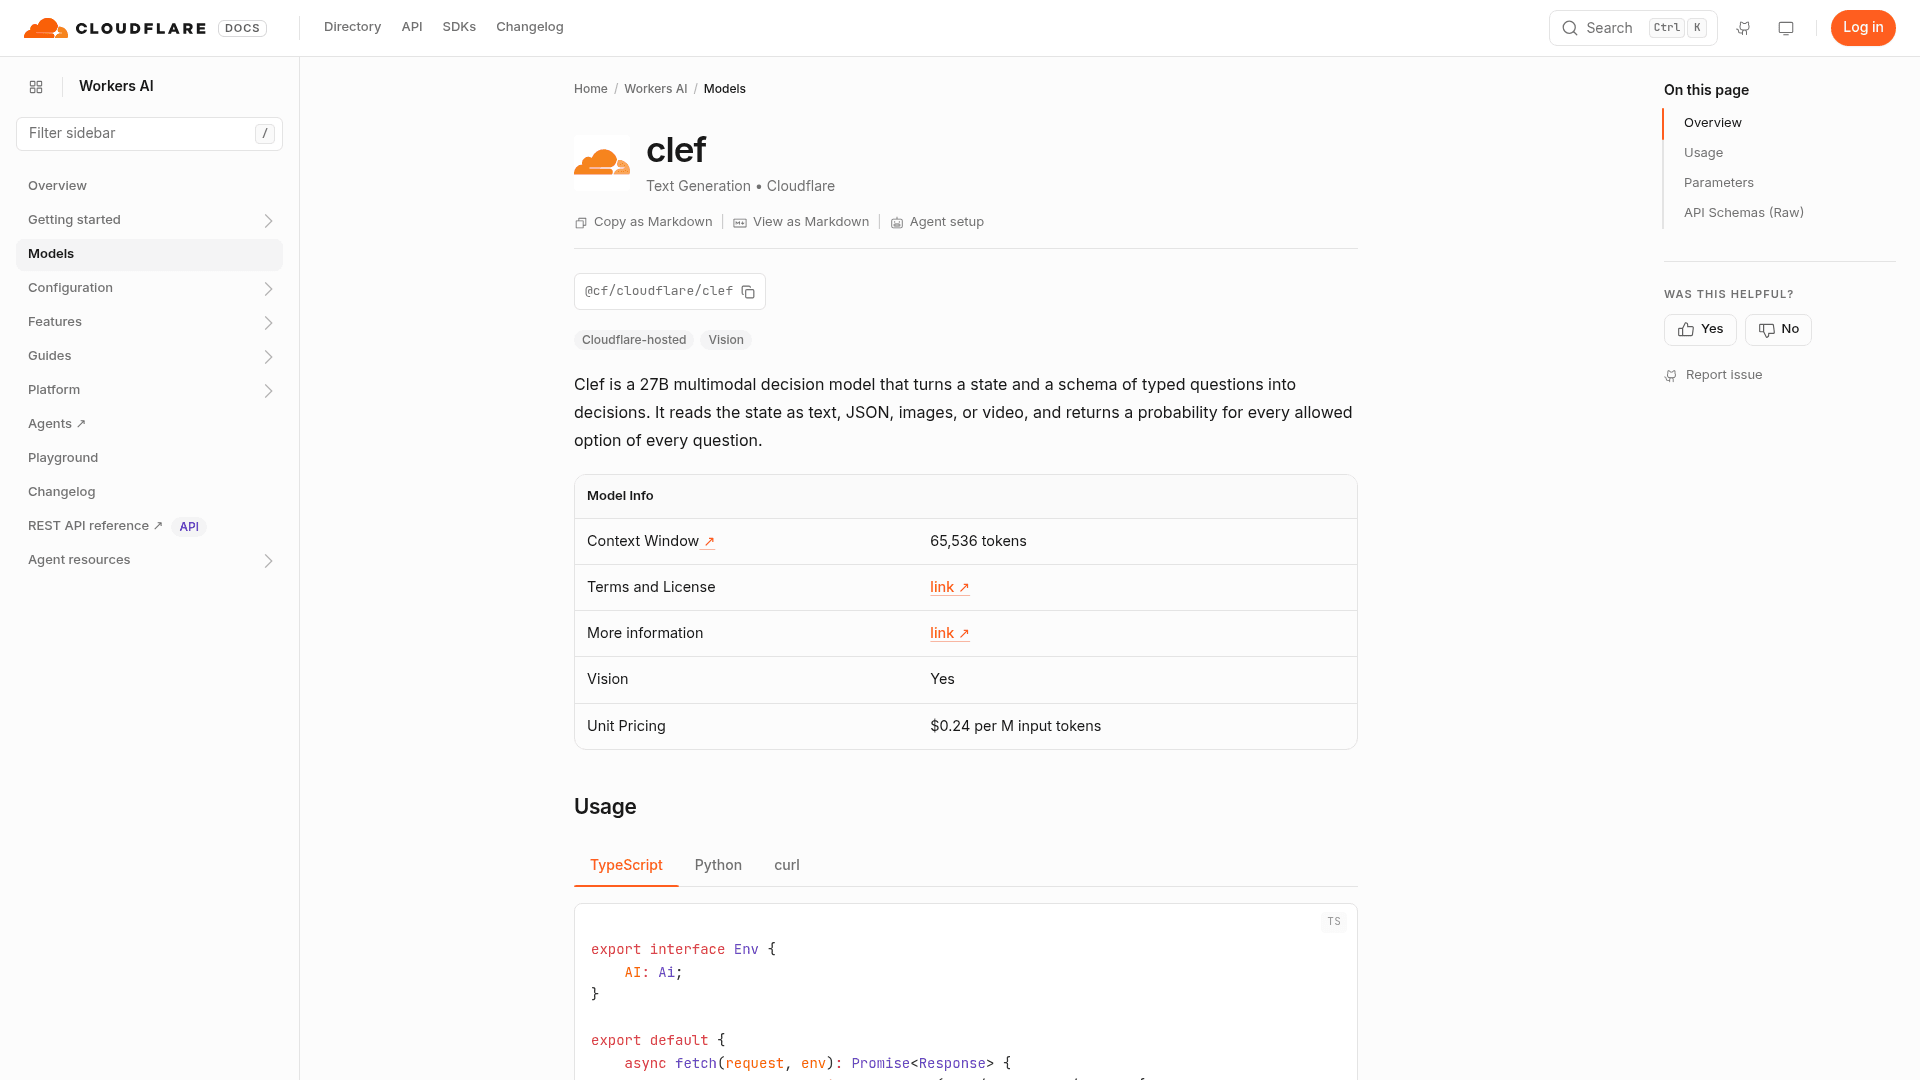
Les deux vrais avantages de Clef sur Jev sont la vision (il lit les images et la vidéo) et un contexte de 64K. D'après les chiffres de Cloudflare, il remporte aussi 3 des 4 évaluations de workflow de TypeSafe elle-même, dont le service client, où les trois modèles se tiennent à un point près (Clef 76.3, Clef-flash 77, Jev 76.0). La réserve : les deux scores de Clef sont Cloudflare qui note ses propres devoirs. Ils ne sont pas reproduits sur le classement d'origine, et Cloudflare a laissé de côté deux benchmarks. Il coûte aussi environ 5.7 fois le prix par token de Jev. J'ai fait le calcul par décision dans mon article sur les tarifs de Cloudflare Clef.
Strands Decider 2B
Strands Decider 2B est la proposition d'AWS Strands Labs, présentée par Marc Brooker, Mike Chambers et Fabio Nonato de Paula. C'est l'option petite qui tourne sur votre portable : 1.9B de paramètres sur une base Qwen3.5-2B, avec poids, données d'entraînement et scripts d'entraînement tous publiés.
Il fonctionne sur CPU, GPU NVIDIA ou Apple silicon, avec une médiane de 115 ms sur une RTX 3090 et de 153 ms sur un M3 Pro pour des prompts courts, selon le dépôt GitHub. Sur JevBench, il obtient 0.762 dans la version la plus récente. J'apprécie la franchise de l'article de lancement : il dit que la conception en une seule passe le rend « nettement moins bon pour résoudre des problèmes complexes que les modèles de raisonnement » et inadapté aux chatbots ou aux résumés. Deux notes pratiques : il n'existe pas de version hébergée (Hugging Face n'affiche aucun fournisseur d'inférence), et son serveur local n'a pas d'authentification, il sert donc aux expériences, pas au trafic de production. Si vous construisez déjà sur le harnais Strands, il se branche sur un hook d'appel d'outil comme barrière autoriser/refuser.
OpenAI Decisions API
OpenAI a annoncé la Decisions API au DevDay du 29 septembre, et le récapitulatif du DevDay la décrit comme « concentrer l'intelligence de Luna sur un ensemble précis de questions définies par l'utilisateur avec des réponses finies et prédéfinies ». Sept jours plus tard, je ne trouve toujours ni page de documentation, ni schéma de référence, ni ligne de prix, ni entrée de changelog. Le point de terminaison /v1/decisions existe, mais une clé standard reçoit un HTTP 403 indiquant que l'API n'est pas activée pour cet utilisateur.
Pour l'instant, le seul chiffre vérifiable chez OpenAI est donc le tarif au token de GPT-6 Luna : $0.10 par million en entrée et $0.50 par million en sortie. Si vous êtes aujourd'hui chez OpenAI, un appel à Luna avec un schéma enum strict fait le même travail ; mon article sur la Decisions API d'OpenAI détaille ce contournement.
Quelle est la vitesse des modèles de décision ?
La vitesse est là où la catégorie mérite son nom. Cloudflare a mesuré la latence médiane sur 43 benchmarks pour six modèles de décision sur sa propre infrastructure :
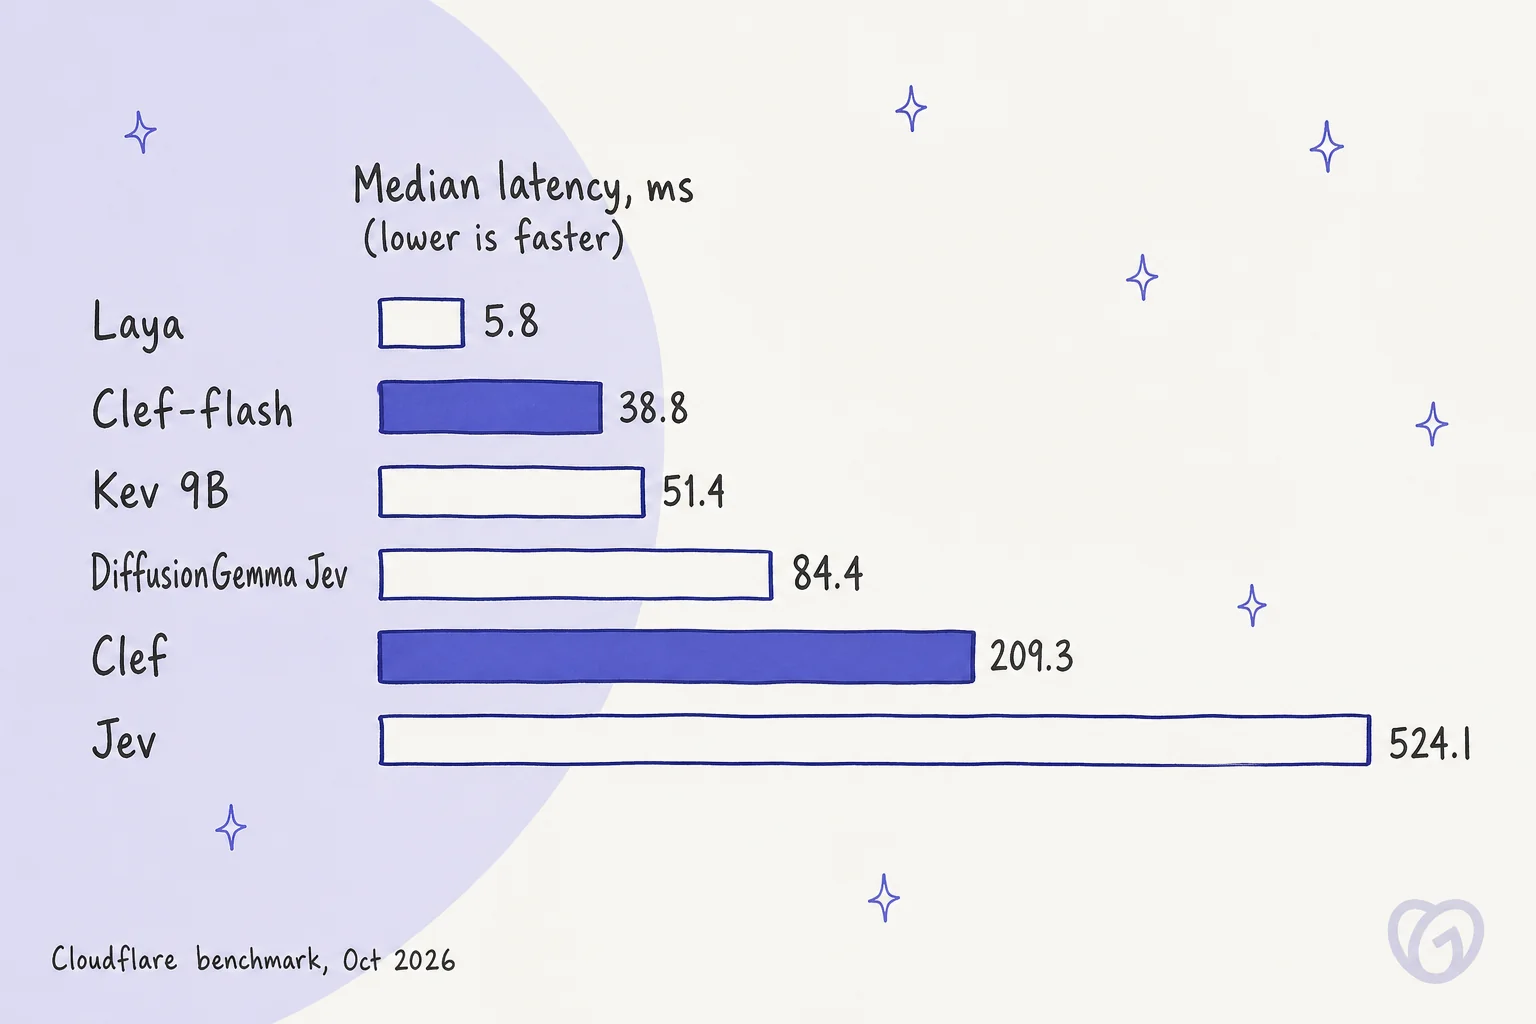
Deux réserves honnêtes sur ce graphique. D'abord, les 524 ms de Jev correspondent à un aller-retour hébergé via internet, alors que les modèles ouverts ont été mesurés sur les propres GPU de Cloudflare : ce n'est pas une course à armes égales. Ensuite, Laya est fulgurant mais n'obtient que 6.0 sur le Decision Index ; la vitesse sans la précision n'est qu'une mauvaise réponse rapide.
À titre de comparaison, un LLM qui fait le même travail se mesure en secondes. Un développeur qui a remplacé par Jev la couche de garde-fous d'un faux agent de support, auparavant basée sur un LLM, a rapporté « 194ms contre 5,825ms. $125 contre $5,894 par million de vérifications » sur un petit test de 51 cas. Cet écart est tout l'argument pour placer un modèle de décision devant un agent IA pour helpdesk comme garde-fou.
Les modèles de décision sont-ils précis ?
C'est là que je tempérerais l'enthousiasme. Les modèles de décision sont assez bons pour beaucoup de tâches, mais ce ne sont pas l'option la plus précise sur la table.
Sur JevBench, les notes d'évaluation de Strands décrivent le haut du classement comme « les modèles de raisonnement (GPT-6 Luna 0.996), puis des reconstructions de Jev sur des troncs plus gros, surtout 12B et plus (0.83-0.93) ». Un LLM de raisonnement comme Luna ou Claude Sonnet 5.5 l'emporte encore en précision. Les modèles de décision gagnent sur le coût, la vitesse et la calibration, et vous échangez quelques points de précision contre cela.
La précision baisse aussi quand le nombre d'étiquettes augmente. La fiche de Laya lui-même indique 0.425 sur BANKING77 (77 étiquettes) contre 0.870 pour Jev (Laya). Si votre helpdesk compte 60 catégories de routage, testez les 60, pas une démo bien propre à quatre.
Et les scores de confiance, tout l'argument de vente, ne sont pas encore de la science établie :
"for production routing, you almost always want to threshold on confidence ('auto-handle above 0.9, route to a human below'), and that only works if the probabilities mean what they say. A 96% model with overconfident outputs is operationally worse than a 94% model with honest ones."
Un testeur a demandé à Jev le résultat d'un lancer de dé équilibré et a obtenu environ 80% de confiance sur le « 1 » (wat10000). Un autre a montré une copie ouverte de Jev qui basculait sur « 100% légitime » quand l'e-mail lui-même disait être légitime (FooBarWidget). Les modèles de décision ne peuvent pas halluciner un paragraphe, mais ils peuvent tout à fait se tromper avec assurance ou se laisser convaincre d'une réponse.
La fiche du modèle Strands donne la bonne consigne par défaut : « mesurez sur votre propre trafic avant de faire confiance à un seuil ». C'est la même leçon que pour éviter les hallucinations de l'IA dans le support : testez sur de vrais tickets, pas sur des démos.
Quel modèle de décision convient à votre besoin ?
Choisissez la situation la plus proche de la vôtre.
Ce dernier onglet n'est pas une blague. Un commentateur sur Reddit l'a parfaitement dit : « la moitié du routage que j'ai écrit s'est révélée être un if déguisé ». De simples règles de routage Zendesk couvrent encore beaucoup de terrain.
Où les modèles de décision se placent-ils dans le support client ?
Le support est le cas d'usage que chaque éditeur met en avant en premier, et pour de bonnes raisons. Le tri automatique est surtout un empilement de petites décisions circonscrites. L'exemple de lancement de Cloudflare est un ticket de support. Les évaluations de workflow de TypeSafe incluent un jeu de service client de 5,330 lignes.
La classification d'intention est une question de type choice. La détection de spam aussi. L'urgence est un score, et « cela doit-il passer à un humain ? » est un oui/non, au cœur de l'escalade par IA. Même l'analyse de sentiment est un score sur une échelle fixe. Ce sont toutes des questions circonscrites avec un ensemble fixe de réponses. C'est exactement la forme pour laquelle un modèle de décision est conçu.
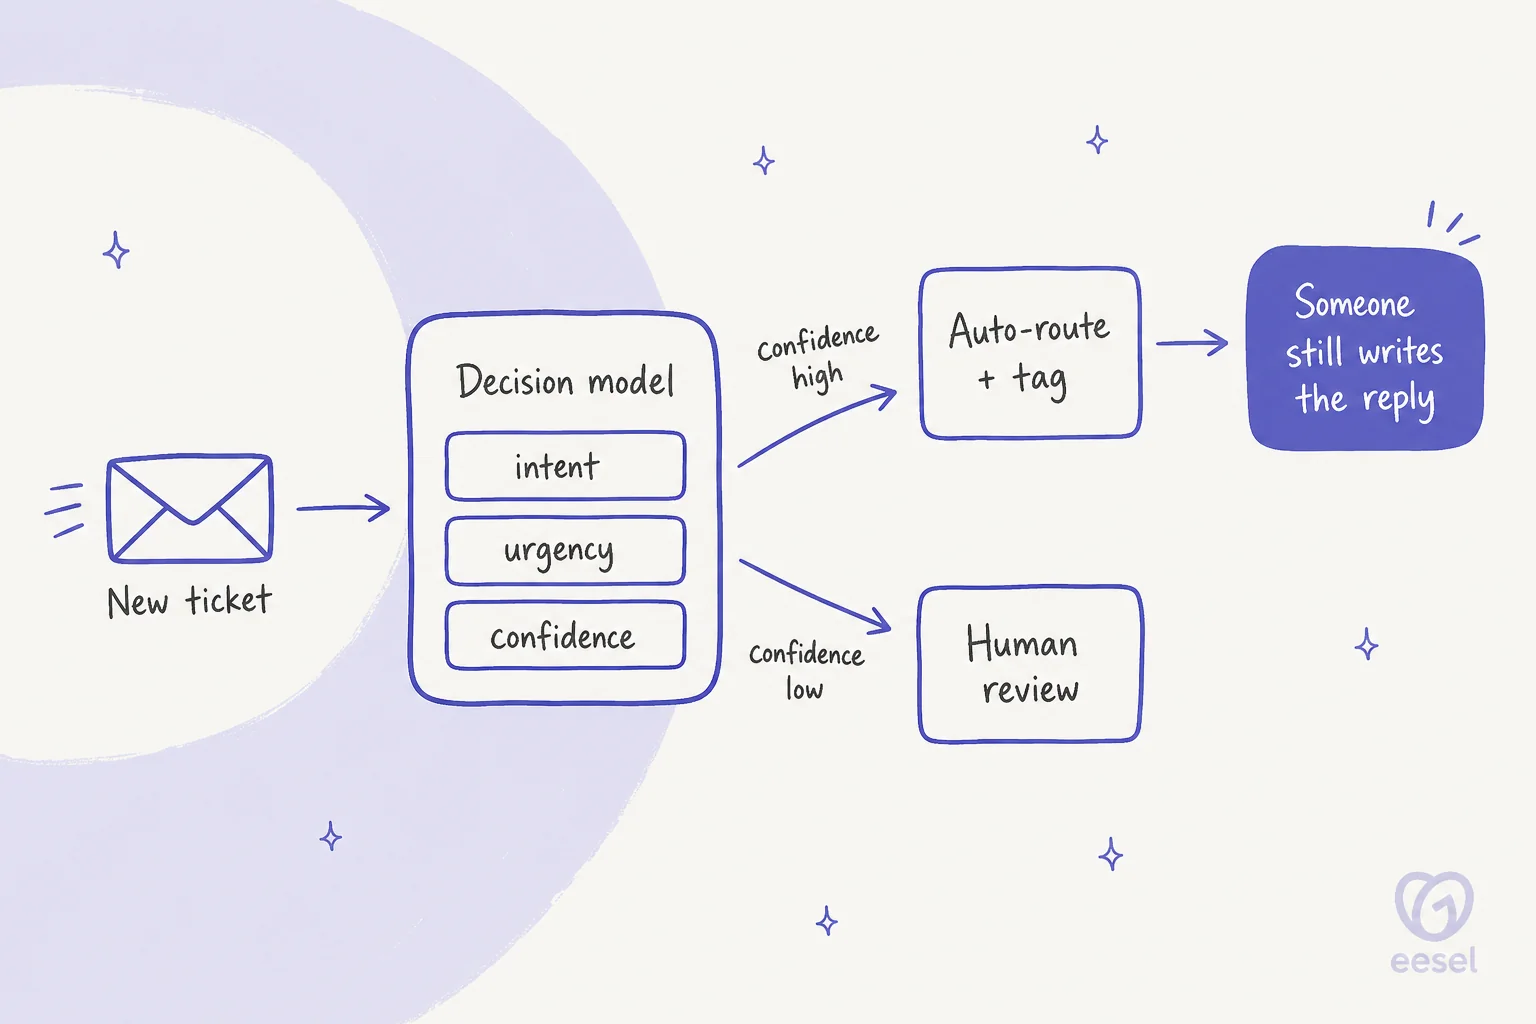
Voici ce que j'ai appris en mettant de l'IA sur de vraies files de support chez eesel pendant des années : le tri est la moitié facile. Lors d'un essai en validation croisée sur la vraie boîte Zendesk d'une entreprise d'e-commerce, le tri par IA a atteint 93% de précision et repéré 100% du spam, qui représentait 22% de la boîte. Lors du même essai, seulement 12% des réponses rédigées par l'IA sont parties telles quelles, et 7% comportaient une erreur factuelle. La classification des tickets était presque résolue. Le travail se trouvait dans la réponse.
Le score de confiance est la pièce que les acheteurs réclament depuis toujours. Un responsable CX qui gère 7,000 tickets par mois a dit à l'équipe d'eesel lors d'un appel commercial :
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est l'idée centrale d'un modèle de décision en une phrase. C'est aussi pourquoi eesel simule chaque déploiement sur les tickets historiques d'une équipe avant toute mise en production : une réponse fausse avec aplomb est pire que pas de réponse, et la seule façon de savoir où se situe votre seuil est de tester sur du trafic réel.
Une remarque pratique d'un propriétaire de MSP mérite d'être entendue avant de reconstruire votre pile autour de la vitesse. Dans un fil de r/SmallMSP, il a dit que le modèle n'était pas le goulot d'étranglement : « Je soupçonne qu'Autotask est mon maillon faible en matière de vitesse. » Gagner 2 secondes sur un appel de routage ne change pas grand-chose si le ticket attend ensuite 40 minutes dans une file.
Alors, où se place un modèle de décision ? Dans un workflow que vous construisez vous-même, comme première passe peu coûteuse. Si vous écrivez du code et traitez des millions d'événements, un modèle de décision est une excellente brique pour le routage, la modération ou les garde-fous, et mon comparatif des alternatives à Jev couvre les options à construire soi-même. Si vous êtes une équipe support qui veut des tickets étiquetés, routés, escaladés et traités dans votre helpdesk existant, un modèle brut est le début d'un projet, pas la fin. Il vous faudrait encore construire l'étiquetage, le processus d'escalade, la recherche dans la base de connaissances et la réponse.
Pour le chemin complet à faire soi-même, commencez par mon guide pour automatiser le tri des tickets. Si vous préférez acheter plutôt que construire, mon comparatif des outils de tri par IA compare les solutions prêtes à l'emploi.
Essayez eesel pour le tri et les réponses
Le coéquipier IA pour helpdesk d'eesel fait les deux moitiés du travail, là où les modèles de décision n'en font qu'une. Il rejoint votre file existante (il existe une intégration Zendesk, ainsi que Freshdesk et Gorgias), étiquette et route les tickets, escalade ce qu'il ne doit pas toucher et rédige la réponse à partir de votre centre d'aide et de vos anciens tickets. Chaque automatisation a même un réglage « Model strength », avec un modèle plus léger « pour les tâches simples comme l'étiquetage ou le routage » (documentation des automatisations) et le plus puissant pour la rédaction : la décision peu coûteuse et la réponse difficile tournent donc déjà sur des modèles différents.

L'idée de confiance se retrouve aussi ici. Chaque action (un tag, une réponse, un remboursement) est réglée sur automatique, nécessite une approbation ou désactivée, et les événements que vos instructions ne couvrent pas sont ignorés et consignés avec une raison. Vous pouvez lancer une simulation sur vos propres anciens tickets avant toute mise en production.
Si vous êtes arrivé ici en tant que développeur, la CLI eesel fait le lien. Lancez npx @eesel/cli et vous pouvez connecter un helpdesk, configurer une automatisation avec des consignes de routage en langage courant via eesel automations, et approuver ou refuser les actions en attente avec eesel approvals, le tout depuis un terminal. Chaque commande renvoie du JSON : Claude Code, Cursor ou Codex peuvent donc piloter toute la configuration, et --dry-run vérifie une écriture avant qu'elle n'ait lieu. Vous obtenez la logique de routage que vous auriez construite autour d'un modèle de décision, plus la partie qui répond au client, sans écrire le code de liaison.
Les offres démarrent à $299 par mois pour 500 crédits sur les tarifs d'eesel, où un crédit correspond à un ticket, sans frais par utilisateur, et il existe un palier gratuit de 100 crédits. Essayez eesel sur vos propres tickets et voyez où se situe réellement votre seuil de confiance.
Questions fréquentes
Qu'est-ce qu'un modèle de décision en IA ?
Un modèle de décision est un petit modèle d'IA qui répond à des questions typées (oui/non, choisir une option ou noter sur une échelle) à propos d'une entrée et renvoie chaque réponse avec une probabilité, au lieu d'écrire du texte. TypeSafe Jev a lancé la catégorie en septembre 2026, et les modèles de décision servent désormais à des tâches comme le tri des tickets. Trier un ticket par sujet, aussi appelé classification d'intention, est une tâche typique.
En quoi les modèles de décision diffèrent-ils des LLM ?
Un LLM génère du texte token par token, il faut donc analyser sa réponse. Un modèle de décision lit l'entrée une seule fois et note les réponses autorisées en une seule passe : il n'y a pas de texte à générer et la sortie est quasiment gratuite. La contrepartie est que les modèles de décision ne savent pas rédiger de réponses, de code ou de résumés, c'est pourquoi une équipe support a toujours besoin d'un agent IA pour helpdesk ou d'une personne pour la réponse.
Les modèles de décision sont-ils de simples classifieurs ?
Mathématiquement, ils sont proches : ils choisissent parmi des étiquettes et renvoient des probabilités. La nouveauté, c'est qu'ils fonctionnent en zero-shot sur des étiquettes que vous définissez au moment de la requête : inutile de collecter des données et d'entraîner un modèle pour chaque nouveau problème de classification de tickets.
Combien coûtent les modèles de décision ?
Jev coûte $0.042 par million de tokens d'entrée avec une sortie gratuite, Cloudflare Clef coûte $0.24 et Clef-flash $0.09 par million de tokens d'entrée, et Strands Decider 2B est gratuit si vous l'hébergez vous-même. OpenAI n'a pas publié de prix pour sa Decisions API. Mon article sur les tarifs de Jev détaille tous les calculs. Pour Clef, consultez le détail des tarifs de Clef.
Quel est le meilleur modèle de décision ?
Sur le Decision Index communautaire, Jev obtient 57.9 et aucun modèle ouvert testé de manière indépendante ne le dépasse pour l'instant. Cloudflare indique 61.2 pour Clef sur sa propre copie du classement, mais ce score est auto-déclaré. Pour les images, Clef ; pour un usage hors ligne ou sur CPU, Strands Decider 2B ; pour les décisions textuelles hébergées les moins chères, Jev.
Puis-je utiliser un modèle de décision pour le routage des tickets ?
Oui. Le routage des tickets, l'urgence et les décisions d'escalade sont le cas d'usage de référence, et l'exemple de lancement de Cloudflare route lui-même un message de support par équipe et par gravité. Il vous faut toujours du code ou un outil de helpdesk pour agir sur l'étiquette, ce que gère de bout en bout un coéquipier IA pour helpdesk.
La Decisions API d'OpenAI est-elle disponible ?
OpenAI a annoncé la Decisions API lors du DevDay 2026 en aperçu limité. Au 6 octobre 2026, il n'existe ni documentation publique, ni schéma, ni prix, et le point de terminaison renvoie une erreur « non activé » pour les clés d'API standard. Mon article sur la Decisions API d'OpenAI suit ce que l'on sait.
Les modèles de décision remplacent-ils un agent de support IA ?
Non. Un modèle de décision prend une décision circonscrite, comme quelle équipe doit s'en occuper ou quel est le niveau d'urgence. Il ne consulte pas une commande, n'applique pas une politique de remboursement et n'écrit pas de réponse. Les modèles de décision sont une brique pour automatiser le tri des tickets, pas un remplacement du coéquipier qui résout le ticket.