

En bref
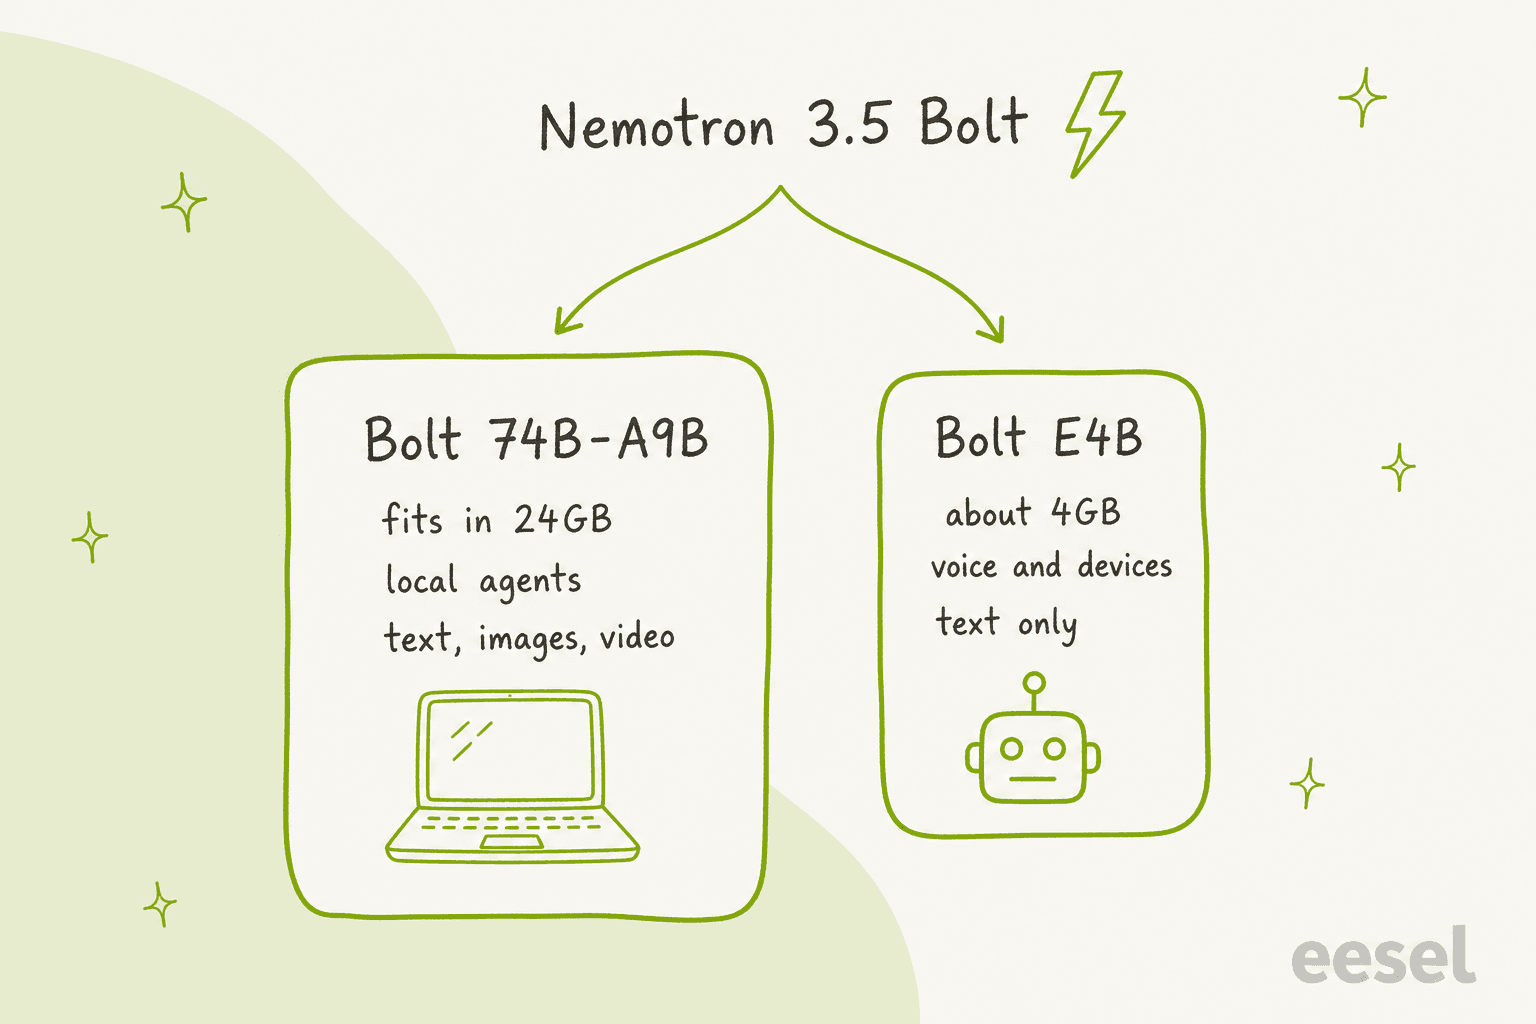
Nemotron 3.5 Bolt est la nouvelle famille de modèles ouverts de NVIDIA conçus pour fonctionner sur votre propre machine, et elle comprend deux modèles, pas un seul. Bolt 74B-A9B fait tenir un modèle de 74B paramètres dans 24GB avec des poids sur 2 bits, afin que des agents locaux puissent fonctionner sur un seul GPU grand public. Bolt E4B est un modèle de 4GB destiné aux assistants vocaux, aux personnages de jeux et aux appareils.
Le modèle 74B obtient un score de 21 sur l’Artificial Analysis Intelligence Index, ce qui le place au quatrième rang des modèles de moins de 100B paramètres et à moins de 2 points du Nemotron 3 Ultra de NVIDIA, qui compte 550B paramètres. Les poids sont gratuits sous licence OpenMDW-1.1, et aucun des deux modèles Bolt ne dispose encore d’une API payante : votre facture se limite donc à votre matériel.
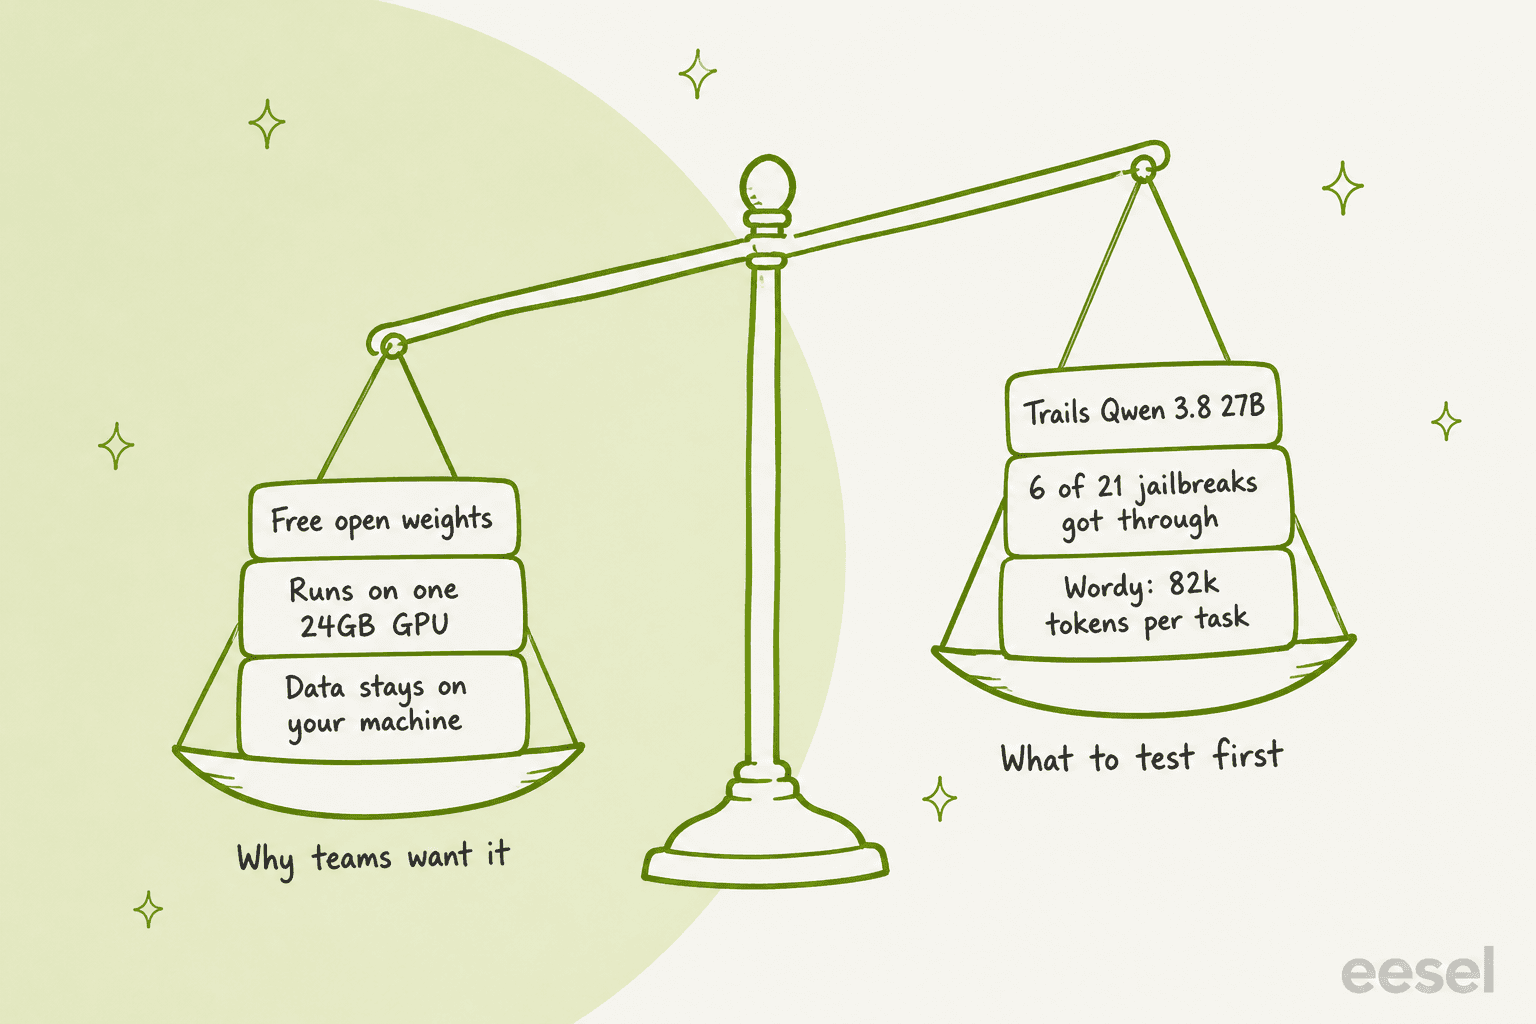
Le hic : le modèle dense Qwen3.8 27B reste plus intelligent (44.5 contre 28.5 sur le propre graphique GDPVal v2 de NVIDIA), Bolt est bavard, et un testeur l’a vu échouer à 6 des 21 tests de jailbreak. Pour les équipes de support, c’est un moteur prometteur pour des tâches privées exécutées sur l’appareil, pas un outil de réponse aux tickets qu’il suffit d’activer. Si c’est ce que vous cherchez aujourd’hui, le coéquipier IA pour le support d’eesel répond uniquement à partir de vos propres documents et est testé sur vos anciens tickets avant de répondre à qui que ce soit.
Pourquoi j’ai lu le rapport technique de Bolt
Je développe des fonctionnalités et des agents IA chez eesel. Je passe donc la majeure partie de ma semaine sur les rouages peu passionnants d’un agent : ce qui entre dans le contexte, l’outil qu’il appelle et ce qui se passe quand le modèle se trompe. La question que les acheteurs techniques me posent le plus souvent n’est pas « à quel point est-il intelligent ? », mais « où vont nos données ? ». Lors d’un appel commercial cette année, une personne chargée de l’évaluation dans une entreprise de matériel informatique a demandé si l’IA se rabattrait sur "some kind of other ChatGPT" lorsqu’elle ne connaissait pas la réponse, et si leurs connaissances restaient réservées à leur organisation.
Un modèle que vous pouvez exécuter sur une machine sous votre propre bureau apporte une réponse honnête à cette question. Alors, quand NVIDIA a lancé un modèle dont tout l’argumentaire se résume à « faire tenir un gros modèle dans 24GB », j’ai lu la fiche du modèle, le rapport technique et tous les tests utilisateurs que j’ai pu trouver. Voici ce qui tient la route et ce qui mérite une note de bas de page.
Qu’est-ce que Nemotron 3.5 Bolt ?
Nemotron 3.5 Bolt est la gamme « edge » de NVIDIA au sein de la famille Nemotron 3.5. NVIDIA l’a annoncée le 15 octobre 2026 aux côtés de Nemotron 3.5 Super VL, et décrit ainsi cette famille : Lightning gère les charges de travail à haut débit, Ultra prend en charge les raisonnements les plus difficiles, et "Bolt brings intelligence to the edge."
Ce nom recouvre deux modèles très différents, ce qui a semé la confusion dans une bonne partie des premiers articles :
- Bolt 74B-A9B 24GB est le modèle phare. Il est "designed to run everyday agentic tasks locally on NVIDIA RTX/DGX Spark, using a native 2-bit quantization to fit in 24GB of memory," selon NVIDIA.
- Bolt E4B 4GB est arrivé le 23 octobre. Il s’agit d’un modèle 8B avec 4B paramètres effectifs, construit sur Gemma 4 E4B de Google avec un post-entraînement Nemotron, pour "fast local voice assistants, interactive characters and embedded interfaces."
Voici leurs caractéristiques côte à côte :
| Caractéristique | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| Date de sortie | 15 octobre 2026 | 23 octobre 2026 |
| Paramètres | 74B au total, 9B actifs par token | 8B au total, 4B effectifs |
| Modèle de base | Nemotron 3.5 Super VL (120B), compressé | Gemma 4 E4B, avec post-entraînement |
| Architecture | Mélange d’experts hybride Mamba-2 et Transformer | Gemma 4 E4B |
| Format des poids | Experts sur 2 bits (IQ2_XXS), 22.1GB | 4 bits (Q4_K_M) |
| Entrées | Texte, images, vidéo (MP4 jusqu’à 2 minutes) | Texte |
| Fenêtre de contexte | Jusqu’à 256K tokens | 64K tokens |
| Matériel cible | RTX Spark, DGX Spark, GeForce RTX, RTX PRO | GeForce RTX, Jetson, RTX/DGX Spark |
| Licence | OpenMDW-1.1 | OpenMDW-1.1, plus Apache 2.0 pour la base Gemma |
Les deux proposent un raisonnement que vous pouvez activer ou désactiver, et le modèle 74B prend en charge l’appel d’outils et la sortie JSON. Si vous suivez les sorties de modèles ouverts comme Meta Muse Spark Open ou Kimi K3, la différence ici tient à la cible : Bolt est conçu pour une seule machine, pas pour un centre de données.
Comment NVIDIA fait-il tenir un modèle 74B dans 24GB ?
En bref : partir d’un gros modèle, l’élaguer, puis réduire la taille de chaque nombre. La page de recherche de NVIDIA énonce clairement l’objectif : "fit into 24GB of memory and achieve a decoding speed of at least 80 TPS, while maximizing intelligence." Quatre étapes permettent d’y arriver.
- Compresser un modèle plus gros. Bolt part de Super VL, qui compte 120B paramètres et sélectionne 22 experts par token. La méthode Star Elastic de NVIDIA l’élague à 74B et fixe le nombre d’experts à 9. À elle seule, cette opération coûte 2.85 points de précision moyenne, soit 4,94 % par rapport au modèle parent, selon le rapport technique.
- Le remettre sur pied avec de l’entraînement. Bolt reçoit ensuite 120B tokens d’entraînement de récupération, retrouve ses capacités visuelles, puis passe par un ajustement fin supervisé et un apprentissage par renforcement. La partie visuelle en a le plus besoin : la compression a fait chuter le score WebArena de 57.4 à 1.35, et l’entraînement l’a ramené à environ 50.
- Quantifier les experts sur 2 bits. Les poids des experts sont stockés sur 2.0625 bits chacun, avec une distillation tenant compte de la quantification pour que le petit modèle apprenne à reproduire le grand à cette précision. Les couches Mamba utilisent le format NVFP4 sur 4 bits, tandis que l’attention et les embeddings restent sur 8 bits. Le modèle passe ainsi de 148GB à 22.1GB, "an 85.1% reduction in size. This quantization is lossy by design," indique NVIDIA.
- Ajouter un modèle de proposition pour accélérer. Un modèle distinct de 1.13B paramètres appelé LiLiCorr anticipe plusieurs tokens, puis le modèle principal les vérifie. C’est ainsi que NVIDIA atteint 84 tokens par seconde sur RTX Spark.
NVIDIA parie sur le fait qu’un gros modèle réduit à 2 bits surpasse un petit modèle entraîné sur 4 bits. C’est l’inverse de la façon dont la plupart des modèles locaux sont construits, et c’est la nouveauté de cette version.
Une précision sur les « 24GB » du nom. Le tableau de mémoire du rapport technique totalise 23.83GB pour le texte seul. L’encodeur visuel nécessite 1.68GB supplémentaires.
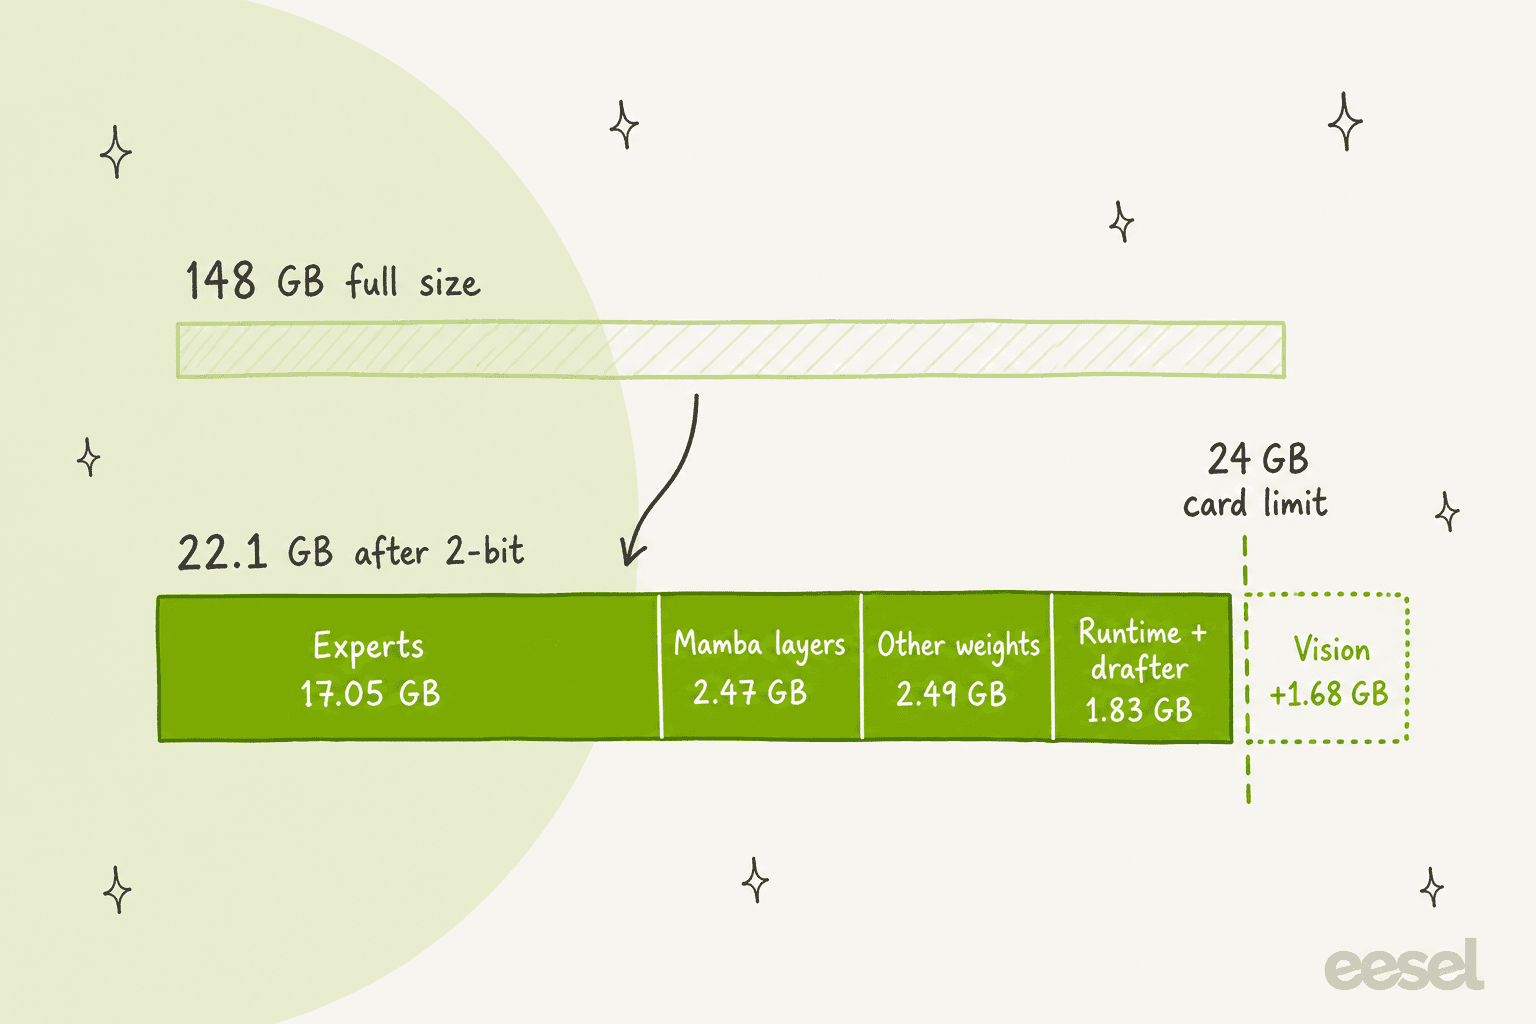
Sur une carte de 24GB, vous faites donc tourner des agents textuels. Si vous voulez aussi les capacités d’image et de vidéo, prévoyez un peu plus de marge. Le guide d’exécution locale d’Unsloth suggère de toute façon 24 à 32GB de mémoire.
Que vaut vraiment Nemotron 3.5 Bolt ?
Consultez deux classements : le classement indépendant et celui de NVIDIA.
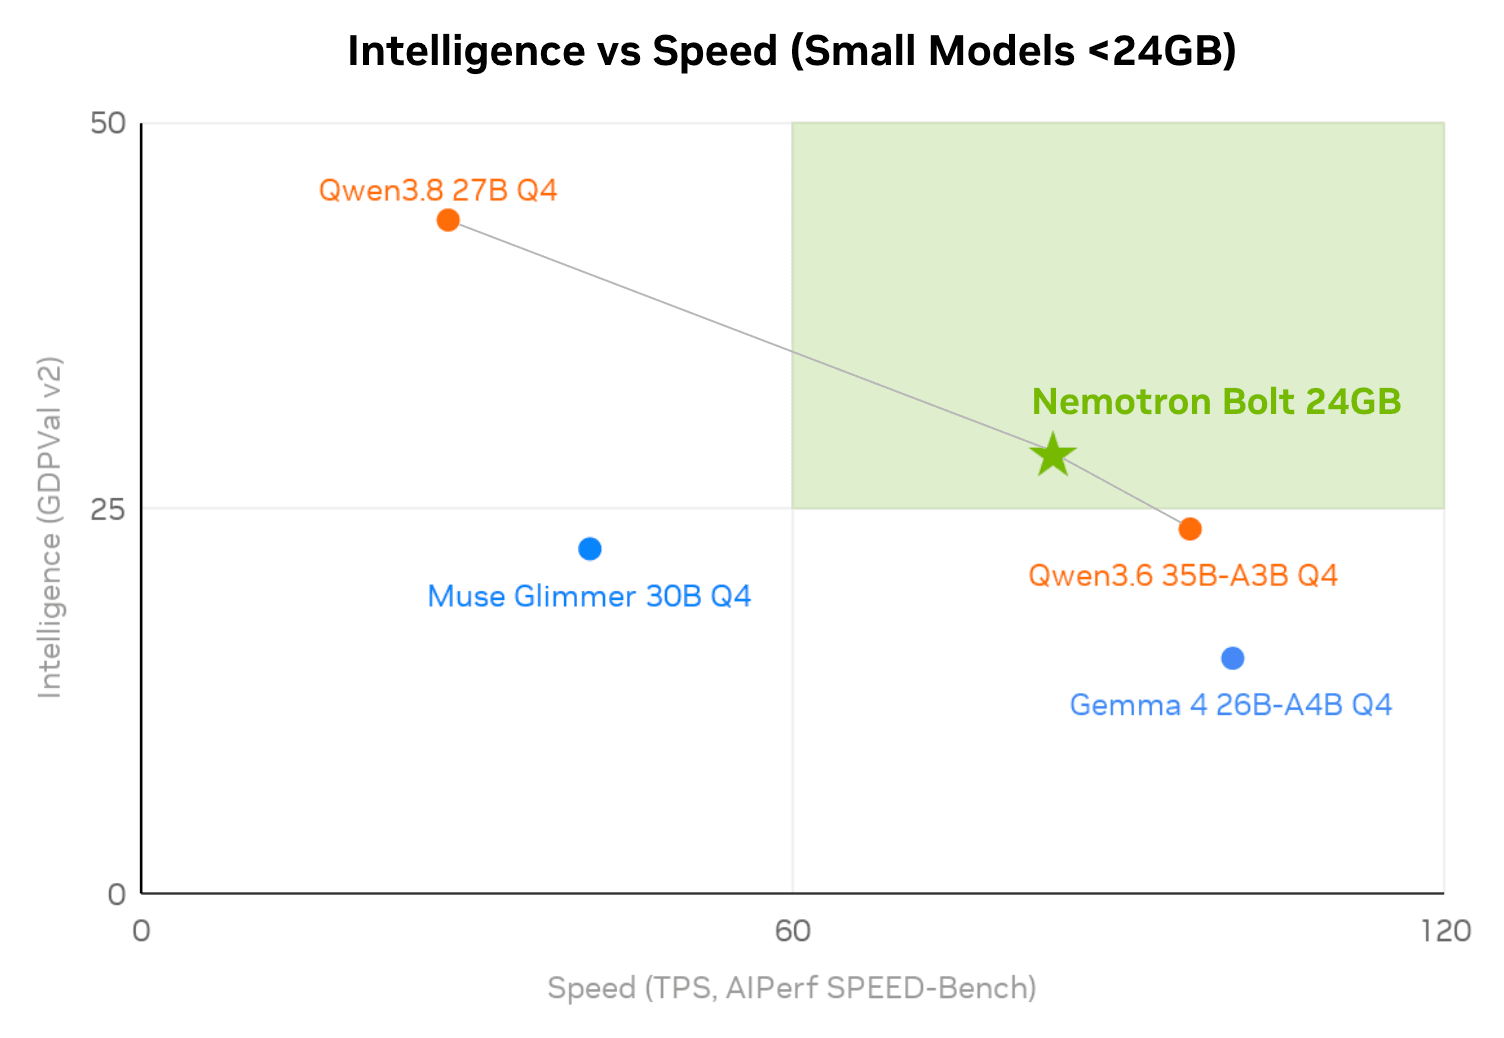
Le score indépendant. Artificial Analysis attribue à Bolt 74B un score de 21.4 sur son Intelligence Index, "placing 4th among models under 100B parameters and first among US models in that class." C’est à moins de 2 points de Nemotron 3 Ultra (23), un modèle comptant environ sept fois plus de paramètres. Bolt surpasse même Ultra sur AutomationBench-AA (15,5 % contre 3,0 %).
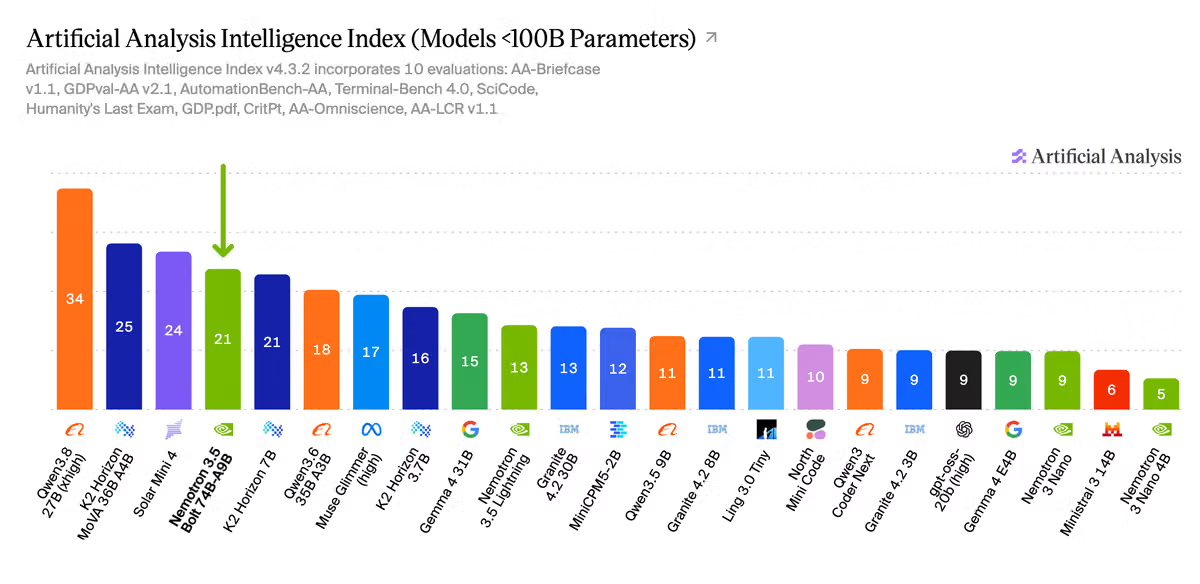
Regardez toutefois la gauche de ce graphique. Qwen3.8 27B obtient 34. Bolt est le meilleur modèle américain de sa catégorie, pas le meilleur modèle de sa catégorie.
Le propre tableau de NVIDIA. La fiche du modèle compare Bolt sur 2 bits à trois modèles homologues à mélange d’experts en pleine précision :
| Benchmark | Bolt 74B 24GB (2 bits) | Qwen3.6 35B-A3B | Gemma 4 26B-A4B | Nemotron 3.5 Lightning |
|---|---|---|---|---|
| GDPVal-AA-V2 (tâches professionnelles réelles) | 28,47 | 25,75 | 15,33 | 18,26 |
| Terminal-Bench 2.1 | 50,98 | 44,38 | 37,22 | 23,46 |
| Tau3 Banking (service client) | 17,01 | 10,52 | 14,02 | 9,48 |
| GPQA Diamond | 86,43 | 83,40 | 79,61 | 75,57 |
| BrowseComp | 66,75 | 48,74 | 26,30 | 36,81 |
| PinchBench | 87,82 | 88,07 | 74,70 | 83,43 |
| Précision AA-Omniscience | 16,90 | 19,47 | 22,17 | 16,63 |
| IFBench (respect des instructions) | 66,17 | 63,71 | 77,25 | 72,88 |
Face à ces trois modèles, Bolt remporte la plupart des lignes, et y parvenir sur 2 bits est impressionnant. Mais le tableau omet le modèle dense Qwen3.8 27B. Le propre rapport technique de NVIDIA lui attribue 44.5 sur GDPVal v2 contre 28.5 pour Bolt, à environ un tiers de sa vitesse. C’est un compromis raisonnable à proposer, mais il faut lire le PDF pour le voir.
Deux autres coûts à connaître :
- Le passage à 2 bits a un coût. Par rapport aux propres poids de Bolt en pleine précision, GDPVal passe de 31.13 à 28.47 et la précision Omniscience de 21.80 à 16.90, selon le rapport technique.
- Il parle beaucoup. Artificial Analysis a compté 82k tokens de sortie par tâche de l’Index, soit 1,8x Super VL et 2,9x Ultra. En local, cela coûte du temps plutôt que de l’argent, mais c’est tout de même du temps.
Quelle est sa vitesse sur du matériel réel ?
Le propre tableau de vitesse de NVIDIA est plus modeste que les annonces de lancement. Sur RTX Spark avec llama.cpp, Bolt atteint 83.99 tokens par seconde, contre 96.63 pour Qwen3.6 35B-A3B, 100.56 pour Gemma 4 26B-A4B et 28.26 pour Qwen3.8 27B, selon la page de recherche. Il est donc plus lent que les petits modèles à mélange d’experts qu’il surpasse en précision, et environ 3x plus rapide que le modèle dense qui le surpasse.
Les utilisateurs disposant de cartes plus puissantes obtiennent bien davantage :
"343 tok/s median with the LiLiCorr drafter (DFlash, n_max 6, about 55% of drafted tokens accepted), 166 tok/s without it. 25.0 GiB at 32K with the drafter and the projector, 22.7 GiB without the drafter."

Ces résultats sont obtenus sur une RTX 5090, et notez les 25GB une fois la vision et le modèle de proposition chargés. Sur une carte de 16GB, un utilisateur a rapporté environ 45 tokens par seconde en déchargeant une partie du modèle vers la mémoire système. Pour les utilisateurs de Mac, c’est moins favorable pour le moment :
"Nemotron Bolt appears to be really quite good but unfortunately it is quite slow on macOS/Metal in llama.cpp at the moment because of lack of support for a tensor type (or something… not sure I understand)."

Combien coûte Nemotron 3.5 Bolt ?
Les poids sont gratuits, et c’est toute la grille tarifaire. Au 27 octobre 2026, aucun des deux modèles Bolt ne dispose d’une API hébergée payante. Il n’est répertorié ni sur OpenRouter ni sur DeepInfra, la page build.nvidia.com de NVIDIA pour le modèle 74B renvoie une erreur 404, et Artificial Analysis indique "No publicly available API."
| Mode d’accès | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| Poids ouverts | Gratuit, OpenMDW-1.1 | Gratuit, OpenMDW-1.1 |
| Hébergement NVIDIA | Non disponible | Point de terminaison d’essai gratuit soumis aux conditions d’essai de l’API de NVIDIA |
| OpenRouter, DeepInfra | Non répertorié | Non répertorié |
| Téléchargement local | 22GB (GGUF sur 2 bits) | 6.18GB (GGUF sur 4 bits, Unsloth) |
| Mémoire nécessaire à l’exécution | 24 à 32GB | Environ 4GB de mémoire vidéo |
Si vous préférez payer au token, les autres modèles de la famille sont hébergés. Sur OpenRouter, Super VL est affiché à 0,15 $ par million de tokens d’entrée et 0,50 $ en sortie, et Lightning à 0,07 $ et 0,20 $. Si vous comptez opter pour l’hébergement, mon guide du meilleur modèle IA pour les tickets de support compare aussi les options fermées, comme Claude Haiku 5.5 et Gemini 3.8 Flash.
La licence est l’autre moitié de l’équation du coût, et c’est une bonne nouvelle. OpenMDW-1.1 autorise l’utilisation "without restriction," n’impose aucune limite aux sorties et ne comporte ni plafond d’utilisateurs ni politique d’utilisation acceptable. Vous conservez les mentions lors de la redistribution, et vos droits prennent fin si vous engagez une action en justice en affirmant que le modèle enfreint un brevet ou un droit d’auteur. Un commentateur Reddit l’a qualifiée de "an Apache styled license," ce qui est assez juste.
Comment l’exécuter ?
Vous avez plus d’options que pour la plupart des modèles dès leur sortie. NVIDIA et ses partenaires ont livré :
- Ollama :
ollama run nemotron-3.5-bolttélécharge la version de 25GB avec un contexte de 256K et une entrée image. Ollama propose aussi des commandes de lancement en une ligne pour Claude Code, OpenCode, Hermes Agent et OpenClaw. - llama.cpp : le propre GGUF de NVIDIA, plus un fichier distinct pour le modèle de proposition. NVIDIA indique que cette version est "optimized for use on RTX Spark with llama.cpp and DGX Spark with vLLM."
- vLLM : nécessite une version nightly et ne prend en charge que les GPU de génération Blackwell pour le moment.
- LM Studio, Unsloth et un snap Canonical complètent le tout.
Le véritable cas d’usage est l’intégration dans un environnement d’exécution d’agents locaux. NVIDIA propose de confier à Bolt des projets "from researching the web to writing to debugging code," sans envoyer le travail dans le cloud. Les utilisateurs qui l’apprécient le plus lui donnent une tâche bien délimitée avec un objectif final clair :
"I really don't hate this model. I was expecting to, it's a 2 bit quant for fucks sakes, but it seems to do really well when it's got some tools, a defined goal and a success condition such as 'compile works and tests pass'."
Que disent les premiers testeurs ?
L’accueil sur r/LocalLLaMA est favorable, avec des limites claires. Quatre thèmes sont revenus à plusieurs reprises.
L’astuce des 2 bits fonctionne mieux que prévu. Un commentateur a qualifié "74GB QAT coming in at 24GB on disk" de "pretty incredible" et a déclaré qu’il "has a decent chance of retiring Qwen3.6-35B for some people." Un autre l’utilise pour une tâche d’ingestion de fax au travail, où il a battu leur précédent modèle de vision en comparaison directe.
Il est en dessous du modèle dense Qwen 3.8 27B sur les tâches réelles. Le test le plus rigoureux que j’ai trouvé portait sur 33 tâches d’infrastructure exécutées sur une RTX 5090 :
"26 of 33 passed, with the LiLiCorr drafter on. On the same tasks the same day qwen3.8:27b passed 32, qwen3.6:27b 31, gemma4:31b and glm-4.7-flash 29, qwen3.6:35b and gemma4:12b 27."
Un deuxième testeur a exécuté 36 tâches à l’aveugle face à Gemma 31B et a trouvé Bolt "about 3.5 times faster, but it made up more problems that weren't there."
Il explore beaucoup. Le même testeur des 33 tâches a constaté que 54 % de ses appels d’outils étaient des vérifications exploratoires et des diagnostics, et l’a résumé ainsi : "Careful, and expensive in turns." Un autre utilisateur l’a vu ignorer l’instruction Docker de son fichier AGENTS.md.
La sécurité reste une vraie inconnue. Ce point est le plus important pour tout usage en contact avec les clients :
"It is not safe for an agent; it failed 6/21 jailbreak tests. Qwen3.8 Flash and 27 B failed none."
Il s’agit du test d’une seule personne, et une réponse dans le même fil apportait un contrepoint pertinent : "If you're relying on model weights to protect you from hostile content, you're doing it wrong." Les deux sont vrais.
Et Bolt E4B ?
Bolt E4B est celui à surveiller si vous concevez des produits vocaux ou des appareils. La page E4B de NVIDIA revendique "~40 % higher average quality" par rapport à son précédent modèle 4B et "up to ~80% fewer tokens vs peers," et cite "customer service" parmi ses usages d’assistant vocal. Il dispose d’un mode conversationnel qui garde les réponses suffisamment courtes pour être prononcées, et prend en charge 35 langues.
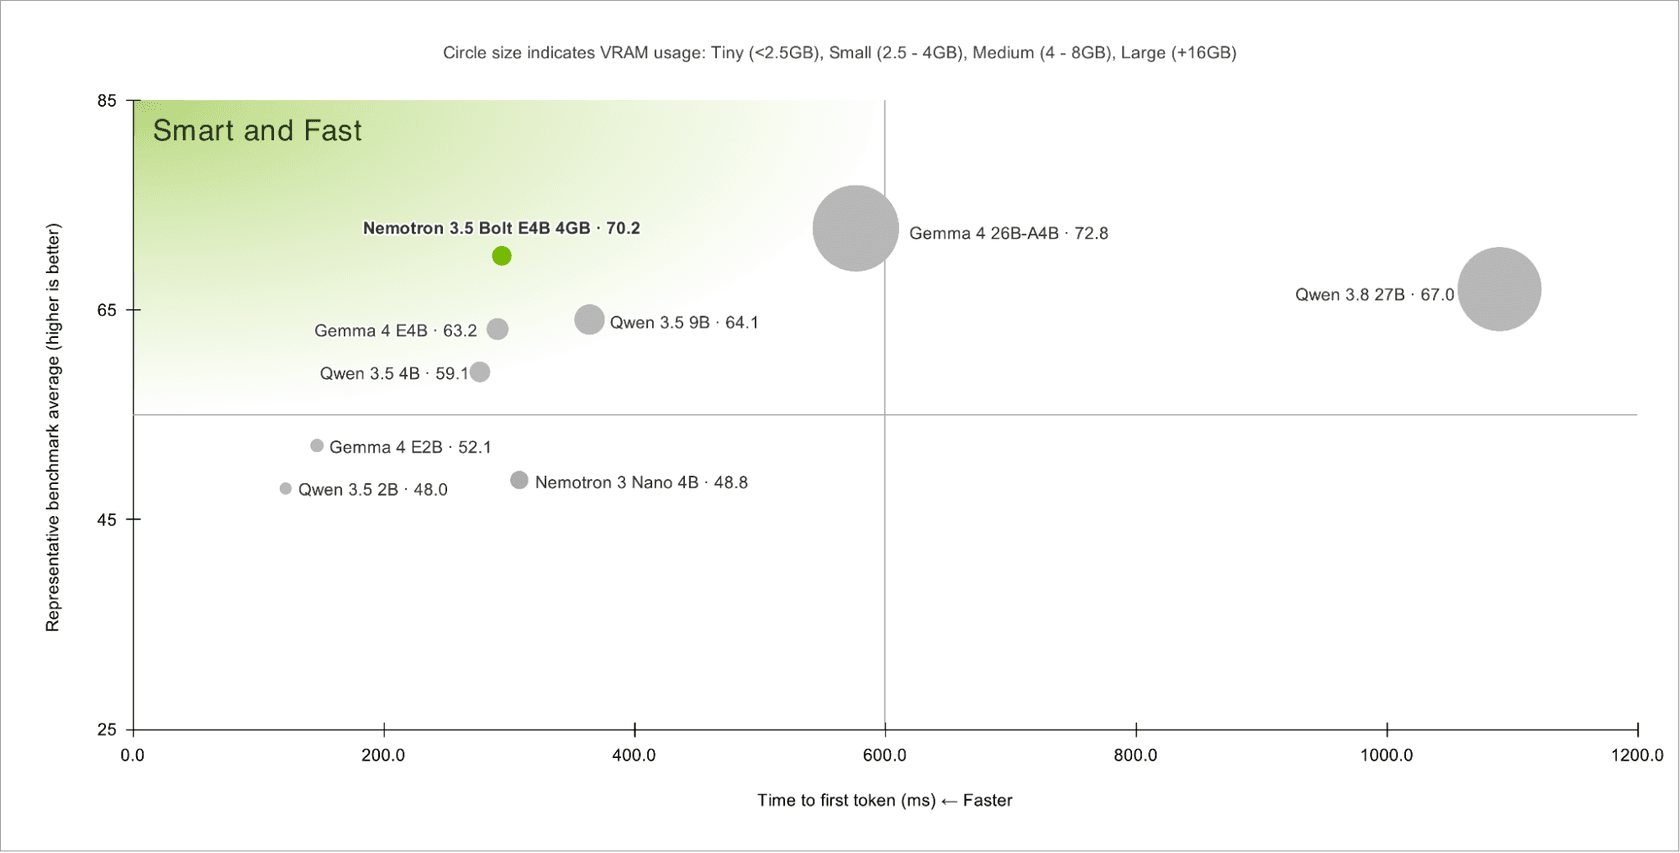
Il est rapide. Sur une RTX 5070, il renvoie son premier token en 548 millisecondes et atteint 133.4 tokens par seconde, en utilisant 3.5GB de mémoire vidéo. Même un Jetson Orin Nano parvient à 15.5 tokens par seconde.
Le tableau des benchmarks est globalement favorable, avec une ligne que les équipes de support devraient remarquer :
| Benchmark | Bolt E4B | Qwen 3.5 4B | Gemma 4 E4B |
|---|---|---|---|
| IHEval (hiérarchie des instructions) | 84,8 | 60,6 | 67,0 |
| RoleMRC | 80,6 | 65,8 | 74,6 |
| RAGTruth F1 | 77,6 | 75,6 | 77,0 |
| BFCL-v3 (appel d’outils) | 68,5 | 70,9 | 66,4 |
| Tau2-Bench (tâches clients) | 55,1 | 75,1 | 38,5 |
Qwen 3.5 4B le surpasse de 20 points sur Tau2-Bench, le benchmark qui simule un agent traitant les demandes des clients dans le respect d’une politique d’entreprise. Si vous développez un agent vocal pour le support client, testez les deux.
Nemotron 3.5 Bolt est-il adapté au support client ?
Il est bien adapté à une partie du support, et risqué pour celle à laquelle les gens pensent généralement.
Le bon côté : garder les données en interne. Un modèle qui fonctionne sur une seule machine avec une licence permissive répond clairement à la question « où vont nos données ? ». Pour les tâches internes, comme résumer les tickets, les classer ou rédiger des réponses qu’un agent vérifie, un Bolt local est un moteur raisonnable, et son score Tau3 Banking (17.01) surpasse tous ses homologues dans le tableau de NVIDIA.
Le côté risqué : répondre directement aux clients. Un score de 17 % sur un benchmark de service client bancaire reste faible dans l’absolu. Ajoutez un taux d’échec signalé de 6 sur 21 aux tests de jailbreak et une tendance à explorer avec des appels d’outils supplémentaires, et vous obtenez un modèle qui a besoin de beaucoup d’encadrement avant de parler à un client. Chaque message client est une entrée non fiable.
Ce que cet encadrement doit faire, c’est précisément ce sur quoi je passe mes journées. eesel a appris très tôt qu’un détail erroné est pire qu’une absence de réponse, c’est pourquoi chaque déploiement est simulé sur des tickets historiques avant qu’une IA ne réponde à un vrai client. L’un de nos clients dont nous avons publié le témoignage, une entreprise d’automatisation industrielle, utilise un chat qui répond à ses ingénieurs uniquement à partir de ses documents techniques et indique d’où vient chaque réponse. Ne pas trouver de réponse y est un résultat acceptable. C’est une propriété du système qui entoure le modèle, pas des poids. Notre guide pour prévenir les hallucinations de l’IA dans le support détaille davantage ces garde-fous.
Mon verdict : si vous avez des ingénieurs, un GPU NVIDIA de 24GB+ et une raison de garder les données en local, Bolt mérite un week-end d’essai. Ce n’est pas quelque chose que vous branchez sur votre file Zendesk AI le lundi. Si vous comparez plutôt des outils prêts à l’emploi, commencez par ma sélection de logiciels de support IA.
Qui devrait utiliser Nemotron 3.5 Bolt ?
Voici comment je ferais mon choix :
- Vous exécutez des agents locaux de programmation ou de recherche sur un seul GPU. C’est exactement ce pour quoi Bolt 74B a été conçu. Donnez-lui des outils et un critère de réussite clair.
- Vous devez garder les données hors du cloud. Des données réglementées, un contrat qui interdit les prestataires de traitement IA externes ou un ordinateur portable dans un avion. La licence et l’empreinte de 24GB rendent ce choix facile à justifier.
- Vous concevez des produits vocaux, des jeux ou des appareils. Bolt E4B est rapide, petit et concis par conception.
- Vous voulez le modèle le plus intelligent qui tient dans 24GB. Regardez d’abord Qwen3.8 27B, et acceptez qu’il soit environ 3x plus lent. Ou choisissez une solution hébergée avec Qwen3.8 Flash-Next ou DeepSeek V4 Flash.
- Vous avez besoin d’une API hébergée cette semaine. Bolt n’en a pas. Utilisez plutôt Nemotron 3.5 Super VL, qui est disponible sur OpenRouter.
Essayez eesel
Nemotron 3.5 Bolt, c’est de l’infrastructure : des poids gratuits, un GPU et un week-end de configuration. Il vous resterait à construire la recherche d’informations, les règles d’escalade, les tests et la piste d’audit. eesel, c’est l’employé. Notre coéquipier IA pour le support se connecte à Zendesk, Freshdesk, Gorgias et aux autres outils, apprend à partir de vos anciens tickets et de votre centre d’aide, et répond uniquement à partir de vos propres connaissances. Avant qu’il ne réponde à un seul client, vous pouvez le tester sur des centaines de vos tickets historiques et voir ce qu’il aurait dit.
C’est ainsi que Dokument 24 l’utilise sur Zendesk : en un mois, le coéquipier a préparé 680 tickets pour l’équipe et laissé 670 brouillons de réponse en danois sous forme de notes internes, prêts à être envoyés ou modifiés.

Si vous aimez piloter des agents depuis un terminal comme vous le feriez avec un modèle local, l’eesel CLI permet de piloter ce même coéquipier. Vous pouvez lire et modifier ses instructions permanentes, lister les actions en attente d’une approbation humaine et consulter le journal d’activité de chaque exécution, avec une sortie JSON et des simulations pour les opérations d’écriture, afin qu’un agent de programmation comme Claude Code puisse gérer votre coéquipier de support aux côtés de votre dépôt. Si vous rédigez du contenu plutôt que de répondre aux tickets, la même équipe comprend un rédacteur de blog IA.
Vous pouvez commencer gratuitement. Essayez eesel sur les tickets du mois dernier avant d’acheter une carte de 24GB pour cet usage, et consultez les forfaits sur la page des tarifs.