

Qu'est-ce que Mistral Large 4 ?
Je construis des agents IA pour gagner ma vie chez eesel, donc chaque lancement de pointe atterrit sur mon bureau avec la même question : les agents d'eesel devraient-ils tourner dessus ? Avec Mistral Large 4, la réponse honnête est « pas encore, mais à surveiller », et les raisons sont plus intéressantes que ce que suggère le graphique de benchmarks.
Mistral le décrit comme son « largest and most capable model to date ». Selon l'article de lancement, il a été entraîné sur 3,800 GPU NVIDIA Grace Blackwell dans les propres centres de données européens de Mistral, et c'est aussi la première étape de la feuille de route que finance la Série D de €3 milliards de Mistral. Si vous avez besoin d'un rappel sur l'entreprise, mon aperçu de Mistral AI couvre l'historique, et le panorama des avis sur Mistral AI montre ce que les utilisateurs pensent des anciens modèles.
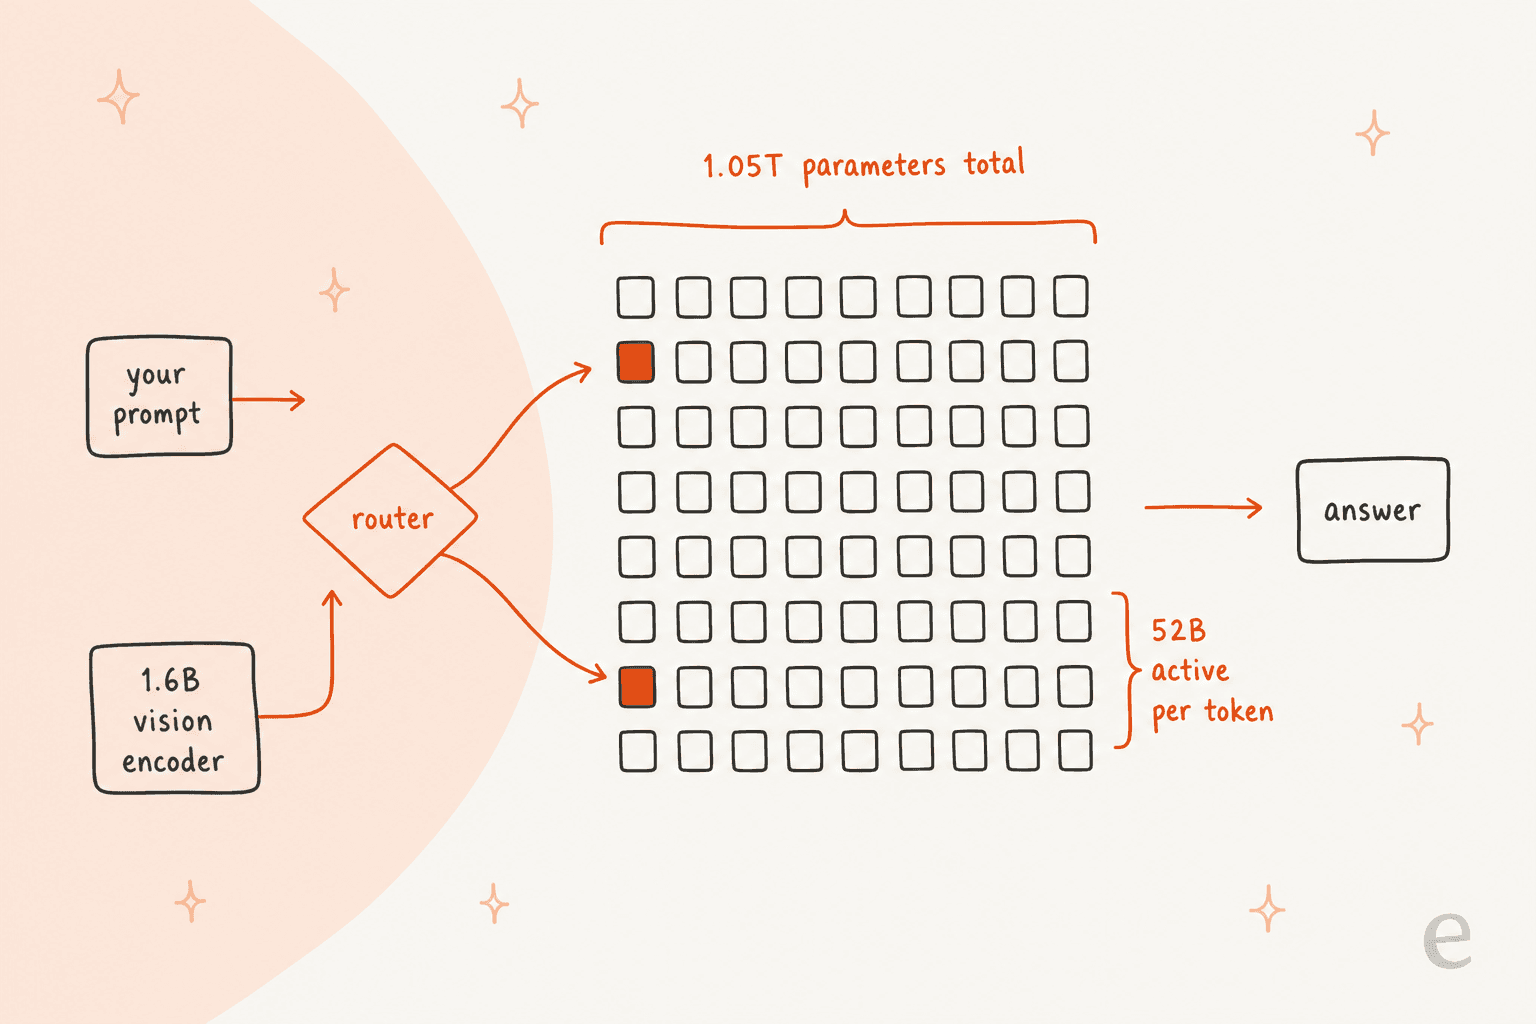
Voici les specs qui comptent, tirées directement de la fiche modèle de la documentation :
| Spécification | Mistral Large 4 |
|---|---|
| Sortie | 6 octobre 2026, préversion publique (v26.10) |
| Architecture | Mélange d'experts granulaire, hybride instruction et raisonnement |
| Paramètres | 1.05T au total, 52B actifs, plus un encodeur de vision de 1.6B |
| Fenêtre de contexte | 1M de tokens |
| Entrée | Texte et images |
| ID du modèle dans l'API | mistral-large-4 |
| Fonctionnalités | Function calling, sorties structurées, document QnA, batching, Agents API, outils intégrés |
| Poids | Promis d'ici fin octobre 2026, licence pas encore nommée |
| Langues d'entraînement | 160+, dont toutes les langues officielles de l'UE |
Il y a un petit accroc côté chiffres : la fiche de la documentation indique 52B de paramètres actifs, alors que le propre article de lancement sur X de Mistral dit 49B. Artificial Analysis liste aussi la fenêtre de contexte à 524,288 tokens, la moitié du 1M de la fiche, donc je planifierais avec le plus petit chiffre jusqu'à ce que Mistral clarifie.
Comment fonctionne Mistral Large 4 sous le capot
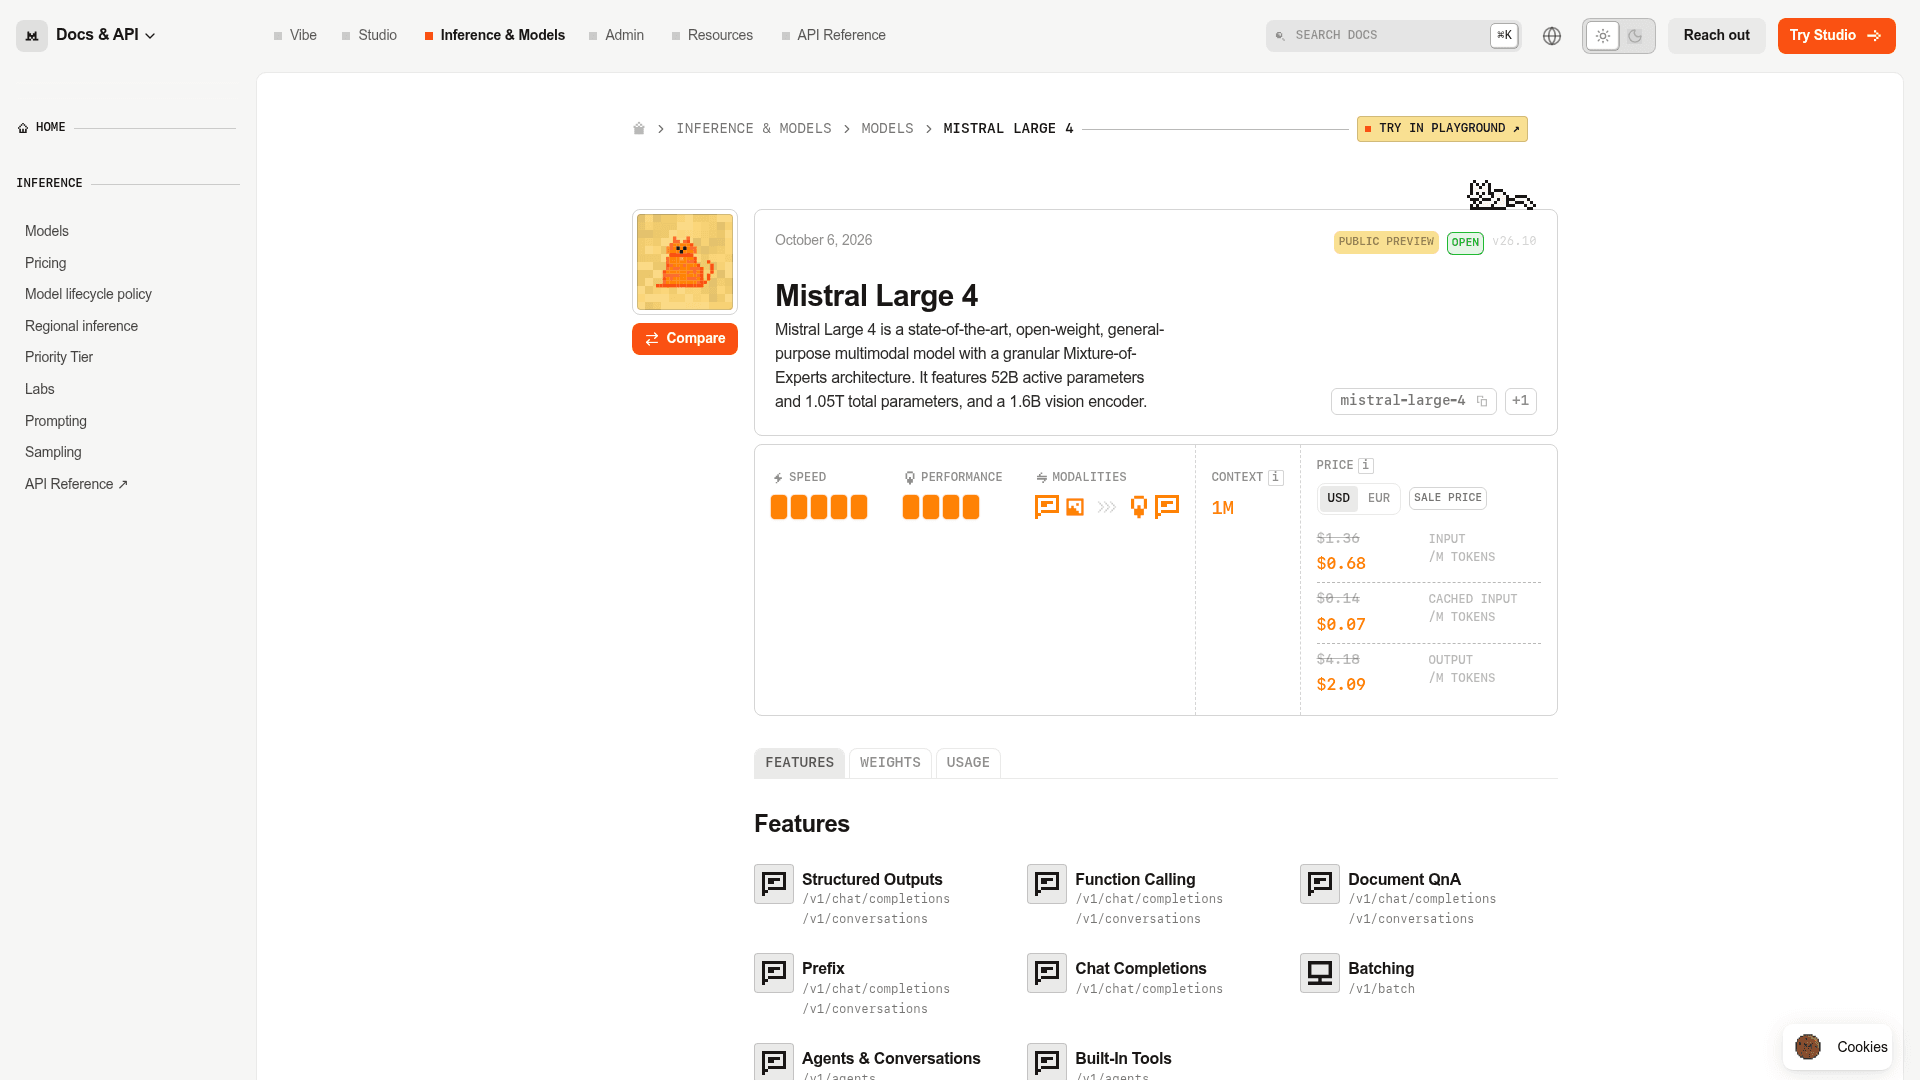
Le chiffre phare, 1.05T de paramètres, est un peu trompeur s'il est regardé seul. Mistral Large 4 est un modèle à mélange d'experts : un routeur choisit une petite portion du réseau pour chaque token, de sorte que seulement environ 5% des poids (52B) travaillent sur un token donné. C'est pourquoi le modèle peut être énorme et pourtant raisonnablement rapide. Artificial Analysis a mesuré 116.1 tokens de sortie par seconde sur l'API de Mistral, bien au-dessus de la médiane de 77.0 des modèles de raisonnement à prix similaire.
C'est aussi un modèle hybride : vous pouvez l'utiliser comme simple modèle d'instruction ou activer le raisonnement avec le paramètre reasoning_effort montré dans l'exemple de la documentation. Le raisonnement est l'endroit où se cachent coût et latence (chaque étape de réflexion est facturée comme des tokens de sortie), et j'y reviendrai plus loin, car c'est la chose la plus importante à comprendre avant de le placer devant des clients.
L'autre choix de conception qui mérite d'être connu : Mistral l'a entraîné sur sa propre infrastructure et sert la préversion depuis le même endroit, y compris « a European deployment that Mistral operates end-to-end ». Pour les équipes soumises aux règles de données de l'UE, cela compte plus que n'importe quel benchmark. Cela pèse aussi dans les revues SOC 2 et RGPD, où l'une des premières questions porte généralement sur l'endroit exact où tourne le modèle.
Tarifs de Mistral Large 4
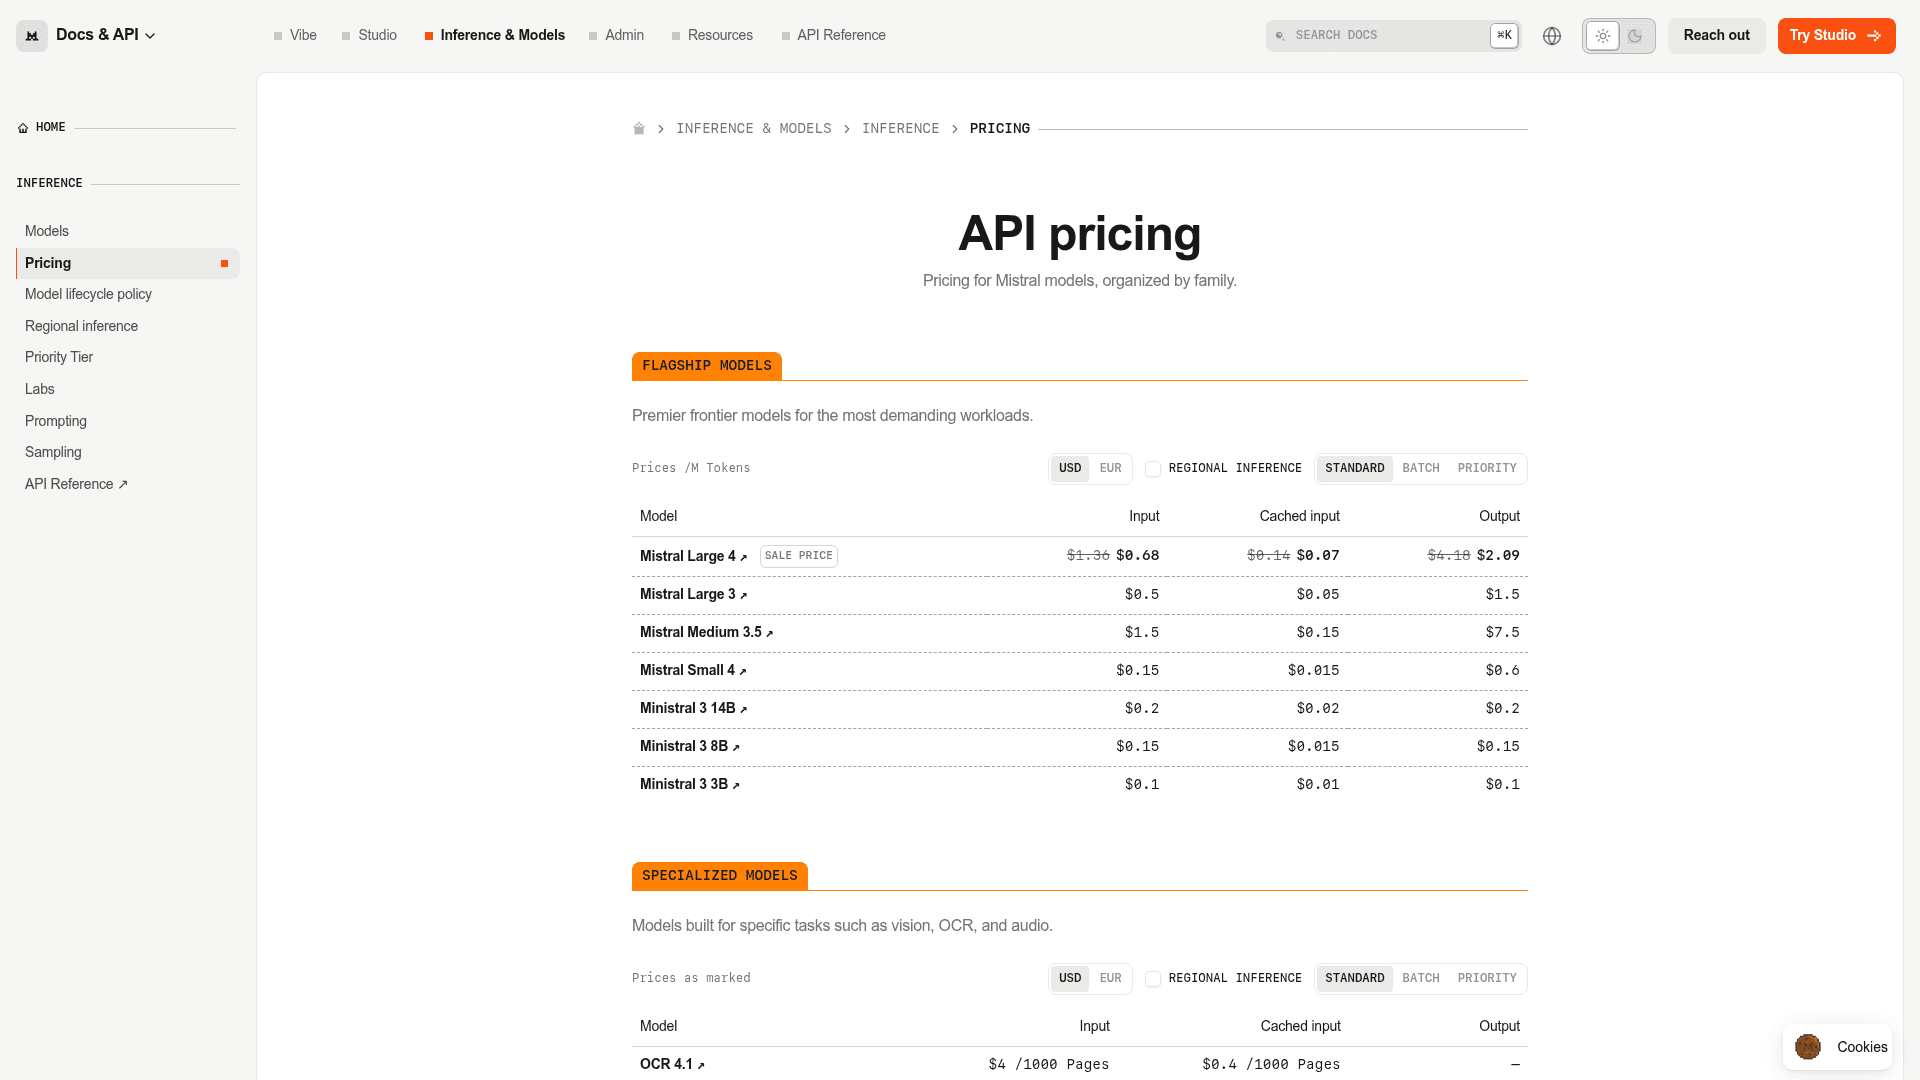
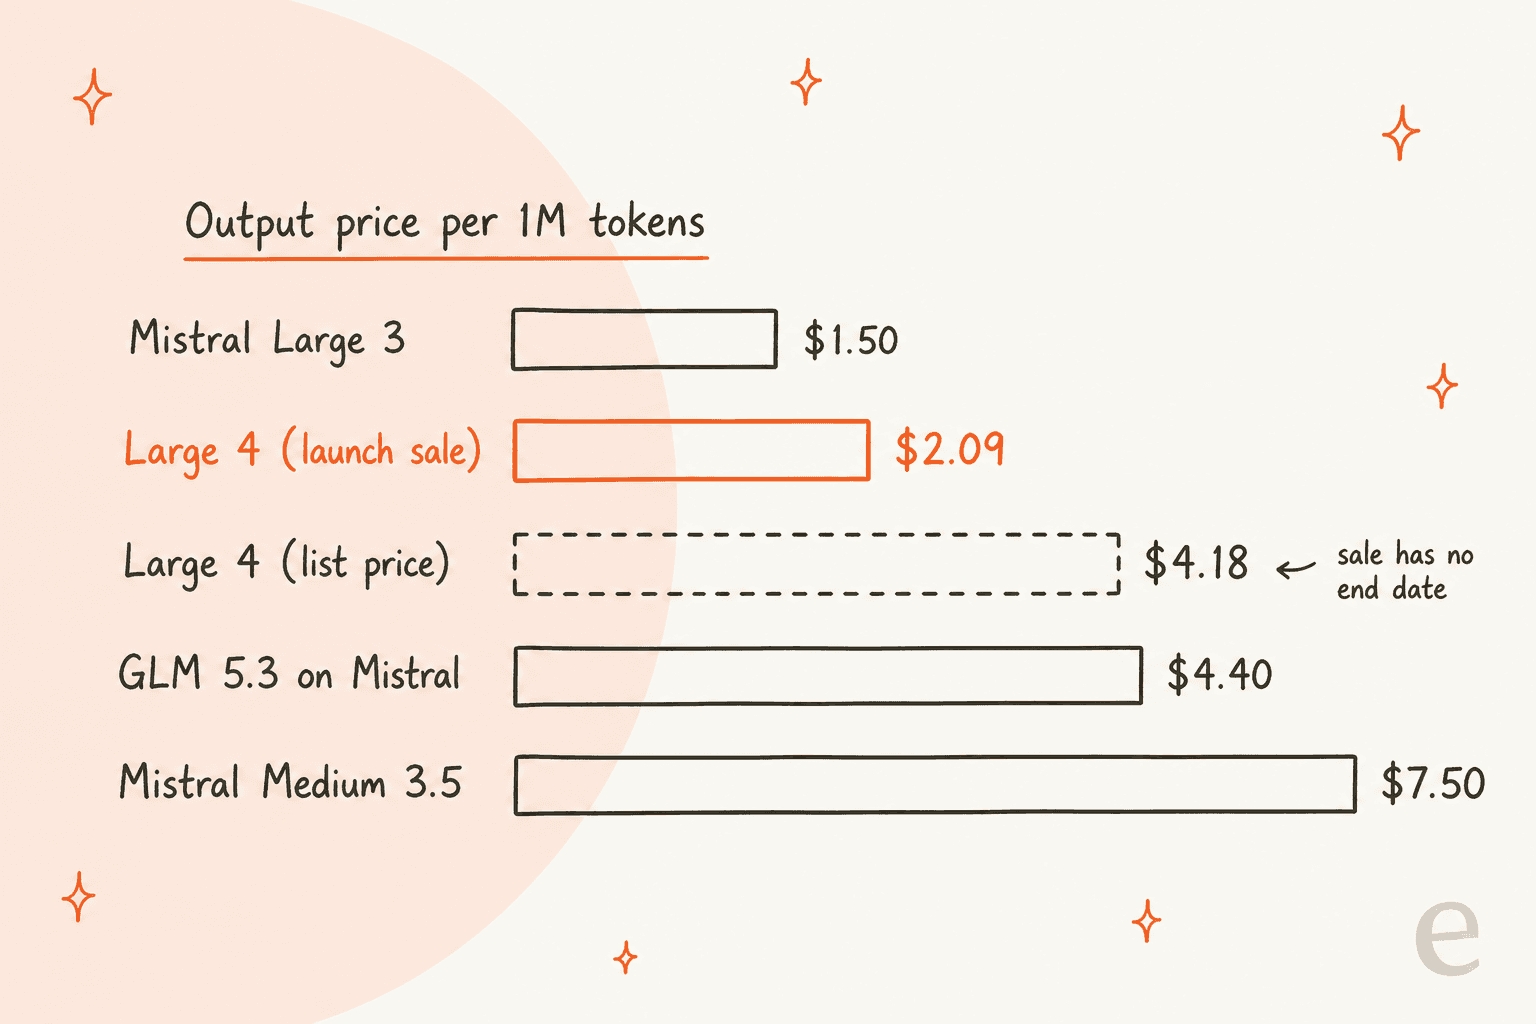
Mistral Large 4 est facturé au token via l'API, et il y a actuellement une offre de lancement, exactement à moitié prix du tarif catalogue. La page des tarifs de l'API affiche les deux :
| Modèle (par 1M de tokens) | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| Mistral Large 4 (offre de lancement) | $0.68 | $0.07 | $2.09 |
| Mistral Large 4 (prix catalogue) | $1.36 | $0.14 | $4.18 |
| Mistral Large 3 | $0.50 | $0.05 | $1.50 |
| Mistral Medium 3.5 | $1.50 | $0.15 | $7.50 |
| Mistral Small 4 | $0.15 | $0.015 | $0.60 |
| GLM 5.3 (hébergé par Mistral) | $1.40 | $0.14 | $4.40 |
Trois choses me frappent :
- L'offre n'a pas de date de fin. Au prix catalogue, la sortie coûte 2.8x ce que coûtait Large 3. Budgétez sur $1.36 / $4.18, puis considérez l'offre comme un bonus.
- Il passe sous le Medium 3.5 de Mistral lui-même. En promotion, la sortie de Large 4 est à $2.09 contre $7.50 pour Medium 3.5, il y a donc peu de raisons de rester sur Medium pour tout nouveau travail.
- Le batch est encore moins cher. La FAQ tarifaire de Mistral indique que les requêtes batch coûtent 50% de moins et l'entrée en cache jusqu'à 90% de moins.
Si vous préférez l'utiliser comme application de chat plutôt que via une API, il se trouve dans le produit grand public de Mistral, désormais appelé Vibe (anciennement Le Chat) : Free à $0, Pro à $14.99/mois, Team à $24.99/utilisateur/mois et Enterprise sur demande. La page des tarifs ne précise pas quelles offres Vibe incluent Large 4, il vaut donc mieux le vérifier avant d'acheter un siège pour lui. Mon guide complet des tarifs de Mistral AI détaille les offres.
Ce que coûte une réponse de support sur Large 4
Les prix au token sont plus faciles à juger avec une charge de travail réelle. Supposons qu'une réponse de support lise 8,000 tokens d'entrée (le fil du ticket plus quelques articles du centre d'aide ramenés par RAG) et écrive 3,000 tokens de sortie, raisonnement compris. Au prix promotionnel, cela fait environ $0.012 par réponse, et au prix catalogue environ $0.023.
C'est bon marché, et c'est pourquoi je dirais à la plupart des équipes de support que le prix au token est rarement le poste qui décide d'un déploiement de support IA. Les mauvaises réponses et les heures passées à surveiller le bot coûtent bien plus, ce qui est aussi le thème de mon décryptage du coût d'un agent de support IA.
Benchmarks de Mistral Large 4 : graphiques de Mistral vs tests indépendants
Mistral a publié beaucoup de graphiques pour ce lancement, et ils méritent une lecture attentive, car ils sont honnêtes d'une façon un peu inhabituelle. Les propres graphiques de Mistral montrent des rivaux battant Large 4 sur quatre des six benchmarks que j'ai pu lire.
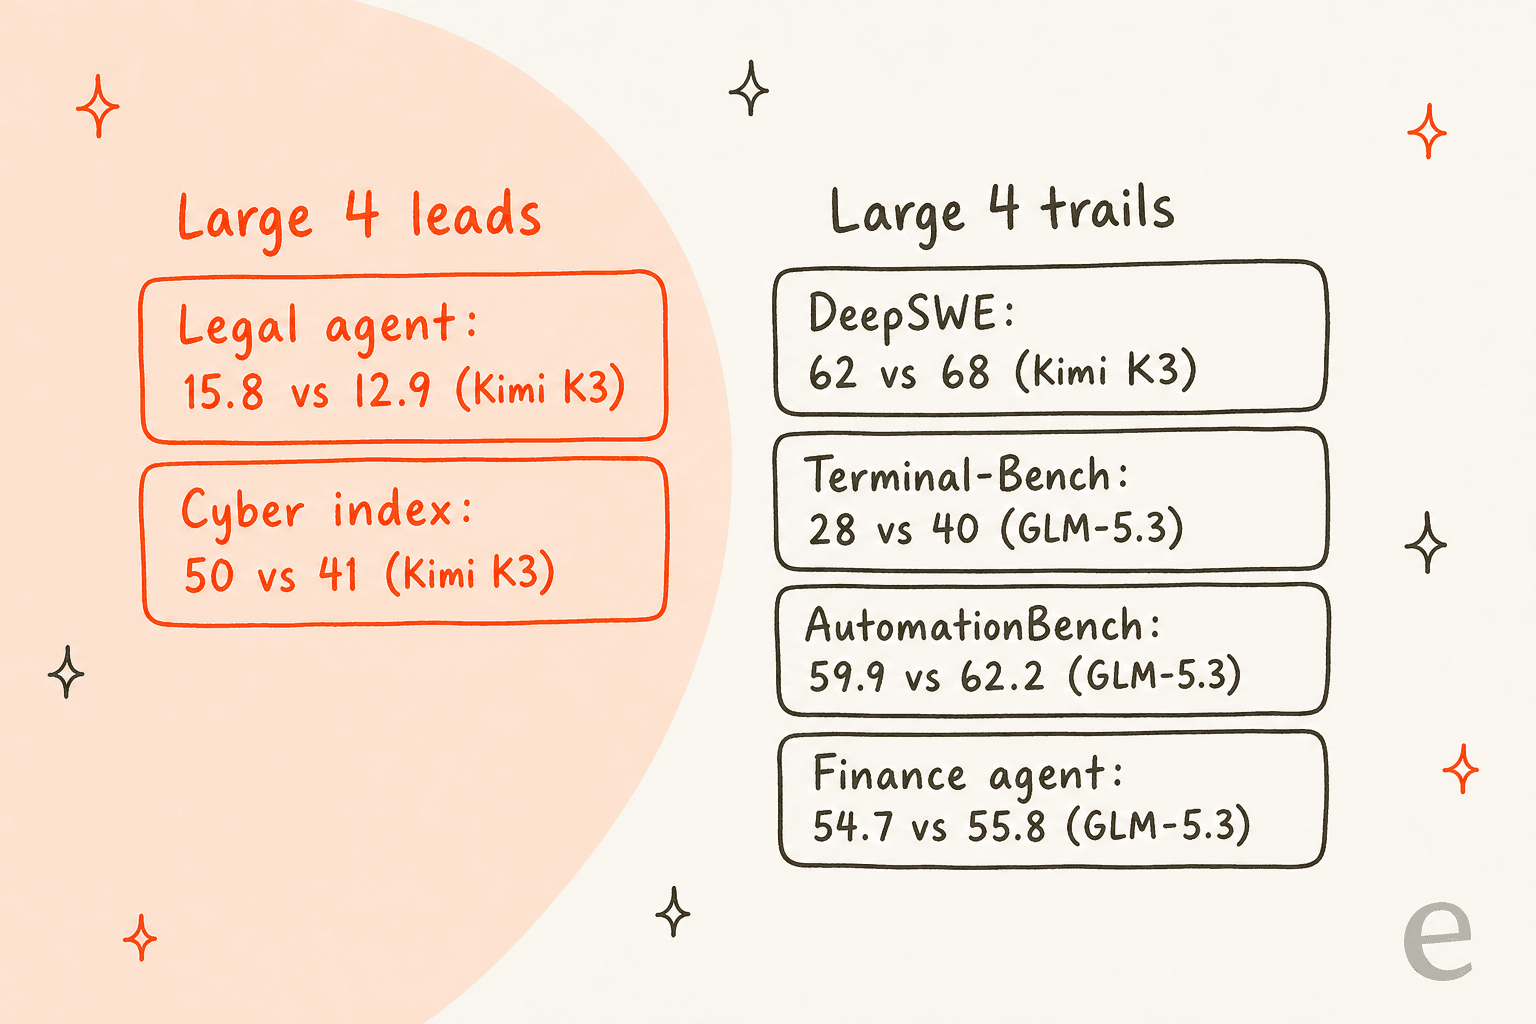
En programmation, il obtient 61.7% sur DeepSWE v1.1, puis 28.3% sur Terminal-Bench 4. Kimi K3 est plus haut sur DeepSWE (68), et GLM-5.3 est plus haut sur Terminal-Bench (40), deux chiffres issus des graphiques de Mistral.
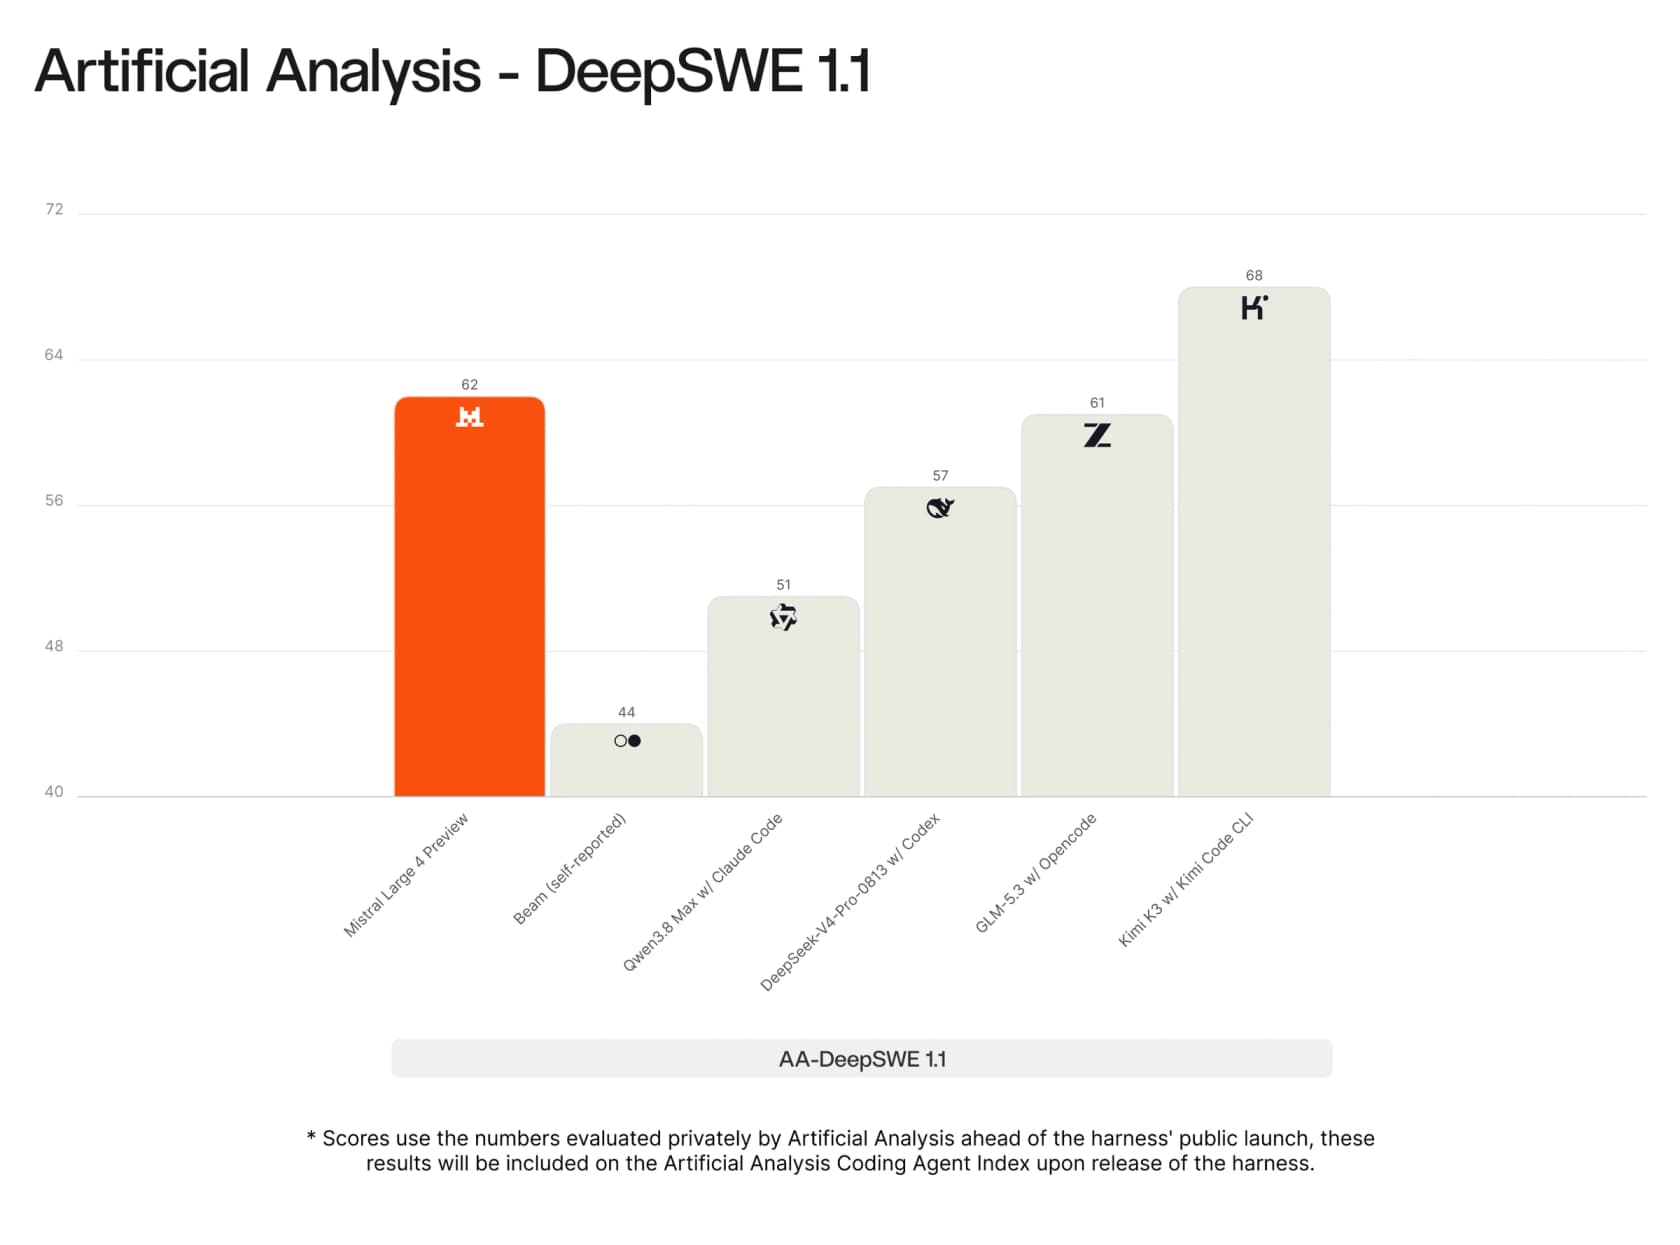
Le tableau indépendant d'Artificial Analysis va dans le même sens. Voici où se place Large 4 sur leur Intelligence Index, avec le coût pour terminer une tâche du benchmark :
| Modèle | AA Intelligence Index | Prix entrée / sortie par 1M | Coût par tâche |
|---|---|---|---|
| Claude Sonnet 5.5 (Max) | 56.0 | $2 / $10 | $5.46 |
| Qwen 3.8 Max | 45.4 | $2 / $6 | $5.41 |
| Kimi K3 (Max) | 43.6 | $3 / $15 | $2.00 |
| Claude Haiku 5.5 (Max) | 43.4 | $0.10 / $0.50 | $0.21 |
| Gemini 3.8 Flash (High) | 40.9 | $0.75 / $3.75 | $1.24 |
| DeepSeek V4.1 Flash (Max) | 39.5 | $0.30 / $1.20 | $0.27 |
| Mistral Large 4 Preview | 38.4 | $1.36 / $4.18 | $1.13 |
| GPT-5.6 Luna (Max) | 37.3 | $0.20 / $1.20 | $0.18 |
| DeepSeek V4 Pro (Max) | 36.0 | $1.32 / $3.96 | $0.67 |
| Mistral Large 3 | 9.3 | $0.50 / $1.50 | $0.03 |
Il y a deux lectures de ce même tableau, et les deux sont vraies. Par rapport au passé de Mistral, Large 4 est un bond de génération : 4.1x le score de Large 3. Par rapport au peloton actuel, il est derrière Kimi K3 et Qwen 3.8 Max, juste sous DeepSeek V4.1 Flash et juste au-dessus de GPT-5.6 Luna, qui coûtent tous deux une fraction par tâche.
La raison tient à l'appétit en tokens. Artificial Analysis a compté 69,330 tokens de sortie par tâche pour Large 4, dont 52,011 de raisonnement. Large 3 en utilisait 5,566. Un modèle de raisonnement qui réfléchit autant transforme un prix par token modéré en prix élevé par tâche.
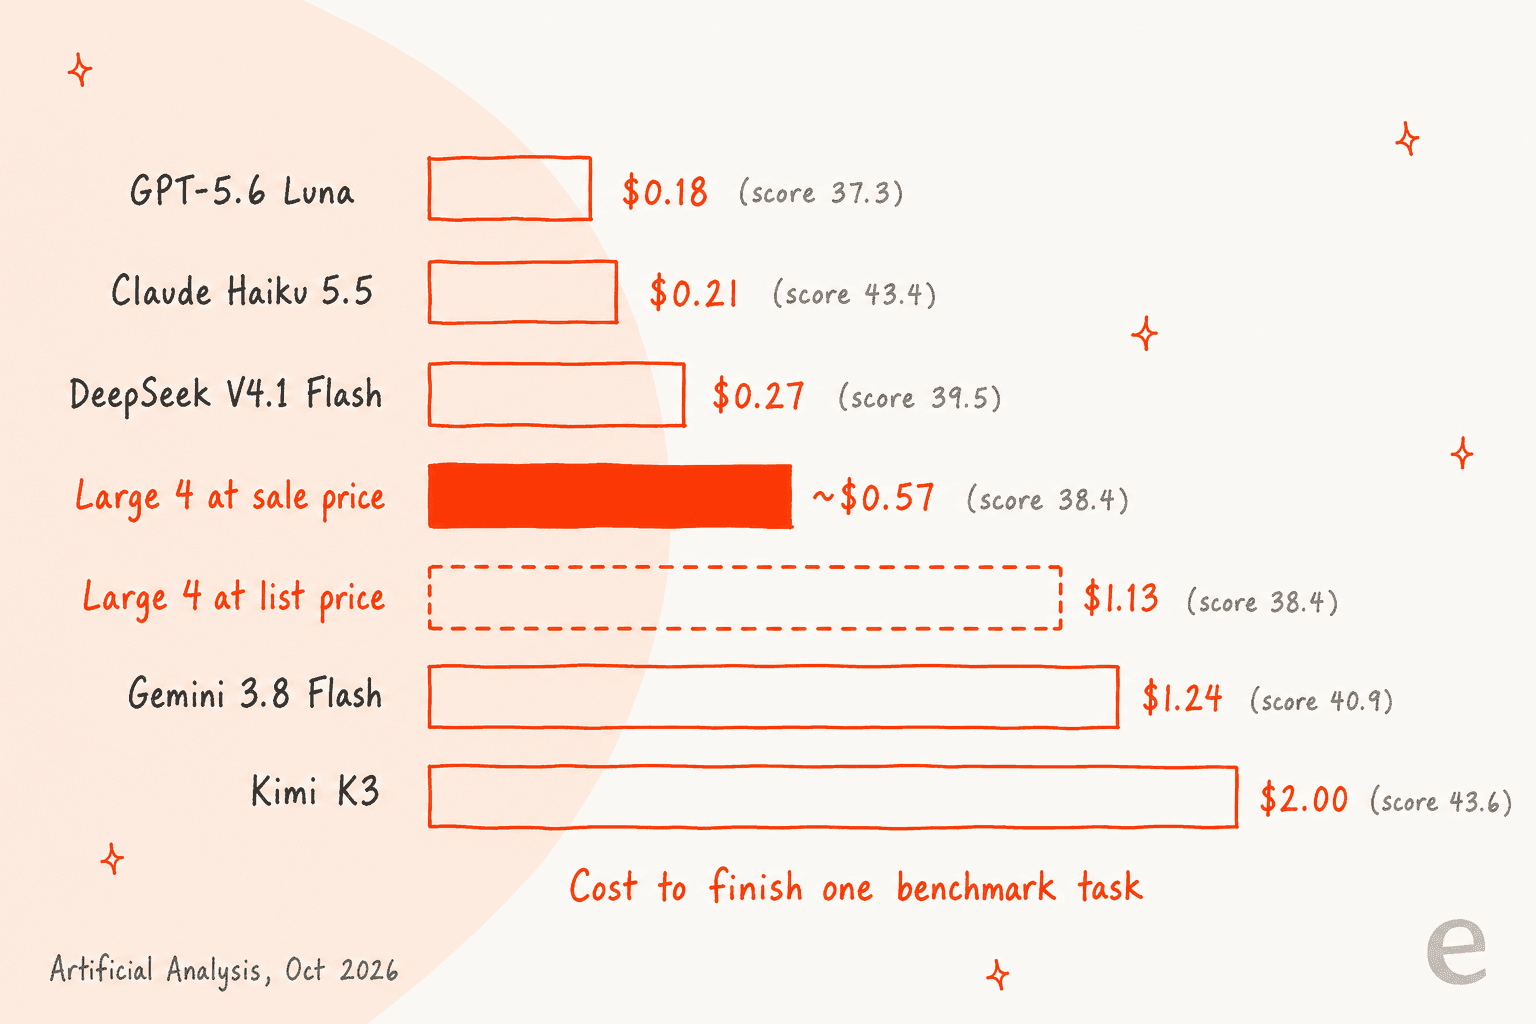
Artificial Analysis chiffre ses essais aux tarifs catalogue, et comme l'offre divise chaque tarif par deux, y compris l'entrée en cache, le prix promotionnel revient à environ $0.57 par tâche. C'est encore environ 2x DeepSeek V4.1 Flash pour un score légèrement inférieur. Si vous comparez des modèles ouverts sur le coût, mes articles sur les tarifs de DeepSeek V4 Flash et les tarifs de Kimi K3 donnent les grilles complètes.
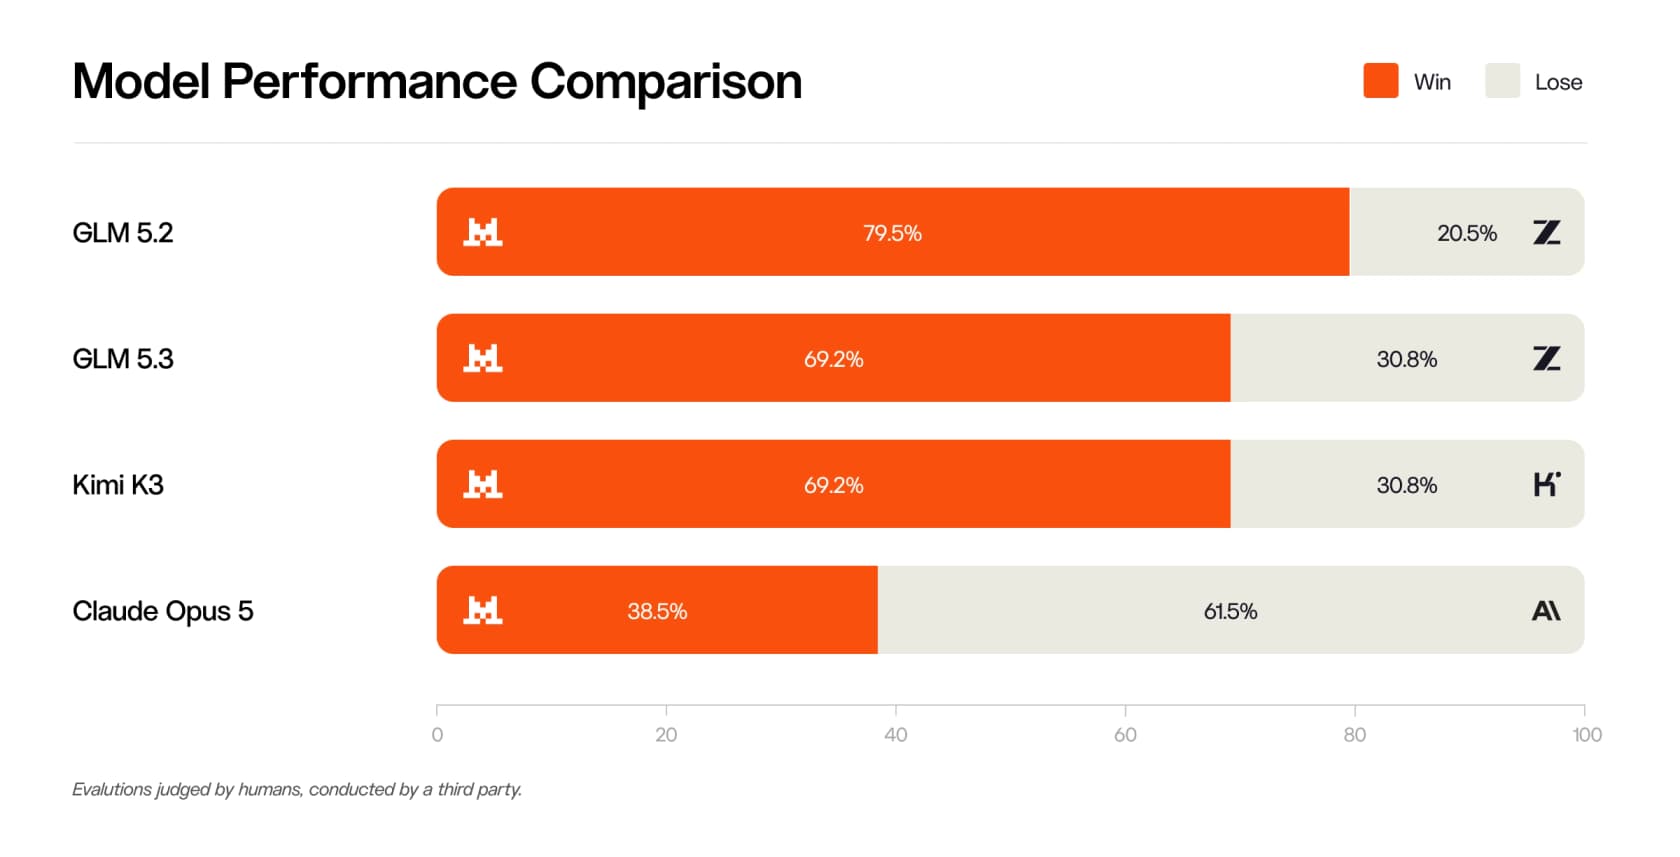
Les évaluateurs humains racontent une histoire plus clémente que l'index. Dans les évaluations humaines de Mistral, menées par un tiers, Large 4 a gagné 69.2% des duels face à GLM-5.3 comme face à Kimi K3, et 38.5% face à Claude Opus 5.
Où Mistral Large 4 est le plus fort
Si l'on met de côté l'index global, une forme claire apparaît : Large 4 n'est pas le meilleur généraliste, mais il mène à quelques endroits précis.
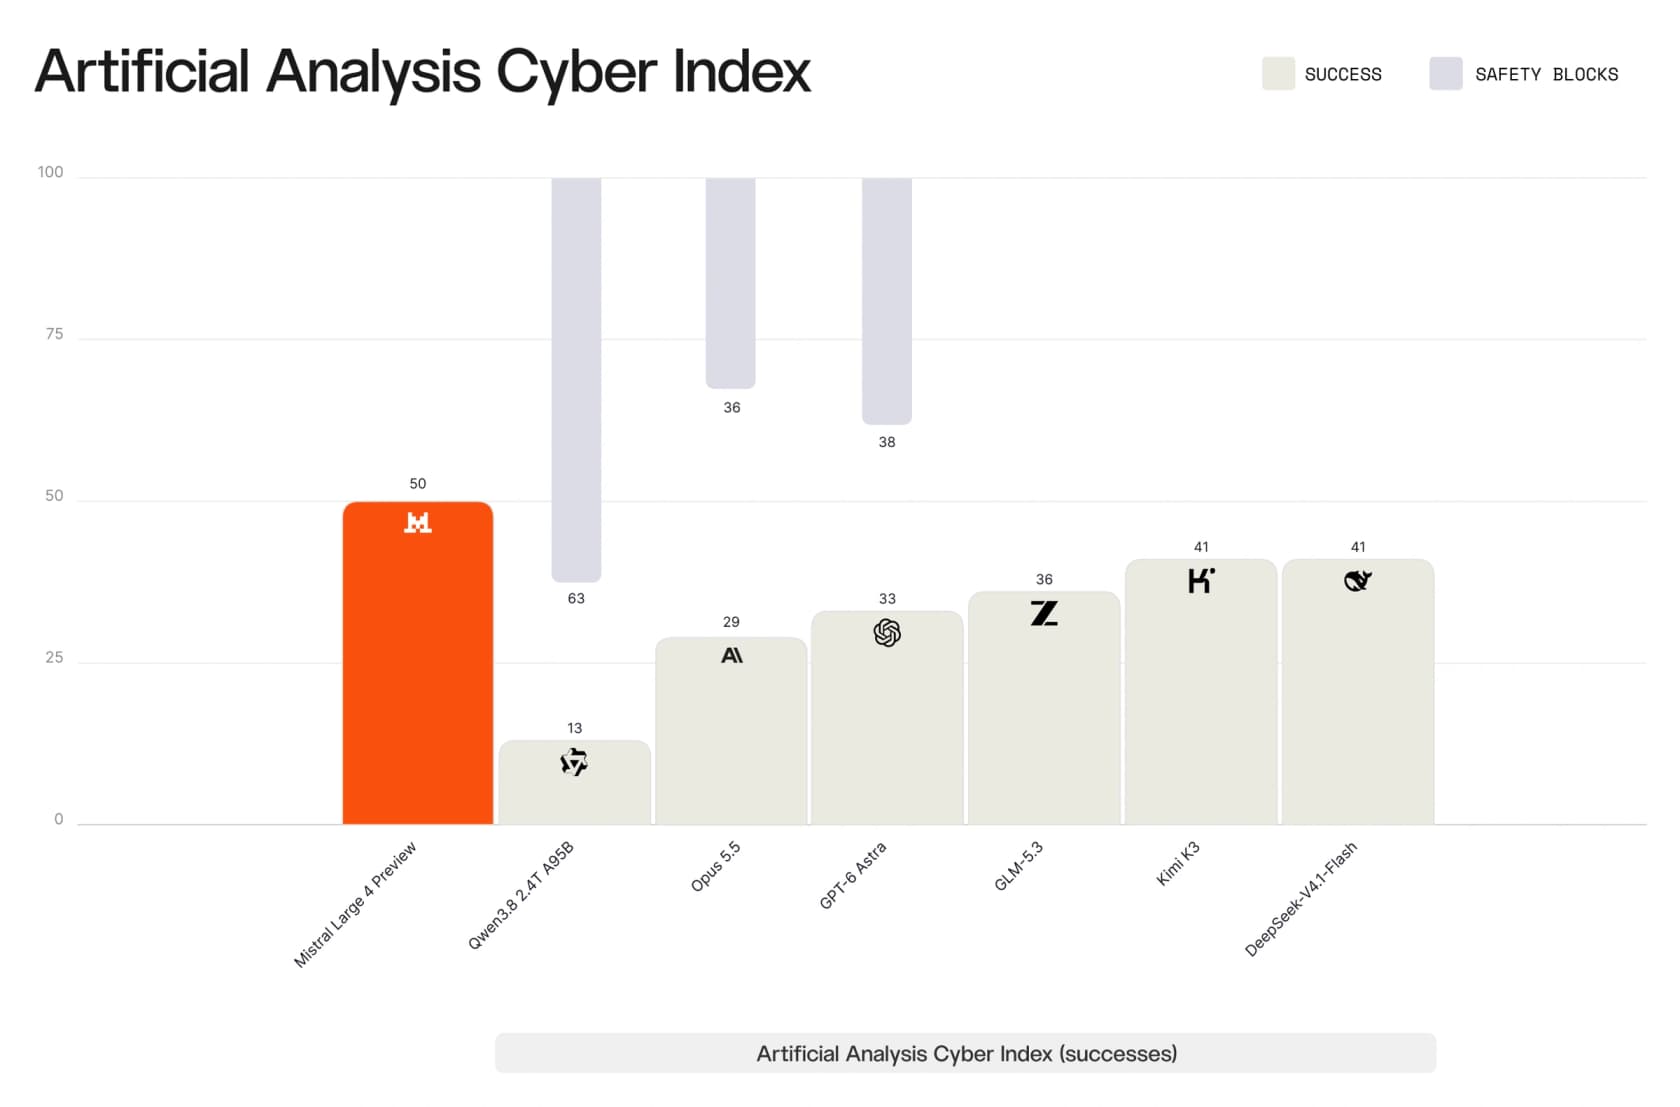
Cyberdéfense. C'est l'argument phare, et les chiffres le confirment. Large 4 a obtenu 50 à l'Artificial Analysis Cyber Index, devant Kimi K3 à 41, GPT-6 Astra à 33 et Claude Opus 5.5 à 29, d'après l'article de lancement de Mistral. Il a atteint 82% sur un test de reproduction puis correction et 93% sur Cybench. Sur ce test de correction, Mistral note que les modèles fermés de pointe « score near zero on the same test because they refuse », donc une partie de l'avance tient à la volonté, pas à la compétence.
Le cofondateur de Mistral Guillaume Lample a défendu directement cette idée :
"Open models are the best defense for enterprises today: capable, auditable, self-hosted and governed under enterprise policies -- and more importantly, they do not refuse to help."
Travail d'agents juridiques. Sur le benchmark Harvey Legal Agent de Vals.ai, il a obtenu 15.8, devant Kimi K3 à 12.9 et GPT-6 Astra à 5.4. Les chiffres absolus sont bas, mais l'avance est nette.
Longs documents et graphiques. Il a obtenu 81.3% au test de raisonnement en contexte long d'Artificial Analysis (AA-LCR) et 42% sur Dense 200 visual grounding, devançant de peu les 41% de GPT-6 Astra. L'équipe data de Plotly a observé la même chose en pratique (plus bas).
Sécurité sous attaque. Il a résisté à 93.3% des attaques sur le benchmark de sécurité d'agents Lakera B3, le meilleur score que Mistral ait rapporté parmi ses concurrents.
Ce que dit la communauté sur Mistral Large 4
Le fil de lancement sur Hacker News a atteint 1,990 points et 1,144 commentaires, et l'ambiance est partagée à peu près comme le suggère le tableau de benchmarks : les gens sont impressionnés par le bond mais pas convaincus qu'il batte le peloton.
Le test pratique le plus utile est venu de quelqu'un chez Plotly qui l'a lancé sur leur benchmark d'analyse de données :
"It's 10x cheaper than Mistral Medium 3.5 from April and goes from 58% to 74% correct. Definitely a generational shift. It's not on the Pareto curve yet, but it's good enough for data analytics"

Le prix est revenu souvent dans les réponses. Un commentateur l'a mis face aux modèles « flash » moins chers :
"So, I think it would have to be significantly better than GLM 5.3-flash to be worth it. GLM 5.3-flash is already very good."
Pour le face-à-face avec les modèles fermés, mes comparatifs Claude vs Mistral et ChatGPT vs Mistral sont une bonne lecture suivante.
Reddit a été plus dur. Sur r/LocalLLaMA, un utilisateur qui fait tourner son propre benchmark d'échecs a écrit :
"Played around with it a bit, for code analysis, image classifications, and chess capability. Feels quite dated and far behind what I usually utilize."

Et pourtant l'argument de la souveraineté revient sans cesse, c'est celui que je prendrais le plus au sérieux pour les acheteurs en entreprise :
"In most corporate workflows, it is probably good enough. And you don't have to sell your soul to Xi or Trump. As a european, I had feared much worse."
La réponse la plus aimée à l'article de lancement de Mistral sur X était une blague qui en dit long sur le cadrage « open weights » : "me with 12 GB of VRAM reading 'open weights, 1.05T parameters'" (An Xuan sur X). Ce qui m'amène à la partie qui, pour l'instant, n'est encore qu'une promesse.
Open weights : ce que « ouvert » signifie aujourd'hui
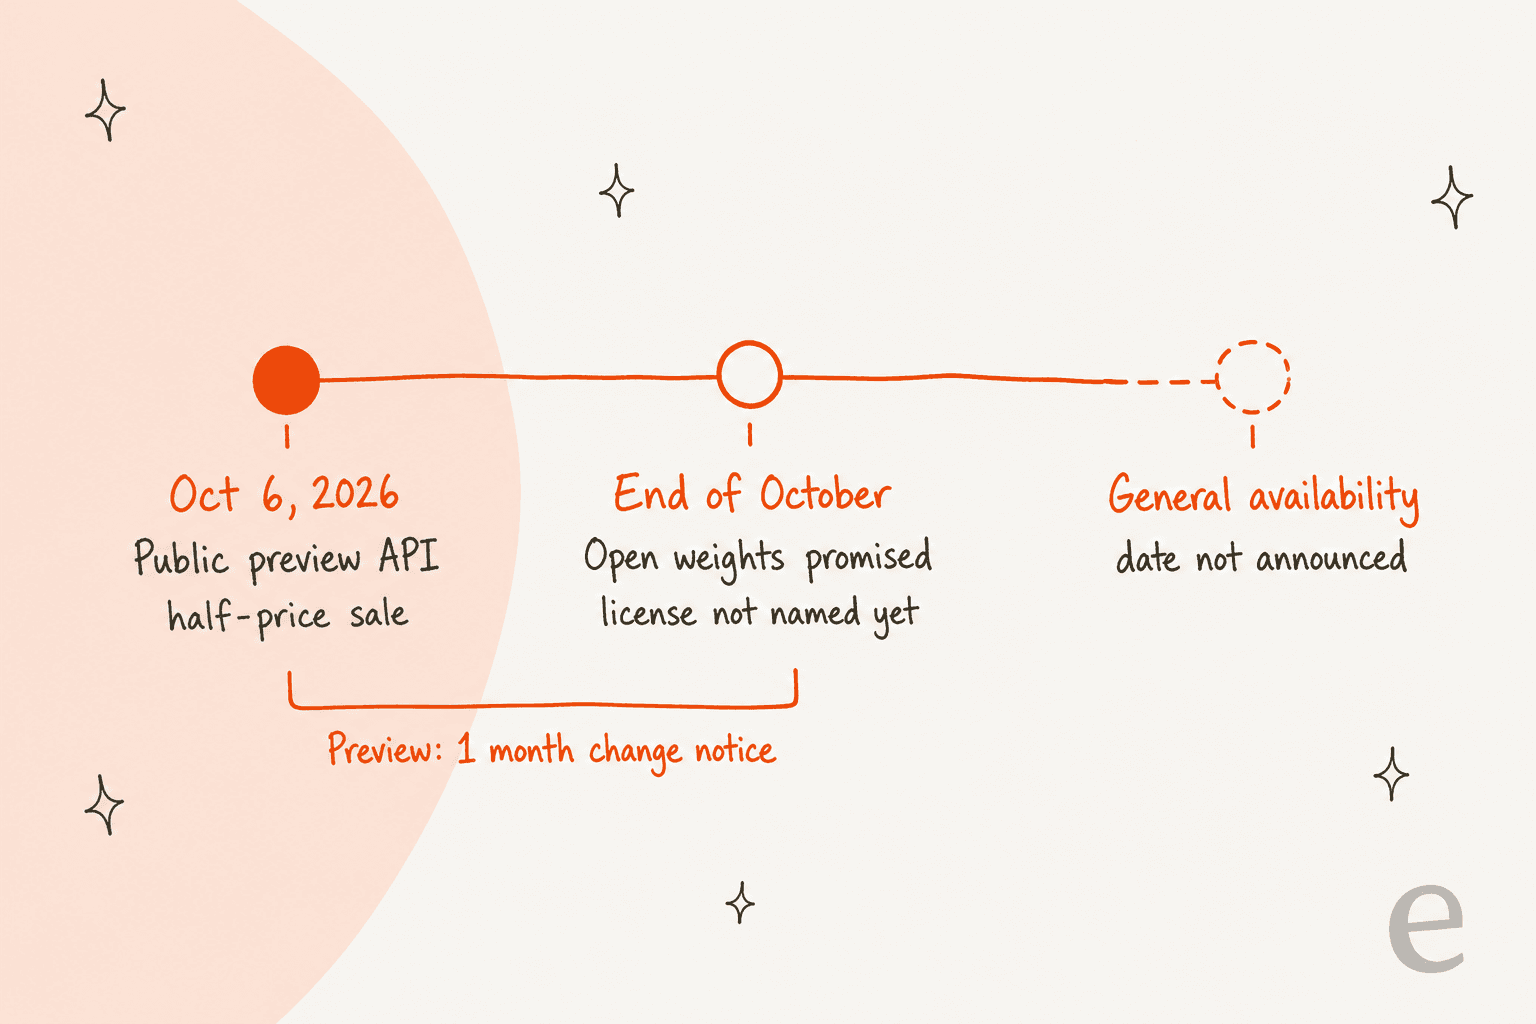
Mistral étiquette Large 4 comme open-weight, mais au 8 octobre 2026 vous ne pouvez pas le télécharger. Il n'y a pas de dépôt Mistral Large 4 sur la page Hugging Face de Mistral, et aucune licence n'a été nommée. Lample dit que l'entraînement RL "is still in flight" et qu'une version finale sortira avec les poids avant la fin du mois.
Cela a deux conséquences pratiques pour vous :
- Les benchmarks peuvent bouger. Le modèle que vous testez aujourd'hui est une préversion, et la politique de cycle de vie de Mistral ne donne aux modèles en Public Preview qu'un mois de préavis avant changement, contre six mois pour la disponibilité générale. Relancez vos évaluations quand la version finale arrivera.
- La licence décide de tout. Large 3 est sorti sous Apache 2.0, tandis que Medium 3.5 utilise une licence MIT modifiée. Tant que Mistral n'en nomme pas une pour Large 4, « ouvert » est une direction, pas un contrat.
Même avec les poids, la plupart des équipes ne le feront pas tourner elles-mêmes, car à 1.05T de paramètres on est en territoire de serveurs multi-GPU. Les voies réalistes sont donc l'API de Mistral, un déploiement européen via Mistral, ou un hébergeur quand il y en aura. Si vous voulez quelque chose que vous pouvez faire tourner sur votre propre matériel dès aujourd'hui, ma liste d'alternatives à Mistral inclut des modèles ouverts plus petits.
Faut-il utiliser Mistral Large 4 pour le support client ?
C'est la question qu'on me pose le plus, voici donc ma réponse directe : Large 4 peut écrire une bonne réponse de support, mais il ne devrait jamais répondre de mémoire.
Au test de connaissances d'Artificial Analysis (AA-Omniscience), il a répondu correctement à 25.8% des questions et affichait un taux d'hallucination de 41.9%, ce qui veut dire que lorsqu'il ne connaissait pas la réponse, il devinait souvent. Dans un helpdesk, une supposition assurée sur votre politique de remboursement ou la compatibilité de votre produit est la pire réponse possible.
J'ai vu ce mode de défaillance de près. Lors d'un appel commercial eesel, une équipe danoise B2B de télématique automobile sous Zendesk, avec environ 200 tickets par mois, craignait que son bot confirme des modèles de voiture non pris en charge, parce que sa base de connaissances disait "we support all models". Un meilleur modèle n'y aurait rien changé, car le modèle lisait correctement les documents, et c'étaient les documents qui étaient faux. C'est pourquoi chaque déploiement sur lequel je travaille est testé sur des tickets historiques avant la mise en ligne, et pourquoi les guides pour stopper les hallucinations commencent par la base de connaissances, pas par le modèle.
Une responsable CX d'une marque de compléments DTC, gérant environ 7,000 tickets, a mieux formulé l'exigence réelle que n'importe quel benchmark :
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
La latence est le deuxième point à vérifier. Avec le raisonnement activé, Artificial Analysis a mesuré environ 18.7 secondes avant le premier token de réponse sur un long prompt. C'est acceptable pour les e-mails et les réponses aux tickets, mais lent pour le chat en direct, où il vaut mieux un reasoning_effort plus bas ou un modèle plus rapide. Mon comparatif du meilleur modèle d'IA pour les tickets approfondit ce compromis.
Voici comment je le résumerais pour une équipe de support :
| Cas d'usage | Adéquation de Large 4 | Pourquoi |
|---|---|---|
| Brouillons de réponses relus par les agents | Bon | Bonne rédaction, peu cher par réponse, un humain dans la boucle vérifie le résultat |
| Réponses autonomes par e-mail ou ticket | Seulement avec des garde-fous | Nécessite un ancrage dans vos documents, un score de confiance et un repli humain |
| Chat en direct | Faible avec le raisonnement activé | ~18.7 s avant le premier token de réponse |
| Exigences de résidence des données dans l'UE | Fort | Conçu et servi en Europe par Mistral |
| Lecture de captures d'écran et de PDF joints par les clients | Fort | Entrée image native, bons scores sur documents et graphiques |
Si vous choisissez entre des modèles pour une pile de support, mon guide du meilleur LLM pour le support compare les principales options, et RAG vs fine-tuning explique pourquoi l'ancrage bat l'entraînement pour les centres d'aide.
Le modèle est de l'infrastructure, eesel est l'employé
Voici le changement de perspective que je vous demanderais de faire. Un modèle comme Mistral Large 4 est de l'infrastructure : un moteur qui prédit du texte. Ce dont une équipe de support a vraiment besoin, c'est d'un coéquipier qui connaît le produit, travaille dans le helpdesk, sait quand passer la main et peut être vérifié avant de parler aux clients. Choisir le moteur est la moitié facile du travail.
Karel de GENERAL BYTES l'a dit simplement en expliquant pourquoi son équipe n'avait pas construit la sienne :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
C'est le travail d'eesel, une plateforme de coéquipiers IA où vous recrutez des coéquipiers prêts à travailler sur des tâches précises.
Pour le support, c'est le coéquipier helpdesk IA : il se branche sur Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, et lance une simulation sur des centaines de vos anciens tickets pour que vous voyiez comment il aurait répondu avant de l'activer. Pour les équipes de contenu, le rédacteur de blog IA fait de même pour les articles longs.
Si vous le comparez à l'IA intégrée de votre helpdesk, j'ai comparé séparément eesel vs Zendesk AI.
Pour être clair sur les limites : eesel fonctionne avec des modèles d'OpenAI, Anthropic et Google, selon sa page sécurité, donc Mistral Large 4 n'est pas une option que vous pouvez choisir dans eesel aujourd'hui. Si votre exigence est précisément « un modèle Mistral, hébergé en Europe », appeler directement l'API de Mistral est la route la plus directe.
Si vous êtes venu à Large 4 parce que vous voulez un contrôle au niveau de l'API, la CLI eesel vous le donne sur le coéquipier lui-même. npx @eesel/cli init chat-bubble --site <your-site> lance une bulle de chat entraînée sur votre site sans compte, chaque commande renvoie du JSON pour que Claude Code, Cursor ou Codex puissent piloter la configuration, et eesel mcp token transforme votre espace de travail en serveur MCP. C'est le même agent que dans le tableau de bord, donc tout ce que vous configurez depuis le terminal y apparaît aussi. Mon article sur les CLI d'agents IA explique pourquoi c'est important.
Essayer eesel
Si vous évaluez Mistral Large 4 parce que vous voulez une IA qui répond aux tickets de support, je commencerais un cran plus haut. Le coéquipier helpdesk d'eesel rejoint votre file Zendesk, Freshdesk ou Gorgias en quelques minutes, apprend des tickets auxquels votre équipe a déjà répondu et vous montre une simulation notée sur ces anciens tickets avant de répondre à qui que ce soit. Vous voyez les mauvaises réponses dans un rapport, pas dans la boîte de réception d'un client.

L'offre gratuite inclut 100 crédits sans carte, et les offres payantes commencent à $299/mois pour 500 tickets ou chats, selon les tarifs d'eesel. Essayez eesel sur un échantillon des tickets du mois dernier et voyez ce que ça donne.
Questions fréquentes
Qu'est-ce que Mistral Large 4 ?
Combien coûte Mistral Large 4 ?
Mistral Large 4 est-il open source ?
Mistral Large 4 est-il meilleur que Kimi K3 ou Qwen 3.8 Max ?
Mistral Large 4 est-il adapté au support client ?
Quel est le nom du modèle Mistral Large 4 dans l'API ?
mistral-large-4, et il accepte un paramètre reasoning_effort. Il prend en charge le function calling, les sorties structurées, le batching et l'Agents API. Les modèles en préversion bénéficient d'un mois de préavis avant tout changement, alors figez vos tests dessus avant de construire un agent IA par-dessus.