

Sakana AI a lancé Fugu Max le 11 septembre 2026, et ce n'est pas un modèle ordinaire. Fugu Max est le palier coût-performance de la famille Fugu, et sous le capot c'est un système d'orchestration appris : un coordinateur léger lit votre requête et la route vers le modèle capable le plus économe dans un ensemble de modèles à poids ouverts et spécialisés, dont NVIDIA Nemotron, le tout derrière une seule API compatible OpenAI.
L'argument, c'est l'argent. À 2 $ par million de tokens en entrée et 6 $ par million en sortie, tarif fixe quelle que soit la longueur du contexte, Sakana affirme dans son article de lancement que la sortie est 40 à 60 % moins chère que Sonnet 5, GPT 5.6 Terra et Kimi K3, tout en restant "within striking distance of elite models." Le hic : les benchmarks sont annoncés par l'éditeur, le routage est opaque par conception, il n'est pas disponible dans l'UE, et les meilleurs modèles propriétaires sont volontairement absents de l'ensemble.
Si vous construisez une application, Fugu Max est une façon vraiment intéressante d'obtenir un résultat presque de pointe avec une facture plus basse. Si votre vrai travail consiste à résoudre des tickets de support, un modèle n'est que le moteur. Il vous faut encore construire l'employé autour, et c'est exactement la partie qu'un coéquipier IA comme eesel vous livre déjà assemblée.
Ce qu'est vraiment Sakana Fugu Max
La plupart des lancements de modèles vous offrent un modèle plus gros. Sakana a fait quelque chose de plus étrange : Fugu Max est un modèle qui appelle d'autres modèles.
Cela ressemble à du marketing jusqu'à ce qu'on regarde le mécanisme. Sakana AI est un laboratoire de recherche de Tokyo fondé en 2023 par trois anciens de Google, dont le CTO Llion Jones, l'un des huit auteurs de l'article original sur les transformers, "Attention Is All You Need". Le pari du laboratoire : l'avenir de l'IA est "a vast collection of small AI systems" qui se coordonnent comme un banc de poissons, plutôt qu'un seul monolithe géant. Fugu est cette thèse transformée en produit.
Fugu Max est le quatrième modèle de la famille, et passer de l'un à l'autre se fait en changeant un paramètre sur une ligne, sur la même API :
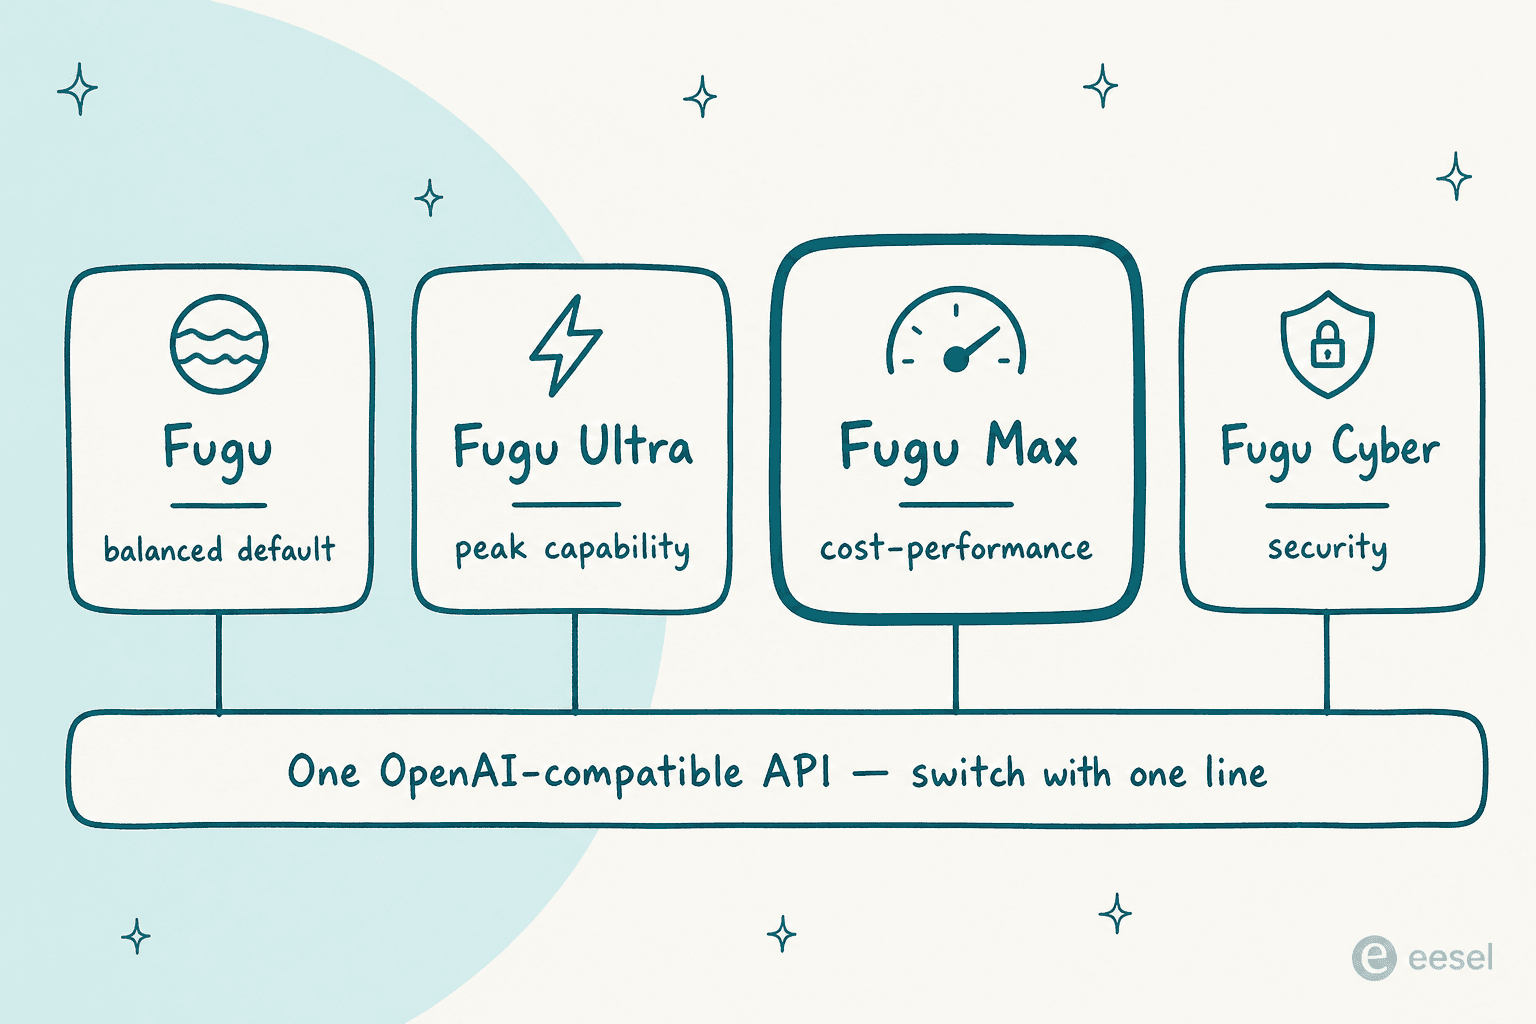
- Fugu équilibre performance et latence, le choix par défaut au quotidien.
- Fugu Ultra (désormais en v2) est réglé pour la qualité de réponse maximale sur des problèmes difficiles à fort enjeu.
- Fugu Max est réglé pour le rapport coût-performance et orchestre le plus grand ensemble de la famille.
- Fugu Cyber est spécialisé dans les travaux de sécurité, comme la recherche de vulnérabilités.
L'article de lancement présente Fugu Max avec une question : "What is the best possible output we can deliver at the lowest possible cost?" Il y répond en élargissant l'ensemble des modèles vers lesquels il peut router, en intégrant "an unprecedented number of open-weights and specialized models", puis en envoyant chaque sous-tâche au modèle le moins cher capable de la traiter. Sakana qualifie Max et Ultra v2 de "not separate products" mais de "the same core orchestration architecture optimized for two distinct missions" : Max fait baisser la facture, Ultra relève le plafond.
Comment l'orchestration fonctionne vraiment
C'est la partie que je trouve vraiment astucieuse. Quand vous appelez Fugu Max, vous ne parlez pas à un seul réseau de poids. Vous parlez à un coordinateur qui décide, requête par requête, qui doit faire le travail.
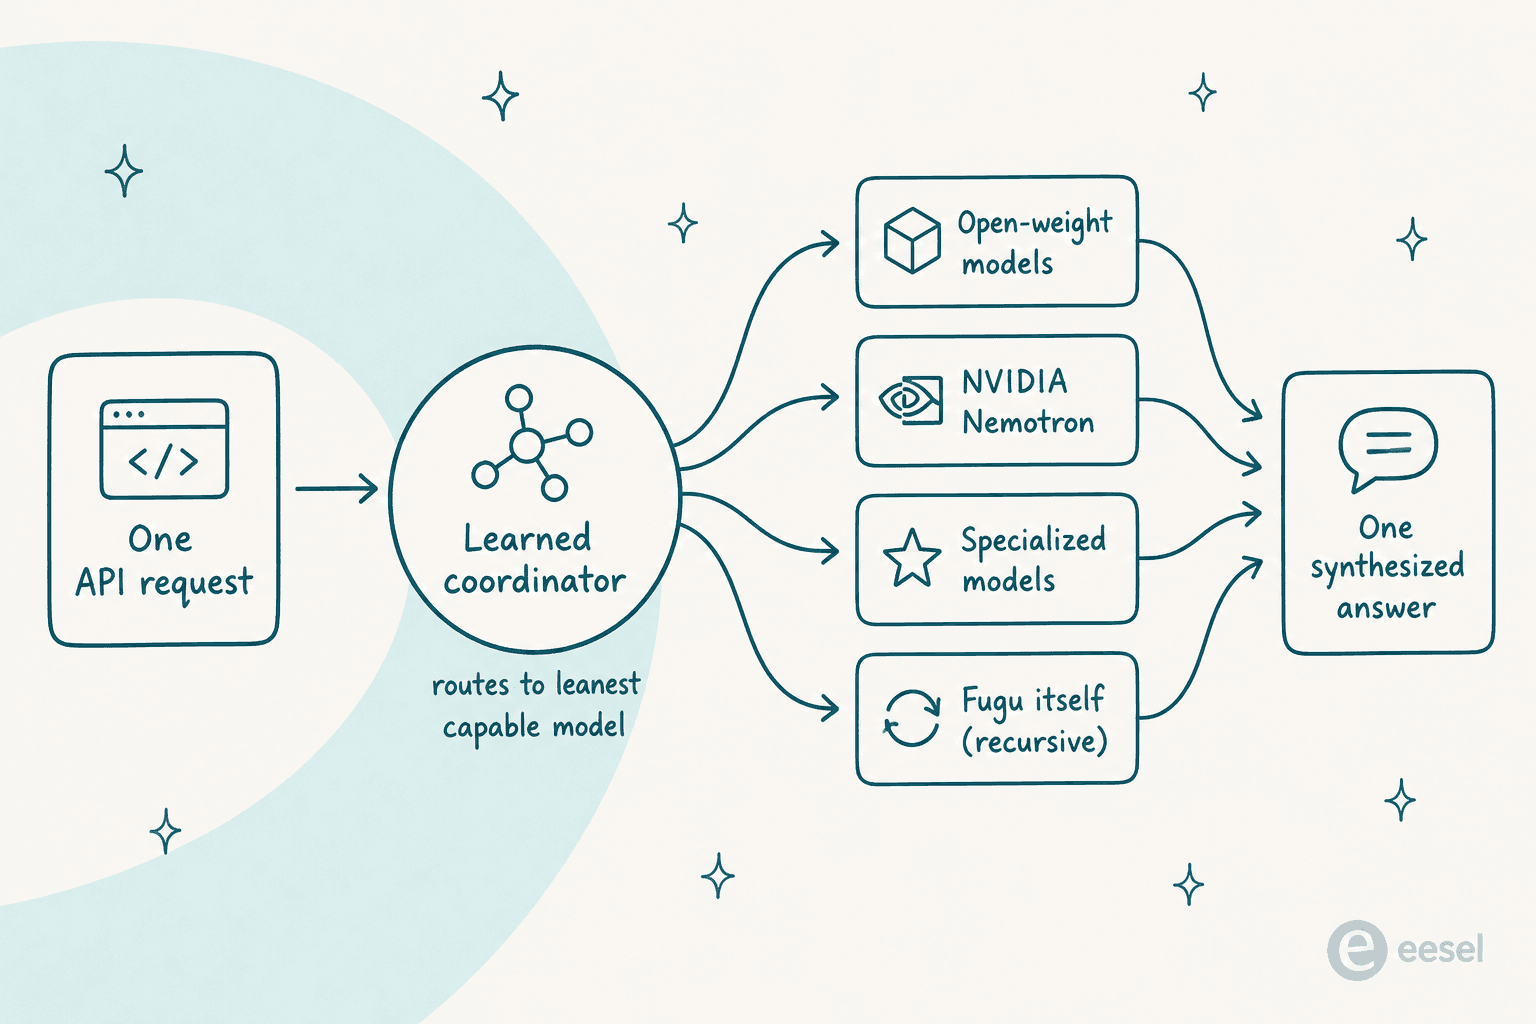
Le coordinateur est lui-même un petit modèle entraîné à orchestrer, fondé sur deux articles d'ICLR 2026. TRINITY est un coordinateur évolué qui attribue les rôles de Thinker, Worker et Verifier à un ensemble de LLM sur plusieurs tours. The Conductor est entraîné par apprentissage par renforcement pour découvrir des stratégies de coordination en langage naturel, de sorte qu'un ensemble diversifié surpasse n'importe quel worker isolé. En clair : le système a appris à déléguer plutôt que de suivre un pipeline écrit à la main, et il peut même s'appeler lui-même de façon récursive.
Le schéma d'architecture de Sakana expose la même idée, de la requête au routage jusqu'à la réponse synthétisée :
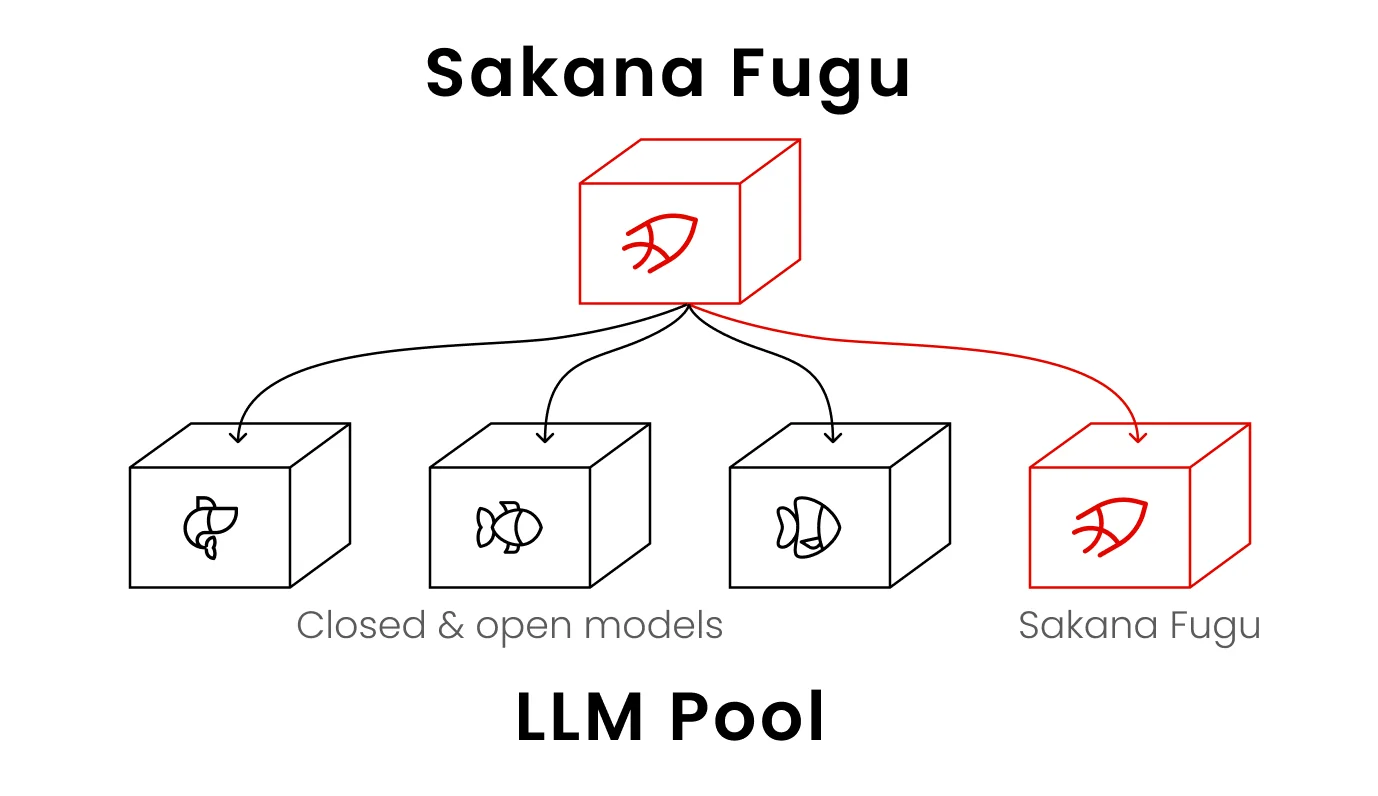
Pour un développeur, l'attrait est que tout cela se cache derrière un seul point d'accès. Vous profitez d'un système multi-agents, avec des modèles experts routés par tâche, sans avoir à le construire et à le maintenir vous-même. C'est un vrai écho de la façon dont les bons agents IA sont censés fonctionner : choisir le bon outil pour chaque étape, plutôt que d'obliger un seul modèle à tout faire.
Quelques précisions sur la variante Max, tirées de la page du modèle sur OpenRouter :
- Contexte de 1 million de tokens, avec des entrées texte, image et PDF et une sortie texte.
- Effort de raisonnement configurable sur high, xhigh et max.
- Appel de fonctions, sorties structurées, recherche et récupération web intégrées.
- L'ensemble d'agents est fixe. Contrairement au modèle Fugu de base, vous ne pouvez pas inclure ou exclure des modèles précis de Fugu Max depuis la console.
- Les tokens d'orchestration sont facturés comme des tokens normaux. Le trafic interne entre agents s'ajoute à votre compteur, ce qui compte pour le calcul des coûts ci-dessous.
Les benchmarks et comment les lire
Les affirmations phares de Sakana pour Fugu Max sont fortes, et toutes sont annoncées par l'éditeur : je les traiterais comme le meilleur profil de l'éditeur plutôt que comme une preuve indépendante.
D'après l'article de lancement, Fugu Max obtient le meilleur score global sur six benchmarks (Terminal Bench 2.1, GPQAD, AA-LCR, GDP.pdf, AutomationBench et SWEFish) et "expands the cost-performance Pareto frontier on seven out of ten benchmarks." Le cadrage sur l'efficacité est le vrai sujet : des performances proches des modèles d'élite à "two to six times lower cost."
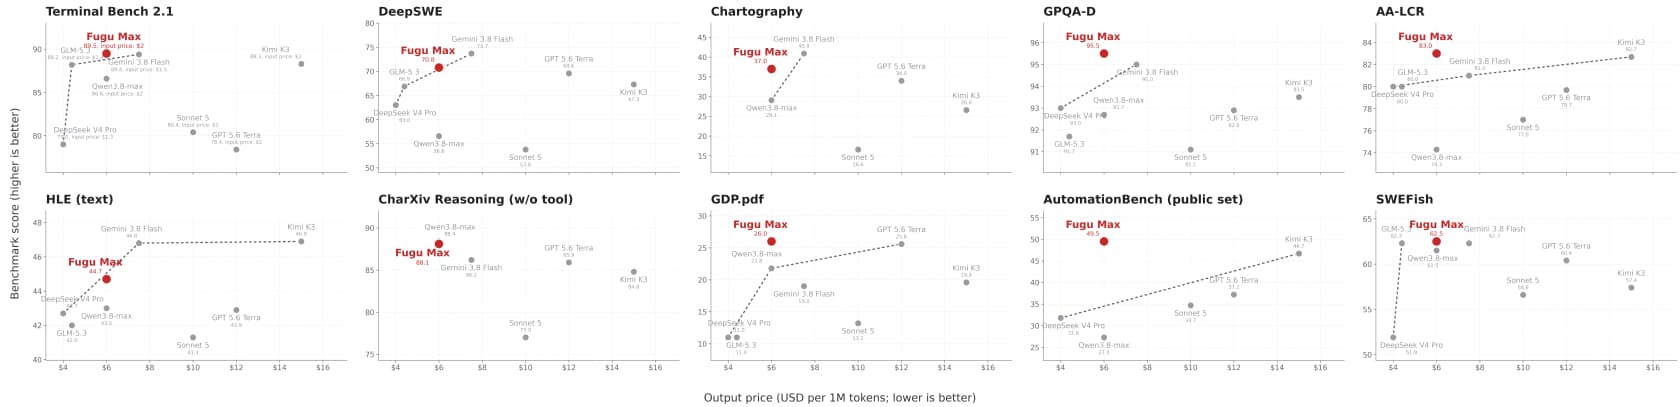
Son jumeau, Fugu Ultra v2, est sorti le même jour avec des chiffres plus musclés. Sur Chartography, un benchmark de raisonnement visuel, Ultra v2 obtient 48,3 contre 27,3 pour Opus 5 et 29,5 pour Fable 5. Sur DeepSWE, un benchmark d'ingénierie logicielle en conditions réelles, il atteint 74,3, ce qui, selon Sakana, bat des modèles coûtant trois à cinq fois plus cher par token.
Trois réserves gardent le tableau honnête, et Sakana les énonce toutes :
- SWEFish est le benchmark interne de Sakana, qui reflète ses propres défis de code, pas un test tiers.
- Les modèles propriétaires les plus forts ne sont pas dans l'ensemble. Sakana est explicite : Fable 5, Fable 5.1 et GPT-6-Astra ne font pas partie des modèles que Fugu orchestre. Battre les modèles de pointe sans eux dans le mélange est précisément ce qu'ils veulent démontrer, mais cela signifie aussi que l'ensemble est composé de modèles ouverts et de milieu de gamme.
- Le routage est opaque par conception. Sakana ne vous dit pas quels modèles sous-jacents ont répondu à une requête donnée, vous ne pouvez donc pas auditer le mélange requête par requête.
Ce dernier point est un vrai compromis pour qui travaille dans un cadre réglementé ou sensible à la sécurité, et c'est la même raison pour laquelle tester sur des données réelles vaut mieux que se fier à un tableau de benchmarks.
Tarifs : les vrais chiffres
Les tarifs de Fugu Max sont publics et, c'est appréciable, fixes. Voici le tableau complet, avec Fugu Ultra v2 à côté pour comparer.
| Poste | Fugu Max (v1.0) | Fugu Ultra v2 (standard) | Fugu Ultra v2 (>272K) |
|---|---|---|---|
| Entrée / 1M de tokens | $2.00 | $5.00 | $10.00 |
| Sortie / 1M de tokens | $6.00 | $30.00 | $45.00 |
| Entrée en cache / 1M | $0.25 | $0.50 | $1.00 |
| Supplément de contexte | Aucun (fixe) | Au-delà de 272K tokens | Appliqué |
| Recherche web / récupération | $0.007 par appel | $0.007 par appel | $0.007 par appel |
Le tarif fixe est le meilleur argument de Fugu Max : selon Sakana, le tarif de 2 $/6 $ vaut "regardless of context length", un prompt de 900K tokens coûte donc le même prix par token qu'un prompt court. C'est inhabituel, et utile si vous lui envoyez de gros documents.
Si les abonnements vous conviennent mieux, il y en a trois, et chaque palier donne accès à tous les modèles Fugu :
| Offre | Prix | Quota |
|---|---|---|
| Standard | $20/mois | Base |
| Pro | $100/mois | 10x Standard |
| Max | $200/mois | 20x Standard |
Un piège de nommage : l'abonnement "Max Plan" n'est pas le modèle "Fugu Max". L'offre à 200 $ est un quota d'usage qui inclut tous les modèles ; Fugu Max est l'un des modèles qu'elle contient.
Deux notes changent le coût réel. D'abord, comme les tokens d'orchestration sont comptés, une requête qui se répartit entre plusieurs agents consomme plus de tokens qu'un appel à un seul modèle : le faible tarif par token ne signifie donc pas toujours une faible facture par réponse. Sakana atténue cela en promettant de "never stacks fees" et facture "a single rate based on the top-tier model involved." Ensuite, le cache fait beaucoup de travail en pratique : sur le panneau en direct d'OpenRouter lors des premiers jours de Fugu Max, le prix d'entrée effectif moyen pondéré tournait autour de 0,61 $ par million contre 2 $ au tarif public, grâce à un taux de réussite du cache de 79,4 %, à environ 29 tokens par seconde.
Ce que les gens disent vraiment
Le lancement de Fugu Max lui-même a été discret en ligne, mais le débat autour de l'approche d'orchestration de Fugu dans son ensemble est vif depuis le lancement en disponibilité générale de juin. Il vaut la peine d'être lu, car les critiques s'appliquent tout autant à Max. (Ce sont des réactions au modèle d'orchestration de Fugu en général, pas à la variante Max en particulier.)
La critique dominante est "pourquoi payer pour un routeur". L'un des commentaires les plus plébiscités du fil Hacker News sur la disponibilité générale a bien résumé l'ambiance :
"You pay $200/month to Anthropic, $200/month to OpenAI, $200/month to Cursor, $200/month to Google, and seeing that it didn't come to a nice round $1024/month, you pay $200/month to Sakana to coordinate it all, because why not."

C'est la vraie question pour tout profil technique : si je peux brancher moi-même des modèles ouverts bon marché et un orchestrateur, qu'est-ce que j'achète ? Pour une bonne partie du fil, la réponse était "pas assez". Mais il y avait aussi un contrepoint juste, et je pense que c'est la lecture honnête :
"Kind of shocking - a model comes out that beats mythos and offers a reasonable price and it ... gets downvoted? ... it's a genuine accomplishment to hit those benchmarks and offer a reasonable plan?"
Et au moins un utilisateur a décrit une configuration réelle qui fonctionne, associant Fugu Ultra comme conseiller à un modèle pilote plus rapide :
"Happy user here, pairing it with Composer 2.5, with Fugu Ultra as advisor and Fugu as planner... Worth it if your harness can split advisor from worker."
Mon avis : Fugu Max est une pièce d'ingénierie réellement intelligente, et l'offre "achetez de l'orchestration gérée plutôt que de la construire" est réelle pour les équipes qui ne veulent pas maintenir une couche de routage. Savoir si cela vaut une facture distincte en plus de vos dépenses actuelles en modèles dépend entièrement de la quantité d'orchestration que vous construiriez autrement vous-même.
Où s'arrête le modèle et où commence le travail
C'est la distinction à laquelle je reviens sans cesse, parce qu'elle s'estompe facilement. Fugu Max est une infrastructure. C'est un moteur, pas un employé.
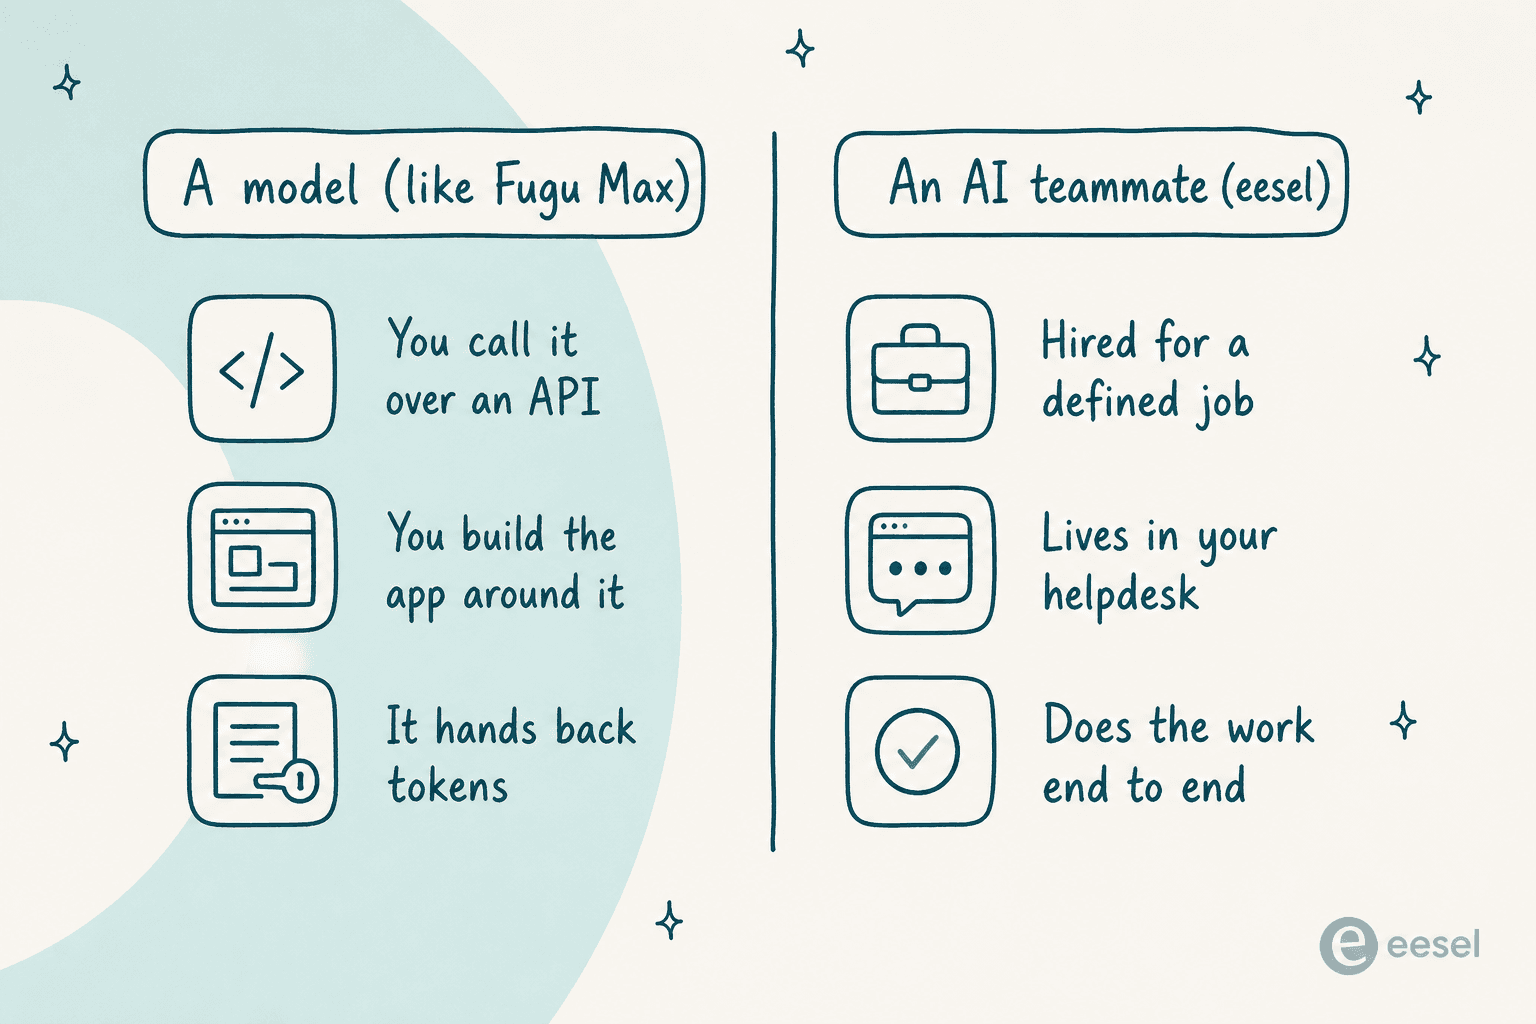
Un modèle, aussi malin que soit son routage, vous rend des tokens. Pour en faire des tickets de support résolus, il faut encore le connecter à votre helpdesk, lui apprendre votre produit et vos politiques, l'autoriser à consulter une commande ou à étiqueter un ticket, décider quand il passe la main à un humain et prouver qu'il est sûr avant qu'il touche un vrai client. Cet écart entre "un modèle capable" et "un coéquipier qui fait le travail" représente l'essentiel du vrai projet, et c'est la partie que les benchmarks ne mesurent jamais.
C'est exactement le compromis derrière le succès de Fugu lui-même : la plupart des équipes ne veulent pas construire elles-mêmes la plomberie multi-agents. La même logique s'applique un niveau plus haut. Pour le support client, vous ne voulez probablement pas non plus construire tout l'employé autour d'un modèle.
Essayez eesel : le coéquipier, pas le moteur
C'est le vide que comble eesel. eesel est une plateforme de coéquipiers IA : vous recrutez des coéquipiers prêts à travailler pour des missions précises, et chacun arrive avec les compétences, les intégrations et le contexte d'entreprise de son rôle. Le coéquipier IA de helpdesk rejoint votre file existante, consulte commandes et dossiers, étiquette les tickets et rédige ou envoie des réponses, le tout dans le helpdesk que vous utilisez déjà.

Le point pertinent pour un article sur les modèles : vous n'avez jamais à choisir le modèle. eesel s'appuie en coulisses sur des modèles de pointe et gère ce choix pour vous : la décision n'est donc pas "Fugu Max ou Sonnet 5", c'est "est-ce que je veux des tickets résolus". Il s'entraîne sur vos anciens tickets et votre centre d'aide, se branche sur plus de 1000 outils comme Zendesk, Freshdesk et Gorgias et, surtout, vous permet de simuler sur des tickets historiques avant de répondre à un seul client, la répétition générale que le routage opaque de Fugu ne peut pas offrir.
Si vous vivez dans un terminal, eesel expose aussi une vraie surface programmable. Le CLI eesel (@eesel/cli) et son serveur MCP permettent à une personne, un script ou un agent de code comme Claude Code de piloter le même coéquipier et le même espace de travail que le tableau de bord. Vous pouvez connecter des intégrations, modifier les instructions permanentes du coéquipier, lancer eesel activity pour inspecter chaque exécution, et approuver ou refuser des actions avec un humain dans la boucle, le tout en JSON, avec un drapeau --dry-run qui affiche l'appel exact qu'une écriture ferait avant de l'envoyer.

Fugu Max est une excellente réponse à "quel modèle doit alimenter mon application". Si votre question est "comment résoudre réellement plus de tickets", vous pouvez essayer eesel gratuitement, sans carte bancaire ni appel commercial, et avoir un coéquipier en ligne en quelques minutes.
Questions fréquentes
Qu'est-ce que Sakana Fugu Max ?
Sakana Fugu Max est un modèle d'IA au bon rapport coût-performance, lancé le 11 septembre 2026. Au lieu de répondre seul, il utilise un coordinateur appris pour router chaque requête vers un ensemble de modèles à poids ouverts et spécialisés derrière une seule API compatible OpenAI. Il se place aux côtés de Fugu, Fugu Ultra et Fugu Cyber dans la famille Sakana Fugu.
Combien coûte Sakana Fugu Max ?
Fugu Max est facturé 2 $ par million de tokens en entrée, 6 $ par million de tokens en sortie et 0,25 $ par million de tokens en entrée mis en cache, tarif fixe quelle que soit la longueur du contexte, d'après la FAQ de Sakana. Les appels de recherche web et de récupération web coûtent 0,007 $ chacun. Les abonnements sont à 20 $ (Standard), 100 $ (Pro) et 200 $ (Max) par mois.
Fugu Max est-il meilleur qu'un seul modèle de pointe ?
Sakana indique que Fugu Max obtient le meilleur score global sur six benchmarks et qu'il est 40 à 60 % moins cher en sortie que Sonnet 5, GPT 5.6 Terra et Kimi K3. Ce sont des chiffres annoncés par l'éditeur, et des modèles propriétaires de premier plan comme Fable 5 ne sont pas dans son ensemble : voyez ces affirmations comme un point de départ et testez sur vos propres tâches. Si votre objectif est de résoudre des tickets de support, un coéquipier IA qui prend en charge tout le travail compte généralement plus que le modèle brut.
Où puis-je accéder à Sakana Fugu Max ?
C'est uniquement une API hébergée, disponible via console.sakana.ai, OpenRouter, le Vercel AI Gateway et opencode. Il n'est pas disponible dans l'UE ni dans l'EEE pendant que Sakana travaille sur sa mise en conformité.
Ai-je besoin d'un modèle comme Fugu Max pour automatiser le support client ?
Non. Un modèle est une infrastructure brute sur laquelle vous construisez. Pour le support, un coéquipier IA comme eesel gère déjà le choix du modèle, les connaissances et les actions, se branche sur votre helpdesk existant et vous permet de simuler sur d'anciens tickets avant la mise en production. Voyez comment il se compare à un chatbot à règles.