

IBM a lancé Granite 4.2 le 25 août 2026 : une famille de modèles de raisonnement à poids ouverts en trois tailles, 3B, 8B et 30B, tous sous licence Apache 2.0. Le changement principal est la « réflexion » native : le raisonnement pas à pas est désormais intégré au modèle et peut être basculé entre complet, effort réduit et désactivé.
Les modèles sont petits, peu coûteux et honnêtes sur leur usage : travail agentique en entreprise, appel d'outils et tâches structurées que vous pouvez exécuter sur votre propre matériel. Le plancher est gratuit car les poids sont ouverts, et le tarif hébergé le moins cher que j'ai pu confirmer est celui du 8B chez Replicate, à 0,06 $/0,25 $ par million de tokens. Sur les benchmarks, le 30B est réellement solide (57,0 sur SWE-Bench Verified), même si la communauté des LLM locaux se tourne encore vers Qwen quand seule compte la capacité brute en code.
Une chose à dire d'emblée, car je construis de l'IA de support : un modèle n'est pas un produit. Granite 4.2 est un excellent moteur. Si ce que vous voulez vraiment, c'est un agent IA qui résout les tickets, le modèle est la partie facile à 10 % ; les connaissances, les intégrations et les garde-fous sont les 90 % restants. J'y reviens à la fin.
Qu'est-ce qu'IBM Granite 4.2 ?
Granite est la famille de modèles ouverts d'IBM pour les entreprises, et la 4.2 est la version axée sur le raisonnement. Elle est arrivée sous la forme de trois checkpoints, granite-4.2-3b, granite-4.2-8b et granite-4.2-30b, chacun post-entraîné à partir du modèle de base Granite 4.1 correspondant. IBM a aussi publié deux minuscules modèles de transcription Granite Speech 5.0, mais le nom « 4.2 » désigne en réalité ces trois modèles de langage.
J'ai passé ces dernières années à mettre de l'IA sur des files de support en production, et ce que je regarde en premier sur tout nouveau modèle ouvert, ce n'est pas le benchmark phare, c'est la licence et le scénario de déploiement. Granite s'en sort bien sur ce point : les poids sont sous Apache 2.0, les modèles sont signés cryptographiquement et certifiés ISO, et la famille a obtenu une note maximale au Foundation Model Transparency Index de Stanford. Pour une équipe soumise à des réglementations qui doit exécuter le modèle chez elle, cette combinaison compte plus que quelques points de benchmark.
Le discours d'IBM est « compétitif face à des modèles de réflexion plus gros, pour une fraction du coût ». C'est le pari intéressant, et il vaut mieux le vérifier que le répéter, alors regardons la gamme réelle.
La gamme de modèles : 3B, 8B et 30B
Voici comment les trois tailles se comparent sur les caractéristiques qui décident où chacune peut tourner. Tous sont des transformers denses à décodeur seul, donc le nombre de paramètres affiché est le modèle entier ; aucun artifice de mélange d'experts ne cache une taille active plus petite.
| Modèle | Paramètres | Couches | Contexte | Modèle de base | Idéal pour |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B (dense) | 40 | 128K | granite-4.1-3b-base | Portables et edge, tâches simples et rapides |
| granite-4.2-8b | 8B (dense) | 40 | 128K | granite-4.1-8b-base | Travail d'entreprise généraliste |
| granite-4.2-30b | 30B (dense) | 64 | 128K (512K étendu) | granite-4.1-30b-base | Raisonnement complexe et agents |
Chaque taille gère nativement une fenêtre de contexte de 128K tokens, et le 30B peut être étendu à 512K. IBM publie aussi des versions quantifiées officielles de chaque taille (fp8, mxfp4, nvfp4) qui réduisent l'empreinte mémoire, ainsi que des conversions GGUF de la communauté pour llama.cpp et LM Studio. Si vous voulez une couche de sécurité, les fiches de modèles renvoient vers le Granite Guardian 4.1 8B, distinct, pour la détection des risques.
Le plus difficile pour la plupart des gens est simplement de choisir une taille. Voici un guide rapide selon ce que vous cherchez à optimiser.
Ce qui est vraiment nouveau : un raisonnement natif que l'on peut basculer
La vraie histoire de la 4.2, c'est que le raisonnement est désormais intégré. Les modèles Granite précédents répondaient directement ; la 4.2 peut d'abord travailler un problème dans des balises <think>...</think> avant de s'engager sur une réponse, ce qui aide pour les maths, le code et toute logique en plusieurs étapes. Ce qui le rend pratique, c'est qu'IBM a rendu le raisonnement commutable dans un seul modèle, vous n'avez donc pas à maintenir des checkpoints « raisonnement » et « chat » séparés.
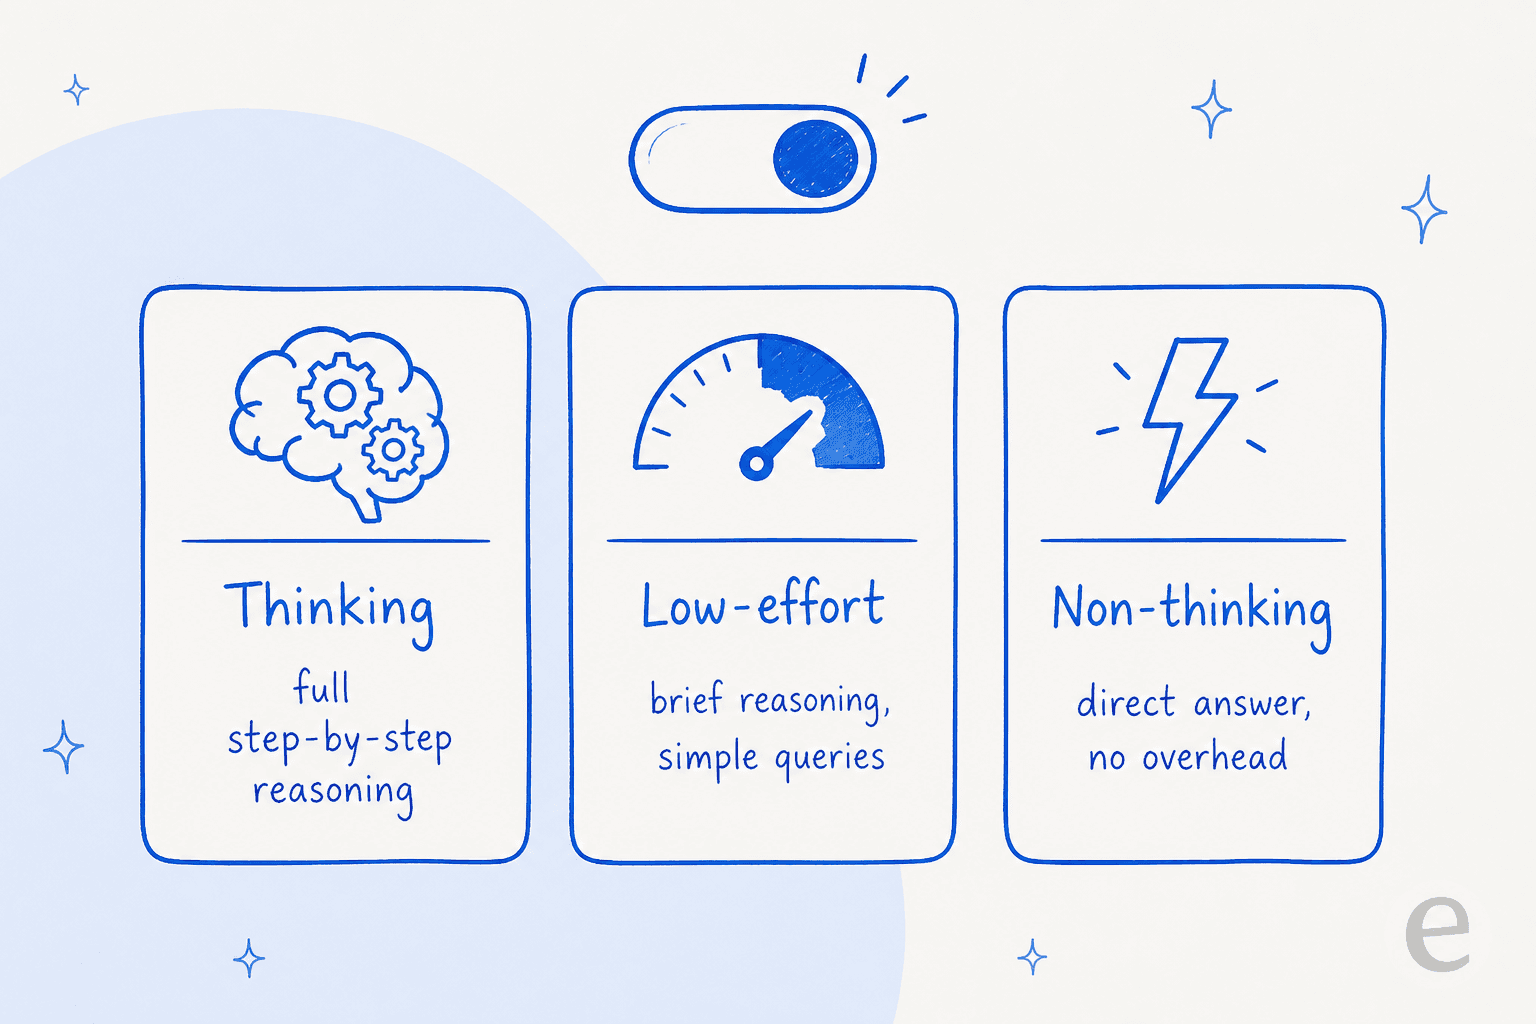
Il y a trois modes, et choisir le bon est surtout une décision de coût :
- Thinking (par défaut) : chaîne de pensée complète. Idéal pour le raisonnement difficile, le pire pour la latence et la consommation de tokens.
- Low-effort : une brève passe de raisonnement pour les requêtes plus simples, un juste milieu qui conserve une partie de la précision sans tout le surcoût.
- Non-thinking : une réponse directe sans aucun token de raisonnement, quand il vous faut juste de la vitesse.
Dans Ollama, vous passez de l'un à l'autre avec /set think et /set nothink. C'est vraiment utile en production, car « toujours raisonner » coûte cher et « ne jamais raisonner » est bête, et la plupart des charges réelles veulent mélanger les deux selon la requête. Si vous avez déjà réglé un bot de support, c'est le même arbitrage que décider quand escalader plutôt que répondre automatiquement.
L'appel d'outils augmenté par le raisonnement
L'autre amélioration, et celle qui importe clairement le plus à IBM, c'est l'appel d'outils. Granite 4.2 a été entraîné à raisonner sur quel outil appeler et pourquoi avant de faire l'appel, plutôt qu'à simplement reconnaître un nom de fonction. En pratique, le modèle planifie, appelle un outil, vérifie le résultat et peut s'auto-corriger.
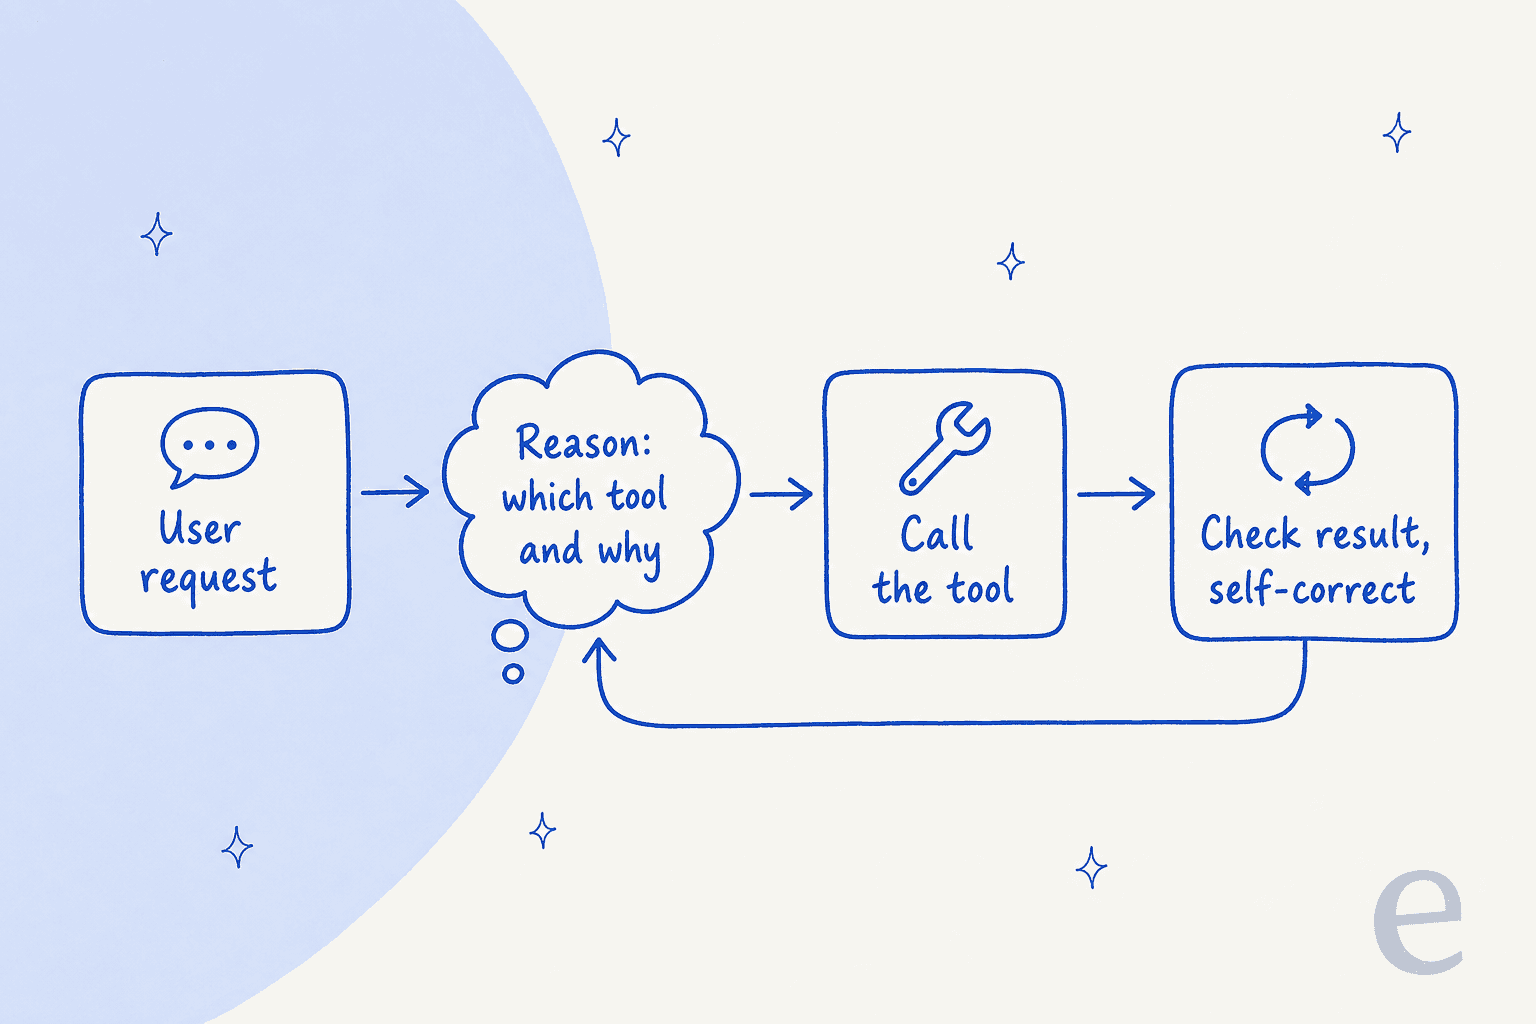
Il expose une API compatible OpenAI et fonctionne immédiatement avec des harnais de code agentiques comme OpenCode, Pi et OpenHands, et il est optimisé pour vLLM (v0.20+) et SGLang pour le service. C'est cette partie qui donne à la 4.2 l'air d'être destinée directement au public des agents IA plutôt qu'à celui des chatbots. Il faut aussi rester lucide : un appel d'outils fiable dans une démo n'est pas la même chose qu'un appel d'outils fiable sur vos systèmes de production désordonnés, et c'est précisément pourquoi nous simulons chaque déploiement sur des données historiques réelles avant qu'il ne touche un client en direct.
Dense, pas hybride : le changement par rapport à Granite 4.0
C'est une nuance qui trompe les gens, elle mérite donc un paragraphe. Granite 4.0 utilisait une architecture hybride Mamba-2/transformer avec une couche de mélange d'experts (MoE), qu'IBM vantait pour sa moindre consommation de mémoire et son inférence plus rapide. Granite 4.2 prend la direction inverse : c'est un simple transformer dense à décodeur seul, post-entraîné à partir de la base dense de Granite 4.1.
Pourquoi cela vous concerne-t-il ? Avec un modèle dense, il n'y a pas de séparation entre paramètres « actifs et totaux », donc un modèle dense de 30B utilise à peu près la puissance de calcul de 30B paramètres à chaque token. C'est plus lourd par token qu'un MoE comparable, mais c'est plus simple à raisonner, largement compatible avec l'outillage standard et prévisible à déployer. La formulation d'IBM est que « its dense architecture supports broad compatibility », une façon honnête de dire qu'on échange un peu d'efficacité contre beaucoup moins de friction au déploiement.
Les performances de Granite 4.2 sur les benchmarks
Voici les chiffres qu'IBM a publiés sur les fiches de modèles, en reprenant les valeurs sur lesquelles les deux tableaux officiels d'IBM s'accordent. Je me suis limité aux benchmarks qui comptent vraiment pour un acheteur.
| Benchmark | 3B | 8B | 30B |
|---|---|---|---|
| SWE-Bench Verified (code) | NA | 47.67 | 57.00 |
| Terminal-Bench 2.1 | NA | 20.56 | 29.24 |
| AIME25 (raisonnement mathématique) | 78.33 | 86.67 | 89.17 |
| GPQA | 54.80 | 64.14 | 66.41 |
| MMLU-Pro | 67.84 | 74.04 | 77.60 |
| Arena-Hard-V2 | 34.96 | 65.19 | 67.93 |
| RULER 128K (contexte long) | 55.30 | 71.41 | 81.38 |
Ce sont de bons résultats pour ces tailles, en particulier le 30B en code et en maths. Mais je veux être franc avec vous, car c'est le plus utile de cette section : IBM compare surtout Granite à ses versions précédentes, et positionne les nouveaux modèles face à Nemotron 3 Super et Gemma 4 plutôt qu'aux modèles que la plupart des gens exécutent réellement en local. C'est une vraie limite à ce que ces tableaux vous apprennent.
La lecture de la communauté est plus sceptique, et à juste titre. Comme l'a formulé un commentateur de Hacker News après la sortie de la 4.1 :
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."

Prenez donc les benchmarks comme « Granite s'est beaucoup amélioré par rapport au Granite précédent », ce qui est vrai et utile, et non comme « Granite bat tout ce qui est de sa taille », ce que les tableaux ne montrent pas vraiment.
Ce que disent les gens
Les tests pratiques indépendants de la 4.2 en particulier sont encore rares, puisqu'elle n'a que quelques jours, mais le sentiment sur Granite 4.x est bien établi et cohérent. Les éloges sont réels : les petits modèles tournent vite sur du matériel courant et sont discrètement excellents sur le travail structuré et ancré.
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
La critique est tout aussi cohérente et se décline en deux versions. D'abord, sur la capacité brute, la communauté des LLM locaux note toujours Qwen plus haut pour le code et le raisonnement agentique :
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
Ensuite, il y a un piège pratique à connaître avant de télécharger le 8B : plusieurs personnes ont vu son empreinte mémoire gonfler bien au-delà de la taille du téléchargement une fois chargé, à cause du cache KV de la longue fenêtre de contexte.
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"

La solution consiste généralement à plafonner la longueur de contexte au chargement, mais c'est un vrai piège si l'on suppose que la taille du téléchargement est la taille en mémoire.
Combien ça coûte et comment l'exécuter
Comme les poids sont ouverts, le moyen le moins cher d'exécuter Granite 4.2 est gratuit : récupérez-le avec Ollama ou Hugging Face et ne payez que votre propre puissance de calcul. Voici ce que coûte réellement chaque voie.
| Voie | Ce que vous payez | Remarques |
|---|---|---|
| Auto-hébergement (Ollama / Hugging Face / vLLM) | 0 $ de licence | Apache 2.0 ; vous couvrez le matériel. Le 3B est un téléchargement de 2,2 Go, à la taille d'un portable |
| Replicate (granite-4.2-8b) | 0,06 $ / 1M en entrée, 0,25 $ / 1M en sortie | Tarif hébergé par token confirmé le moins cher ; ~0,0014 $ par exécution type |
| IBM watsonx.ai | Paiement à l'usage par 1M de tokens + hébergement à l'heure | Offre Standard ~1 050 $/mois ; facturé en Resource Units (1 RU = 1 000 tokens) |
Une remarque sur watsonx : la grille tarifaire en direct pour la ligne Granite 4.2 renvoyait une erreur lors de ma vérification, je n'ai donc pas pu confirmer directement un chiffre exact par token pour la 4.2. Le tarif confirmé le plus proche de la famille Granite-4 dans la documentation d'IBM est d'environ 0,06 $ par 1M en entrée et 0,27 $ par 1M en sortie, et le modèle de tarification (paiement à l'usage par million de tokens plus hébergement à l'heure) est confirmé. Au moment de la rédaction, OpenRouter ne listait encore que Granite 4.0 et 4.1, pas la 4.2.
Pour une vraie comparaison de coût, auto-héberger le 3B sur du matériel que vous possédez déjà est ce qui se rapproche le plus d'une inférence gratuite, ce qui explique en grande partie pourquoi les équipes soucieuses de la confidentialité des données apprécient la famille Granite. Si vous la comparez à un produit hébergé, notre analyse du taux de résolution de l'IA est un meilleur étalon que le prix brut par token.
Qui devrait vraiment utiliser Granite 4.2 ?
Après avoir tout passé en revue, voici mon avis honnête.
Optez pour Granite 4.2 si vous avez besoin d'un modèle ouvert et sous licence que vous pouvez exécuter on-prem, que vous tenez aux tâches structurées et ancrées (appel d'outils, résumé, extraction, étiquetage) et que vous voulez un raisonnement commutable sans jongler entre deux checkpoints. Le 8B est un excellent choix par défaut pour l'automatisation en entreprise, et le 3B est un modèle vraiment bon pour « tourner sur un portable ». Il se marie aussi naturellement avec une couche de recherche, car ces modèles brillent quand ils s'appuient sur vos propres documents plutôt que de répondre de mémoire.
Cherchez ailleurs si votre seule priorité est le meilleur code ou le meilleur raisonnement agentique à tout prix, là où le consensus de la communauté désigne encore Qwen, ou si vous voulez un produit géré, clé en main, plutôt qu'un modèle sur lequel construire. Granite est un excellent modèle, pas une application finie, et l'écart entre les deux est là où la plupart des projets d'IA de support réussissent ou échouent.
Du modèle au coéquipier : la place d'eesel
C'est la partie qui compte le plus pour moi, car c'est l'erreur que je vois les équipes commettre sans cesse. Un modèle brut comme Granite 4.2 est un moteur. Un très bon moteur. Mais un moteur n'est pas une recrue.
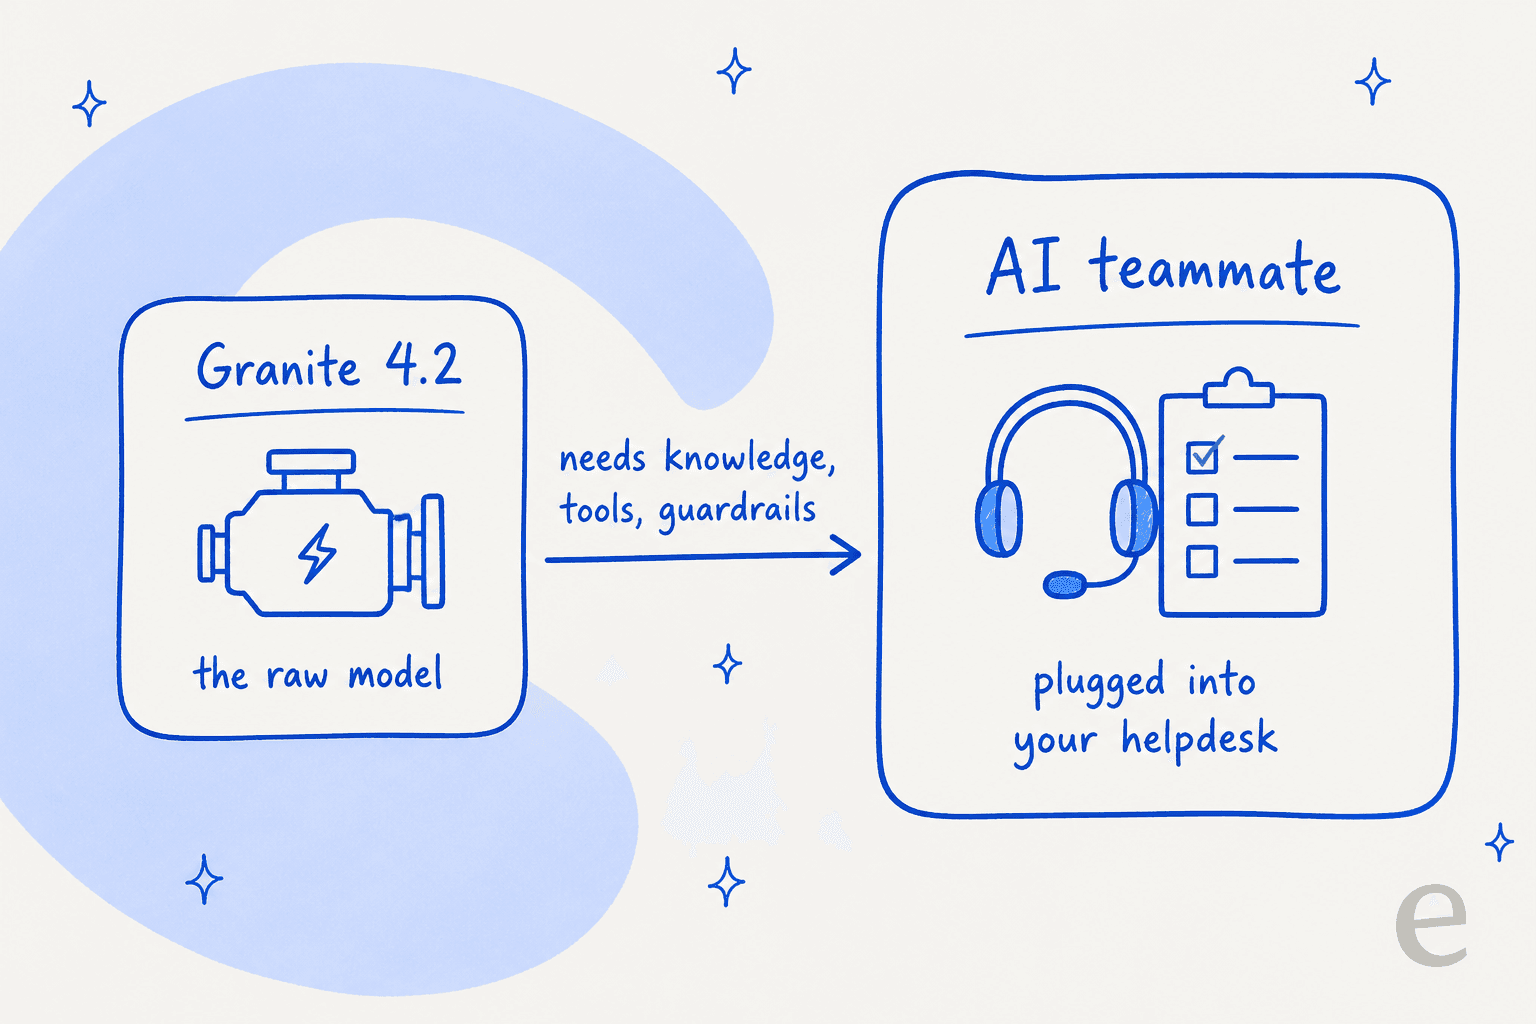
eesel vend le coéquipier abouti, pas le moteur. Le coéquipier IA de helpdesk se branche sur le helpdesk que vous utilisez déjà, qu'il s'agisse de Zendesk, de Freshdesk, de Gorgias ou d'une boîte partagée, apprend de vos tickets passés et de votre base de connaissances, et rédige ou envoie des réponses dans vos outils existants. Ce que Granite 4.2 vous apporte, le raisonnement natif et l'appel d'outils, est ici le minimum requis ; les 90 % difficiles, c'est le contexte de l'entreprise, les intégrations et le filet de sécurité autour.

Et la partie sans laquelle je ne mettrais pas un bot de support en production : eesel vous permet de simuler le coéquipier sur des milliers de vos vrais tickets historiques avant qu'il ne parle à un client, de sorte que vous voyez le taux de résolution et les réponses exactes avant la mise en service, au lieu d'actionner un interrupteur en espérant. Nous l'avons construit parce que nous avons vu des bots à l'air sûr d'eux donner discrètement de mauvaises réponses, et tester sur vos propres tickets est la seule chose qui l'attrape.
Si vous évaluez Granite 4.2 parce que vous voulez automatiser le support, voici le raccourci à connaître : vous pouvez essayer eesel gratuitement, connecter votre helpdesk en quelques minutes et voir comment un coéquipier prêt à travailler traite vos vrais tickets, sans avoir à monter et surveiller un modèle vous-même. Et si l'écriture est le travail, la même idée alimente aussi le coéquipier rédacteur de blog IA.
Questions fréquentes
Qu'est-ce qu'IBM Granite 4.2 ?
IBM Granite 4.2 est une famille de modèles de langage de raisonnement à poids ouverts, sortie le 25 août 2026 en trois tailles : 3B, 8B et 30B paramètres. Tous trois sont distribués sous licence Apache 2.0, prennent en charge une fenêtre de contexte de 128K et ajoutent un raisonnement natif en chaîne de pensée que vous pouvez activer ou désactiver. Ils sont conçus pour l'IA dans le service client, le code et l'usage agentique d'outils.
Combien coûte l'exécution de Granite 4.2 ?
Le plancher est gratuit : les poids sont sous Apache 2.0, vous pouvez donc l'héberger vous-même via Ollama ou Hugging Face et ne payer que votre propre matériel. Le tarif hébergé confirmé le moins cher est celui de granite-4.2-8b chez Replicate, à 0,06 $ par million de tokens en entrée et 0,25 $ par million en sortie. watsonx.ai, la plateforme d'IBM, facture au million de tokens plus l'hébergement à l'heure, avec une offre Standard d'environ 1 050 $/mois.
Granite 4.2 est-il bon pour le code et les agents ?
Le modèle de 30B obtient 57,0 sur SWE-Bench Verified et ajoute l'appel d'outils avec raisonnement, il est donc crédible pour le travail agentique et le code. Pour la capacité brute en programmation, la communauté des LLM locaux continue de mieux noter Qwen. Si votre objectif est un agent IA qui résout les tickets de support, le modèle n'est que le moteur : il vous faut encore des connaissances, des outils et des garde-fous autour.
En quoi Granite 4.2 diffère-t-il de Granite 4.0 ?
Granite 4.0 utilisait une conception hybride Mamba-2/transformer avec une couche de mélange d'experts. Granite 4.2 est un transformer dense, décodeur seul, post-entraîné à partir de la base de Granite 4.1, et son ajout phare est le raisonnement natif commutable. Dense signifie qu'il n'y a pas de séparation entre paramètres actifs et totaux : la taille que vous téléchargez est la taille qui s'exécute.
Puis-je utiliser Granite 4.2 gratuitement à des fins commerciales ?
Oui. La licence Apache 2.0 autorise l'usage commercial et de recherche sans restriction, le fine-tuning et l'auto-hébergement, sans redevance de licence par token. Vous êtes responsable de la puissance de calcul sur laquelle vous l'exécutez. Pour un déploiement de support, l'associer à une couche d'agent IA de helpdesk comme eesel est ce qui transforme le modèle brut en quelque chose qui traite réellement votre file.