

En bref
Qwen 3.8 Flash Next est l'aperçu à poids ouverts que l'équipe Qwen a publié de son architecture de nouvelle génération, Qwen4. Après une semaine d'utilisation, mon verdict est le suivant : c'est l'un des meilleurs modèles en intelligence par dollar que l'on puisse obtenir en ce moment, et c'est aussi un aperçu de recherche que Qwen a volontairement sous-entraîné. Les deux sont vrais à la fois.
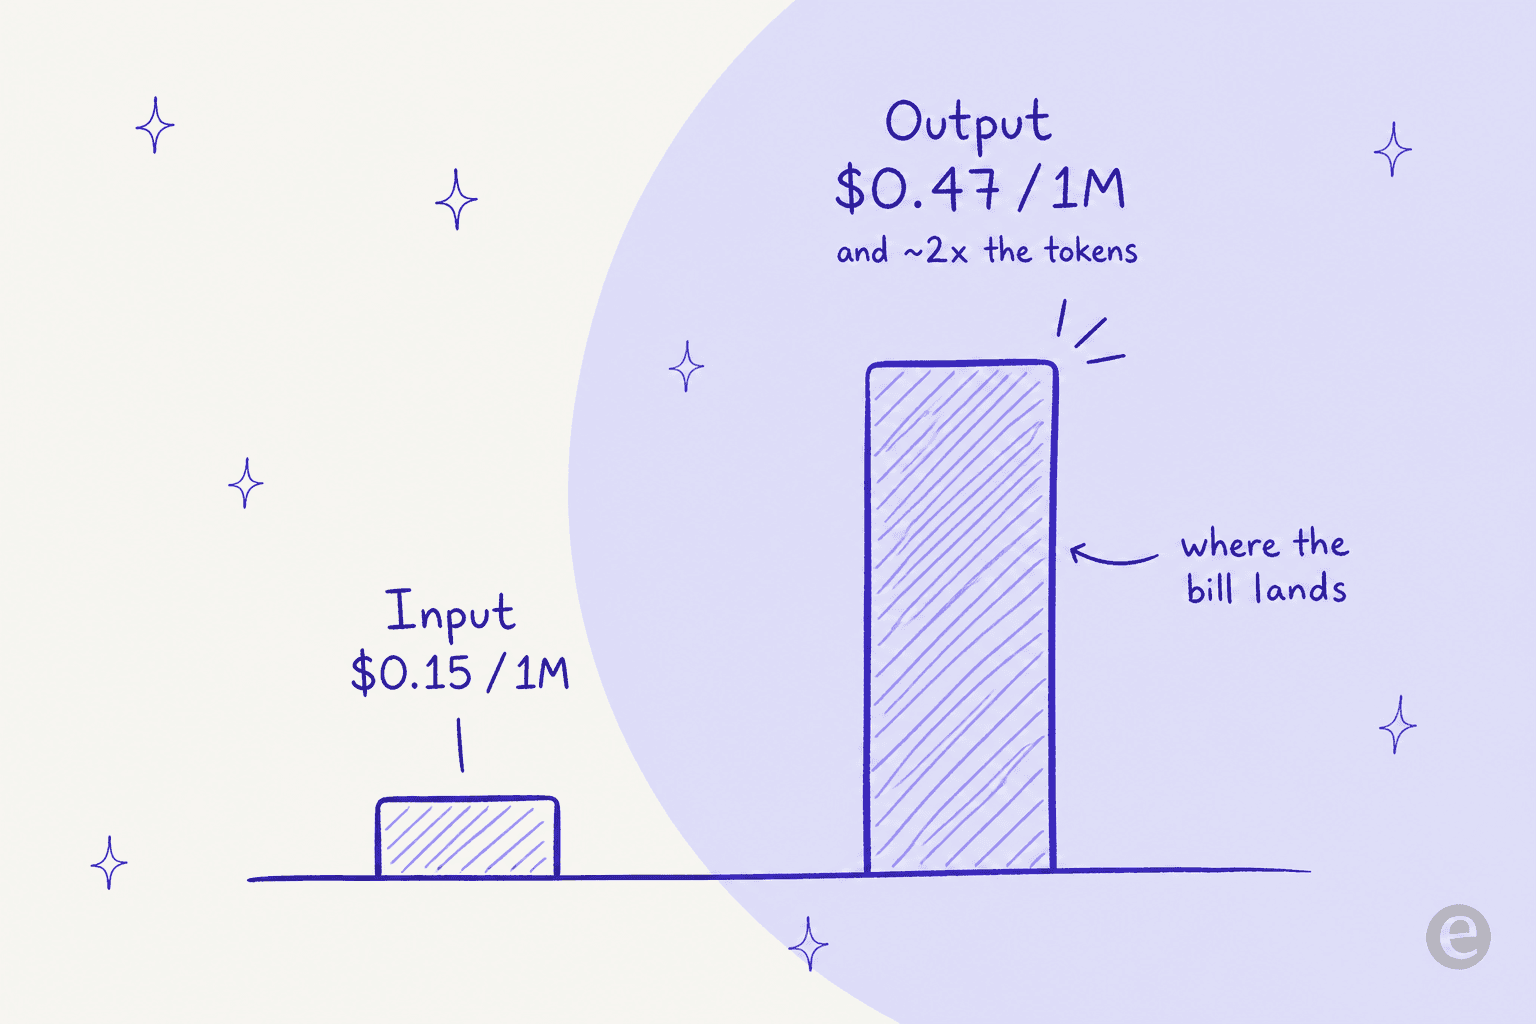
Ce qu'il fait bien est réel. C'est un modèle à mélange d'experts de 125B qui n'active que 6B paramètres par token, donc il tourne vite sur du matériel qui ne pourrait jamais accueillir un modèle dense de cette taille, et la version hébergée est facturée seulement $0.15 en entrée / $0.47 en sortie par million de tokens. Artificial Analysis le place 5e sur 111 en intelligence dans sa catégorie.
Les réserves sont tout aussi réelles. Qwen dit qu'il est volontairement sous-entraîné, la quantification en peu de bits nécessaire pour l'exécuter en local coûte visiblement en qualité, et il est très verbeux, ce qui gonfle discrètement la facture de tokens de sortie. Si vous voulez aujourd'hui un modèle abouti dans cette catégorie de poids, GLM 5.3 Flash est le choix le plus sûr.
Et si vous lisez ceci parce que vous voulez de l'IA bon marché pour le support client : le modèle est la partie facile. Un modèle brut ne lit pas vos tickets et ne rédige pas de réponses. C'est un travail de plateforme, et c'est ce que eesel gère par-dessus des modèles comme celui-ci.
Ce que j'ai vraiment testé
Je construis des agents IA chez eesel, donc la sortie d'un modèle est un problème de travail, pas un sport de spectateur : la question est toujours de savoir si je le mettrais devant une vraie charge de travail. Quand l'équipe Qwen a lancé Qwen 3.8 Flash Next le 26 août 2026, la première heure a servi à démêler le nom, car il déroute les gens.
Voici la version claire. Qwen3.8-Flash-Next est l'aperçu à poids ouverts que vous auto-hébergez ; Qwen3.8-Flash est la future API hébergée avec 1M de contexte et des outils intégrés. « Next » n'est pas un Flash plus gros. C'est l'étiquette que Qwen appose sur un aperçu d'architecture, publié pour que la communauté puisse tester la nouvelle plomberie avant que la famille Qwen4 complète soit construite dessus. Chaque verdict ci-dessous repose sur ce seul mot.
Ce cadrage compte, car « aperçu sous-entraîné » n'est pas une critique que j'ai inventée. C'est la description de Qwen elle-même, reprise partout où la communauté s'est réunie. L'explication la plus claire est venue du fil de lancement sur Hacker News :
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

La façon équitable de le tester n'est donc pas « est-ce le meilleur modèle ? », mais « le pari sur l'architecture est-il payant, et ce checkpoint précis vaut-il d'être exécuté ? ». Des questions différentes, des réponses différentes.
Ce qui est vraiment bon
Le chiffre phare tient face à un examen indépendant, ce qui est plus rare qu'il ne devrait l'être. Artificial Analysis attribue à Flash Next 56 à son Intelligence Index, soit la 5e place sur 111 dans sa catégorie, contre une médiane de 29. Leur verdict est qu'il figure « amongst the leading models in intelligence and reasonably priced ». À environ $0.10 par tâche de l'Index, l'argument de valeur n'est pas du battage.
Dans le tableau de benchmarks de Qwen lui-même, à lire comme des chiffres déclarés par le fournisseur, il est particulièrement fort en code et en travail agentique :
| Benchmark | Qwen3.8-Flash-Next | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude-Opus-4.6 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 55.8 | 56.0 | 53.4 |
| LiveCodeBench v6 | 91.9 | 89.6 | 90.6 | 88.8 |
| GPQA Diamond | 91.7 | 90.3 | 90.8 | 91.3 |
| IFBench (suivi d'instructions) | 81.3 | 79.1 | 79.2 | 62.5 |
| CoWorkBench (longues tâches de bureau) | 73.9 | 65.1 | 45.1 | 68.2 |
| Humanity's Last Exam | 35.9 | 34.7 | 33.8 | 40.0 |
Source : tableaux de benchmarks de Qwen. Deux lectures honnêtes. Il devance des modèles bien plus gros sur SWE-bench Pro, un vrai résultat à cette taille. Et ce n'est pas un sans-faute : Claude Opus 4.6 remporte toujours Humanity's Last Exam, et DeepSeek V4 Flash le bat sur la génération à l'échelle d'un dépôt.
Le deuxième vrai atout est l'efficacité matérielle, et c'est la partie qui intéresse vraiment la communauté. Comme seulement 6B paramètres sont actifs par token et que la table de consultation N-gram de 51B peut être déportée dans la RAM système ordinaire, des gens font tourner un modèle de classe ~180B sur des machines modestes. Les spécialistes des outils ont vite donné le ton :
"Qwen3.8-Flash can now be run locally! The 125B MoE model outperforms Claude-Opus-4.6 (Max). Run on 75GB RAM via Unsloth GGUFs. Qwen3.8-Flash-Next enables CPU RAM / unified mem setups to deliver near VRAM speeds."
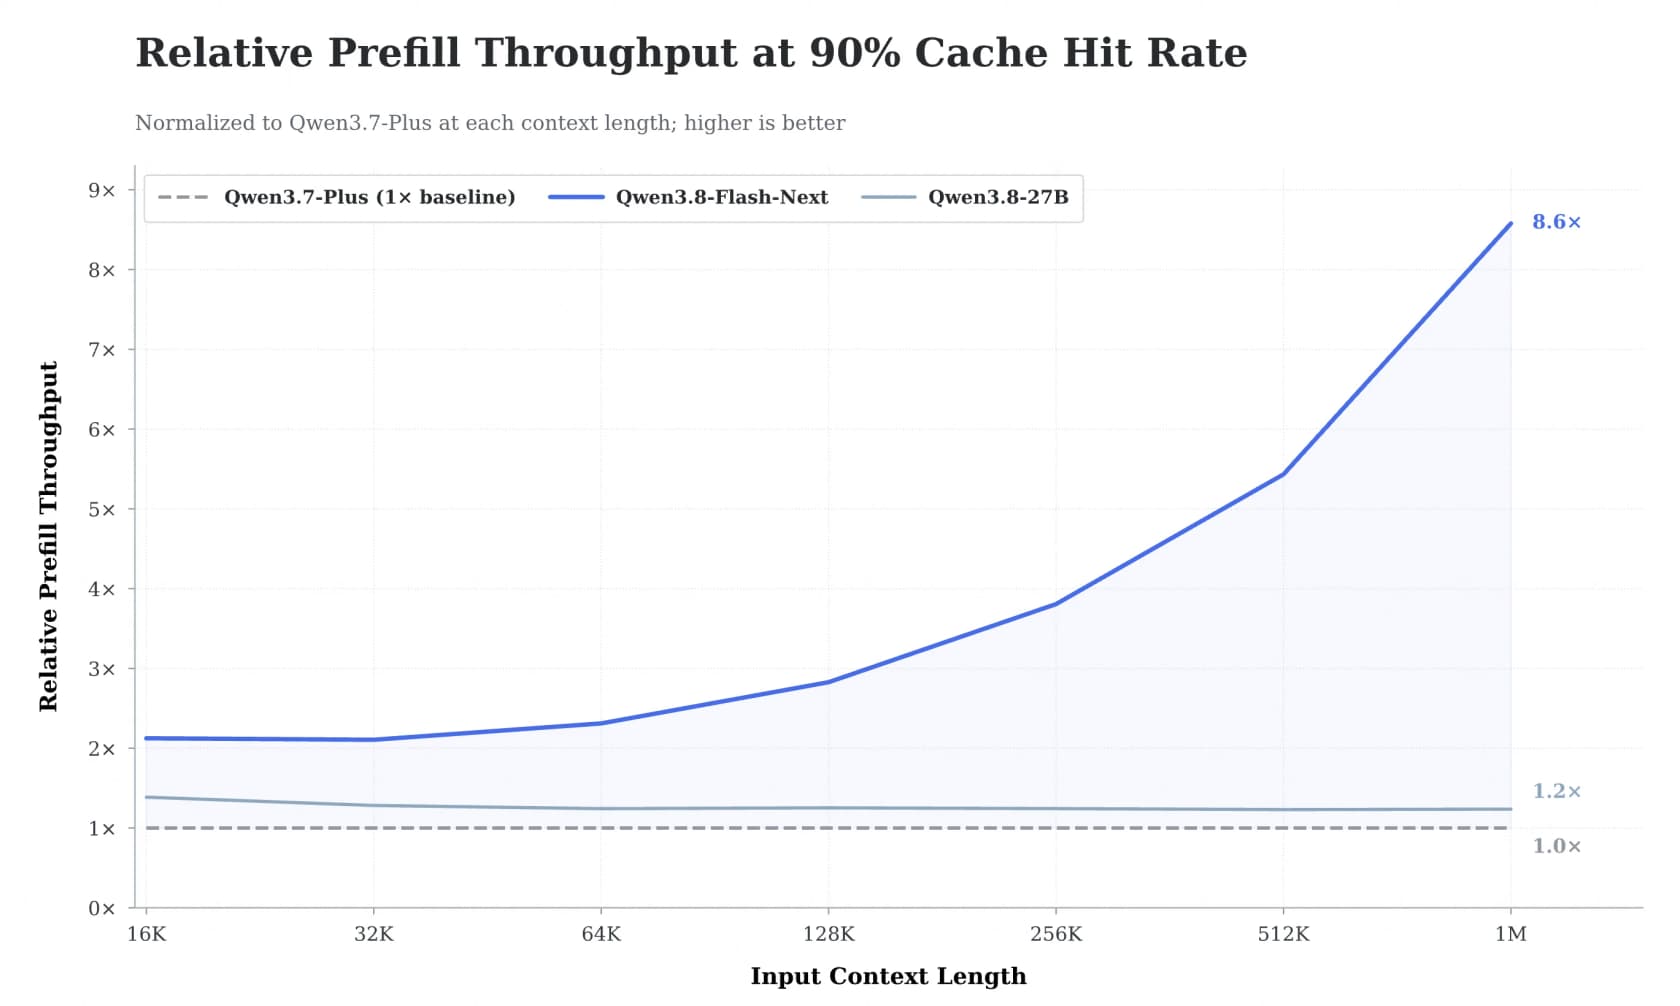
Considérez la phrase « surpasse Opus 4.6 » comme de l'enthousiasme, pas comme un fait mesuré, puisqu'elle vient d'eux et n'est pas vérifiée. Mais l'affirmation de vitesses sur du matériel bon marché est réelle et répétée. Sur un contexte long, le gain est le plus grand : Qwen indique que son noyau d'attention parcimonieuse atteint jusqu'à 7.6x d'accélération en prefill et 4.9x en decode à 1M de tokens.
Où l'aperçu se voit
Passons maintenant aux points qui l'écartent d'une place en production.
La quantification fait mal, visiblement. Pour faire tenir un modèle de classe ~180B sur du matériel grand public, il faut quantifier fortement, et le coût en qualité n'est pas subtil. Simon Willison l'a exécuté à plusieurs niveaux de raisonnement sur un DGX Spark et a fini par préférer le plus petit modèle dense :
"I ran some pelicans at the four different reasoning levels... Surprised I didn't get one I liked as much as the Qwen 3.8 27B one, maybe because of quantization."
C'est le thème récurrent de tous les fils sur l'exécution locale que j'ai lus. L'architecture vous permet de l'exécuter à peu de frais ; elle ne promet pas que le checkpoint que vous faites tenir sur votre machine égale le tableau de benchmarks.
Il réfléchit trop. Comme la plupart des modèles de raisonnement de Qwen, Flash Next est un gros penseur, et cela se voit dans les traces.
"It's definitely a heavy thinker, like most Qwens. I see strings like 'write, now.' in the thinking traces then it goes on to think for a lot longer, so it's kind of weird."
Cela rejoint l'avertissement pratique le plus tranchant de tout cet avis.
Le piège du coût des sorties verbeuses. Artificial Analysis l'a signalé comme « very verbose » : 200M de tokens de sortie pour terminer son Index contre une médiane de 110M. C'est presque le double. Sur l'API hébergée, la sortie est facturée $0.47 par million, donc l'entrée bon marché mise en avant cache une vraie facture de sortie sur les longues exécutions agentiques. Pour une courte réponse de support, c'est une erreur d'arrondi ; pour une boucle d'agent en plusieurs étapes, c'est le chiffre qui décide réellement de votre coût. Modélisez les tokens de sortie avant de croire le tarif affiché.
Ce qu'il coûte vraiment
Les poids ouverts sont gratuits. Si vous avez le matériel, vous ne payez que le calcul, et c'est tout l'intérêt pour ceux qui auto-hébergent.
Pour l'API hébergée Qwen3.8-Flash, la tarification est forfaitaire, sans paliers de longueur de contexte comme avec Qwen 3.7 Flash :
| Poste | Tarif (USD / 1M de tokens) |
|---|---|
| Entrée | $0.15 |
| Sortie | $0.47 |
| Entrée, lecture en cache | $0.016 |
| Création explicite de cache | $0.20 |
Cette lecture en cache est environ 89 % moins chère que l'entrée neuve, et ce n'est pas théorique : OpenRouter a observé un taux de succès du cache de 91.1 % sur du trafic réel, ce qui ramène le prix d'entrée effectif à environ $0.028 par million. Un astérisque au-delà de la verbosité : pour l'instant il n'y a qu'un seul fournisseur d'API, Alibaba Cloud International, donc pas encore de bascule entre plusieurs fournisseurs. Comparez cela à Kimi K3 ou Qwen 3.8 Max si la résilience compte plus que le dernier centime.
Alors, faut-il l'utiliser ?
Voici où j'en arrive après une semaine. Parcourez les deux questions ci-dessous et tout se range de lui-même.
Je veux exécuter des modèles sur mon propre matériel
Un oui franc. Un Mac à mémoire unifiée, un DGX Spark ou une machine avec beaucoup de RAM système, c'est exactement la configuration que cette conception récompense. Attendez-vous à des vitesses proches de la VRAM, et à perdre un peu de qualité à cause de la quantification. Choisissez vos flags de budget de raisonnement pour dompter la réflexion excessive.
Je veux une API hébergée bon marché et orientée code
Oui, les yeux ouverts. Les chiffres SWE-bench sont réels et le prix de l'entrée en cache est excellent. Modélisez d'abord les tokens de sortie, car c'est la verbosité qui fait vraiment monter la facture, et rappelez-vous qu'il n'y a qu'un seul fournisseur aujourd'hui.
J'ai besoin d'un modèle stable pour la production maintenant
Attendez. Qwen le qualifie d'aperçu sous-entraîné, et il se comporte comme tel. Tournez-vous vers GLM 5.3 Flash, un palier Claude Opus 5 ou Qwen 3.8 Max en attendant l'arrivée de la gamme Qwen4 complète.
Prenez-le si vous êtes un bricoleur de l'inférence locale, que vous voulez un premier aperçu de l'architecture Qwen4 ou que vous avez une charge de code favorable au cache où le prix bas et les solides chiffres SWE-bench paient. Attendez si vous avez besoin aujourd'hui d'un modèle de qualité production, puisque c'est un aperçu sous-entraîné de l'aveu même de Qwen, que la quantification fait mal et que l'API hébergée n'a qu'un seul fournisseur.
Dans tous les cas, le point le plus utile est de comprendre ce qu'est vraiment un modèle : un composant. C'est ce que je dois sans cesse expliquer aux équipes qui cherchent une « IA pas chère ».
Où un modèle comme celui-ci s'intègre dans le vrai travail de support
Beaucoup de gens lisent un lancement pareil et pensent : « super, je vais brancher ma boîte de support sur Qwen 3.8 Flash Next et réduire ma facture d'IA ». C'est une erreur de catégorie. Un modèle brut reçoit des tokens et en renvoie. Il ne connaît pas votre politique de remboursement, ne peut pas lire l'historique de commandes d'un client et ignore si sa réponse assurée est réellement correcte. Le modèle est l'infrastructure ; ce qui fait le travail, c'est l'employé.
J'ai vu cet écart mordre de la pire façon. Au début chez un client, le bot disait gaiement aux acheteurs « oui, nous prenons en charge votre modèle de voiture » pour des marques absentes de leur base de données, parce que la base de connaissances disait « nous prenons en charge tous les modèles ». La solution n'a pas été un meilleur modèle de base. Ce fut une meilleure recherche d'informations, un ancrage plus strict et des tests sur l'historique réel avant la mise en ligne. Le résumé de l'équipe elle-même sur cette phase était « essais et erreurs au début », et c'est exactement la phase dans laquelle un modèle flambant neuf et sous-entraîné vous replongerait si vous lui faisiez confiance à l'état brut.
Cette couche d'employé, c'est ce que nous construisons chez eesel. Le principe est simple : eesel est une plateforme de coéquipiers IA, et vous recrutez des coéquipiers prêts à travailler pour des tâches précises, actuellement un coéquipier IA pour le helpdesk et un rédacteur de blog IA. Chacun arrive avec les compétences, les intégrations et le contexte d'entreprise de son rôle, si bien que le modèle qui tourne en dessous devient un détail d'implémentation plutôt que votre problème.

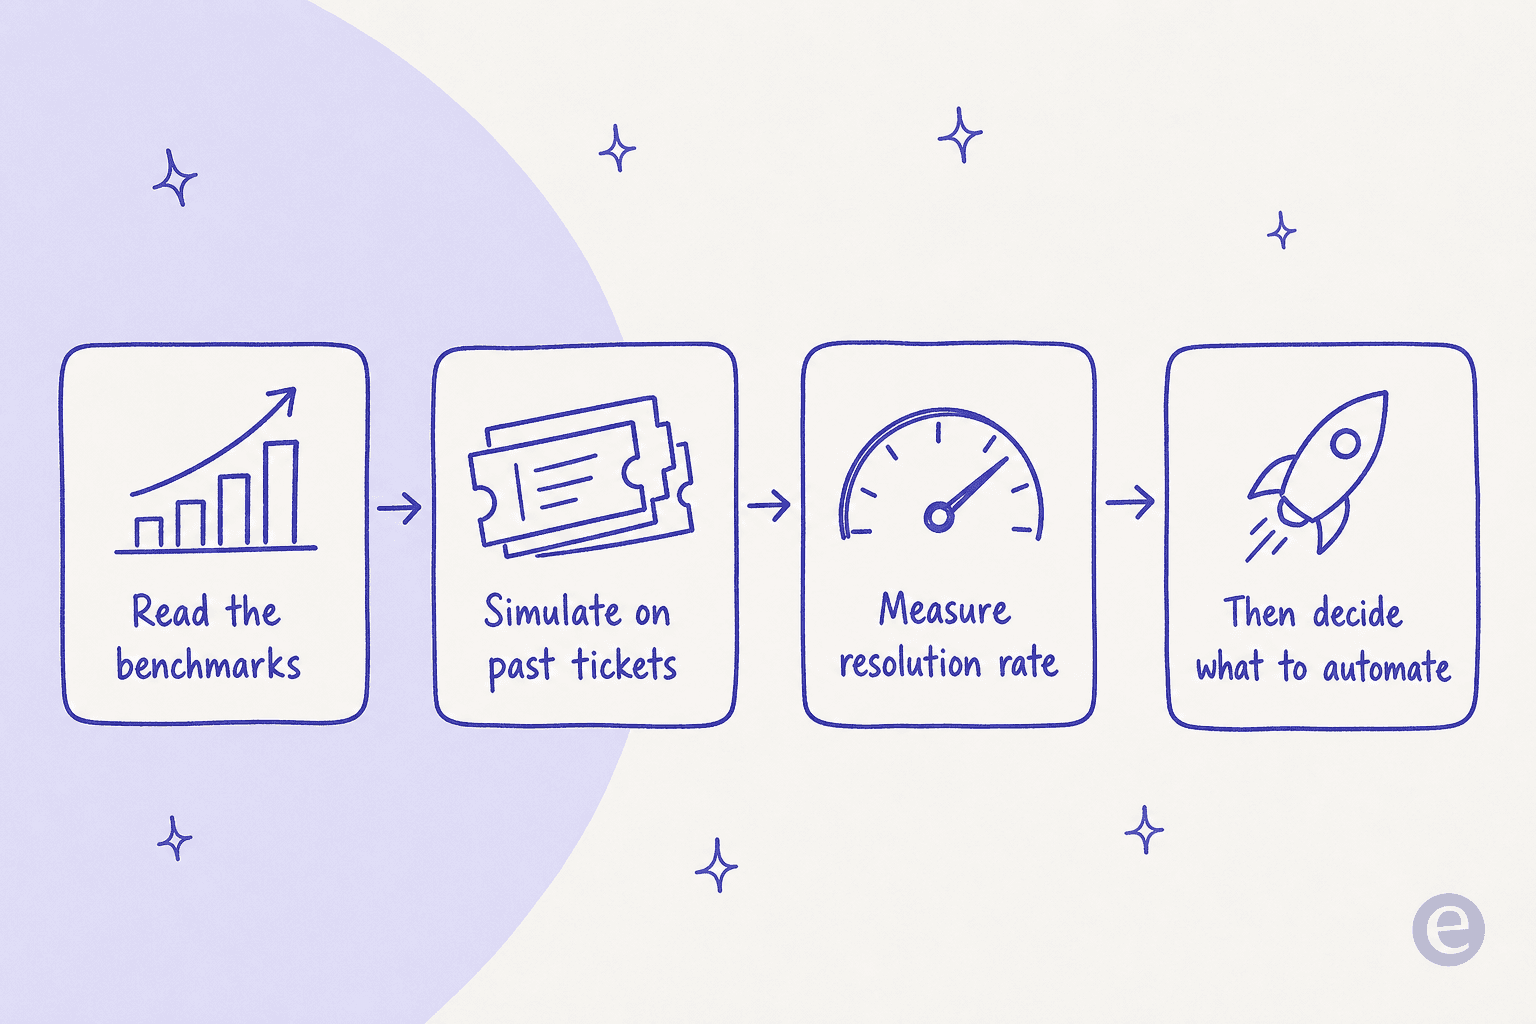
La partie sur laquelle j'insisterais le plus est le test, car j'ai vu qu'il sauve des gens. Le coéquipier helpdesk d'eesel simule chaque déploiement sur vos tickets historiques avant de toucher un client réel : vous voyez le taux de résolution et les réponses exactes qu'il aurait envoyées sur de vraies conversations passées, puis vous décidez quoi automatiser. Un modèle d'aperçu sous-entraîné est précisément le genre de chose que vous voulez faire passer par ce filtre plutôt que de lui faire confiance sur un tableau de benchmarks. Et comme eesel lit votre base de connaissances et vos anciens tickets, le problème de contexte qu'un modèle brut ne peut jamais résoudre seul est pris en charge.
En résumé : des modèles comme Qwen 3.8 Flash Next deviennent vite bon marché et performants, ce qui est une excellente nouvelle, mais en choisir un n'est que les 10 % faciles du travail. Les 90 % restants consistent à en faire un coéquipier qui résout des tickets, et c'est cette couche qui mérite votre temps.
Essayer eesel
Si vous êtes venu ici en pesant Qwen 3.8 Flash Next pour une charge de support, le conseil honnête est d'arrêter de chercher un modèle et de commencer à tester sur vos propres tickets. eesel se branche sur votre helpdesk existant, apprend de votre base de connaissances et de vos conversations passées, et simule chaque déploiement sur des tickets historiques pour que vous voyiez le vrai taux de résolution avant que quoi que ce soit ne passe en production. L'essai est gratuit, et le modèle en dessous reste notre problème, pas le vôtre.