

Gimlet Labs exploite ce qu'elle appelle le premier « cloud d'inférence multi-silicium ». En clair : un logiciel qui répartit une charge de travail d'IA entre différents types de puces, de sorte que chaque phase d'un modèle s'exécute sur le matériel qui la gère le mieux. Le 4 septembre 2026, l'entreprise a levé une série B de 300 millions de dollars menée par Andreessen Horowitz, avec une valorisation de 3 milliards de dollars, à laquelle se sont joints Arm et la branche de capital-risque de Microsoft.
La raison pour laquelle cela vaut 3 Md$ est la même que celle pour laquelle cela m'intéresse, moi qui construis des agents IA au quotidien : les charges de travail agentiques cassent l'hypothèse « un modèle, un GPU ». Un agent enchaîne une douzaine d'appels séquentiels au modèle, et chaque appel sollicite une partie différente du matériel. Le pari de Gimlet est d'acheminer chaque partie vers la puce la plus rapide pour elle.
L'affirmation est une inférence 3 à 10 fois plus rapide pour la même puissance. C'est un chiffre communiqué par l'éditeur, qui mérite une bonne dose de scepticisme, j'y reviens. Mais le problème de fond est réel, et je le ressens à chaque mise en production.
Qu'est-ce que Gimlet Labs ?
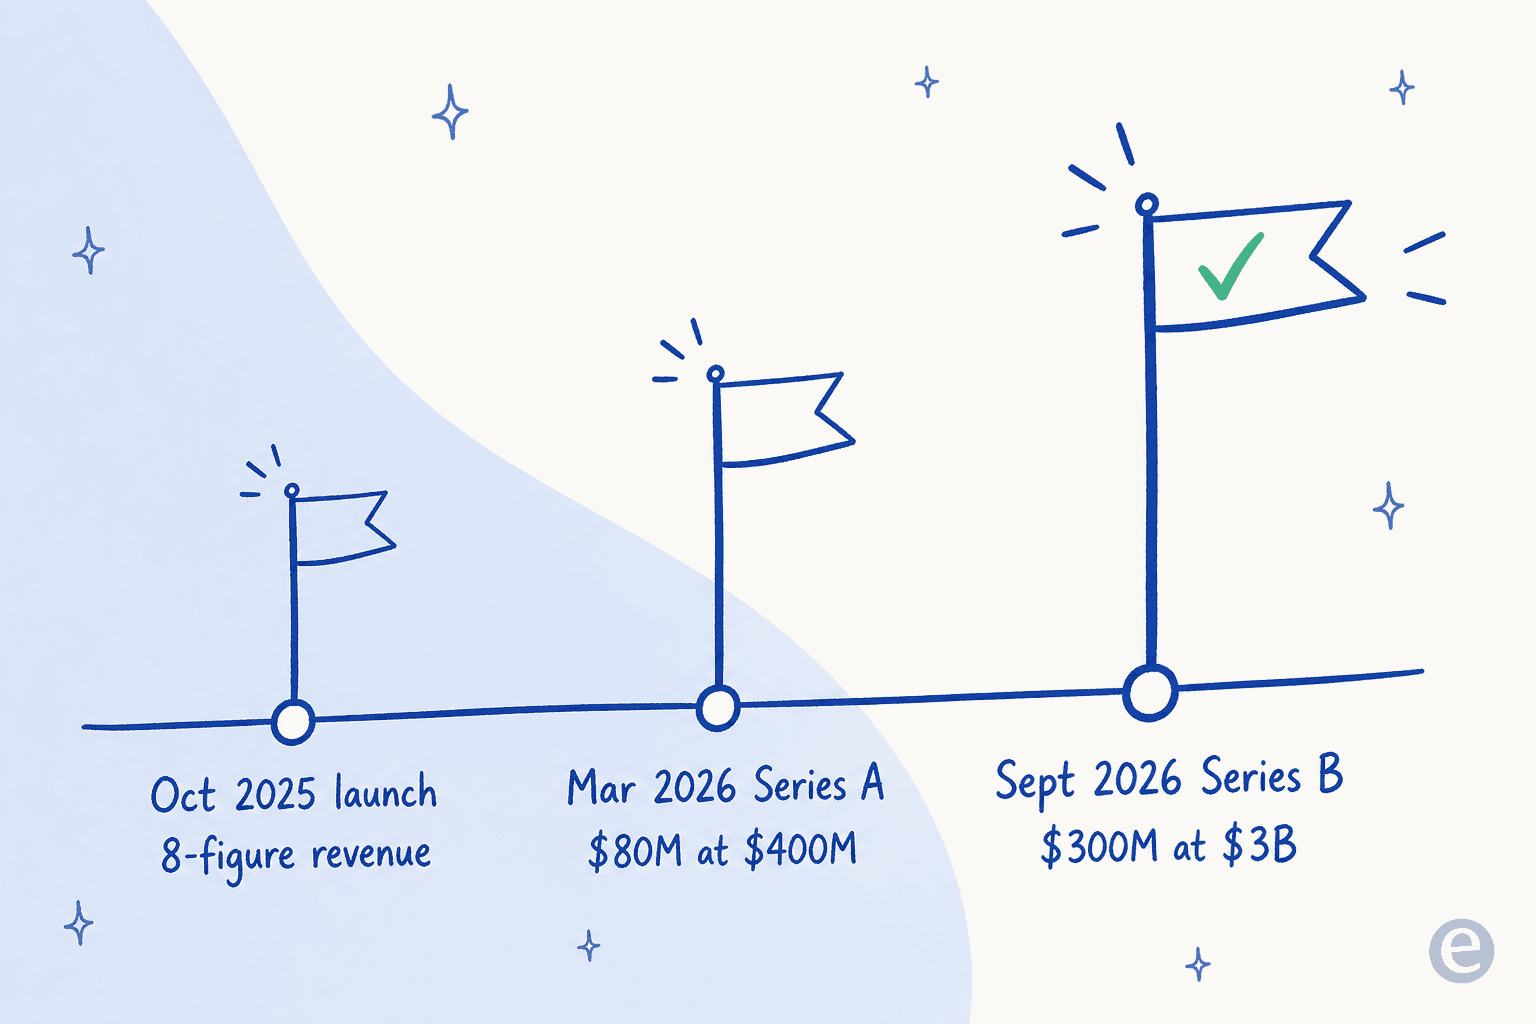
Gimlet Labs est une entreprise de recherche appliquée et de produits en IA. Elle a été lancée publiquement en octobre 2025 avec, selon ses propres dires, un chiffre d'affaires à huit chiffres dès le départ, ce qui est inhabituel pour une entreprise aussi jeune.
Sa page d'accueil résume sa vision en une phrase : « Today's computing systems will undergo a massive transformation to efficiently and scalably serve AI workloads. » Tout le reste en découle. Plutôt que d'accepter qu'un modèle tourne sur le GPU que vous louez, Gimlet construit la couche qui répartit le modèle sur de nombreux types de puces à la fois.
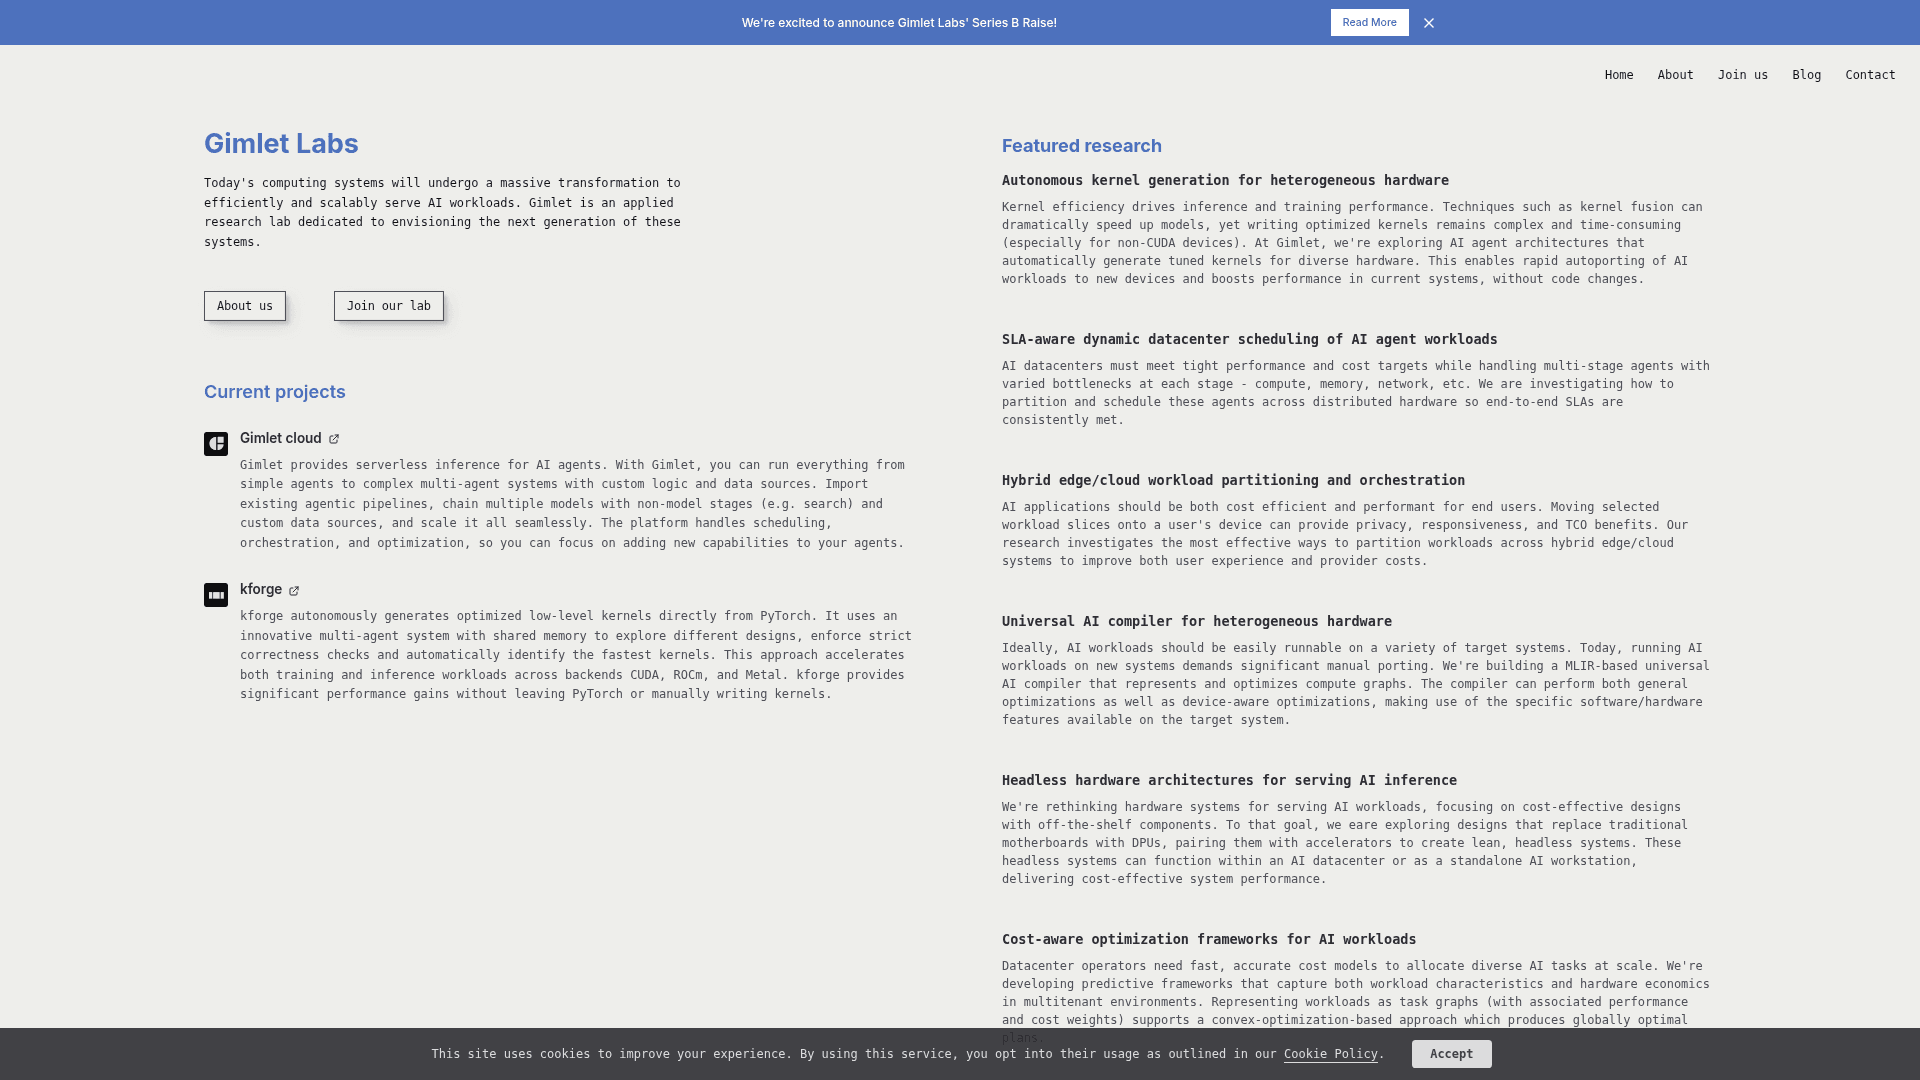
Deux produits sous-tendent cette proposition :
- Gimlet Cloud est une plateforme d'inférence serverless destinée aux agents IA. Vous importez un pipeline agentique existant, vous enchaînez plusieurs modèles avec des étapes non-modèles comme la recherche, et la plateforme gère la planification et l'orchestration.
- kforge est la brique de plus bas niveau. Il génère automatiquement des kernels optimisés directement à partir de PyTorch pour les backends CUDA, ROCm et Metal, grâce à un système multi-agents qui explore des conceptions de kernels et vérifie leur exactitude, de sorte que les ingénieurs obtiennent des gains de vitesse sans écrire de kernels à la main.
Le problème : les agents ont mis à mal l'inférence sur une seule puce
Voici la partie qui fait tout comprendre, et c'est pourquoi je pense que c'est plus qu'une simple histoire de levée de fonds.
Un grand modèle de langage ne fait pas un seul type de travail uniforme. Lorsqu'il répond, il commence par lire votre prompt (la phase de prefill), qui est limitée par le calcul : elle réclame du débit de calcul brut. Puis il génère les tokens un par un (la phase de decode), qui est limitée par la bande passante mémoire : elle passe son temps à faire circuler des données vers et depuis la mémoire. Et un agent IA moderne ne s'arrête pas là : il appelle des outils, interroge des API et récupère des documents, ce qui est limité par le réseau.
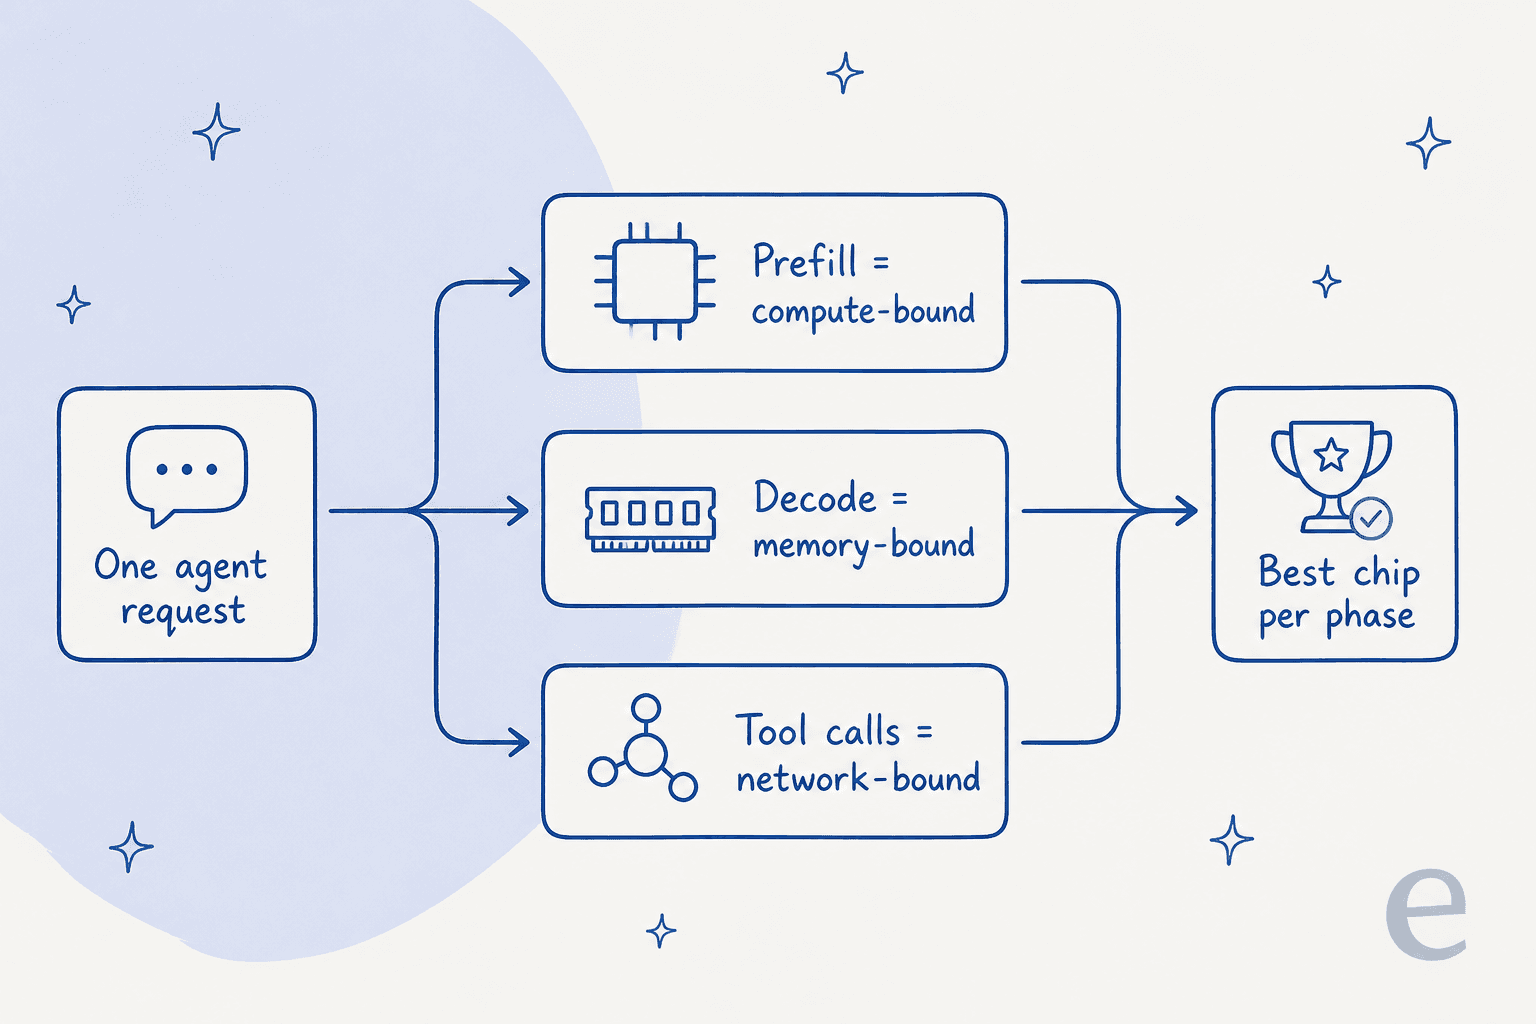
Si vous faites tourner tout cela sur un cluster de GPU homogène, il y a toujours quelque chose d'inutilisé. Pendant le decode, votre coûteuse puissance de calcul n'est qu'à moitié sollicitée. Pendant les appels d'outils, tout l'accélérateur attend le réseau. L'argument de Gimlet, tiré directement de son article sur la série B, est que le matériel homogène seul ne peut pas répondre aux besoins de vitesse et d'efficacité des charges de travail agentiques. Plus un agent enchaîne d'étapes, plus ce gaspillage se cumule.
Ce n'est pas une préoccupation abstraite pour moi. Chez eesel, je construis des agents IA qui résolvent des tickets de support, et une seule résolution est une chaîne : lire le ticket, chercher dans la base de connaissances, raisonner sur ce qui a été trouvé, parfois appeler une API de consultation de commande, puis rédiger une réponse. Chacune de ces étapes a un goulot d'étranglement différent. Quand on me demande pourquoi les produits agentiques peuvent sembler lents, c'est une grande partie de la réponse.
Comment fonctionne le cloud multi-silicium
La solution de Gimlet est la désagrégation. Elle sépare les phases et exécute chacune sur le silicium le mieux adapté : le prefill sur un ensemble de dispositifs optimisé pour le calcul, le decode sur un autre optimisé pour la bande passante mémoire, et ainsi de suite. Elle y ajoute le décodage spéculatif et la séparation entre attention et feed-forward, et rééquilibre dynamiquement à mesure que du matériel se libère.
Pour rendre cela possible, Gimlet s'associe à toute l'industrie des puces plutôt que de choisir un camp. Elle travaille avec les puces NVIDIA comme avec AMD, Intel, Arm, Cerebras et d-Matrix. Le logiciel est le produit ; le silicium est interchangeable. C'est l'inverse du discours habituel « achetez notre accélérateur », et c'est pourquoi Arm a investi dans le tour de table au lieu de voir Gimlet comme une menace.
Le gain annoncé par Gimlet est de 5 à 10x dans la même enveloppe de puissance, ou le même débit à latence réduite. Pour l'IA agentique en particulier, où une requête peut nécessiter des dizaines d'appels séquentiels au modèle, gagner de la latence à chaque appel fait jouer l'effet cumulatif en votre faveur plutôt que contre vous.
L'histoire du financement et qui parie
L'argent indique qui y croit. La série B a été menée par Andreessen Horowitz, avec une longue liste de participants dont Menlo Ventures (qui avait mené la série A), Arm, M12, Samsung Ventures, Tiger Global et XTX Markets. Gimlet affirme avoir ajouté des milliards de revenus contractualisés depuis mars et disposer d'un pipeline de centres de données qui se mesure en gigawatts.
La trajectoire est raide : une série A de 80 millions de dollars en mars 2026 pour une valorisation d'environ 400 millions, puis un bond à 3 milliards six mois plus tard. Sur un marché où chaque laboratoire cherche une inférence de LLM moins chère, la thèse selon laquelle l'efficacité, et pas seulement des modèles plus gros, sera le prochain champ de bataille trouve clairement un écho auprès des investisseurs.
Les réserves honnêtes
Je veux être juste, car une valorisation de 3 Md$ et une promesse de 10x appellent exactement le genre de battage que j'essaie d'éviter.
Premièrement, les chiffres de performance viennent de Gimlet elle-même. Lorsque l'entreprise a publié un article sur des kernels Metal générés par IA, un ingénieur PyTorch sur Hacker News a soulevé une objection précise et raisonnable :
« I work on PyTorch and there are many things that make me suspicious about these results. My TL;DR is unless we get a zip file of all the kernels with how they're benchmarked results like this are almost impossible to verify. »

Ce n'est pas un éreintement, et l'équipe de Gimlet a répondu dans le fil. Mais c'est le bon cadre : les gains de vitesse des benchmarks sont une affirmation à vérifier sur votre propre charge de travail, pas un résultat établi. Deuxièmement, Gimlet n'a pas nommé publiquement ses clients, les décrivant seulement comme « a major model maker » et « an extremely large cloud computing company ». Et troisièmement, il s'agit d'une infrastructure pour les laboratoires et les centres de données. Si vous développez un produit, vous ne toucherez probablement jamais Gimlet directement : vous ne le ressentirez que comme une inférence plus rapide et moins chère sous les outils que vous utilisez réellement.
Ce que cela signifie si vous construisez avec l'IA
Alors, où cela vous place-t-il si vous ne dirigez pas un laboratoire de pointe ?
Gimlet est un bon rappel de la structure en couches. Il y a le silicium en bas, la couche d'inférence que Gimlet se bat pour dominer au milieu, les modèles, puis les véritables employés que vous embauchez au-dessus. Gimlet est de l'infrastructure. Il fait mieux tourner le moteur ; ce n'est pas lui qui fait votre travail.
C'est exactement ainsi que je vois eesel. eesel est une plateforme de coéquipiers IA : vous embauchez des coéquipiers prêts à travailler pour des missions précises, et aujourd'hui l'équipe se compose d'un coéquipier de helpdesk IA et d'un rédacteur de blog IA. Le coéquipier helpdesk rejoint votre file de support existante, apprend de vos anciens tickets et de votre centre d'aide, et résout les conversations dans Zendesk, Freshdesk ou Gorgias. Le rédacteur de blog fait de même pour le contenu. Quel que soit le cloud d'inférence en dessous, c'est le coéquipier qui mène le travail à son terme.

Et puisque l'univers de Gimlet est entièrement agentique et programmable, autant préciser qu'eesel rejoint aussi ce lecteur là où il se trouve. La CLI eesel pilote le même coéquipier helpdesk depuis un terminal : une personne peut l'exécuter à la main, des scripts peuvent l'automatiser, et des agents de codage comme Claude Code ou Cursor peuvent l'utiliser via la CLI et son serveur MCP, si bien que simuler un déploiement sur des tickets historiques ou déclencher une exécution devient une seule commande au lieu d'un clic dans un tableau de bord. Si vous préférez le voir résoudre de vrais tickets plutôt que lire une énième fiche technique, vous pouvez essayer eesel gratuitement et le brancher sur votre propre centre d'aide en quelques minutes.
Si vous en êtes au début et comparez simplement les options, les comparatifs des meilleurs agents IA et de la classification de tickets par IA sont un meilleur point de départ qu'un cloud d'inférence à 3 Md$.
En résumé
Gimlet Labs est une entreprise intéressante qui résout un problème réel et peu glamour : le matériel sous l'IA est mal adapté à la façon dont les agents s'exécutent réellement, et quelqu'un devait construire le logiciel pour y remédier. La valorisation de 3 Md$ est un pari sur le fait que l'efficacité de l'inférence sera le prochain grand combat, et vu la rapidité de la croissance de l'IA agentique, ce n'est pas un pari insensé.
Gardez simplement vos distances avec les promesses de vitesse tant qu'elles ne sont pas testées de façon indépendante, et rappelez-vous quelle couche vous achetez vraiment. Gimlet rend le moteur plus rapide. Le coéquipier au-dessus reste celui qui fait le travail.