

Groq 3 LPX est le nouvel accélérateur d'inférence à l'échelle du rack de NVIDIA pour la plateforme Vera Rubin, et il est entré en production complète le 24 août 2026. Chaque rack réunit 256 puces Groq 3 LPU qui travaillent aux côtés des GPU Vera Rubin NVL72. Les GPU gèrent le travail de contexte, gourmand en mémoire ; les LPU gèrent la tâche sensible à la latence qui consiste à générer rapidement les tokens. Cette répartition vise à rendre l'IA agentique fluide sans sacrifier le débit.
Le nom est confus à dessein. NVIDIA a obtenu une licence sur la technologie LPU de Groq (non exclusive) et a embauché son fondateur et des membres clés de l'équipe : c'est donc un produit NVIDIA fondé sur la conception de Groq, qui utilise le nom Groq sous licence. L'entreprise Groq reste indépendante et GroqCloud continue de fonctionner.
Côté chiffres clés : NVIDIA cite 3 400 tokens par seconde sur Gemma 4 31B avec un contexte de 100K, ainsi qu'une projection de 35x de débit par mégawatt et de 10x de revenu par watt par rapport à sa génération précédente. Ce sont des affirmations du constructeur, mesurées par rapport aux références de NVIDIA elle-même : lisez-les comme un objectif, pas comme un résultat indépendant testé. Si vous construisez des agents ou automatisez le support, l'enseignement pratique est plus simple : vous n'achèterez presque certainement pas ce rack, vous consommerez la vitesse qu'il débloque via un modèle ou un cloud, et ce que vous déployez réellement est un coéquipier comme eesel posé par-dessus.
Ce qu'est réellement Groq 3 LPX
NVIDIA décrit Groq 3 LPX comme « l'accélérateur d'inférence IA interactive pour NVIDIA Vera Rubin ». En termes plus simples : c'est un rack entier de puces spécialisées dont l'unique rôle est de générer des tokens vite, et il s'intègre à la plateforme de centre de données la plus récente de NVIDIA, aux côtés des GPU généralistes.
NVIDIA s'appuie sur un compromis classique à trois branches. Pendant des années, le matériel d'inférence offrait deux propriétés sur trois : intelligence et débit, ou intelligence et interactivité, mais jamais les trois à bas coût. Les gros modèles sont lents à converser ; les modèles rapides sont petits. Groq 3 LPX est présenté comme la pièce qui permet à un gros modèle de rester réactif, en confiant la partie sensible à la latence de chaque token à une puce conçue exactement pour cela.
Il faut être précis sur ce qu'il n'est pas. Ce n'est pas un produit autonome que l'on glisse dans n'importe quel serveur, ni un remplaçant du GPU. C'est une extension co-conçue de Vera Rubin NVL72 qui fonctionne à côté des GPU Rubin, les deux calculant conjointement chaque couche du modèle pour chaque token de sortie. NVIDIA appelle même la LPU « la septième puce » de la plateforme Vera Rubin.
Attendez, c'est la startup Groq ?
C'est la réaction la plus courante que j'aie vue, et elle est légitime. Pendant des années, Groq a été la startup d'inférence audacieuse dont la LPU servait de contre-exemple à « il suffit d'ajouter des GPU ». Désormais, « Groq 3 LPX » est une gamme de produits NVIDIA. Une personne sur X a bien résumé l'ambiance :
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
Voici la version exacte, tirée des sources primaires. Groq a conclu un accord de licence non exclusif avec NVIDIA pour sa technologie d'inférence, la même que celle qui se trouve derrière les tarifs de GroqCloud et sa gamme d'alternatives à Groq. Dans ce cadre, le fondateur Jonathan Ross et d'autres membres de l'équipe Groq ont rejoint NVIDIA pour aider à faire passer à l'échelle la conception sous licence. Groq reste indépendant sous la direction d'un nouveau PDG, Simon Edwards, et GroqCloud continue de fonctionner. La page de presse de NVIDIA porte en pied de page la mention « Groq and LPU are used under license from Groq, Inc. »
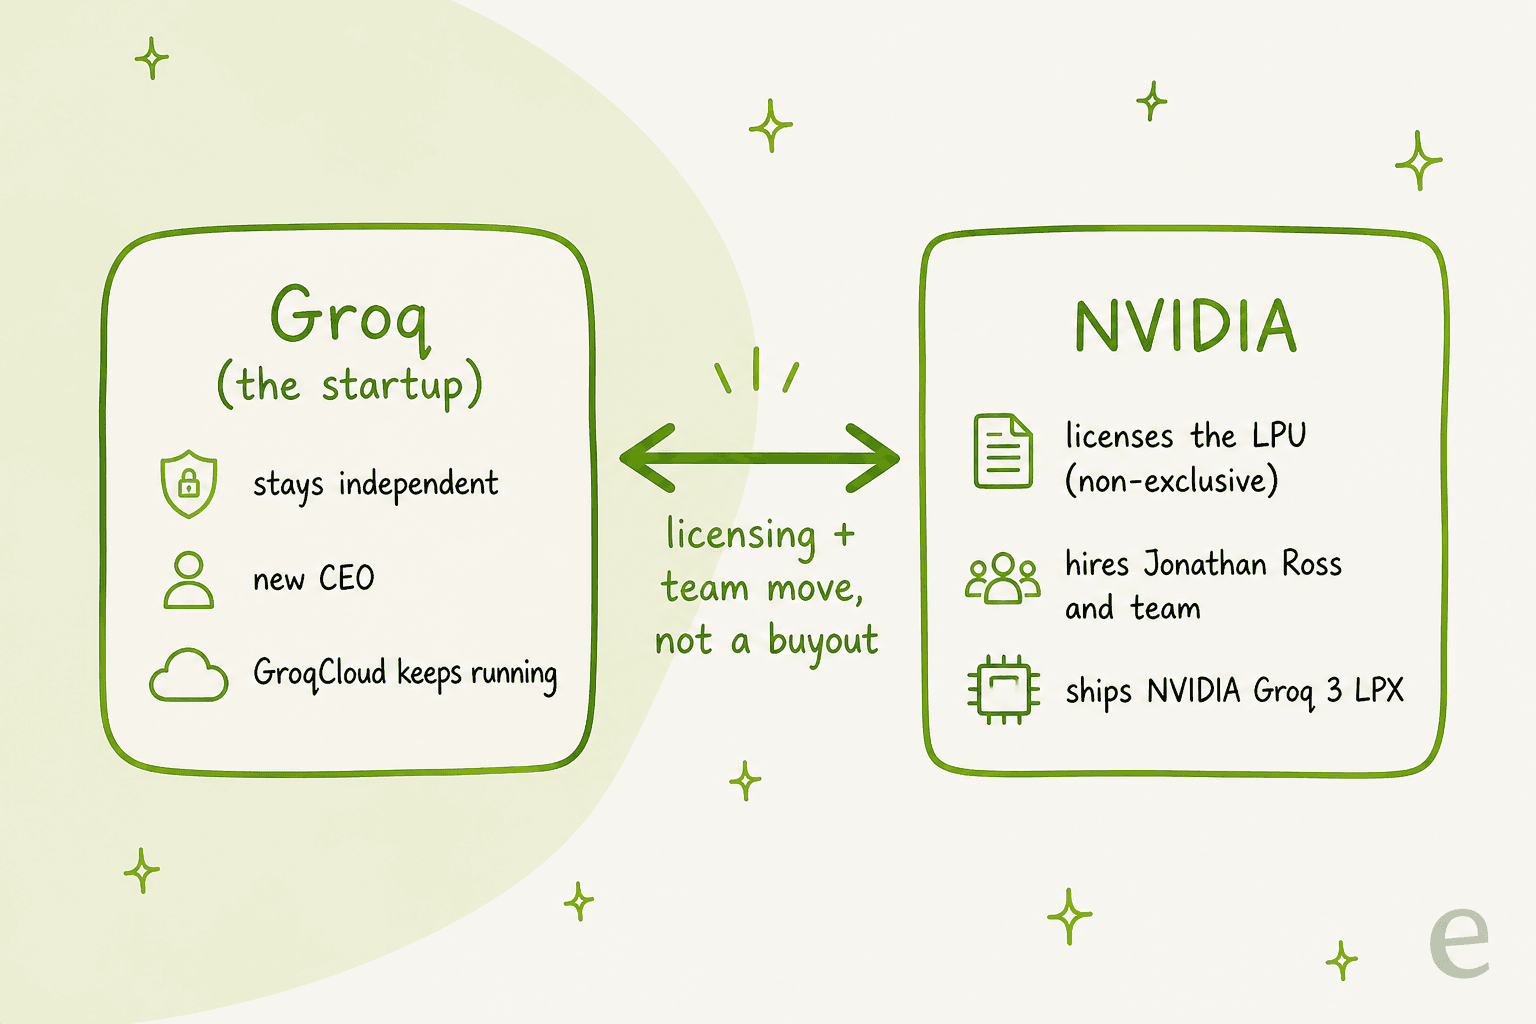
Donc, quand vous lisez « NVIDIA Groq 3 LPX », imaginez une licence et une embauche d'équipe, pas une acquisition nette. Des montants élevés circulent dans la presse à propos de l'accord, mais ces chiffres n'apparaissent dans aucune des déclarations des deux entreprises, je les laisse donc de côté. Ce que les sources primaires étayent, c'est la structure ci-dessus, et c'est elle qui compte pour comprendre le produit.
Le tout, dans un seul rack
Les spécifications sont la partie amusante, car elles sont vraiment inhabituelles. Voici ce que NVIDIA indique pour un seul rack Groq 3 LPX.
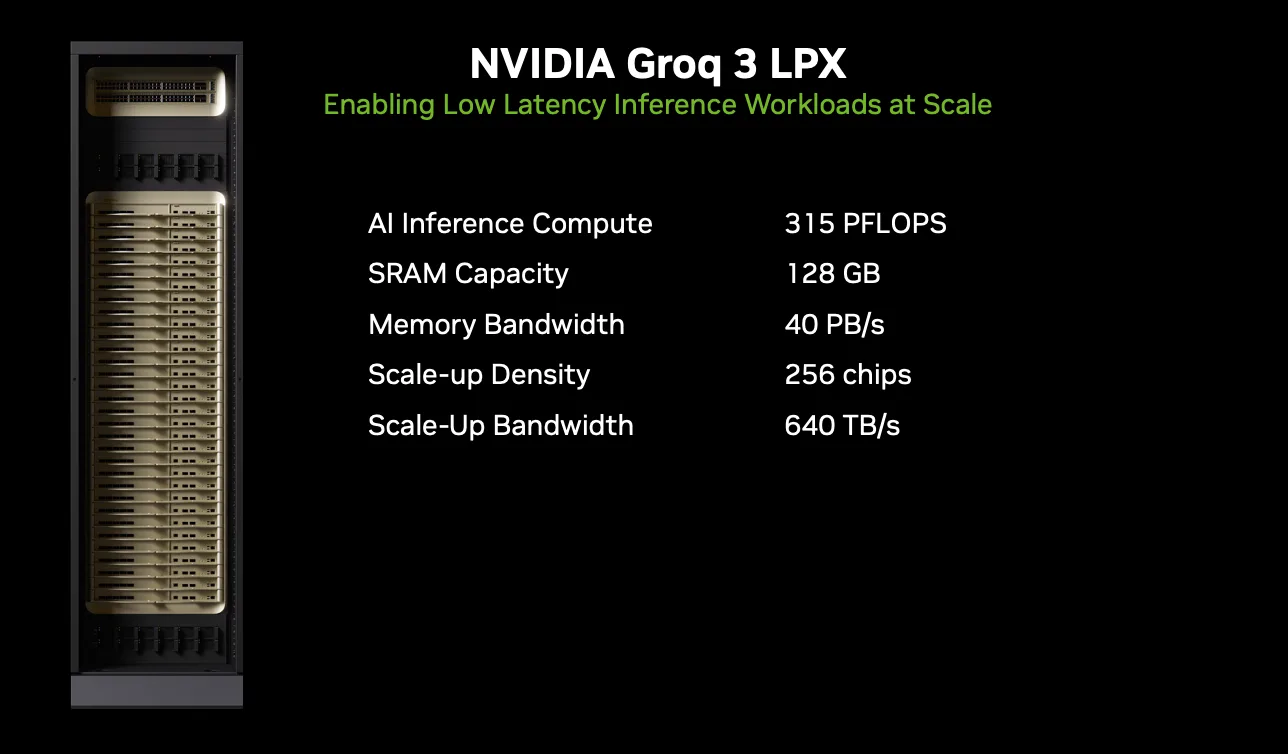
| Spécification au niveau du rack | NVIDIA Groq 3 LPX |
|---|---|
| Puces par rack | 256 accélérateurs Groq 3 LPU |
| Calcul d'inférence IA | 315 PFLOPS (FP8) |
| Capacité totale de SRAM | 128 Go |
| Bande passante SRAM sur puce | 40 Po/s |
| Bande passante de scale-up | 640 To/s |
| Construction | 32 plateaux de calcul 1U refroidis par liquide, 8 LPU chacun |
Le chiffre qui saute aux yeux, c'est 40 pétaoctets par seconde de bande passante SRAM sur puce. Ce n'est pas une faute de frappe, et c'est toute la thèse de la conception en un seul chiffre. Au lieu d'alimenter les puces depuis une mémoire externe plus lente, la LPU garde les données de travail sur la puce et les déplace à une bande passante qu'une configuration mémoire conventionnelle ne peut atteindre. Le compromis, c'est la capacité : 128 Go de SRAM dans un rack, c'est minuscule à côté des téraoctets de HBM d'un rack de GPU, et c'est précisément pourquoi les LPU ont besoin des GPU à leurs côtés.
Pourquoi construire une puce entièrement nouvelle ?
Pour comprendre pourquoi NVIDIA s'est donné cette peine, il aide de mettre les deux puces côte à côte. Le schéma de NVIDIA le fait clairement.
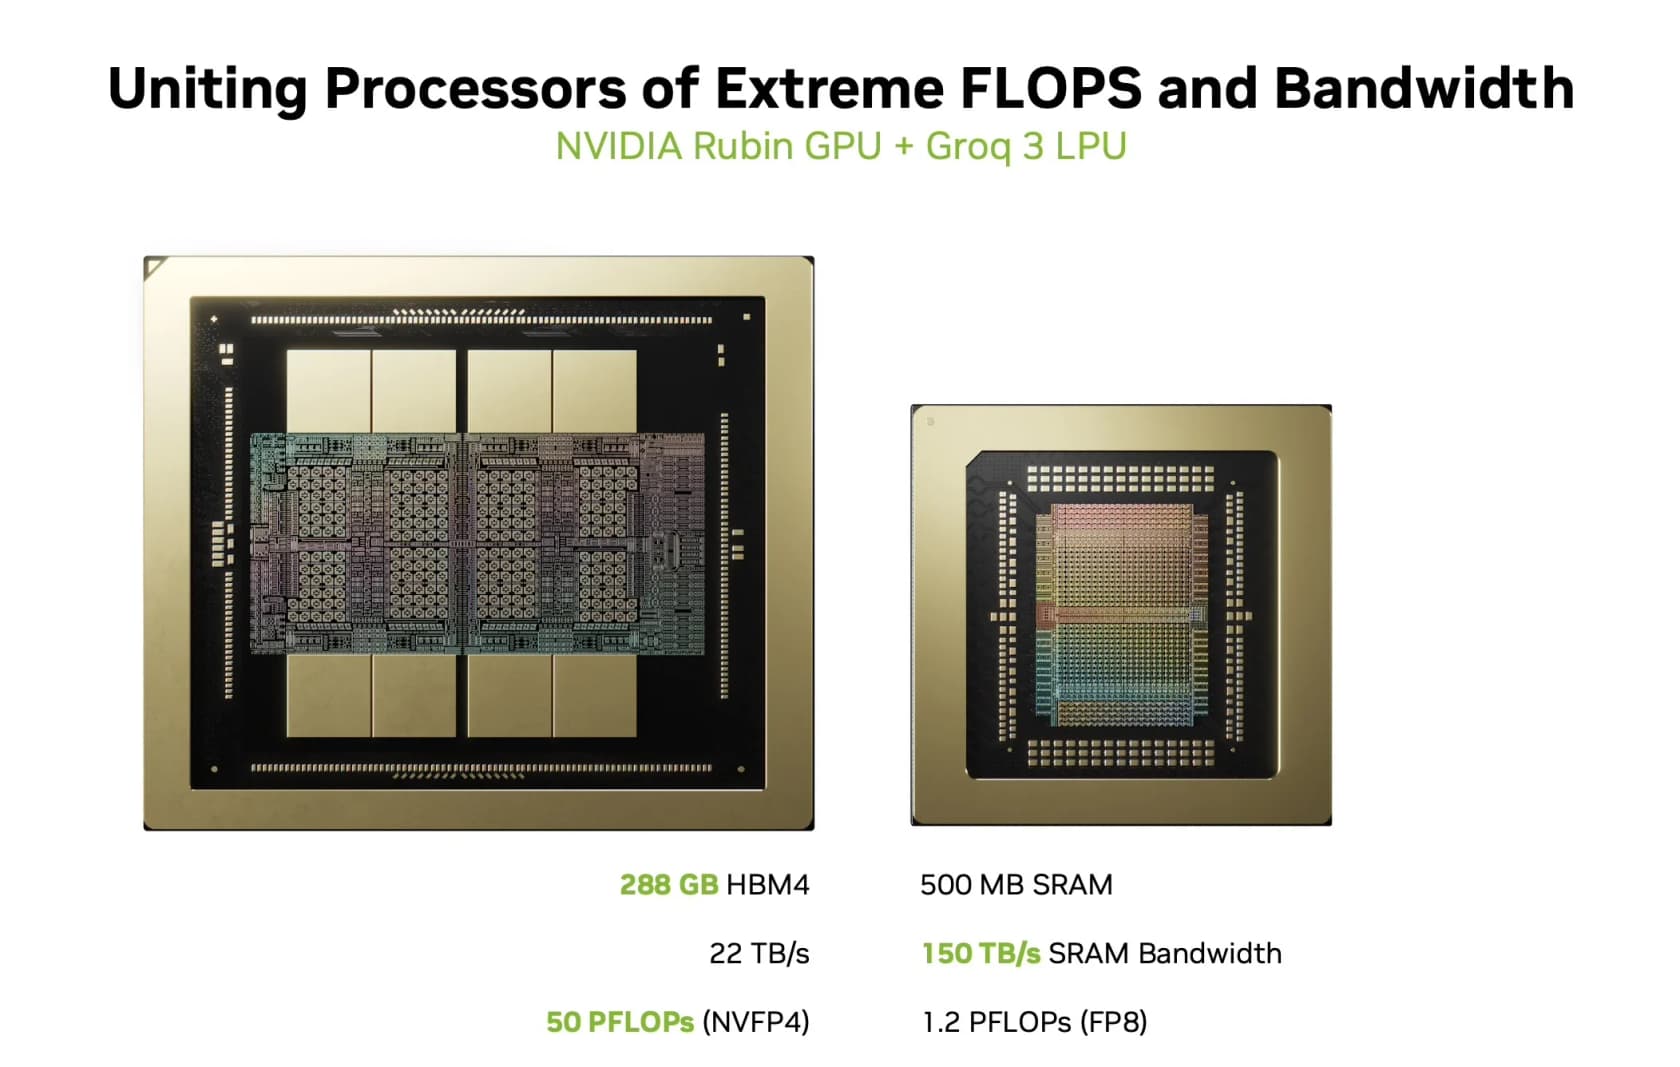
Un GPU Rubin apporte environ 288 Go de HBM4, quelque 22 To/s de bande passante mémoire et environ 50 PFLOPs de calcul. Une seule Groq 3 LPU apporte 500 Mo de SRAM, mais à 150 To/s de bande passante, avec 1,2 PFLOPs de calcul FP8. Le GPU est un cheval de labour optimisé pour le débit maximal et la grande mémoire. La LPU est optimisée pour une seule chose : maintenir un flux de tokens avec une latence prévisible et faible.
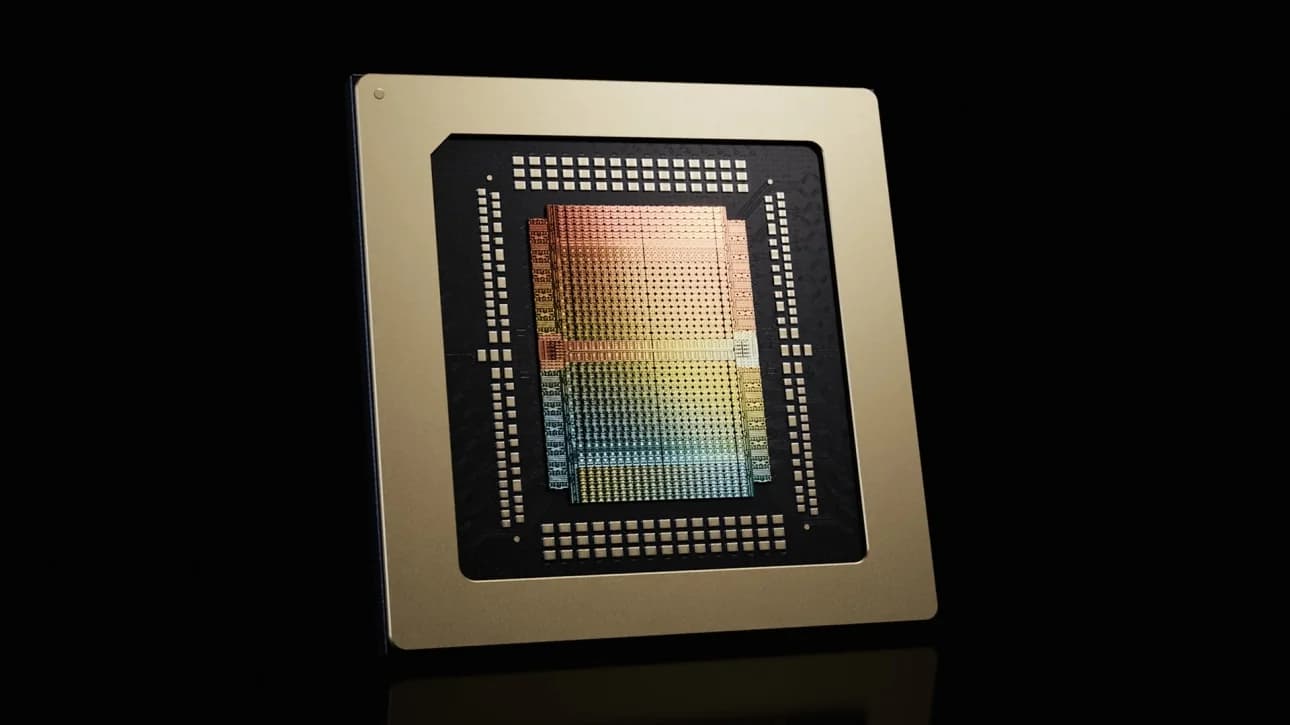
Les choix de conception sous le capot sont ce qui distingue la LPU d'un GPU, et je les trouve vraiment intéressants car ils inversent des choses que les programmeurs GPU tiennent pour acquises :
- La SRAM est la mémoire principale, pas un cache. Il y a 500 Mo de SRAM sur puce par LPU, qui contient directement les poids actifs, les activations et l'état KV. Il n'y a aucune HBM sur la puce.
- Aucun cache géré par le matériel. Le compilateur et le runtime placent et déplacent explicitement les données, au lieu de s'appuyer sur des heuristiques de cache. Cela réduit les blocages imprévisibles et garde la latence stable.
- Exécution déterministe planifiée par le compilateur. La puce s'appuie sur le modèle d'exécution spatiale de Groq, où le calcul, le déplacement des données et la synchronisation sont planifiés à l'avance. NVIDIA décrit un protocole matériel qui annule la dérive d'horloge pour que des centaines de LPU agissent comme un système coordonné.
- Déplacement de données explicite, centré sur les tenseurs. Tout opère sur des vecteurs fixes de 320 octets via des unités dédiées de matrices, de vecteurs et de commutation, de sorte que la planification reste prévisible.
Si vous vous êtes déjà demandé pourquoi les coûts d'inférence des LLM sont si sensibles à la latence, voici la réponse côté matériel : construire une puce dont le timing est connu, puis en câbler des centaines sans perdre cette propriété.
Comment ça marche vraiment : une boucle à deux moteurs
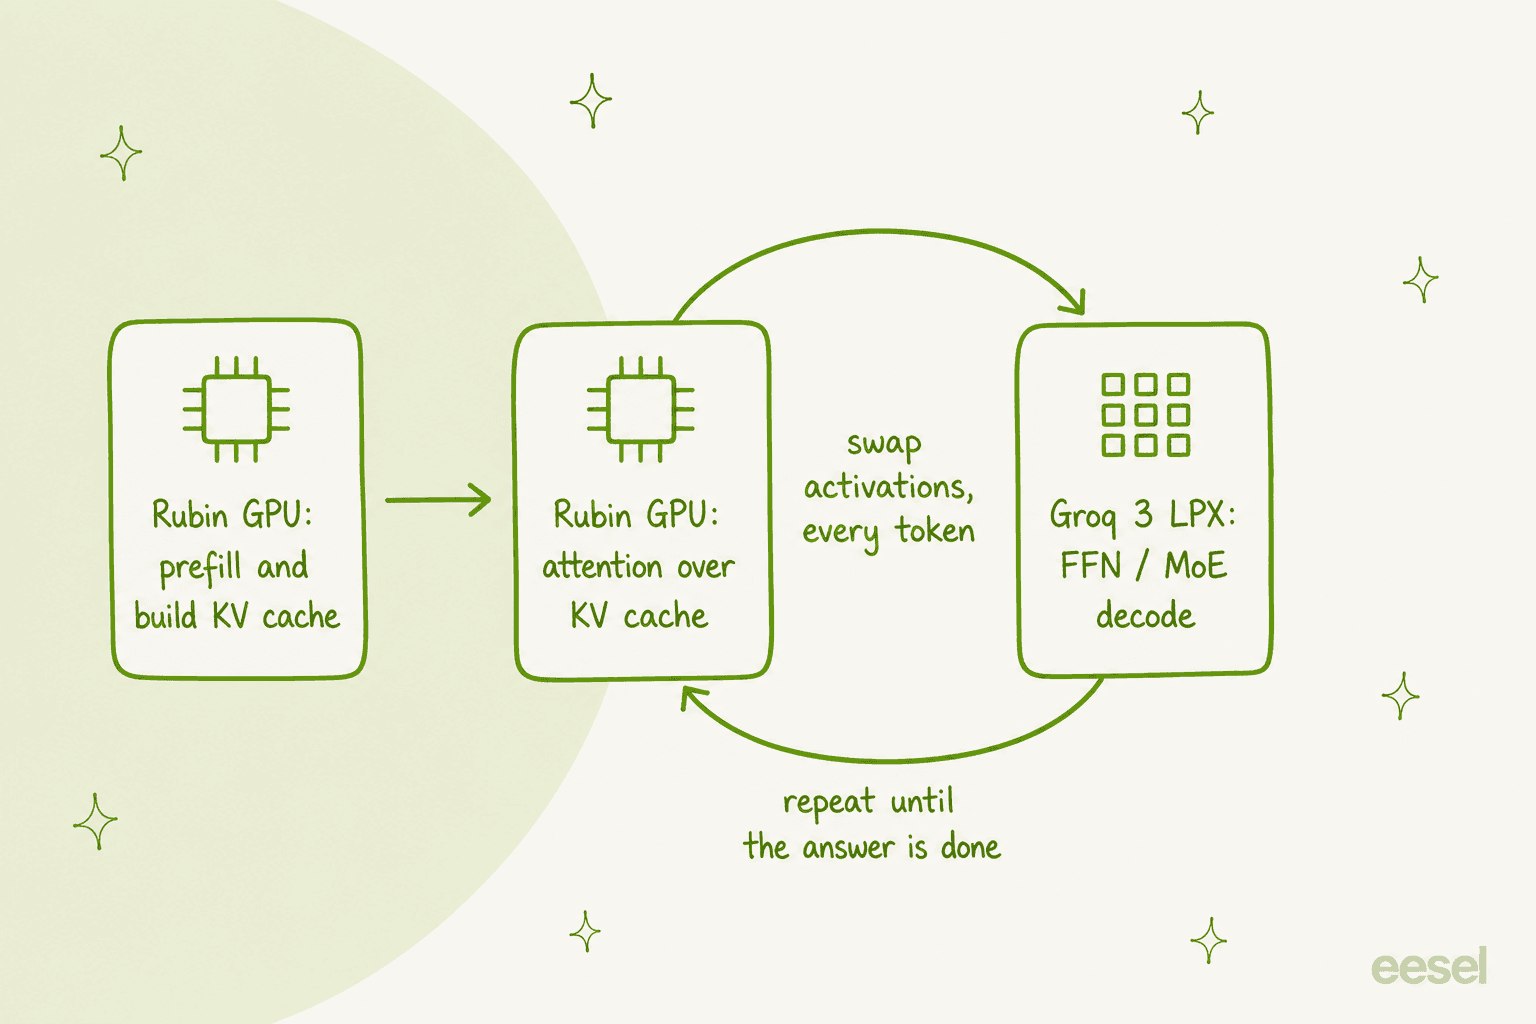
C'est ici que tout s'éclaire. L'idée de NVIDIA est que l'inférence n'est pas une charge de travail uniforme. Une requête comporte deux phases très différentes, qui demandent du matériel différent.
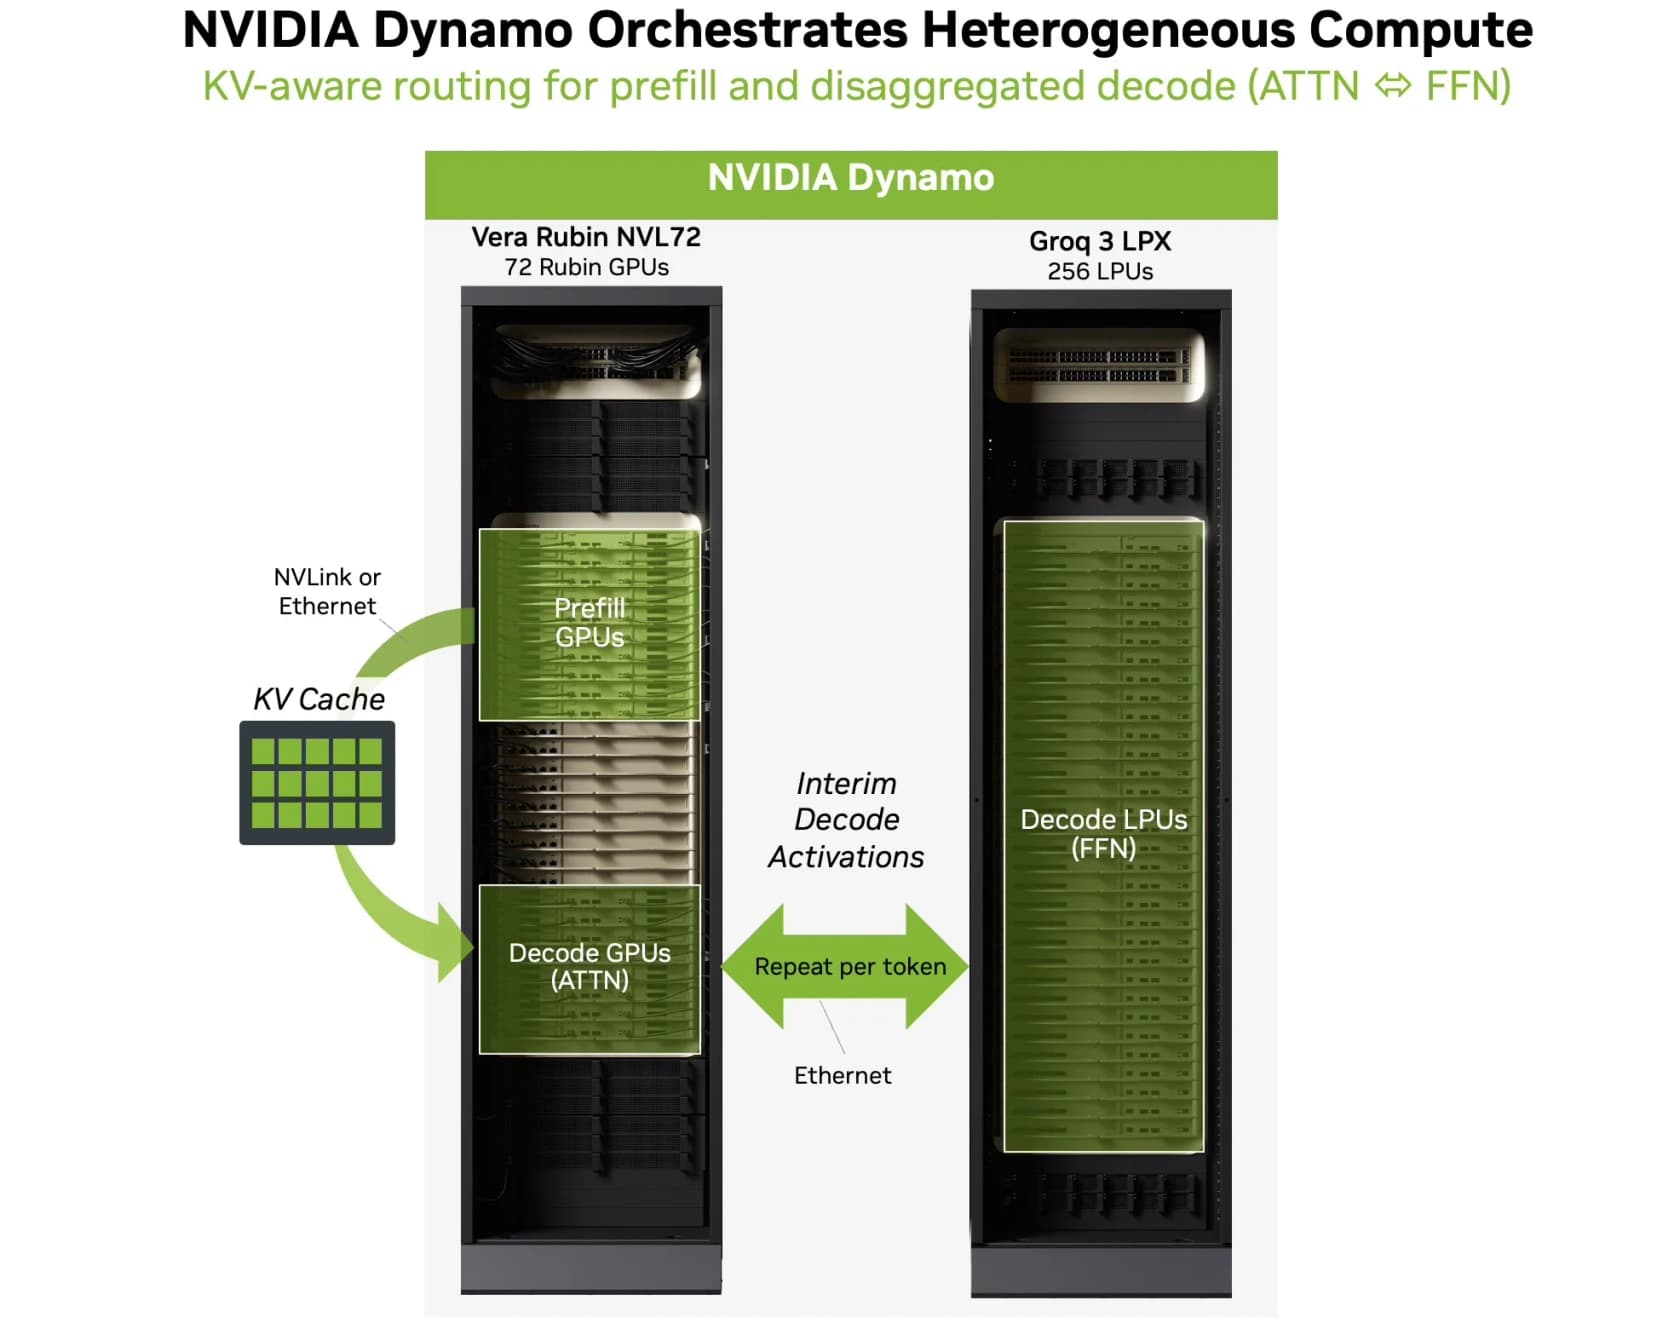
La première phase, le prefill, ingère votre prompt et construit le cache KV. C'est un travail dense, parallèle et gourmand en mémoire, qui convient bien au GPU. La seconde phase, le decode, génère la réponse token par token dans une boucle. NVIDIA répartit cette boucle entre les deux puces, avec une technique qu'elle appelle désagrégation attention-FFN : les GPU Rubin exécutent l'attention sur le contexte accumulé, et Groq 3 LPX gère les calculs feed-forward et de mélange d'experts, les plus sensibles à la latence. Pour chaque token, les deux échangent des activations intermédiaires.
Le régulateur de trafic de tout cela est NVIDIA Dynamo, la couche d'orchestration qui oriente le prefill vers les workers GPU, déplace les activations par token entre les moteurs et planifie le tout selon des objectifs de latence, afin qu'une session interactive ne reste pas coincée derrière un job par lots.
LPX joue un rôle de plus qu'il vaut la peine de connaître : il sert de moteur de brouillon pour le décodage spéculatif. Son exécution déterministe et sa bande passante SRAM énorme lui permettent de produire rapidement des tokens de brouillon, en avance sur le GPU, qui les vérifie. C'est une autre manière dont les deux puces se partagent le travail au lieu de le dupliquer.
À l'intérieur du rack
Si vous aimez voir où se trouvent physiquement les pièces, le schéma du plateau de calcul de NVIDIA est la vue la plus claire. Un rack compte 32 de ces plateaux 1U refroidis par liquide, et chaque plateau contient huit LPU.
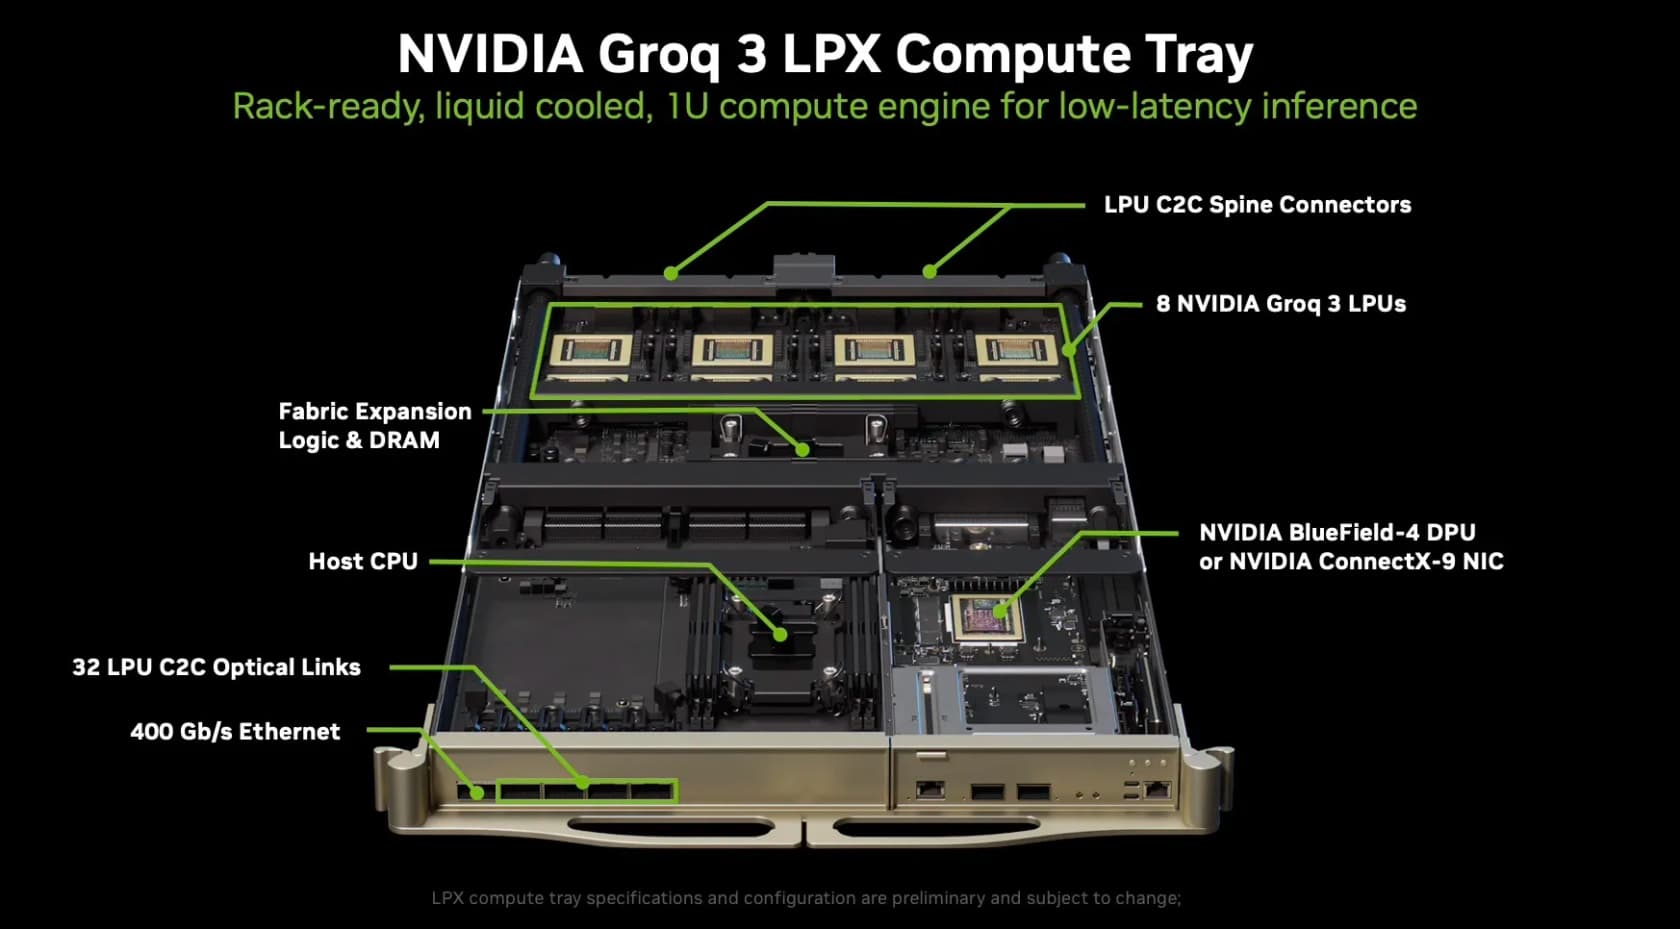
Quelques éléments ressortent de cette disposition. Chaque LPU se connecte via 96 liaisons puce à puce à 112 Gbit/s, soit 2,5 To/s de bande passante de scale-up par puce, ce qui permet à 256 d'entre elles de se comporter comme une seule machine. Chaque plateau embarque aussi un DPU BlueField-4 et un CPU hôte, et l'ensemble est sans câble et refroidi par liquide. Il repose sur l'architecture de rack MGX de NVIDIA, de sorte qu'un centre de données peut prévoir une conception de rack commune pour tout son déploiement Vera Rubin plutôt qu'une configuration sur mesure pour le chemin d'inférence.
Les affirmations de performance, et comment les lire
Passons aux chiffres que tout le monde cite. Le titre de NVIDIA est jusqu'à 35x plus de débit par mégawatt pour des modèles à mille milliards de paramètres lorsque Vera Rubin NVL72 est associé à LPX, par rapport à sa génération précédente GB200, mesuré à 400 tokens par seconde par utilisateur. NVIDIA projette aussi jusqu'à 10x plus de revenu par watt pour les charges les plus sensibles à la latence. L'image la plus claire est le graphique de Pareto de NVIDIA.
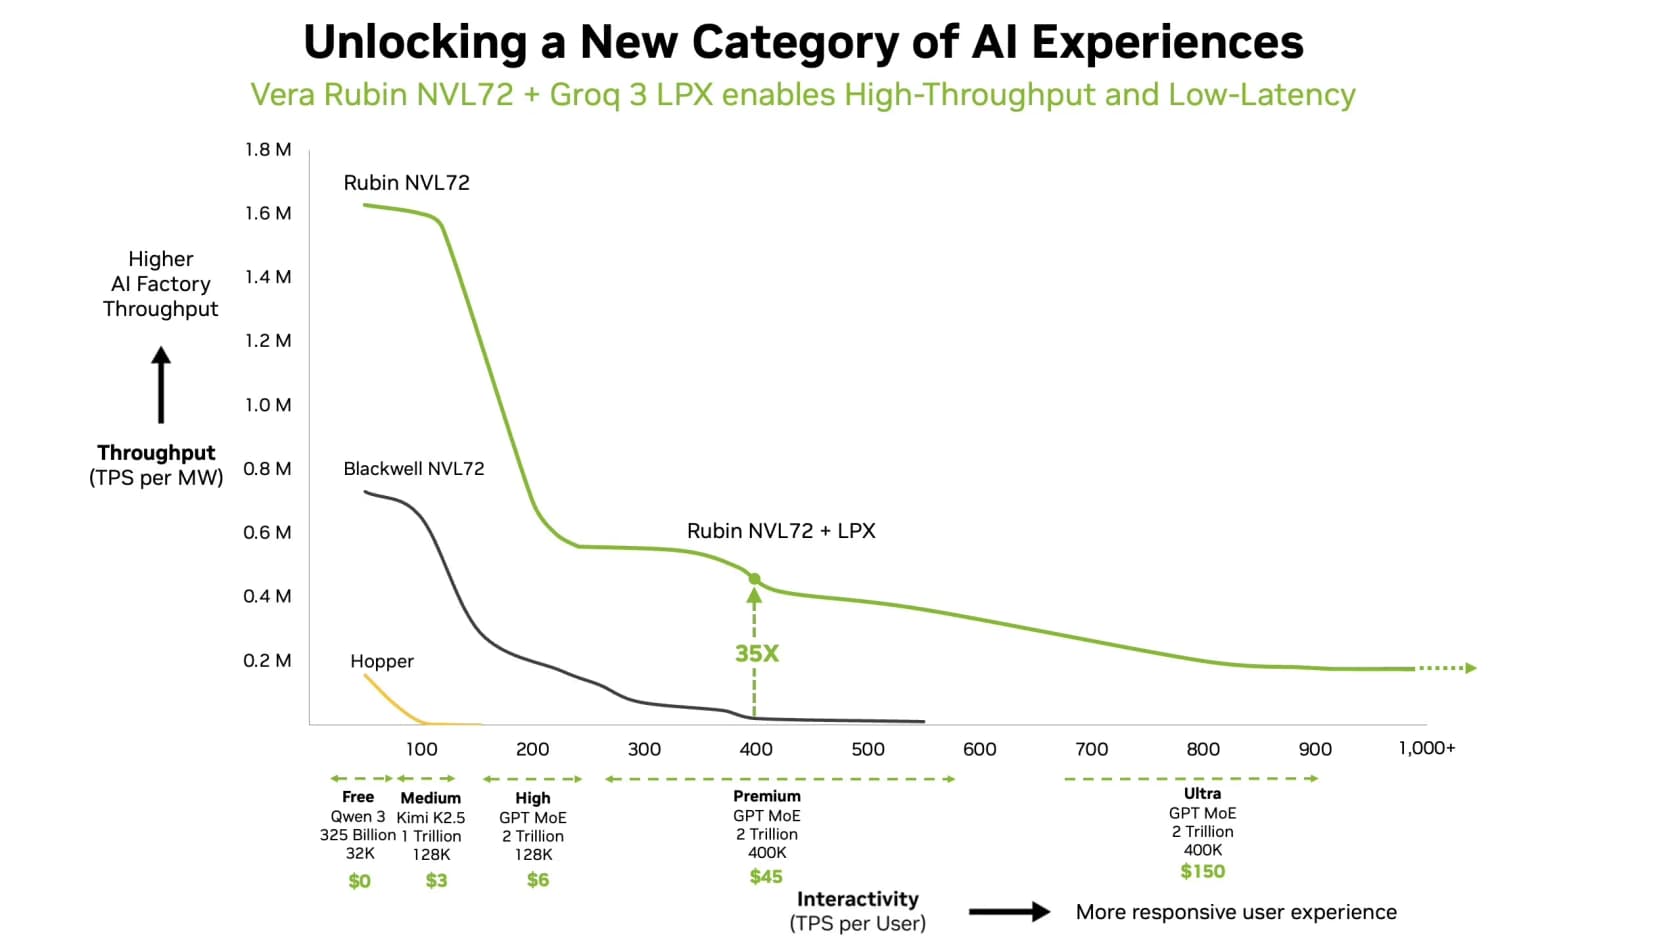
Lu honnêtement, le graphique dit quelque chose de réel : l'écart entre la ligne verte (Rubin plus LPX) et les anciens systèmes s'ouvre spectaculairement sur le côté droit, là où chaque utilisateur reçoit des tokens rapidement. À faible interactivité, tout le monde se ressemble ; à forte interactivité, le chemin LPX reste haut tandis que les lignes GPU seul s'effondrent. C'est l'affirmation réelle, et elle est cohérente.
La réserve honnête concerne qui a mesuré. Ce sont les chiffres de NVIDIA face aux références de NVIDIA, et le scénario « premium » modélisé est un modèle précis de 2 mille milliards de paramètres avec un contexte de 400K. Le seul point de données d'allure indépendante que j'aie trouvé est un benchmark d'Artificial Analysis cité par NVIDIA, de 3 400 tokens par seconde sur Gemma 4 31B avec un contexte de 100K. C'est un chiffre solide, mais presque toute la conversation publique jusqu'ici répète les diapositives de NVIDIA au lieu de tester le matériel, car Nebius n'est que le premier cloud à le déployer. Sur Hacker News, l'un des rares avis de fond l'a lu à l'aune du bilan de Groq plutôt que du marketing :
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

Ma lecture : l'architecture est réellement astucieuse, le benchmark est prometteur, et le chiffre de 35x est un chiffre marketing du meilleur cas qu'il faut tenir avec prudence tant que des tiers ne l'ont pas reproduit.
Pourquoi maintenant : l'inférence est devenue la partie coûteuse
Une puce comme celle-ci existe parce que la forme des charges de travail IA a changé. Quand l'inférence se résumait à une réponse de chatbot, la latence de decode comptait peu. Les systèmes agentiques ont tout changé. Ils génèrent des tokens sur des centaines, voire des milliers d'étapes, et NVIDIA cite des données montrant que les charges agentiques consomment environ 15 fois plus de tokens qu'une simple requête de chat. Chaque petit retard par token se multiplie désormais le long d'une longue chaîne.
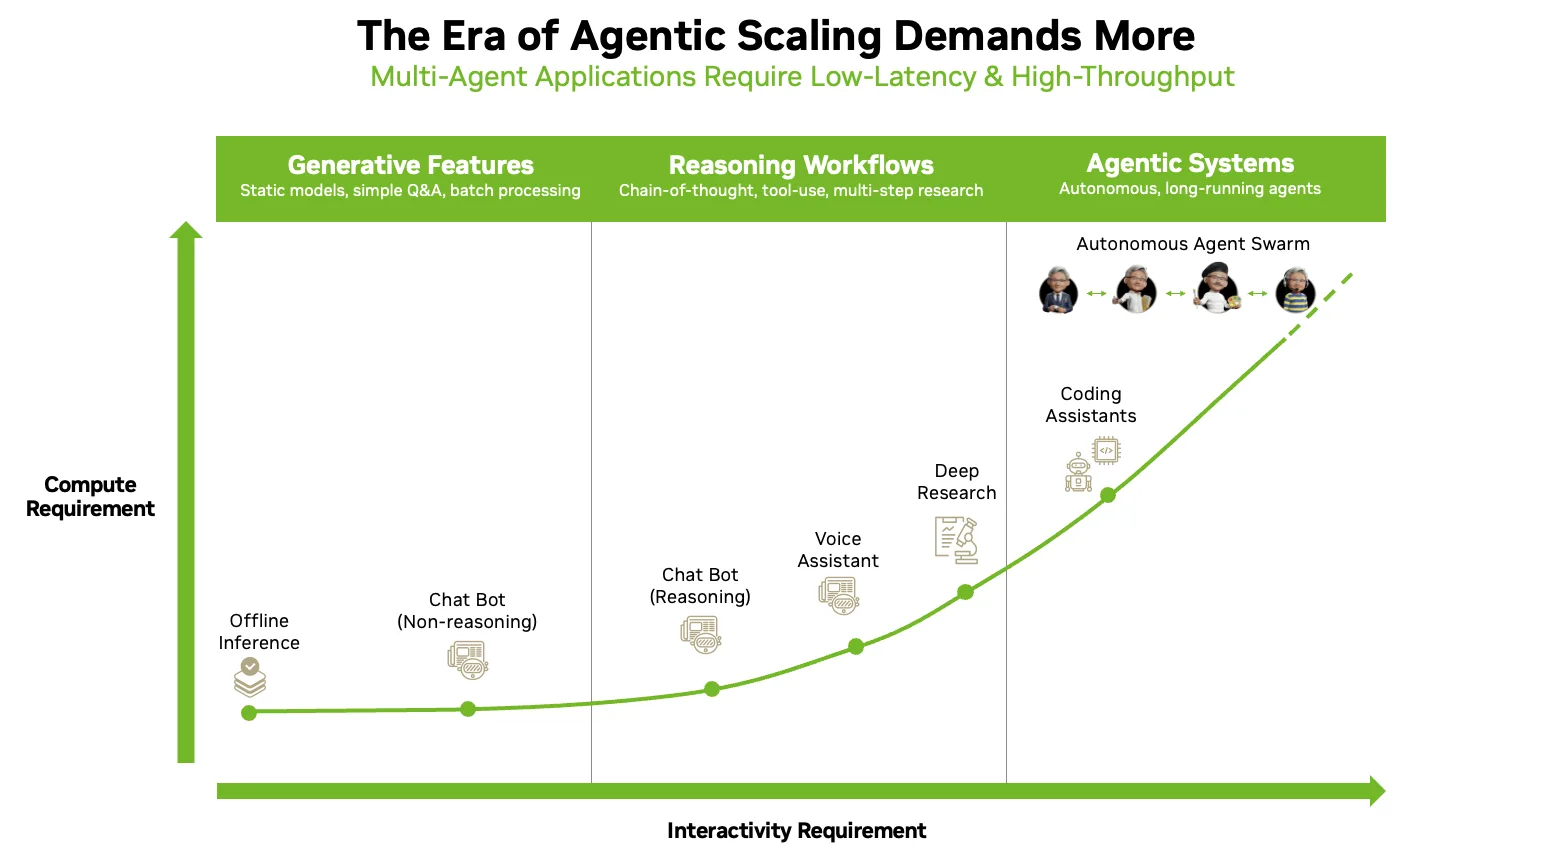
On voit le même basculement dans la direction que prend l'argent du marché. L'activité centres de données de NVIDIA surfe fortement sur cette vague : l'entreprise a annoncé 96,2 milliards de dollars de chiffre d'affaires pour son trimestre clos fin juillet 2026, en hausse de 106 % sur un an. L'inférence, et non l'entraînement, est désormais le moteur de croissance, et une puce conçue spécifiquement pour la génération à faible latence et en plusieurs étapes est un pari direct là-dessus. Un analyste sur X a bien résumé l'angle stratégique :
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
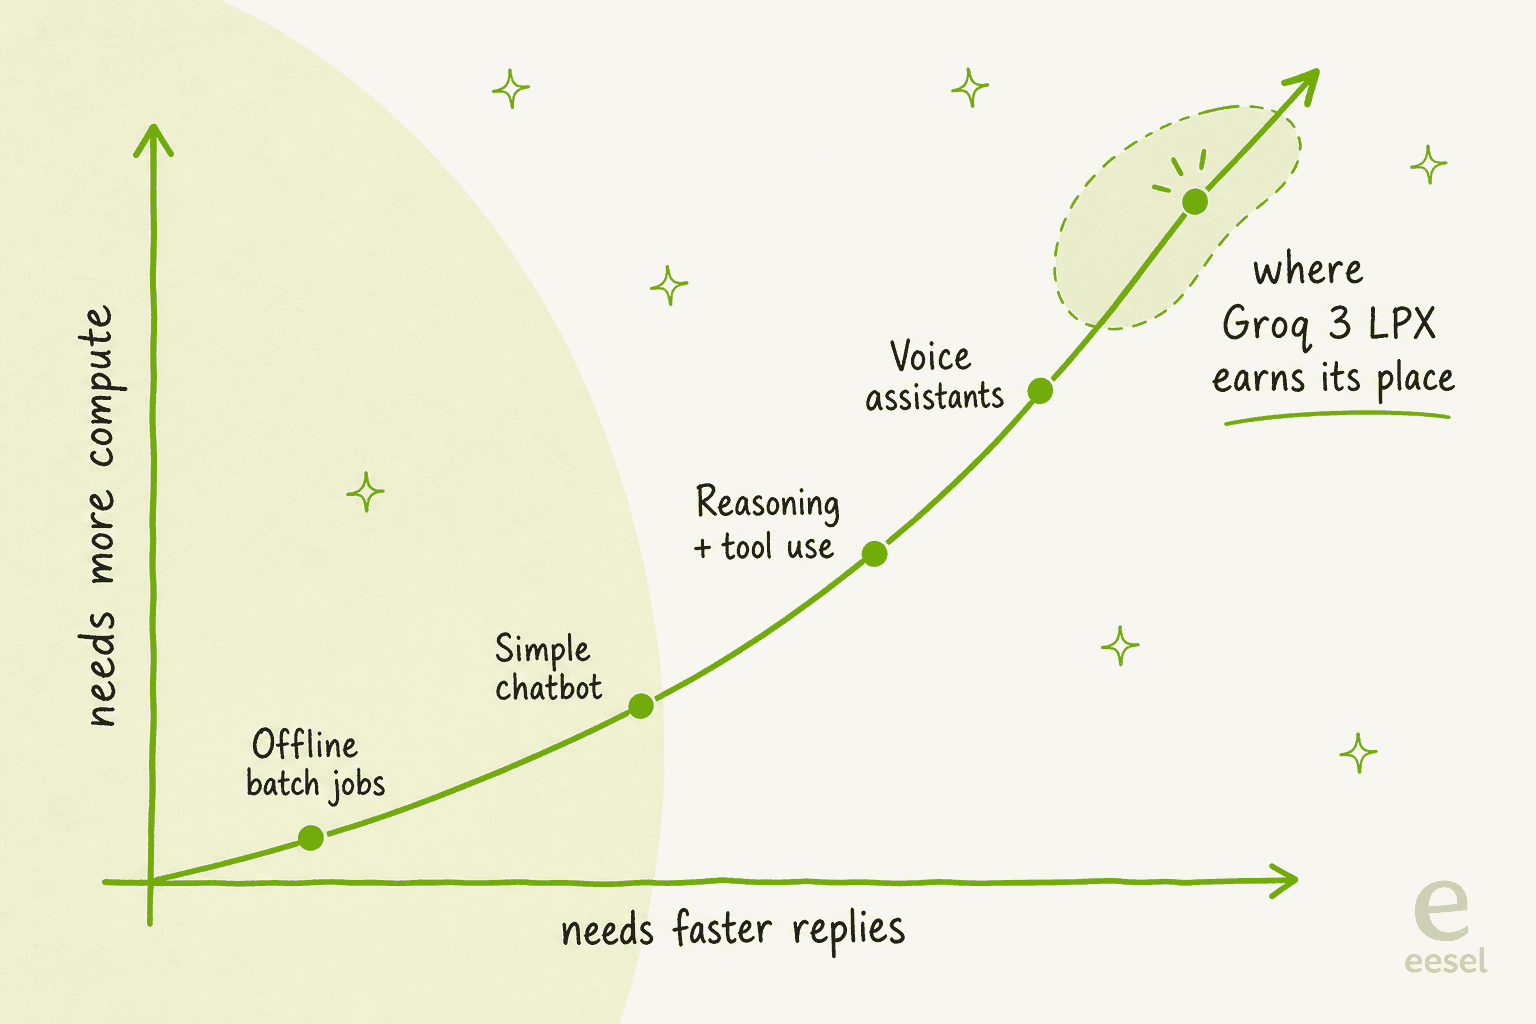
Le modèle mental utile : plus votre charge de travail penche vers « beaucoup d'échanges rapides », plus un moteur dédié à faible latence compte. Les jobs par lots s'en moquent. Les assistants de code, les essaims d'agents et la voix y tiennent beaucoup.
Ce que cela signifie si vous construisez avec l'IA
Voici la partie sur laquelle je veux être franc, car il est facile de se laisser emporter par la fiche technique. À moins d'exploiter un cloud ou une très grande plateforme d'IA, vous n'achèterez pas de rack Groq 3 LPX. C'est une infrastructure située plusieurs couches sous l'endroit où travaillent la plupart des équipes. Vous la ressentirez sous forme de tokens plus rapides et moins chers dans les API de modèles et les clouds que vous utilisez déjà, comme vous n'avez jamais acheté de GPU pour utiliser un agent IA.
Et c'est là le recadrage utile. La puce est le moteur ; ce que vous déployez réellement, c'est le travailleur qui roule par-dessus. Une inférence plus rapide rend les agents plus réactifs et moins chers à exploiter, abaisse le seuil pour mettre une vraie automatisation en production et change le calcul des coûts face à un agent humain, qu'il s'agisse d'un agent de code, d'un agent de recherche ou d'un agent de helpdesk IA qui traite votre file de support. La course au matériel vise à rendre cette couche viable à grande échelle. La valeur reste dans la couche.
Où eesel s'inscrit
Les puces comme Groq 3 LPX, c'est la plomberie. eesel est ce que vous recrutez pour faire le travail par-dessus. eesel est une plateforme de coéquipiers IA : vous ne provisionnez pas d'inférence ni ne montez de pipeline, vous faites venir un coéquipier prêt à travailler pour un rôle précis et vous le branchez à vos applications. L'équipe actuelle comprend un coéquipier de helpdesk IA qui rejoint votre file de support et fait plus qu'un simple chatbot de support, et un rédacteur de blog IA qui produit des contenus comme cet article.

La différence concrète tient à l'endroit où atterrissent les tokens rapides. Un coéquipier de support qui répond en une seconde au lieu de huit, c'est toute l'expérience pour la personne qui attend, et les années passées à exploiter l'IA sur de vraies files de support nous ont appris la moitié peu glamour : la vitesse n'aide que si la réponse est juste, c'est pourquoi eesel simule un déploiement sur vos anciens tickets avant de répondre à un vrai client. Tout le silicium du monde ne corrige pas une mauvaise réponse énoncée avec aplomb. Si vous voulez voir le coéquipier plutôt que le rack, vous pouvez essayer eesel gratuitement.