

Qwen 3.8 Flash Next est l'aperçu open-weight de l'équipe Qwen de son architecture Qwen4 de nouvelle génération, publié le 26 août 2026. Le nom déroute, alors commençons par là : Flash Next est l'aperçu de recherche en poids ouverts que vous hébergez vous-même ; Qwen3.8-Flash est la future API hébergée avec une fenêtre de contexte de 1M et des outils intégrés. Ce sont deux visages du même modèle.
Les spécifications sont tout l'intérêt. C'est un modèle à mélange d'experts de 125B qui n'active que 6B paramètres par token, associé à une table de consultation de N-grammes de 51B que vous pouvez décharger vers la RAM ordinaire du système. Cette conception explique pourquoi il tourne vite sur du matériel qui ne pourrait jamais contenir un modèle dense de cette taille, et pourquoi la version hébergée est facturée seulement $0.15 en entrée / $0.47 en sortie par million de tokens.
Les tests indépendants confirment le battage jusqu'à un certain point : Artificial Analysis le place parmi les tout premiers modèles en intelligence pour son prix. Le hic, répété dans tous les fils de discussion de la communauté, c'est qu'il s'agit d'un aperçu de R&D volontairement sous-entraîné, pas d'un modèle de production terminé. GLM 5.3 Flash est le rival le plus abouti si vous avez besoin de quelque chose de stable aujourd'hui.
Si vous êtes ici parce que vous voulez une IA bon marché pour le support client, le choix du modèle est la partie facile. Un modèle brut ne lit pas vos tickets, ne rédige pas de réponses et n'escalade pas. C'est le travail d'une plateforme, et c'est exactement ce que fait eesel au-dessus de modèles comme celui-ci.
Ce qu'est réellement Qwen 3.8 Flash Next
Je construis des agents IA chez eesel, ce qui veut dire que je vois la couche des modèles bouger toutes les deux semaines et que j'ai appris à lire au-delà des visuels de lancement. Quand l'équipe Qwen a publié Qwen 3.8 Flash Next le 26 août 2026, la première chose que j'ai faite a été de démêler le nom, car il est vraiment déroutant.
Voici la version claire. "Flash" est la gamme économique et rapide de Qwen. "Next" n'est pas un Flash plus gros ou plus récent. C'est l'étiquette que Qwen appose sur un aperçu d'architecture, le même rôle que Qwen3-Next a joué avant Qwen3.5. Flash Next existe pour que la communauté puisse tester la nouvelle plomberie avant que toute la famille Qwen4 soit construite dessus.
La distinction pratique compte, car elle change ce que vous pouvez en faire :
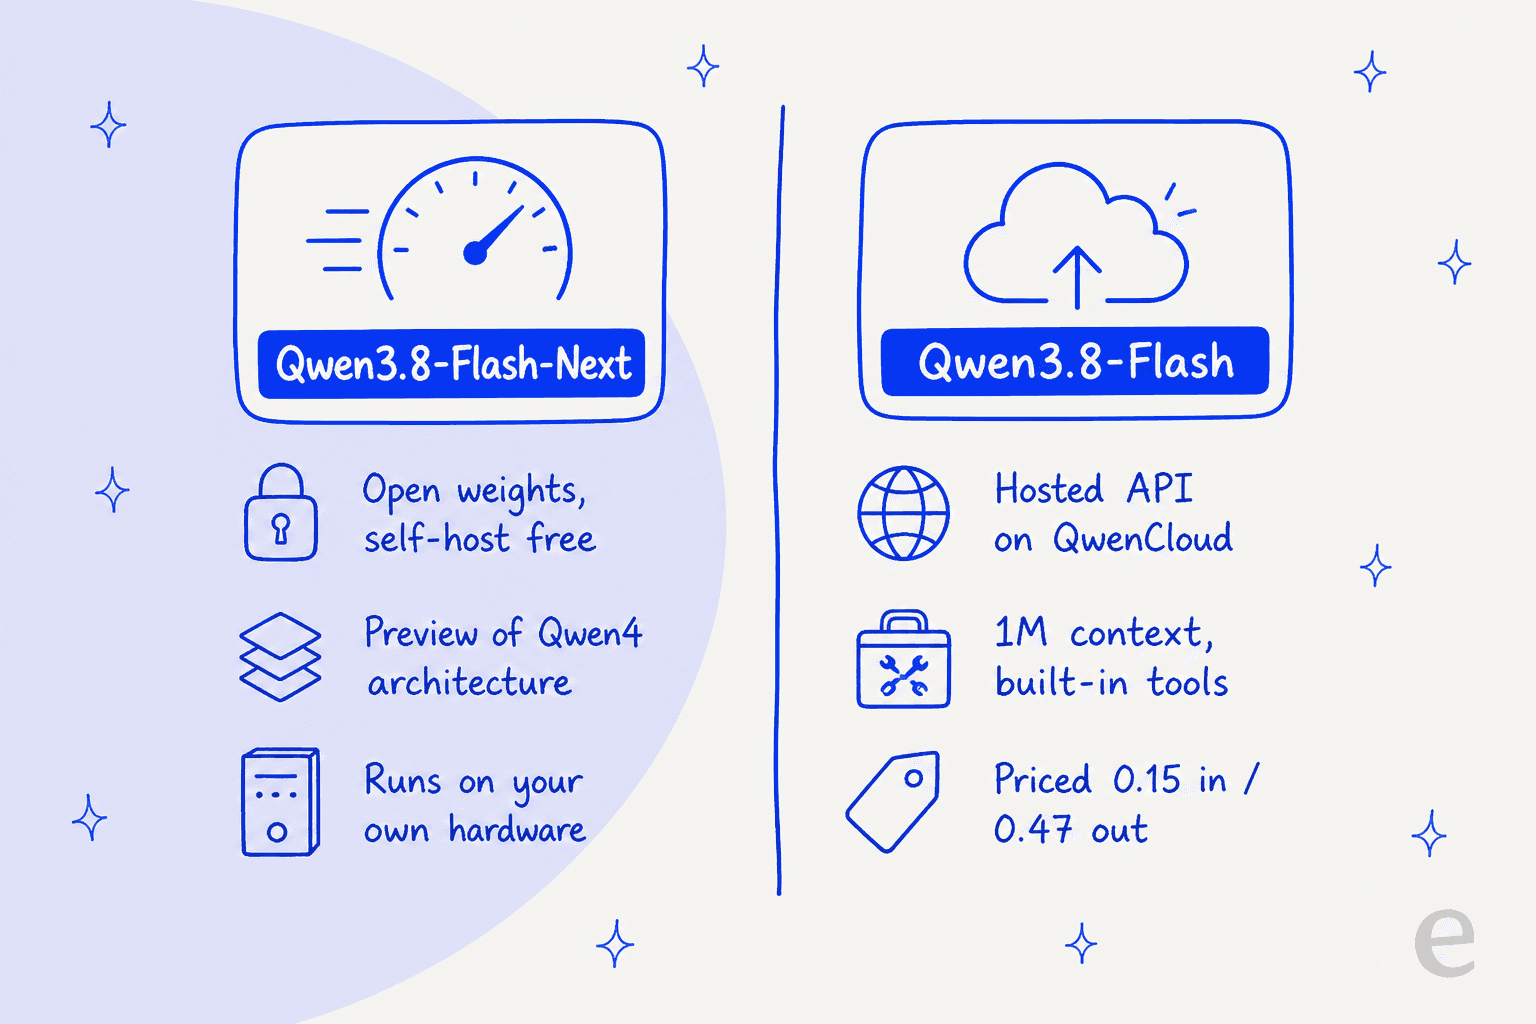
- Qwen3.8-Flash-Next est la version en poids ouverts sur Hugging Face et ModelScope, sous la Qwen Community License 1.0. Vous la téléchargez et l'exécutez vous-même.
- Qwen3.8-Flash est la version de production servie sur QwenCloud, avec 1M de contexte par défaut et des outils intégrés officiels. C'est celle que vous appelez via une API.
C'est déjà un vrai changement par rapport à Qwen 3.7 Flash, sorti fermé, sans poids et sans aucun benchmark. Cette fois, vous obtenez des poids ouverts et un tableau de benchmarks détaillé dès le premier jour. C'est un modèle de raisonnement multimodal : il accepte texte, images et vidéo en entrée, produit du texte, et le mode réflexion est activé par défaut.
L'architecture qui mérite le "Next"
C'est la partie qui m'intéresse vraiment, car l'architecture est la raison pour laquelle le prix peut être ce qu'il est. Flash Next étend la conception hybride de Qwen3-Next selon quatre axes, et chacun est un pari consistant à échanger de la mémoire contre du calcul.
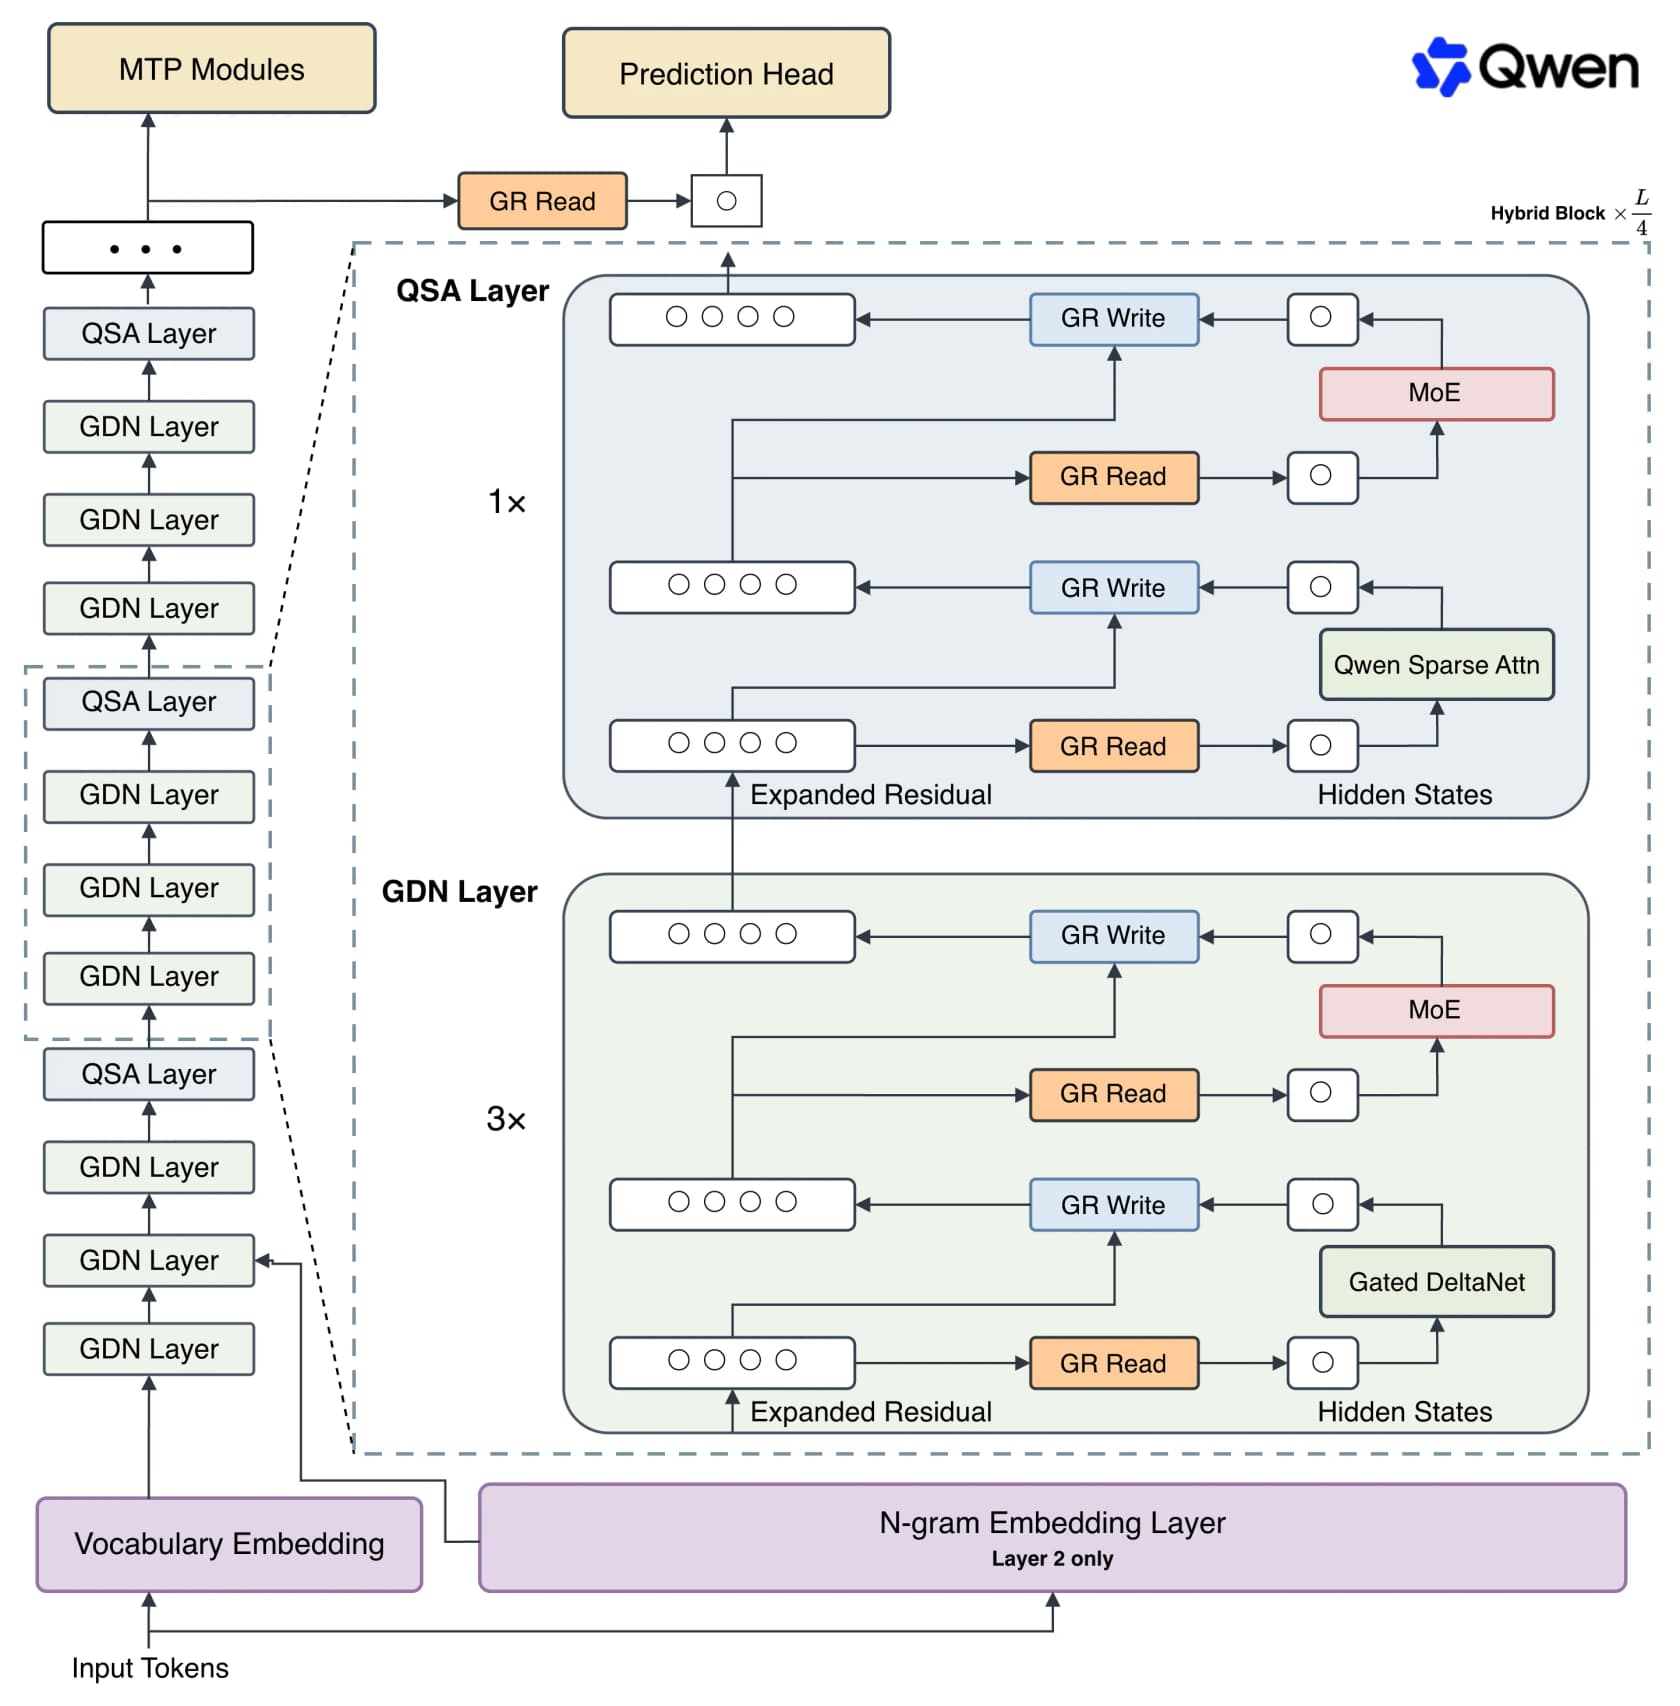
Attention : un hybride GDN et QSA. Trois couches sur quatre utilisent Gated DeltaNet pour compresser l'historique dans un état de taille fixe, ce qui est bien moins coûteux que de stocker un cache clé-valeur complet. La quatrième couche utilise l'attention globale, mais elle est remplacée par Qwen Sparse Attention, qui sélectionne le contexte important à une granularité de micro-bloc plutôt que token par token.
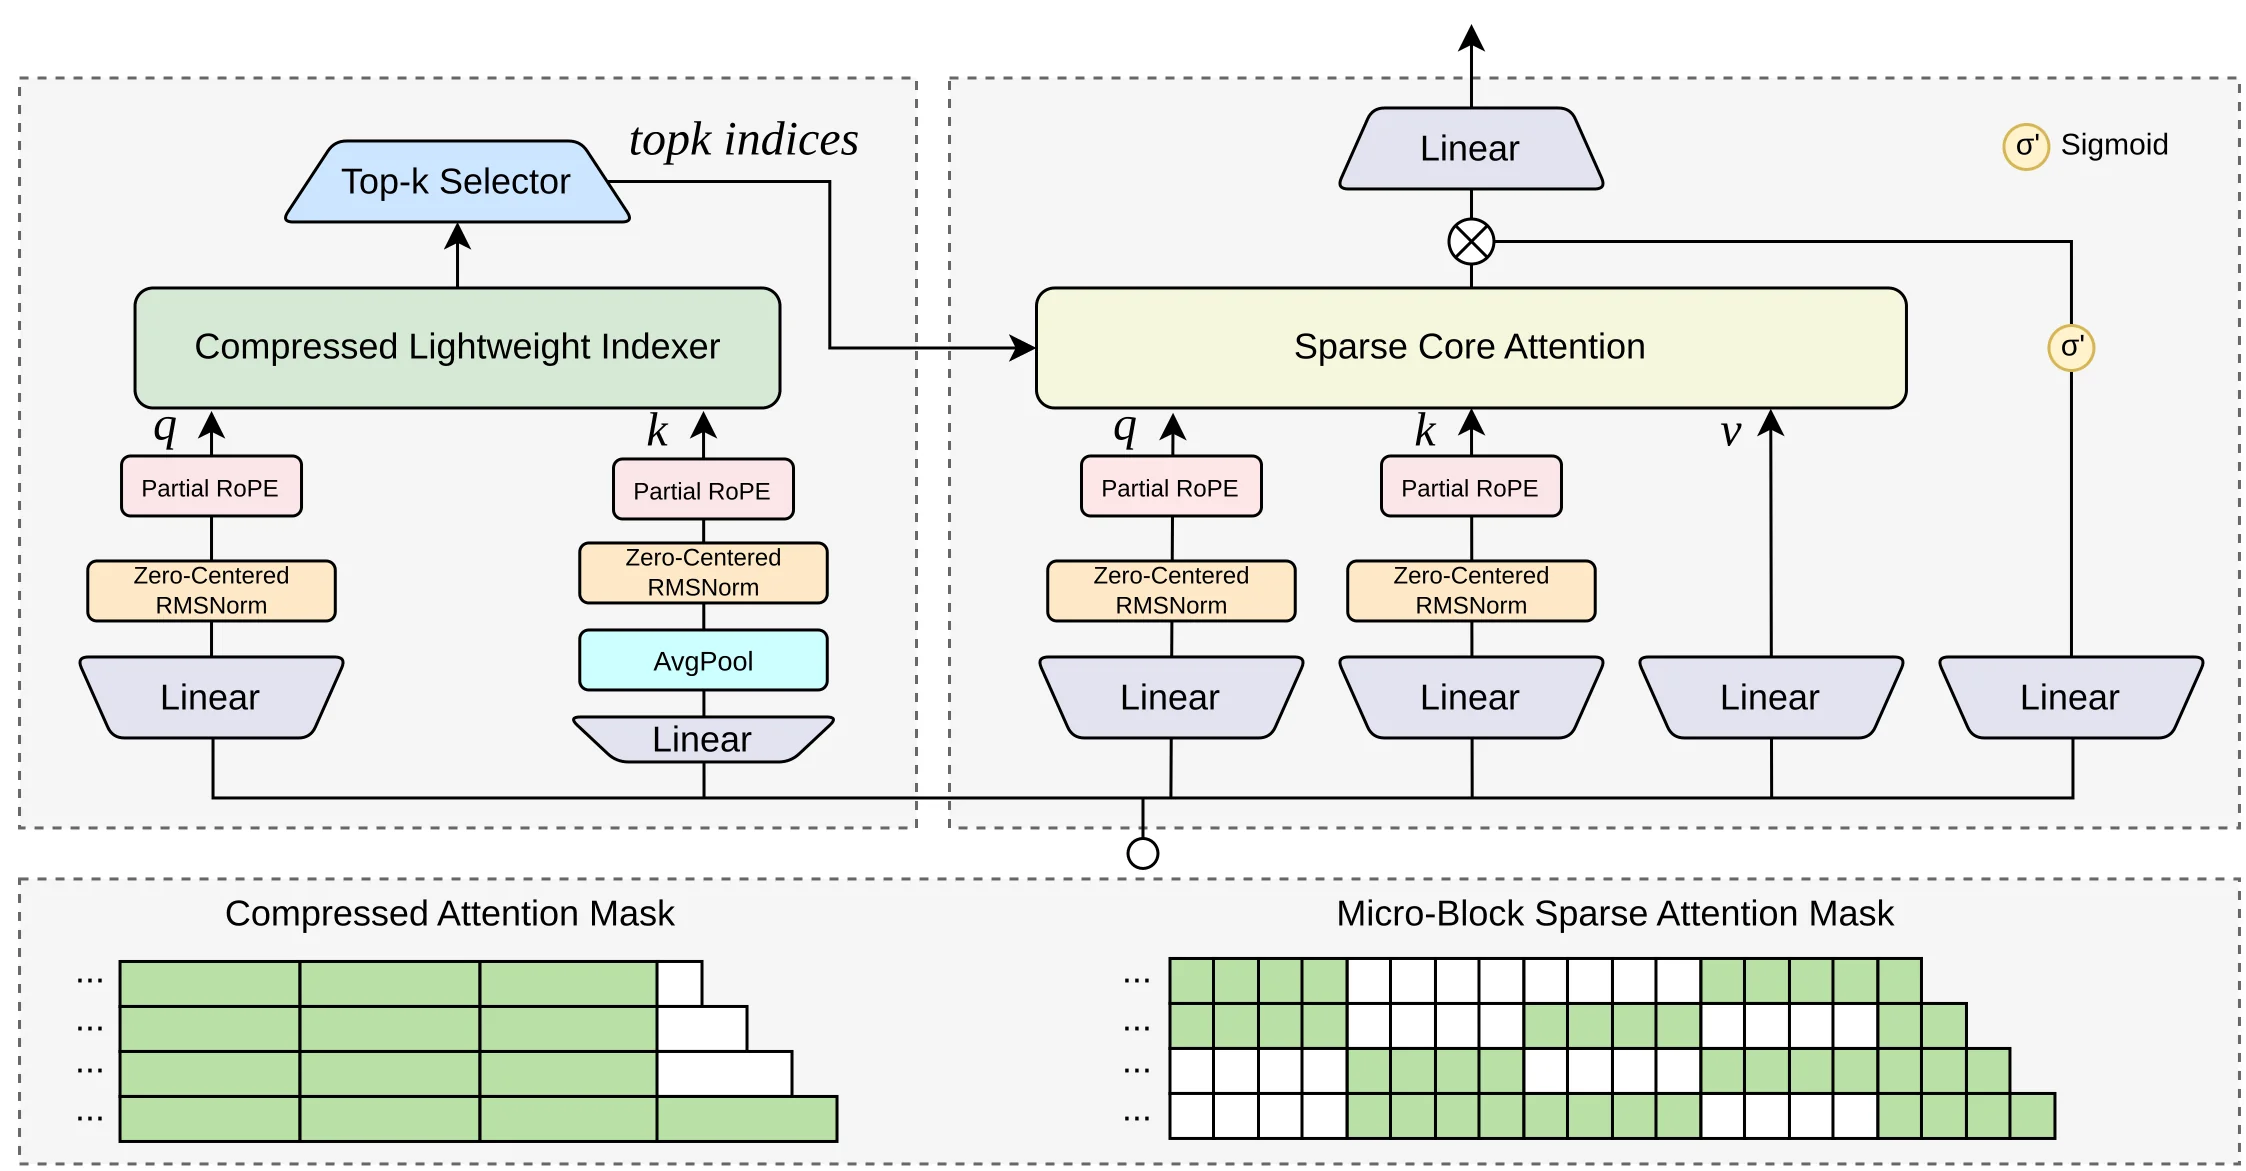
Embedding : une table de N-grammes de 51B. C'est la partie astucieuse. Qwen ajoute 51 milliards de paramètres de recherches de bigrammes et trigrammes basées sur le contexte, qui peuvent être déchargées vers la mémoire de l'hôte et préchargées de façon asynchrone. Vous obtenez un énorme gain de capacité pour presque aucun calcul supplémentaire par token, ce qui explique que des gens fassent tourner un modèle "d'environ 180B" sur des machines aux GPU modestes.
Les deux autres axes sont un flux résiduel à portes, qui élargit le résiduel en quatre branches parallèles avec stockage FP8, et le passage à l'optimiseur Muon pour les applications linéaires 2D. Qwen affirme que cette combinaison a réduit le coût d'entraînement à environ un neuvième de celui de Qwen3.7-Plus tout en le dépassant en programmation et en tâches bureautiques.
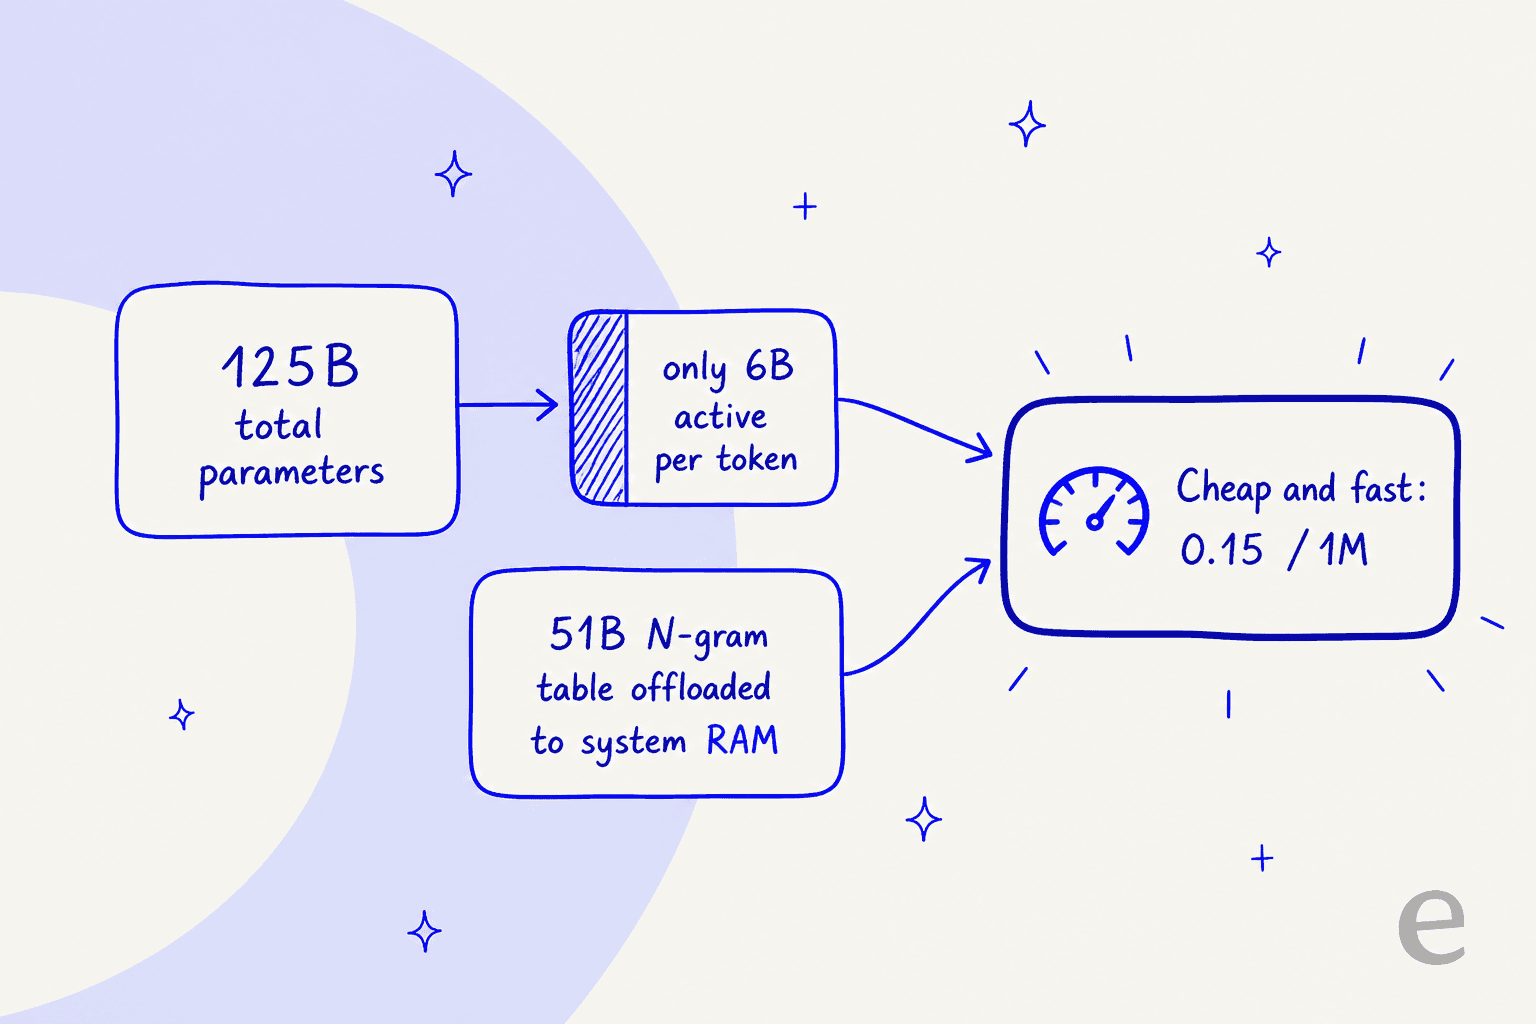
Mettez les spécifications bout à bout et la forme est claire : 125B de paramètres principaux, 6B activés par token, plus l'embedding de N-grammes de 51B et une tête de prédiction multi-token de 4B (Artificial Analysis arrondit le total à 180B). Il utilise 512 experts dont 10 routés plus 1 partagé actifs, un contexte natif de 262 144 tokens extensible à 1M via YaRN. Une réserve honnête : le chiffre du contexte varie selon les sources, la fiche du modèle indiquant 262K natif, QwenCloud tournant à 1M par défaut et Artificial Analysis listant 256K. Lisez-le comme "très long, le plafond exact dépend de l'endroit où vous l'exécutez."
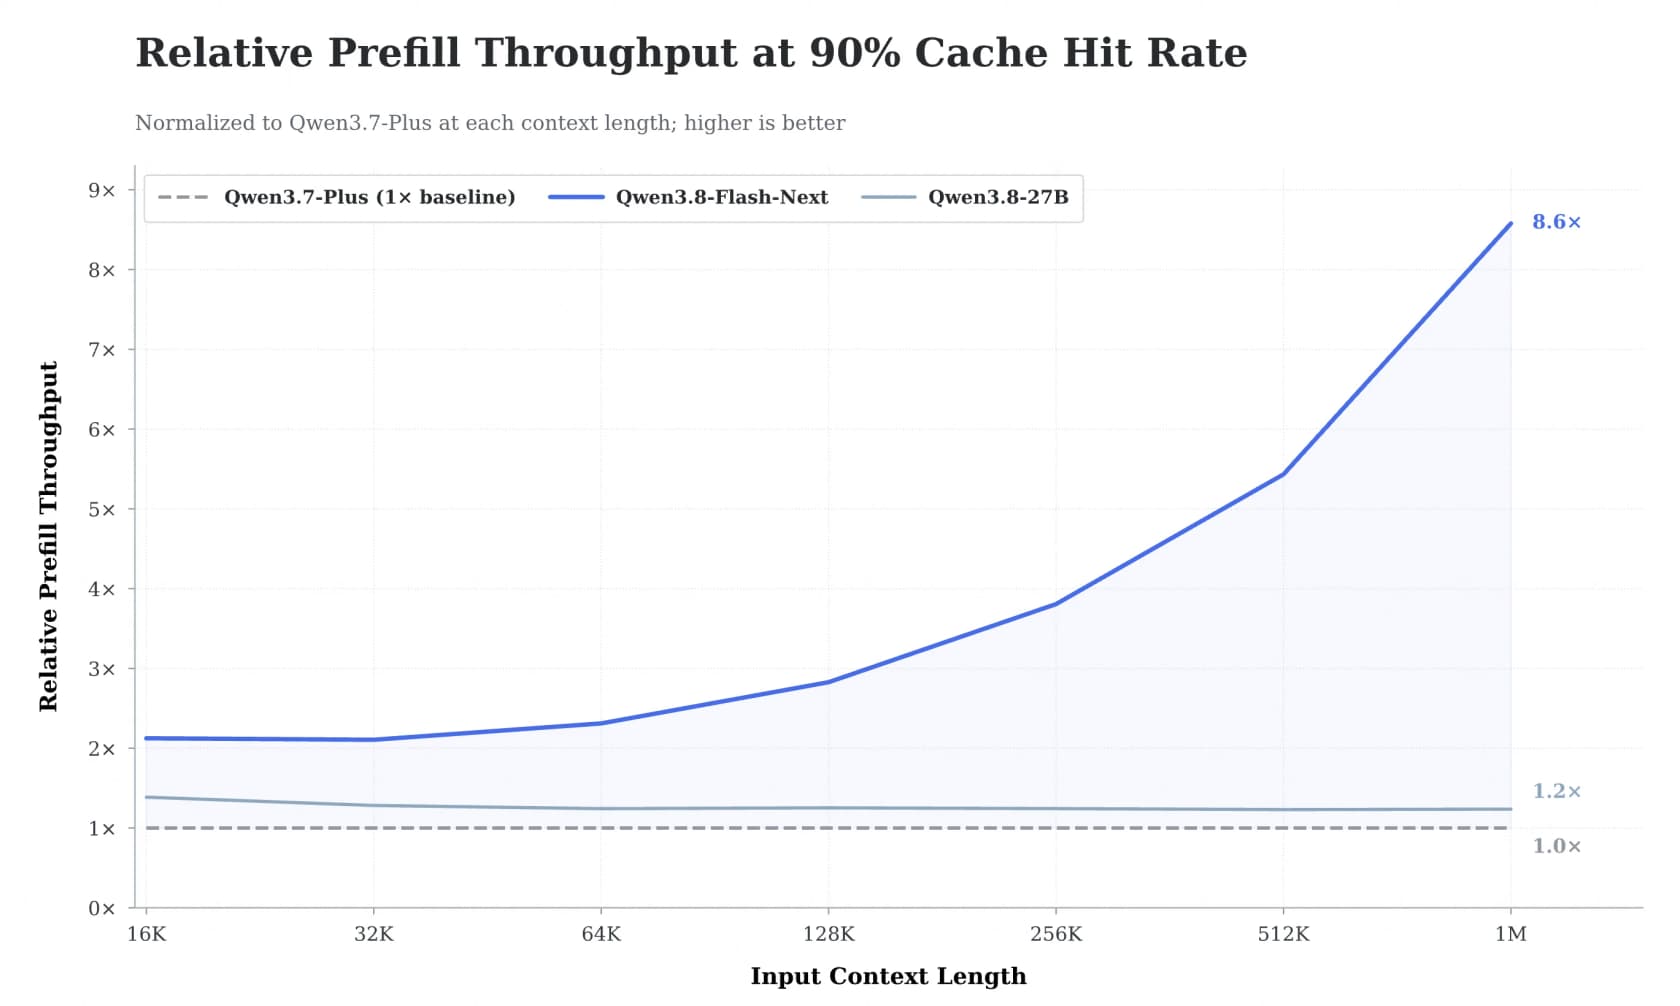
Le gain d'efficacité se voit surtout sur le long contexte. Qwen rapporte que le noyau QSA atteint jusqu'à 7,6x d'accélération en prefill et 4,9x en decode à 1M de tokens, et 8,6x le débit de prefill de Qwen3.7-Plus à 1M avec 90 % de succès de cache.
Ce que Qwen 3.8 Flash Next sait réellement faire
Les benchmarks viennent ici en deux variantes, et la différence compte. Il y a le tableau de Qwen lui-même, impressionnant mais rapporté par l'éditeur, et il y a un repère véritablement indépendant.
Commençons par l'indépendant. Artificial Analysis attribue à Flash Next 56 sur son Intelligence Index, ce qui le classe 5e sur 111 dans sa catégorie, pour une médiane de 29. Il atteint 77 tokens de sortie par seconde et coûte environ $0.10 par tâche de l'Index. Leur verdict en une ligne est qu'il figure "parmi les modèles leaders en intelligence et à un prix raisonnable", mais qu'il est "très verbeux", brûlant 200M de tokens de sortie pour terminer l'Index contre une médiane de 110M. Retenez ce point sur la verbosité, car il gonfle discrètement les factures réelles.
Les chiffres de Qwen eux-mêmes, à lire comme "Qwen rapporte" plutôt que comme un fait neutre, le placent devant ses cousins sur la plupart des lignes :
| Benchmark | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude-Opus-4.6 |
|---|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | 73.8 | 75.8 | - | 77.5 |
| LiveCodeBench v6 | 91.9 | 90.3 | 89.6 | 90.6 | 88.8 |
| GPQA Diamond | 91.7 | 89.2 | 90.3 | 90.8 | 91.3 |
| IFBench (suivi d'instructions) | 81.3 | 79.5 | 79.1 | 79.2 | 62.5 |
| CoWorkBench (longues tâches bureautiques) | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 |
| Humanity's Last Exam | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 |
Source : les tableaux de benchmarks de Qwen. Deux choses ressortent. Il est réellement fort en programmation et en tâches agentiques, devançant de justesse des modèles bien plus gros sur SWE-bench Pro. Et ce n'est pas un sans-faute : Claude Opus 4.6 gagne toujours Humanity's Last Exam, et DeepSeek V4 Flash le bat en génération au niveau du dépôt. Côté vision, Qwen rapporte 84,5 sur AndroidWorld et 88,5 sur RealWorldQA, deux scores en tête de l'ensemble comparé.
Tarifs de Qwen 3.8 Flash Next
Les poids ouverts sont gratuits. Si vous avez le matériel, vous ne payez que le calcul, et c'est tout l'attrait pour les adeptes de l'auto-hébergement.
Pour l'API hébergée Qwen3.8-Flash, la tarification est forfaitaire, sans paliers de longueur de contexte comme en avait Qwen 3.7 Flash :
| Poste | Tarif (USD / 1M tokens) |
|---|---|
| Entrée | $0.15 |
| Sortie | $0.47 |
| Entrée, lecture en cache | $0.016 |
| Création de cache explicite | $0.20 |
| Lecture de cache explicite | $0.016 |
Cette lecture en cache est environ 89 % moins chère que l'entrée neuve, et ce n'est pas théorique : OpenRouter a observé un taux de succès de cache de 91,1 % sur du trafic réel, ce qui ramène le prix d'entrée effectif à environ $0.028 par million. Ce que vous payez réellement sur des charges répétitives favorables au cache est donc bien en dessous du prix affiché.
Un astérisque sur le titre "bon marché". Comme le modèle est très verbeux, les charges riches en sortie coûtent plus que ne le suggère le faible tarif par token, puisque tous ces tokens de réflexion sont facturés. Pour une réponse de support conversationnelle, c'est un arrondi ; pour de longues exécutions agentiques, cela s'accumule. Si vous le comparez sur le prix à DeepSeek V4 Flash ou Kimi K3, modélisez les tokens de sortie, pas seulement le tarif d'entrée.
Il n'y a aussi, pour l'instant, qu'un seul fournisseur d'API : Alibaba Cloud International. OpenRouter redirige directement vers lui, donc pas encore de routage multi-fournisseurs ni de basculement.
Ce que les gens disent vraiment
La réaction de la communauté a été bruyante, et c'est presque entièrement une histoire d'inférence locale plutôt que d'API ou d'entreprise. Le fil de lancement sur Hacker News a atteint 698 points, et r/LocalLLaMA a tenu un mégafil de sortie de plus de 650 commentaires. Les gens sont obsédés par l'idée de le faire tourner sur leurs propres machines.
Les gens de l'outillage ont donné le ton. Unsloth l'a fait tourner vite et a avancé une grosse affirmation :
"Qwen3.8-Flash can now be run locally! The 125B MoE model outperforms Claude-Opus-4.6 (Max). Run on 75GB RAM via Unsloth GGUFs. Qwen3.8-Flash-Next enables CPU RAM / unified mem setups to deliver near VRAM speeds."
Ce "surpasse Opus 4.6" est de leur cru et n'est pas évalué de façon indépendante, voyez-y de l'enthousiasme, pas un fait. Les voix plus mesurées ont ajouté la réserve qui revient sans cesse. Voici l'explication la plus claire de ce que "Next" signifie vraiment, tirée du fil HN :
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

Et l'écueil pratique, signalé par Simon Willison, qui l'a exécuté à plusieurs niveaux de raisonnement sur un DGX Spark et a fini par préférer le plus petit modèle dense, en attribuant cela à la quantification à faible nombre de bits nécessaire pour le faire tenir. C'est le thème récurrent : l'architecture est enthousiasmante, mais ce checkpoint précis est un aperçu, et le faire tenir sur du matériel grand public coûte en qualité. Si vous voulez aujourd'hui l'option qui paraît aboutie dans cette catégorie de poids, de nombreux fils pointent plutôt vers GLM 5.3 Flash.
Alors, faut-il l'utiliser ?
Voici où j'en suis après une semaine d'observation.
Optez pour lui si vous êtes un bricoleur d'inférence locale avec une machine à mémoire unifiée ou un GPU de rechange, si vous voulez un premier aperçu de l'architecture Qwen4, ou si vous avez une charge favorable au cache et centrée sur le code où le faible prix hébergé et les solides résultats SWE-bench paient. La conception à activation parcimonieuse lui permet vraiment de dépasser son empreinte matérielle.
Patientez si vous avez besoin dès maintenant d'un modèle stable et prêt pour la production. C'est un aperçu sous-entraîné de l'aveu même de Qwen, la quantification dégrade la qualité, et l'API hébergée Qwen3.8-Flash n'a qu'un seul fournisseur. Pour du travail critique, un modèle plus abouti, que ce soit GLM 5.3 Flash, un palier Claude Opus 5 ou Qwen 3.8 Max, est le choix le plus sûr jusqu'à l'arrivée de la gamme Qwen4 complète.
Quoi qu'il en soit, le point le plus important est ce qu'est réellement un modèle : un composant. Ce qui m'amène à ce que je dois sans cesse expliquer aux équipes qui cherchent une "IA pas chère".
Où un tel modèle s'insère dans le vrai travail de support
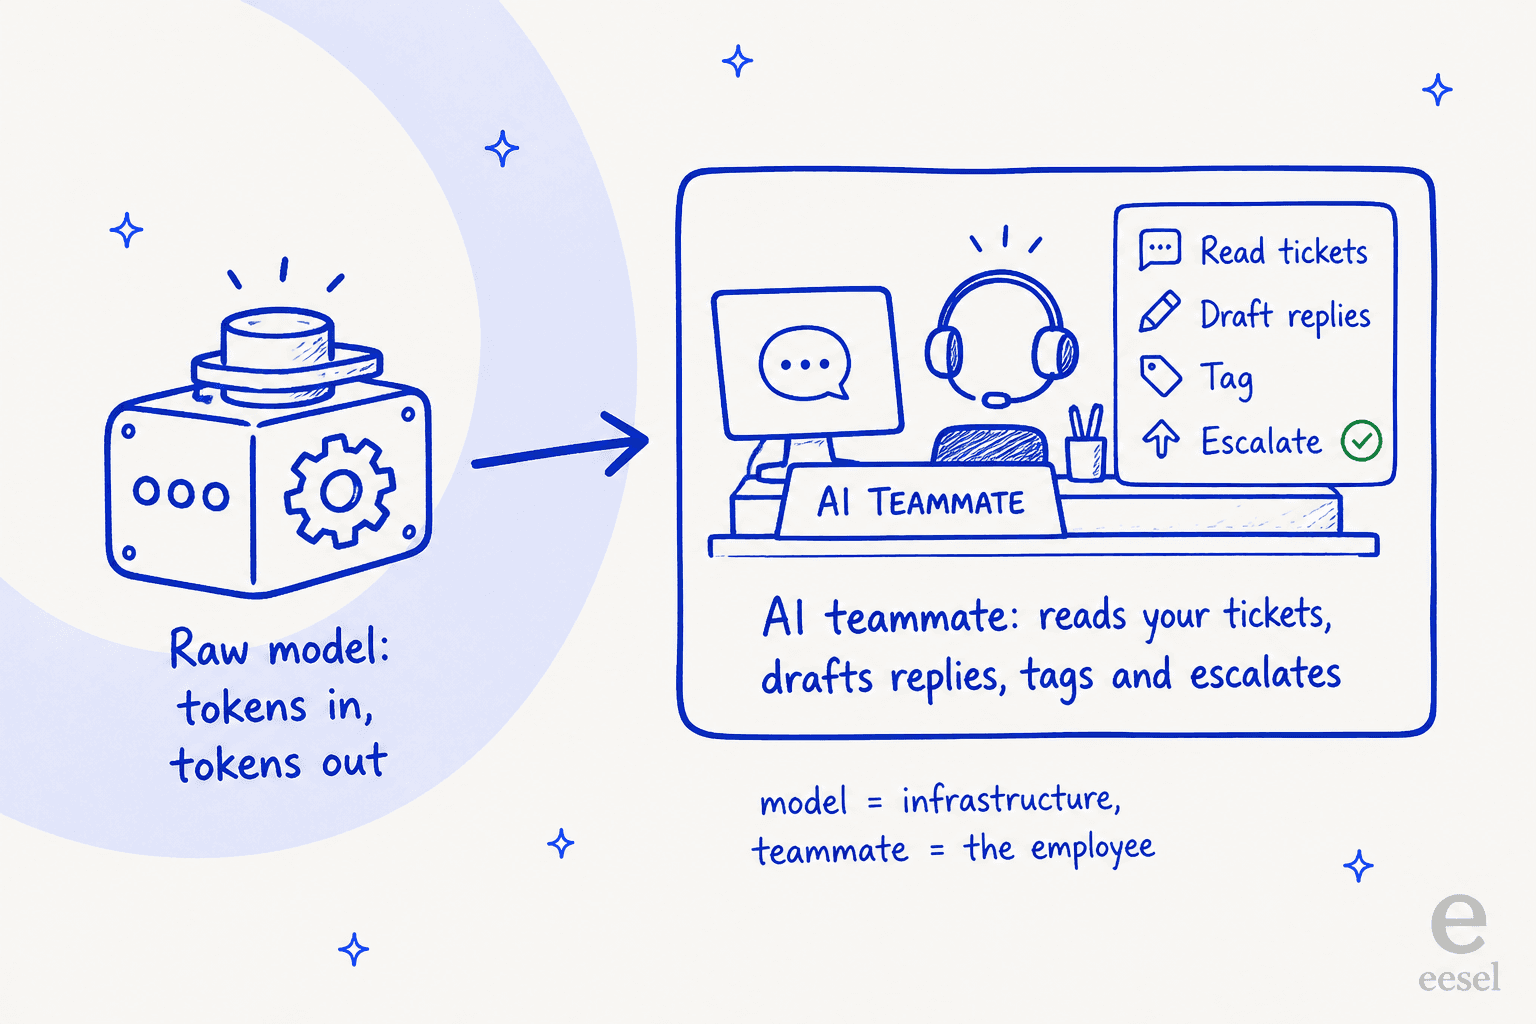
Beaucoup de gens lisent un lancement comme celui-ci et pensent "super, je vais brancher ma boîte de support sur Qwen 3.8 Flash Next et réduire ma facture d'IA". C'est une erreur de catégorie. Un modèle brut reçoit des tokens et en renvoie. Il ne connaît pas votre politique de remboursement, ne peut pas lire l'historique de commandes d'un client, ne rédigera pas de réponse dans votre helpdesk et ne sait pas si sa réponse assurée est réellement correcte. Le modèle est l'infrastructure ; ce qui fait le travail, c'est l'employé.
Cette couche d'employé est ce que nous construisons chez eesel. Le cadre que nous utilisons est simple : eesel est une plateforme de coéquipiers IA, et vous embauchez des coéquipiers prêts à travailler pour des missions précises, actuellement un coéquipier IA pour le helpdesk et un rédacteur de blog IA. Chacun arrive avec les compétences, les intégrations et le contexte d'entreprise de son rôle, si bien que la question du modèle qui tourne en dessous devient un détail d'implémentation et non votre problème.

La partie sur laquelle j'insisterais le plus, parce que j'ai vu des gens s'y brûler, c'est le test. Nous avons tous vu un bot à l'air sûr de lui donner discrètement une mauvaise réponse, c'est pourquoi le coéquipier helpdesk d'eesel simule chaque déploiement sur vos tickets historiques avant de toucher un client réel. Vous voyez le taux de résolution et les réponses exactes qu'il aurait envoyées sur de vraies conversations passées, puis vous décidez quoi automatiser. Un modèle tout neuf et sous-entraîné est précisément ce que vous voulez faire passer par ce filtre plutôt que de vous fier à un tableau de benchmarks. Et comme eesel se branche sur votre helpdesk existant et lit votre base de connaissances et vos anciens tickets, le problème du contexte, celui qu'un modèle brut ne peut jamais résoudre seul, est réglé.
La version courte : des modèles comme Qwen 3.8 Flash Next deviennent vite bon marché et performants, ce qui est une excellente nouvelle, mais en choisir un n'est que les 10 % faciles du travail. Les 90 % restants consistent à en faire un coéquipier qui résout vraiment des tickets, et c'est cette couche qui mérite votre temps.