

Granite 4.2 d'IBM est une vraie bonne famille à poids ouverts : trois petits modèles de raisonnement (3B, 8B, 30B), Apache 2.0, réflexion activable à la demande et peu coûteux à exécuter. La plupart des gens cherchent une alternative pour l'une de ces trois raisons : ils veulent plus de capacité brute (souvent pour la programmation), ils le veulent encore moins cher à grande échelle, ou ils ont besoin d'un modèle avec une licence plus souple ou d'une API hébergée et gérée.
Voici la version courte de qui choisir :
- Qwen 3.8 si vous voulez la plus forte capacité brute, surtout en programmation. Checkpoint ouvert de 27B, Apache 2.0.
- DeepSeek V4 Flash si le coût à grande échelle est tout l'enjeu. Licence MIT, l'option sérieuse la moins chère ici.
- GLM 5.3 Flash si vous voulez des agents peu coûteux, multimodaux et à l'aise avec les outils, sur poids ouverts.
- Kimi K3 si vous menez un travail agentique au long cours et acceptez de payer plus cher.
- Mistral (Large 3 + modèles ouverts) si vous tenez à un fournisseur européen et à une licence on-prem claire.
- Google Gemini 3.6 Flash si vous préférez une API hébergée et gérée plutôt que d'héberger quoi que ce soit.
- NVIDIA Nemotron 3 si vous travaillez sur du matériel NVIDIA, ou voulez des poids et des recettes d'entraînement ouvertes.
Une chose à dire d'emblée, parce que construire de l'IA de support est mon métier : chaque modèle de cette liste est un moteur, pas un produit. Si ce que vous voulez vraiment, c'est un agent IA qui résout des tickets, le modèle représente les 10 % faciles ; les connaissances, les intégrations et les garde-fous sont les 90 % restants. Nous y revenons à la fin.
Pourquoi chercher une alternative à Granite 4.2
Soyons d'abord justes envers Granite, car il le mérite (j'ai étudié la famille en détail dans mon test complet de Granite 4.2). Granite 4.2 est sorti le 25 août 2026 sous la forme de trois modèles de raisonnement denses sous licence Apache 2.0. Les petits tournent vite sur du matériel courant (le 3B est un téléchargement de 2,2 Go), les données d'entraînement sont récentes, et le consensus de la communauté est que Granite est discrètement excellent sur le travail structuré et ancré : appel d'outils, résumés, et étiquetage de documents et extraction. Si vous avez besoin d'un modèle on-prem, sous licence libre, qui se comporte bien dans une boucle d'agent, c'est un choix par défaut solide.
Alors pourquoi changer ? Quelques raisons bien réelles reviennent sans cesse, et aucune n'est du discours marketing.
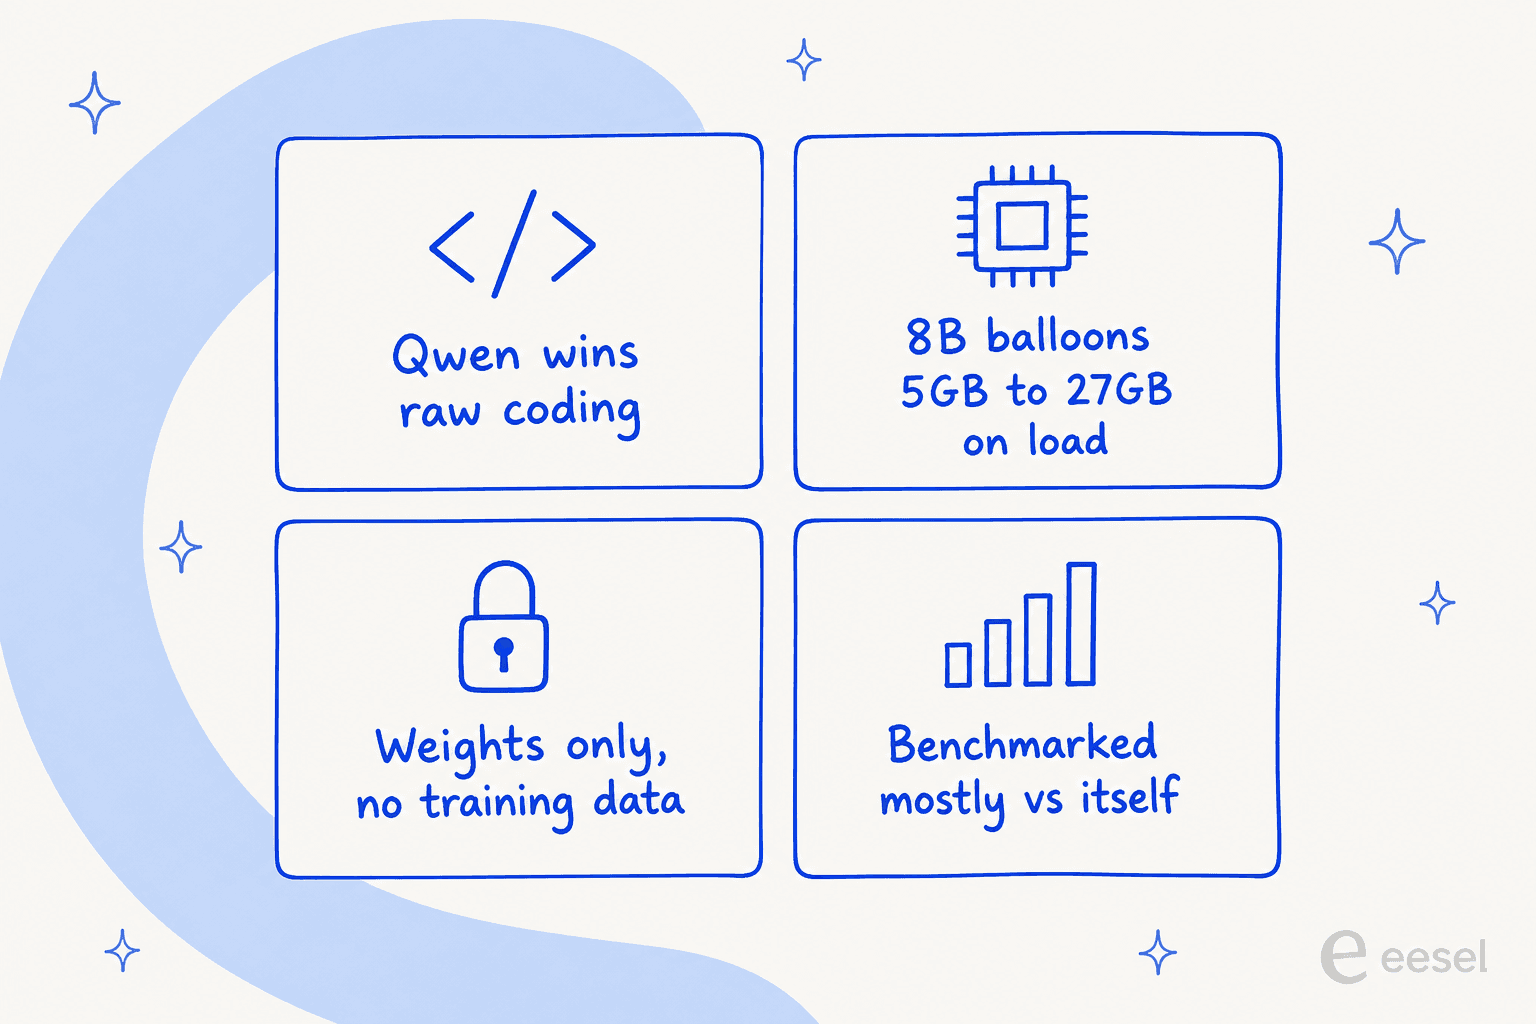
La capacité brute, surtout en programmation. C'est la raison la plus répétée. Sur Hacker News, la phrase récurrente est sans détour :
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."

Même ceux qui ont aimé Granite ont gardé leur ancien favori pour le plus difficile :
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly. Qwen3.6 35b a3b is still my local champion but I may use this for auto complete and small tasks."
IBM se compare surtout à elle-même. Les fiches de modèle de Granite le comparent aux versions précédentes de Granite et à un petit ensemble de rivaux comme Nemotron de NVIDIA et Gemma de Google, pas à Qwen. Cela nourrit un scepticisme bien précis :
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."
Un vrai piège opérationnel. Le 8B est un téléchargement de 5,3 Go, mais un fil r/LocalLLaMA très partagé a signalé qu'il peut gonfler jusqu'à 27 Go en mémoire au chargement une fois le cache KV alloué, de quoi le faire sortir d'un GPU grand public. À vérifier avant de vous engager.
"Des poids seuls, ce n'est pas vraiment de l'open source." Granite publie des poids sous Apache 2.0, mais pas les données ni la recette d'entraînement, et une partie de la communauté tient une ligne plus stricte sur ce que « ouvert » devrait signifier. Si la reproductibilité compte pour vous, cet écart est une raison de regarder des modèles qui publient davantage.
Voici aussi l'angle pratique du coût. Imaginons une charge de type support de 5 millions de tokens de sortie par mois. Au tarif hébergé confirmé le moins cher de Granite 4.2, cela fait environ $1.25 ; avec Kimi K3, les mêmes tokens coûtent $75. Cet écart de 60 fois est précisément la raison pour laquelle la question « quelle alternative » mérite une réponse soignée plutôt que de prendre ce qui dominait un classement la semaine dernière.
Comment j'ai choisi ces alternatives
J'ai orienté la liste vers ce qu'est réellement Granite : un modèle ouvert, de taille petite à moyenne, capable de raisonner, que l'on peut auto-héberger à bas coût. Les critères étaient donc :
- Poids ouverts d'abord. Six sur sept publient des poids téléchargeables, car c'est la raison pour laquelle on exécute Granite plutôt qu'une API fermée. Gemini 3.6 Flash est le seul choix uniquement hébergé, inclus parce que beaucoup d'équipes échangeraient volontiers l'ouverture contre un point d'accès géré.
- Raisonnement et usage d'outils. La fonction phare de Granite est la réflexion activable et l'appel d'outils appuyé sur le raisonnement, donc chaque modèle ici peut raisonner et appeler des outils dans une boucle d'agent.
- Des tarifs réels et vérifiables. Pas de « contactez les ventes ». Chaque prix ci-dessous renvoie à une page du fournisseur. (Si votre vraie question est de savoir quel moteur placer derrière un bot de support, je l'ai comparé séparément dans meilleur modèle d'IA pour les tickets de support.)
- Sources primaires uniquement. Les spécifications viennent des fiches de modèle et des pages tarifaires ; l'opinion vient de Hacker News, Reddit et X, pas de listes d'agrégateurs.
Voici l'ensemble du paysage en un coup d'œil avant de passer outil par outil.
| Modèle | Idéal pour | Poids ouverts | Licence | Contexte | Hébergé entrée/sortie pour 1M | Raisonnement |
|---|---|---|---|---|---|---|
| Granite 4.2 (le titulaire) | Agents d'entreprise on-prem | Oui | Apache 2.0 | 128K–512K | $0.06 / $0.25 | Activable |
| Qwen 3.8 | Capacité brute de programmation | Oui (27B Apache) | Mixte | 1M | $2 / $6 (Max) | Activé (xhigh) |
| DeepSeek V4 Flash | Coût à grande échelle | Oui | MIT | 1M | $0.22 / $0.66 (heures creuses) | Activé (high) |
| GLM 5.3 Flash | Agents multimodaux économiques | Oui | Ouverte | 1M | $0.075 / $0.25 (promo) | Réflexion seule |
| Kimi K3 | Agents au long cours | Oui | Modifiée | 1M | $3 / $15 | Toujours activé |
| Mistral Large 3 | Européen / on-prem | Partiel (petits modèles Apache) | Mixte | 128K+ | $0.50 / $1.50 | Optionnel |
| Gemini 3.6 Flash | API hébergée et gérée | Non | Propriétaire | 1M | $1.50 / $7.50 | Optionnel |
| NVIDIA Nemotron 3 | Pile NVIDIA, recettes ouvertes | Oui | Ouverte | jusqu'à 1M | Points d'accès gratuits / calcul | Oui |
Les 7 meilleures alternatives à Granite 4.2 en 2026
1. Qwen 3.8 - le meilleur pour la capacité brute et la programmation
Idéal pour : les équipes qui ont choisi Granite pour sa licence mais butent sans cesse sur son plafond en programmation et en raisonnement difficiles.
S'il existe un seul modèle vers lequel la communauté des LLM locaux se tourne à la place de Granite, c'est Qwen. La comparaison est si réflexe que, lors de la sortie de Granite 4.2, la première question sur X demandait littéralement comment il se comparait :
"Anyone tested Granite 4.2 30B from IBM yet? How does it compare to Qwen-3.8-27B?"
Qwen 3.8 existe en deux formes. Le vaisseau amiral Qwen 3.8 Max est un modèle à mélange d'experts de 2,4T paramètres (95B actifs) avec un contexte de 1M de tokens, vendu comme API hébergée. En dessous se trouve le checkpoint ouvert Qwen3.8-27B sous une vraie licence Apache 2.0, qui est la comparaison directe avec les tailles ouvertes de Granite. À noter : les poids de base ouverts de Max utilisent la licence restrictive propre à Alibaba, pas Apache ; « Qwen ouvert » avec liberté commerciale signifie donc le 27B, pas le géant.
Où il bat Granite : la capacité brute, point. Sur LMArena, Qwen 3.8 Max se place près du sommet en texte et en développement web, et le verdict de la communauté sur la programmation est tranché. Le contexte de 1M éclipse aussi les 128K natifs de Granite.
Où il déçoit : l'option propre sous Apache est le 27B, pas le Max vedette, l'histoire d'ouverture est donc plus étroite qu'il n'y paraît. Et l'environnement de programmation de Qwen est configuré avec un plafond de sortie de 64K, si bien que le chiffre de « 1M de contexte » est plus théorique que ce que la plupart des charges toucheront jamais.
Tarifs : le 27B ouvert est gratuit à auto-héberger. Qwen 3.8 Max sur le cloud d'Alibaba coûte $2 par million de tokens d'entrée et $6 par million de sortie, avec des lectures d'entrée en cache à $0.25.
Verdict : si vous avez quitté Granite parce qu'il ne suivait pas en programmation ou en raisonnement difficile, Qwen est le premier endroit où regarder. Prenez le 27B si une licence propre compte, ou le Max hébergé si vous voulez la version la plus puissante et que les conditions d'Alibaba ne vous gênent pas.
2. DeepSeek V4 Flash - le meilleur pour le coût à grande échelle
Idéal pour : les charges à gros volume où la facture par token décide réellement de l'architecture.
DeepSeek V4 Flash est le champion du budget de cette liste et, contrairement au modèle phare de Qwen, il est véritablement sous licence MIT, l'une des plus permissives qui existent.
C'est un modèle à mélange d'experts de 284B paramètres (13B actifs) avec un contexte de 1M de tokens, publié sous forme d'environ 167 Go de poids ouverts. Le raisonnement est activé par défaut à « high », et voici la particularité qui le rend intéressant : la configuration économique et la bonne configuration sont littéralement des exécutions différentes des mêmes poids (le compromis RAG contre LLM brut apparaît ici aussi, puisque plus de réflexion signifie plus de tokens facturés). Les propres chiffres de DeepSeek montrent Flash à 8.1 sur HLE sans réflexion contre 34.8 à effort maximal. Vous choisissez à quel point il réfléchit, et vous payez les tokens de raisonnement au tarif de sortie.
Où il bat Granite : le prix, et une licence plus propre. C'est aussi un modèle bien plus gros que le 30B de Granite, donc à effort maximal il atteint des capacités que les petites tailles de Granite ne peuvent pas atteindre.
Où il déçoit : il ne traite que du texte (pas d'entrée d'image documentée), il peut être bavard, et il y a un vrai écueil de gouvernance des données. Les conditions de l'API payante de DeepSeek sont muettes sur l'entraînement éventuel sur vos entrées, et le service relève du droit de la RPC, ce n'est donc pas un remplacement direct pour des données clients réglementées (si vous traitez des données de support, l'angle SOC 2 et RGPD compte ici). Surveillez aussi l'horloge des tarifs : les tarifs doublent aux heures de pointe (01:00–04:00 et 06:00–10:00 UTC), qui se trouvent être des heures creuses pour la plupart des files d'attente occidentales.
Tarifs : en heures creuses, l'entrée sans cache coûte $0.22 par million et la sortie $0.66 ; les tarifs de pointe sont exactement le double. Auto-héberger les poids MIT est gratuit.
Verdict : si votre charge est importante et vos données non réglementées, rien ici ne bat DeepSeek sur le coût par unité de capacité. Construisez simplement votre modèle de coûts sur le tarif de pointe pour qu'un décalage horaire ne vous surprenne jamais, et gardez les données personnelles des clients hors de l'API officielle.
3. GLM 5.3 Flash - le meilleur pour les agents multimodaux économiques
Idéal pour : les développeurs qui veulent des agents multimodaux à l'aise avec les outils, sur poids ouverts, sans payer des prix de pointe.
GLM 5.3 Flash de Z.ai (Zhipu) est le modèle le plus récent ici, et il s'appuie exactement sur la niche agentique et d'appel d'outils où Granite est le plus fort, avant de le sous-coter.
C'est un MoE de 320B paramètres (18B actifs), le premier modèle nativement multimodal de la ligne GLM-5, avec un contexte de 1M et des poids ouverts sur Hugging Face. Il obtient un Artificial Analysis Intelligence Index de 57, à égalité avec des modèles bien plus chers, pour une fraction du coût par tâche.
Où il bat Granite : il est nativement multimodal (Granite 4.2 n'a pas de variante vision), le contexte est 8 fois plus grand, et le prix promotionnel est proche de la gratuité. Il a aussi dominé un temps les classements d'usage d'OpenRouter, il est donc éprouvé à volume.
Où il déçoit : le raisonnement est toujours activé et ne peut pas être désactivé, donc pas de vrai mode « rapide, économique, sans réflexion » comme celui qu'offre Granite. L'API officielle est aussi lente (~49 tokens/seconde) ; il vous faudra un hébergeur plus rapide comme Databricks pour le travail sensible à la latence.
Tarifs : tarifs promotionnels de $0.075 par million d'entrée et $0.25 par million de sortie (public $0.15/$0.50), la promotion courant jusqu'au 9 septembre 2026, et l'entrée en cache à $0.015. Un GLM Coding Plan distinct coûte $18/$80/$168 par mois. Les poids ouverts sont gratuits à auto-héberger.
Verdict : pour des agents économiques qui doivent voir des images et appeler des outils, GLM 5.3 Flash est l'échange « Granite, mais plus grand et multimodal » le plus direct de cette liste. Prévoyez simplement qu'il réfléchit toujours.
4. Kimi K3 - le meilleur pour le travail agentique au long cours
Idéal pour : les exécutions d'agents complexes à plusieurs étapes où vous préférez payer plus que de surveiller un modèle plus faible.
Kimi K3 de Moonshot AI est l'option premium à poids ouverts : plus gros, plus cher, et réglé pour un raisonnement agentique soutenu plutôt que pour un débit économique.
C'est un MoE de 2,8T paramètres (104B actifs) avec un contexte de 1M de tokens et une vision native, et Moonshot a publié les poids ouverts comme prévu. Sur l'Artificial Analysis Intelligence Index, il se situe autour de 57 (4e au total), devançant certains modèles de pointe sur de nombreuses tâches.
Où il bat Granite : c'est un modèle bien plus fort sur les tâches difficiles et longues, et un raisonneur agentique sérieux là où les petites tailles de Granite manquent de marge.
Où il déçoit : le prix. À $3 en entrée / $15 en sortie par million de tokens, il se situe dans la même fourchette que Claude Sonnet, environ 50 fois le tarif de sortie de DeepSeek, c'est donc l'opposé d'un choix économique. Le raisonnement ne peut en outre être désactivé à aucun niveau (le réglage d'effort est un contrôle de latence, pas un palier de coût), et les poids ouverts représentent un téléchargement de 1 561 Go, donc « auto-héberger » signifie ici une infrastructure sérieuse.
Tarifs : $3 par million d'entrée, $0.30 en succès de cache, $15 par million de sortie. Les formules de l'application grand public sont Free / $19 / $39 / $99 / $199 par mois.
Verdict : Kimi K3 est ce que l'on choisit quand la tâche est assez difficile pour qu'un modèle moins cher échoue, et que le coût de l'échec dépasse celui des tokens. Pour du travail routinier à gros volume, c'est superflu à côté de Granite ou de DeepSeek.
5. Mistral (Large 3 + modèles ouverts) - le meilleur pour les équipes européennes et un on-prem propre
Idéal pour : les équipes qui veulent un fournisseur non américain, une résidence des données dans l'UE et une licence vraiment permissive pour les petits modèles.
Mistral est la réponse européenne à la promesse « ouvert, sous licence, on-prem » qui attire d'abord les gens vers Granite, et ses petits modèles sortent sous Apache 2.0.
La gamme se répartit nettement : Mistral Large 3 est le vaisseau amiral hébergé, Codestral et Devstral couvrent la programmation et le travail agentique, et une famille de modèles ouverts plus petits couvre le cas de l'auto-hébergement. L'assistant grand public de Mistral, autrefois appelé Le Chat, s'appelle désormais Vibe.
Où il bat Granite : juridiction européenne et une offre entreprise mature (résidence des données dans l'UE, déploiement on-prem). Les petits modèles ouverts offrent une voie d'auto-hébergement sous licence Apache avec un fournisseur occidental derrière, ce qui compte pour les achats d'une façon que le texte de la licence seul ne saisit pas.
Où il déçoit : les meilleurs et plus gros modèles Mistral sont les modèles hébergés payants, la gamme ouverte n'est donc pas à la pointe. Et sur la capacité pure en benchmark, les modèles ouverts chinois (Qwen, DeepSeek, GLM) ont tendance à mener actuellement.
Tarifs : Mistral Large 3 coûte environ $0.50 par million d'entrée et $1.50 par million de sortie ; Codestral environ $0.30/$0.90. Les formules grand public de Vibe sont Free / $14.99 / $24.99 par utilisateur et par mois. Les petits modèles ouverts sont gratuits à auto-héberger.
Verdict : si votre raison d'aller vers l'ouvert était la gouvernance et la juridiction du fournisseur plutôt que de gratter le dernier centime d'un benchmark, Mistral est ici l'option la plus confortable. Si c'était la capacité brute, regardez d'abord Qwen ou DeepSeek.
6. Google Gemini 3.6 Flash - le meilleur pour une API hébergée et gérée
Idéal pour : les équipes qui préfèrent ne jamais toucher aux poids et veulent simplement un point d'accès hébergé rapide, économique et fiable.
Tous les utilisateurs de Granite ne veulent pas réellement auto-héberger ; certains veulent juste un cheval de trait économique et vaguement ouvert, et ont choisi Granite parce qu'il était bon marché. Pour eux, Gemini 3.6 Flash est l'alternative fermée mais facile.
C'est le palier Flash « cheval de trait » de Google, lancé le 21 juillet 2026, avec un contexte d'environ 1M de tokens, une utilisation d'ordinateur intégrée et une date limite de connaissances en mars 2026. Google indique qu'il utilise environ 17 % de tokens de sortie en moins que le Flash précédent sur les mêmes tâches, ce qui réduit discrètement la facture réelle.
Où il bat Granite : aucune charge opérationnelle. Pas de GPU, pas de configuration vLLM, pas de surprises de cache KV. Il est fort en utilisation d'ordinateur et en tâches à contexte long, et il est vraiment rapide.
Où il déçoit : il est propriétaire et uniquement hébergé, donc pas d'auto-hébergement, pas d'on-prem, pas de liberté de licence, c'est-à-dire exactement ce pour quoi la plupart des gens sont venus à Granite. Et le prix de sortie est élevé pour cette liste.
Tarifs : $1.50 par million d'entrée et $7.50 par million de sortie, avec les requêtes par lots à moitié prix ($0.75/$3.75).
Verdict : si l'ouverture des poids ne vous a jamais importé et que vous vouliez juste une API économique et capable, Gemini 3.6 Flash est une vie plus simple que de faire tourner Granite vous-même. Si l'ouverture ou l'on-prem était le but, c'est la mauvaise direction.
7. NVIDIA Nemotron 3 - le meilleur pour la pile NVIDIA et des recettes vraiment ouvertes
Idéal pour : les équipes déjà sur du matériel NVIDIA, et ceux qui veulent la reproductibilité que Granite ne fournit pas.
La famille Nemotron de NVIDIA est l'un des rivaux contre lesquels IBM compare réellement Granite, ce qui en fait un duel naturel, et elle répond directement au reproche « des poids seuls, ce n'est pas ouvert ».
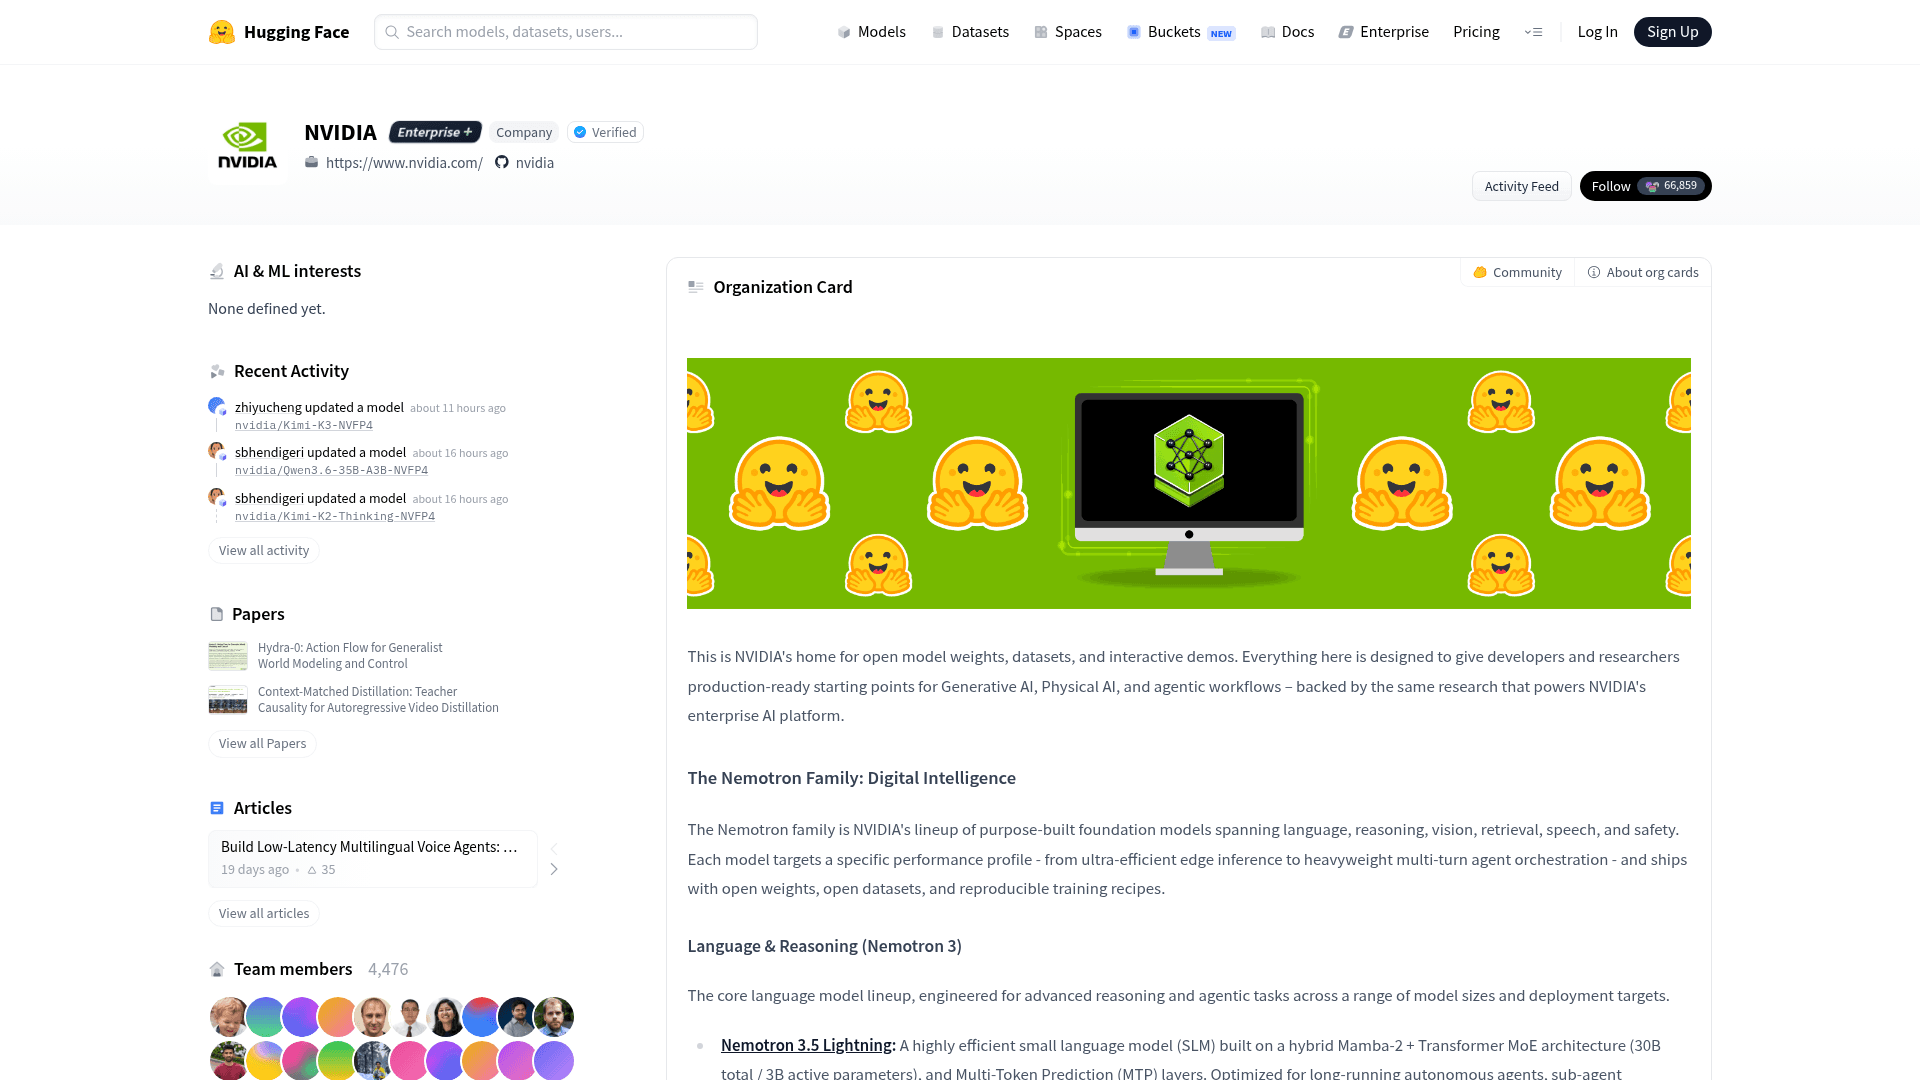
Nemotron est la gamme de modèles de fondation conçus sur mesure par NVIDIA pour le langage, le raisonnement, la vision et la récupération. Les modèles de langage actuels vont de nemotron-3.5-lightning-30b-a3b (un MoE de 30B au total / 3B actifs réglé pour des agents autonomes de longue durée) jusqu'à nemotron-3-ultra-550b-a55b (un MoE hybride ouvert Mamba-Transformer avec un contexte de 1M, conçu pour le raisonnement agentique, la programmation et l'appel d'outils). Point crucial : NVIDIA affirme que la famille est livrée avec "open weights, open datasets, and reproducible training recipes."
Où il bat Granite : cette ligne sur la reproductibilité est tout l'argument. Là où Granite donne des poids, Nemotron donne des poids, des données et la recette, ce qui est la définition plus stricte de l'ouvert que réclame une partie de la communauté. Il est aussi optimisé pour le silicium NVIDIA, et vous pouvez appeler les modèles gratuitement sur build.nvidia.com avant de vous engager.
Où il déçoit : les modèles Nemotron les plus puissants sont gros (l'ultra fait 550B), donc l'histoire du « tourne sur un portable » qui rend le 3B de Granite si attachant ne s'applique pas vraiment en haut de gamme. Et la tarification au token grand public est moins claire que celle des autres ici ; l'hébergement en production passe par NVIDIA NIM ou des partenaires cloud et est facturé au calcul.
Tarifs : les poids ouverts sont gratuits à télécharger, et NVIDIA propose des points d'accès hébergés gratuits sur build.nvidia.com. L'hébergement en production via NVIDIA NIM ou un partenaire cloud est facturé selon le calcul sous-jacent plutôt qu'à un tarif public par token.
Verdict : si vous êtes déjà sur une infrastructure NVIDIA, ou si la question « est-ce vraiment ouvert » est la raison pour laquelle vous quittez Granite, Nemotron est l'échange le plus cohérent de la liste. Dimensionnez-le simplement selon votre matériel.
Ce que tous les modèles de cette liste ont en commun
Voici la partie qui se perd dans les fils de benchmarks. Que vous choisissiez Granite, Qwen, DeepSeek ou Nemotron, vous avez choisi un moteur. Un modèle, seul, ne connaît pas votre politique de remboursement, ne peut pas voir vos tickets Zendesk et ne sait pas si la réponse qu'il vient de générer peut être envoyée sans risque à un vrai client. C'est toute la raison pour laquelle l'IA pour le service client est une catégorie de produit et pas seulement une clé d'API.
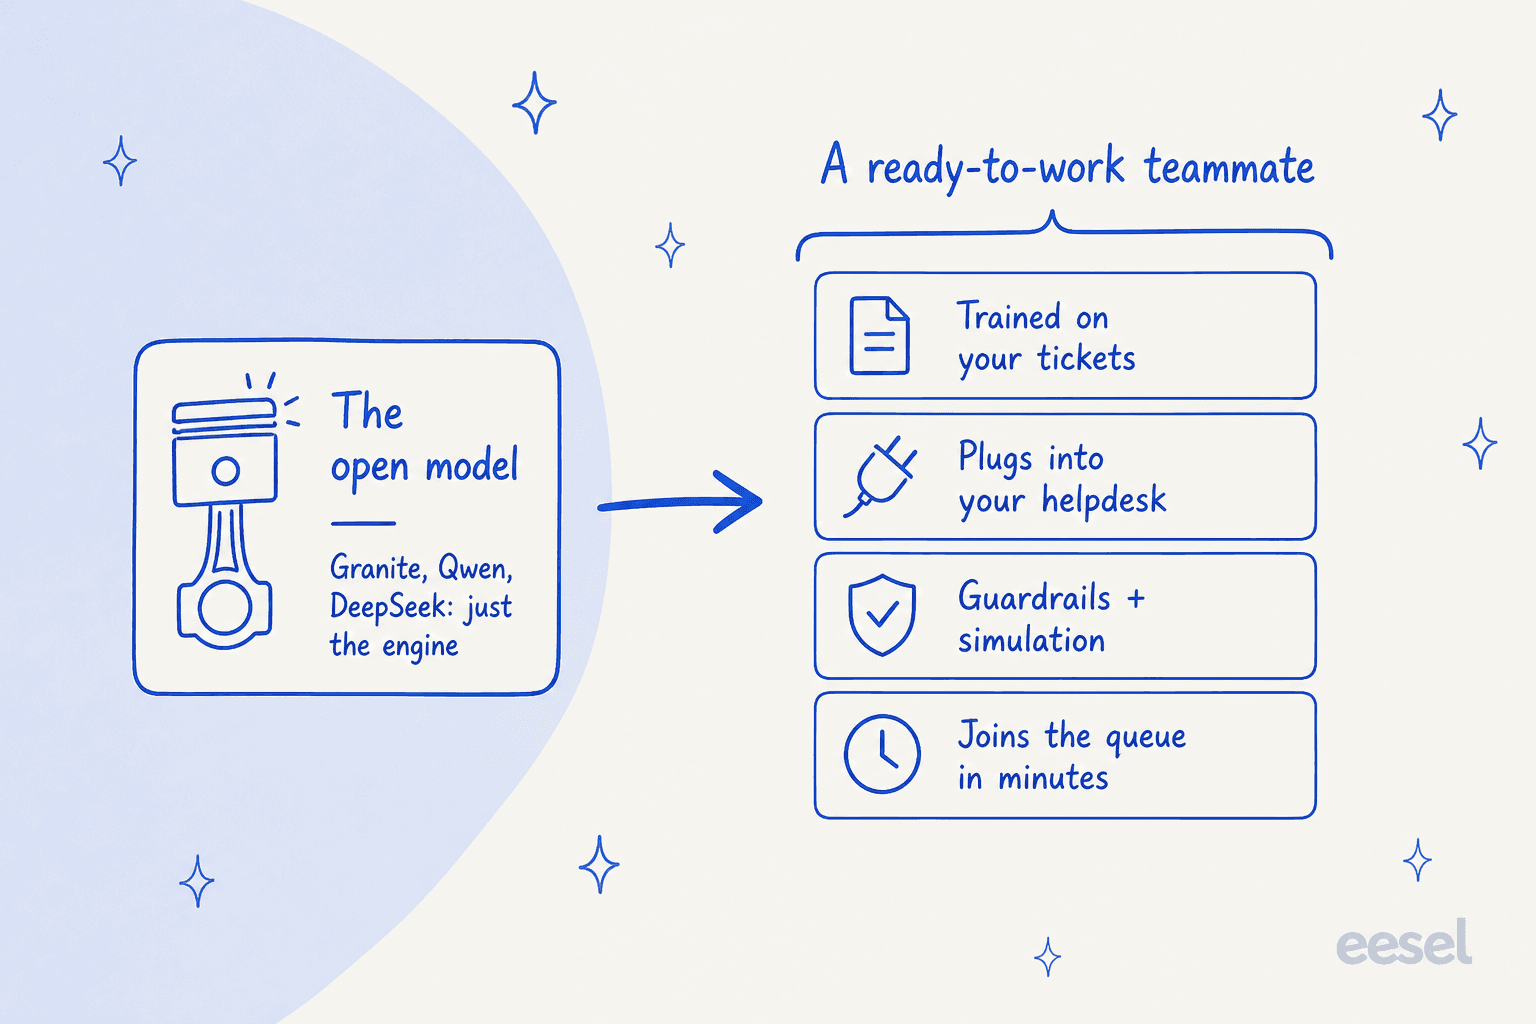
Si vous choisissez entre ces modèles pour construire quelque chose, parfait ; prenez le moteur qui convient et lancez-vous. Mais si le véritable objectif est un agent IA qui résout les tickets de support, remplacer Granite par Qwen change les 10 % faciles et laisse intacts les 90 % difficiles : se connecter à votre base de connaissances, s'intégrer au helpdesk, écrire les garde-fous et prouver que c'est sûr avant la mise en ligne. C'est la différence entre un agent IA et un chatbot à règles, et c'est là que se trouve tout le vrai travail.
Essayez eesel : la couche qu'aucun modèle de cette liste ne vous donne
Si votre objectif est de répondre aux tickets plutôt que de choisir un modèle sur lequel construire, c'est exactement le vide que comble eesel. Chaque modèle ci-dessus vous donne un moteur. eesel est le coéquipier IA pour le helpdesk prêt à travailler qui a déjà un moteur, plus tout ce qui l'entoure : il s'entraîne sur vos anciens tickets et votre centre d'aide, se branche sur le helpdesk que vous utilisez déjà (Zendesk, Freshdesk, Gorgias et plus de 1 000 autres intégrations), et rejoint la file en quelques minutes au lieu de plusieurs trimestres.

La différence, c'est le filet de sécurité qu'un modèle nu, Granite ou autre, n'apporte pas : avant qu'eesel réponde à un seul vrai client, vous pouvez le simuler sur des milliers de tickets historiques pour voir exactement comment il aurait répondu et ce qu'il aurait résolu. Utilisez n'importe quel modèle de cette liste si vous construisez. Utilisez un coéquipier IA pour le helpdesk si vous cherchez à répondre aux tickets. Vous pouvez essayer eesel gratuitement, sans carte bancaire et sans appel commercial pour commencer.
Foire aux questions
Quelle est la meilleure alternative à poids ouverts à IBM Granite 4.2 ?
Pour la capacité brute, la communauté des LLM locaux cite sans cesse Qwen : son checkpoint ouvert de 27B est sous Apache 2.0 et bat Granite en programmation. Si le coût est le critère décisif, DeepSeek V4 Flash est sous licence MIT et moins cher à exploiter à grande échelle. Les deux sont traités en détail plus haut, ainsi que notre présentation de Granite 4.2.
Existe-t-il une alternative moins chère à Granite 4.2 ?
Granite est déjà proche du plancher : les poids sont sous Apache 2.0, l'auto-hébergement est donc gratuit, et le 8B de Replicate coûte $0.06/$0.25 par million de tokens. Parmi les tarifs hébergés, le prix promotionnel de GLM 5.3 Flash ($0.075/$0.25) est comparable, et la sortie de DeepSeek V4 Flash en heures creuses coûte $0.66. Le modèle est pourtant rarement la partie chère d'un agent IA ; ce sont les connaissances, les intégrations et les garde-fous qui coûtent.
Quelle alternative à Granite 4.2 est la meilleure pour la programmation ?
Qwen est le choix consensuel pour la programmation chez ceux qui exécutent des modèles en local, et DeepSeek V4 Flash obtient aussi de bons scores. Le 30B de Granite 4.2 est crédible (57.0 sur SWE-Bench Verified), mais pour la génération de code pure, la plupart des testeurs se tournent encore vers Qwen. Si vous choisissez un modèle pour automatiser le support plutôt que pour un outil de programmation, consultez notre guide du meilleur modèle d'IA pour les tickets de support.
Les alternatives à Granite 4.2 tournent-elles sur votre propre matériel ?
La plupart, oui. Qwen, DeepSeek V4 Flash, GLM 5.3 Flash, Kimi K3, les petits modèles de Mistral et NVIDIA Nemotron publient tous des poids ouverts que vous pouvez télécharger et exécuter via Ollama, vLLM ou llama.cpp. Gemini 3.6 Flash de Google fait exception ; il n'existe qu'en version hébergée. Pour un vrai usage client, il faut quand même de la récupération et des garde-fous autour du modèle.
Que dois-je utiliser à la place de Granite 4.2 pour créer un agent de support ?
Si l'objectif est de résoudre des tickets plutôt que de construire une infrastructure, vous ne voulez pas d'un modèle brut, mais de la couche qui se place par-dessus. eesel est un coéquipier IA pour le helpdesk qui s'entraîne sur vos anciens tickets et votre centre d'aide, se branche sur votre helpdesk existant et peut être simulé sur des tickets historiques avant de répondre à un seul client réel. Le modèle en dessous est la partie facile.