

IBM Granite 4.2 est la famille de modèles de raisonnement ouverts d'IBM, sortie le 25 août 2026 en trois tailles (3B, 8B, 30B), toutes sous la licence permissive Apache 2.0. Le grand changement par rapport à Granite 4.0 est le raisonnement « thinking » natif intégré au modèle, avec trois modes commutables (thinking complet, sans thinking et effort réduit) et un appel d'outils bien plus solide.
Est-ce que ça vaut le coup ? Cela dépend de ce que vous valorisez :
- Vous voulez une IA fiable, sous licence et sur site : oui. Poids signés, une excellente note de transparence de Stanford et Apache 2.0 font de Granite le choix sûr pour l'entreprise, et les petits modèles tournent vite sur du matériel courant.
- Vous voulez le meilleur score brut en code ou en agents : probablement pas. La communauté des LLM locaux continue de se tourner vers Qwen pour la capacité pure, et IBM se compare surtout à elle-même.
- Vous voulez un agent de support prêt à l'emploi : ce n'est pas la bonne couche. Granite est un moteur, pas un coéquipier IA pour helpdesk. Il faut encore construire par-dessus la recherche d'information, les garde-fous et les tests.
La façon la moins chère de l'essayer : il est gratuit à auto-héberger sous Apache 2.0 (le 3B est un téléchargement de 2,2 Go via Ollama). Pour une API hébergée, Replicate propose le 8B à $0.06/$0.25 par million de tokens.
Ce que je cherche dans un modèle ouvert comme Granite 4.2
Un peu de contexte sur mon point de vue. Je construis des agents IA chez eesel, et nous mettons de l'IA sur de vraies files de support depuis des années, donc je lis le lancement d'un modèle autrement que quelqu'un qui court après les benchmarks. Un score AIME élevé, c'est bien. Ce qui m'importe vraiment, c'est de savoir si un modèle sait suivre des consignes qui lui déplaisent, appeler le bon outil sans en inventer un, rester ancré dans une base de connaissances et se comporter pareil sur le ticket n° 4 000 que dans la démo. Nous avons vu des modèles au ton assuré donner discrètement de mauvaises réponses, et c'est précisément pourquoi nous simulons chaque déploiement sur des tickets historiques avant qu'il ne touche un client.
Cet avis regarde donc Granite 4.2 sous cet angle : ce qui a réellement changé, où se situent honnêtement les benchmarks, ce que coûte son exploitation et à qui il convient.
Ce qui a changé dans Granite 4.2
La version en une ligne : Granite 4.2 ajoute le raisonnement natif. Là où Granite 4.0 était un modèle instruct rapide et efficace, la 4.2 sait planifier, s'autocorriger et raisonner pas à pas dans des balises <think>...</think> avant de répondre. Cela aide surtout en mathématiques, en logique à plusieurs étapes et, ce qui compte le plus pour moi, pour décider quel outil appeler et pourquoi.
L'astuce, c'est que le raisonnement est commutable dans un seul modèle, donc vous ne payez pas de chain-of-thought sur des questions qui n'en ont pas besoin :
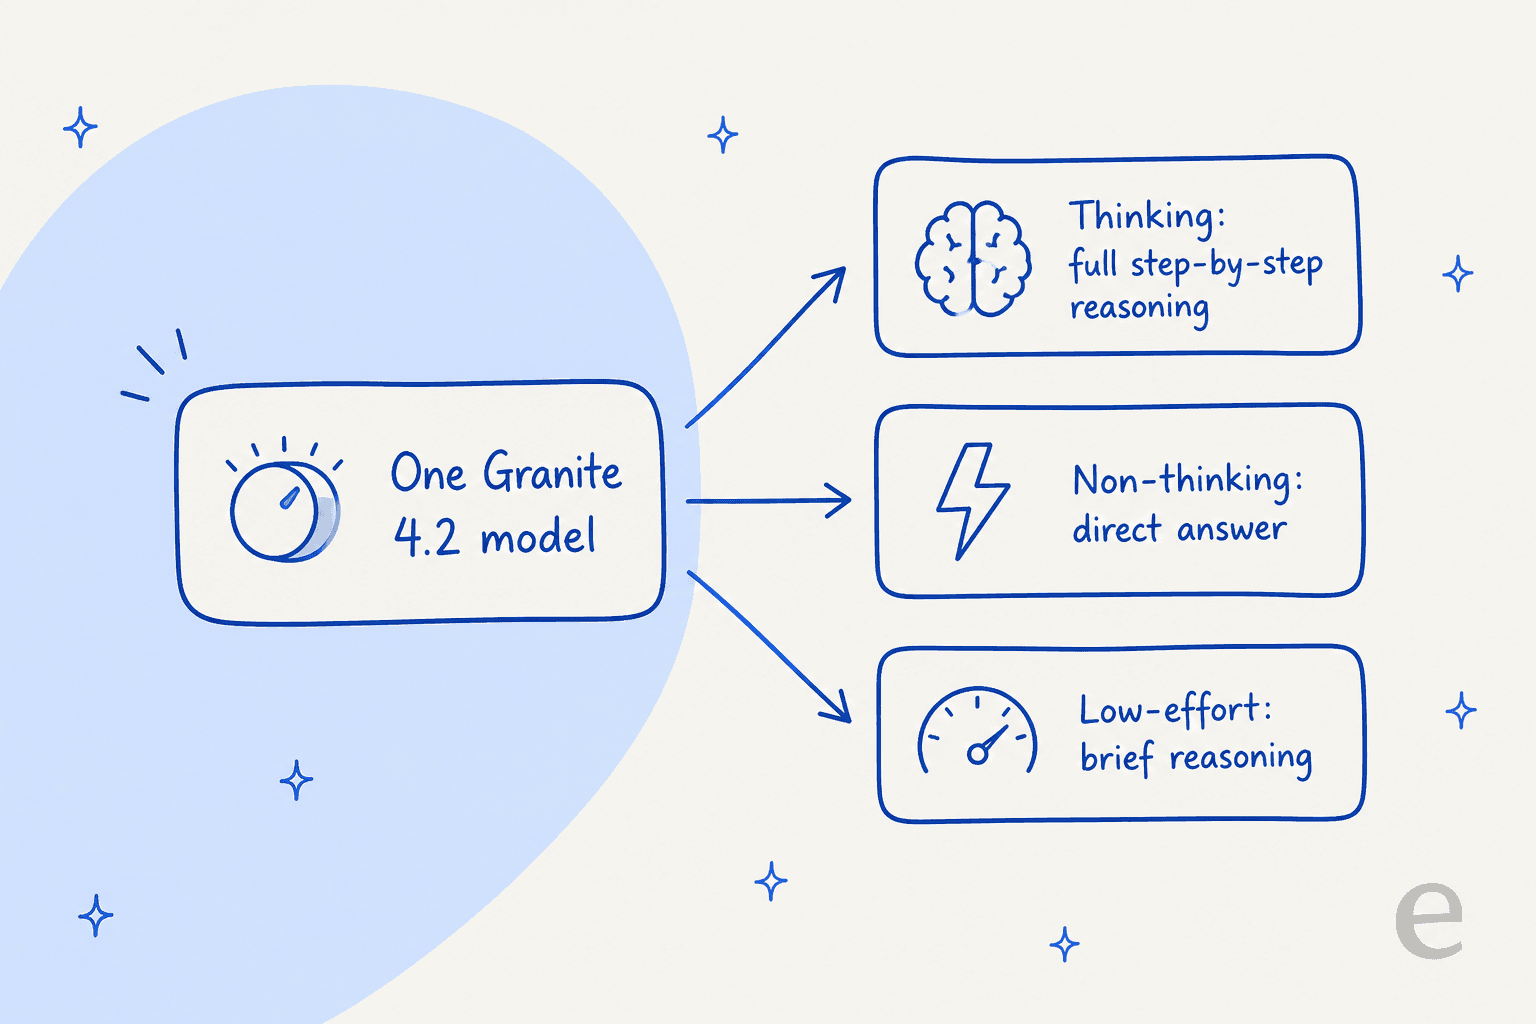
- Thinking (par défaut) donne un chain-of-thought complet.
- Sans thinking saute entièrement le raisonnement pour une réponse directe, ce qui compte quand vous servez un gros volume et ne voulez ni la latence ni le coût en tokens.
- Effort réduit fait un raisonnement bref pour les requêtes plus simples, une vitesse intermédiaire.
Dans Ollama, vous basculez de l'un à l'autre avec /set think et /set nothink, une jolie attention pour qui règle coût et qualité par cas d'usage.
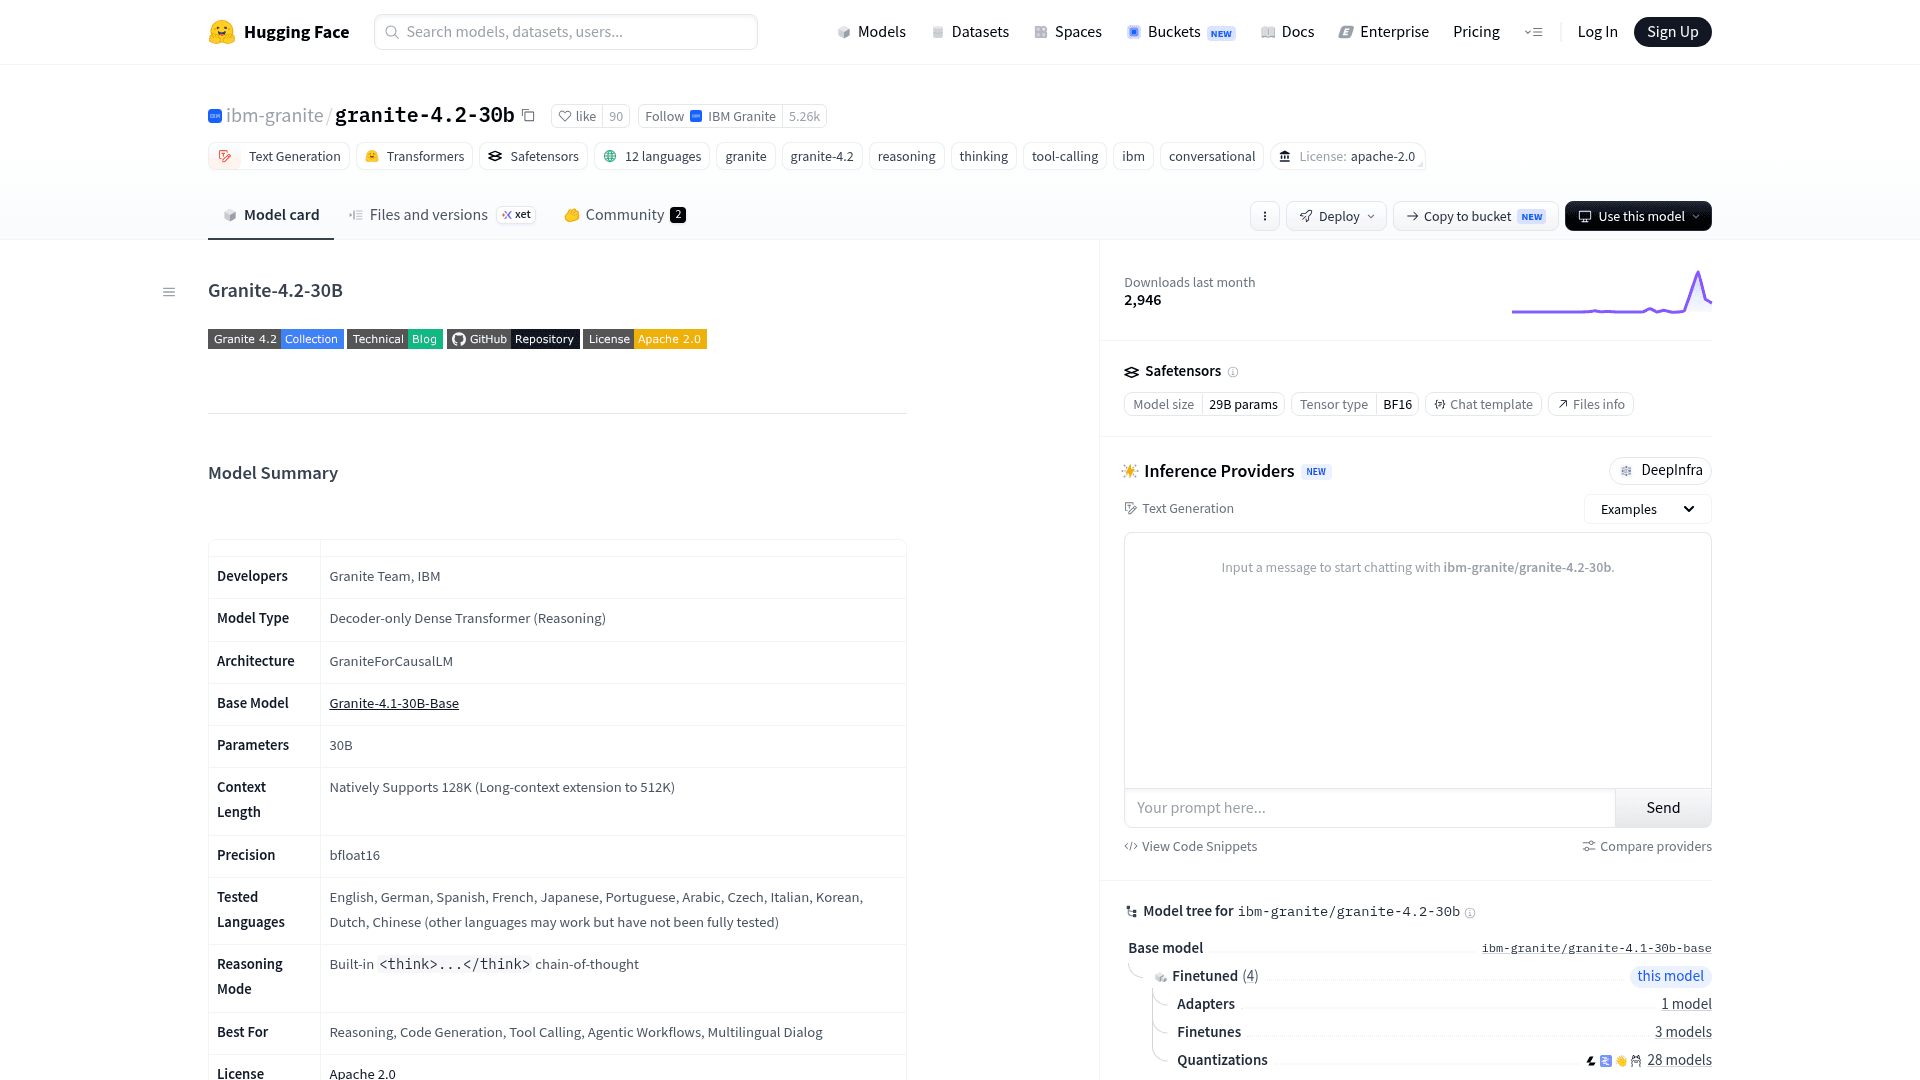
Il y a aussi une histoire d'architecture, qu'il faut signaler parce qu'elle va à contre-courant. Granite 4.0 utilisait une conception hybride Mamba-2/transformer avec un mélange d'experts pour l'efficacité mémoire. Granite 4.2 est un simple transformer dense décodeur seul. Le raisonnement d'IBM est que "its dense architecture supports broad compatibility", ce qui est un vrai argument si vous déployez sur du matériel hétérogène et diverses piles de service. Cela veut aussi dire que le nombre de paramètres affiché est le modèle entier, sans tour de passe-passe entre actifs et total.
Pour compléter la sortie : le dialogue multilingue est testé dans 12 langues, et IBM a livré deux minuscules modèles de transcription Granite Speech 5.0 Turbo (470M de paramètres) en plus des LLM pour l'audio en périphérie.
Les trois modèles : 3B, 8B et 30B
Granite 4.2, ce sont exactement trois modèles denses, chacun post-entraîné à partir de la base Granite 4.1 correspondante. Tous gèrent nativement un contexte de 128K tokens, et le 30B va jusqu'à 512K.
| Modèle | Paramètres | Couches | Contexte | Téléchargement Ollama | Idéal pour |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B dense | 40 | 128K / 512K | 2,2 Go | Périphérie, portables, tâches économiques à gros volume |
| granite-4.2-8b | 8B dense | 40 | 128K / 512K | 5,3 Go | Cheval de trait polyvalent et équilibré |
| granite-4.2-30b | 30B dense | 64 | 128K / 512K | 18 Go | Modèle phare pour le raisonnement et les tâches agentiques |
IBM fournit aussi des quantifications officielles (fp8, mxfp4, nvfp4) de chaque taille, ainsi que des builds GGUF communautaires pour llama.cpp et LM Studio. À savoir : les fiches des modèles recommandent explicitement d'exécuter Granite avec Granite Guardian 4.1 8B, un modèle de sécurité distinct pour la détection des risques. L'étiquette « 4.2 » ne couvre que les trois modèles de langage ; Vision, Guardian et Speech suivent leurs propres numéros de version.
Benchmarks : où se situe réellement Granite 4.2
Voici la comparaison phare d'IBM, le 30B face au Nemotron 3 Super 120B de Nvidia et au Gemma 4 31B de Google :
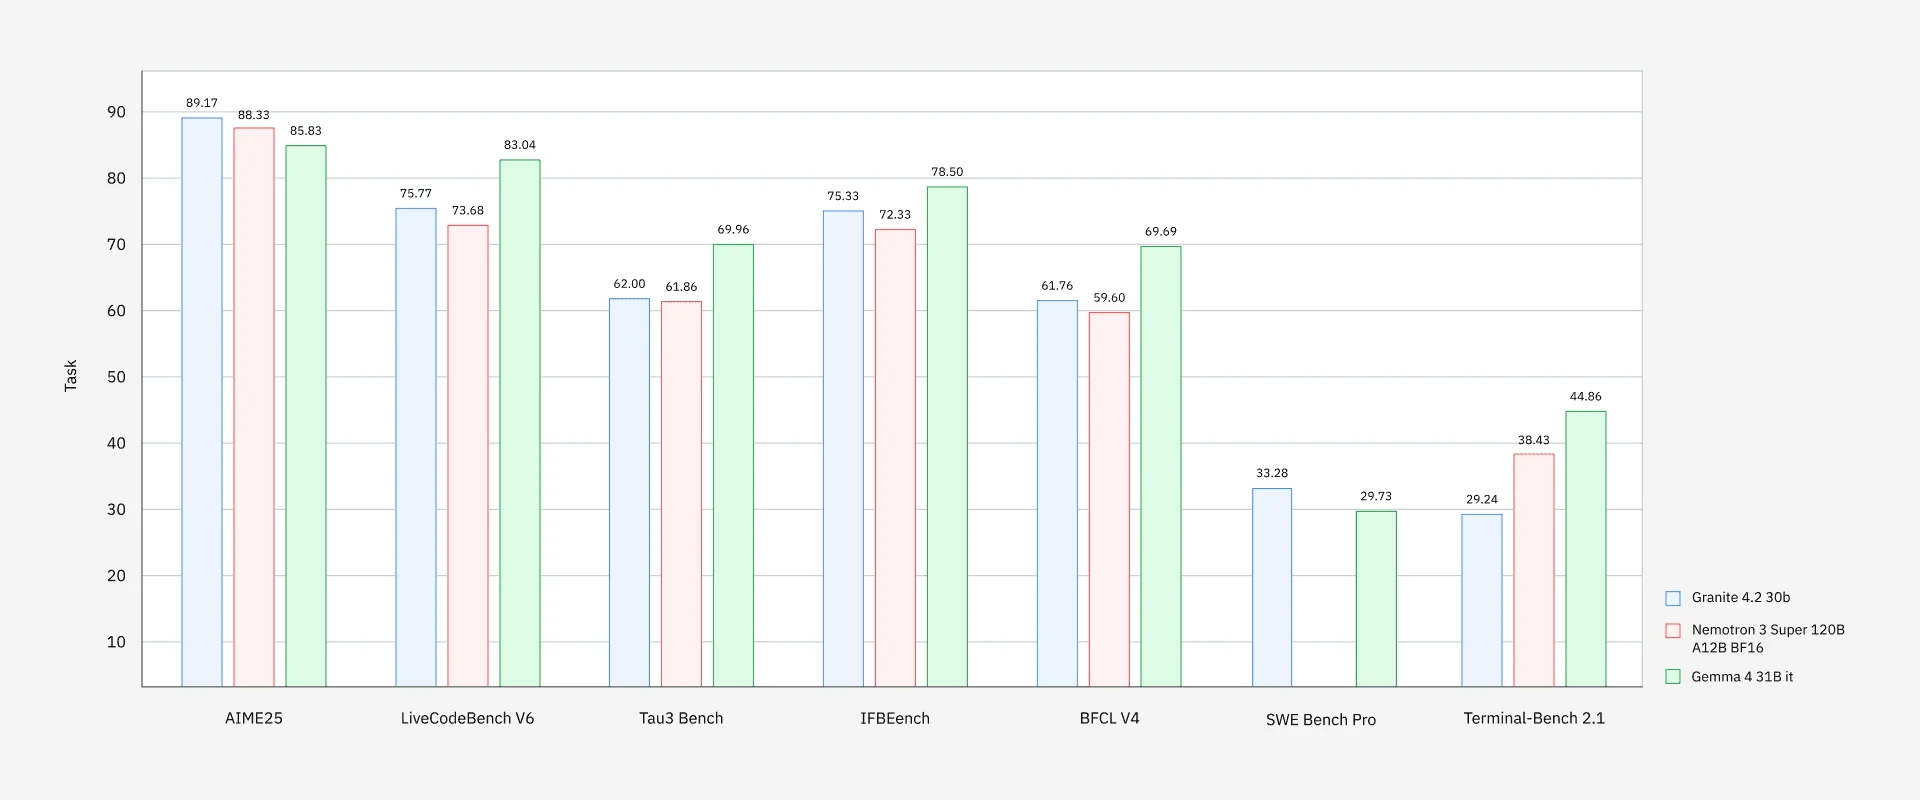
L'histoire qu'IBM veut raconter est réelle : sur AIME25, le 30B obtient 89.17, devançant de peu un modèle Nemotron de 120B paramètres, et il mène aussi sur LiveCodeBench, IFBench et BFCL. « Compétitif avec de plus gros modèles thinking pour une fraction du coût » résume correctement ce graphique.
Les réserves honnêtes comptent tout autant :
- Le tableau s'inverse sur le code agentique le plus difficile. Gemma 4 31B bat Granite à la fois sur SWE-Bench Pro et Terminal-Bench 2.1. Les chiffres bruts de Granite en agent de code (33.29 sur SWE-Bench Pro, 29.24 sur Terminal-Bench) sont corrects pour la taille mais ne dominent pas la catégorie.
- IBM se compare à un ensemble de pairs soigneusement choisi. C'est toujours IBM qui choisit la comparaison. Comme l'a dit un commentateur de Hacker News lors du lancement de la 4.1 :
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models. At least this is the most reasonable assumption until data comes out to the contrary."

Pour les chiffres qui comptent dans l'automatisation du support, le tableau est encourageant : le 30B atteint 62.00 sur tau3-bench (usage agentique d'outils), 61.39 sur BFCL v4 (appel de fonctions) et 77.60 sur MMLU-Pro. Ce sont les muscles d'appel d'outils et de suivi de consignes sur lesquels un agent de support s'appuie vraiment, et le 8B est assez proche (52.39 BFCL, 74.04 MMLU-Pro) pour être intéressant dans des déploiements sensibles au coût.
Comment fonctionne la boucle raisonnement et appel d'outils
L'amélioration la plus utile pour qui construit des agents, c'est que Granite 4.2 raisonne sur les outils avant de les appeler. Au lieu de faire correspondre un nom de fonction par motif, le modèle réfléchit à l'outil qui convient et pourquoi, puis fait l'appel. C'est la différence entre un agent qui consulte fiablement une commande et un agent qui invente une fonction qui n'existe pas.
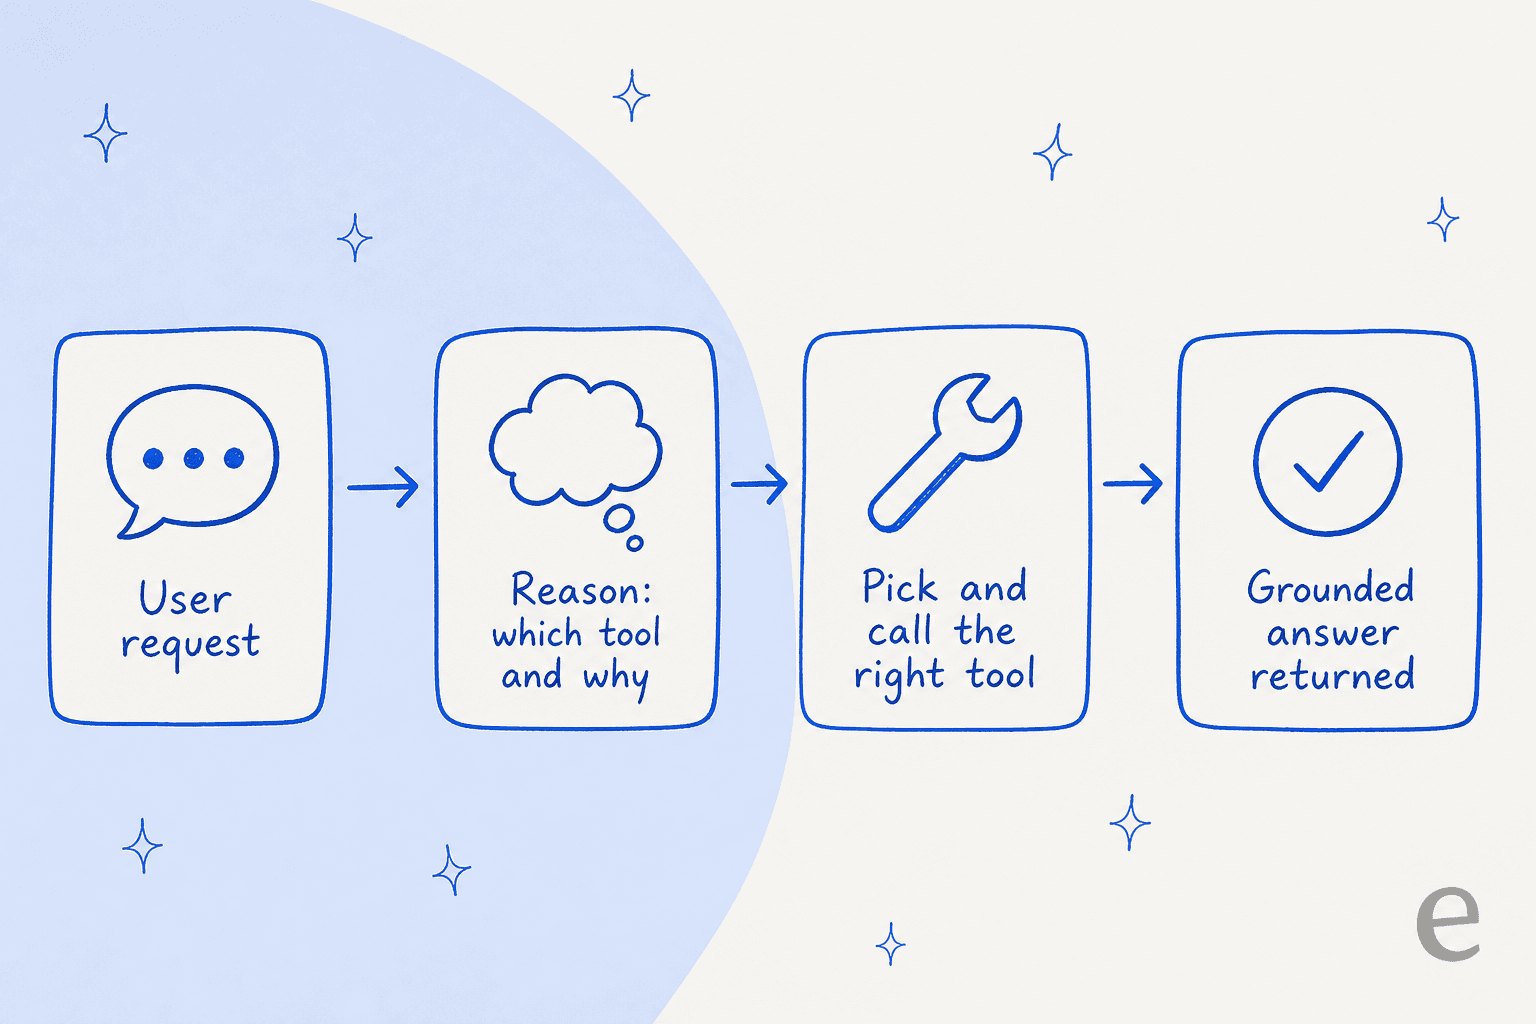
Il est exposé via une API compatible OpenAI et fonctionne immédiatement avec des environnements de code agentique comme OpenCode et OpenHands. Le ressenti de la communauté confirme la conception : les petits modèles de Granite sont discrètement bons sur le travail structuré.
"IBM Granite 4H-Small, it's very good with tool calls. most tool-calling issues come from the model not sticking to the exact structure you"

C'est la couche où le choix du modèle rencontre un vrai produit. Un appel d'outils fiable est ce qui sépare un agent IA d'un chatbot à règles, et c'est ce qui permet à un agent de consulter une commande, d'étiqueter un ticket ou de déclencher un remboursement au lieu de simplement écrire une phrase plausible à ce sujet.
Accès et tarifs
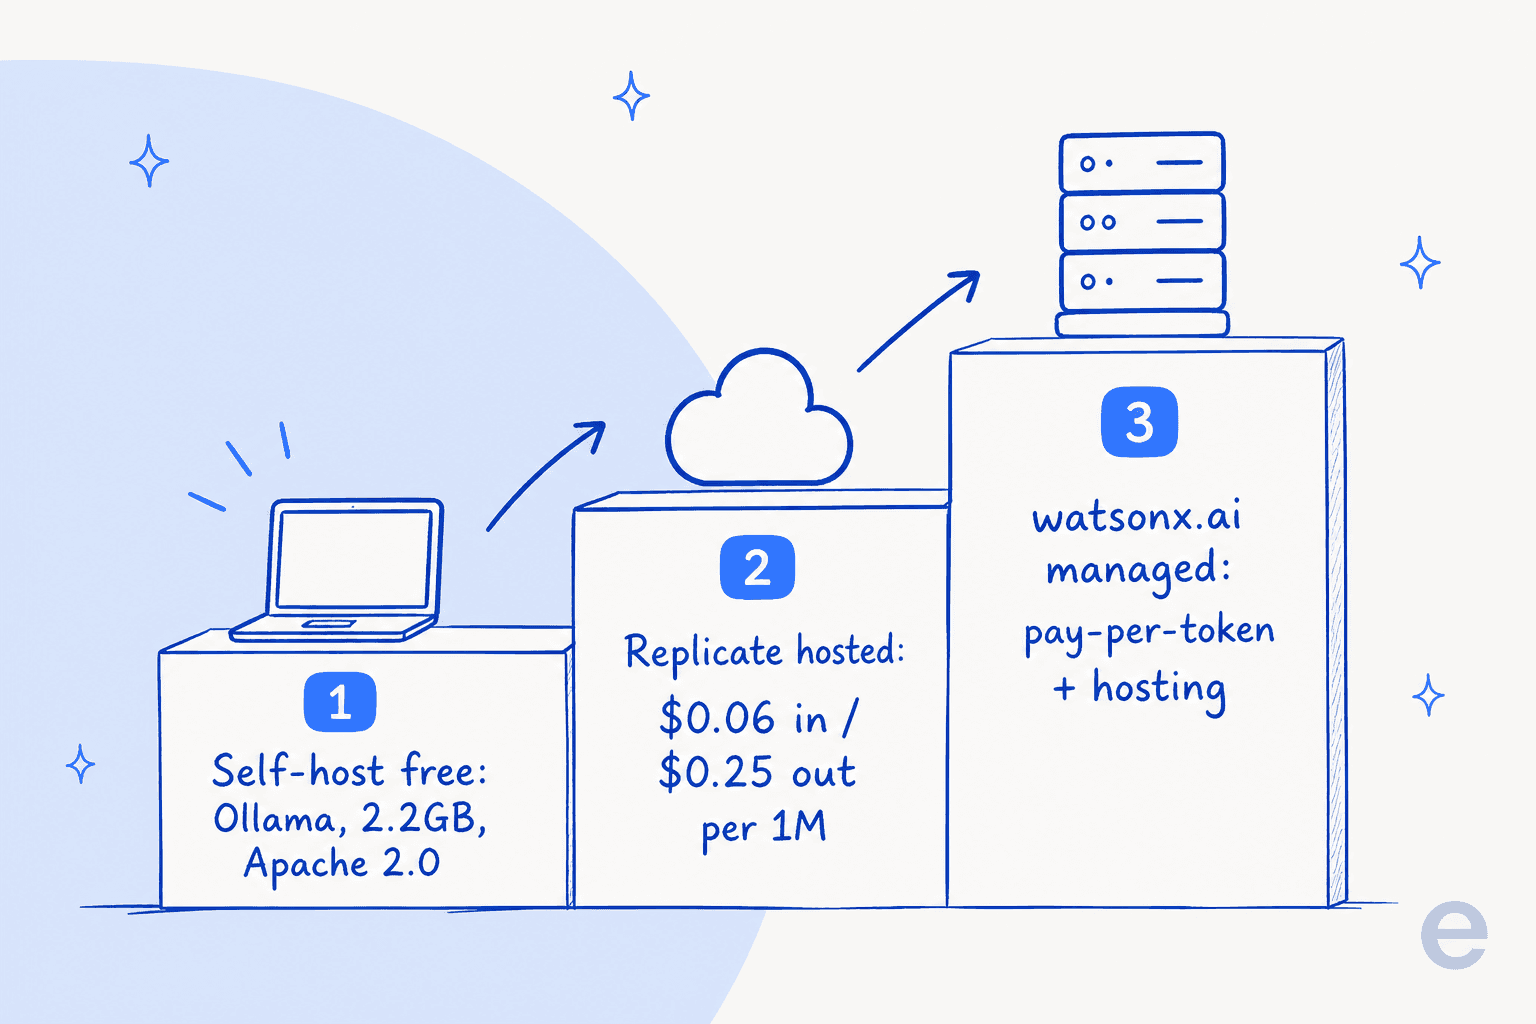
C'est là que Granite devient attrayant : comme il est sous Apache 2.0, le plancher est gratuit. Vous pouvez le télécharger, l'affiner et le mettre en production sans frais de licence ni coût par token au-delà de la puissance de calcul sur laquelle vous l'exécutez. Il y a trois voies pratiques, de plus en plus confortables et de plus en plus coûteuses :
| Voie | Tarif | Remarques |
|---|---|---|
| Auto-hébergement (Ollama, vLLM, llama.cpp) | Gratuit (votre calcul) | Le 3B tourne sur un portable ; le 30B demande ~18 Go+ de VRAM |
| API hébergée Replicate | $0.06 / 1M en entrée, $0.25 / 1M en sortie | ~$0.0014 par exécution type ; 8B uniquement, confirmé |
| watsonx.ai | Paiement par 1M tokens + hébergement à l'heure | Forfait Standard ~$1,050/mois ; plateforme gérée d'IBM |
Deux notes honnêtes. D'abord, watsonx.ai, la plateforme d'IBM, est la voie entreprise, et son modèle tarifaire (paiement à l'usage par million de tokens, où historiquement 1 Resource Unit = 1 000 tokens, plus hébergement à la demande à l'heure) est confirmé, mais le tableau de la documentation en ligne a renvoyé une erreur 500 quand j'ai vérifié, donc je n'ai pas pu fixer la ligne exacte de Granite 4.2. Le tarif Granite 4 confirmé le plus proche se situe autour de $0.06 par million en entrée et $0.27 en sortie. Ensuite, au moment de la rédaction, les modèles 4.2 n'étaient pas encore listés sur OpenRouter, qui n'affichait toujours que Granite 4.1 8B et 4.0 Micro.
Voici la voie gratuite en action sur Ollama, ce qui est la façon dont la plupart des gens vont tester :
Un piège que la communauté a vite repéré : la taille du téléchargement ment sur la mémoire nécessaire. Un fil sur r/LocalLLaMA signalait le 8B qui gonflait bien au-delà de son empreinte :
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"
C'est le cache KV et l'allocation du contexte à l'œuvre, et c'est normal à prévoir, mais si vous dimensionnez un GPU d'après la taille du téléchargement, vous serez à court. Prévoyez de la marge, surtout avec un contexte long.
Ce que la communauté en pense vraiment
Le sentiment sur Granite 4.x est constant et, à mon avis, juste. Les éloges se concentrent précisément sur ce qu'IBM a voulu construire : les petits modèles tournent vite sur du matériel courant, ont des données d'entraînement récentes et une licence commerciale sans restriction.
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly... Granite has recent training data which is nice."
La critique est tout aussi constante : en capacité brute, surtout pour le code, les gens se tournent encore vers Qwen.
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
Et un commentateur sur X a mieux résumé le positionnement que le marketing d'IBM lui-même : Granite rivalise sur la confiance plutôt que de chercher à dominer un classement.
"IBM just released a model built to need less of your trust, not more of your capability. Granite 4.2 ships in 3, 8, and 30 billion parameter sizes, fully open under Apache 2.0. It's trained specifically for tool use, terminal work, and multistep agent tasks."
C'est tout l'avis en un paragraphe, honnêtement. Granite 4.2 ne cherche pas à être le modèle le plus intelligent que vous puissiez exécuter. Il cherche à être celui que vos équipes sécurité et juridique valident : poids signés, certification ISO, une excellente note de transparence de Stanford et une licence qui ne vous enferme pas. Pour une entreprise réglementée qui monte des modèles spécialisés par domaine sur site, cette combinaison vaut plus que deux points sur un benchmark de code.
Où Granite 4.2 se place pour les équipes support et IA
Alors, une équipe support ou ops doit-elle s'y intéresser ? Oui, mais il faut être clair sur ce que l'on tient réellement. Granite 4.2 est de l'infrastructure, un moteur. Ce n'est pas, à lui seul, un agent de service client, pas plus qu'un V8 n'est une voiture.
Si vous avez une équipe ML et voulez un contrôle maximal (des données qui ne quittent jamais votre VPC, un modèle affiné sur vos propres tickets, pas de facture au token à grande échelle), l'auto-hébergement d'un modèle ouvert comme Granite est une voie réelle et de plus en plus répandue. Le 8B est un point de départ raisonnable pour l'automatisation du service client : bon appel d'outils, peu coûteux à exécuter, sous licence. Vous construiriez ensuite le reste vous-même : la recherche dans votre centre d'aide, la logique d'escalade, des garde-fous contre les hallucinations, un moyen de mesurer le taux de résolution et une façon sûre de tester avant la mise en production.
Ce « construire le reste vous-même », c'est tout le travail, et c'est la partie que les tests de modèles passent sous silence. Choisir le modèle, c'est peut-être 10 % du chemin pour livrer un agent de support qui dévie vraiment les tickets de niveau 1 sans aggraver les choses. Les 90 % restants, c'est la plomberie, les tests et la sécurité opérationnelle, là où la plupart des projets internes calent.
Essayer eesel : la couche que Granite ne fournit pas
Si votre but est un agent de support opérationnel plutôt qu'un modèle sur lequel construire, c'est exactement le vide que comble eesel. Granite vous donne un moteur. eesel est le coéquipier IA pour helpdesk prêt à travailler qui a déjà le moteur, plus tout ce qu'il y a autour : il s'entraîne sur vos anciens tickets et votre centre d'aide, se branche sur le helpdesk que vous utilisez déjà (Zendesk, Freshdesk, Gorgias et plus de 1 000 autres intégrations) et rejoint la file en quelques minutes plutôt qu'en quelques trimestres.

Ce qui fait la différence, c'est ce que je disais au début qui m'importe : avant qu'eesel ne réponde à un seul vrai client, vous pouvez le simuler sur des milliers de vos tickets historiques pour voir exactement comment il aurait répondu et ce qu'il aurait résolu. C'est le filet de sécurité qu'un modèle brut, Granite ou autre, ne fournit pas. Un client, Global Pay, a rapporté jusqu'à 80 % de temps gagné grâce à lui.
Utilisez Granite 4.2 si vous construisez. Utilisez un coéquipier IA pour helpdesk si vous voulez répondre à des tickets. Vous pouvez essayer eesel gratuitement, sans carte bancaire et sans appel commercial pour commencer.
Comment Granite 4.2 se compare-t-il à Qwen ?