

Ce qu'est réellement Claude Mythos 5.1
Anthropic a sorti Claude Mythos 5.1 le 1er septembre 2026, avec l'identifiant de modèle claude-mythos-5-1. C'est un modèle frontière destiné au travail vérifié en cybersécurité et en sciences de la vie, et Anthropic a indiqué que Claude Security lui-même tourne désormais dessus.
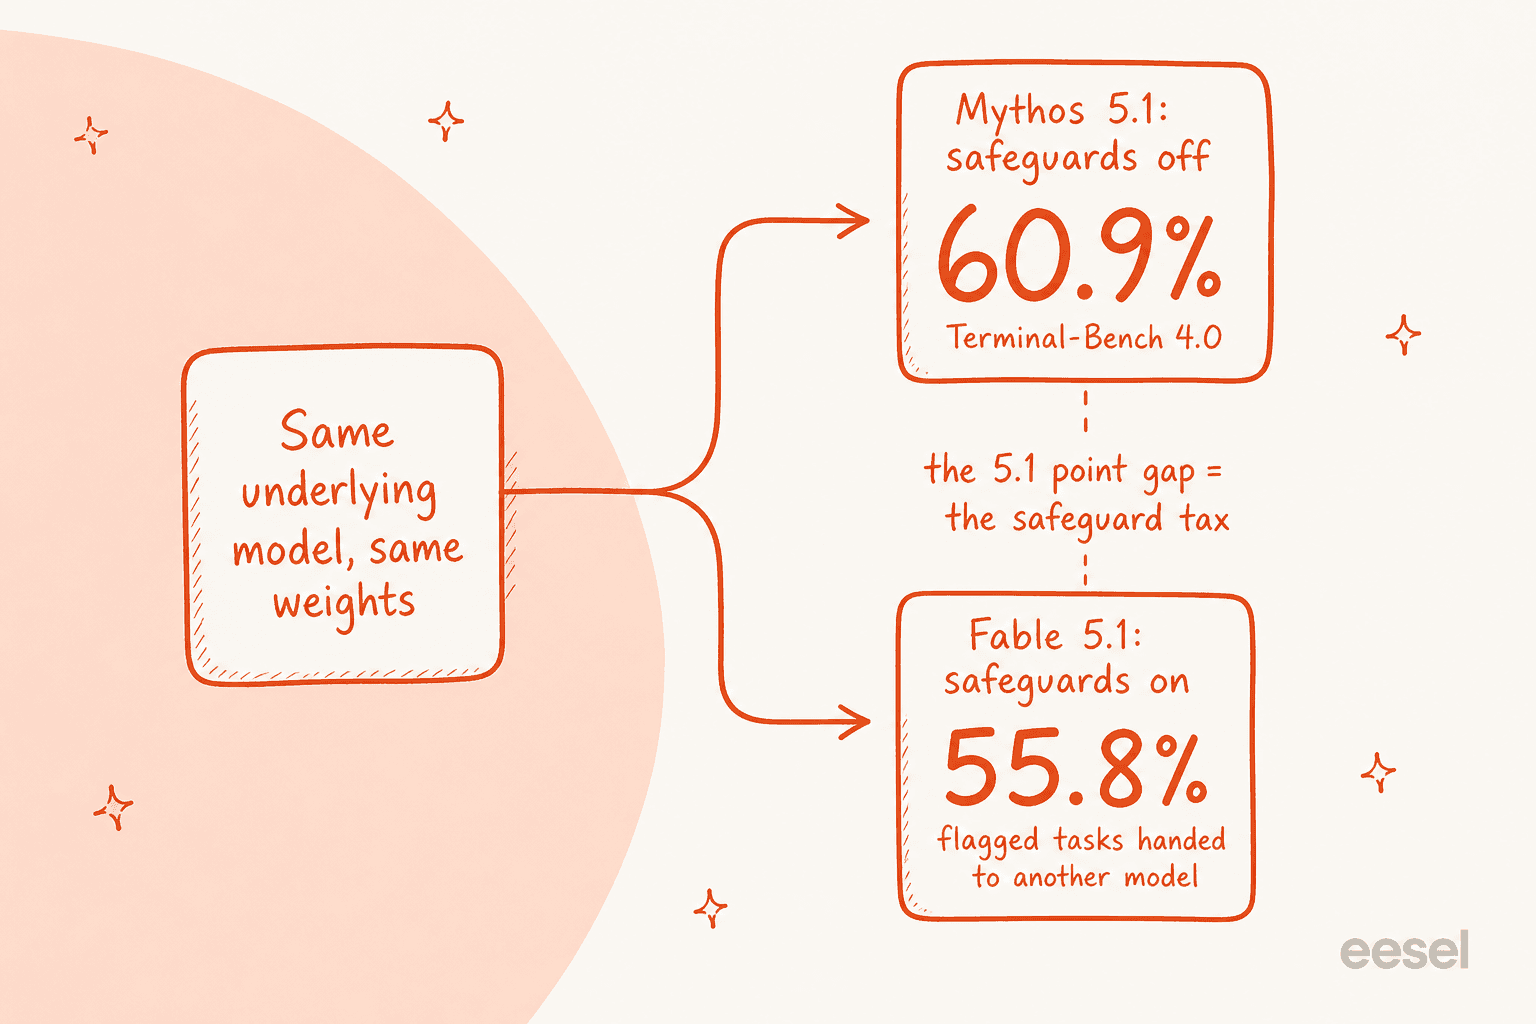
La chose à bien intégrer avant toute discussion de benchmark : Mythos 5.1 et Fable 5.1 sont les mêmes poids. Seule la couche de garde-fous diffère. Fable 5.1 est la version évaluée et livrée avec les garde-fous de production activés, et quand un garde-fou se déclenche, il transmet la tâche à un autre modèle (le travail cyber part vers Opus 4.8, la biologie vers Opus 5). Mythos est le même modèle mesuré avec ces garde-fous désactivés. Cette relation résume toute l'histoire, donc j'y reviendrai sans cesse.
Mythos 5.1 contre Fable 5.1 : l'écart est une taxe de sécurité
Voici le chiffre que tout le monde cite hors contexte. Sur Terminal-Bench 4.0, Mythos 5.1 obtient 60,9 % et Fable 5.1 obtient 55,8 %. On dirait que Mythos est le modèle le plus intelligent. Ce n'est pas le cas. Le score plus faible de Fable, c'est ce qui se passe quand les garde-fous interceptent une tâche et la réorientent, et une tâche interceptée peut tomber directement à zéro. L'écart de 5,1 points est le coût des garde-fous, pas une différence dans le cerveau sous-jacent.
Ce point a piégé beaucoup de lecteurs au lancement. Comme l'a formulé un commentateur sur Hacker News :
"Attends, donc c'est littéralement le même modèle mais il score plus haut parce que t'as retiré la ceinture de sécurité ? Ce n'est pas un nouveau modèle, c'est une note de bas de page de benchmark."

Anthropic elle-même s'attend à ce que l'écart se réduise à mesure que les garde-fous deviennent plus précis, ce qui revient à admettre tacitement que la différence vient de la couche de sécurité et non de la qualité du modèle. Donc si vous comparez Mythos et Fable sur la capacité brute, arrêtez : ils sont équivalents. Là où Fable justifie sa place, c'est dans le travail de garde-fous lui-même. Il peut désormais identifier des vulnérabilités logicielles dans le code source, il déclenche environ 60 % moins d'interventions de sécurité cyber par session Claude Code, et ses garde-fous de biologie se déclenchent 85 % moins souvent sur des requêtes anodines. Les tests d'intrusion, la génération d'exploits et le scan de vulnérabilités binaires continuent d'être orientés vers Opus. Les deux modèles se placent aux côtés du reste de la gamme, donc si vous voulez la carte complète de la famille, les articles sur Claude Opus 5 et Claude Sonnet 5 couvrent les niveaux inférieurs.
Pour mémoire, voici comment Fable 5.1 (votre substitut concret de Mythos) se situe face à la concurrence, sur la base des chiffres publiés :
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6 | 24.7 | 29.0 | 22.4 |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| AutomationBench | 31.4 | 17.1 | 26.9 | 19.6 |
| CursorBench 3.2.0 | 73.4 | 70.5 | 70.0 | 67.2 |
| HLE with tools | 65.0 | 63.8 | 63.6 | - |
Le bond sur Terminal-Bench-Science, de 24,7 à 52,6, est celui que je signalerais vraiment à un acheteur. Pour une comparaison directe avec le camp OpenAI, les articles sur GPT-5.6 Sol et GPT-5.6 vs Claude vont plus loin qu'une simple ligne de tableau ne le permet.
La vraie information, c'est la lecture de cache à 0,25 $
Si vous ne retenez qu'un seul chiffre de cet avis, retenez celui-ci. Fable 5.1 et Mythos 5.1 tarifient une lecture de cache à 0,25 $ par million de tokens, soit 0,025x le taux de base en entrée. Tout autre modèle Claude facture 0,1x, soit 1,00 $. C'est un modèle au double du prix de base d'Opus 5 qui propose une lecture de cache à la moitié du prix d'Opus 5 (0,50 $).
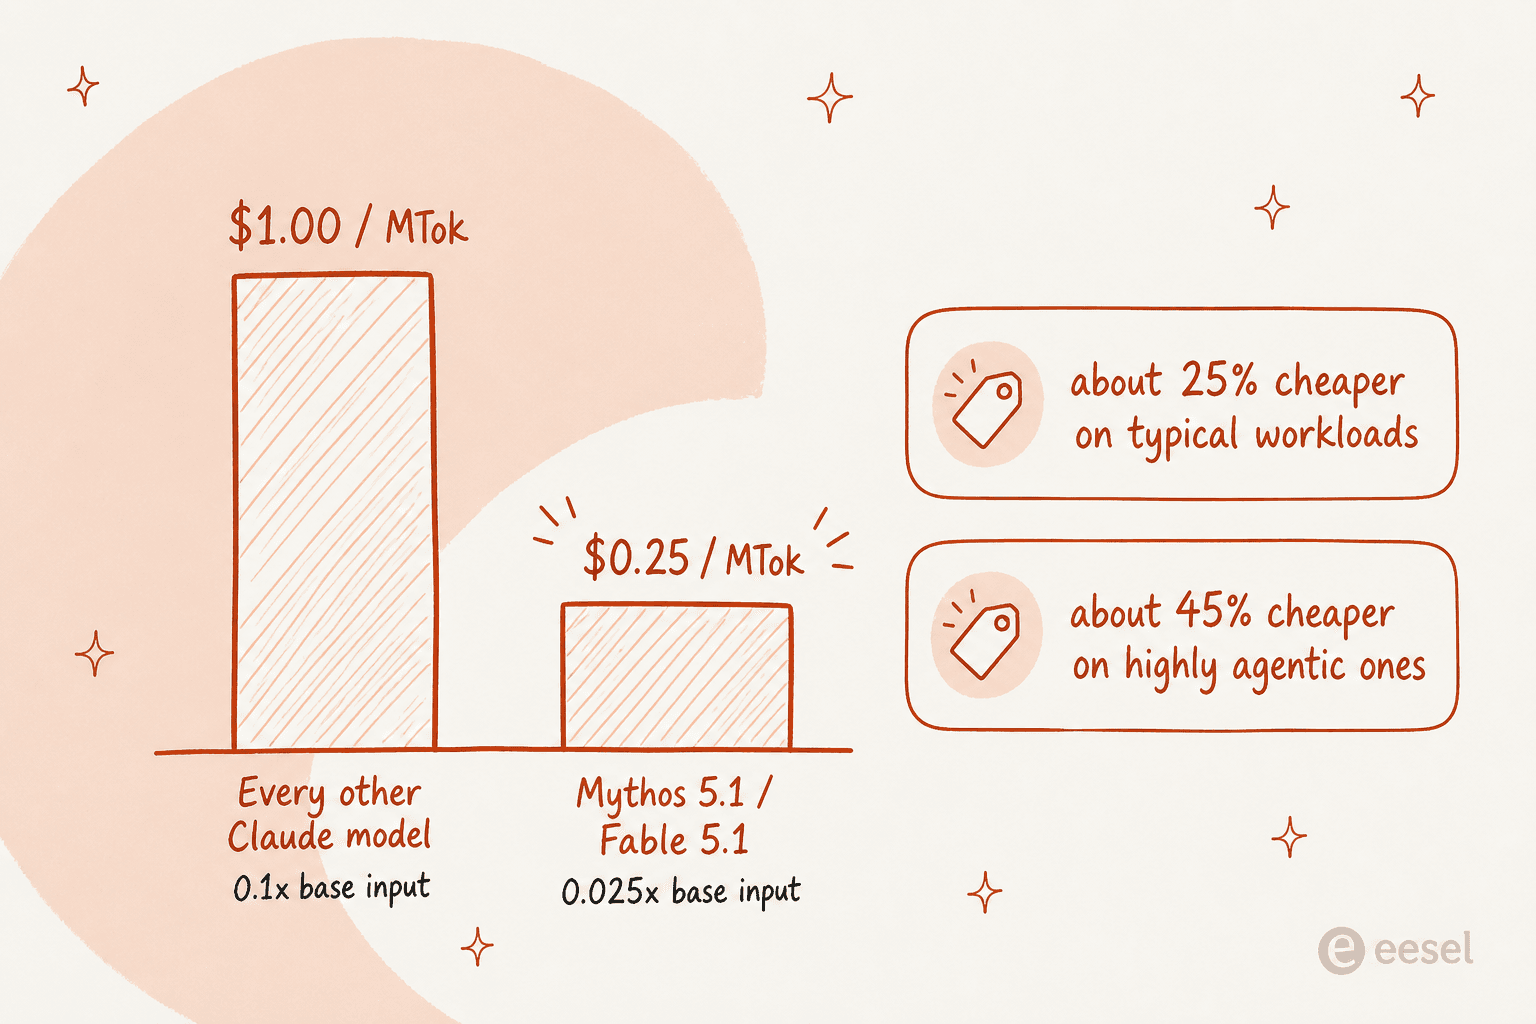
Anthropic a mesuré l'effet sur quatre semaines d'utilisation en août 2026 : environ 25 % moins cher pour les charges de travail typiques et environ 45 % moins cher pour les plus agentiques. Le taux de base (10 $ en entrée / 50 $ en sortie) ne change pas, le mode batch coûte 5 $ / 25 $, l'écriture de cache de cinq minutes coûte 12,50 $, et celle d'une heure coûte 20 $. Si vous faites tourner des agents à contexte long qui relisent la même base de connaissances à chaque tour, c'est ce chiffre qui fait vraiment bouger votre facture, bien plus que le taux de base. Un commentateur de Hacker News a fait le calcul à voix haute :
"La lecture de cache à 0,025x, c'est dément. Avec un taux de succès de 95 %, le coût d'entrée effectif se réduit essentiellement au prix du cache, donc on paie des centimes pour garder un énorme contexte au chaud."
Pour voir comment l'économie du cache se traduit dans une vraie pile d'agents, le guide sur les tarifs de l'API Anthropic et le détail des tarifs de Claude Code sont les prochains articles que je lirais.
Qui peut réellement faire tourner Claude Mythos 5.1
C'est ici que l'avis devient pratique, et un peu décevant. Mythos 5.1 n'est pas quelque chose que l'on active avec une simple clé API. L'accès est aujourd'hui limité aux États-Unis et passe par une de trois portes : le Cyber Verification Program (Anthropic indique que l'accès à Mythos arrive "dans un futur proche", donc ce n'est pas encore actif), une bêta du Life Sciences Program sur invitation, construite avec le gouvernement américain, ou une conversation directe avec votre équipe de compte Anthropic, AWS ou GCP. En plus de cela, utiliser Mythos 5.1 exige d'accepter par défaut une conservation des données de 30 jours.
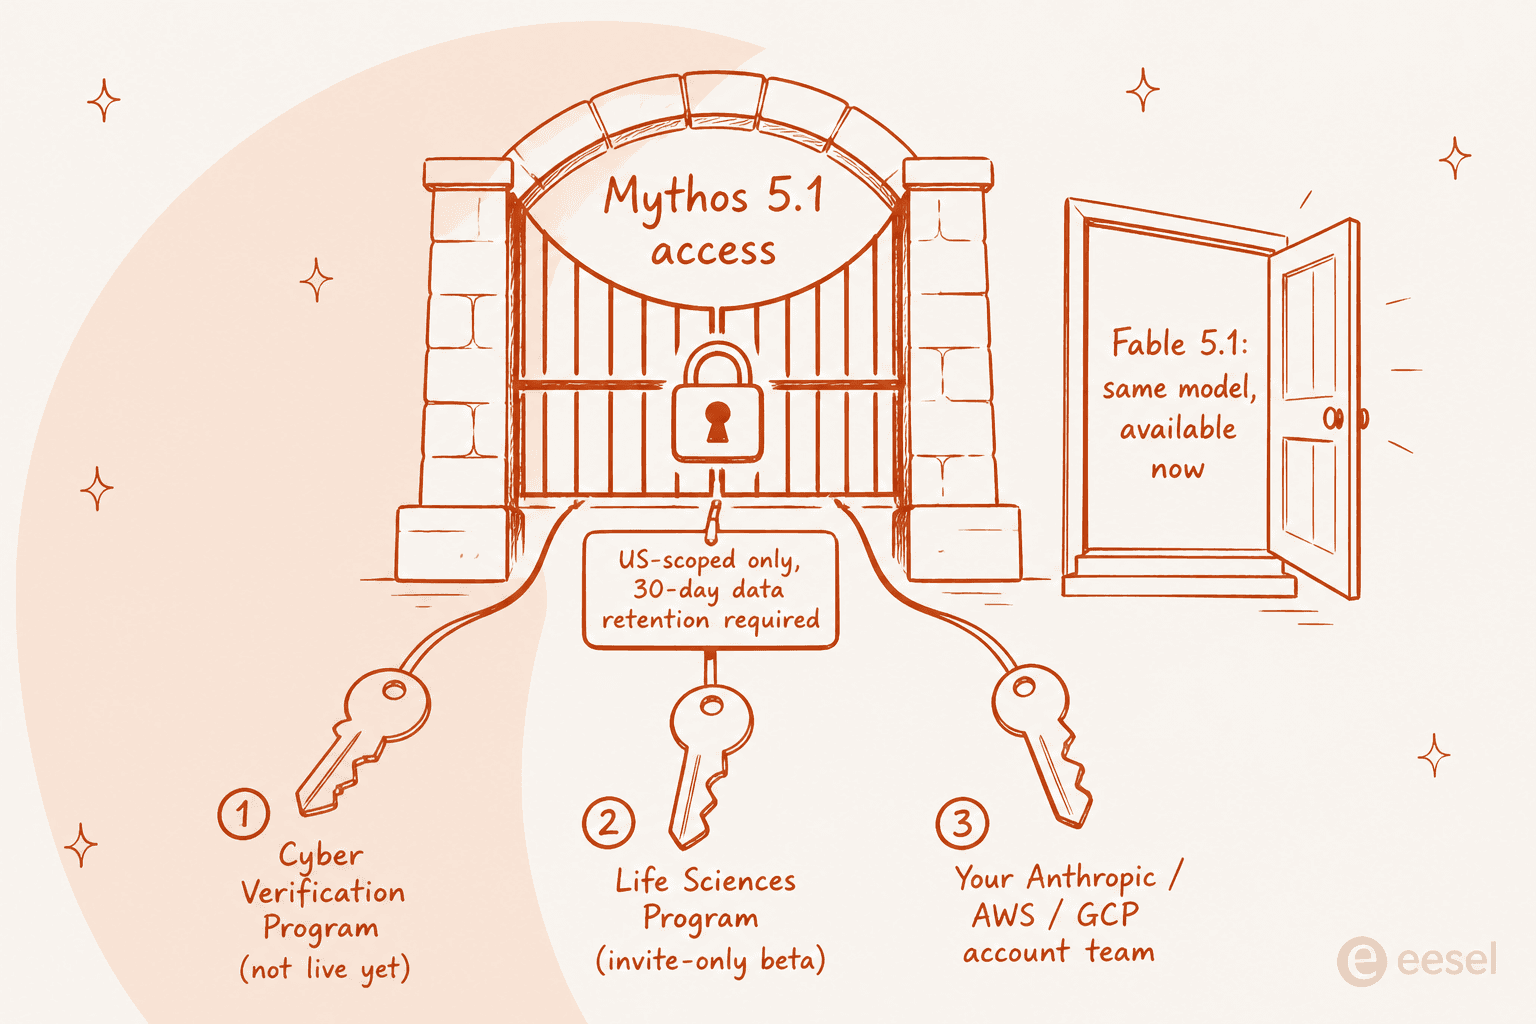
La réponse honnête à "devrais-je faire tourner Mythos 5.1" est donc que, pour presque tout le monde, ce n'est pas envisageable, et que la version que l'on peut faire tourner, Fable 5.1, est le même modèle. Ce n'est pas un reproche fait au modèle, c'est une raison d'orienter son évaluation vers le jumeau que l'on peut réellement déployer. Si vous choisissez un modèle Claude pour une charge de travail réelle dès aujourd'hui, les guides sur les alternatives à Claude et le meilleur modèle d'IA pour les tickets de support sont les lectures les plus pragmatiques.
La fiche technique
Pour les acheteurs qui veulent tous les chiffres au même endroit, voici avec quoi Mythos 5.1 (et donc Fable 5.1) est livré :
| Spécification | Valeur |
|---|---|
| Fenêtre de contexte | 1M tokens |
| Sortie maximale | 128K tokens |
| Thinking | Adaptatif, toujours activé ; effort par défaut high |
| Date limite des connaissances | Juin 2026 |
| Latence | Plus lente |
| Modalité | Texte + images vers texte |
| Plateformes | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry |
| Retrait | Pas avant le 1er septembre 2027 |
Deux changements côté développeurs sont à connaître avant de construire quoi que ce soit. Il y a trois changements d'API cassants qui touchent les deux modèles : l'usage forcé d'outils renvoie désormais une erreur, les blocs de "thinking" sont liés au modèle qui les a produits, et les nouveaux comptes API créés depuis le jour du lancement ne peuvent pas éditer le contexte précédent tout en conservant la transcription de "thinking", une mesure anti-distillation. Il y a aussi une particularité liée à l'AI Act européen : les modèles sortis après le 2 août 2026 portent un filigrane de texte invisible, avec une API de détection en préversion privée. Ce filigrane est ce qui a suscité le plus de débats lors du lancement. Si vous intégrez un modèle Claude à votre propre pile technique, les notes sur la sélection de modèle dans Claude Code et l'article sur les agents gérés de Claude sont les suites pratiques logiques.
Ce que j'utiliserais réellement
Voici ma conclusion après avoir digéré ce lancement. Mythos 5.1 est un excellent modèle que vous ne pourrez probablement pas utiliser, enveloppant un changement de tarification vraiment excellent que vous pouvez utiliser. Le bon réflexe n'est pas de courir après l'invitation. C'est de faire tourner Fable 5.1, d'empocher la lecture de cache à 0,25 $, et de traiter toute cette opposition Mythos contre Fable comme la note de bas de page sur la sécurité qu'elle est réellement.
Et il y a un point plus large caché derrière "le modèle est la partie facile". Un modèle frontière, Mythos ou Fable, c'est de l'infrastructure. Ce n'est pas un agent de support, un chercheur, ou un coéquipier à lui seul. Placer une clé API Claude brute à côté de votre helpdesk vous donne un générateur de texte très intelligent qui ne connaît pas votre politique de remboursement, ne peut pas voir vos 10 000 derniers tickets, et n'a aucun moyen d'être testé avant de s'adresser à un client. Combler cet écart, c'est le vrai travail, et c'est le même travail que le modèle en dessous soit Mythos, Fable, ou Opus 5.
Essayez eesel pour la partie que le modèle ne fait pas
Si vous lisez un avis sur Claude Mythos 5.1 parce que vous voulez une IA plus intelligente sur votre file d'attente de support, voici la transmission honnête : le modèle n'est pas le goulot d'étranglement, c'est la plomberie autour de lui. C'est exactement à cela que sert eesel.
Pensez-y comme à une nouvelle recrue. eesel est une plateforme de coéquipiers IA, et le coéquipier IA pour helpdesk rejoint votre file d'attente existante déjà formé sur vos tickets passés, votre centre d'aide et vos macros, si bien que l'intelligence brute du modèle est dirigée vers le contexte réel de votre entreprise plutôt que vers le web ouvert. Avant qu'il ne réponde jamais à un client réel, vous pouvez le simuler sur vos tickets historiques pour voir exactement ce qu'il aurait répondu, ce qui est la seule habitude qui a évité à mon équipe d'envoyer une réponse fausse mais assurée plus de fois que je ne peux le compter. Il se connecte à votre helpdesk en quelques minutes, qu'il s'agisse de Zendesk, Freshdesk, Front, Gorgias, ou Help Scout.
Et comme une bonne partie des personnes qui lisent l'avis d'un modèle sont des ingénieurs, il faut préciser qu'eesel n'est pas réservé au tableau de bord. Il existe une vraie CLI eesel ainsi qu'un serveur MCP, pour que vous puissiez piloter le même coéquipier depuis un terminal, l'intégrer dans vos propres workflows, ou laisser un agent de code comme Claude Code le manœuvrer. C'est le même coéquipier, que vous le pilotiez à la souris ou que vous le fassiez tourner en mode headless. Vous pouvez essayer eesel gratuitement, et si vous préférez le voir d'abord sur vos propres tickets, réservez une démo.
Questions fréquentes
Qu'est-ce que Claude Mythos 5.1 ?
Claude Mythos 5.1 est le modèle frontière d'Anthropic sorti le 1er septembre 2026, évalué avec les garde-fous de production désactivés. Il partage les mêmes poids sous-jacents que Fable 5.1, la version avec garde-fous activés que la plupart des gens utilisent réellement. Voir le guide complet sur Claude Mythos pour le contexte de toute la famille.
En quoi Claude Mythos 5.1 diffère-t-il de Fable 5.1 ?
Ce sont le même modèle avec une couche de garde-fous différente. Dans mon avis sur Claude Mythos 5.1, le seul écart mesurable est que Fable transmet les tâches signalées à un autre modèle, ce qui lui coûte quelques points de benchmark. Pour un regard plus approfondi sur le modèle jumeau, lisez l'avis sur Claude Fable 5.1.
Combien coûte Claude Mythos 5.1 ?
Le tarif de base est de 10 $ par million de tokens en entrée et 50 $ par million en sortie, comme Fable 5.1. La vraie nouveauté, c'est la lecture de cache à 0,25 $ par million de tokens. Le détail des tarifs de Claude Fable 5.1 et le guide plus large sur les tarifs de Claude couvrent le reste.
Tout le monde peut-il utiliser Claude Mythos 5.1 ?
Pas encore. L'accès est limité aux États-Unis et passe par le Cyber Verification Program, le Life Sciences Program, ou votre équipe de compte Anthropic, AWS ou GCP, et son utilisation impose d'accepter une conservation des données de 30 jours. Si vous voulez un modèle Claude que vous pouvez utiliser dès aujourd'hui, consultez les guides sur les alternatives à Claude et le meilleur modèle d'IA pour les tickets de support.
Claude Mythos 5.1 est-il adapté au support client ?
Le modèle est puissant, mais un modèle brut reste de l'infrastructure, pas un agent de support. Pour mettre un modèle Claude sur votre file d'attente, il faut encore de la recherche documentaire, des garde-fous et des tests, ce qui est exactement ce que la connexion de Claude à votre helpdesk et un logiciel de service client IA comme eesel font pour vous.