

Pouvez-vous vraiment obtenir Claude Mythos 5.1 ?
Commencez ici, car pour la plupart des lecteurs c'est toute la question.
Vérification d'accès à Claude Mythos 5.1
Choisissez la description la plus proche de votre équipe. Chaque réponse provient des pages d'accès d'Anthropic elles-mêmes, à jour de septembre 2026.
Qui êtes-vous ?
Peut-être, mais pas encore aujourd'hui
Le Cyber Verification Program est la voie à suivre. Il accorde déjà des garde-fous cyber réduits sur des modèles de classe Opus et Sonnet, et Anthropic indique que l'accès à la classe Mythos s'y ajoutera prochainement. Les candidatures se font via le portail du CVP.
À utiliser aujourd'hui : Fable 5.1. Il peut désormais identifier des vulnérabilités logicielles dans le code source, et les utilisateurs de Claude Code constatent environ 60 % d'interventions de garde-fous cyber en moins par session par rapport à Fable 5.
Uniquement sur invitation
Le Life Sciences Verification Program est une bêta sur invitation uniquement, construite avec le gouvernement américain, qui assouplit les garde-fous de biologie pour la R&D professionnelle. Les premiers participants sont inscrits ; un élargissement plus large est promis mais non planifié.
À utiliser aujourd'hui : Fable 5.1, dont les garde-fous de biologie se déclenchent désormais 85 % moins souvent sur des questions bénignes de biologie élémentaire et de médecine. Les requêtes de sciences de la vie de niveau recherche sont toujours redirigées vers Opus.
Demandez à votre équipe de compte
Claude Mythos 5.1 est listé sur l'API Claude, Amazon Bedrock, Google Cloud et Microsoft Foundry, et la documentation indique de demander l'accès via votre équipe de compte Anthropic, AWS ou Google Cloud. La disponibilité reste restreinte à un ensemble d'organisations américaines.
À utiliser aujourd'hui : Fable 5.1 sur la même plateforme, avec les Enterprise Frontier Safeguards arrivant par phases cet automne et une rétention de données nulle disponible pour les clients éligibles en attendant.
Non, et cela devrait rester ainsi pour un moment
Il n'existe aucun accès en libre-service à Mythos 5.1. Les deux programmes sont organisationnels, vérifiés, et limités aux États-Unis. Ni une carte bancaire ni un palier d'usage ne vous y font entrer.
À utiliser aujourd'hui : Fable 5.1 pour le plafond, ou Opus 5 à 5 $ en entrée et 25 $ en sortie, ce que la documentation d'Anthropic elle-même recommande comme point de départ pour la plupart des charges de travail.
Non, et vous n'en avez pas envie
La marge supplémentaire de Mythos 5.1 se situe en cybersécurité et en biologie. Ni l'une ni l'autre n'apparaissent dans une demande de remboursement ou un ticket WISMO. C'est aussi le modèle le plus lent et le plus cher de la famille, sur une file où c'est la latence que le client ressent.
À utiliser aujourd'hui : Sonnet 5 ou Opus 5 derrière une couche qui connaît réellement votre produit. L'écart sur une file de support, c'est le grounding et les tests, pas le niveau brut du modèle.
Ce qu'est réellement Claude Mythos 5.1
Claude Mythos 5.1 est le modèle de pointe de classe Mythos d'Anthropic, sorti le 1er septembre 2026 avec l'ID de modèle claude-mythos-5-1. Son statut dans la documentation indique « Active (invite only) », et son retrait n'est engagé au plus tôt que pour le 1er septembre 2027.
La lignée Mythos a commencé avec Claude Mythos Preview, le modèle non publié qu'Anthropic a utilisé pour lancer Project Glasswing en avril 2026. Mythos 5 a suivi le 9 juin, est devenu indisponible le 12 juin, et a vu ses contrôles à l'exportation levés le 1er juillet après approbation du gouvernement américain. Mythos 5.1 est le troisième modèle de cette lignée, et le premier à arriver aux côtés d'un jumeau en disponibilité générale.
Voici la fiche technique, tirée de la page du modèle plutôt que du discours marketing.
| Spécification | Claude Mythos 5.1 |
|---|---|
| ID du modèle | claude-mythos-5-1 |
| Date de sortie | 1er septembre 2026 |
| Statut | Actif, sur invitation uniquement |
| Fenêtre de contexte | 1M de tokens |
| Sortie maximale | 128K tokens |
| Thinking | Adaptatif, toujours actif |
| Effort par défaut | high |
| Date de coupure des connaissances | Juin 2026 |
| Latence comparative | Plus lent |
| Entrée / sortie | Texte et images, vers texte |
| Prix en entrée | $10 / MTok |
| Prix en sortie | $50 / MTok |
| Lecture de cache | $0.25 / MTok |
| Plateformes | Claude API, Bedrock, Google Cloud, Microsoft Foundry |
| Retrait | Pas avant le 1er septembre 2027 |
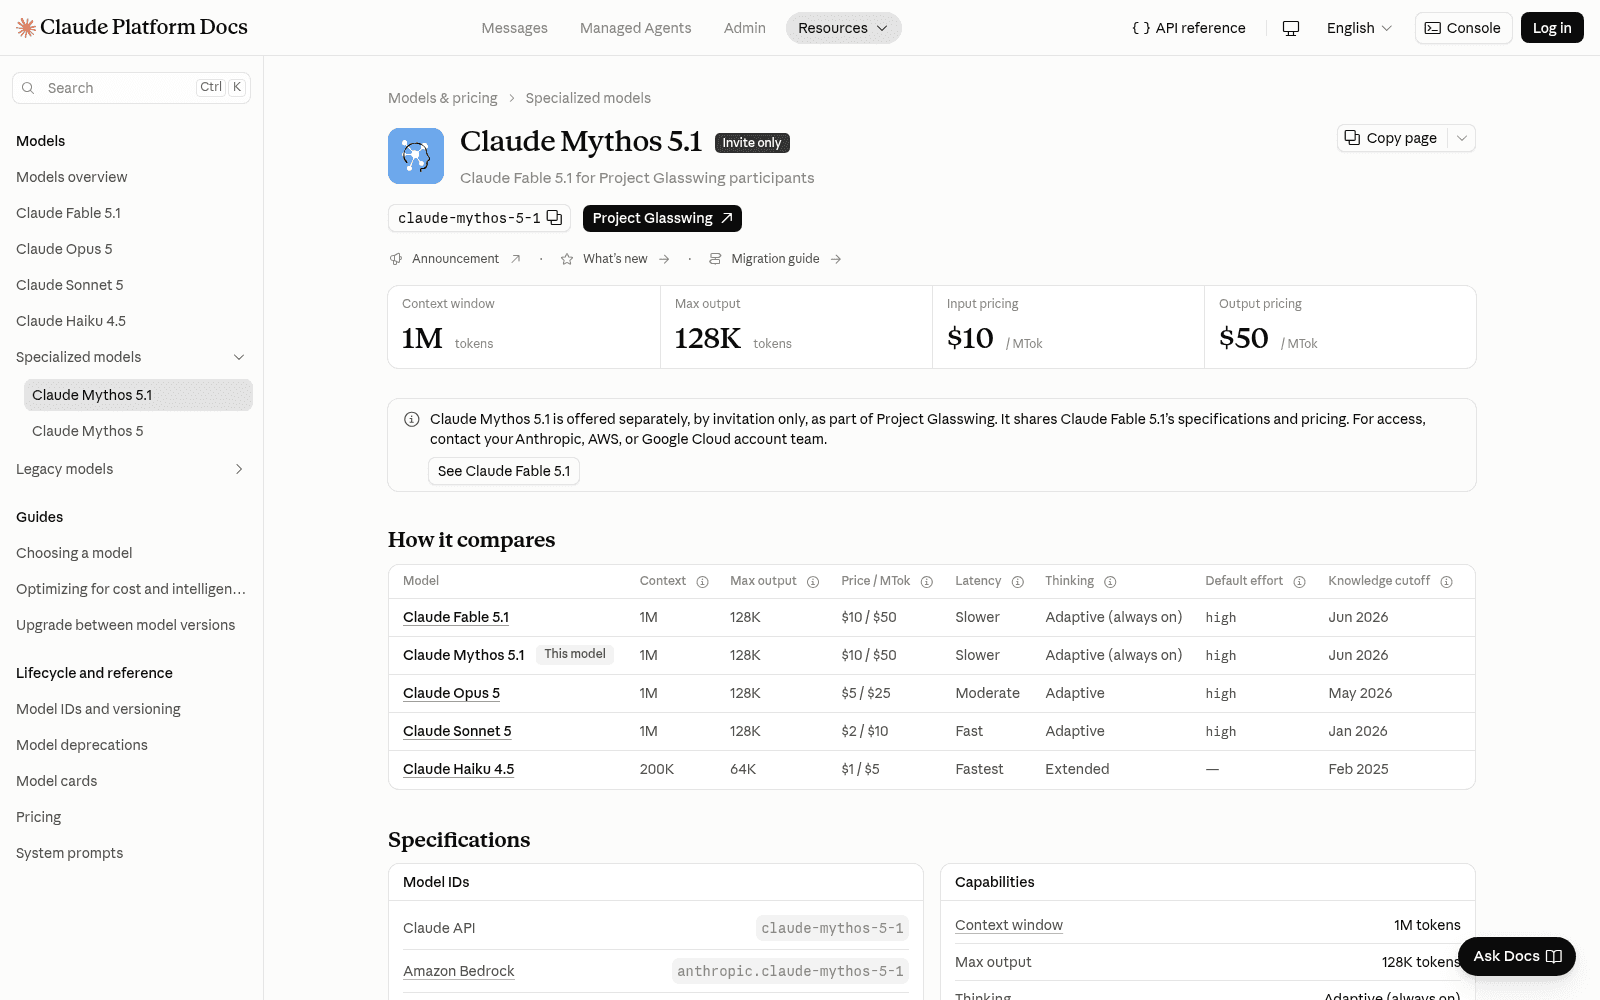
Une ligne à lire deux fois : utiliser Mythos 5.1 nécessite d'accepter par défaut une politique de conservation des données de 30 jours pour la surveillance de sécurité. C'est un fait réel côté achats, et c'est le miroir de l'histoire de rétention nulle qu'Anthropic raconte côté Fable.
Mythos 5.1 et Fable 5.1 sont un seul modèle à deux serrures
C'est la partie qui déroute presque tout le monde, y compris le fil Hacker News du jour du lancement :
"Claude Mythos 5.1 is identical to Fable 5.1, but it offers more permissive safeguards for vetted individuals and organizations"
Then why does it have separate datapoints for Terminal Bench, and score higher? Something doesn't add up here??

Ça se tient bel et bien, et la réponse est mécanique plutôt que mystérieuse. Anthropic évalue Fable 5.1 avec les garde-fous de production activés. Quand ces garde-fous se déclenchent sur une tâche de benchmark, la tâche n'échoue pas simplement ; elle est confiée à un autre modèle. Les tâches de cybersécurité ont été menées par Opus 4.8, les tâches de biologie par Opus 5, et sur OSWorld 2.0 les tâches concernées par une intervention ont obtenu un zéro pointé. Le chiffre publié pour Fable 5.1 est donc celui de tout le système avec garde-fous, pas celui des poids.
Mythos 5.1, ce sont ces mêmes poids avec des classificateurs cyber et biologie assouplis. C'est toute la différence.
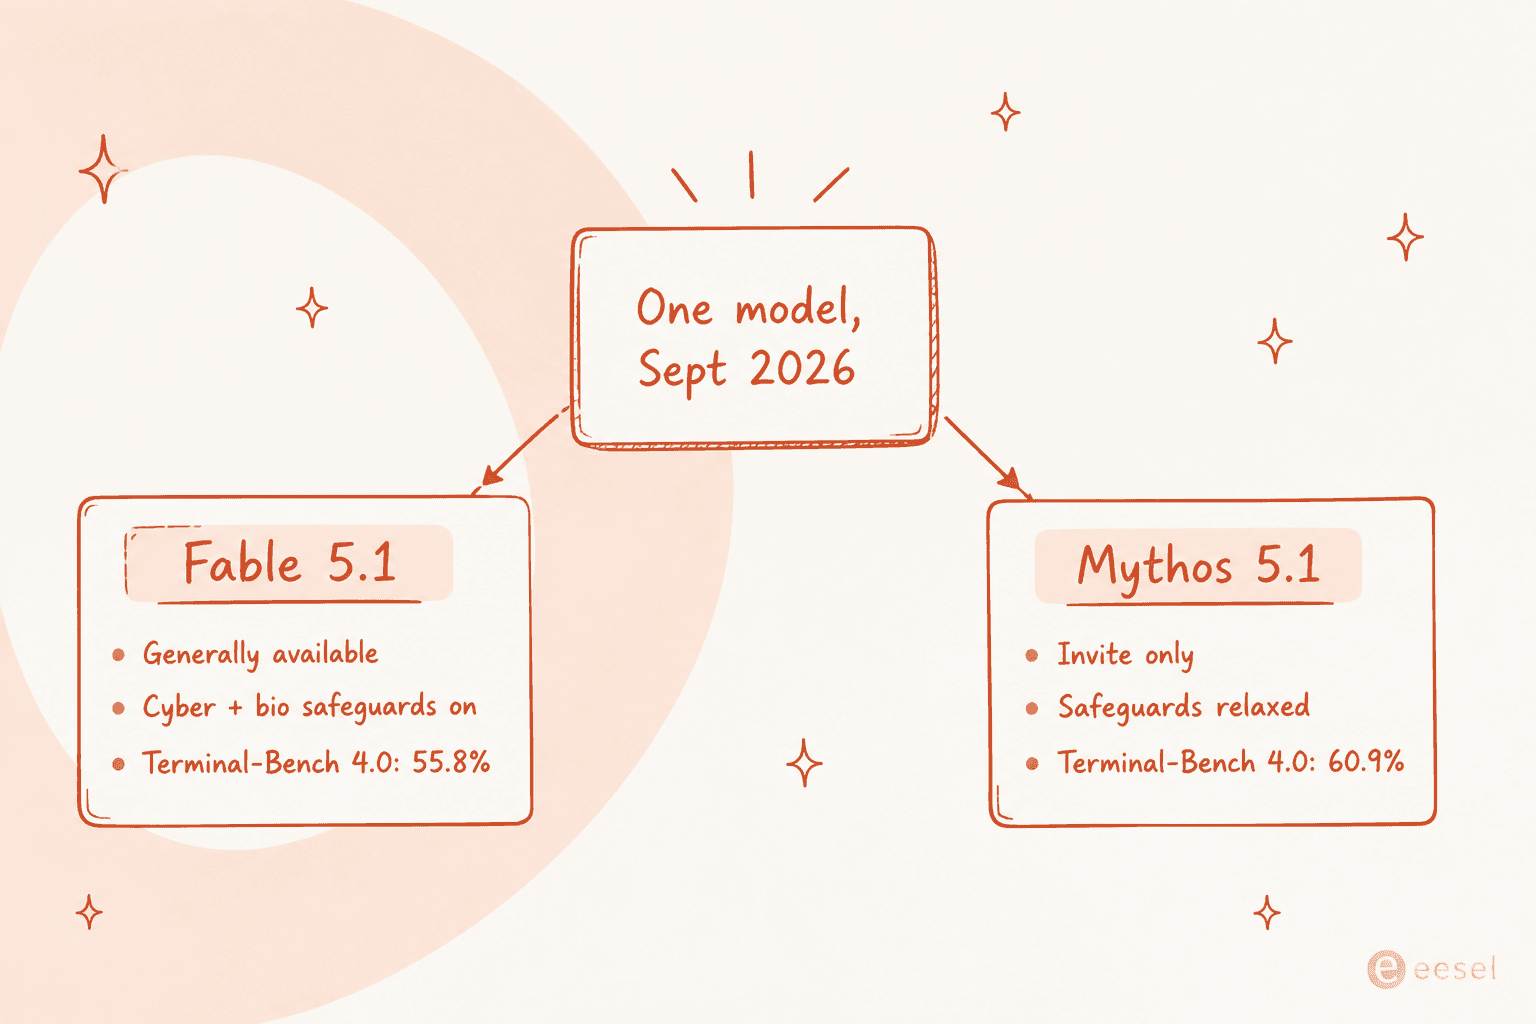
Anthropic dit explicitement s'attendre à ce que l'écart se réduise. L'article de lancement note que la différence sur Terminal-Bench reflète les garde-fous cyber antérieurs, moins précis, et qu'avec les améliorations de Fable 5.1 livrées le même jour, la différence entre les deux modèles devrait être bien plus faible.
Ce qui a réellement changé côté Fable mérite d'être connu même si vous ne touchez jamais à Mythos :
- Fable 5.1 peut désormais être utilisé pour identifier des vulnérabilités logicielles dans le code source, ce que les garde-fous précédents bloquaient.
- Les utilisateurs de Claude Code devraient constater environ 60 % d'interventions de garde-fous cyber en moins par session.
- Les garde-fous de biologie se déclenchent 85 % moins souvent sur des questions bénignes de biologie élémentaire et de médecine que ceux lancés avec Fable 5.
- Le travail à double usage est toujours redirigé vers des modèles Opus : tests d'intrusion, génération d'exploits et analyse de vulnérabilités à partir de binaires.
Ce dernier point est la limite honnête. Fable 5.1 lira votre code source et vous dira où se trouve le bug. Il ne vous écrira pas l'exploit.
Les benchmarks, et celui qui compte
Anthropic a publié les chiffres de Fable 5.1 et Mythos 5.1 côte à côte avec Fable 5, Opus 5 et GPT-5.6 Sol. Les scores ci-dessous concernent Fable 5.1 sauf mention contraire dans la ligne.
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% (60.9% Mythos 5.1) | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 (strict) | 41.7% | 36.1% | 39.6% | not published |
| Humanity's Last Exam (tools) | 65.0% | 63.8% | 63.6% | not published |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
Ce qui ressort, c'est Terminal-Bench-Science, qui a plus que doublé par rapport à Fable 5. Tout le reste est une progression plus modeste, et le fil de lancement l'a remarqué :
The price reduction comes from the cache read pricing falling from $1/M to $0.25/M, which means that Fable 5.1 now costs half of Opus's cache read costs ($0.5/M).
Cette lecture est juste sur les lignes de code et l'est moins sur la ligne science, où un bond de 27,9 points n'est pas un artefact d'arrondi. Anthropic note en bas de page une erreur standard de 3,5 à 4,5 points par modèle sur ce benchmark, ce qui laisse quand même l'écart largement en dehors du bruit statistique.
Les démonstrations scientifiques derrière ces chiffres sont la partie que je capturerais vraiment en capture d'écran. Mythos 5.1 a conçu des liants protéiques qui ont battu les meilleures entrées des compétitions d'Adaptyv Bio d'un facteur 10 sur l'affinité de liaison pour trois cibles, avec un taux de réussite proche de 50 % sur 12 cibles, là où 10 à 15 % est typique. Il a aussi écrit des kernels GPU qui ont accéléré sept modèles open source de génomique et de protéines jusqu'à 2,5 fois avec des résultats identiques, réduisant le coût GPU estimé des analyses à l'échelle du génome de 30 à 60 %. Séparément, Fable 5.1 a construit une nouvelle carte d'élévation haute résolution pour un tiers de Vénus à partir de données radar Magellan vieilles de 30 ans.
Rien de tout cela n'est un cas d'usage support. Tout cela explique pourquoi le modèle est derrière une porte.
Tarification : la baisse de la lecture de cache est la vraie nouvelle
Mythos 5.1 et Fable 5.1 partagent la même grille tarifaire. L'entrée coûte 10 $ par million de tokens, la sortie 50 $ par million. Cela n'a pas changé depuis Fable 5.
Ce qui a changé, c'est la ligne lecture de cache, et elle a beaucoup changé.
| Mesure | Fable 5 / Mythos 5 | Fable 5.1 / Mythos 5.1 |
|---|---|---|
| Entrée de base | $10 / MTok | $10 / MTok |
| Sortie | $50 / MTok | $50 / MTok |
| Écriture de cache 5 minutes | $12.50 / MTok | $12.50 / MTok |
| Écriture de cache 1 heure | $20 / MTok | $20 / MTok |
| Lecture de cache | $1.00 / MTok | $0.25 / MTok |
| Entrée / sortie Batch | $5 / $25 | $5 / $25 |
Tous les autres modèles Claude tarifent un hit de cache à 0,1x l'entrée de base. Fable 5.1 et Mythos 5.1 le tarifent à 0,025x, et la documentation d'Anthropic le signale en note de bas de page comme la seule exception de la famille. C'est aussi, comme l'a relevé le fil ci-dessus, la moitié du coût d'une lecture de cache sur Opus 5, sur un modèle dont le prix de base est le double.
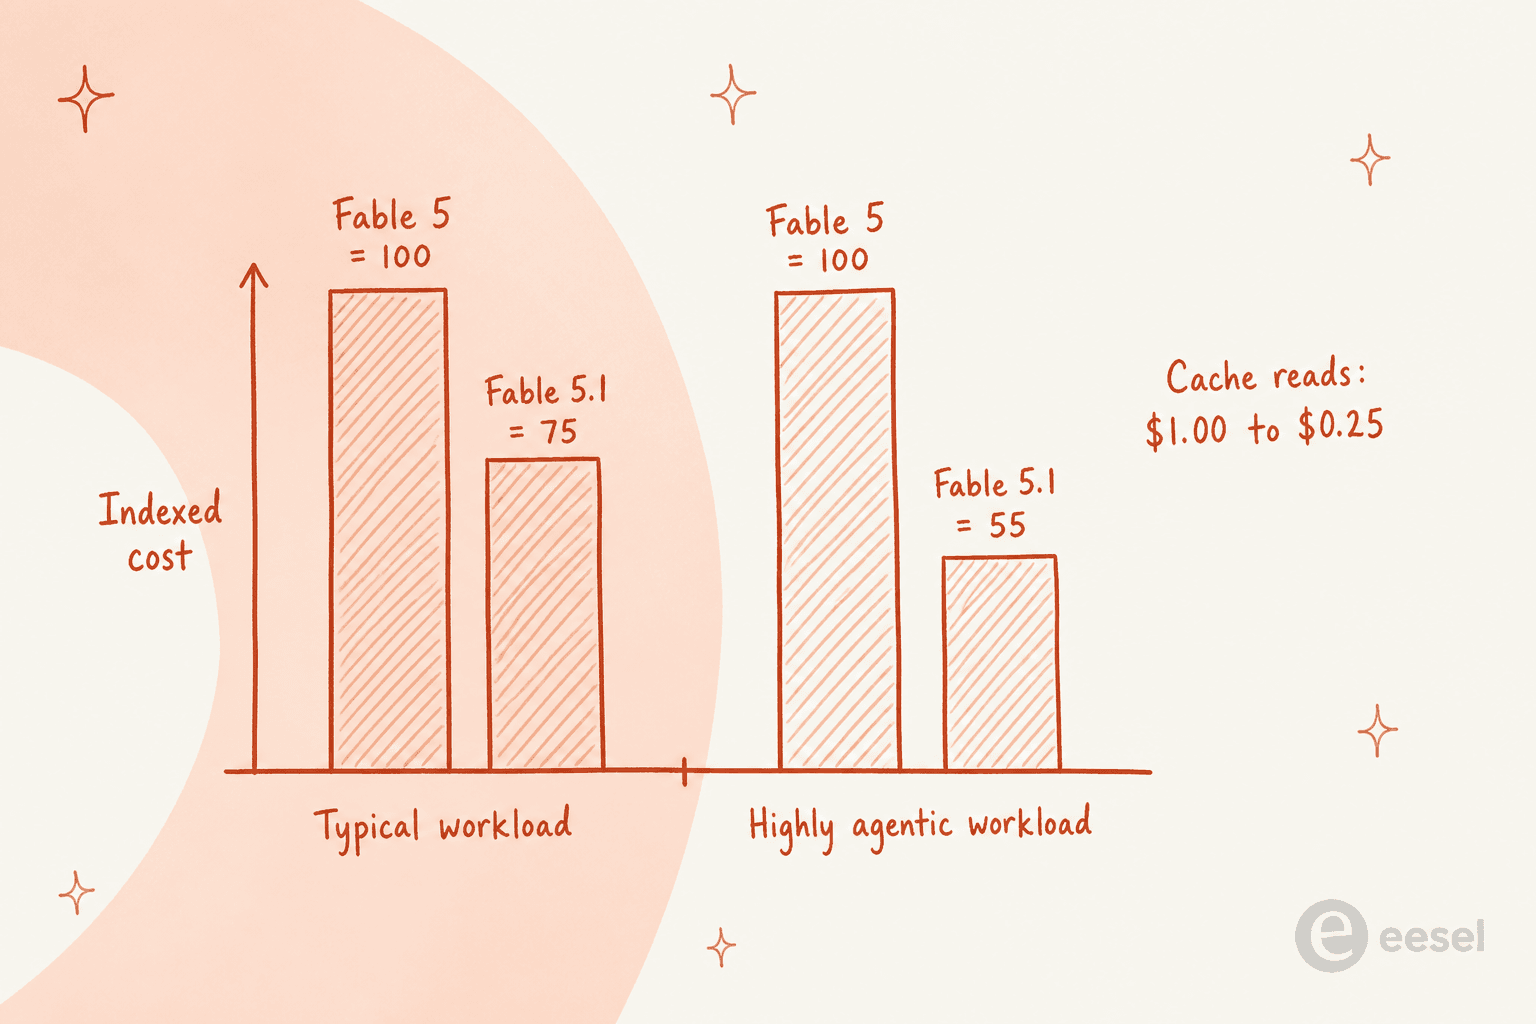
Anthropic a mesuré cela sur quatre semaines d'usage réel en août 2026 à effort par défaut. Les charges de travail typiques sur Claude Enterprise, Claude Code et l'API deviennent environ 25 % moins chères. Le travail agentique gourmand en contexte et en outils, où les lectures de cache représentent l'essentiel de la facture, devient environ 45 % moins cher.
La conséquence pratique est un changement de planification, pas juste une facture plus petite :
"Cache reads now cost 75% less, or $0.25 per million tokens." For me, at a typical 95% cache hit rate, I think my optimal context window size before autocompaction goes from ~200K to ~400K tokens. Great for longer horizon tasks.
C'est tout l'intérêt du changement. Sur une longue exécution agentique, la transcription est relue à chaque tour, donc le compteur de lecture de cache est celui qui s'accumule. Si vous compressiez agressivement le contexte pour maintenir la facture basse, le calcul vient de changer. La grille tarifaire complète de la famille se trouve dans mon récapitulatif des tarifs de l'API Anthropic, et le côté abonnement se trouve dans les tarifs de Claude.
Une chose que la baisse de prix ne change pas : le contexte long reste facturé de façon uniforme. Claude 4.6 et les modèles ultérieurs incluent la fenêtre complète de 1M au tarif standard, donc une requête de 900 000 tokens est facturée au même tarif par token qu'une requête de 9 000 tokens.
Comment l'accès fonctionne réellement
Deux programmes, tous deux vérifiés, tous deux limités aux États-Unis aujourd'hui.
Cyber Verification Program. Le CVP fournit actuellement des garde-fous cyber réduits sur certains modèles de classe Opus et Sonnet pour le travail de sécurité défensive. Anthropic indique que l'accès à la classe Mythos s'y ajoutera prochainement, ce qui relève de la promesse plutôt que d'une date. Les candidatures passent par le portail des programmes d'Anthropic.
Life Sciences Verification Program. Le LSVP est une bêta sur invitation uniquement, développée avec le gouvernement américain, qui assouplit les garde-fous de biologie pour la recherche et le développement professionnels tout en laissant tous les autres garde-fous en place. Les premiers participants sont inscrits, et Anthropic indique prévoir un élargissement à la communauté des sciences de la vie au sens large.
Les clients entreprise existants ont une troisième porte : la documentation indique de contacter votre équipe de compte Anthropic, AWS ou Google Cloud. Et Claude Security, le produit d'analyse de code d'Anthropic, tourne désormais sur Mythos 5.1, ce qui est le seul moyen d'utiliser le modèle sans y être directement invité.
La raison de tout cela se trouve dans l'annonce de Glasswing d'avril 2026. Mythos Preview a trouvé des milliers de vulnérabilités zero-day sur pratiquement tous les principaux systèmes d'exploitation et navigateurs, y compris un plantage à distance vieux de 27 ans dans OpenBSD et une faille vieille de 16 ans dans FFmpeg que les tests automatisés avaient rencontrée cinq millions de fois sans la détecter. Anthropic s'est engagé sur 100 M$ de crédits d'usage et 4 M$ de dons, et a réuni douze partenaires de lancement plus 40 organisations d'infrastructure supplémentaires, s'étendant à environ 150 organisations dans plus de quinze pays d'ici juin.
Côté sécurité, l'évaluation d'Anthropic elle-même est que Mythos 5.1 possède les capacités cyber les plus fortes de tous les modèles qu'elle ait publiés, reste dans la catégorie de risque la plus basse de son Frontier Compliance Framework, et n'atteint pas le palier de risque suivant de la Responsible Scaling Policy. Il est déployé avec les mêmes garde-fous de biologie que Mythos 5.
Trois changements qui vont casser l'intégration de quelqu'un
Cela vaut la peine de le signaler même si Mythos lui-même est hors de portée, car ces changements touchent aussi Fable 5.1.
- L'usage forcé d'outil renvoie une erreur. Si votre code fixe
tool_choicesuranyou sur un outil nommé, cet appel échoue désormais. C'est celui qui a le plus de chances de faire sonner l'alarme chez quelqu'un. - Les blocs de thinking sont liés au modèle qui les a produits. Les modèles antérieurs ne peuvent pas lire les blocs de thinking de Fable 5.1 ou Mythos 5.1, et modifier un tour antérieur les invalide.
- L'anti-distillation change l'édition multi-tours. Les nouveaux comptes API créés à partir du jour du lancement ne peuvent plus modifier manuellement le contexte antérieur de Claude tout en préservant la transcription de son thinking antérieur. Les comptes existants ne sont pas affectés pour l'instant, mais le changement s'appliquera à tout le monde lors des futures sorties de modèles.
Il y a aussi un changement de conformité à traîne longue. Pour se conformer au Code de bonnes pratiques sur la transparence des contenus générés par IA de l'AI Act européen, les modèles sortis après le 2 août 2026 portent un filigrane textuel, avec une API de détection en prévisualisation privée pour les régulateurs, chercheurs et entreprises assujetties. Anthropic indique qu'il est invisible sans l'API de détection et ne porte aucune information sur l'utilisateur ou ses conversations. C'est ce qui a suscité le plus de remous dans le fil de lancement, ce qui vaut la peine d'être su si votre pipeline de contenu a un avis sur la provenance. Mes notes sur le contenu IA et l'E-E-A-T couvrent le volet publication de ce sujet.
Que faire tourner à la place, selon la tâche
Presque tout le monde qui lit ceci choisit entre des modèles qu'il peut réellement appeler. Voici comment je répartirais les choses.
- Plafond de pointe, disponible aujourd'hui. Fable 5.1. Mêmes poids que Mythos 5.1, même prix, pas de liste d'attente. Contexte dans ce qu'est Claude Fable 5 et le relancement de Fable 5.
- Cheval de bataille par défaut. Opus 5 à 5 $ en entrée et 25 $ en sortie. La documentation d'Anthropic elle-même recommande toujours de commencer la plupart des charges de travail ici et de ne monter en gamme que lorsque vos évaluations ne suffisent plus. La revue d'Opus 5 contient mon verdict, et les tarifs d'Opus 5 les tableaux.
- Travail sensible à la latence. Sonnet 5 à 2 $ en entrée et 10 $ en sortie, avec la même fenêtre de 1M. Les tarifs de Sonnet 5 et la revue de Sonnet 5 approfondissent le sujet.
- Agents de codage. Le niveau d'effort influe plus sur votre facture que le niveau du modèle. La sélection de modèle de Claude Code et les tarifs de Claude Code sont les deux à lire.
- Orchestration longue durée. Claude Managed Agents facture le temps d'exécution de la session en plus des tokens, ce que la baisse de la lecture de cache ne touche pas.
- Peser l'ensemble du paysage. Les alternatives à Claude et les alternatives à Opus 5 si vous n'êtes pas lié à Anthropic, plus GPT-5.6 face à Claude pour le face-à-face.
Si la tâche concerne des conversations clients plutôt que du code ou de la recherche, la question du niveau est presque hors sujet. Mon comparatif du meilleur modèle pour les tickets de support parcourt le véritable arbitrage, et les modèles d'IA sur mesure explique quand entraîner le sien en vaut la peine.
Ce qu'un modèle de pointe ne règle pas sur une file de support
Je veux être prudent ici, car les résultats de Mythos 5.1 sont réels et la science est difficile à contester. Mais il y a un schéma d'échec que j'ai observé suffisamment de fois pour lui donner un nom.
Une équipe lit un article de lancement, met à niveau le modèle derrière son bot de support, et s'attend à ce que le taux de résolution bouge. Il ne bouge pas. Ce qui fait bouger le taux de résolution, c'est de savoir si le modèle peut voir les bonnes connaissances, s'il sait quand s'arrêter et transférer, et si quelqu'un l'a testé sur de vrais tickets avant qu'un client ne le voie. Aucun de ces éléments n'est un problème de niveau de modèle.
La moitié « confiance » de tout cela est celle qui coûte de l'argent. Comme l'a formulé une responsable CX d'une marque de compléments DTC lors d'un appel commercial :
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est un problème de périmètre et de contrôle, et un score de 60,9 % sur Terminal-Bench n'a rien à dire là-dessus. Pas plus que la voie du « construisons-le nous-mêmes », où atterrissent beaucoup d'équipes après un lancement comme celui-ci. Karel, chez GENERAL BYTES, a résumé l'arbitrage sans détour :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
La clé API est la partie bon marché. La récupération d'informations, les limites de permissions, les règles d'escalade, le dispositif d'évaluation, et la maintenance de ces quatre éléments à mesure que votre produit évolue sont la partie coûteuse. Ce travail ne devient pas moins cher parce que les lectures de cache le sont devenues.
Où eesel s'inscrit
eesel vend des coéquipiers IA, pas un modèle. Le coéquipier IA pour helpdesk rejoint la file que vous exploitez déjà, lit le centre d'aide et les tickets passés que vous possédez déjà, et répond dans le périmètre que vous définissez. Le rédacteur de blog IA fait le même travail pour le contenu. Les deux arrivent avec les intégrations et le contexte d'entreprise propres à leur rôle, exactement la couche qu'un modèle de pointe brut n'apporte pas.

La chose précise que je soulignerais, compte tenu du sujet de cet article : avant qu'un coéquipier eesel ne réponde à un seul client réel, il s'exécute sur vos propres tickets historiques pour que vous puissiez voir ce qu'il aurait répondu. C'est l'essai à blanc que personne n'obtient d'un lancement de modèle, et c'est la différence entre livrer une mise à niveau et livrer une supposition. Il se connecte à Zendesk, Freshdesk, Gorgias, Front, Help Scout et HubSpot en quelques minutes, et l'essai est gratuit.
Courir après Mythos 5.1 pour une file de support revient à optimiser la seule variable qui n'a jamais été la contrainte. Connecter Claude à votre helpdesk est un après-midi plus utile, et utiliser Claude pour le support est la version honnête de ce que cela vous apporte.
Mon verdict sur Claude Mythos 5.1
C'est le modèle le plus performant qu'Anthropic ait livré, il ne vous est pas accessible, et la version qui vous est accessible est le même modèle. C'est une chose inhabituelle à pouvoir écrire, et c'est le fait le plus utile de tout cet article.
Si vous êtes cyberdéfenseur ou chercheur en sciences de la vie, postulez, car les résultats scientifiques justifient les démarches administratives. Si vous êtes quelqu'un d'autre, le lancement qui compte est le prix de la lecture de cache de Fable 5.1, qui a discrètement rendu le travail agentique gourmand en contexte environ 45 % moins cher. Cela changera plus de systèmes en production ce trimestre qu'un modèle verrouillé ne le fera jamais.
Questions fréquentes
Qu'est-ce que Claude Mythos 5.1 ?
claude-mythos-5-1. C'est le même modèle sous-jacent que Fable 5.1, livré avec des garde-fous de cybersécurité et de biologie plus souples, et il n'est proposé que sur invitation via Project Glasswing. L'article précédent sur Claude Mythos explique comment la famille a commencé.Combien coûte Claude Mythos 5.1 ?
Quelle est la différence entre Claude Mythos 5.1 et Claude Fable 5.1 ?
Claude Mythos 5.1 est-il disponible sur Bedrock ou Google Cloud ?
claude-mythos-5-1 partout. Être présent sur la plateforme n'équivaut pas à pouvoir l'appeler, puisque l'invitation reste nécessaire.Que devrais-je utiliser à la place de Claude Mythos 5.1 ?
Claude Mythos 5.1 dispose-t-il d'une fenêtre de contexte de 1M ?
high. Anthropic facture toute la fenêtre au tarif standard, donc une requête de 900 000 tokens coûte le même prix par token qu'une requête de 9 000 tokens. La taille de la fenêtre de contexte de Claude Code explique ce que cela signifie au quotidien.Est-il sûr de pointer Claude Mythos 5.1 vers des données clients ?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.







Comment obtenir l'accès à Claude Mythos 5.1 ?