
Ce qu'est vraiment Claude Sonnet 5.5
Claude Sonnet 5.5 est le modèle de milieu de gamme d'Anthropic et la deuxième sortie de la famille Claude 5.5, six jours après Opus 5.5. Anthropic le présente comme "a faster, lower-cost complement" d'Opus : Opus reste réservé au travail complexe qui demande un jugement soigneux, et Sonnet prend les tâches courantes bien délimitées. Un Haiku 5.5 est également promis "in the coming weeks".
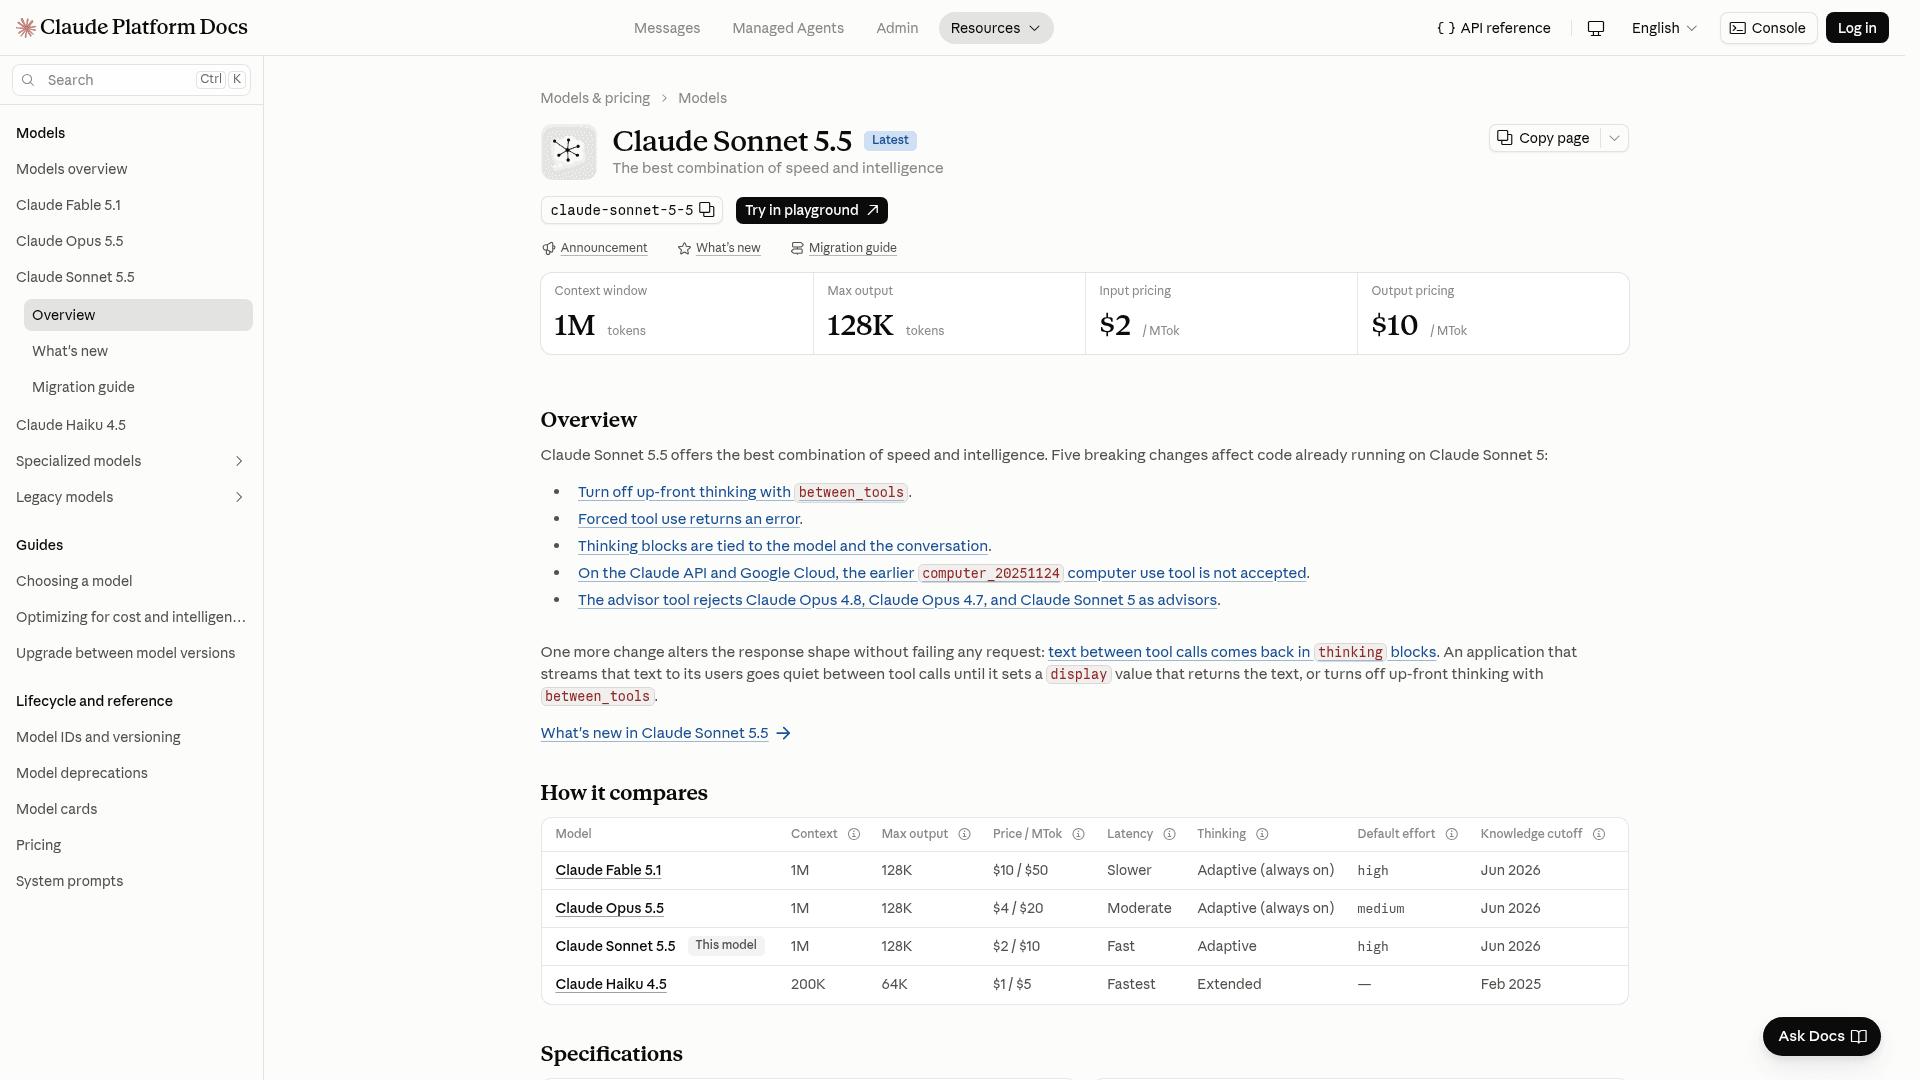
Voici les spécifications, telles qu'indiquées sur la page de présentation du modèle :
- L'ID du modèle est
claude-sonnet-5-5sur la Claude API, Google Cloud, Microsoft Foundry et Claude Platform on AWS, etanthropic.claude-sonnet-5-5sur Amazon Bedrock. - Le contexte est de 1M de tokens en entrée et 128K en sortie, ou 300K en sortie sur la Batch API avec un en-tête bêta.
- La date limite de connaissances fiable est juin 2026, la même que pour Opus 5.5 et Fable 5.1.
- Le thinking est adaptatif, et l'effort par défaut est
highsur l'API, mais Medium dans les apps Claude et dans Claude Code. - Le retrait est prévu "not sooner than September 28, 2027", ce qui vous laisse au moins un an avant de devoir migrer de nouveau.
Le tokenizer est le même que celui de Claude Sonnet 5, d'après la page des nouveautés, ce qui signifie que le même texte donne le même nombre de tokens. Ce détail compte plus qu'il n'y paraît : toutes les économies annoncées par Anthropic viennent du fait que le modèle écrit moins, et non d'une façon plus avantageuse de compter.
La vraie histoire : même prix, facture plus petite
Sur le prix affiché, rien n'a bougé. Sonnet 5.5 coûte exactement ce que coûte Sonnet 5 : 2 $ en entrée, 10 $ en sortie, 0,20 $ pour les lectures de cache. Ce qui a changé, c'est le nombre de tokens qu'il dépense pour terminer un travail.
Les chiffres d'accès anticipé du billet de lancement sont précis d'une façon qu'on voit rarement :
- Balyasny Asset Management a exécuté 2 441 tâches financières et a vu Sonnet 5.5 utiliser environ 121k tokens par réponse là où Sonnet 5 en utilisait 497k, avec un meilleur score.
- Slack a constaté de meilleurs résultats sur "almost all" ses évaluations hors ligne de Slackbot "with about 14% fewer output tokens", et cela sans changer aucun prompt.
- Base44 terminait les builds d'apps en 3,6 itérations en moyenne, là où Opus 5 en demandait 7,7.
- Lovable a mesuré "a third fewer tool calls and roughly half the shell runs to finish a task".
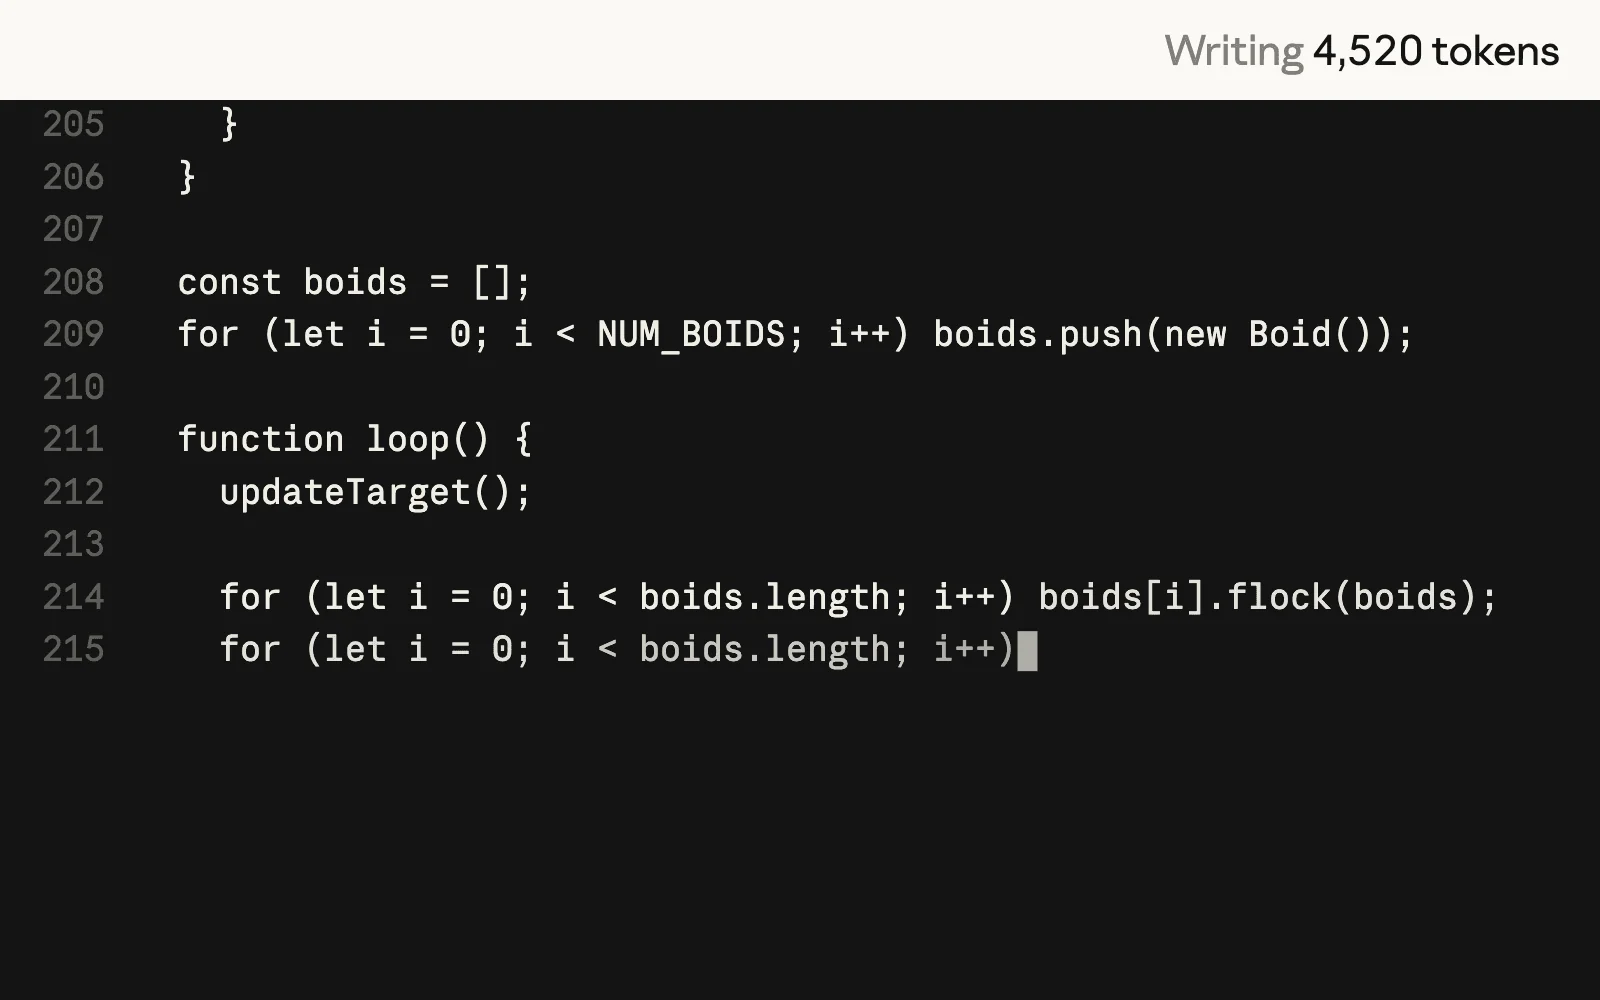
La comparaison côte à côte d'Anthropic elle-même dit la même chose, de façon visuelle. Quand on a demandé aux deux de construire une nuée de 400 étourneaux dans un seul fichier HTML, Sonnet 5 écrivait encore du code à 4 520 tokens :
Sonnet 5.5 avait déjà terminé à 4 158 tokens, et à ce stade sa nuée volait depuis 12,5 secondes :
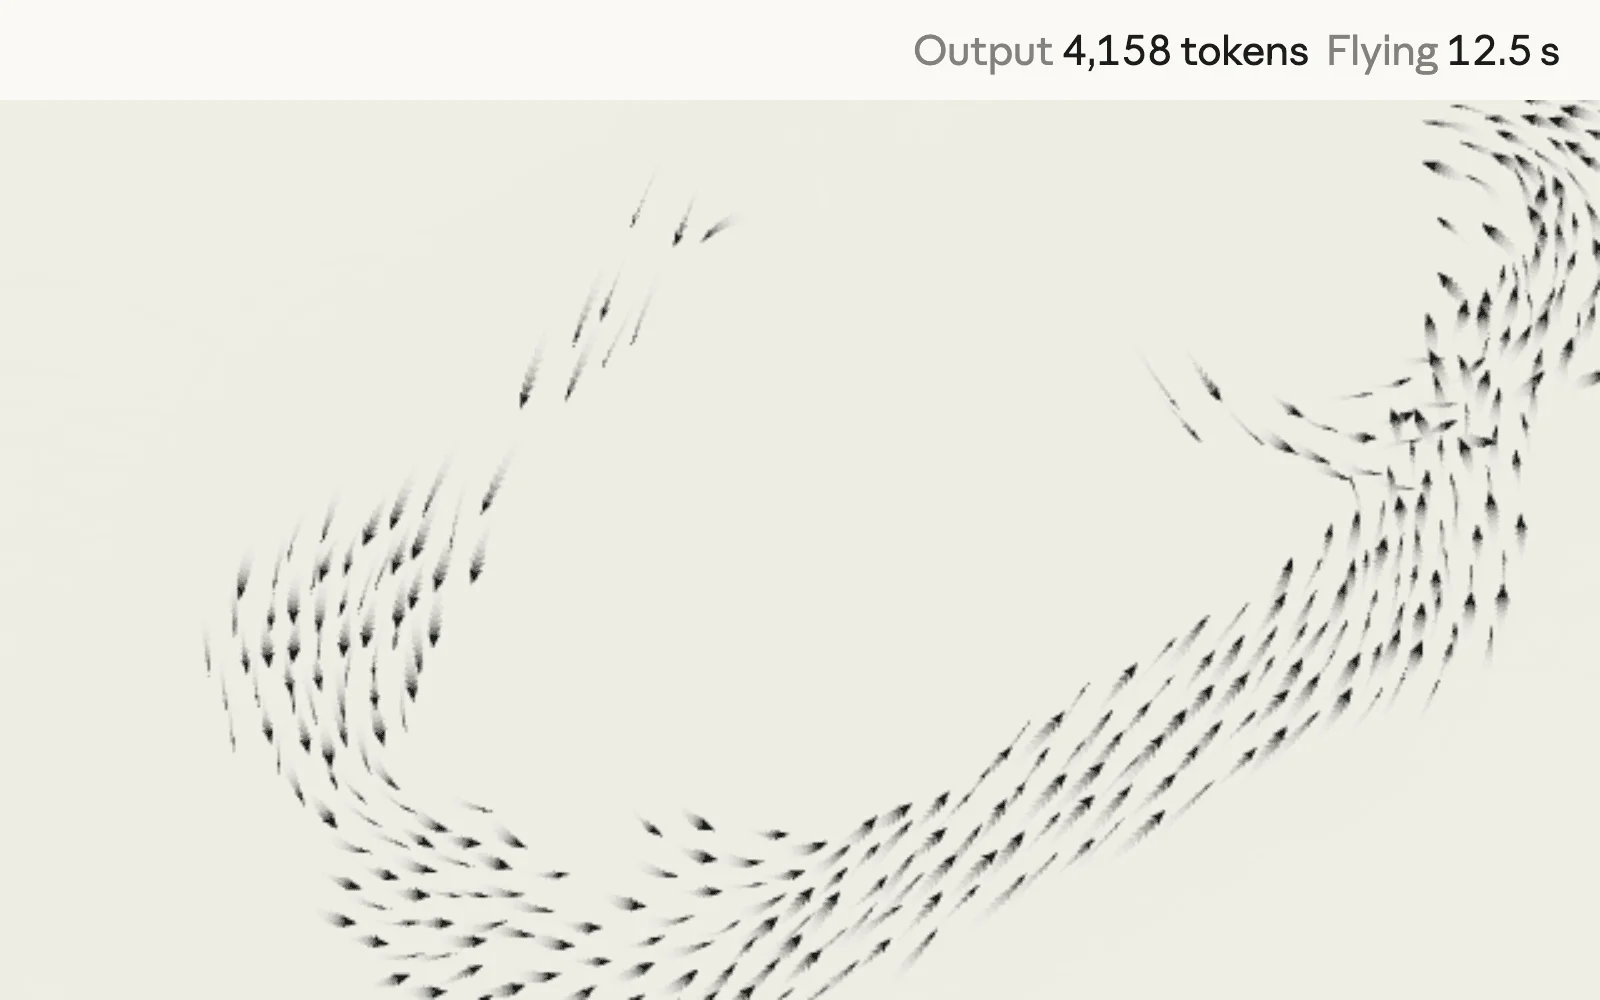
L'écart entre les clients est là où se trouve la lecture honnête. La baisse de 4x de tokens chez Balyasny et la réduction de 14 % chez Slack sont toutes deux réelles, ce qui montre que l'économie dépend beaucoup de la verbosité de vos exécutions Sonnet 5 au départ. Le titre d'Anthropic dit "up to 30% less per task", et le "up to" fait beaucoup de travail dans cette phrase. Sonnet 5 avait une habitude connue de s'étendre : lors des tests d'Artificial Analysis, il a pris 183 tours par tâche à effort max, le pire du graphique. Si votre charge de travail en était là, attendez-vous au gros chiffre, et si vos prompts gardaient déjà les réponses courtes, attendez-vous à quelque chose de plus proche de Slack.
À quel point il se rapproche d'Opus 5.5
Pour qui paie au prix d'Opus, c'est ici que la sortie devient intéressante. Sur le tableau de benchmarks du lancement d'Anthropic, Sonnet 5.5 comble l'essentiel de l'écart avec un modèle qui coûte deux fois plus cher par token.
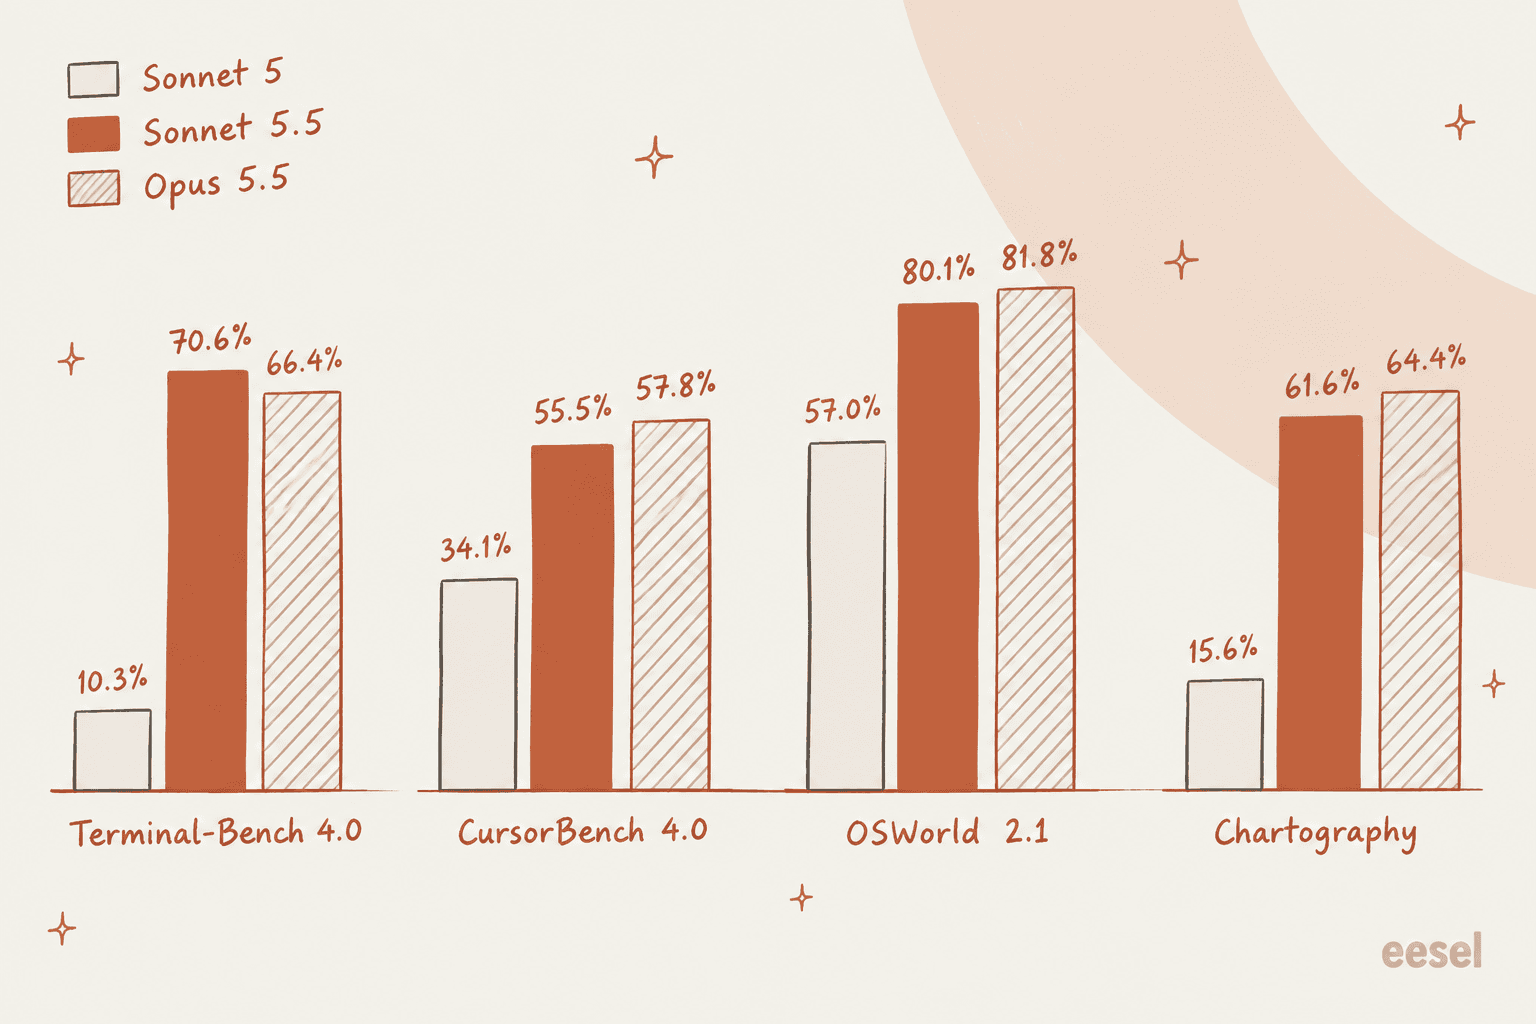
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (programmation agentique) | 70.6% | 10.3% | 66.4% | non communiqué |
| FrontierCode 1.1 (code prêt à fusionner) | 52.1% (Xhigh) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | non communiqué |
| GDPval-AA v2.1 (travail intellectuel, Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (travail de longue haleine, Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (avec outils) | 64.5% | 54.9% | 67.7% | non communiqué |
| OSWorld 2.1 (utilisation de l'ordinateur) | 80.1% | 57.0% | 81.8% | non communiqué |
| Chartography (lecture de graphiques) | 61.6% | 15.6% | 64.4% | 53.6% |
Plusieurs choses ressortent. D'abord, le bond sur Terminal-Bench de 10,3 % à 70,6 % est énorme, et sur celui-ci Sonnet 5.5 bat en fait Opus 5.5. GDPval-AA, un test de travail réel sur 44 métiers, le place à deux points Elo d'Opus 5.5 et environ 400 devant Sonnet 5. Ensuite, face à GPT-6 Sol, le rival qu'Anthropic a choisi de représenter, Sonnet 5.5 à son meilleur niveau d'effort mène sur chaque ligne où le modèle d'OpenAI a un score, et à effort High il égale le meilleur résultat FrontierCode de GPT-6 Sol pour environ un cinquième du coût par tâche.
J'apprécie qu'Anthropic soit franche sur la limite. Le billet de lancement dit que "in our own testing, and in that of external testers, Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment". Les benchmarks ont tendance à récompenser les tâches avec une bonne réponse claire. Les décisions ouvertes, comme déterminer si un client entreprise en colère a besoin d'un remboursement, d'excuses ou peut-être d'une escalade, sont exactement là où le surcoût d'Opus se justifie encore. La comparaison Opus 5.5 vs GPT-6 Sol approfondit ce niveau supérieur.
Une note de plus qui mérite d'être lue : les scores FrontierCode baissent à effort Max (46.2%) par rapport à Xhigh (52.1%). L'explication d'Anthropic est qu'à Max, Sonnet 5.5 répartissait plus souvent la revue de code entre des sous-agents, ce qui causait des timeouts ou des modifications dépassant le périmètre de la tâche. Réfléchir plus n'est pas toujours mieux, un schéma que le guide d'effort d'Opus 5 avait aussi constaté.
Ce que Sonnet 5.5 signifie pour les équipes de support
Si je devais mettre une seule citation du billet de lancement devant un responsable de support, ce serait celle-ci. Le Director of AI de Zendesk a testé le modèle sur des tickets réels :
"We fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions and resolved tickets faster than the Claude models we use in production today. Tickets were processed 20% faster, getting our customers the help they need without the wait."
Abhinay Kathuria, Director of AI chez Zendesk, dans l'annonce d'Anthropic
"Fewer wrong decisions" est la partie qui compte ici. La vitesse est appréciable, mais dans une file de support, une réponse rapide et fausse coûte plus cher qu'une réponse lente et juste : elle crée un second ticket et un suivi agacé, et parfois un remboursement en plus. Zendesk AI fait déjà tourner des modèles Claude en production, donc quand il revendique de meilleures décisions d'escalade par rapport à sa configuration actuelle, cela pèse réellement. Atlassian a fait une remarque connexe sur l'échelle, en disant que les équipes exécuteront leurs agents Rovo "up to 30% faster than they could with Sonnet 5", et Slack AI le teste déjà pour Slackbot.
Vu du côté de la file, voici comment je ferais correspondre la gamme Claude aux tâches de support :
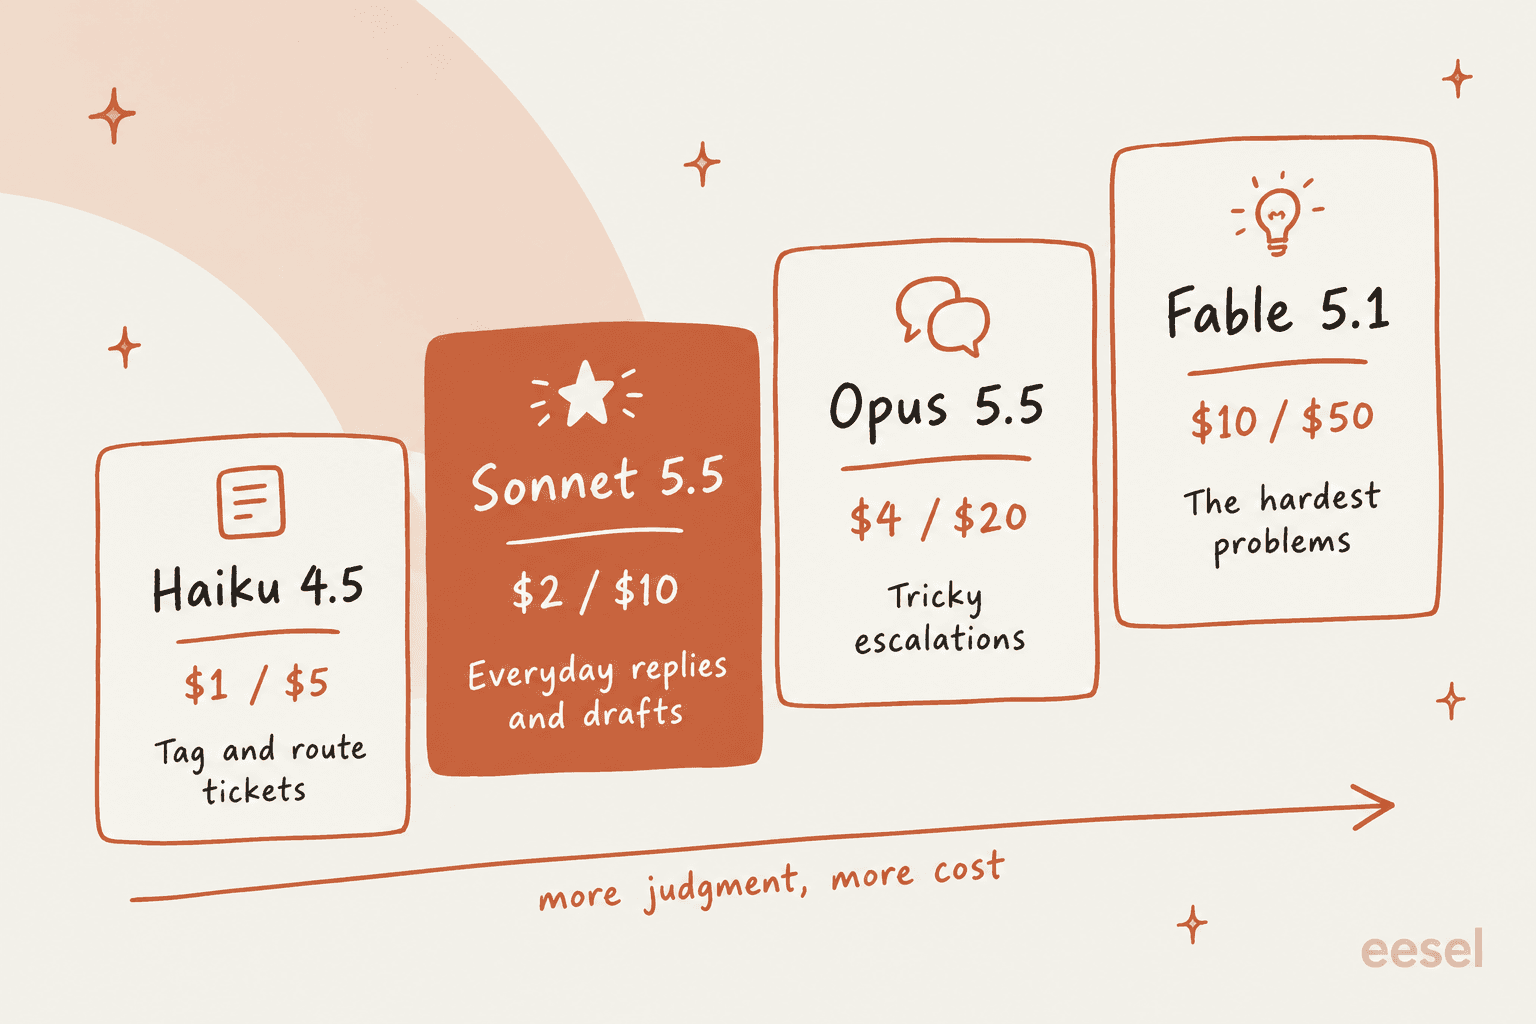
Sonnet 5.5 est le choix par défaut naturel pour l'essentiel d'une file : questions sur les commandes, réponses pratiques, consultations de politiques et premiers brouillons à faire valider par un agent. Haiku reste le choix économique pour le tri des tickets et l'étiquetage. Opus 5.5 est celui vers lequel j'enverrais les tickets qui demandent du jugement, ceux que vos agents seniors prendraient de toute façon. Là où le gain de vitesse de plus de 30 % compte le plus, c'est le chat en direct, car un client y regarde l'indicateur de saisie.
La réserve honnête : un meilleur modèle ne corrige pas une réponse manquante. J'ai vu un bot de support affirmer avec assurance à un client qu'un produit était pris en charge parce que le centre d'aide disait "we support all models", et j'en ai vu un autre inventer des réponses quand la recherche revenait vide. Aucun des deux n'était un problème de qualité du modèle. Les deux étaient des problèmes d'ancrage, et un modèle plus intelligent peut même rendre une réponse fausse et assurée encore plus convaincante. C'est pourquoi eesel simule chaque déploiement sur des tickets historiques avant qu'une IA ne réponde à qui que ce soit, quel que soit le modèle en dessous.
Avant de migrer : cinq choses qui renvoient désormais des erreurs
La plupart des articles sur le lancement passeront cette section sous silence, et c'est celle qui vous prendra votre après-midi. Passer de claude-sonnet-5 à claude-sonnet-5-5 tient en une ligne. Derrière, la page des nouveautés liste cinq changements qui cassent la compatibilité, et une règle de plus appartient à la même liste de contrôle.
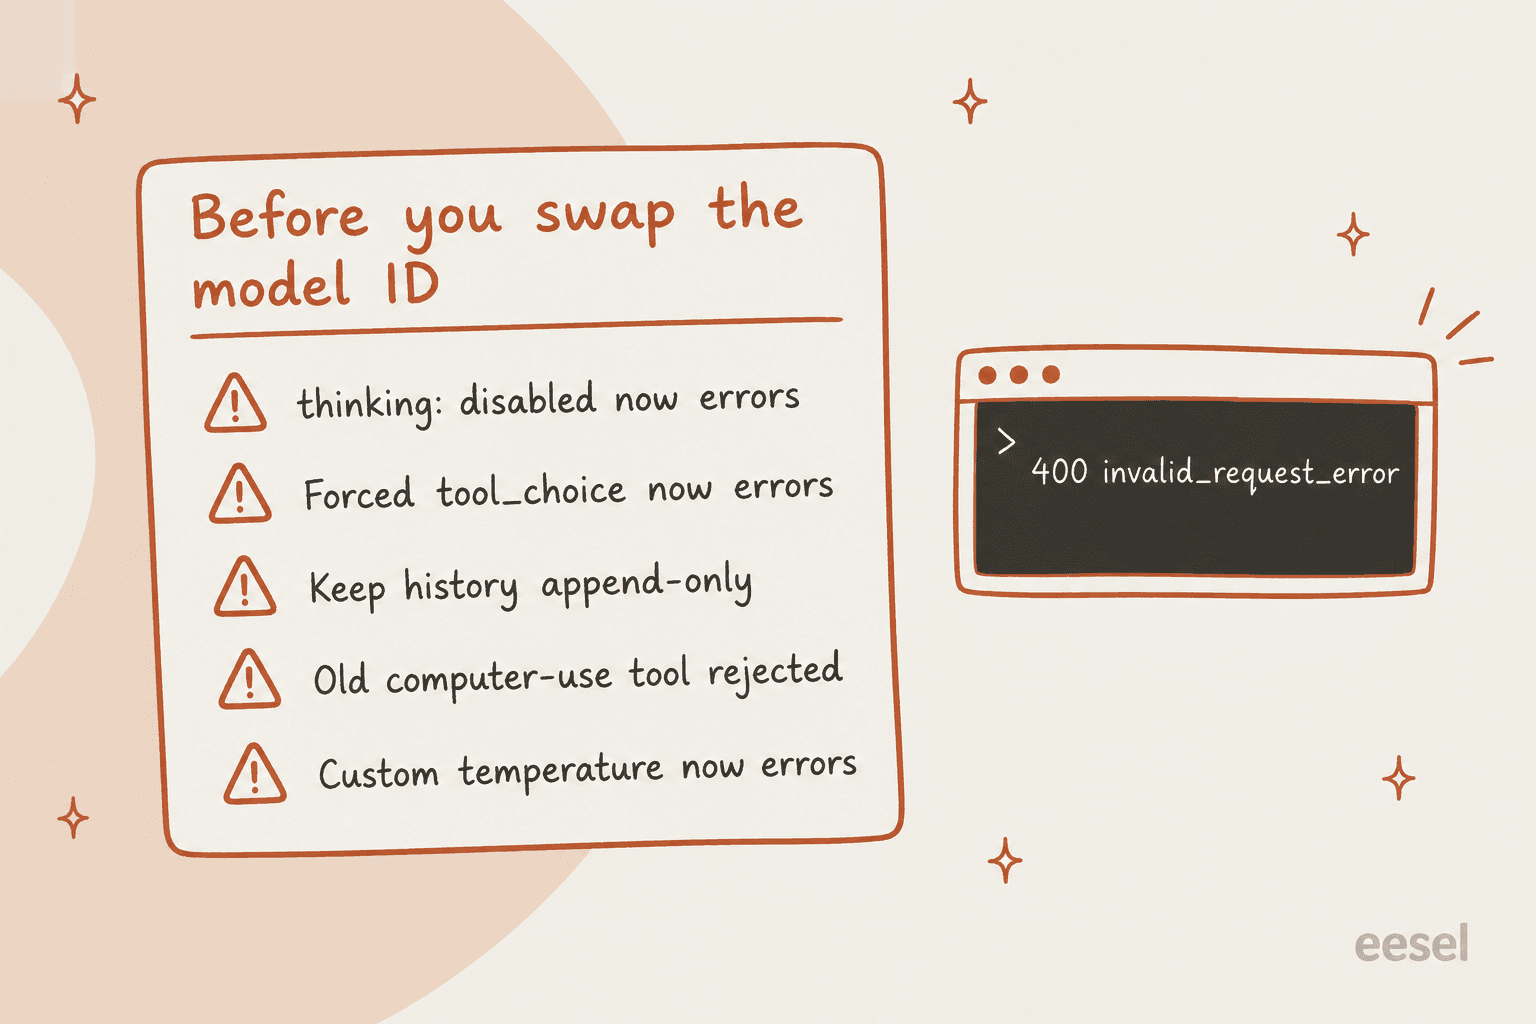
thinking: disabledrenvoie un 400. Envoyez plutôtthinking: {"type": "between_tools"}, qui désactive le thinking initial. Cela ne fonctionne qu'à l'efforthighou en dessous ; àxhighoumax, cela renvoie aussi une erreur.- L'utilisation forcée d'outils a disparu.
tool_choiceréglé suranyou sur untoolnommé renvoie une erreur. La solution estautoplus l'utilisation stricte d'outils. - Les blocs de thinking sont liés au modèle et au compte. Si vous modifiez des messages précédents, le prompt système ou les outils, puis rejouez un bloc de thinking de Sonnet 5.5, les comptes récents reçoivent un 400. Gardez donc les conversations en ajout seul.
- L'ancien outil
computer_20251124est rejeté sur la Claude API et Google Cloud. Bedrock l'accepte encore. - Certains appariements avec advisor sont rejetés. Opus 4.8, Opus 4.7 et Sonnet 5 ne peuvent plus conseiller un exécuteur Sonnet 5.5.
À propos de cette règle supplémentaire, la documentation indique que définir temperature, top_p ou top_k à une valeur non par défaut renvoie un 400 sur ce modèle.
Le piège du support est le numéro deux. De nombreux bots de helpdesk forcent un appel d'outil pour garantir une sortie structurée : "always call classify_ticket", "always call draft_reply". Sur Sonnet 5.5, cette requête échoue tout simplement. Si vous avez construit votre propre intégration sur l'API Anthropic, cherchez d'abord tool_choice avec grep, avant de toucher à l'ID du modèle.
Il y a aussi un changement plus discret, qui ne génère pas d'erreur mais déroutera quand même les utilisateurs. Le texte que le modèle écrit entre les appels d'outils revient désormais dans des blocs thinking, et avec la valeur par défaut display: "omitted", ce texte est vide. Si votre widget de chat diffuse "Checking your order status..." pendant que l'agent travaille, il restera muet tant que vous ne définirez pas une valeur de display. Anthropic a aussi recalibré les niveaux d'effort, alors relancez vos tests d'effort plutôt que de reprendre les réglages de Sonnet 5. Le guide du transfert d'agent IA vaut la lecture si un changement de modèle modifie le moment où votre bot escalade.
Enfin, la sécurité. Sonnet 5.5 est le premier Sonnet à sortir avec des garde-fous cyber, parce que ses capacités cyber sont comparables à celles d'Opus 5. Les demandes de cybersécurité à plus haut risque "visibly fall back to Sonnet 5", et une demande refusée renvoie HTTP 200 avec stop_reason: "refusal". Pour un bot de support, cela se déclenchera rarement. Mais si vous servez des clients en sécurité ou en informatique, mieux vaut gérer le cas du refus plutôt que d'afficher une réponse vide.
Prix et accès de Claude Sonnet 5.5
Voici la grille tarifaire complète de la documentation des prix d'Anthropic, par million de tokens :
| Prix par 1M de tokens | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | Claude Haiku 4.5 |
|---|---|---|---|---|
| Entrée | $2 | $2 | $4 | $1 |
| Sortie | $10 | $10 | $20 | $5 |
| Écriture en cache de 5 minutes | $2.50 | $2.50 | $5 | $1.25 |
| Écriture en cache de 1 heure | $4 | $4 | $8 | $2 |
| Lecture de cache | $0.20 | $0.20 | $0.20 | $0.10 |
| Entrée / sortie en Batch | $1 / $5 | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Fenêtre de contexte | 1M | 1M | 1M | 200K |
Quelques remarques sur ce tableau. Le thinking est facturé comme des tokens de sortie, donc une exécution à effort high paie aussi 10 $ par million pour son raisonnement. Et le prompt minimal pouvant être mis en cache est désormais de 512 tokens, d'après la présentation du modèle, ce qui facilite la mise en cache d'un prompt système de support stable.
Pour traduire ces tarifs en termes de support, voici un calcul illustratif qui n'utilise que les prix publiés. Supposons qu'une réponse de ticket envoie 6 000 tokens d'entrée (le ticket plus les articles d'aide récupérés) et reçoit 800 tokens de sortie. Cela fait 0,012 $ en entrée et 0,008 $ en sortie, soit environ 2 cents par ticket. Si 5 000 de ces tokens d'entrée sont un prompt système en cache, le côté entrée tombe à environ 0,003 $ et la réponse entière avoisine 1,1 cent. À 10 000 tickets par mois, cela fait environ 200 $ sans cache contre 110 $ avec cache, avant les tokens de thinking. Vos propres chiffres varieront selon l'effort et la taille de la récupération, mais cela montre pourquoi la ligne du modèle sur la facture est rarement le gros poste de coût d'un agent de support IA.
Voici où vous pouvez l'utiliser :
- La Claude API, sous
claude-sonnet-5-5, avec prompt caching et la Batch API. La rétention zéro des données est disponible. - Les apps Claude. Anthropic dit "anyone can chat with Claude using Sonnet 5.5 on Claude.ai" sur le web, iOS et Android. Les offres payantes sont couvertes dans le guide des tarifs de Claude Pro.
- Claude Code, où l'effort par défaut est Medium. Le guide des tarifs de Claude Code couvre le calcul abonnement contre API, et fixer un modèle demande un seul réglage.
- Les clouds : Amazon Bedrock, Google Cloud, Microsoft Foundry et Claude Platform on AWS, tous dès le premier jour.
Si ce que vous comparez, ce sont des fournisseurs plutôt que des niveaux, la comparaison de trois API et le détail des tarifs de GPT-6 Sol sont les vérifications les plus rapides.
Ce que disent les développeurs
Le fil du lancement sur Hacker News a dépassé 550 commentaires en un jour, et la réaction se répartit assez nettement. Les gens aiment la vitesse et respectent les benchmarks, tandis que les critiques portent surtout sur sa place par rapport à Opus 5.5.
"Playing around with it for a few minutes, Sonnet 5.5 feels very fast, much quicker than Opus 5.5. Can't tell yet if it's a lot worse but the speed is definitely welcome."

La critique la plus acérée concerne les niveaux d'effort élevés. Simon Willison a mesuré son test SVG habituel à chaque niveau d'effort et a trouvé low à 1,6 cent, medium à 1,8 cent et high à 2,3 cents, mais max a épuisé tout son budget de thinking :
"Sonnet 5.5 has the same problem as Opus 5.5: on "max" thinking effort it burned through 128,000 thinking tokens (taking 15 minutes to do that) and ran out before it had produced the final SVG."
Un utilisateur de Reddit a tiré le même schéma d'Artificial Analysis, en indiquant que "sonnet 5.5 max has a cost per task of $7.60 while opus 5.5 max has $5.98", Sonnet utilisant 193k tokens par tâche contre 119k pour Opus (u/ex-procrastinator, Reddit). Un autre commentateur a résumé ce que suggèrent les graphiques :
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost."
Anthropic dit à peu près la même chose dans son propre billet de lancement : Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings", et "at higher settings, it can perform comparably at a similar cost". La conclusion pratique, et ce que je dirais à toute équipe qui change de modèle, est donc la suivante : faites tourner Sonnet 5.5 à effort Low ou Medium, là où se trouvent vraiment les économies. L'API utilise high par défaut, donc la version économique de ce modèle est une version qu'il faut demander. Les réponses de support sont exactement le genre de travail bien délimité que Medium gère bien.
Il y a une régression à connaître. Un développeur qui exécute un benchmark adversarial a constaté que Sonnet 5.5 obtenait un score inférieur à Sonnet 5 "mainly because it is more reluctant to keep going to get an answer, instead it returns to ask the user questions" (dom96, Hacker News). Pour un agent de programmation, c'est agaçant, mais pour un bot de support, s'arrêter pour vérifier plutôt que deviner est souvent exactement ce que l'on veut.
Un modèle plus rapide a toujours besoin d'un coéquipier autour
Chaque sortie de modèle relance la même conversation avec les clients techniques : c'est désormais bon marché et suffisamment bon, alors pourquoi ne pas construire notre propre bot de support sur l'API brute ? C'est une question légitime, et Sonnet 5.5 rend la moitié modèle plus simple que jamais.
Ce que la grille tarifaire omet, c'est tout ce qui entoure le modèle. Sonnet 5.5 est un excellent moteur. Ce n'est pas un agent de support tant que quelqu'un n'a pas construit la récupération sur votre centre d'aide et vos anciens tickets, plus les règles d'escalade et la gestion des refus, le réglage de l'effort, et maintenant aussi le travail de migration pour cinq changements qui cassent la compatibilité. Le modèle est l'infrastructure, et l'employé est ce que vous construisez par-dessus.
eesel vend cette partie déjà construite. Son coéquipier de helpdesk IA rejoint votre file existante dans Zendesk, Freshdesk, Gorgias et d'autres. Il apprend de vos anciens tickets et de votre centre d'aide, puis rédige ou envoie des réponses, avec un modèle de pointe en dessous. Quand Anthropic sort un modèle comme celui-ci, le changement et les modifications incompatibles sont le problème d'eesel, pas le vôtre.

Si vous voulez un contrôle programmatique, eesel dispose d'une CLI qui pilote le même coéquipier et le même espace de travail que le tableau de bord. Vous pouvez la piloter depuis un terminal ou la scripter, et vous pouvez aussi laisser un agent de programmation comme Claude Code l'exécuter, ce qui vous donne le flux de travail agentique que les gens construisent sur des modèles bruts sans avoir à posséder la pile d'ancrage et de nouvelles tentatives. Mes articles sur la CLI d'agents IA et les serveurs MCP montrent comment tout cela s'articule.
La tarification repose sur des crédits mensuels fixes : un ticket ou un chat traité vaut un crédit, l'offre gratuite inclut 100 crédits sans carte, et les offres payantes commencent à 299 $ pour 500. Vous pouvez simuler le coéquipier sur vos propres tickets historiques avant qu'il ne réponde à un seul client. Essayez eesel gratuitement sur votre file Zendesk et constatez le gain de vitesse de classe Sonnet sur des tickets dont vous connaissez déjà les réponses.
Claude Sonnet 5.5 en vaut-il la peine ?
Si vous utilisez Sonnet 5 aujourd'hui, oui, et c'est l'une des mises à niveau les plus faciles qu'Anthropic ait livrées. Vous payez le même tarif pour un modèle qui obtient de bien meilleurs scores et termine avec moins de tokens, et il tourne aussi plus vite. Le seul vrai coût est le travail de migration, et c'est une liste connue de cinq points, pas un mystère.
Si vous utilisez Opus 5.5 pour le travail courant, testez Sonnet 5.5 sur votre propre trafic à effort Medium avant de renouveler cette habitude. Pour les tâches bien délimitées, l'écart de benchmark est de quelques points et l'écart de prix par token est de 2x. Au-delà de l'effort high, cet avantage disparaît, donc si une tâche demande un raisonnement maximal, envoyez-la à Opus. Gardez Opus pour les décisions de jugement ouvertes où Anthropic elle-même dit qu'il reste nettement plus fort. Un commentateur de Hacker News a décrit un schéma, "80% Sonnet 5.5, Opus 5.5 to finish the last 20%", et c'est aussi une façon sensée de répartir une file. Pour le reste du paysage, mon test de Sonnet 5 et le tour d'horizon des alternatives à Opus 5.5 sont les lectures suivantes.
Questions fréquentes
Qu'est-ce que Claude Sonnet 5.5 ?
Combien coûte Claude Sonnet 5.5 ?
Claude Sonnet 5.5 est-il moins cher que Sonnet 5 ?
Claude Sonnet 5.5 est-il meilleur qu'Opus 5.5 ?
Claude Sonnet 5.5 convient-il au support client ?
Qu'est-ce qui casse quand je passe de Sonnet 5 à Sonnet 5.5 ?
Puis-je utiliser Claude Sonnet 5.5 dans Claude Code ?
Quelles sont les meilleures alternatives à Claude Sonnet 5.5 ?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.