Ce qu'est réellement Claude Opus 5.5
Anthropic a lancé Claude Opus 5.5 le 22 septembre 2026, et on le comprend mieux comme une mise à jour d'efficacité d'Opus 5 que comme un modèle entièrement nouveau. Le fait marquant, c'est le renversement : chaque Opus précédent avait été lancé à prix premium, et c'est le premier à être lancé moins cher que le modèle qu'il remplace.
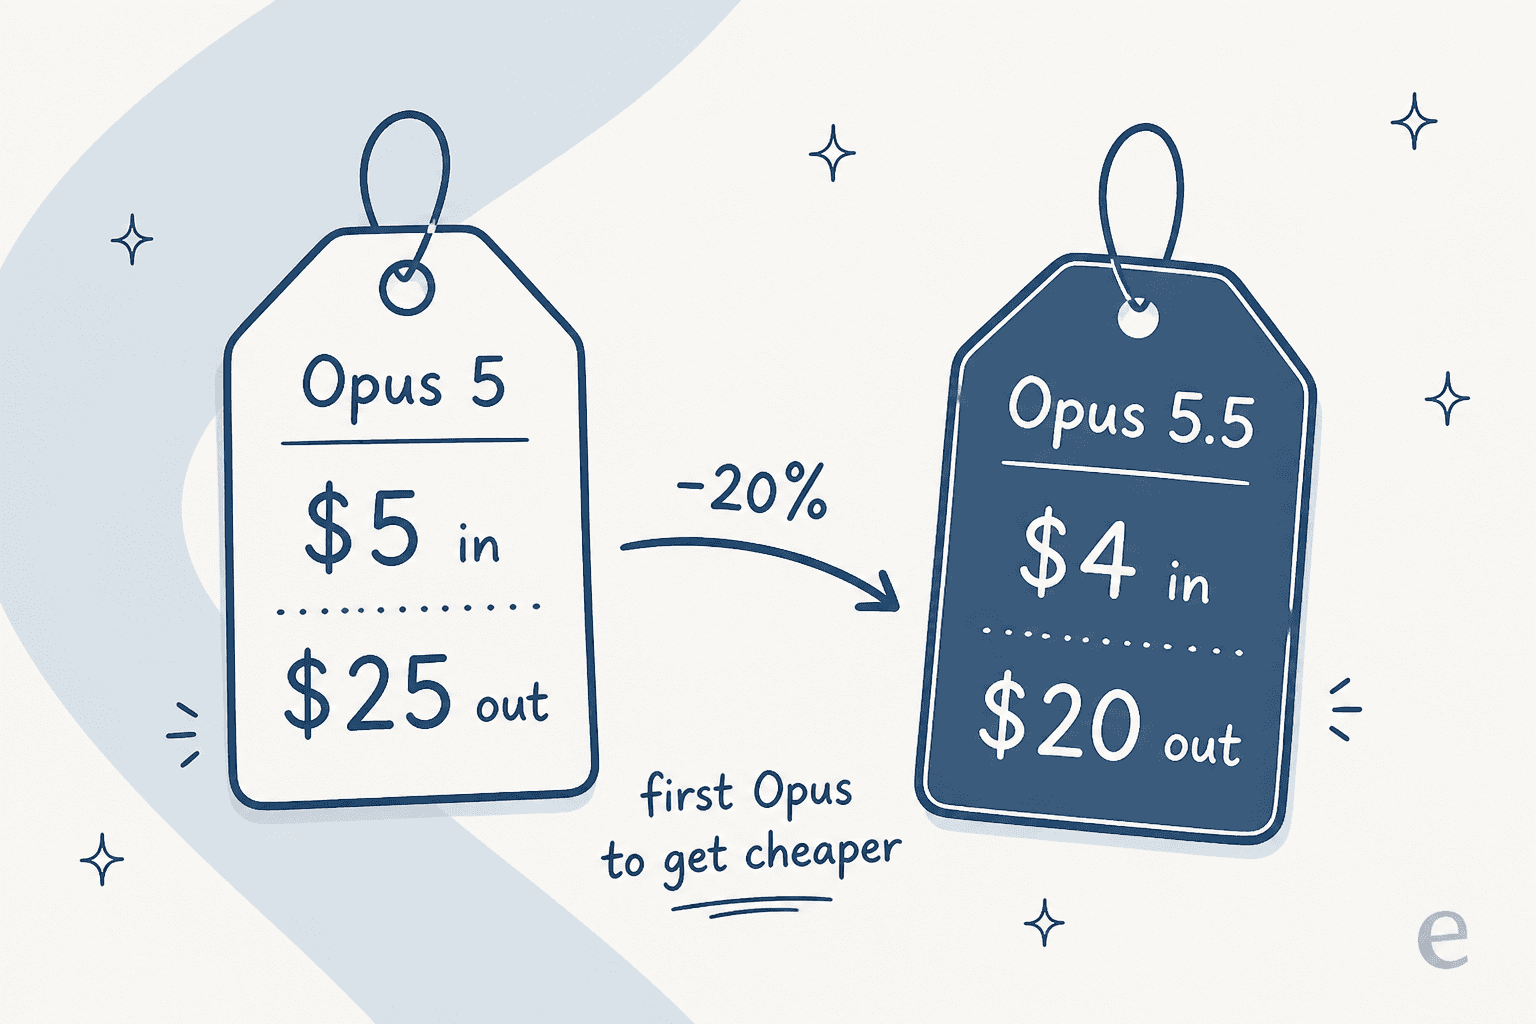
Le prix est passé des $5/$25 d'Opus 5 à $4/$20 par million de tokens, une baisse uniforme de 20%. Cela paraît minime jusqu'à ce qu'on se rappelle à quoi Opus sert habituellement : un travail long, gourmand en tokens et autonome, où le côté sortie de la facture domine. Une baisse de 20% sur le tarif de sortie de $20 est là où la plupart des équipes le ressentent.
Plusieurs choses ont changé sous le capot en même temps que le prix. L'effort par défaut est passé de high à medium, le thinking est toujours activé, et Anthropic recommande désormais de commencer avec Opus 5.5 pour la plupart des tâches plutôt que de traiter Opus comme le niveau premium de dernier recours. Il dispose d'une fenêtre de contexte d'1M de tokens, jusqu'à 128K tokens en sortie (300K en Batch), d'une vision native et d'une date de coupure des connaissances de juin 2026. C'est le modèle par défaut sur Claude Max, le plus puissant sur Claude Pro, et c'est lui qui fait tourner Claude Code pour le codage agentique.
Le curseur d'effort, c'est tout le test
Je construis des agents IA chez eesel, donc chaque lancement de modèle de pointe implique le même rituel : relancer mes évaluations, regarder le coût par tâche terminée, décider ce qui change. Ce qui m'a le plus surpris avec Opus 5.5, ce n'est pas la qualité, c'est à quel point le réglage d'effort domine tout le reste dans son utilisation.
Voici le mécanisme. Opus 5.5 expose un contrôle d'effort à cinq niveaux : low, medium (le nouveau défaut), high, very high et max. Un effort plus élevé ne fait pas simplement « essayer plus fort » de façon vague ; il fait raisonner le modèle plus longtemps et produire beaucoup plus de tokens avant de répondre. À effort maximal sur une tâche difficile, il a consommé environ 119k tokens en sortie, contre une exécution bien plus légère à effort faible. Comme la sortie est facturée $20 le million, le curseur d'effort est en réalité un curseur de coût déguisé en étiquette de qualité.
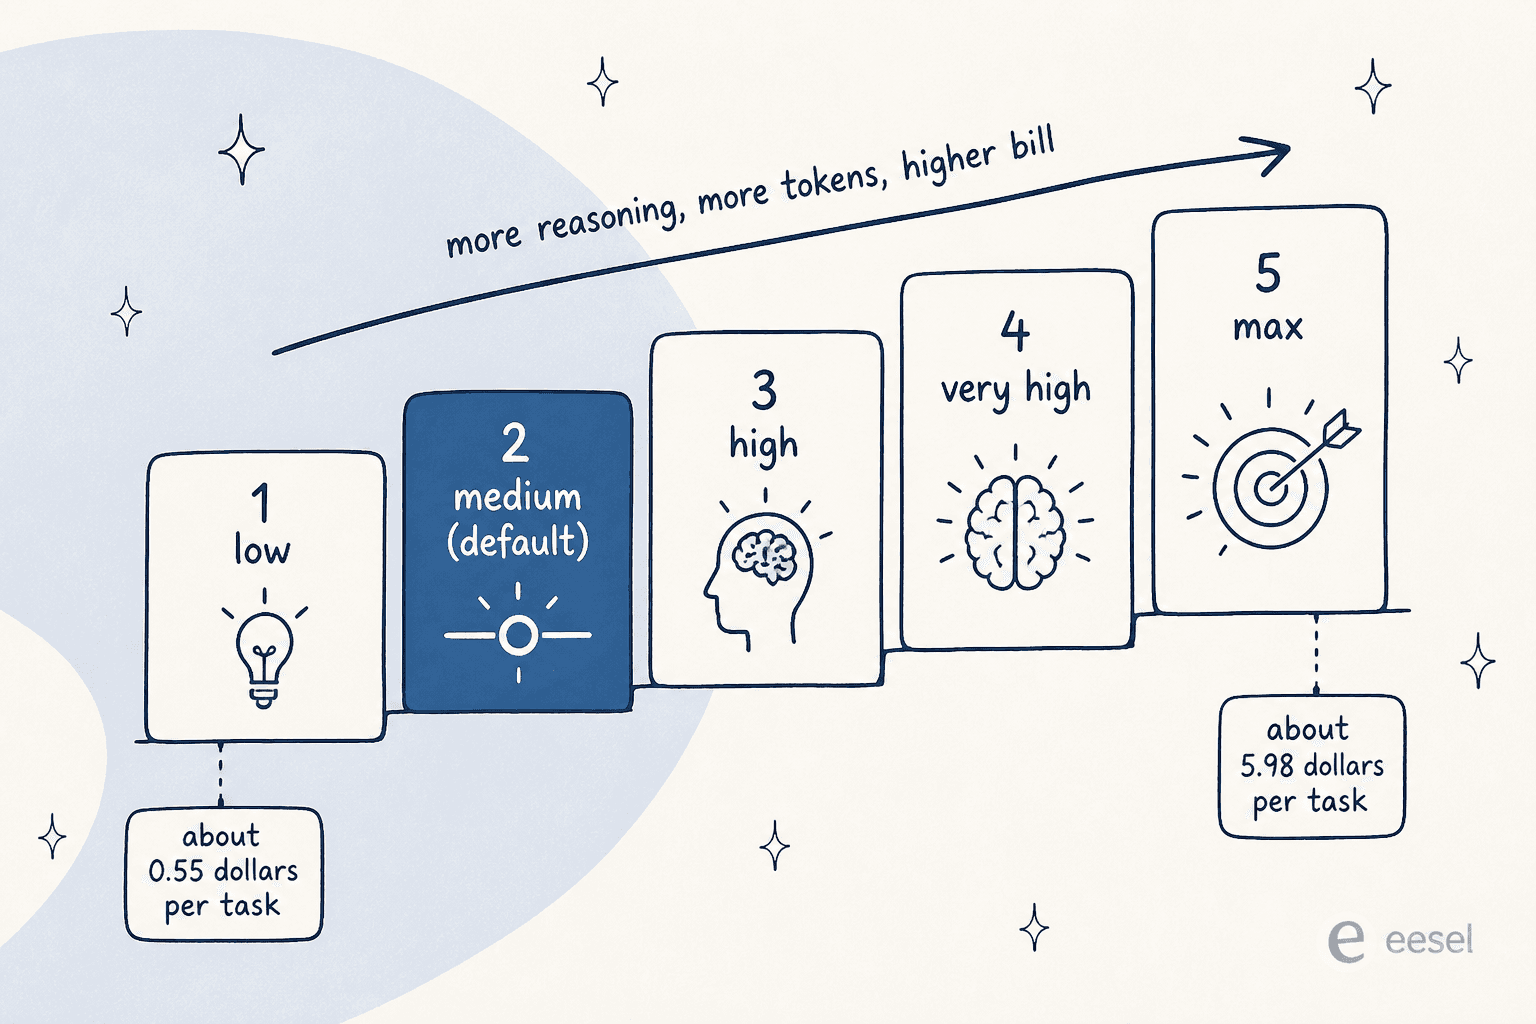
C'est pourquoi le tarif par token est presque une distraction. Selon la propre mesure d'Artificial Analysis, la même tâche difficile coûte environ $0,55 à effort faible, environ $1,34 à effort moyen et environ $5,98 à effort maximal. L'intelligence que vous payez grimpe avec : l'exécution à effort faible obtient 42 sur l'Intelligence Index, medium atteint 51, et seul le max atteint le score phare de 58. La vraie question au moment de déployer Opus 5.5 n'est donc pas « puis-je me le permettre », mais « quel est le niveau d'effort le plus bas qui franchit encore la barre pour cette tâche ». La plupart du temps, c'est medium.
C'est aussi le principal piège pour quiconque vient d'Opus 5, où l'effort par défaut était high. En transposant la même charge de travail sur Opus 5.5 sans toucher au réglage, votre facture par tâche peut même baisser, car le défaut se situe désormais un cran plus bas. C'est un réglage par défaut vraiment réfléchi, mais cela signifie qu'on ne peut pas déduire le coût du seul prix affiché.
Les benchmarks : il gagne presque toutes les catégories
En mettant le prix de côté un instant, sur la capacité pure, Opus 5.5 est clairement en tête. Sur l'Intelligence Index d'Artificial Analysis, il occupe la première place avec 58, devant tout le peloton de pointe. Et ce n'est pas un coup de chance sur un seul benchmark : il domine sur GDPval-AA (1846), sur AutomationBench et sur les évaluations de codage à long horizon, celles qui comptent le plus pour les agents.
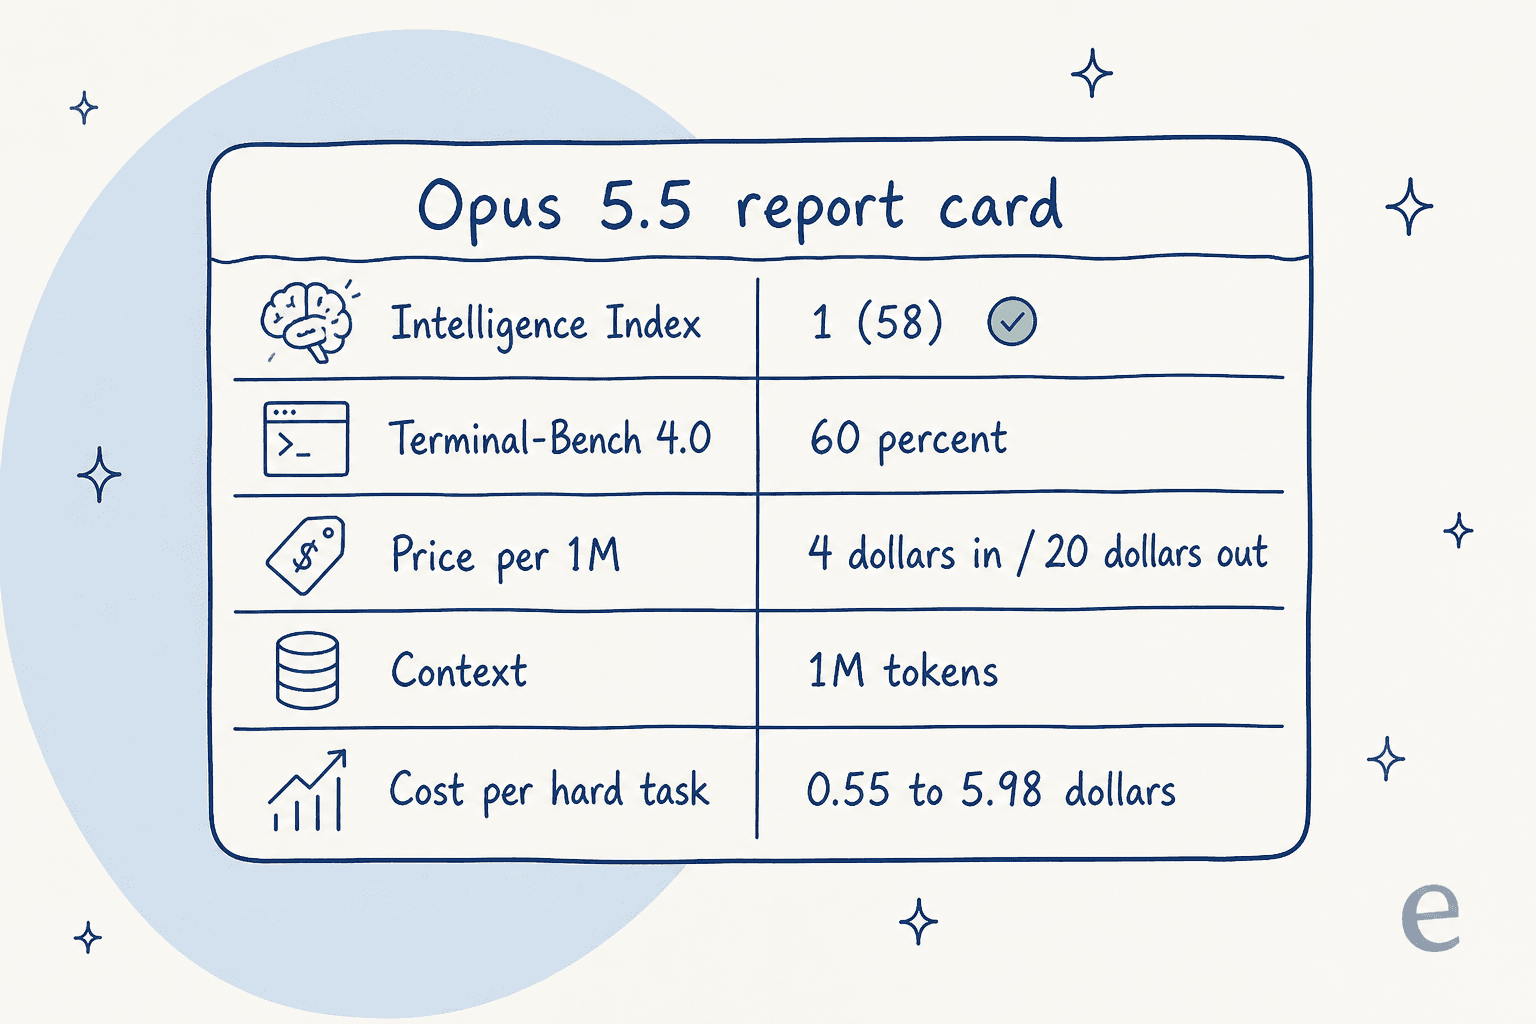
C'est sur le codage qu'il prend le plus nettement l'avantage. Sur Terminal-Bench 4.0, exécuté via le harnais d'Artificial Analysis à effort maximal, Opus 5.5 a obtenu 60% contre 44% pour son rival le plus proche en prix. C'est le genre d'écart qui se traduit par moins d'impasses lors d'une longue exécution de codage agentique, exactement la charge de travail pour laquelle Anthropic l'a ajusté. Si vous faites du travail d'ingénierie difficile, autonome et en plusieurs étapes, c'est le modèle qui termine des tâches où d'autres modèles calent.
Un bémol à ajouter : le score le plus élevé est un chiffre obtenu à effort maximal, et l'effort maximal est le réglage à $5,98 la tâche. Les benchmarks qui sacrent Opus 5.5 le mesurent à son point le plus coûteux. C'est équitable, chaque modèle est mesuré à son plafond, mais cela signifie que la victoire au classement et l'expérience quotidienne ne sont pas la même chose, à moins de toujours payer pour le max.
Ce que coûte réellement Claude Opus 5.5
Voici la grille tarifaire complète, car les prix « à partir de » cachent justement les éléments qui font mal sur un travail gourmand en tokens.
| Poste | Tarif |
|---|---|
| Entrée (par 1M de tokens) | $4 |
| Sortie (par 1M de tokens) | $20 |
| Lecture en cache (par 1M de tokens) | $0,20 |
| Surcoût contexte long | Aucun |
| Fenêtre de contexte | 1M de tokens |
| Sortie maximale | 128K tokens (300K en Batch) |
| Coût par tâche difficile (AA) | $0,55 (low) à $5,98 (max) |
Deux lignes méritent un second regard. D'abord, il n'y a aucun surcoût pour les contextes longs, ce qui distingue Opus 5.5 des rivaux qui doublent leur tarif d'entrée au-delà d'un certain seuil ; sur les tâches à très gros contexte, cette tarification plate referme discrètement l'écart par token. Ensuite, les lectures en cache à $0,20 le million signifient que si votre charge de travail repose sur un grand prompt système stable suivi de questions courtes, une large part de votre facture d'entrée reste peu coûteuse.
Un exemple chiffré rapide. Supposons que vous exécutiez 1 000 tâches d'agent difficiles par mois. À effort moyen ($1,34 chacune), cela représente environ $1 340. Si vous poussez ces mêmes 1 000 tâches à effort maximal pour gagner les derniers points d'intelligence, vous êtes à environ $5 980. Cet écart de 4x est un choix de configuration, pas un changement de forfait, et c'est le coût par tâche que j'inscrirais au tableau avant d'intégrer Opus 5.5 dans quoi que ce soit de gros volume. Pour le détail complet avec le Batch et les tarifs régionaux, voir mon guide sur les tarifs d'Opus 5.5, et la comparaison plus large OpenAI API vs Anthropic API montre comment il se positionne face à l'autre plateforme de pointe.
Là où Opus 5.5 justifie son prix, et là où il ne le justifie pas
Soyons concrets sur l'adéquation, car « c'est le meilleur modèle » est vrai et inutile à la fois.
Il justifie son prix quand la tâche est difficile, longue et coûteuse à rater. Un agent de codage de plusieurs heures qui refactorise une vraie base de code, une tâche de recherche qui doit tenir un contexte énorme et raisonner à travers lui, un problème ambigu où un modèle moins cher tourne en rond. Dans ces cas, les tokens supplémentaires achètent un résultat abouti plutôt qu'une impasse à l'apparence plausible, et la facture est modeste face aux heures d'ingénierie économisées.
C'est le mauvais outil quand la tâche est bien définie et à haut volume : classification, réponses courtes, traduction, recherches simples, les 80% ennuyeux de la plupart des charges de production. Payer les tarifs et la latence d'Opus pour un travail qu'un modèle intermédiaire accomplit sans peine, c'est de l'argent et de la vitesse qu'on ne récupère pas. Opus est délibérément posé par conception, donc pour tout ce qu'un humain attend en direct, comme une réponse de chat, la réactivité compte plus que les derniers points de l'Intelligence Index. C'est l'argument en faveur d'une configuration à deux modèles : router les tâches vraiment difficiles vers Opus 5.5 et tout le reste vers Sonnet 5, ou se tourner vers l'une des options moins chères de mon comparatif des alternatives à Opus 5.5.
Le constat honnête en une phrase : Opus 5.5 est le meilleur modèle, et « meilleur modèle » n'est que rarement la même question que « bon modèle pour cette tâche ».
Ce que les gens en disent vraiment
Les réactions du fil de lancement rejoignaient mes propres tests : un vrai respect pour la capacité, et un rappel récurrent que l'étiquette sur le curseur d'effort compte plus que le classement. Un testeur expérimenté, comparant le modèle à la concurrence de pointe lancée le lendemain, a conclu ceci :
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

Ce « at medium » fait une grande partie du travail, et c'est tout l'objet de ce test. L'autre thème qui mérite d'être relevé, c'est à quel point un seul benchmark ne devrait pas décider de votre choix en 2026 :
Only hands-on experience matters in the end, and these days it's very easy to switch models.
Cette dernière proposition, « very easy to switch models », est la vraie histoire de l'année, et elle mène directement à la question que la plupart des tests de modèles évitent.
Essayer eesel : le coéquipier qui tourne sur n'importe quel modèle
Chaque test de modèle suppose implicitement que le travail du lecteur consiste à choisir un modèle, à connecter son API, à gérer le prompt engineering, à le relier à ses outils et à l'empêcher d'halluciner devant de vrais clients. Pour la plupart des équipes, ce n'est pas le travail. Le travail, c'est un taux de résolution plus élevé, ou des articles publiés. Un modèle de pointe comme Opus 5.5 est de l'infrastructure ; c'est le moteur, pas l'employé.

C'est ainsi que je présenterais eesel. C'est une plateforme de coéquipiers IA, et vous embauchez des coéquipiers prêts à travailler pour des missions précises. L'équipe actuelle compte un coéquipier IA de support qui rejoint votre file de support existante et une rédactrice de blog IA qui rédige des articles documentés. Chacun arrive en connaissant déjà son métier, connecté à vos outils et ancré dans le contexte de votre entreprise, si bien que ce n'est pas vous qui choisissez entre les niveaux d'effort et surveillez un prompt. Comme le modèle se trouve sous le coéquipier, un modèle moins cher ou plus intelligent lancé le mois prochain devient une mise à niveau gratuite, pas une reconstruction, et le coéquipier IA de support est facturé au ticket résolu plutôt qu'au token, si bien que le calcul du curseur d'effort évoqué plus haut cesse d'être votre problème.
Si vous êtes du genre à lire un test de modèle jusqu'au bout, vous allez apprécier ceci : tout se pilote depuis le terminal. Le CLI eesel (npx @eesel/cli) connecte les intégrations, modifie les instructions permanentes de l'agent, simule un déploiement sur vos tickets historiques, approuve des actions et lit le journal d'activité de chaque exécution, le tout en JSON, avec une option --dry-run qui affiche l'appel exact qu'une écriture effectuerait avant de l'envoyer. Chaque espace de travail est aussi un serveur MCP, si bien que des agents de codage comme Claude Code, Codex et Cursor peuvent piloter le même coéquipier. C'est le même produit que le tableau de bord, exposé pour les personnes et les agents qui vivent dans un terminal. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Claude Opus 5.5 en vaut-il la peine en 2026 ?
Combien coûte Claude Opus 5.5 ?
Qu'est-ce que le curseur d'effort dans Claude Opus 5.5 ?
Claude Opus 5.5 est-il bon pour le code ?
Ai-je besoin de Claude Opus 5.5 pour créer un agent de support IA ?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.