

Que veut dire « ultrarapide » ?
La vitesse est tout l'argument ici, alors je commence par les chiffres que TypeSafe publie réellement, puis je les passe au crible.
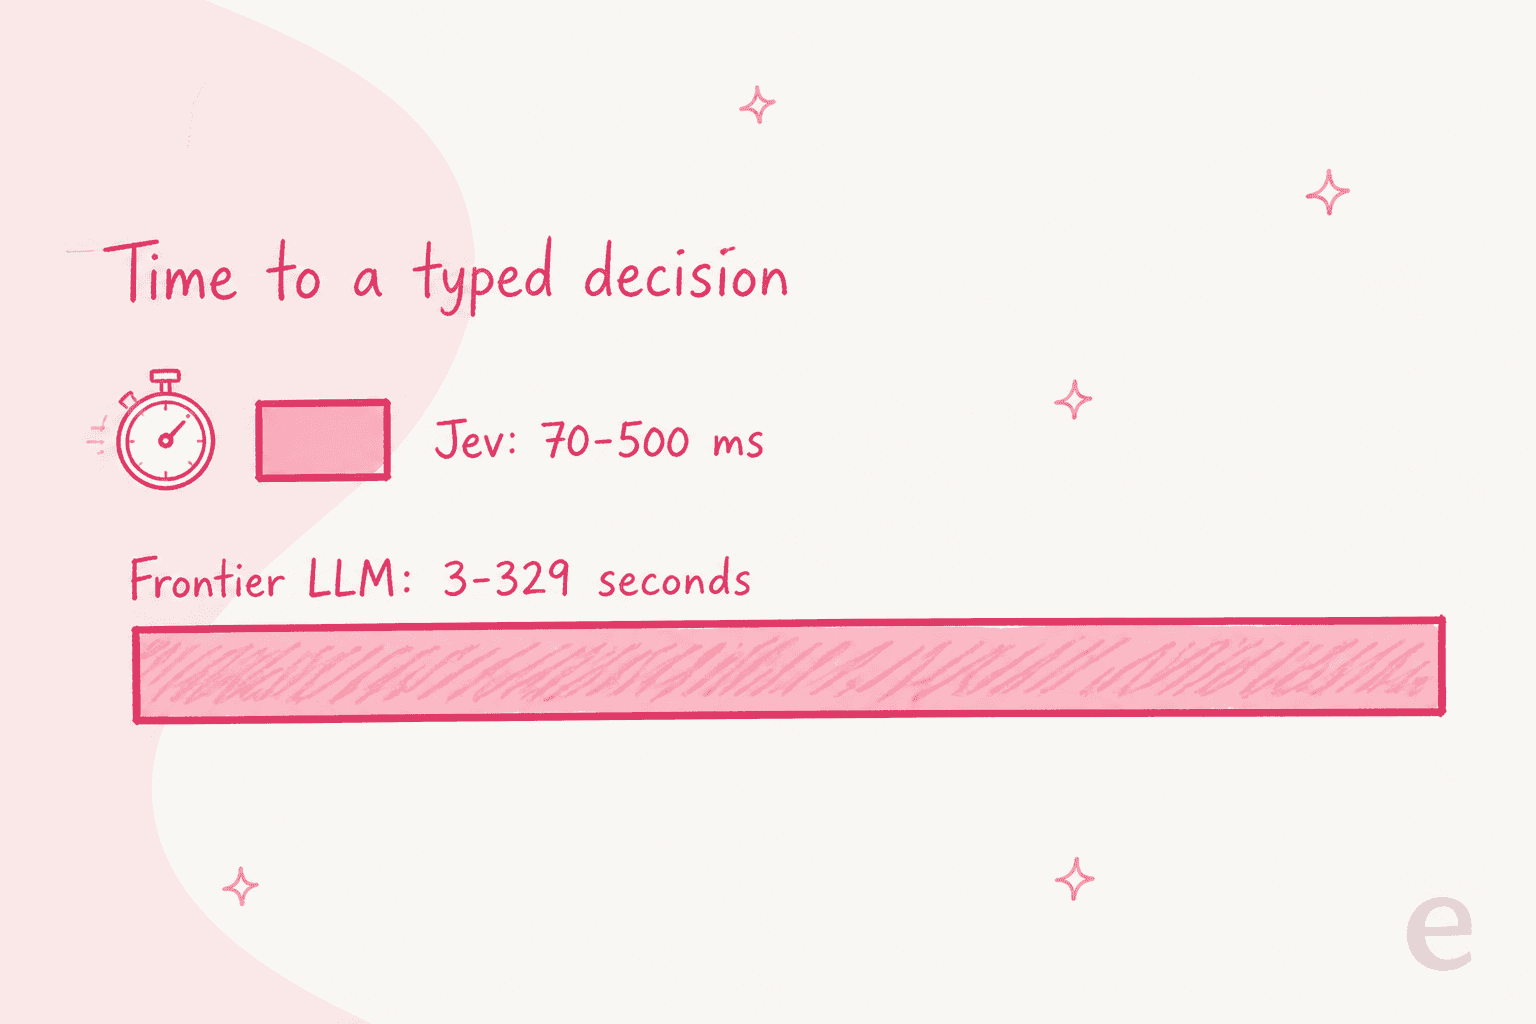
TypeSafe affirme que le temps de réponse de bout en bout de Jev est de 70 ms à 500 ms, contre 3 à 329 secondes pour les LLM de pointe sur des requêtes de type System One. Sur sa page d'accueil, elle va plus loin avec un benchmark de flux de travail : 193,6x plus rapide et 444,6x moins cher, même si l'article de lancement admet honnêtement que ces chiffres sont « dans le haut de la fourchette des gains réels ». Une démo sur la même page chronomètre une seule décision à 0,114 seconde et 0,000081 $, contre 8,566 secondes et 0,013880 $ pour une référence LLM.
Voici le même ensemble avec les réserves jointes, car les références comptent autant que les chiffres.
| Affirmation | Jev | Référence indiquée par TypeSafe |
|---|---|---|
| Latence de bout en bout | 70 ms à 500 ms | 3 à 329 secondes pour les LLM de pointe |
| Facteur de vitesse | 40x à 200x plus rapide | sur des requêtes de type System One |
| Titre du flux de travail | 193,6x plus rapide | « dans le haut de la fourchette des gains réels » |
| Démo de décision unique | 0,114 s | 8,566 s pour la référence LLM |
| Fenêtre de contexte | 32 000 jetons | version du modèle jev-1.13.0 |
La fourchette de 70-500 ms est le chiffre sur lequel je m'appuierais, car elle décrit une seule requête plutôt qu'un flux de travail entier. À cette latence, une décision peut tenir dans une requête qu'un utilisateur attend, ce qui est impossible quand une étape de classification prend huit secondes.
Pourquoi Jev est rapide : une passe parallèle, pas un flux de jetons
La vitesse n'est pas une astuce de réglage, elle vient d'une conception différente. Un LLM échantillonne un jeton à la fois, en séquence, jusqu'à produire une chaîne pour un lecteur humain. Jev génère toutes ses sorties en une seule passe parallèle et ne produit jamais de texte libre.
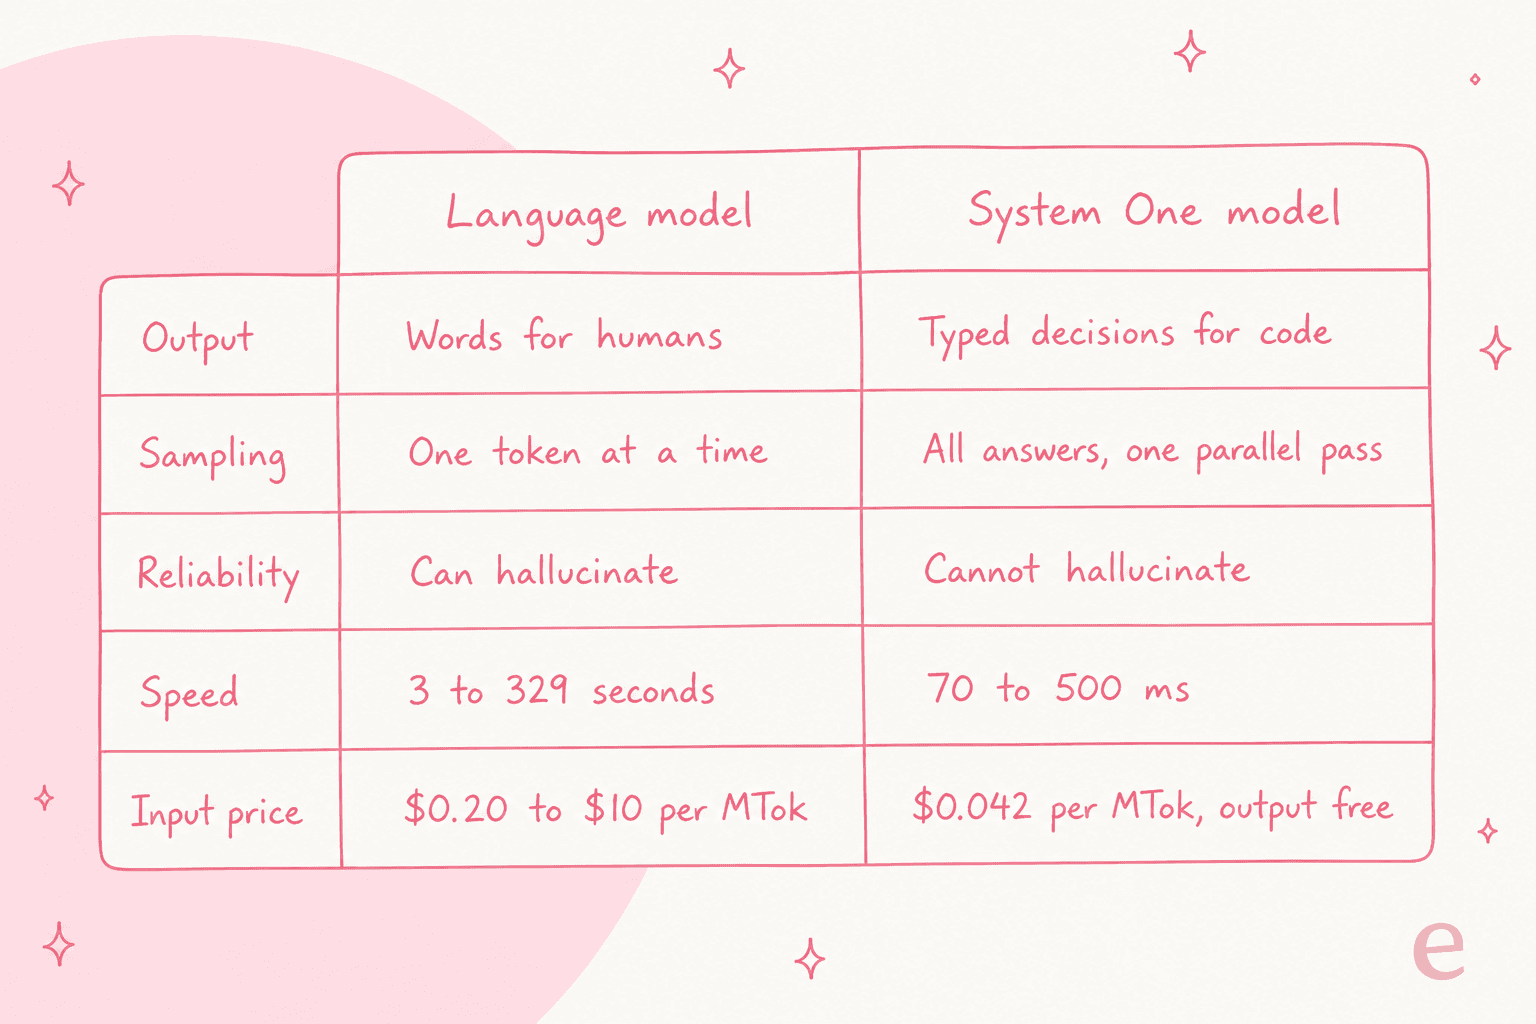
Vous envoyez à Jev un état (une chaîne ou un objet structuré) plus un ensemble de questions typées. Il évalue chaque question en parallèle face à ce même état et renvoie des réponses typées avec des probabilités et un score de confiance. Comme chaque question est notée séparément, TypeSafe affirme qu'en ajouter change à peine le temps de réponse, vous pouvez donc demander « est-ce urgent », « quel service » et « quel niveau de frustration » en un seul appel tout en restant dans votre budget de latence.
C'est pourquoi présenter Jev comme une primitive rapide est plus juste que « un LLM plus rapide ». Il s'insère là où vous forcez aujourd'hui un modèle de langage à émettre un blob JSON que vous analysez ensuite en espérant qu'il soit valide, la même question « quelle couche choisir » qui revient dans AgentKit vs l'API Anthropic. Il ne s'insère pas là où il faut de la rédaction, de l'explication ou du raisonnement en plusieurs étapes.
La comparaison de vitesse n'est pas tout à fait équivalente
C'est la partie que la foule du jour du lancement a repérée en moins d'une heure, et mieux vaut être franc. Jev est rapide en partie parce qu'il en fait moins. Le commentaire en tête du fil Hacker News à 1 929 points a recadré tout le lancement, et la critique de latence la plus acérée a suivi aussitôt :
"'70-500ms vs 3-329 seconds' are apples-to-oranges unless the LLM baseline is doing comparable work... If Jev is skipping generation entirely for a narrow structured task, of course it's faster."

C'est une critique juste. Comparer un modèle qui émet trois valeurs typées à un modèle qui rédige un paragraphe, puis qualifier le premier de 200x plus rapide, revient à mesurer deux choses différentes. La lecture honnête est que Jev est extrêmement rapide pour la tranche de travail en forme de décision qu'il vise, et cette tranche est réelle et courante. Il n'est pas plus rapide sur les tâches qu'il ne fait tout simplement pas.
Le chiffre auquel je fais le plus confiance n'est donc pas sur le site de TypeSafe. Il vient du PDG de Vercel, qui a intégré Jev dans un produit en production :
"We're seeing extraordinary results from @typesafeai... Jev is up to 18x faster (p95) and more accurate."
Un gain de 18x au p95 sur une vraie étape de revue de sécurité est à la fois plus petit et bien mieux étayé que le chiffre marketing de 200x, et il indique exactement où l'ultrarapide est rentable.
Où la vitesse est vraiment rentable
Une latence inférieure à la seconde ne vaut le coup que lorsqu'une décision se trouve sur le chemin critique, avec quelque chose qui attend la réponse. C'est le schéma à rechercher : un vérificateur rapide placé devant un système plus lent.
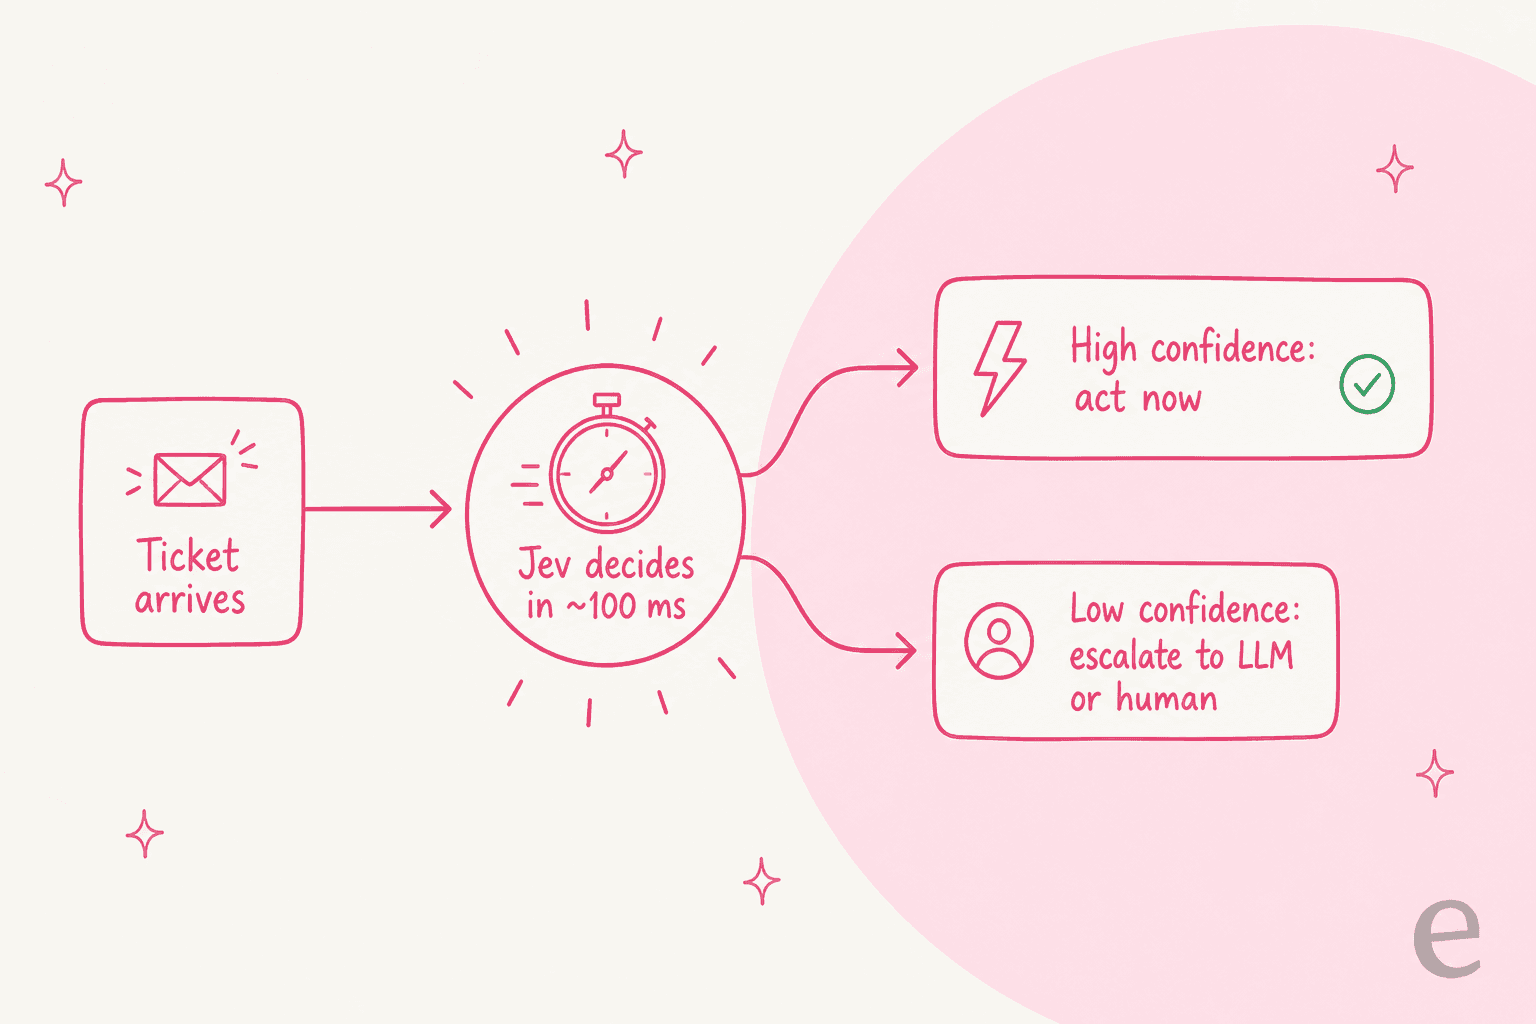
L'exemple concret publié par Cloudflare est, de façon parlante, un ticket de support : donnez à Jev « Help! My payouts have been failing for 3 days » et il renvoie is_urgent à 0,95, department à facturation avec 0,8 de confiance et un score de frustration, le tout en un appel. C'est du tri, de l'acheminement et de l'analyse de sentiment en une seule requête, exactement le type d'étape qu'un flux de tri de tickets par IA exécute des milliers de fois par jour. Quand chaque appel prend 100 ms au lieu de 8 secondes, vous pouvez l'exécuter de façon synchrone dès l'arrivée du ticket plutôt que dans une lente file d'arrière-plan.
Le développeur qui a le mieux résumé l'appétit faisait déjà cela à la main :
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing."
Le score de confiance rend la vitesse exploitable dans une boucle comme celle-ci : agir tout de suite sur les réponses sûres, et renvoyer les incertaines vers un modèle plus grand ou un humain. C'est la même discipline que derrière une bonne conception d'agents IA et toute étape sérieuse d'assistance à l'agent, où le but est la vitesse sans laisser une décision fausse mais sûre d'elle atteindre un client.
Ce que coûte une telle vitesse
L'autre moitié de « ultrarapide », c'est qu'il est assez peu cher pour être appelé en permanence. TypeSafe facture Jev 0,042 $ par million de jetons en entrée, la sortie étant gratuite, ce qu'elle présente comme 238x moins cher en entrée que Claude Fable 5.1, et elle décrit la sortie comme « too cheap to meter ». Il n'y a pas encore de page de tarifs dédiée, et sur la pérennité, l'article de lancement est d'une franchise rafraîchissante : « We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up). »
Peu cher par appel plus rapide par appel, c'est ce qui débloque l'argument du paradoxe de Jevons dont le modèle tire son nom : quand une décision coûte une fraction de centime et revient en 100 ms, on cesse de la rationner et on l'appelle partout, comme on s'appuie déjà sur des primitives bon marché dans l'automatisation de flux de travail par IA. C'est une posture très différente de payer des tarifs de LLM pour chaque classification.
Faut-il construire sur la vitesse de Jev ?
Ma lecture après avoir parcouru la documentation, les démos et les critiques : prenez Jev quand le travail est une décision étroite et bien délimitée que votre code consomme et que la latence est sur le chemin critique, comme l'acheminement, la modération, la détection d'intention, le scoring ou une porte de sécurité rapide devant un modèle plus gros. C'est là que les 70-500 ms et la sortie gratuite changent vraiment ce que vous pouvez construire.
Ne le prenez pas en espérant un ChatGPT plus rapide. Il n'écrit pas, n'explique pas et ne tient pas de conversation, et un outil aussi rapide pousse à l'usage excessif sur des tâches qu'un classifieur simple ou une règle devrait gérer. La ligne à tenir : Jev est une primitive, il vous donne une excellente décision en millisecondes, et vous restez propriétaire du pipeline, de la logique d'escalade, de la stratégie de déviation et de chaque action après la décision. La vitesse à la décision ne vous achète rien de tout cela.
Essayer eesel
Si vous gérez du support, la traduction honnête est la suivante : Jev est un moteur brillant, pas la voiture. Il vous dira qu'un ticket est urgent, relève de la facturation et vient d'un client frustré en environ 114 millisecondes. Il n'ouvrira pas le ticket, ne rédigera pas de réponse fondée sur votre centre d'aide, n'appliquera pas le remboursement et ne passera pas la main à un humain quand il hésite. Quelqu'un doit encore construire cette couche.
eesel est ce coéquipier fini. C'est un coéquipier de support IA que vous branchez à votre helpdesk, et il prend déjà les décisions de tri, d'acheminement et d'escalade que Jev expose comme primitives, puis agit dessus de bout en bout. Il apprend de vos anciens tickets et de votre centre d'aide, et vous pouvez simuler sur des tickets historiques avant qu'il ne touche un seul client réel.

Et si vous avez aimé l'ergonomie développeur de Jev, vous allez aimer ceci : eesel n'est pas qu'un tableau de bord. La CLI eesel (npx @eesel/cli) pilote le même coéquipier depuis un terminal, une personne peut lancer eesel chat ou eesel activity à la main, des scripts peuvent l'automatiser en CI, et des agents de code comme Claude Code, Codex et Cursor peuvent le conduire, puisque chaque commande affiche du JSON et que --dry-run montre l'appel exact avant son envoi. Chaque espace de travail est aussi un serveur MCP. Jev vous donne la décision rapide ; eesel vous donne le coéquipier qui agit dessus. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Quelle est la vitesse de TypeSafe Jev ?
TypeSafe situe le temps de réponse de bout en bout de Jev entre 70 ms et 500 ms, contre 3 à 329 secondes pour un LLM de pointe sur un travail de même forme. Le hic : Jev ne renvoie que des décisions typées, pas du texte, donc la comparaison n'est pas tout à fait équivalente. Il est réellement rapide pour les tâches de classification et d'acheminement derrière la déviation de niveau 1.
Pourquoi Jev est-il tellement plus rapide qu'un modèle d'IA classique ?
Un LLM échantillonne un jeton à la fois jusqu'à écrire une chaîne lisible par un humain. Jev évalue toutes ses questions en une seule passe parallèle et ne génère jamais de texte libre, il saute donc la partie la plus lente. Cela signifie aussi que c'est une primitive de décision, pas un substitut à un modèle qui rédige ou raisonne, la même séparation qu'entre un agent à règles et un agent IA.
La comparaison de vitesse de Jev est-elle équitable ?
En partie. Un chiffre réel et solide est venu du PDG de Vercel, qui a mesuré Jev 18 fois plus rapide au p95 sur une vraie étape de revue de sécurité. Le chiffre marketing de 193,6x porte sur un flux de travail entier et, selon TypeSafe elle-même, se situe dans le haut de la fourchette des gains réels, un point que Hacker News a vite relevé.
Combien coûte le modèle ultrarapide Jev ?
TypeSafe facture Jev 0,042 $ par million de jetons en entrée, la sortie étant gratuite, ce qu'elle présente comme un prix d'entrée 238 fois inférieur à Claude Fable 5.1. Il n'y a pas encore de grille de forfaits et l'accès se fait via une liste d'attente d'accès anticipé. Il est aussi disponible sur Cloudflare Workers AI.
Puis-je utiliser Jev seul pour répondre aux tickets de support ?
Pas seul. Jev prend la décision rapide, mais il n'ouvre pas le ticket, ne rédige pas de réponse fondée et n'applique pas le remboursement. Un coéquipier fini comme eesel prend ces décisions de service client et agit dessus dans votre helpdesk, et vous pouvez même le piloter depuis la CLI eesel.