Ce qu'est vraiment TypeSafe Jev
TypeSafe est un laboratoire d'IA de San Francisco qui a passé deux ans en mode furtif avant de lancer Jev. Sa présentation est délibérément provocatrice : sur la page d'accueil de TypeSafe, les LLM « produisent des mots pour les gens », tandis que « Jev produit des décisions typées et ressemble davantage à du code : fiable, rapide, cohérent avec lui-même et type-safe ». Le billet de lancement appelle Jev « un appel de fonction à intelligence de pointe : état non structuré en entrée, décisions probabilistes typées en sortie ».
Le nom est une private joke en deux parties. « System One » emprunte à Système 1 / Système 2 : Les deux vitesses de la pensée de Daniel Kahneman : la distinction qu'il établit entre la pensée rapide et intuitive du système 1 et le raisonnement lent et délibéré du système 2. Les modèles de chat visent le système 2. Jev est conçu pour le système 1 : le jugement instantané qu'une personne compétente porte en quelques secondes. « Jev » quant à lui porte le nom de l'économiste William Stanley Jevons, dont TypeSafe cite le paradoxe comme sa thèse : chaque baisse d'un ordre de grandeur du coût de l'intelligence débloque des ordres de grandeur d'usages supplémentaires.
La prémisse derrière tout cela est que le RLHF, la technique qui a rendu les chatbots agréables à converser, les a aussi rendus peu fiables pour une consommation par des machines. Le pitch de TypeSafe est qu'elle a « pris la direction de recherche opposée » et entraîné une nouvelle classe de modèle avec un nouvel algorithme qu'elle appelle Reinforcement Learning for Calibrated Decisions (RLCD).
Comment Jev fonctionne : état en entrée, décisions typées en sortie
La boucle centrale, c'est une requête pour une réponse. Vous envoyez un état (soit une simple chaîne, soit un objet structuré) plus un ensemble de questions typées. Jev évalue chaque question en parallèle par rapport à ce même état, et renvoie des réponses typées avec probabilités et confiance. Votre code branche, trie et route ensuite en fonction de ces réponses.
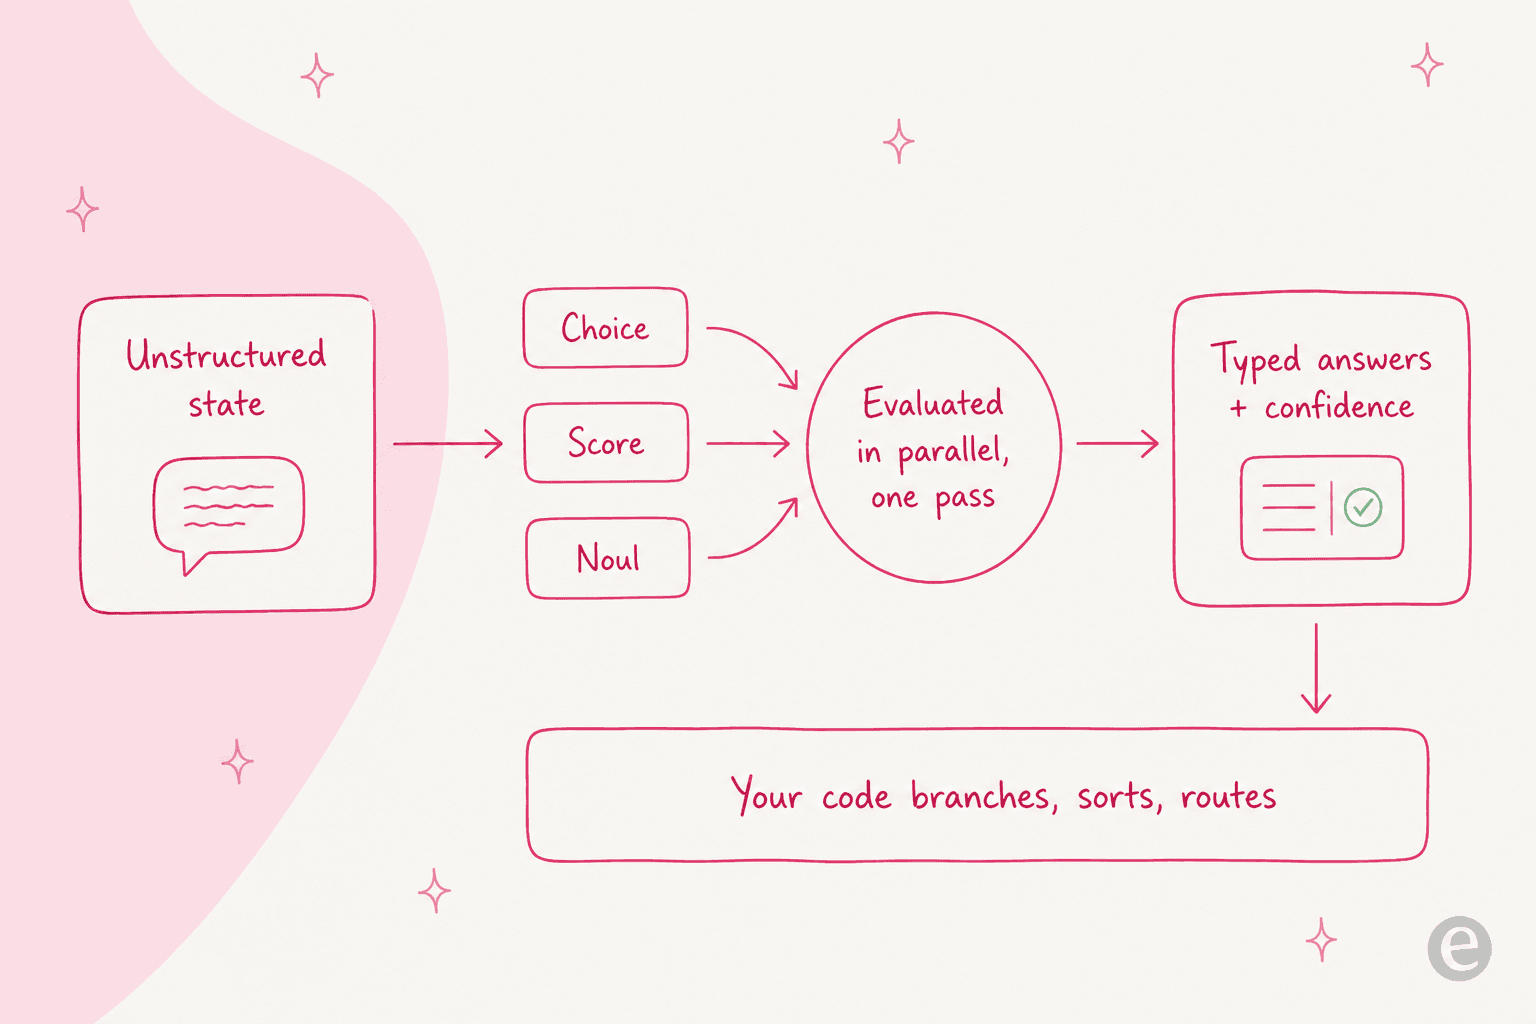
Le choix de conception le plus important : chaque question est évaluée indépendamment et isolément par rapport au même état. TypeSafe affirme que l'ajout de questions modifie à peine le temps de réponse, et comme chacune est notée séparément, vous n'obtenez pas ce « context-rot » qui s'installe quand on entasse une dizaine d'instructions dans un seul prompt.
Le conseil de TypeSafe est de garder chaque question atomique. Plutôt que de demander « évalue ce pitch de startup », vous posez chaque dimension séparément (taille du marché, faisabilité technique, différenciation) et combinez les scores avec votre propre formule. Quand les priorités changent, vous modifiez un coefficient dans le code plutôt que de réécrire un prompt. Si vous avez déjà lutté contre un mega-prompt pour le faire bien se comporter, cet instinct de décomposition vous paraîtra familier, et c'est la même logique derrière une bonne automatisation des workflows par l'IA.
Les trois primitives : Noul, Choice et Score
Jev expose exactement trois types de questions, et vous pouvez mélanger les trois dans un seul appel d'API.
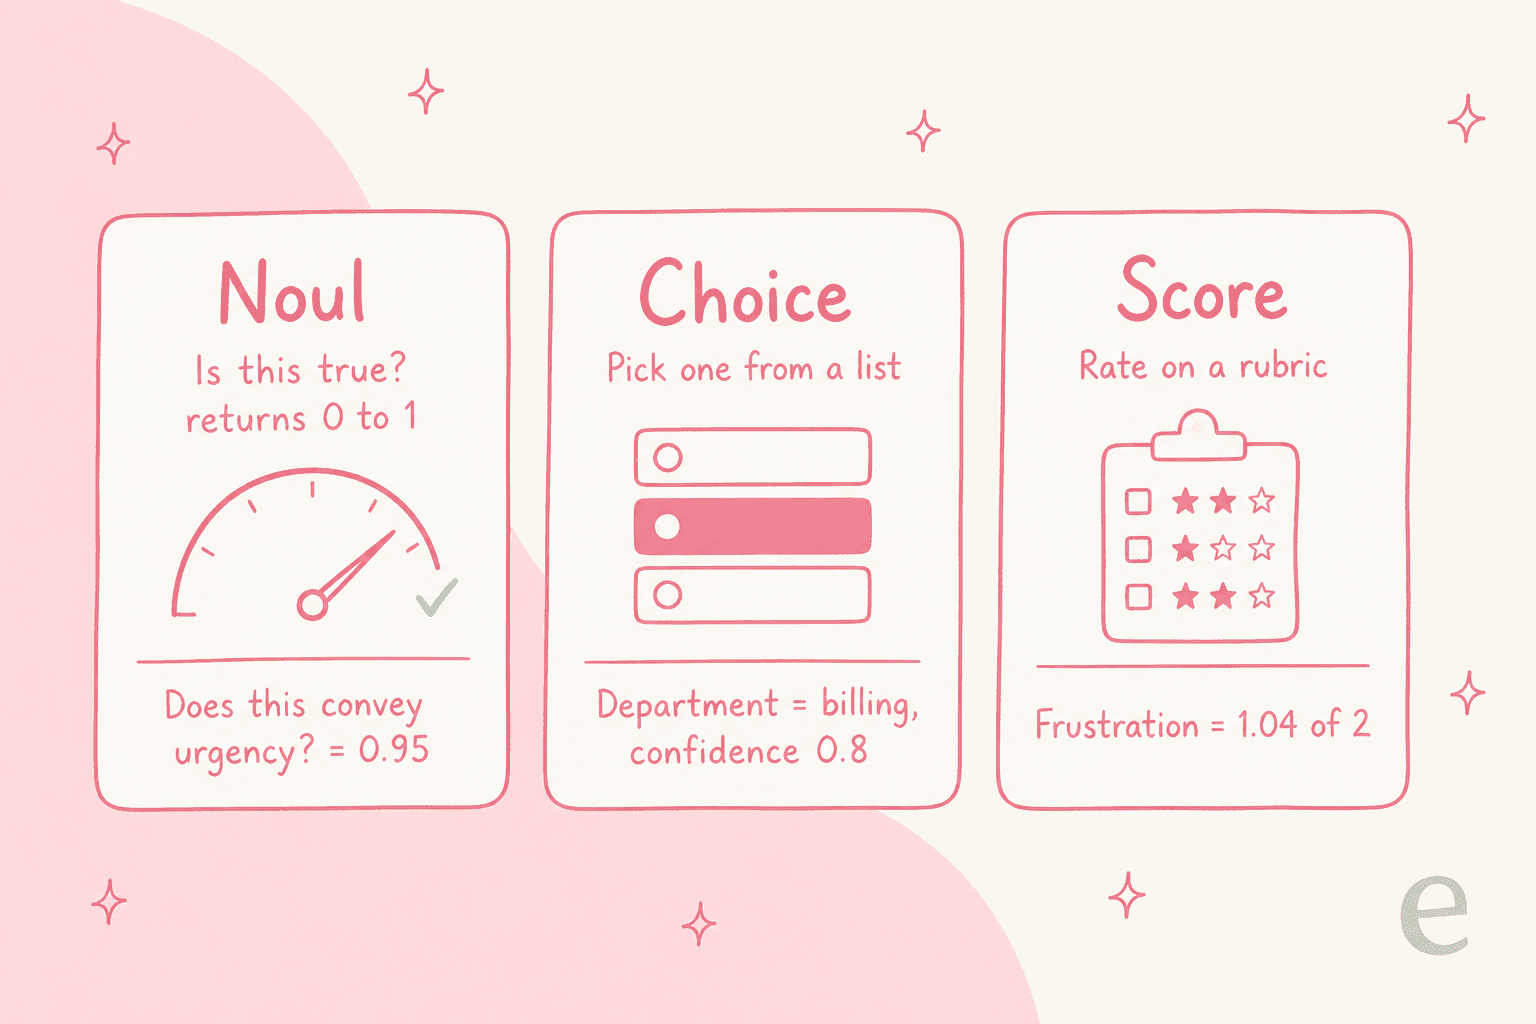
- Noul répond à « cette affirmation est-elle vraie ? » et renvoie une seule probabilité de 0 à 1.
- Choice choisit une option dans une liste que vous définissez, et renvoie le choix, les probabilités par option et une valeur de confiance.
- Score note l'état selon une grille que vous définissez, et renvoie une valeur numérique (elle peut tomber entre deux niveaux, comme 1,04 sur 2), des probabilités par niveau et une confiance.
L'exemple concret que Cloudflare publie est, révélateur, un ticket de support. Donnez à Jev le message « Help! My payouts have been failing for 3 days » et trois questions mixtes, et il répond avec is_urgent (Noul) à 0,95, department (Choice) à billing avec une confiance de 0,8, et frustration (Score) à 1,04 sur une échelle allant de calme à très en colère, le tout en un seul appel. C'est le tri, le routage et le sentiment en une seule requête, exactement le genre de décision dont a besoin une étape de tri de tickets par IA.
Où Jev rompt avec un LLM classique
Si vous ne devez retenir qu'un seul modèle mental, que ce soit celui-ci : un LLM écrit, Jev décide.
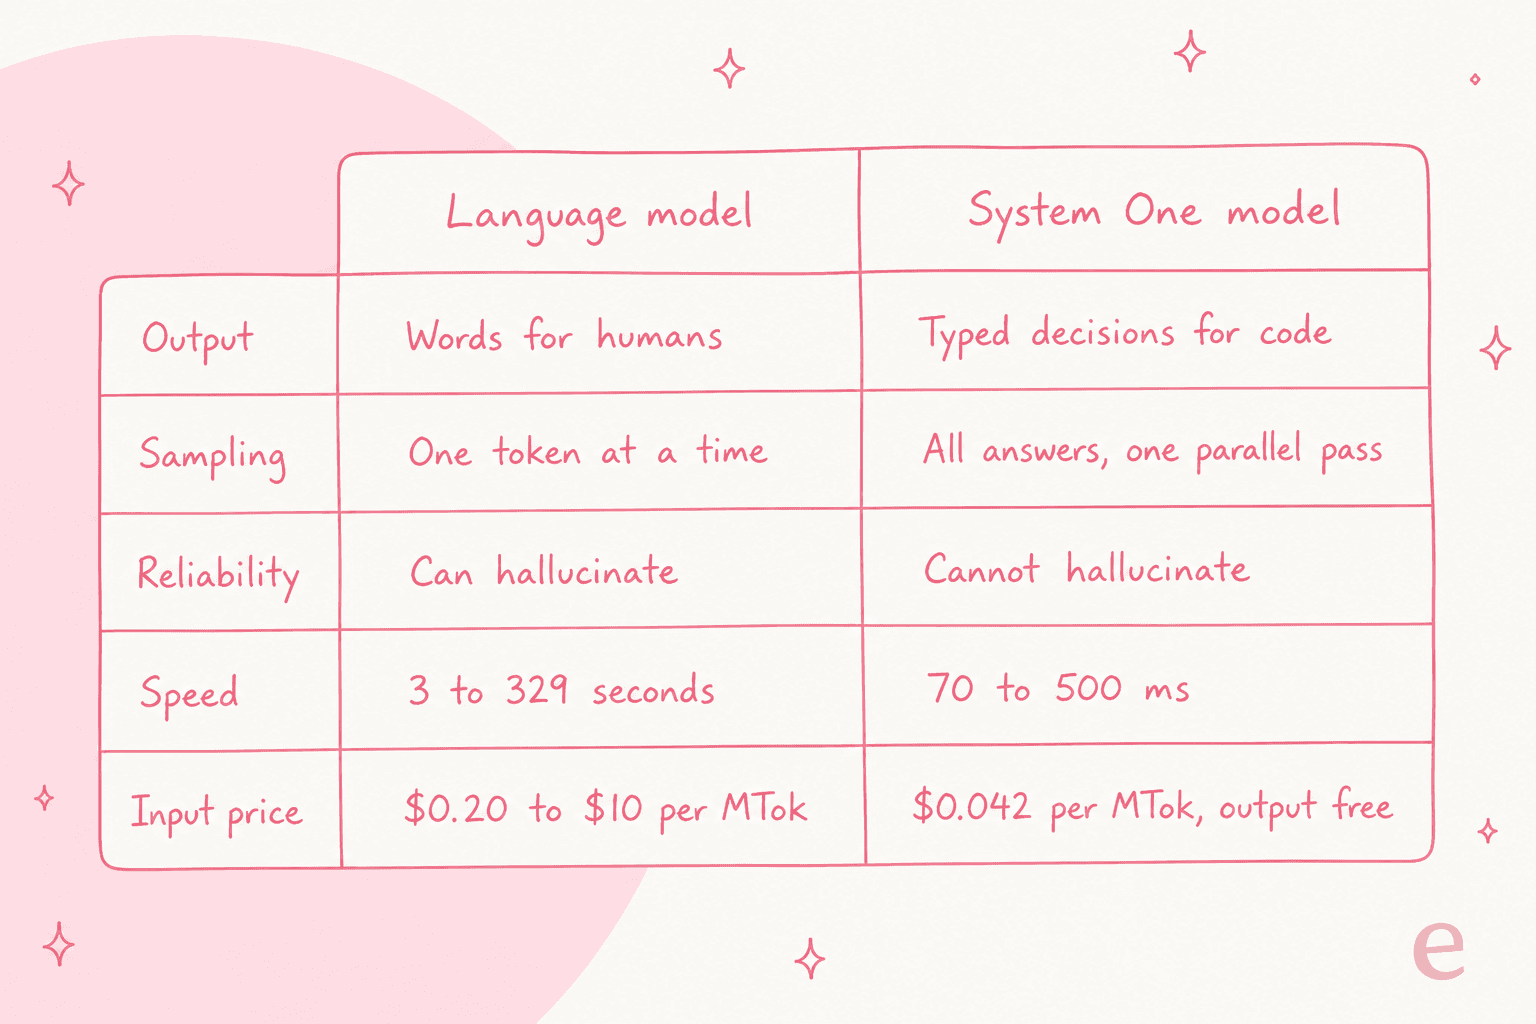
Un modèle de langage échantillonne un token à la fois, en séquence, jusqu'à produire une chaîne qu'un humain lit. Jev génère toutes ses sorties en une seule passe parallèle et ne produit jamais de texte libre du tout. C'est pourquoi il est rapide, et c'est aussi pourquoi la comparaison n'est pas tout à fait équitable, un point sur lequel je reviendrai. La conséquence pratique pour les développeurs, c'est que Jev s'intègre partout où vous forcez actuellement un LLM à produire un blob JSON que vous parsez ensuite en espérant qu'il soit valide. C'est la même question de « quelle couche est-ce que je choisis vraiment » qui revient dans AgentKit face à l'API Anthropic.
Les chiffres avancés par TypeSafe
TypeSafe ne lésine pas sur les chiffres, alors les voici avec leurs réserves.
| Affirmation | Jev | Référence déclarée par TypeSafe |
|---|---|---|
| Latence de bout en bout | 70 ms à 500 ms | 3 à 329 secondes pour les LLM de pointe |
| Multiple de vitesse | 40x à 200x plus rapide | sur des requêtes au format System One |
| Chiffre phare du workflow | 193,6x plus rapide, 444,6x moins cher | « dans le haut de la fourchette des gains réels » |
| Prix d'entrée | 0,042 $ / MTok, sortie gratuite | 238x inférieur à Claude Fable 5.1 |
| Fenêtre de contexte | 32 000 tokens | version du modèle jev-1.13.0 |
Jev est déjà en production sur Cloudflare Workers AI sous le nom typesafe/jev, et TypeSafe ouvre l'accès anticipé via une liste d'attente. Il n'existe pas encore de page tarifaire autonome ; le chiffre de 0,042 $ provient de la page d'accueil et du billet de lancement. Sur la durabilité, TypeSafe est étonnamment franc dans son billet de lancement : "We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Le point de donnée externe le plus crédible est venu du PDG de Vercel, qui a intégré Jev dans un vrai produit :
"We're seeing extraordinary results from @typesafeai. Default mode in 𝚏𝚡 is auto, with a safety reviewer analyzing every command. That reviewer runs on GPT Luna today. Jev is up to 18x faster (p95) and more accurate."
Une accélération de 18x sur une véritable étape de revue de sécurité est une affirmation bien plus fondée que le chiffre marketing de 200x, et elle indique où Jev brille vraiment : le vérificateur rapide placé devant un système plus lent.
Ce que signifie vraiment « ne peut pas halluciner »
C'est l'affirmation qui a enflammé le fil de lancement sur Hacker News (1 929 points, 508 commentaires), et cela vaut la peine de s'y attarder car c'est ce que la plupart des gens vont mal comprendre.
Jev ne peut pas faire d'erreur de type ni renvoyer une option qui n'était pas dans votre liste. Dans ce sens mécanique, il « ne peut pas halluciner ». Mais une réponse typée peut quand même être fausse avec assurance, et plusieurs commentateurs l'ont souligné avec précision :
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

La défense est que Jev vous fournit toujours une valeur de confiance, ce qui vous permet d'agir sur les réponses sûres et de router les réponses fragiles vers un humain :
"they mean they produce a confidence value for every result, so you could see for example it has 0.1 confidence, and you can disregard the result."
Le vrai test, c'est la calibration, pas le slogan « ne peut pas halluciner ». Comme l'a dit un commentateur, si le modèle annonce 0,9 sur mille réponses, environ 900 d'entre elles devraient être correctes. RLCD est censé être optimisé exactement pour cela. Tant qu'il n'existe pas de chiffres de calibration indépendants, traitez « ne peut pas halluciner » comme « ne renverra pas de sortie mal formée », pas comme « a toujours raison ». Pour quiconque déploie de l'IA sur de vraies questions de clients, cette distinction est primordiale, et c'est pourquoi nous nous appuyons autant sur le grounding et les tests pour prévenir les hallucinations de l'IA dans le support.
Qui est derrière Jev
TypeSafe a un pedigree difficile à ignorer. Le fondateur et PDG Diogo Almeida a co-inventé RLHF et InstructGPT chez OpenAI, la ligne de recherche qui a mené à ChatGPT, et est passé auparavant par Google Brain. Il est rejoint par la COO Sasha Sheng (ex-Meta/FAIR) et le CTO Erik Gafni, avec une équipe issue d'OpenAI, Google Brain, Meta, Stripe, Airbnb et Docker.
L'entreprise affirme être "soutenue par des investisseurs de premier plan" mais n'a publié aucun chiffre de financement sur ses propres pages, donc je n'avancerai aucun montant. Le slogan, « Build Prod, Not God », en dit long sur la posture : c'est une équipe qui optimise pour livrer des briques de production fiables, pas pour courir après l'AGI.
Devriez-vous vraiment utiliser Jev ?
Voici mon avis après être passé par la documentation, les démos et les critiques.
Tournez-vous vers Jev quand la tâche est une décision étroite et bien délimitée que votre code consomme : routage, modération, détection d'intention, notation, filtres d'extraction, ou un contrôle de sécurité rapide devant un modèle plus grand. L'avis de développeur le plus convaincant sur Hacker News venait de quelqu'un qui faisait déjà cela à la main :
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing. If this does at all what it claims, I think this is going to quickly become the new standard approach for agentic systems."
Ne vous tournez pas vers Jev quand vous avez besoin de génération, d'explication ou de raisonnement en plusieurs étapes. Le commentaire le plus voté de tout le fil a résumé le cadrage honnête :
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference.'"
Et les sceptiques les plus bruyants, dont le développeur Theo Browne, ont fait valoir que les démos virales le poussent vers des tâches qu'un classificateur simple ou une règle devrait plutôt assumer. C'est une mise en garde juste : un outil aussi rapide invite au surusage. La ligne à tenir, c'est que Jev est une brique. Il vous donne une excellente décision ; le pipeline, la logique d'escalade, la stratégie de deflection et chaque action qui suit la décision restent les vôtres.
Essayez eesel
Si vous dirigez le support, la traduction honnête de tout cela est : Jev est un moteur brillant, pas une voiture. Il vous dira qu'un ticket est urgent, relève de la facturation et vient d'un client frustré, en 114 millisecondes. Il n'ouvrira pas le ticket, ne rédigera pas la réponse fondée sur votre centre d'aide, n'appliquera pas le remboursement et ne transférera pas à un humain en cas de doute. Quelqu'un doit encore construire cela.
eesel est ce coéquipier fini. C'est un coéquipier IA pour le support que vous branchez sur votre helpdesk, et il prend déjà les décisions de tri, de routage et d'escalade que Jev expose comme des primitives, puis agit dessus de bout en bout. Il rejoint votre file de service client existante, apprend de vos tickets passés et de votre centre d'aide, et vous pouvez le simuler sur des tickets historiques avant qu'il ne touche un vrai client.

Et si vous avez aimé l'ergonomie pour développeurs de Jev, vous allez aimer ceci : eesel n'est pas réservé au tableau de bord. Le CLI eesel (npx @eesel/cli) pilote le même coéquipier et le même espace de travail depuis un terminal. Une personne peut exécuter eesel chat, eesel activity ou eesel approvals à la main ; des scripts peuvent l'automatiser en CI ; et des agents de codage comme Claude Code, Codex et Cursor peuvent le piloter, puisque chaque commande affiche du JSON et que --dry-run montre l'appel exact avant qu'il ne se déclenche. Chaque espace de travail est aussi un serveur MCP. Jev vous donne la décision ; eesel vous donne le coéquipier qui agit dessus, et permet à vos agents de le piloter. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Qu'est-ce que TypeSafe Jev ?
TypeSafe Jev est le premier modèle System One public : au lieu de générer du texte, il évalue des questions typées par rapport à un état et renvoie des décisions typées avec des probabilités et un score de confiance. Il est conçu pour les jugements étroits et structurés que le logiciel consomme directement, comme le tri de niveau 1 et le routage.
Combien coûte TypeSafe Jev ?
TypeSafe facture Jev 0,042 $ par million de tokens en entrée, avec une sortie gratuite, ce que l'entreprise présente comme un prix d'entrée 238 fois inférieur à celui de Claude Fable 5.1. Il n'existe pas encore de grille tarifaire publiée, et l'accès se fait via une liste d'attente d'accès anticipé.
Jev peut-il vraiment ne pas halluciner ?
Il ne peut pas produire d'erreur de type ni inventer une option en dehors de la liste que vous lui avez donnée, mais une réponse typée avec une confiance élevée peut quand même être fausse, un point débattu sur Hacker News. Le vrai test est la calibration. Si vous voulez des réponses fondées sur une file de support, la même discipline décrite dans notre guide pour prévenir les hallucinations de l'IA s'applique.
Jev remplace-t-il un LLM ?
Non. Jev prend des décisions typées rapides, il n'écrit pas de texte, ne raisonne pas étape par étape et ne tient pas de conversation. De nombreuses équipes le combinent avec un LLM, en utilisant Jev pour l'étape de classification et de routage, un peu comme fonctionne en pratique une répartition entre un système à base de règles et un agent IA.
En quoi Jev diffère-t-il d'un agent de service client IA classique ?
Jev est de l'infrastructure : une brique de décision que vous intégrez dans votre propre code. Un produit de service client IA comme eesel est le coéquipier fini qui prend ces décisions et effectue l'action directement dans votre helpdesk. Vous pouvez même le piloter depuis un terminal avec le CLI eesel.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.