

Ce qu'est Grok 4.7
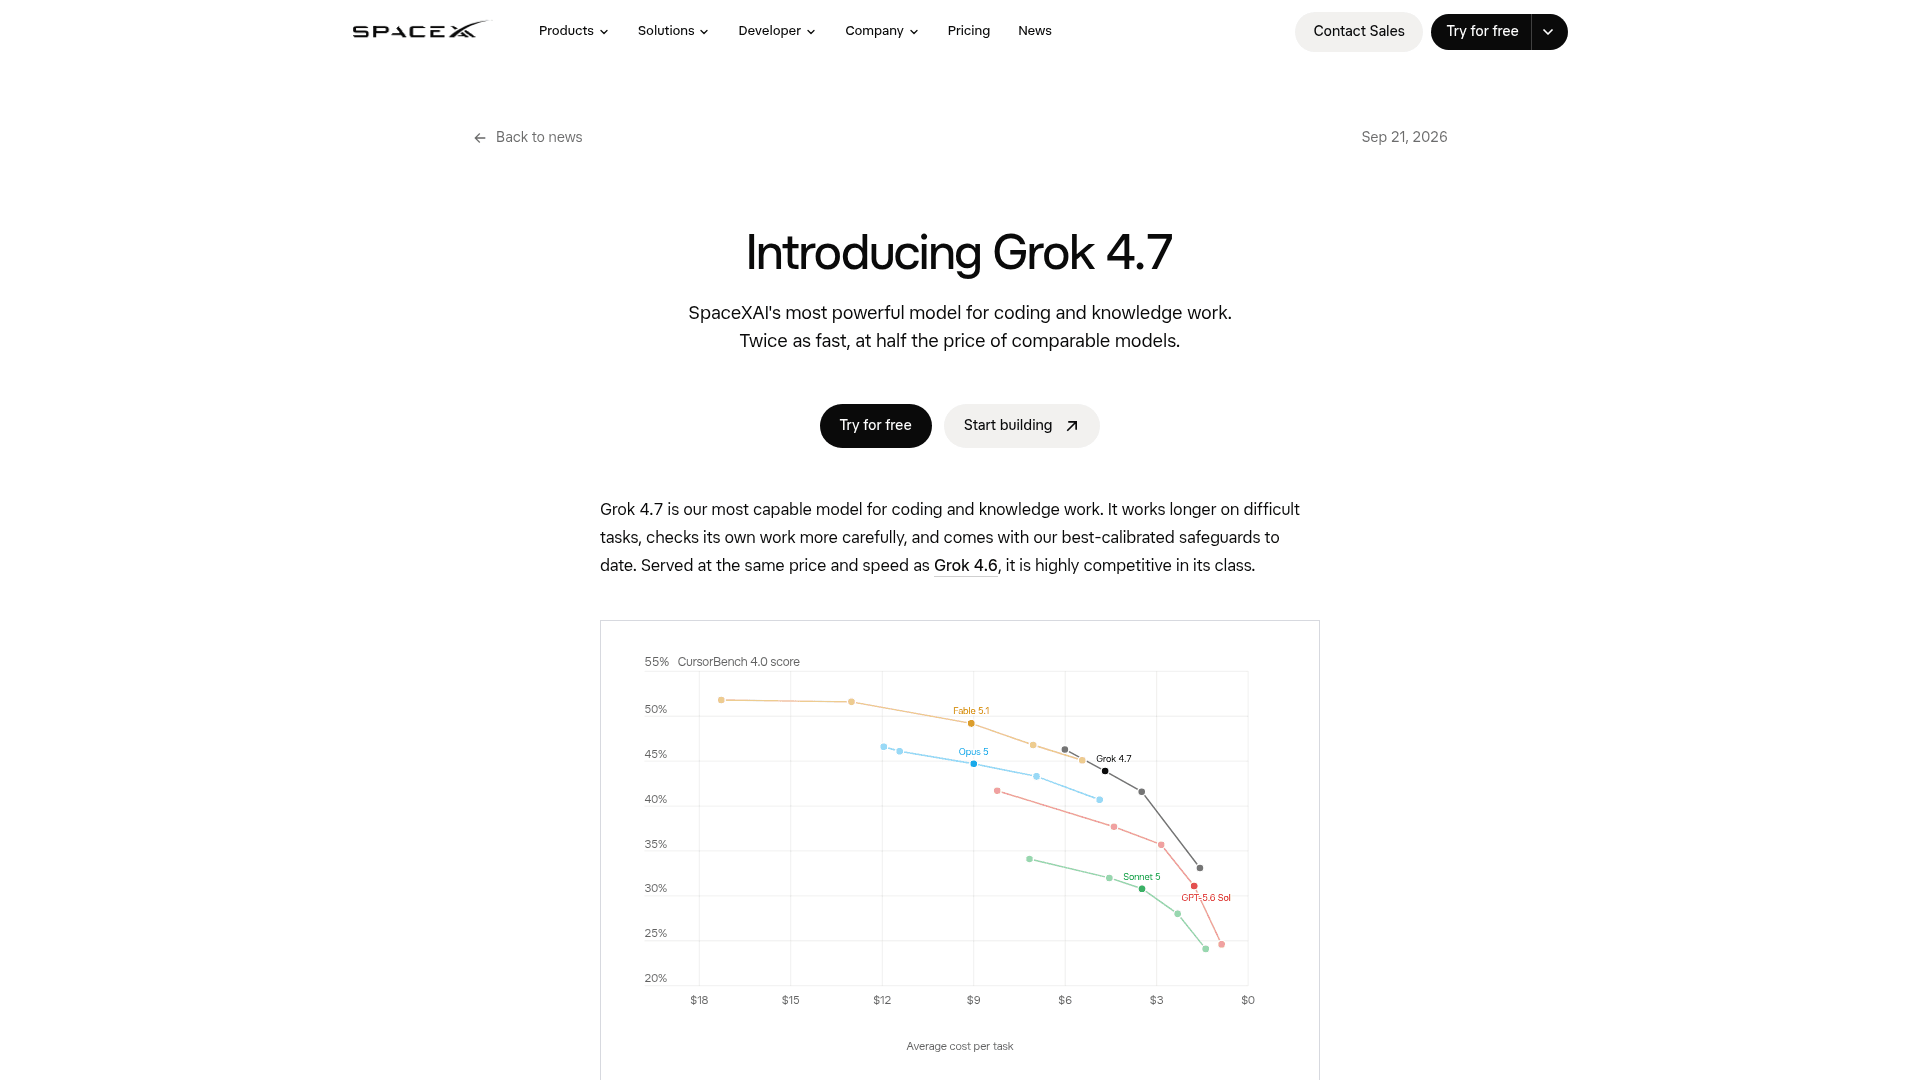
Grok 4.7 est le modèle phare de xAI pour le code, les agents et le travail de connaissance, publié sous le nom grok-4.7 sur l'API xAI. Il conserve la fenêtre de contexte de 500k tokens de Grok 4.6, accepte texte et image en entrée et renvoie du texte, et propose un effort de raisonnement configurable en faible, moyen, élevé et xÉlevé. Sa date limite de connaissances est mai 2026, et comme tout modèle Grok, il n'a aucune conscience des événements en direct sauf si vous activez les outils de recherche web et X côté serveur.
C'est la construction elle-même qui est intéressante. xAI a entraîné 4.7 sur un nouveau modèle de base plus grand que 4.6, puis a fait tourner un entraînement par renforcement plus long sur un mélange de tâches plus difficile, orienté vers des problèmes qui prennent de nombreuses heures. Il a aussi été entraîné à comprendre nativement l'environnement Grok Bot, ce qui explique pourquoi il paraît plus fluide sur du travail multi-étapes avec appels d'outils qu'un modèle de chat brut ne l'est habituellement. Une toute nouvelle fonctionnalité d'API l'accompagne : une API de compaction de contexte pour faire tenir de longs historiques sous le seuil tarifaire.
Grok 4.7 est le cerveau texte-et-code d'une gamme plus large, et cet avis ne porte que sur ce modèle. Si vous cherchiez les autres composants, xAI les sépare : Grok Imagine s'occupe de l'image et de la vidéo, l'API Grok Voice s'occupe de la parole, et le volet créateur d'agents se trouve dans Grok Bot. Tout ce qui suit concerne uniquement grok-4.7.
Ce qui a vraiment changé depuis Grok 4.6
La mise à niveau de Grok 4.5 vers 4.6 était incrémentale, comme le notait l'avis Grok 4.5. Le saut vers 4.7 ne l'est pas, du moins sur un point. La façon la plus claire de le voir, ce sont les écarts de benchmarks publiés par xAI.
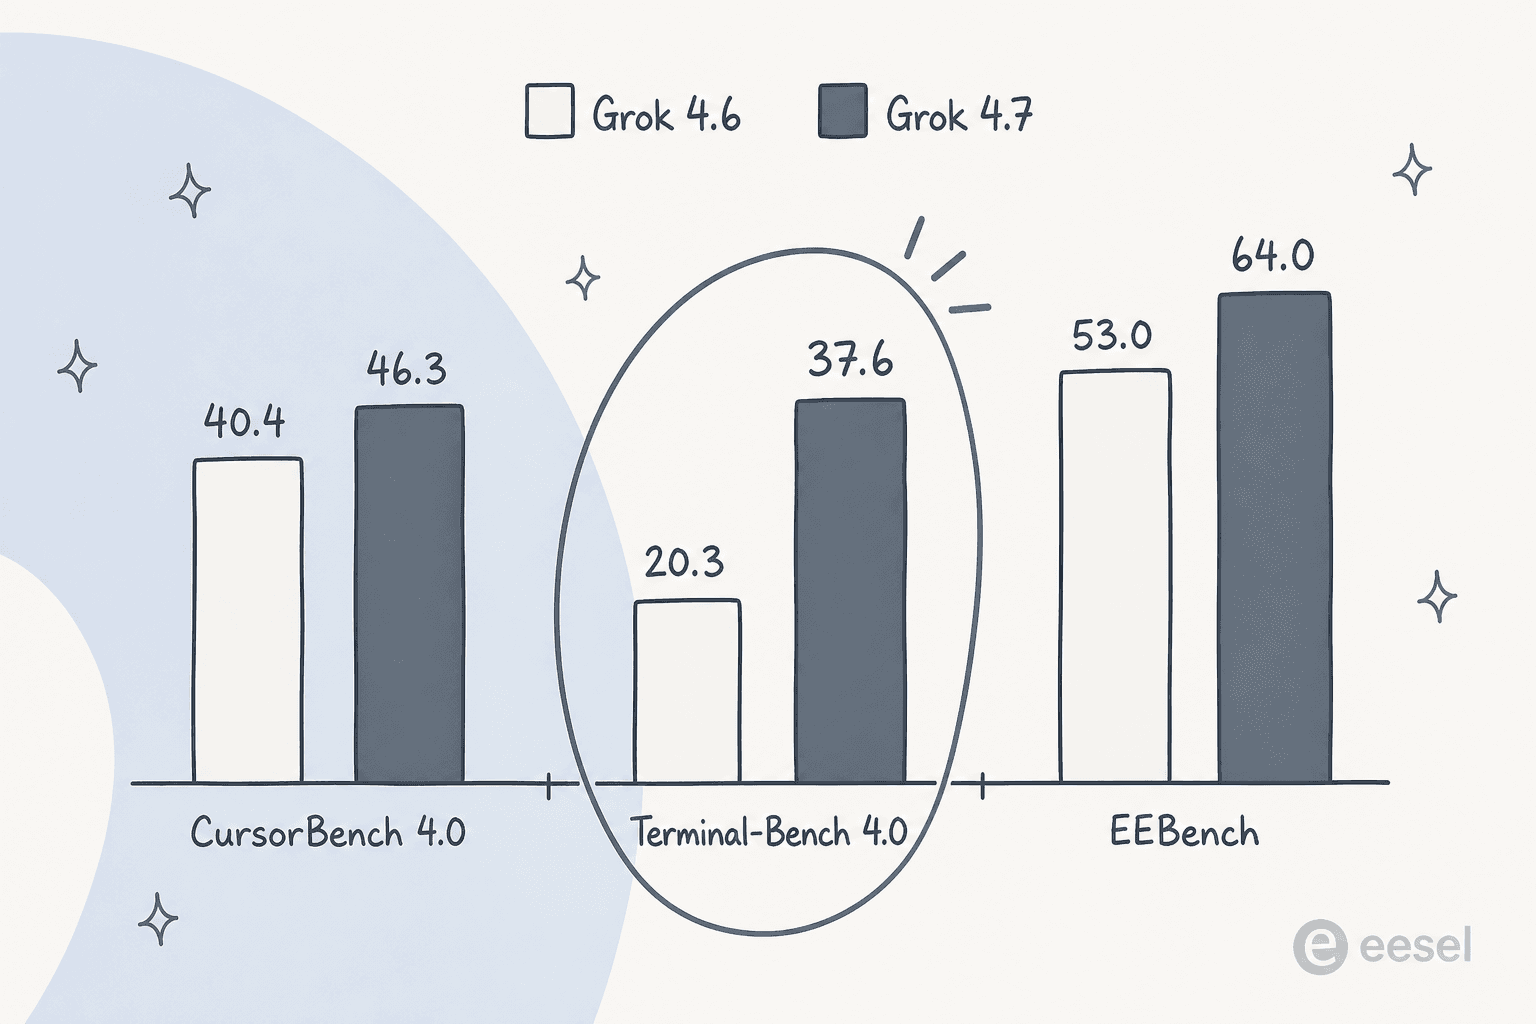
CursorBench 4.0 est passé de 40,4 à 46,3, et EEBench (génie électrique) de 53,0 à 64,0. Ce sont de solides progrès. Le plus marquant est Terminal-Bench 4.0, qui a quasiment doublé, passant de 20,3 à 37,6, le plus gros gain unique entre 4.6 et 4.7, et une mesure directe de la capacité du modèle à tenir un travail de terminal long et multi-étapes sans perdre le fil. Si votre cas d'usage est un agent qui avance dans une vraie liste de tâches plutôt que de répondre à un seul prompt, c'est le chiffre qui compte, et c'est celui que l'avis Grok 4.6 ne pouvait pas encore vous montrer.
Le reste des améliorations est plus discret : meilleure autovérification, gestion plus stable du contexte long, et sortie de documents et présentations renforcée, ce qui se traduit par des gains sur les benchmarks de travail professionnel GDPval et AA Briefcase. Rien de tout cela n'est gratuit ailleurs, et ici, ça arrive au même prix.
Les benchmarks, lus honnêtement
xAI a comparé Grok 4.7 xHigh à Grok 4.6 High, GPT-5.6 Sol Max et Fable 5.1 Max. Voici le tableau principal, tiré directement de la page de lancement, pour que vous voyiez à la fois où 4.7 gagne et où il ne gagne pas.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Entrée $/1M | $2 | $2 | $4 | $10 |
| Sortie $/1M | $6 | $6 | $20 | $50 |
| CursorBench 4.0 | 46.3 | 40.4 | 41.7 | 51.8 |
| DeepSWE v1.1 | 71.0* | 65.2 | 72.7 | 70.0 |
| Terminal-Bench 4.0 | 37.6 | 20.3 | 37.3 | 57.9 |
| EEBench | 64.0 | 53.0 | 39.4 | 56.4 |
| AA Briefcase v1.1 (Elo) | 1657 | 1546 | 1487 | 1678 |
| Harvey Legal Agent | 19.6 | 15.8 | 2.5 | 6.7 |
| HealthBench Professional | 56.7 | 48.5 | 60.5 | 62.1 |
*score en effort élevé. Source : xAI, lancement de Grok 4.7.
En le lisant équitablement, le tableau est clair. Grok 4.7 gagne nettement sur EEBench et le benchmark Harvey Legal Agent, où il plus que double le score de Fable, et reste compétitif partout ailleurs. Mais Fable 5.1 domine sur CursorBench, Terminal-Bench et AA Briefcase, GPT-5.6 Sol le devance légèrement sur DeepSWE, et sur HealthBench Professional, Grok 4.7 perd face aux deux. Donc si votre travail exige une précision de code maximale ou du raisonnement clinique et que le budget n'est pas un problème, Grok 4.7 n'est pas le bon choix. Si votre travail consiste à exploiter cette capacité à grand volume, le graphique suivant est celui qui tranche.
Le prix, c'est tout l'argument
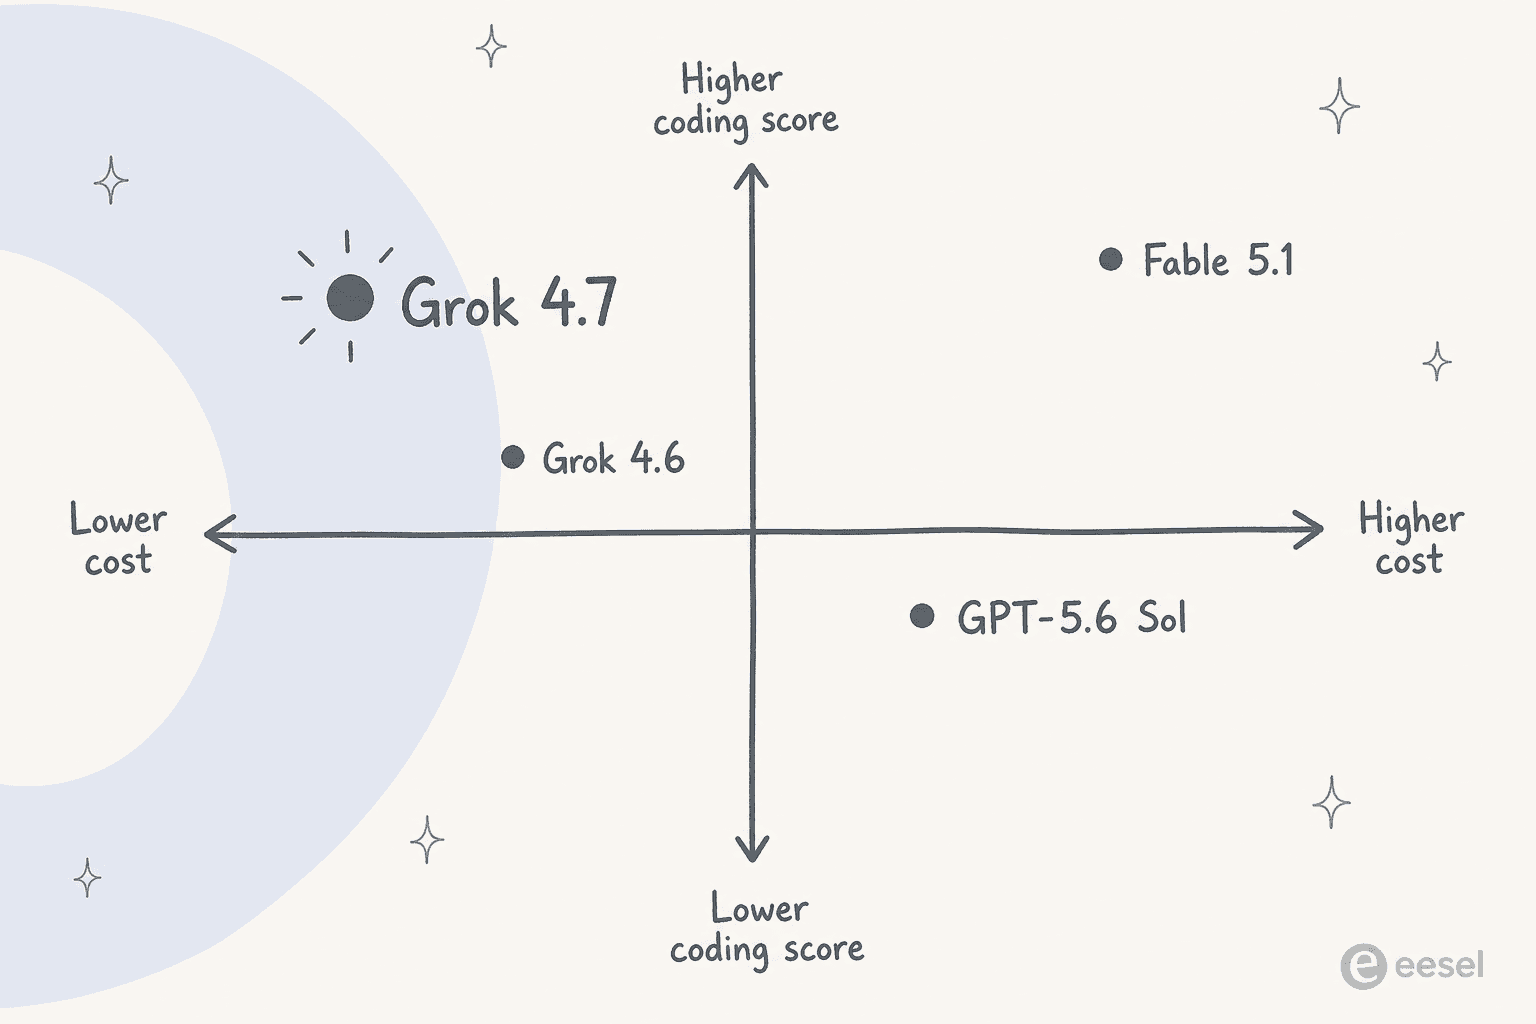
Grok 4.7 offre une capacité proche de Fable au tarif de Grok 4.6. Concrètement, une tâche qui lit 50k tokens et en écrit 10k coûte environ 0,16 $ sur Grok 4.7 contre 0,40 $ sur GPT-5.6 Sol et 1,00 $ sur Fable 5.1. Multipliez cela par un agent qui effectue des milliers d'exécutions par jour, et le choix du modèle cesse d'être une question de décimale de benchmark pour devenir une question de facture.
Deux réserves pour rester honnête. D'abord, le seuil des 200k : dépasser 200k tokens de prompt double le tarif à 4 $ / 1 $ / 12 $, appliqué à tous les tokens de la requête, pas seulement au dépassement, ce qui est exactement ce que l'API de compaction de contexte existe pour éviter. Ensuite, le graphique de lancement comparait à l'ancien GPT-5.6 Sol à 4 $ / 20 $, mais OpenAI a sorti GPT-6 Sol à 2 $ / 10 $ dès le lendemain, donc l'écart de prix de sortie réel est de 40 %, pas les 70 % suggérés par le graphique. Les tarifs xAI restent les plus solides de leur catégorie, juste avec une marge moins large que ne le laisse penser la diapositive. Le détail complet, compteur par compteur, se trouve dans le guide des tarifs Grok 4.7.
Il y a aussi la surtaxe de la variante Fast à connaître. Grok 4.7 Fast est le même modèle à deux fois la vitesse de sortie pour le double du prix par token, et il n'existe que dans Cursor et Grok Build, pas sur l'API publique. Cela vaut le coût quand vous regardez du code s'afficher en direct et que la latence gêne ; c'est de l'argent gaspillé sur des tâches par lots ou nocturnes où personne n'attend.
Je fais tourner des agents à grand volume (appels d'outils, travail de terminal)
Oui, passez au changement. C'est le point idéal. Le bond sur Terminal-Bench associé au tarif 2 $ / 6 $ est exactement ce que veut une boucle d'agents. Surveillez le seuil des 200k et utilisez Context Compaction.
J'ai besoin de la meilleure précision de code possible, coût mis à part
Restez sur Fable 5.1 pour les tâches les plus difficiles. De nombreuses équipes routent l'essentiel du travail vers Grok 4.7 et n'escaladent que les cas les plus exigeants vers un modèle plus coûteux.
Je fais du raisonnement clinique ou sensible à la santé
Ce n'est pas le bon choix. Grok 4.7 est derrière GPT-5.6 Sol et Fable 5.1 sur HealthBench Professional. Choisissez sur la base de ce benchmark, pas du prix.
Je veux que l'IA réponde aux tickets de support ou écrive mon blog
Un modèle brut est la mauvaise couche. Vous voulez un coéquipier qui connaît déjà votre produit et se branche sur vos outils. Passez à la dernière section.
La sécurité, que xAI a pris au sérieux cette fois
Cela mérite un paragraphe, car c'est un vrai changement. Grok 4.7 est sorti avec une pile de sécurité entièrement nouvelle et est, selon les propres tests de xAI, son modèle le plus solide en matière de refus et de résistance aux jailbreaks. Sur HackerBench v0.3, il ne laisse passer que 3,3 % des prompts à double usage risqués tout en bloquant rarement le travail de sécurité légitime, et il domine le benchmark de biosécurité de LatchBio avec 62,4 %. xAI a aussi commencé à donner à certains partenaires en cybersécurité un accès sur invitation aux capacités de red-team du modèle. Pour une entreprise dont les modèles précédents avaient été critiqués précisément sur cet axe, c'est une amélioration significative et vérifiable, pas une simple ligne de communiqué de presse.
Ce qu'en disent ceux qui construisent vraiment avec
Les benchmarks, c'est l'histoire racontée par xAI. Voici ce que rapportent les développeurs indépendants. Le signal le plus utile que j'ai trouvé concernait le périmètre : le modèle règle magnifiquement les petites choses en une fois, et l'enthousiasme retombe sur les grandes bases de code existantes.
"I agree, the models keep getting better at one shotting. That's useful in a lot of situations, like for small one-off scripts that filter/transform some tool call, or make a clever bash call. For the code itself, it doesn't help me much though."

Cela correspond à la forme des benchmarks : solide sur des tâches délimitées et bien spécifiées, moins magique quand le travail consiste à « comprendre ce dépôt de 200 000 lignes ». L'autre thème récurrent, c'est que les gros utilisateurs quotidiens atteignent rarement le plafond d'utilisation, ce qui compte si vous avez déjà été échaudé par des limites de crédits sur d'autres outils.
"I use the crap out of Grok in my daily life, including to build a couple self-hosted apps as an amateur. I have a Grok bot monitor my email every 15 minutes and file things away for me... and I never even get close to using my quota."
Les deux rejoignent le fil conducteur de cet avis : en tant que moteur bon marché et à haut débit sur lequel s'appuyer toute la journée, Grok 4.7 tient ses promesses. Ce qu'aucun des deux commentateurs ne décrit, c'est un système qui arrive déjà en connaissant leur entreprise, exactement la lacune que je veux combler dans la dernière section.
Qui devrait utiliser Grok 4.7
Tournez-vous vers lui si vous écrivez du code, faites tourner des agents ou construisez sur l'API et que le coût par tâche vous importe, ce qui concerne la plupart des gens qui construisent des produits IA en 2026. C'est le choix par défaut naturel pour les boucles d'agents à grand volume, et une base intelligente même si vous escaladez les 5 % de tâches les plus difficiles vers Claude Opus 5 ou Fable. Face au reste du peloton de pointe bon marché, c'est un généraliste plus solide sur le travail agentique que Kimi K3 ou DeepSeek V4 Flash.
Il bat aussi Qwen sur les tâches de terminal et fait moins cher que GPT-5.6 Sol sur le prix tout en égalant l'essentiel de sa capacité de code. Dans un éditeur, il est intégré à Cursor, donc au quotidien il rivalise avec les mêmes outils dont cette communauté débat déjà.
Passez votre chemin, ou du moins ne le mettez pas en avant, si vous avez besoin d'une précision de code maximale quel que soit le budget, si votre travail est clinique, ou si ce que vous voulez vraiment n'est pas un modèle mais un travail terminé. Ce dernier cas est plus courant que ne l'admet le cadre de l'avis de modèle, et c'est là que je veux être direct.
La partie qu'un avis de modèle oublie généralement : un moteur n'est pas un employé
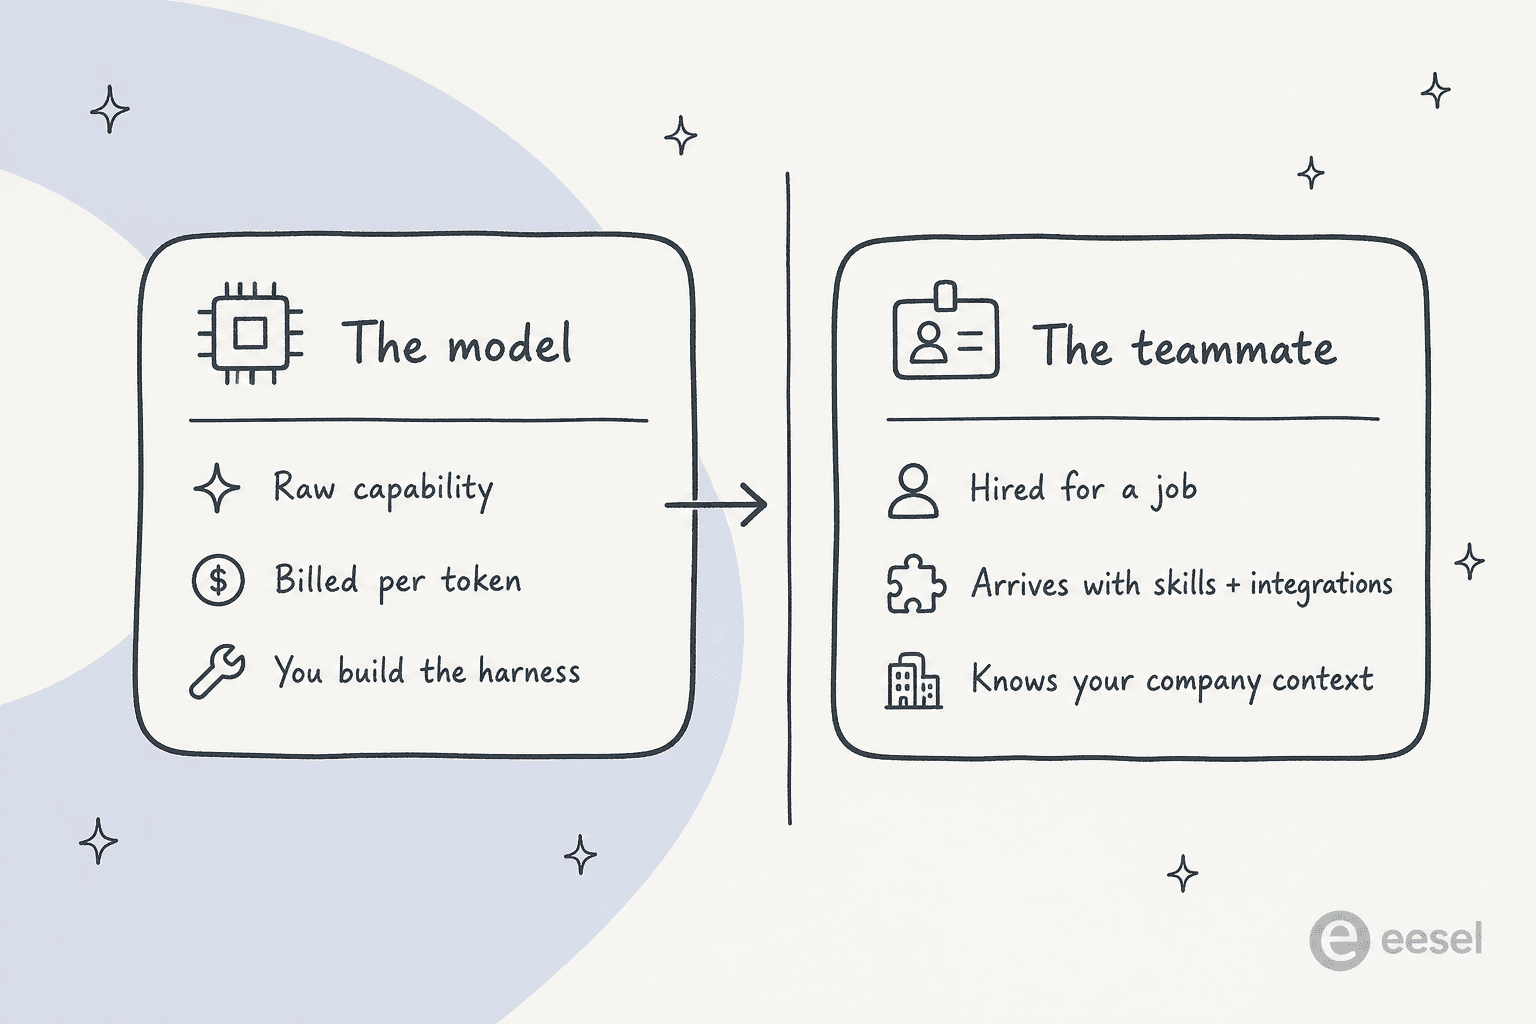
Voici ce que trois ans à déployer de l'IA sur des files de support en production m'ont appris. Un modèle de pointe est un moteur incroyablement capable, et un moteur n'est pas la même chose qu'un employé. Grok 4.7 vous donne de l'intelligence brute au token. Il ne connaît pas votre politique de remboursement, il n'est pas connecté à votre helpdesk, il n'a jamais vu vos anciens tickets, et il ne décidera pas de lui-même quelles questions il est assez confiant pour traiter et lesquelles laisser à un humain. Câbler tout cela est un vrai projet, et c'est la partie sur laquelle le score de benchmark reste muet.
C'est un arbitrage construire-ou-acheter qui finit par se poser à chaque équipe. Un client, une entreprise d'infrastructure, l'a exprimé simplement :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
C'est la lacune que eesel est conçu pour combler. eesel est une plateforme de coéquipiers IA, et vous embauchez des coéquipiers prêts à l'emploi pour des travaux précis plutôt que de louer des tokens bruts. L'offre actuelle comprend un coéquipier IA pour le helpdesk qui rejoint votre file de support existante, et un rédacteur de blog IA aux côtés des meilleurs outils d'écriture IA pour du contenu digne d'une recherche approfondie. Chacun arrive déjà construit sur des modèles de pointe, et déjà porteur des compétences, intégrations et du contexte d'entreprise nécessaires à son rôle.
Le coéquipier support s'entraîne sur vos tickets historiques, rédige des brouillons ou répond entièrement dans votre ton, et ne traite que ce dont il est confiant, exactement le contrôle que l'approche modèle-au-token vous oblige à concevoir vous-même. Cette différence, c'est tout l'argument de agent IA contre chatbot à base de règles, et c'est pourquoi l'IA pour le service client est une catégorie de produit, pas juste un prompt.
La preuve est dans la file, pas dans le benchmark. Un client, une plateforme de mobilité, a vu eesel résoudre 73 % des demandes de niveau 1 dès le premier mois, et un autre a rapporté jusqu'à 80 % de gain de temps sur le support. Ce sont des chiffres qu'on obtient d'un coéquipier qui connaît le métier, pas d'un modèle qui a bien scoré sur Terminal-Bench. Si vous pesez encore le côté coût, le détail agent IA contre coût d'un agent humain et le paysage plus large des logiciels de service client IA sont les prochaines lectures que je recommanderais.
Si vous voulez vraiment piloter le modèle vous-même
Pour les développeurs auxquels s'adresse Grok 4.7, il existe une voie intermédiaire qui mérite d'être connue. eesel propose une interface en ligne de commande et un serveur MCP qui exposent le même coéquipier et le même espace de travail d'une manière adaptée aux agents. Une personne peut le piloter depuis un terminal, des scripts peuvent l'automatiser, et des agents de code comme Claude Code, Codex et Cursor peuvent l'exploiter directement. Vous obtenez ainsi le contrôle programmable et sans interface qui vous intéressait déjà dans une API brute, mais dirigé vers un coéquipier qui connaît déjà votre entreprise plutôt qu'un modèle vierge qu'il faut réenseigner à chaque exécution. C'est le même réflexe qui sous-tend l'automatisation du tri des tickets depuis le code plutôt qu'en cliquant dans un tableau de bord.
Envie de le voir sur vos propres tickets ? eesel se branche sur votre helpdesk en quelques minutes, s'entraîne sur votre historique, et vous permet de simuler sur des milliers de tickets passés avant de répondre au premier ticket en direct. Gratuit à essayer.

Mon verdict
Grok 4.7 est un modèle facile à recommander pour ce qu'il est : le meilleur rapport qualité-prix à la pointe, surtout pour les agents et le code à grand volume. Ce n'est pas le modèle le plus intelligent sur tous les axes, et le graphique de lancement surestime désormais l'écart de prix maintenant que GPT-6 Sol existe, mais pour un travail sensible au coût, c'est celui vers lequel je me tournerais en premier. Souvenez-vous juste de ce que vous achetez. Un modèle vous donne de la capacité au token. Si ce dont vous avez besoin, c'est un travail fait de manière fiable, cela demande un coéquipier, et c'est un achat complètement différent.
Questions fréquentes
Grok 4.7 est-il bon ?
Pour le code et le travail agentique à faible coût, oui. Dans mon avis Grok 4.7, il enregistre la plus grosse progression de toutes les récentes sorties de xAI sur les tâches de terminal longues et reste à la pointe du rapport prix-performance. Ce n'est pas le modèle le plus intelligent sur tous les tableaux, puisque Fable 5.1 de Claude domine toujours le code de pointe et le travail de terminal, mais c'est le meilleur rapport qualité-prix de sa catégorie.
Combien coûte Grok 4.7 ?
Grok 4.7 coûte 2 $ par million de tokens en entrée, 0,50 $ en cache et 6 $ en sortie en dessous de 200k tokens de prompt, puis 4 $ / 1 $ / 12 $ une fois qu'une requête dépasse les 200k, selon la page tarifaire de xAI. C'est identique à Grok 4.6. Le détail complet, y compris les compteurs de recherche et d'exécution de code, se trouve dans le guide des tarifs de Grok 4.7.
Grok 4.7 est-il meilleur que GPT-5.6 Sol ?
Sur le propre ensemble de benchmarks de xAI, Grok 4.7 bat GPT-5.6 Sol sur la plupart des tâches de code et agentiques, pour une fraction du prix, même si Sol garde une légère avance sur le raisonnement clinique. À noter qu'OpenAI a depuis lancé GPT-6 Sol à 2 $ / 10 $, donc l'écart de prix réel est plus resserré que ne le suggère le graphique de lancement.
Quelle est la différence entre Grok 4.7 et Grok 4.6 ?
Grok 4.7 tourne sur un modèle de base plus grand et un entraînement par renforcement plus long, orienté vers des tâches de plusieurs heures. Il enregistre les plus gros gains sur Terminal-Bench 4.0, en quasiment doublant le score de 4.6. Les deux conservent la fenêtre de contexte de 500k et la même tarification, c'est donc un gain de capacité gratuit. L'avis Grok 4.6 couvre la version précédente.
Grok 4.7 est-il bon pour coder ?
Le code est son point fort principal. Il obtient 46,3 % sur CursorBench 4.0 et bat Grok 4.6 sur tous les benchmarks logiciels publiés par xAI. Il est intégré dans Cursor et Grok Build, et les développeurs de la communauté rapportent qu'il excelle pour générer des scripts en une seule fois, même s'il est moins transformateur sur de grandes bases de code existantes.
Qu'est-ce que Grok 4.7 Fast ?
Grok 4.7 Fast est le même modèle à deux fois la vitesse de sortie pour le double du prix par token, disponible uniquement dans Cursor et Grok Build, pas sur l'API publique. Cela vaut le coût quand la latence compte, par exemple pour regarder du code s'afficher en direct, et c'est superflu pour les tâches par lots ou nocturnes. Voir l'aperçu des tarifs xAI.


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.





Comment accéder à Grok 4.7 ?
Vous pouvez l'appeler sur l'API xAI sous le nom
grok-4.7, l'utiliser gratuitement dans Grok Build, ou y accéder dans Cursor. Si vous voulez que cette intelligence effectue un travail défini plutôt que des tokens bruts, un coéquipier IA intègre un modèle de pointe avec les compétences, intégrations et le contexte d'entreprise nécessaires pour un vrai rôle comme l'automatisation du support.