

L'erreur que tout le monde commet à la première intégration
Je construis des intégrations chez eesel, et je peux vous dire que la première estimation d'une intégration d'agent IA se trompe presque toujours dans le même sens.
Quelqu'un lit la documentation API d'un fournisseur, voit une liste bien propre d'endpoints, et cadre le travail comme « appeler cet endpoint, transmettre la réponse au modèle, terminé ». Puis on démarre, et une semaine s'évapore dans les cycles de vie des webhooks, les événements dupliqués, et un modèle de permissions que personne n'avait dessiné au tableau. La référence API était la partie facile. C'est la carte d'un pays qu'il faut encore réellement traverser.
J'ai passé des années à déployer des agents IA sur des systèmes en production, à travers des milliers d'intégrations réelles, et le schéma se vérifie à chaque fois. Alors plutôt qu'un énième tutoriel « voici comment faire une requête POST », cet article porte sur la forme du travail dans son ensemble : de quoi est vraiment faite une intégration API pour agent IA, où va vraiment le temps, et les deux ou trois décisions qui vous épargnent le plus de douleur.
Une intégration d'agent IA, ce sont trois surfaces, pas une
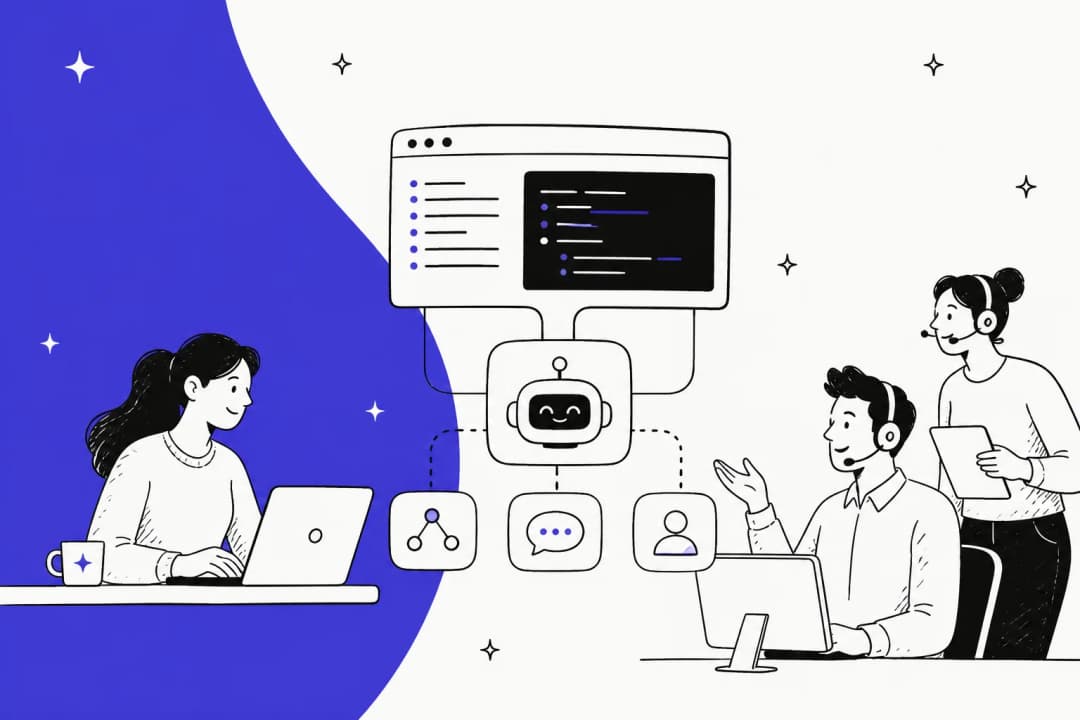
La reformulation la plus utile : une intégration n'est pas « une connexion à un outil ». Ce sont jusqu'à trois choses distinctes que vous donnez à l'agent, et elles sont indépendantes.
- Les sources sont ce que l'agent peut lire : tickets, articles de centre d'aide, conversations passées, une base de connaissances. C'est le côté récupération d'information, le contexte sur lequel l'agent raisonne.
- Les triggers sont les raisons pour lesquelles l'agent se réveille : un nouveau ticket arrive, quelqu'un le mentionne avec un @, un webhook se déclenche, une planification arrive à échéance.
- Les actions sont les choses qu'il est autorisé à faire en retour : rédiger une réponse, taguer un ticket, escalader, mettre à jour un enregistrement, appeler une autre API.
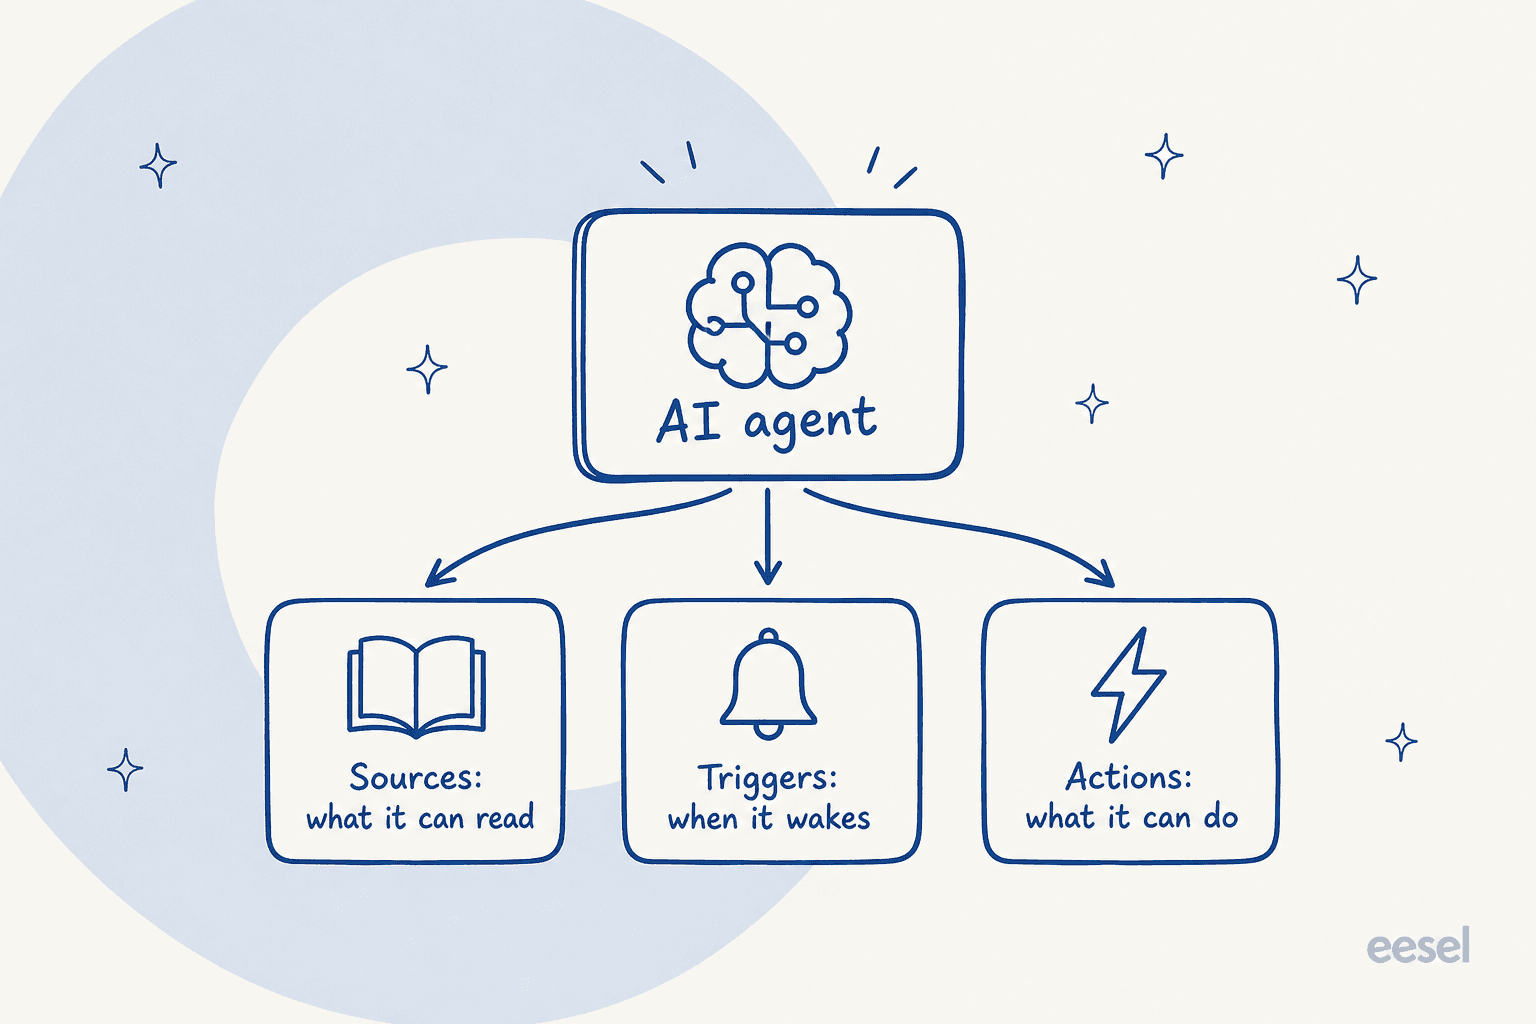
Voici ce qui mérite d'être intériorisé : un système peut vous donner une, deux, ou les trois, et chacune représente un type de travail différent. Connecter un site de documentation, c'est généralement seulement des sources. Connecter un helpdesk, c'est souvent les trois. Et dire « intégrer X » sans préciser laquelle des trois vous voulez dire, c'est exactement comment les estimations dérapent. Sur la page d'intégrations d'eesel, le sous-titre auquel l'équipe est arrivée est littéralement « connectez des intégrations pour donner à votre agent des sources de connaissances, des triggers et des actions », parce que ce cadrage est ce qui rend le travail lisible.
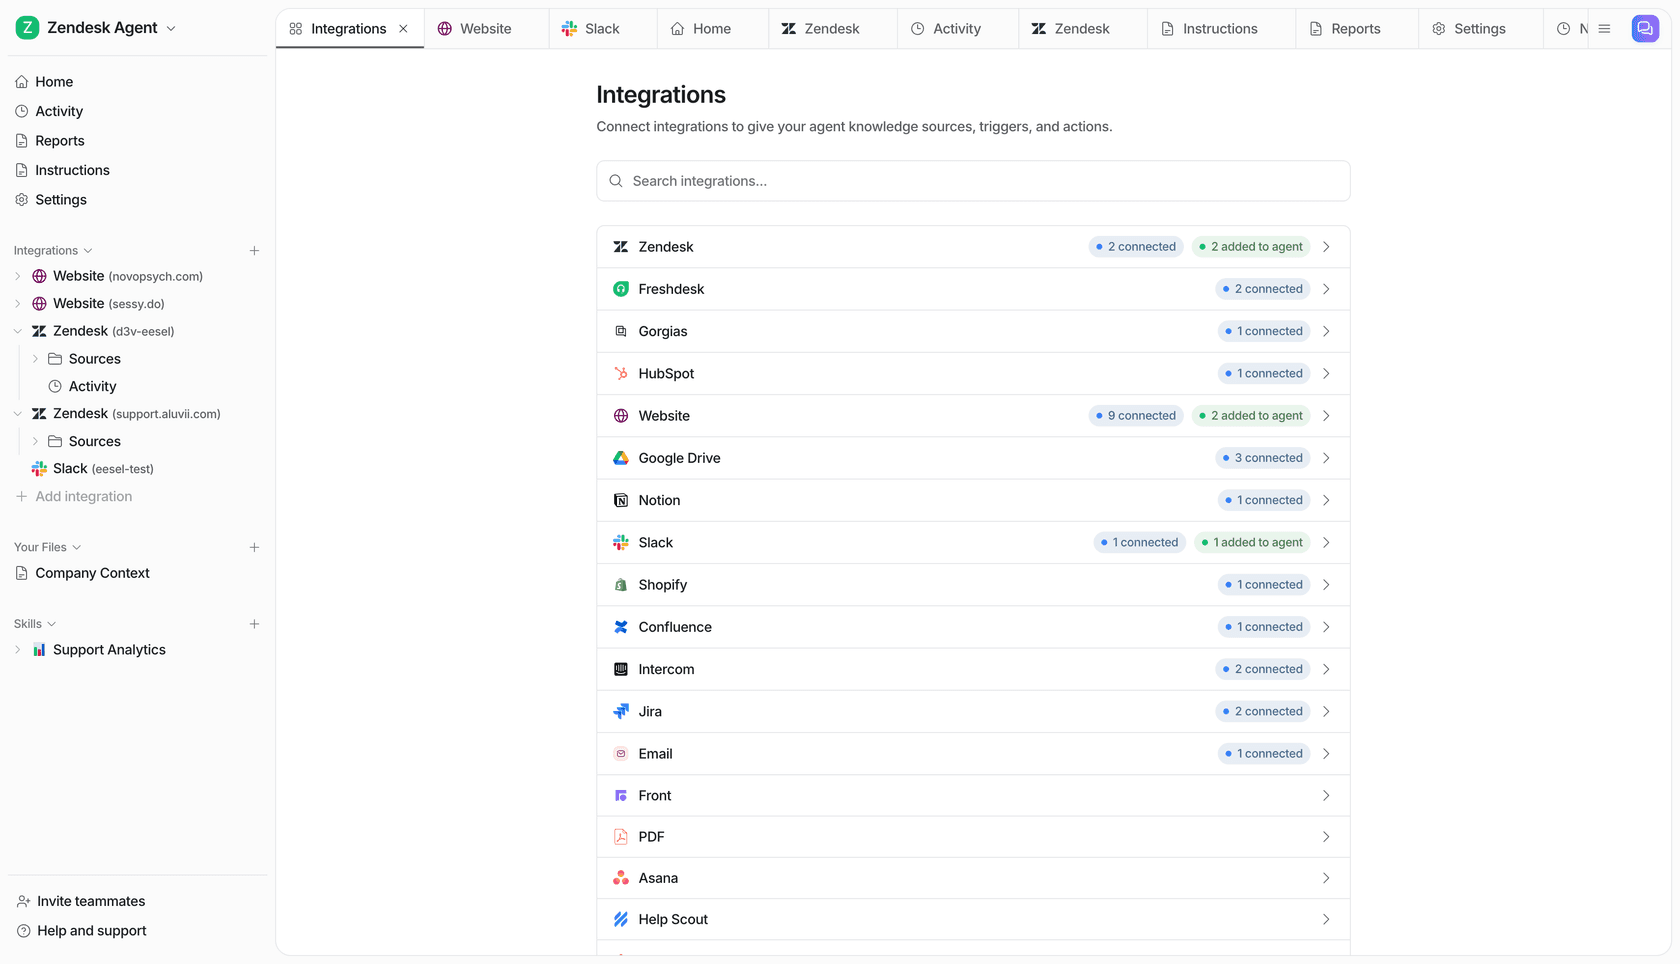
C'est aussi pourquoi un agent IA n'est pas un chatbot à base de règles auquel on a greffé une API. Un chatbot a besoin d'un trigger et d'une réponse toute faite. Un agent a besoin des trois surfaces travaillant ensemble, parce qu'il lit le contexte, décide, et agit.
Où va vraiment le travail
Si vous ne devez retenir qu'un chiffre de cet article, retenez celui-ci : sur une intégration réelle, l'appel API en lui-même représente environ les 20 derniers pourcents de l'effort. Les triggers et la plomberie événementielle s'approchent de la moitié. Les actions et les permissions prennent la majeure partie du reste.
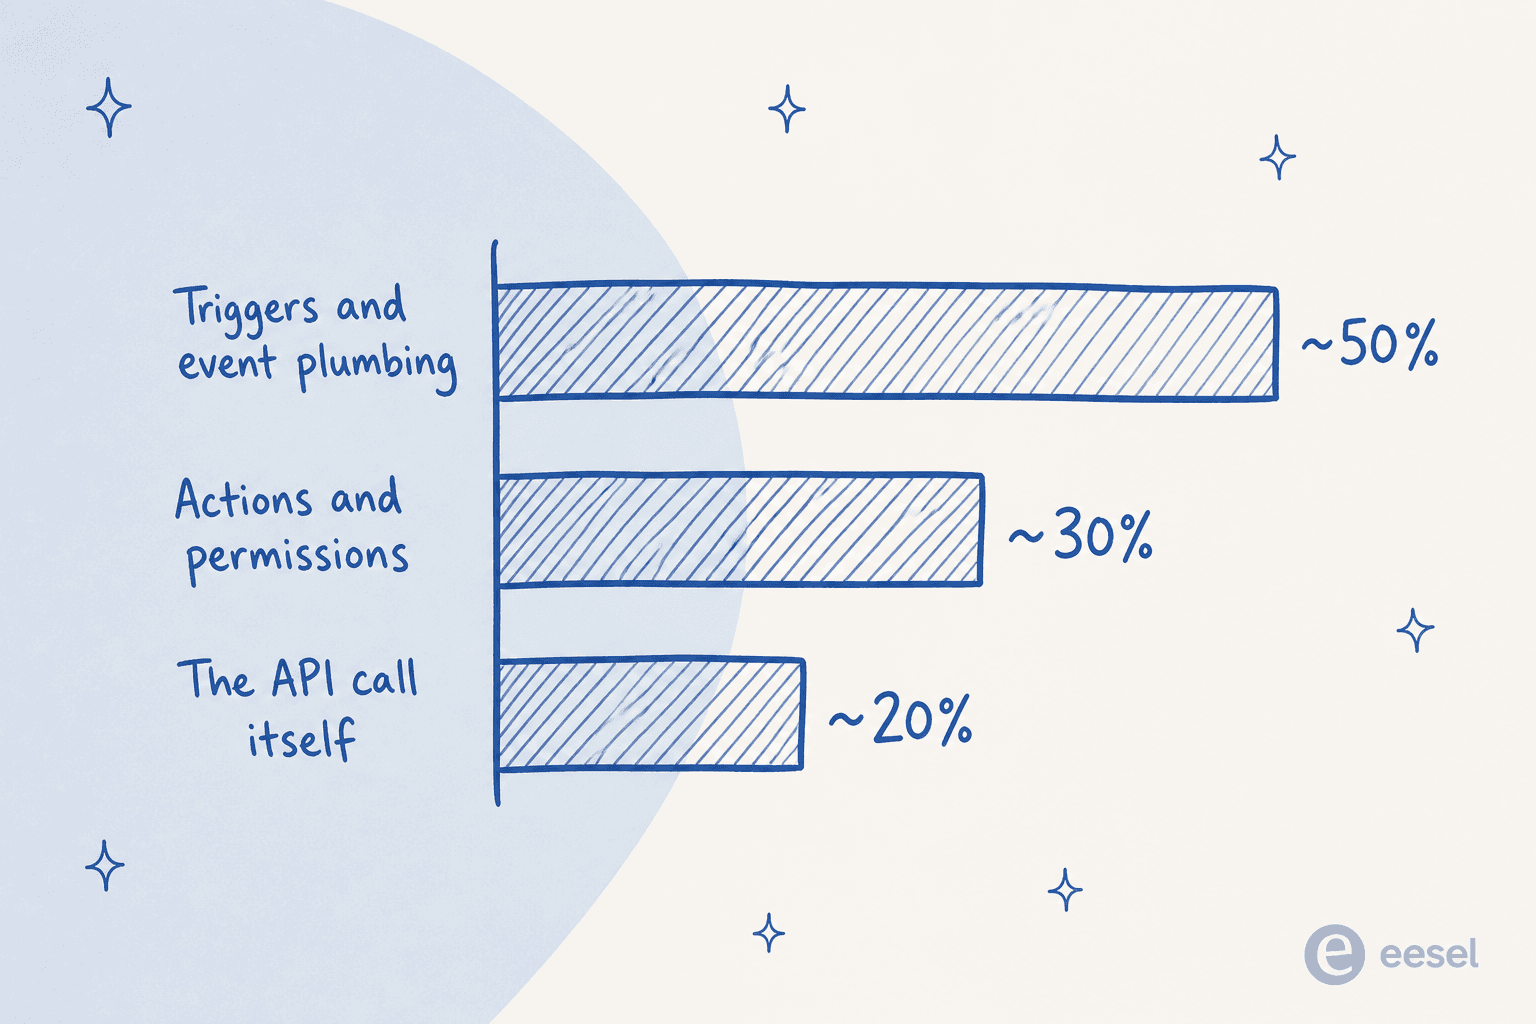
Cette répartition surprend les gens, alors voici pourquoi les triggers pèsent si lourd.
Chaque plateforme gère les événements différemment. Certaines envoient des webhooks propres. Certaines vous obligent à construire des règles d'automatisation dans leur interface. Certaines n'ont pas de véritable système d'événements et vous finissez par interroger une API sur une minuterie. Une fois les événements arrivés, il faut les dédupliquer, parce que les plateformes déclenchent joyeusement le même événement deux fois, et un agent qui répond deux fois au même ticket, ça fait mauvais genre. Les abonnements webhooks ont des cycles de vie qu'il faut créer et nettoyer par client, sinon ils deviennent orphelins et cessent silencieusement de se déclencher des mois plus tard.
Et puis il y a les comportements que personne ne documente. Le cas canonique qui m'a coûté de vraies heures : Freshdesk ne déclenche silencieusement jamais ses règles d'automatisation pour les tickets créés par un agent. Rien dans la documentation ne le dit. Vous observez simplement votre trigger ne pas se déclencher, et vous y perdez un après-midi. Chaque plateforme mature a une poignée de ces cas, et on ne les trouve qu'en confrontant le système à du trafic réel. C'est exactement le genre de lacune autour de laquelle l'intégration Freshdesk d'eesel a dû être construite, et c'est pourquoi eesel simule désormais chaque déploiement sur l'historique réel d'un client avant sa mise en service.
On entend la même chose de la part de développeurs qui se débattent avec ça en dehors du support client :
"So I've been messing around with a few AI agents trying to get them to fit into the workflow at my company. We've got a mix of legacy systems and some..."

La partie sur les systèmes hérités et « quelques autres » raconte toute l'histoire. Le « quelques autres », c'est toujours là que vivent les surprises.
Les deux décisions qui vous épargnent le plus de douleur
Une fois qu'on accepte que la plomberie est le vrai travail, deux choix de conception font l'essentiel du travail pour garder une intégration saine.
Construire un connecteur, ou confier une clé à l'agent ?
Toutes les intégrations ne méritent pas le même investissement. Il y a une vraie bifurcation ici, et choisir la mauvaise branche, c'est exactement comment les équipes sur-construisent.
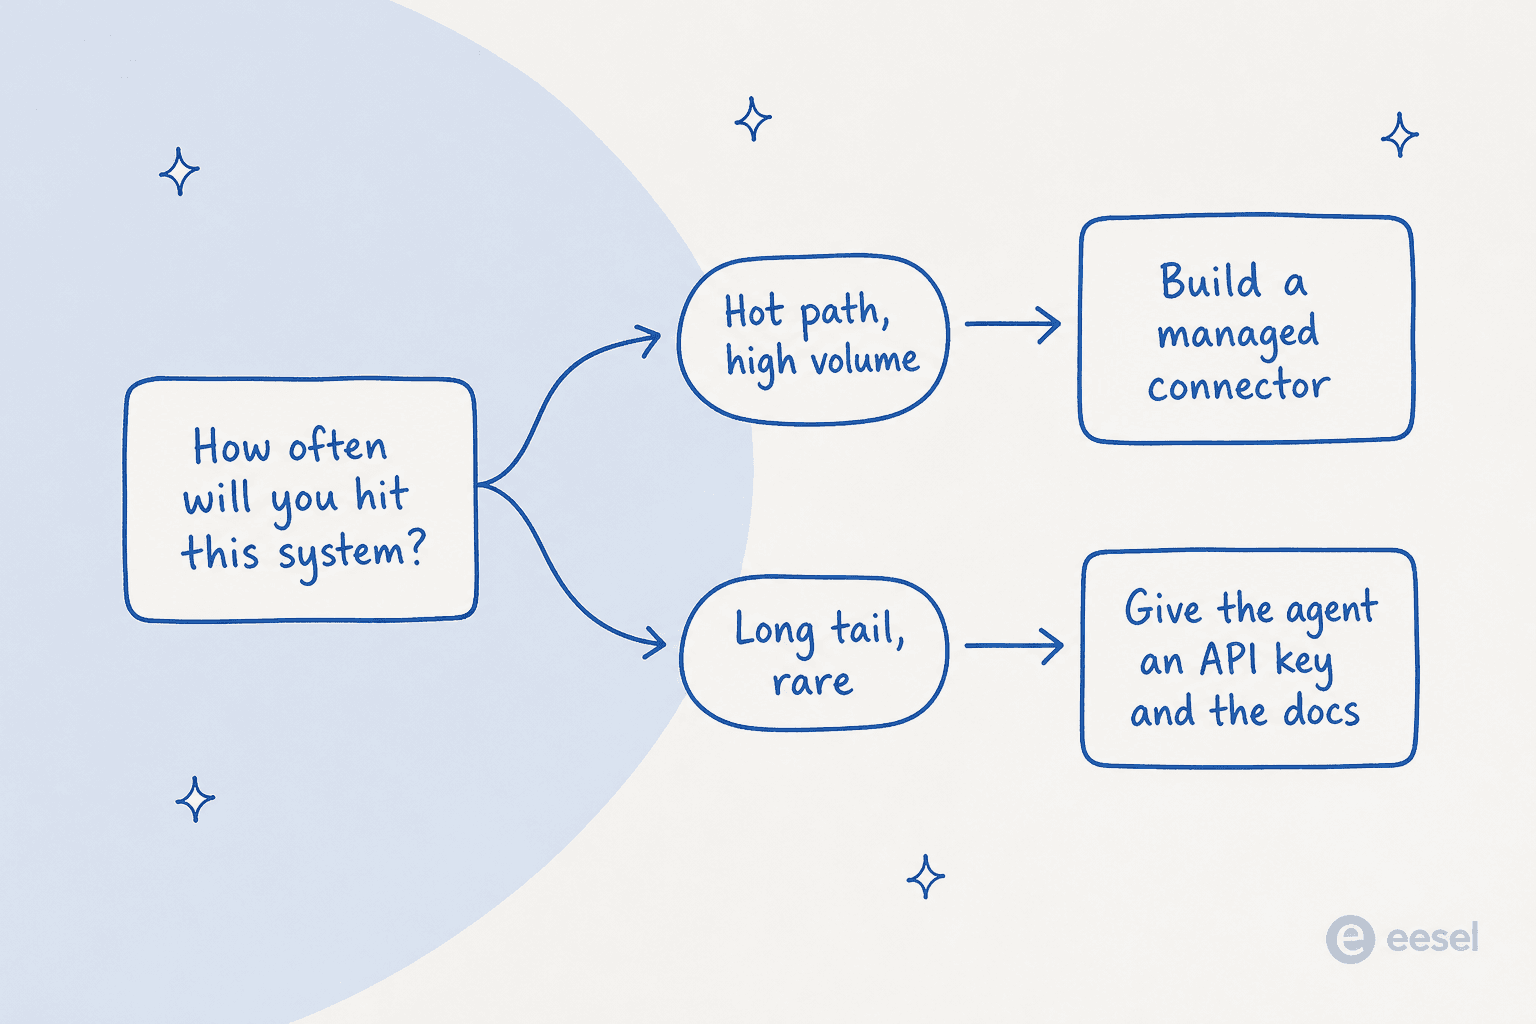
Pour un chemin critique, un système que votre agent sollicite en permanence, construisez un vrai connecteur : authentification gérée, actions préconstruites, déduplication, tentatives de nouvelle exécution, tout l'attirail. Le coût initial se rentabilise chaque jour.
Pour la longue traîne, les systèmes que vous touchez rarement ou qui sont propres à un seul client, ce même investissement est du gaspillage. Je l'ai réellement testé : donnez à l'agent une clé API, la documentation API du fournisseur, et un court script de référence, et pour des intégrations ponctuelles, cela a surpassé la construction d'un wrapper soigné pour l'outil du fournisseur. Les agents modernes savent bien lire la documentation API et formuler des requêtes. Laissez-les faire. C'est toute l'idée derrière le fait de donner à un agent un accès réseau à un domaine autorisé plutôt que de préconstruire un connecteur pour chaque outil possible. Les développeurs retombent sans cesse sur le même arbitrage :
"APIs are glue, but they're messy glue. Documentation can be outdated, authentication flows differ, and error..."
Une colle désordonnée, c'est exactement la longue traîne. Vous ne voulez pas construire à la main un connecteur pour chaque coin désordonné. Vous voulez que l'agent lise la documentation et se débrouille.
Se lier à l'instance, pas à la plateforme
Celui-ci est subtil et il finira par vous mordre. « Zendesk la plateforme » et « ce Zendesk spécifique de ce client » ne sont pas la même chose. Si vous modélisez votre intégration autour de la plateforme, vous finirez par activer une action pour un client et par voir cela affecter silencieusement un autre, parce que votre code a lié l'action à « Zendesk » plutôt qu'à cet espace de travail précis.
Tout ce qui a la forme d'une intégration — sources, triggers, actions, identifiants — doit se lier à l'instance spécifique. Écrit noir sur blanc, ça paraît évident. Ça ne l'est pas à 2h du matin quand une permission fuit d'un tenant à l'autre. Réglez cela correctement dans le modèle de données dès le premier jour, et vous n'y repenserez plus jamais. Ratez-le, et c'est une réécriture.
Les parties de la plomberie qu'on oublie
Au-delà des trois surfaces, une intégration API pour agent IA en production a besoin de quelques éléments qui n'apparaissent jamais dans la démo du chemin idéal.
Une authentification que le modèle ne voit jamais. Les identifiants doivent être stockés sous forme d'en-têtes ou de secrets que la couche d'intégration attache, pas des valeurs qui passent un jour par le contexte du modèle. Le principe derrière la fonctionnalité Network Access d'eesel est exactement celui-ci : vous autorisez un domaine et ajoutez un en-tête d'authentification une fois pour toutes, l'agent peut ensuite appeler cette API, et l'identifiant n'est jamais montré à l'IA. C'est la différence entre une intégration sûre et une intégration à une fuite de clé d'un incident.
Des actions cadrées avec un humain dans la boucle pour les plus risquées. Lire des données est peu risqué. Écrire des données, rembourser une commande, supprimer un enregistrement, ne l'est pas. Chaque action que l'agent peut entreprendre devrait être cadrée au moindre privilège, et les actions destructrices devraient rester verrouillées derrière une validation jusqu'à ce que vous leur fassiez confiance. Une bonne API d'agent de support client fait de « rédiger sans envoyer » et « proposer mais exiger une validation » des états de première classe, pas des idées après coup.
Un journal d'audit que vous pouvez réellement lire. Quand un agent fait quelque chose de surprenant, et cela arrivera, la première question est « qu'a-t-il vu, et qu'a-t-il fait ? ». Si votre intégration ne peut pas répondre rapidement à cela, vous déboguez à l'aveugle. C'est pourquoi l'observabilité compte autant que la connexion elle-même.
Choisir sa surface d'intégration
« Via API » n'est pas la seule façon de connecter un agent, et ce n'est souvent pas la meilleure. La surface que vous choisissez doit correspondre à la tâche. Voici comment les options courantes se comparent réellement.
| Surface | Idéale pour | Ce qu'elle vous apporte | À surveiller |
|---|---|---|---|
| API REST | Applications sur mesure, appels service à service | Contrôle total, votre code possède le flux | Vous construisez vous-même l'authentification, les nouvelles tentatives, la déduplication et les événements |
| Webhooks | Réveiller l'agent sur un événement | Un trigger propre, sans polling | Gestion du cycle de vie, déduplication, et abonnements orphelins |
| Serveur MCP | Laisser un client IA utiliser vos outils | Interface d'outils standard que tout client MCP peut appeler | Standard récent ; tous les clients ne le parlent pas encore |
| CLI | Scripting, CI, ops-as-code | Scriptable, sortie JSON, essai à blanc avant écriture | Une personne ou un script doit la piloter |
| Connecteur préconstruit | Plateformes à chemin critique (helpdesks, CRM) | Authentification, actions et événements gérés d'emblée | Vous dépendez de la couverture du fournisseur pour cette plateforme |
La plupart des configurations réelles mélangent tout cela. Vous pourriez réveiller l'agent avec un webhook, le laisser lire depuis des sources préconstruites, entreprendre des actions via un connecteur géré, et atteindre un système de longue traîne via un accès réseau brut. Si vous voulez la comparaison plus approfondie de quand chaque surface convient, j'ai écrit un article entier sur l'accès programmatique aux agents IA et un autre sur pourquoi une plateforme API-first se comporte différemment de celle où l'API a été greffée plus tard.
La version honnête du conseil : si vous intégrez un agent dans votre helpdesk, ne construisez rien de tout cela à la main. Si vous intégrez dans quelque chose de sur mesure, attendez-vous à la plomberie, cadrez le projet en conséquence, et appuyez-vous sur l'agent lui-même pour la longue traîne.
Essayez eesel pour le volet helpdesk
Si l'agent que vous connectez est censé gérer le support client, les trois surfaces ci-dessus sont déjà construites. eesel est un coéquipier helpdesk IA qui se branche sur votre stack existant comme le ferait une nouvelle recrue, et traite chaque connexion comme des sources, des triggers et des actions dès le premier jour.
Cela veut dire que les parties qui dévorent votre calendrier d'intégration — la gestion des événements pour Zendesk ou Freshdesk, la liaison par instance, les actions cadrées avec validations, un journal d'activité auditable — sont déjà prises en charge. Et quand vous voulez garder le contrôle par le code, il y a une CLI, un serveur MCP sur chaque espace de travail, des webhooks pour réveiller l'agent, et un accès réseau pour la longue traîne. Vous pouvez tout simuler sur votre historique de tickets réel avant que cela ne touche un client, et la tarification est basée sur l'usage, donc vous ne payez pas par poste pour une intégration que vous êtes encore en train de tester.
C'est le moyen le plus rapide de vous épargner la plomberie décrite dans tout cet article, au moins pour le volet helpdesk de votre stack. Essayez eesel gratuitement.
Questions fréquentes
Qu'implique réellement une intégration API pour un agent IA ?
Ai-je besoin d'une API REST pour intégrer un agent IA, ou existe-t-il une autre solution ?
Pourquoi est-il si difficile de connecter des agents IA à des outils et des API externes ?
Faut-il construire un connecteur géré ou confier à l'agent une clé API ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.




Comment sécuriser une intégration API pour agent IA ?