En bref
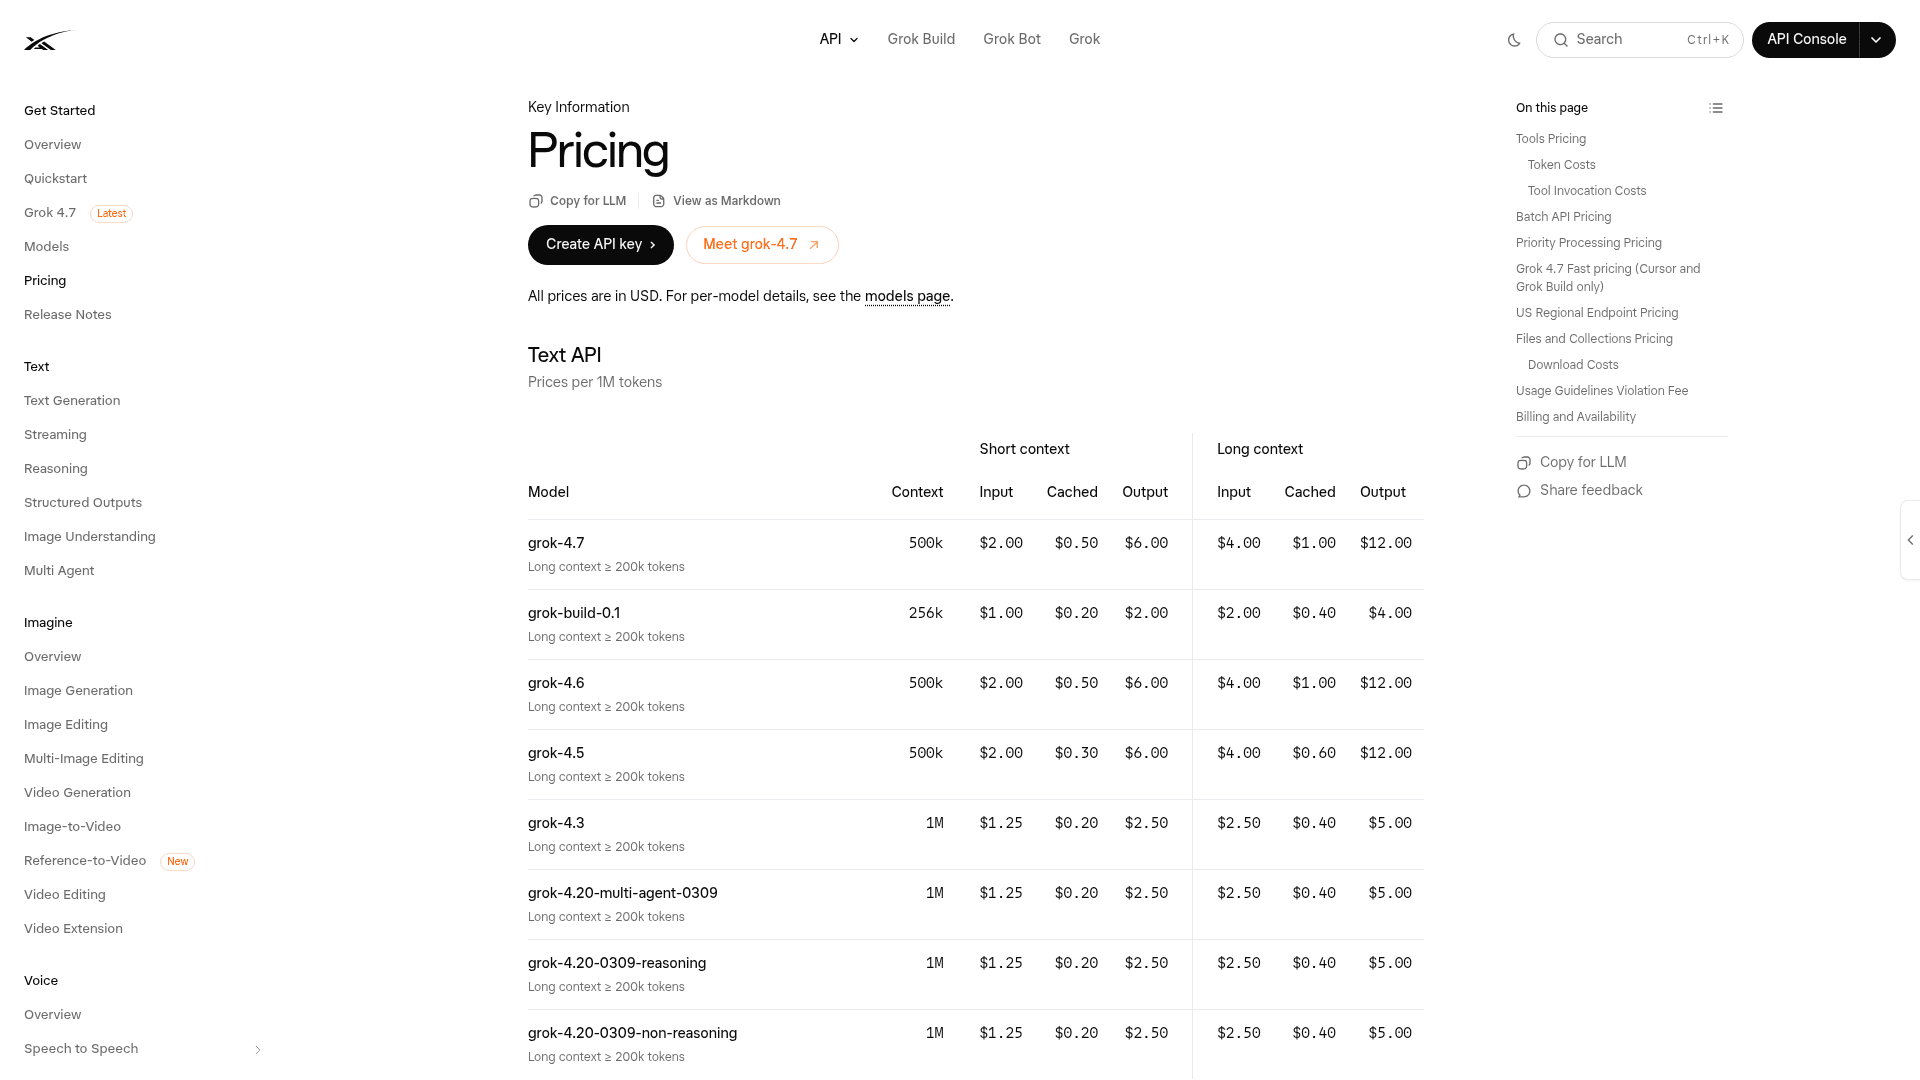
Grok 4.7 est tarifé pour fonctionner à volume. Sur l'API xAI, il coûte 2 $ par million de tokens en entrée et 6 $ par million de tokens en sortie pour les requêtes standard, avec un bond à 4 $ / 12 $ dès qu'un prompt dépasse 200k tokens. C'est exactement la même grille tarifaire que Grok 4.6, donc la mise à jour ajoute des capacités sans faire grimper le compteur.
Face à la concurrence, c'est ce prix en sortie qui fait l'histoire. Grok 4.7 égale GPT-6 Sol en entrée (2 $) mais coûte 40 % de moins en sortie (6 $ contre 10 $), et ne représente qu'un cinquième du tarif de Fable 5.1. Le piège se cache dans ce qui n'est pas sur l'étiquette : le seuil de contexte long à 200k qui retarifie toute votre requête, la variante Fast qui double le prix au token, et les compteurs d'appels d'outils qui s'accumulent silencieusement quand un agent cherche et exécute en boucle.
Je passe les trois dernières années et demie à déployer des agents IA sur de vraies files de support, et le chiffre qui décide réellement quel modèle est mis en production n'est jamais le meilleur benchmark, c'est la facture par token une fois qu'un agent tourne en boucle sur des milliers de tickets par jour. Cet article parle donc de la facture : la grille tarifaire complète, les compteurs que la plupart des modèles de coût ignorent, et comment Grok 4.7 se compare aux tarifs de GPT-6 Sol et aux tarifs de Fable 5.1 quand les tokens s'accumulent.
Indiquez votre propre volume mensuel de tokens pour voir où se situe Grok 4.7 face à GPT-6 Sol et Fable 5.1. L'interrupteur de contexte long fait basculer Grok sur ses tarifs à partir de 200k.
Les tarifs de Grok 4.7 en un coup d'œil
Voici la grille tarifaire, directement issue de la source plutôt qu'un chiffre « à partir de ».
| Palier | Entrée / 1M | Entrée en cache / 1M | Sortie / 1M |
|---|---|---|---|
grok-4.7, prompt sous 200k | 2,00 $ | 0,50 $ | 6,00 $ |
grok-4.7, prompt à 200k et plus | 4,00 $ | 1,00 $ | 12,00 $ |
| Grok 4.7 Fast (Cursor et Grok Build uniquement) | 2x les tarifs ci-dessus | 2x | 2x |
La fenêtre de contexte de 500k et les tarifs par token sont tous deux inchangés par rapport à Grok 4.6, ce qui est le titre de cette sortie pour un acheteur : vous obtenez un modèle plus puissant sur le même compteur. Les gains se sont portés sur le travail agentique de longue durée, et le prix n'a pas bougé pour les payer.
Un bon détail pour l'API : l'effort de raisonnement est configurable entre faible, moyen, élevé et xhigh, ce qui permet de régler l'intensité de réflexion du modèle par requête. Puisque les tokens en sortie coûtent 3 fois plus cher que ceux en entrée, et que le raisonnement consomme des tokens de sortie, l'effort est un vrai levier de coût, pas seulement de qualité. Réduire l'effort sur les appels faciles est l'optimisation la moins chère que vous ne faites pas.
Le seuil de contexte long à 200k
C'est l'élément le plus coûteux à manquer dans les tarifs de Grok 4.7. Dès que le prompt d'une requête franchit 200k tokens, les tarifs de contexte long s'appliquent à chaque token de la requête, pas seulement au dépassement au-delà de 200k.
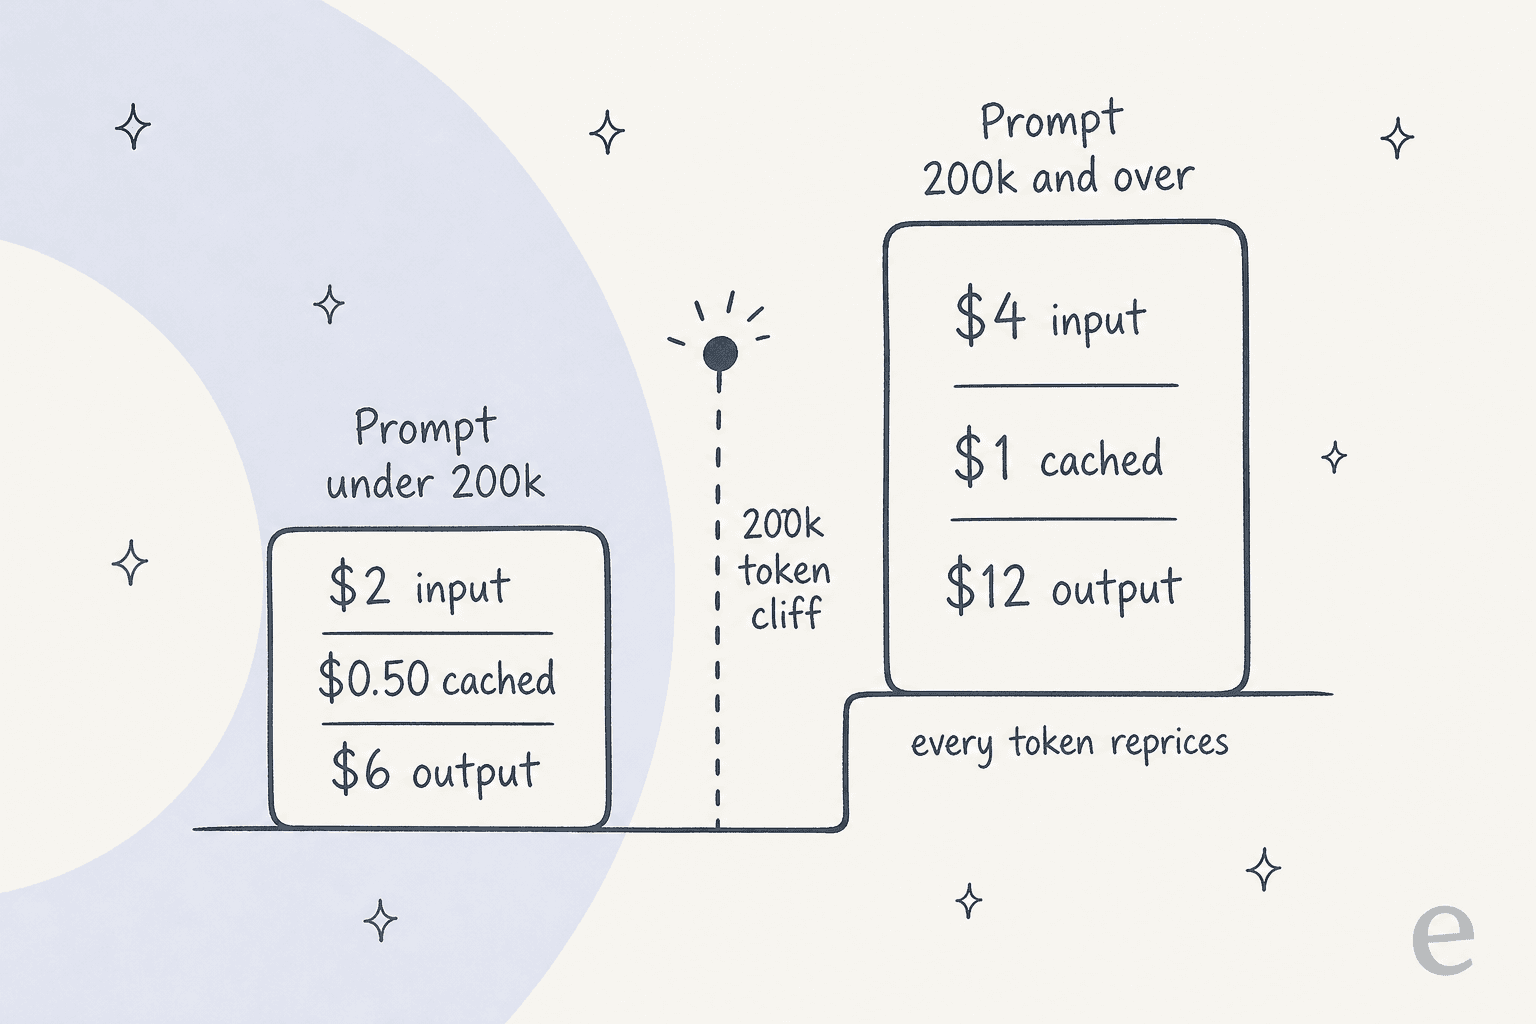
Ainsi, un prompt de 210k tokens est facturé entièrement à 4 $ / 12 $, pas majoritairement à 2 $ / 6 $. C'est un doublement déclenché par les 10 derniers milliers de tokens. Pour une boucle d'agent longue qui accumule lentement du contexte, message après message, le seuil est un vrai piège : l'exécution devient silencieusement deux fois plus chère au moment où elle bascule, et rien dans les en-têtes de réponse ne le signale avant que cela n'arrive.
xAI en a clairement conscience, puisque l'entreprise a lancé une Context Compaction API spécifiquement pour réduire les conversations avant qu'elles ne franchissent la ligne. Si vous exécutez quelque chose de long, prévoyez du temps d'ingénierie pour garder les prompts du côté abordable des 200k, ou acceptez que certaines de vos requêtes seront facturées silencieusement au double. C'est le genre de détail qui rend la tarification au token prévisible dans un tableur et imprévisible sur la facture.
Les compteurs que la plupart des modèles de coût ignorent
Les tarifs au token font la une, mais ils ne représentent pas toute la facture. Sur l'API, la page tarifaire de xAI liste une série de compteurs par appel qui s'ajoutent aux tokens, et qui comptent beaucoup pour les agents qui font plus que discuter :
- Recherche web, recherche X et exécution de code : 5 $ pour 1 000 appels chacun.
- Recherche dans les pièces jointes : 10 $ pour 1 000 appels.
- Recherche de collections (celle de type RAG) : 2,50 $ pour 1 000 appels.
- Priority Processing : double tous les tarifs de tokens, et n'est facturé que lorsque la réponse confirme qu'elle a tourné au palier prioritaire.
- Frais d'infraction aux directives d'usage : 0,05 $ pour une requête bloquée avant génération.
Aucun de ces éléments ne fait exploser la facture à lui seul. Mais un agent qui cherche sur le web, récupère dans une base de connaissances et exécute du code sur chaque ticket déclenche trois ou quatre appels facturables par échange, et c'est une ligne que vos calculs de tokens ne montreront pas. Si vous modélisez le coût d'un agent IA, c'est généralement dans ces compteurs que se cache la surprise.
Il y a aussi une note sur les lots à connaître : la remise de 20 % sur les lots proposée par xAI ne s'applique pas à Grok 4.7. Elle ne couvre que les variantes plus anciennes grok-4.3 et grok-4.20. Donc si vous avez un travail volumineux et tolérant à la latence, l'exécuter sur Grok 4.3 en lot peut revenir moins cher par token que Grok 4.7 aux tarifs standard. C'est un vrai carrefour pour les charges de travail hors ligne.
Grok 4.7 Fast, et la taxe 2x
Grok 4.7 Fast est le même modèle, servi à environ deux fois la vitesse de sortie pour deux fois le prix au token. Il n'est disponible que dans Cursor et Grok Build, pas sur l'API publique.
L'échange est de la latence pure contre de l'argent. Vous payez 4 $ / 12 $ (ou 8 $ / 24 $ au-delà du seuil) pour gagner quelques secondes sur la réponse. Cela vaut le coup lors d'une session de code interactive où vous regardez le code s'afficher en direct et où chaque seconde d'attente casse le flux. C'est du gaspillage sur des tâches par lots, des exécutions de nuit, ou toute tâche en arrière-plan où personne ne fixe le curseur. Ma règle générale : Fast pour le premier plan, standard pour tout le reste.
Où vous pouvez (et ne pouvez pas) acheter Grok 4.7
La voie d'achat change le prix effectif plus que la plupart ne l'imaginent, donc cela vaut la peine de la cartographier avant de s'engager.
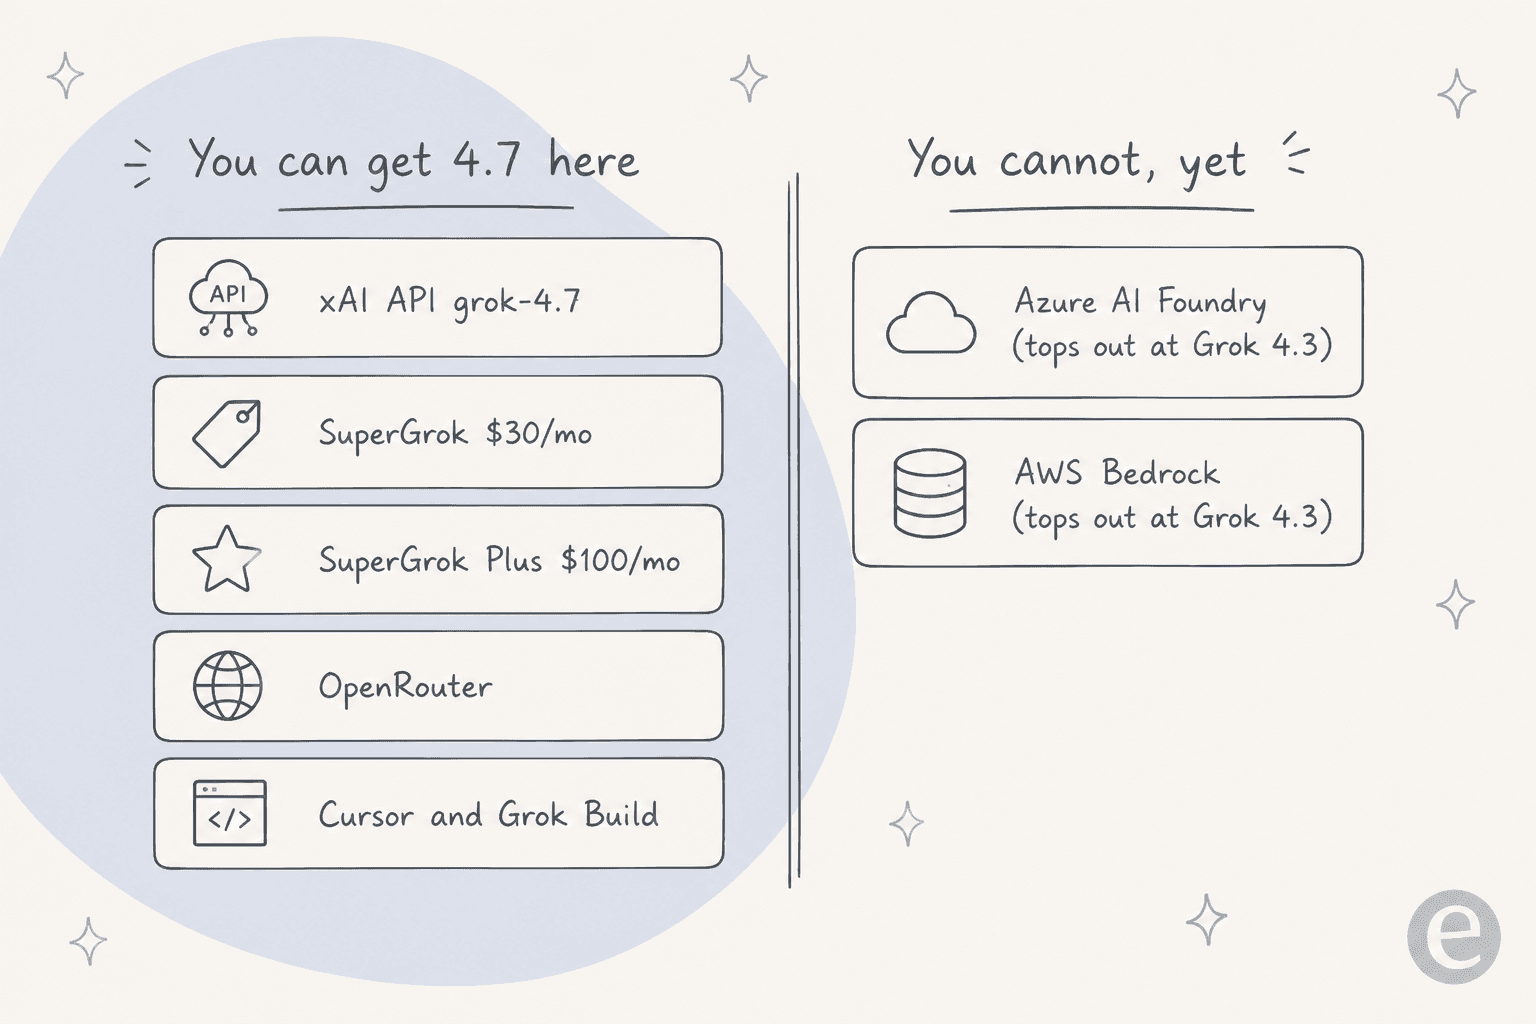
- API xAI (
grok-4.7) : le prix de référence, 2 $ / 6 $, celui sur lequel modéliser votre facture. - SuperGrok et SuperGrok Plus : les abonnements grand public, 30 $/mois et 100 $/mois. Bon pour une personne qui utilise Grok dans l'application, pas pour un volume programmatique.
- OpenRouter : répercute le tarif du fournisseur sans marge d'inférence, mais facture 5,5 % sur les achats de crédits (minimum 0,80 $), et les crédits expirent au bout d'un an. Sa valeur réside dans le prix effectif réel mesuré : sur Grok 4.6, une mise en cache intensive a fait chuter le prix moyen pondéré d'entrée bien en dessous du prix catalogue, un aperçu de la façon dont 4.7 sera facturé pour un trafic favorable au cache.
- Cursor et Grok Build : là où vit la variante Fast, et un bon endroit pour essayer le modèle avant de brancher l'API.
L'écart à signaler : Azure AI Foundry et AWS Bedrock plafonnent tous deux à Grok 4.3, à des prix autour de 1,25 $ / 2,50 $. Si votre entreprise impose un approvisionnement via une marketplace cloud, vous ne pouvez pas y acheter Grok 4.7 du tout, en tout cas pas encore. C'est une vraie limite, pas une critique, et c'est le genre de détail qui décide du choix du modèle pour les acheteurs d'entreprise, indépendamment de la grille tarifaire.
Grok 4.7 face à GPT-6 Sol et Fable 5.1 sur le prix
Voici la comparaison actuelle, en utilisant les tarifs publiés par chaque fournisseur. À noter que le propre matériel de lancement de xAI comparait au GPT-5.6 Sol plus ancien à 4 $ / 20 $, mais OpenAI a depuis lancé GPT-6 Sol à moitié prix, donc c'est le panorama réel auquel un acheteur fait face aujourd'hui.
| Modèle | Entrée / 1M | En cache / 1M | Sortie / 1M |
|---|---|---|---|
| Grok 4.7 | 2,00 $ | 0,50 $ | 6,00 $ |
| GPT-6 Sol | 2,00 $ | 0,20 $ | 10,00 $ |
| Fable 5.1 | 10,00 $ | n/d | 50,00 $ |
Le motif est clair. Grok 4.7 égale GPT-6 Sol en entrée et le sous-cote de 40 % en sortie, là où un agent bavard dépense l'essentiel de son argent. Face à Fable 5.1, Grok coûte environ un cinquième du prix par token. Fable reste en tête sur le codage de pointe et le travail de terminal de longue durée, donc la vraie question n'est jamais « lequel est le plus intelligent » (souvent Fable), mais « combien suis-je prêt à payer par point marginal ».
En termes par tâche : un seul échange d'agent de 50k en entrée plus 10k en sortie coûte environ 0,16 $ sur Grok 4.7, 0,40 $ sur GPT-6 Sol, et 1,00 $ sur Fable 5.1. Répétez cela dix mille fois par jour et la différence est toute la raison pour laquelle les charges de travail à fort volume optent par défaut pour le modèle bon marché en sortie. Une mise en garde apprise à mes dépens : moins cher au token n'est pas toujours moins cher par tâche, car un modèle qui émet plus de tokens de raisonnement pour finir le même travail peut effacer son avantage tarifaire. Modélisez-le sur votre propre trafic avec le calculateur ci-dessus avant de changer. Si vous comparez cela à un modèle premium, notre décryptage des tarifs de Claude Opus 5.5 fait le même constat par tâche, plus en détail.
Les tarifs de Grok 4.7 valent-ils le coup ?
Pour quiconque écrit du code, construit des agents IA, ou déploie sur l'API où le coût au token s'accumule, oui, sans hésiter. La combinaison de scores proches de la pointe et des tarifs de Grok 4.6 est tout l'argument, et les gains sur les tâches de longue durée signifient qu'il tient la route sur des travaux qui s'étalent dans le temps, pas seulement sur des prompts ponctuels. Si vous voulez une analyse plus poussée des capacités, notre aperçu de Grok 4.7 couvre les benchmarks.
Les utilisateurs intensifs confirment l'angle « le faire tourner en continu ». Un abonné de longue date de Grok a décrit comment il l'a intégré dans des tâches quotidiennes sans jamais approcher ses limites :
« J'ai un bot Grok qui surveille mes e-mails toutes les 15 minutes et classe des choses pour moi. J'ai un autre bot qui surveille des résultats d'analyses sanguines... et je n'approche jamais de ma limite d'utilisation. »

C'est la forme d'un modèle tarifé pour le volume : il vous invite à le laisser tourner. Là où je tempérerais les attentes, c'est sur les compteurs et le seuil. Le prix affiché est bas, mais un agent qui cherche, récupère et exécute du code à chaque échange, sur des prompts qui grimpent vers 200k tokens, facturera bien au-delà des « 2 $ / 6 $ » budgétés. Grok 4.7 est bon marché au démarrage et facile à sous-estimer, le même piège que tend tout modèle tarifé au token.
La tarification au token est un compteur, pas une facture prévisible
Voici le recadrage, car c'est ce qu'une simple comparaison de prix passe à côté. Chaque chiffre de cet article est un relevé de compteur, pas une facture. Grok 4.7 est de l'infrastructure : un moteur brillant que vous louez au token, qui arrive sans rien savoir de votre entreprise, de vos tickets, de votre ton ou de vos outils. Pour en faire quelque chose qui accomplit un vrai travail, il faut construire le harnais, connecter les connaissances, câbler les intégrations, écrire les garde-fous, gérer l'escalade, puis continuer à surveiller un compteur qui se retarife lui-même à 200k tokens et ajoute 5 $ tous les mille recherches.
Cet écart est toute l'idée derrière eesel. Plutôt qu'un modèle et un harnais vide, eesel est une plateforme de coéquipiers IA où vous embauchez des coéquipiers prêts à travailler pour un poste précis. L'équipe actuelle comprend un coéquipier IA pour le helpdesk qui rejoint votre file de support, et un rédacteur de blog IA qui recherche et rédige des articles longs. Chacun arrive déjà avec les compétences, les intégrations et le contexte d'entreprise dont son rôle a besoin, tournant en dessous sur des modèles de pointe comme celui-ci, pour que vous obteniez la capacité sans posséder la plomberie, ni le compteur.

La différence de prix est l'essentiel : eesel facture au ticket résolu, pas au token, donc le coût correspond au travail effectué plutôt qu'à la verbosité du modèle ce jour-là. Vous ne prévoyez pas des tokens de sortie ni n'esquivez un seuil de contexte long, vous payez pour des résultats.
Et si vous avez aimé Grok 4.7 parce que vous vivez dans un terminal, eesel vous y retrouve. La CLI eesel fait fonctionner le même coéquipier et le même espace de travail que le tableau de bord, mais en ligne de commande : une personne peut l'exécuter, des scripts peuvent l'automatiser, et des agents de code comme Claude Code, Codex et Cursor peuvent la piloter. Vous pouvez inspecter les instructions d'un coéquipier, envoyer un message de test, relire le résultat JSON et l'activité, et proposer un changement borné qu'un responsable devra approuver, le tout sans quitter votre shell. C'est le même attrait « faire fonctionner l'agent de façon programmatique » qui rend une API de modèle brute séduisante, appliqué à un employé qui connaît déjà le métier. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Combien coûte Grok 4.7 ?
Le tarif de Grok 4.7 est de 2 $ par million de tokens en entrée, 0,50 $ par million de tokens en entrée mis en cache, et 6 $ par million de tokens en sortie pour toute requête dont le prompt fait moins de 200k tokens, selon la page tarifaire de xAI. Au-delà de 200k tokens de prompt, les tarifs doublent à 4 $ / 1 $ / 12 $ sur chaque token de cette requête. C'est exactement la même grille tarifaire que Grok 4.6.
Quel est le prix de l'API Grok 4.7 par million de tokens ?
Sur l'API xAI, grok-4.7 coûte 2 $ en entrée et 6 $ en sortie par million de tokens au palier standard de contexte court. C'est le chiffre sur lequel modéliser votre facture. La page tarifaire de Grok 4.7 liste aussi des compteurs d'appels d'outils (recherche web et X, exécution de code à 5 $ pour 1 000 appels) qui s'ajoutent aux tokens pour les charges de travail agentiques.
Qu'est-ce que le seuil de tarification de contexte long de Grok 4.7 ?
Dès que le prompt d'une requête atteint 200k tokens ou plus, xAI facture toute la requête au tarif de contexte long de 4 $ / 1 $ / 12 $ par million, pas seulement les tokens au-delà de 200k. Un prompt de 210k tokens est facturé entièrement au tarif supérieur. xAI propose une Context Compaction API pour réduire les conversations avant qu'elles ne basculent au-delà du seuil.
Qu'est-ce que Grok 4.7 Fast et combien coûte-t-il de plus ?
Grok 4.7 Fast est le même modèle servi à environ deux fois la vitesse de sortie pour deux fois le prix au token. Il n'est disponible que dans Cursor et Grok Build, pas sur l'API publique. Cela vaut la prime quand la latence compte, comme regarder du code s'afficher en direct, et c'est du gaspillage sur des tâches par lots ou en arrière-plan.
Grok 4.7 est-il moins cher que GPT-6 Sol ou Fable 5.1 ?
Sur les tokens en sortie, oui. Grok 4.7 est à 2 $ / 6 $, GPT-6 Sol à 2 $ / 10 $, et Fable 5.1 à 10 $ / 50 $. Grok égale GPT-6 Sol en entrée et le sous-cote de 40 % en sortie, et ne représente qu'une fraction du tarif de Fable. Pour un travail d'agent à fort volume, Grok 4.7 est généralement l'option de classe frontière la moins chère.
Combien coûte Grok 4.7 pour les particuliers ?
Sur x.ai/pricing, le palier payant le moins cher qui nomme le dernier Grok est SuperGrok à 30 $/mois, avec SuperGrok Plus à 100 $/mois. Il existe un palier gratuit avec des limites. Si vous voulez appeler Grok 4.7 de façon programmatique, c'est le prix API de 2 $ / 6 $, pas l'abonnement.
Puis-je utiliser Grok 4.7 sur Azure ou AWS Bedrock ?
Pas encore. Azure AI Foundry et AWS Bedrock plafonnent tous deux à Grok 4.3 au moment de la rédaction, donc un acheteur soumis à un mandat cloud ne peut pas s'y procurer Grok 4.7. Vous pouvez l'atteindre via l'API xAI, via OpenRouter, ou dans Cursor et Grok Build.
Les tarifs de Grok 4.7 valent-ils le coup face à un paiement au résultat ?
La tarification au token vous récompense d'optimiser vos prompts et vous pénalise pour le contexte long, donc votre facture n'est prévisible qu'à hauteur de votre trafic. Si vous préférez payer par ticket résolu plutôt que par token, un coéquipier IA comme eesel tourne en dessous sur des modèles de pointe mais facture au résultat, pour que le coût corresponde au travail effectué.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.