

Ce qu'est vraiment Grok 4.7
Grok 4.7 est le modèle de pointe de xAI pour le code, les tâches agentiques et le travail de connaissance. Sur l'API, il est proposé sous le nom grok-4.7, avec une fenêtre de contexte de 500k, des entrées texte et image, et une sortie uniquement en texte sans limite de sortie, selon les notes de version de xAI. L'effort de raisonnement est configurable entre faible, moyen, élevé (par défaut) et xhigh, afin de doser à quel point le modèle réfléchit pour chaque requête.
Sous le capot, xAI affirme que Grok 4.7 utilise un modèle de base nouveau et plus grand que Grok 4.6. Je tiens à être précis ici, car une bonne partie de la couverture médiatique a avancé un nombre de paramètres exact : les documents de xAI eux-mêmes le décrivent comme un modèle de base plus grand sans publier de chiffre, donc le nombre précis qui circule n'est pas quelque chose que l'entreprise a réellement déclaré. Ce que xAI affirme, c'est la forme du changement, et c'est cette forme qui est intéressante.
L'entraînement était orienté vers des problèmes difficiles qui prennent de nombreuses heures à résoudre, puis renforcé sur une exécution plus longue. xAI a également entraîné le modèle à comprendre nativement son harnais Grok Bot, l'échafaudage qui permet au modèle de discuter, d'appeler des outils et de progresser dans une tâche. En termes simples, ils ont moins optimisé pour bien répondre à une seule question et davantage pour avancer dans un travail long et à plusieurs étapes sans perdre le fil.
Ce qui a changé par rapport à Grok 4.6
La façon la plus claire de voir le bond consiste à aligner les deux modèles sur les benchmarks publiés par xAI. Les gains ne sont pas uniformes, et là où ils se concentrent en dit long sur ce dont il s'agit vraiment dans cette sortie.
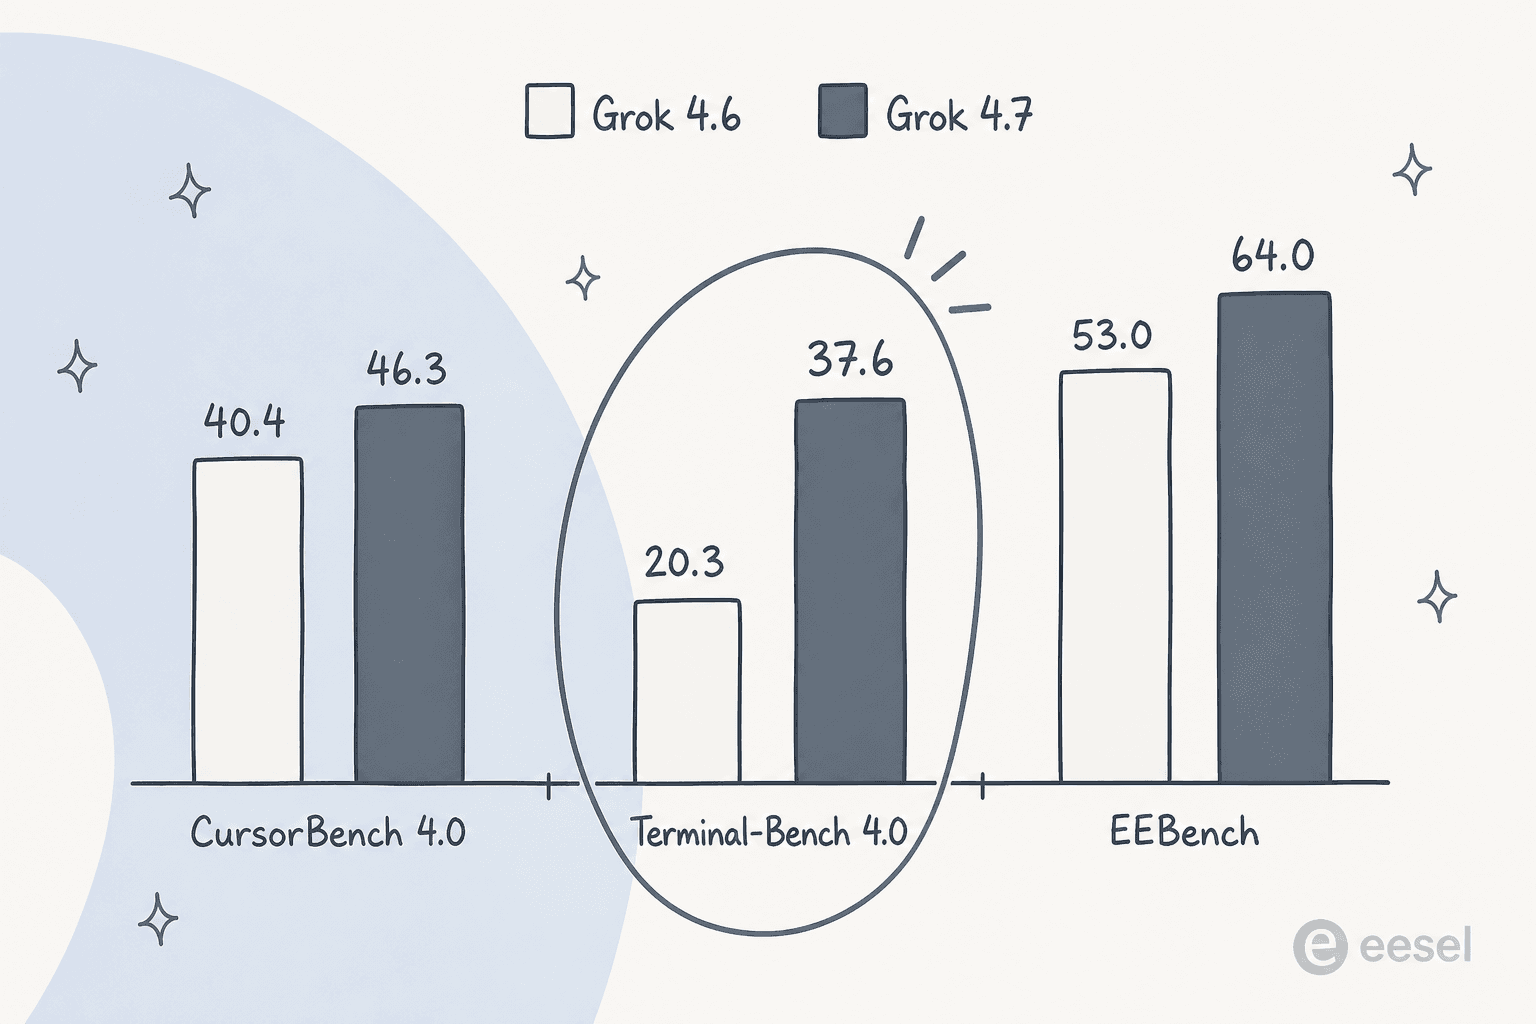
Le plus grand mouvement se situe sur Terminal-Bench 4.0, qui mesure un travail de plusieurs heures sur un vrai terminal : Grok 4.6 a obtenu 20,3 % et Grok 4.7 le fait presque doubler à 37,6 %. C'est exactement le genre de tâche à long horizon pour laquelle l'exécution RL plus longue a été conçue, et c'est là que la sortie prouve sa valeur. Le code et l'ingénierie suivent la même histoire : CursorBench 4.0 grimpe de 40,4 % à 46,3 %, et EEBench (génie électrique) passe de 53,0 % à 64,0 %.
Voici le tableau plus complet, avec GPT-5.6 Sol et Fable 5.1 à côté pour donner du contexte aux chiffres. Tous les chiffres de Grok 4.7 sont à l'effort xHigh, Grok 4.6 à High.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Prix d'entrée / 1M | $2 | $2 | $4 | $10 |
| Prix de sortie / 1M | $6 | $6 | $20 | $50 |
| CursorBench 4.0 (code) | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| DeepSWE v1.1 | 71,0 %* | 65,2 % | 72,7 % | 70,0 % |
| Terminal-Bench 4.0 | 37,6 % | 20,3 % | 37,3 % | 57,9 % |
| EEBench (génie électrique) | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| AA Briefcase v1.1 (Elo) | 1 657 | 1 546 | 1 487 | 1 678 |
| Harvey Legal Agent | 19,6 % | 15,8 % | 2,5 % | 6,7 % |
| HealthBench Professional | 56,7 % | 48,5 % | 60,5 % | 62,1 % |
*Le score DeepSWE de Grok 4.7 est mesuré à effort élevé. Chiffres tirés de l'annonce de Grok 4.7 de xAI.
Deux réserves honnêtes avant que quiconque n'y voie un balayage total. Fable 5.1 reste en tête sur CursorBench, Terminal-Bench et le raisonnement clinique, donc si seul le score maximal compte et que le coût n'est pas un problème, il est devant. Et sur HealthBench Professional, GPT-5.6 Sol (60,5 %) comme Fable 5.1 (62,1 %) devancent les 56,7 % de Grok 4.7. L'histoire de Grok 4.7 n'est pas « le meilleur en tout ». C'est « très proche du meilleur, pour une fraction du prix ».
Les prix de Grok 4.7, et la taxe Fast
Les prix, c'est là que ce modèle devient intéressant, et cela vaut la peine de les détailler plutôt que d'agiter un chiffre « à partir de ».
| Palier | Entrée / 1M | Entrée mise en cache / 1M | Sortie / 1M |
|---|---|---|---|
grok-4.7, prompt sous 200k tokens | $2,00 | $0,50 | $6,00 |
grok-4.7, prompt à 200k et plus | $4,00 | $1,00 | $12,00 |
| Grok 4.7 Fast (Cursor et Grok Build uniquement) | 2x les tarifs ci-dessus | 2x | 2x |
Le premier piège est le palier de contexte long. Dès qu'une requête dépasse 200k tokens de prompt, les tarifs plus élevés s'appliquent à chaque token de la requête entière, pas seulement au dépassement au-delà de 200k. Un prompt de 210k tokens est donc facturé entièrement à 4 $ / 12 $, pas majoritairement à 2 $ / 6 $. Pour les boucles d'agents longues qui accumulent lentement du contexte, cette falaise est bien réelle, et c'est pourquoi xAI a lancé une API de compaction de contexte pour réduire les conversations avant qu'elles ne basculent.
Le second, c'est la variante Fast. Grok 4.7 Fast est le même modèle servi à deux fois la vitesse de sortie pour deux fois le prix du token, et il n'est disponible que dans Cursor et Grok Build, pas sur l'API publique. C'est un compromis latence contre argent, utile quand vous regardez le code défiler en direct et que chaque seconde compte, et facultatif pour le travail par lots ou en arrière-plan où la vitesse importe peu.
Ensuite, il y a les compteurs que la plupart des articles manquent. Sur l'API, la page de tarification de xAI liste les appels d'outils séparément : la recherche web, la recherche X et l'exécution de code coûtent 5 $ pour 1 000 appels, la recherche dans les pièces jointes coûte 10 $ pour 1 000, et la recherche de collections façon RAG coûte 2,50 $ pour 1 000. Le Priority Processing double tous les tarifs de tokens. Aucun de ces postes ne fait exploser le budget, mais si vous modélisez le coût d'un agent qui cherche et exécute en permanence, le prix du token n'est pas toute la facture.
Ce qu'il faut retenir : Grok 4.7 est tarifé pour être utilisé à volume. C'est un positionnement délibéré, et c'est la raison la plus claire de le préférer à un modèle de pointe plus cher pour tout ce qui tourne en boucle.
Où se situe Grok 4.7 face à GPT-5.6 Sol et Fable 5.1
Si vous tracez la capacité en fonction du coût, Grok 4.7 se retrouve dans un coin de plus en plus fréquenté mais toujours précieux : des scores solides, un prix bas.
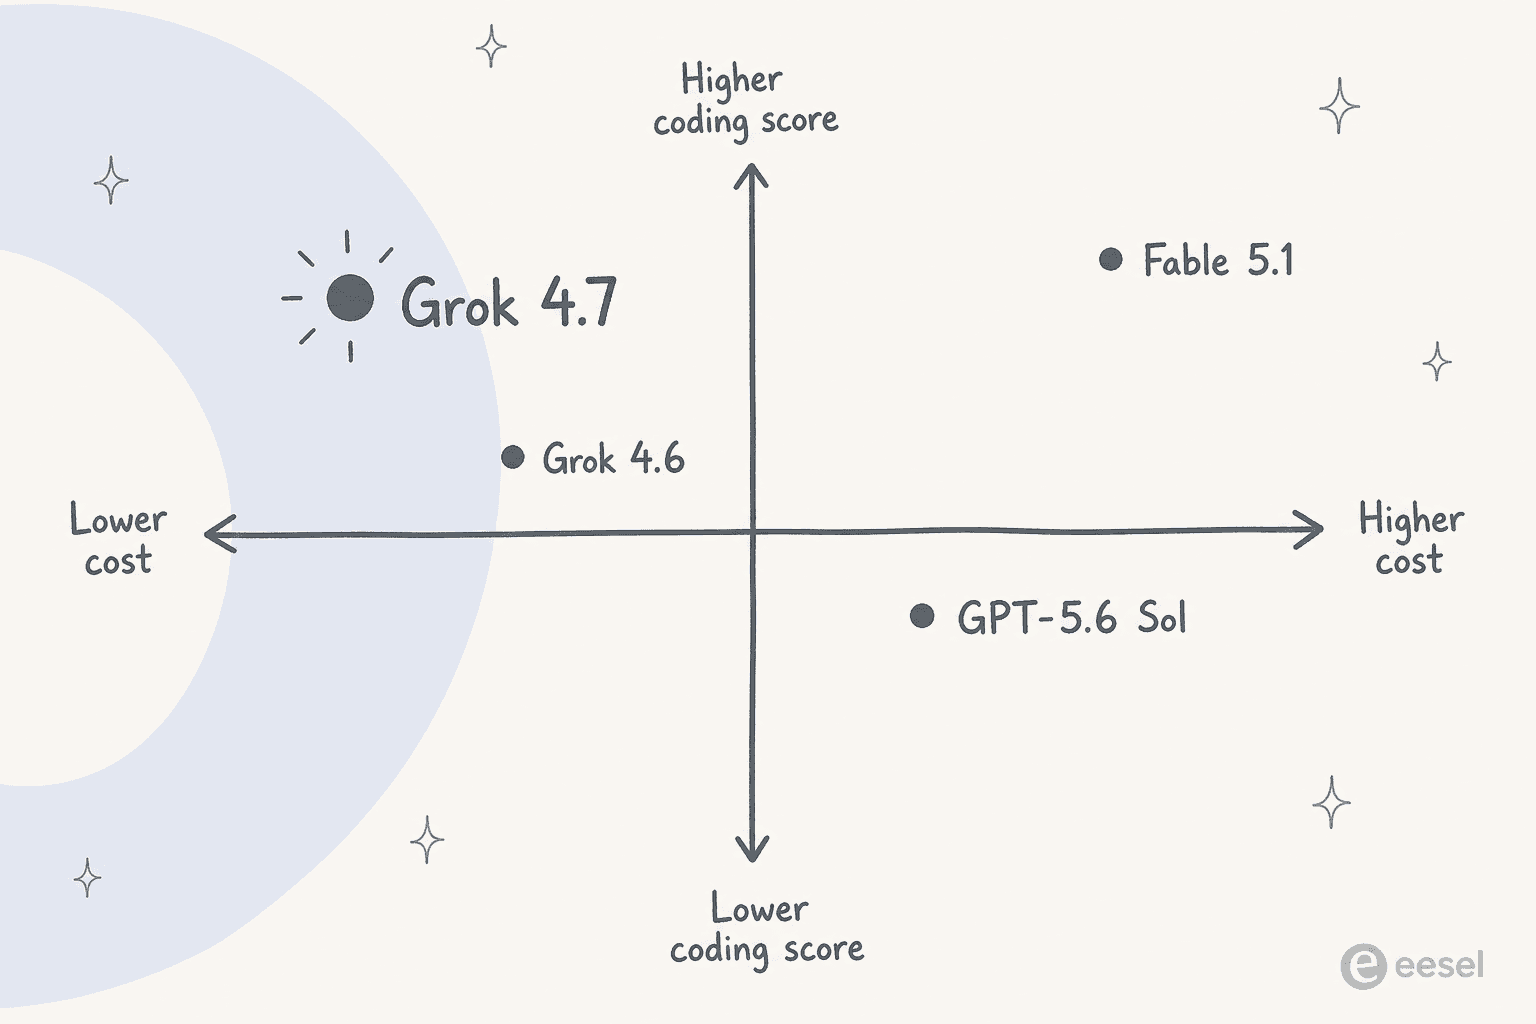
Face à GPT-5.6 Sol, Grok 4.7 est le meilleur choix sur la plupart des travaux agentiques et d'ingénierie : il devance Sol sur CursorBench, EEBench, Terminal-Bench, le benchmark juridique de Harvey et AA Briefcase, pour la moitié du prix d'entrée et moins d'un tiers du prix de sortie. Sol conserve un vrai avantage en raisonnement clinique et un léger avantage sur DeepSWE, ce n'est donc pas un balayage total, mais l'écart de prix fait de Grok 4.7 le choix par défaut pour le travail agentique sensible aux coûts.
Face à Fable 5.1, la lecture honnête est que Fable reste le modèle le plus fort en code pur et en travail au terminal à long horizon, et son Elo de connaissances professionnelles GDPval de 1 735 devance les 1 695 de Grok 4.7. Mais Fable facture 10 $ / 50 $ par million de tokens, cinq à huit fois les tarifs de Grok. La question n'est donc pas « lequel est le plus intelligent » (souvent Fable), mais « combien êtes-vous prêt à payer par point supplémentaire ». Pour beaucoup de charges de travail en production, Grok 4.7 est la réponse qui garde la facture raisonnable.
Sécurité et cybersécurité
xAI a accordé un poids réel à la sécurité pour ce cycle, et c'est l'une des parties les plus concrètes de la sortie. Grok 4.7 a été construit avec une pile de garde-fous entièrement nouvelle, et xAI le présente comme le modèle le plus solide qu'il ait testé en matière de refus et de résistance au jailbreak.
Ce sont les détails qui rendent cette affirmation vérifiable. Sur HackerBench v0.3, le benchmark de xAI pour les tâches cyber à risque, Grok 4.7 laisse passer seulement 3,3 % des prompts à double usage risqués tout en bloquant rarement, selon xAI, le travail de sécurité légitime. Il domine aussi le benchmark de biosécurité de LatchBio à 62,4 %. L'argument est un modèle qui reste utile pour un vrai travail de sécurité et de recherche sans être un outil facile pour la version dangereuse de la même tâche, et xAI a commencé à donner à des partenaires cybersécurité sélectionnés un accès sur invitation aux capacités de red-team du modèle pour la recherche défensive. Les benchmarks proviennent du fournisseur lui-même, à traiter donc comme un point de départ, mais la direction est claire.
À qui s'adresse vraiment Grok 4.7
Après avoir examiné les chiffres, voici où j'en arrive. Grok 4.7 est un excellent choix si vous écrivez du code, construisez des agents, ou déployez quoi que ce soit sur l'API où le coût des tokens s'accumule. La combinaison de scores proches de la frontière et des prix de Grok 4.6 est la raison principale de s'y intéresser, et les gains sur le long horizon signifient qu'il tient mieux la route que 4.6 sur les travaux qui durent un moment.
Des utilisateurs réels confirment l'angle « le faire tourner en permanence ». Un abonné Grok assidu a décrit comment il l'a intégré à des tâches quotidiennes sans jamais approcher les limites :
« J'ai un bot Grok qui surveille mes e-mails toutes les 15 minutes et classe les choses pour moi. J'en ai un autre qui surveille les résultats d'analyses de sang... et je n'approche jamais mon quota. »

Là où je modérerais les attentes, c'est sur le code profond et complexe. Les modèles de pointe s'améliorent tous pour produire un script en une seule fois, et c'est bien réel, mais ce n'est pas la même chose que de porter une grande base de code. Comme l'a formulé un développeur dans le même fil :
« Les modèles s'améliorent de plus en plus pour tout réussir en un coup. C'est utile dans beaucoup de situations, comme pour de petits scripts ponctuels... Pour le travail de code lui-même, en revanche, ça ne m'aide pas beaucoup. »
C'est une lecture juste pour tout modèle de cette catégorie, Grok 4.7 y compris. Utilisez-le pour le volume de travail moyennement difficile où son prix l'emporte, et réservez le modèle le plus cher aux tâches qui ont vraiment besoin de ces derniers points.
Un modèle de pointe est le moteur, pas l'employé
Voici le recadrage promis dans le TL;DR, car c'est ce que la plupart des articles « quel modèle utiliser » passent sous silence.
Grok 4.7 est de l'infrastructure. C'est un moteur brillant que vous louez au token, et il arrive sans rien savoir de votre entreprise, de vos tickets, de votre ton ou de vos outils. Pour en faire quelque chose qui accomplit un vrai travail, quelqu'un doit construire le harnais : connecter les connaissances, câbler les intégrations, écrire les garde-fous, gérer l'escalade et maintenir le tout en fonctionnement. C'est un vrai projet, pas un simple interrupteur de configuration.
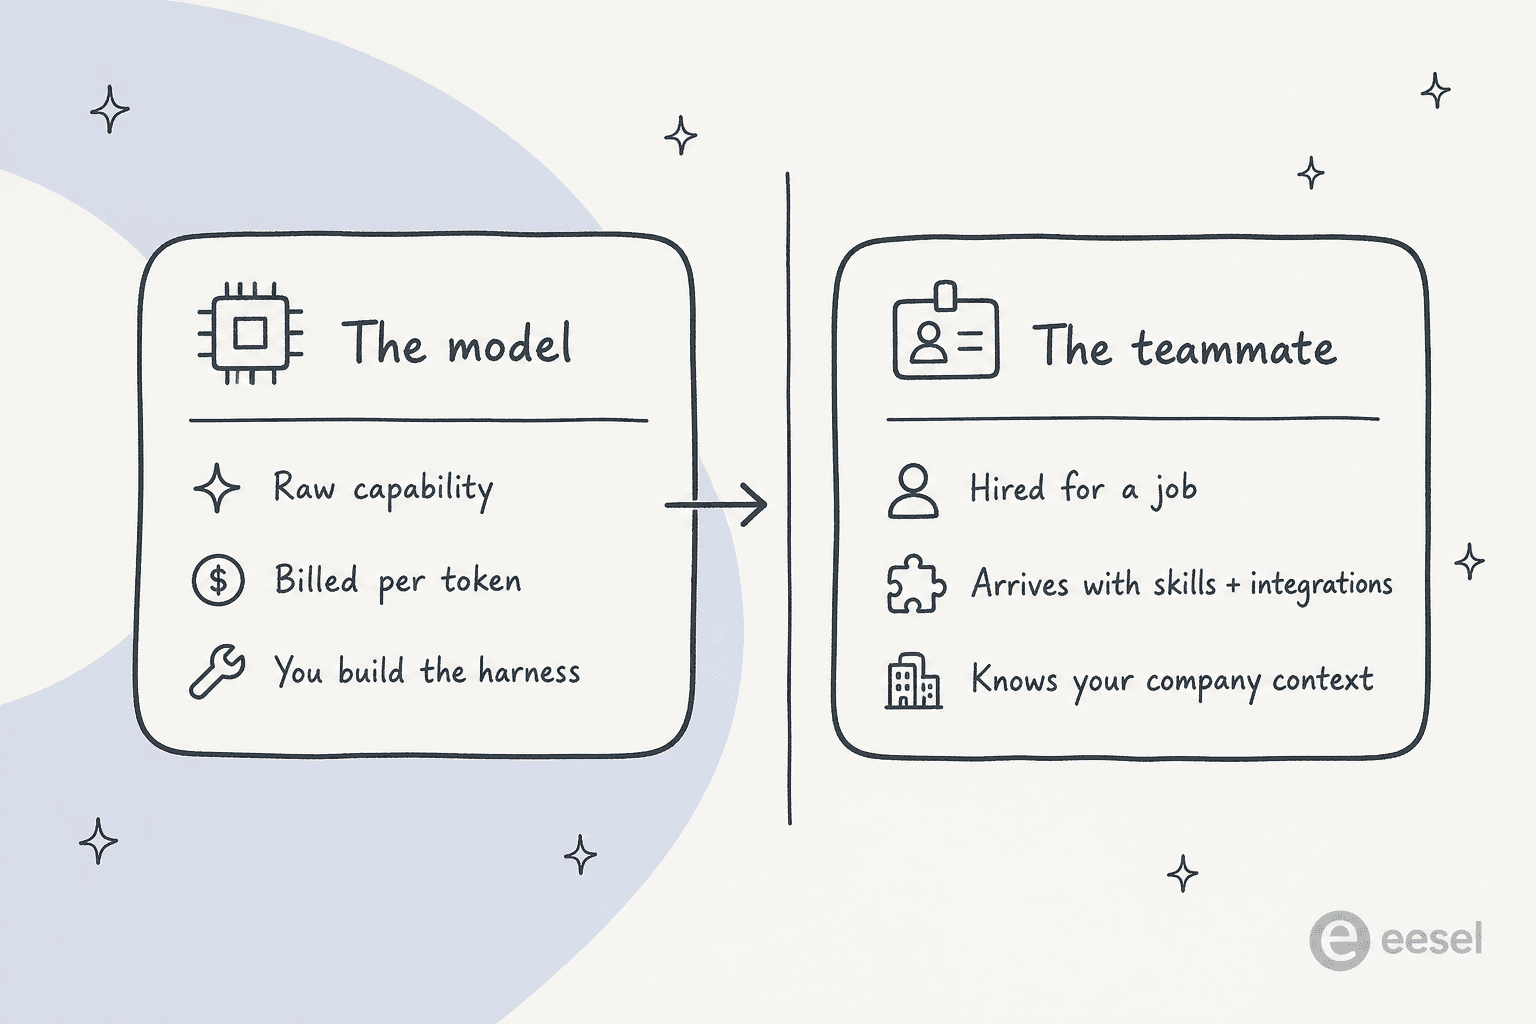
Cet écart, c'est toute l'idée derrière eesel. Plutôt que de vous remettre un modèle et un harnais vide, eesel est une plateforme de coéquipiers IA où vous embauchez des coéquipiers prêts à travailler pour un poste précis. La gamme actuelle comprend un coéquipier IA pour le helpdesk qui rejoint votre file de support, et un rédacteur de blog IA qui fait des recherches et rédige des articles de fond. Chacun arrive déjà avec les compétences, les intégrations et le contexte d'entreprise dont son rôle a besoin, tout en tournant en coulisses sur des modèles de pointe, pour que vous obteniez la capacité sans avoir à gérer la plomberie.
Et si vous avez aimé Grok 4.7 parce que vous vivez dans un terminal, eesel vous y retrouve aussi. La CLI eesel pilote le même coéquipier et le même espace de travail que le tableau de bord, mais depuis la ligne de commande : une personne peut l'exécuter, des scripts peuvent l'automatiser, et des agents de code comme Claude Code, Codex et Cursor peuvent la piloter. Vous pouvez inspecter les instructions d'un coéquipier, envoyer un message de test, relire le résultat JSON et l'activité, et proposer un changement limité qu'un responsable approuvera, le tout sans quitter votre shell. C'est le même schéma « piloter l'agent de façon programmatique » qui rend une API de modèle brut attrayante, mais appliqué à un employé qui connaît déjà le travail. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Qu'est-ce que Grok 4.7 ?
Grok 4.7 est le modèle de pointe de xAI pour le code, les tâches agentiques et le travail de connaissance, sorti le 21 septembre 2026. Il fonctionne sur un modèle de base nouveau et plus grand que Grok 4.6, conserve la fenêtre de contexte de 500k et est proposé sur l'API xAI sous le nom grok-4.7. C'est le même type de moteur de modèle brut sur lequel s'appuie un produit comme un coéquipier IA.
Combien coûte Grok 4.7 ?
Le prix de Grok 4.7 est de 2 $ par million de tokens en entrée, 0,50 $ pour l'entrée mise en cache et 6 $ en sortie en dessous de 200k tokens de prompt, doublant à 4 $ / 1 $ / 12 $ dès qu'une requête dépasse 200k, selon la page de tarification de xAI. Cela correspond exactement à Grok 4.6, la mise à niveau ajoute donc de la capacité sans augmentation de prix.
Quelle est la différence entre Grok 4.7 et Grok 4.6 ?
Grok 4.7 utilise un modèle de base plus grand et une exécution d'apprentissage par renforcement plus longue, orientée vers des tâches de plusieurs heures, et affiche les plus grands gains sur les benchmarks agentiques de longue durée comme Terminal-Bench 4.0. Les deux partagent la fenêtre de contexte de 500k et les mêmes prix par token.
Grok 4.7 est-il bon pour le code ?
Oui, le code est sa principale force. Il obtient 46,3 % sur CursorBench 4.0 et devance Grok 4.6 sur chaque benchmark logiciel publié par xAI, et il est proposé au sein de Cursor et Grok Build. Pour un travail de code plus poussé, les équipes le combinent souvent encore avec un modèle plus cher pour les tâches les plus difficiles.
Grok 4.7 est-il meilleur que GPT-5.6 Sol ou Fable 5.1 ?
Cela dépend de ce que vous privilégiez. Grok 4.7 devance GPT-5.6 Sol sur la plupart des benchmarks de code et agentiques pour une fraction du prix, tandis que Fable 5.1 reste en tête sur le code de pointe et le travail au terminal, mais coûte de cinq à huit fois plus par token. Pour un travail à volume élevé et sensible aux coûts, Grok 4.7 est généralement le meilleur choix.
Qu'est-ce que Grok 4.7 Fast ?
Grok 4.7 Fast est le même modèle servi à deux fois la vitesse de sortie pour deux fois le prix du token, disponible uniquement dans Cursor et Grok Build plutôt que sur l'API publique. Cela en vaut la peine quand la faible latence compte, par exemple pour voir le code défiler en direct, et c'est facultatif pour les tâches par lots ou en arrière-plan.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.






Comment accéder à Grok 4.7 ?
Vous pouvez appeler Grok 4.7 via l'API xAI sous le nom
grok-4.7, l'utiliser gratuitement dans Grok Build, ou y accéder depuis Cursor. Si vous voulez que cette intelligence accomplisse un travail défini plutôt que des tokens bruts, une plateforme de coéquipiers IA comme eesel regroupe un modèle de pointe avec les compétences, les intégrations et le contexte de l'entreprise pour un vrai rôle.