Pourquoi on cherche une alternative à Grok 4.7
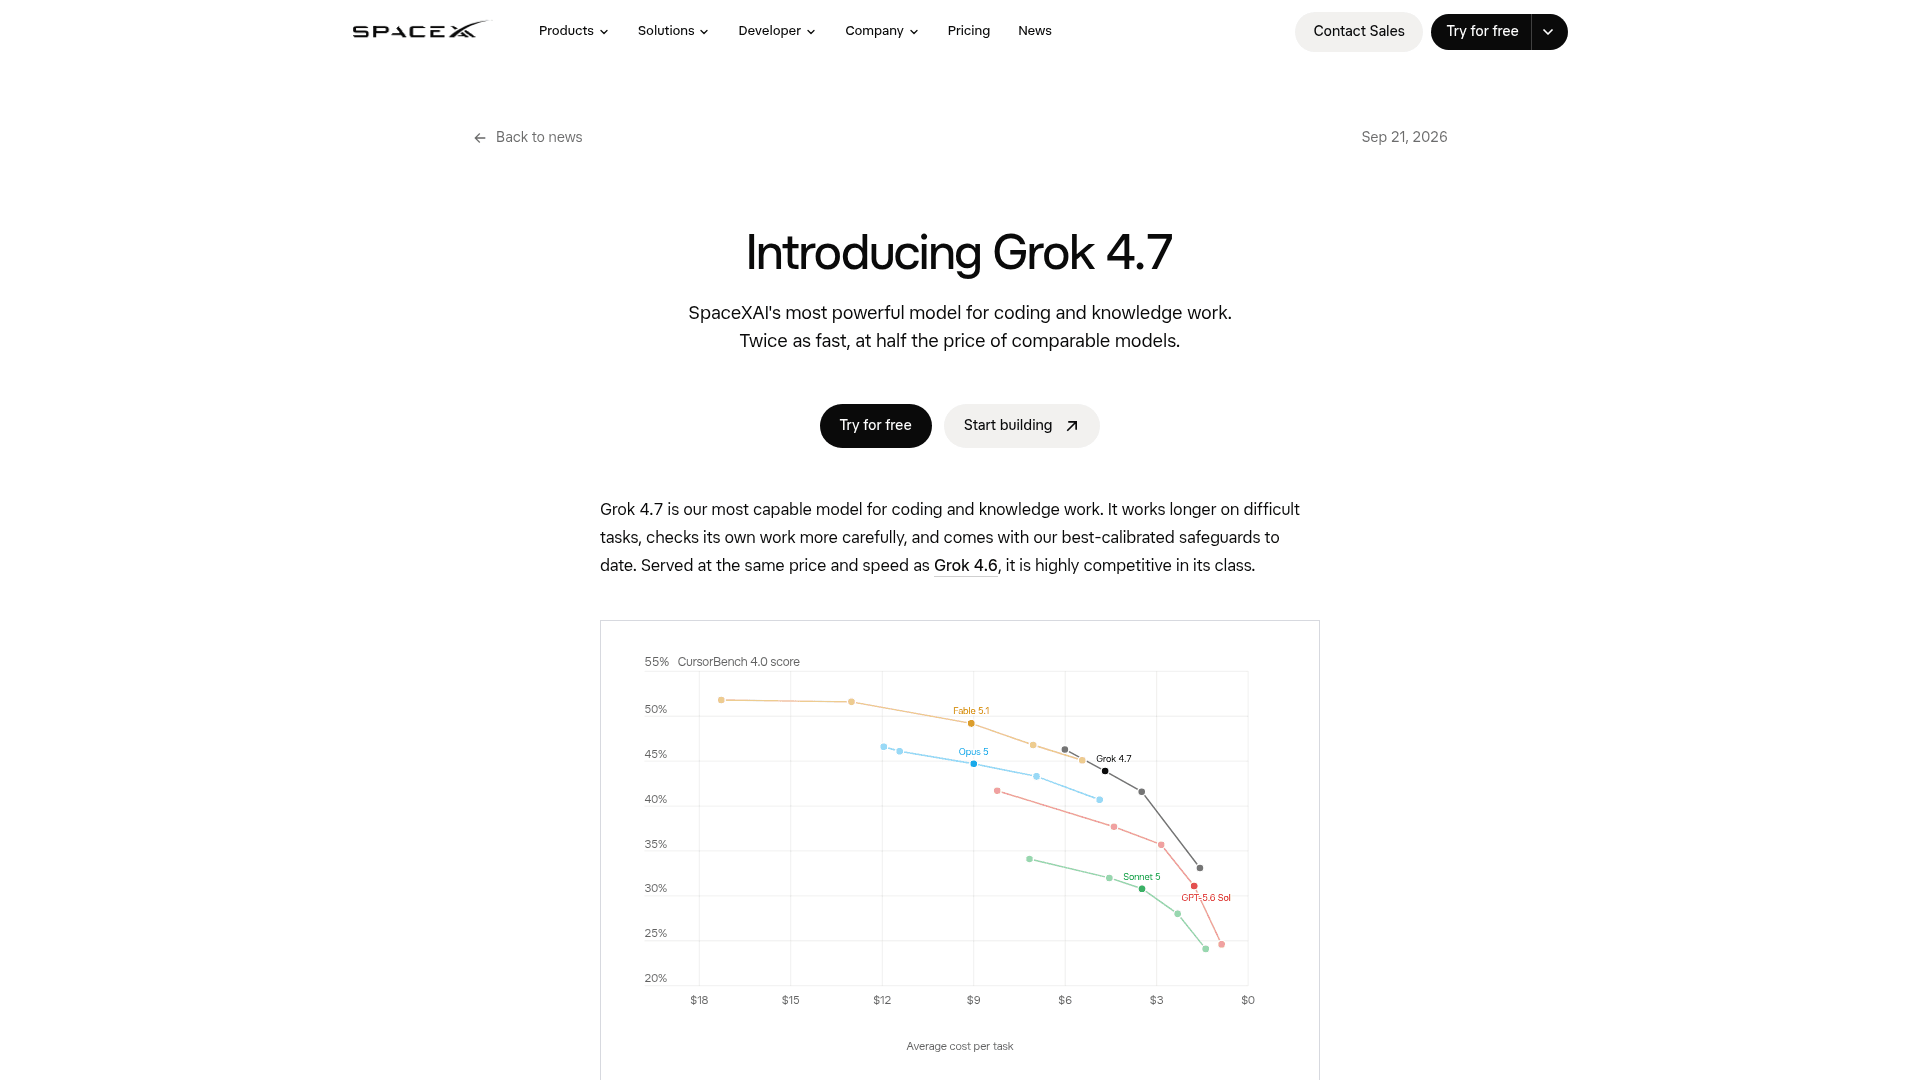
Grok 4.7 est un choix par défaut solide, donc les raisons de chercher ailleurs sont généralement spécifiques. La plus fréquente que j'entends est le seuil de prix des 200k tokens : dès qu'une requête dépasse 200k tokens de prompt, Grok 4.7 facture chaque token de cette requête à 4 $ / 12 $ au lieu de 2 $ / 6 $, selon la page des tarifs xAI. Si votre charge de travail porte sur de longs documents ou de grandes bases de code, ce doublement change la donne, et certaines alternatives ne le facturent pas du tout.
Les autres raisons relèvent des politiques et des capacités. Grok est fermé, donc si vous avez besoin de poids ouverts, il est exclu. Il prend du texte et de l'image en entrée et produit du texte, donc si vous avez besoin d'une compréhension native de l'audio ou de la vidéo, vous regardez du côté de Gemini. Et quelques équipes veulent simplement le tout premier rang des classements d'intelligence, où Claude trône toujours. Les utilisateurs de Grok 4.6 peuvent aussi lire la critique de Grok 4.6 pour le contexte de la génération précédente.
Comment j'ai comparé ces modèles
Je me suis tenu aux sources primaires : les pages propres de chaque fournisseur sur ses modèles et ses tarifs, plus les tableaux de benchmarks publiés par les fabricants eux-mêmes. Les prix sont les chiffres en vigueur sur les pages de documentation en date de septembre 2026, donc si une promotion expire (celle de Gemini expire le 1er janvier 2027), je l'ai signalé. Quand je cite des classements d'intelligence, ils proviennent des graphiques des fabricants eux-mêmes et de l'index indépendant Artificial Analysis, pas d'une liste tierce qui recopie une autre liste.
J'ai pondéré fortement deux éléments, parce que ce sont ceux que les acheteurs ratent : le seuil de prix des 200k, et le fait de savoir si le chiffre « pas cher » est bien celui que vous payez réellement. Un modèle bon marché au token mais bavard à la tâche n'est pas bon marché. Je l'ai signalé là où c'est le cas.
Les meilleures alternatives à Grok 4.7 en un coup d'œil
Voici tout le champ sur un seul écran. Les prix sont par million de tokens, tirés des pages de documentation en direct de chaque fournisseur.
| Modèle | Fabricant | Entrée / Sortie | Contexte | Seuil des 200k | Poids ouverts | Vision native | Idéal pour |
|---|---|---|---|---|---|---|---|
| Grok 4.7 | xAI | 2 $ / 6 $ | 500k | Oui (2x) | Non | Image | Codage de pointe bon marché |
| Claude Fable 5.1 | Anthropic | 10 $ / 50 $ | 1M | Non (fixe) | Non | Image | Intelligence maximale |
| Claude Opus 5.5 | Anthropic | 4 $ / 20 $ | 1M | Non (fixe) | Non | Image | Codage agentique long |
| GPT-6 Sol | OpenAI | 2 $ / 10 $ | Grand | Oui (2x) | Non | Image | Écosystème + équilibre |
| Gemini 3.8 Flash | 0,75 $ / 3,75 $ | 1M | Non (fixe) | Non | Image, audio, vidéo | Multimodal + bon marché | |
| DeepSeek V4.1 Flash | DeepSeek | ~0,22 $ / 0,66 $ | 1M | Non | Oui (MIT) | Non | Le moins cher, auto-hébergeable |
| Kimi K3 | Moonshot | 3 $ / 15 $ | 1M | Non | Oui | Image, vidéo | Pointe à poids ouverts |
| Qwen 3.8 Max | Alibaba | 2 $ / 6 $ | 1M | Non | Base seulement | Image, vidéo | Prix de Grok, base ouverte |
Une remarque sur l'équité avant la liste : les 0,75 $ / 3,75 $ de Gemini sont le tarif promotionnel jusqu'au 31 décembre 2026, puis il double. Le tarif hors pointe de DeepSeek double à peu près pendant les heures ouvrées chinoises. Et la base ouverte de Qwen 3.8 Max n'est pas équivalente en fonctionnalités à la version hébergée. Les détails figurent dans chaque entrée.
1. Claude (Fable 5.1 et Opus 5.5)
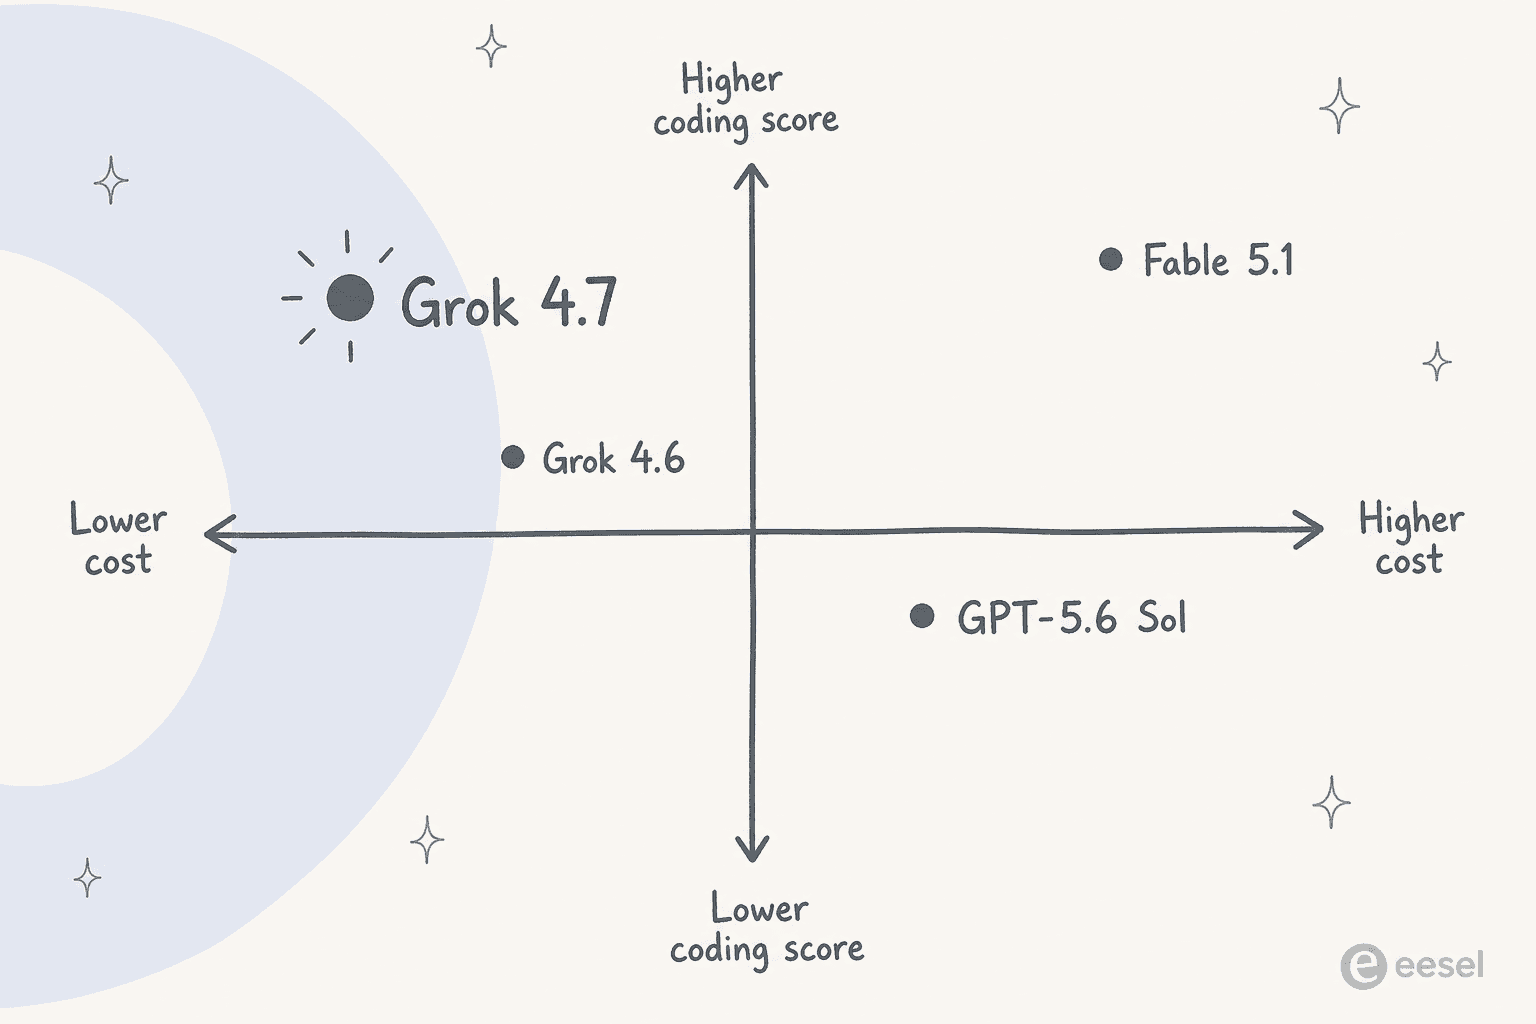
Si l'argument de Grok 4.7 est « proche de la pointe pour pas cher », celui de Claude est « vraiment la pointe ». Le Fable 5.1 d'Anthropic est le modèle à battre sur la plupart des classements publics, et Opus 5.5 se situe juste en dessous comme cheval de trait pour le codage agentique long.
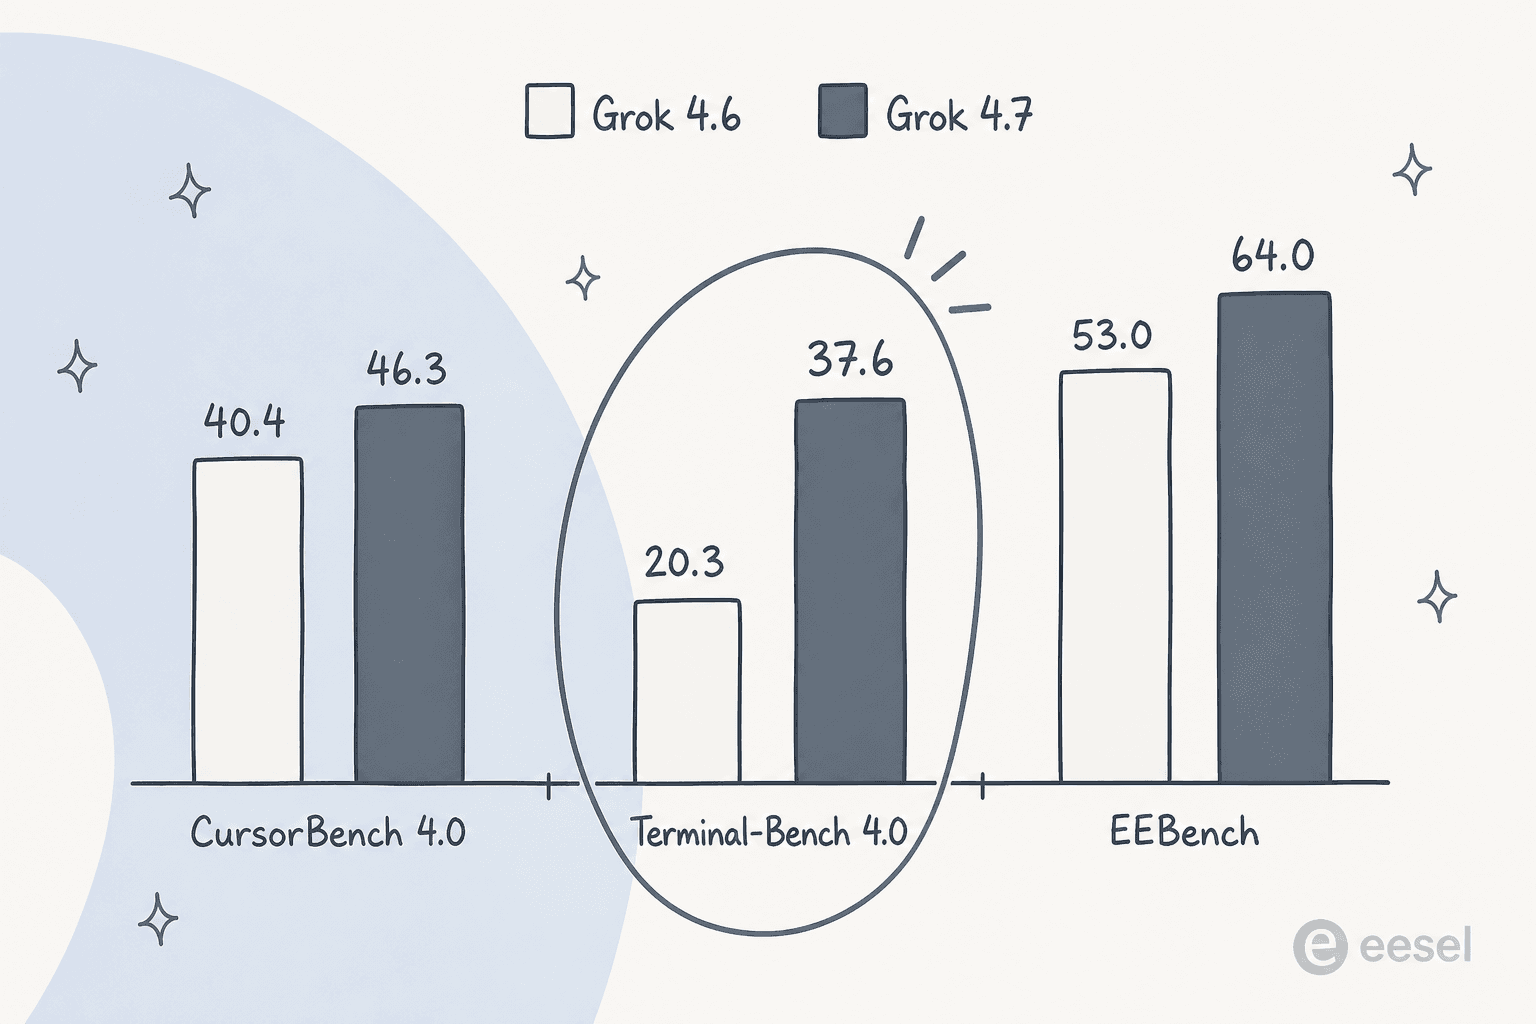
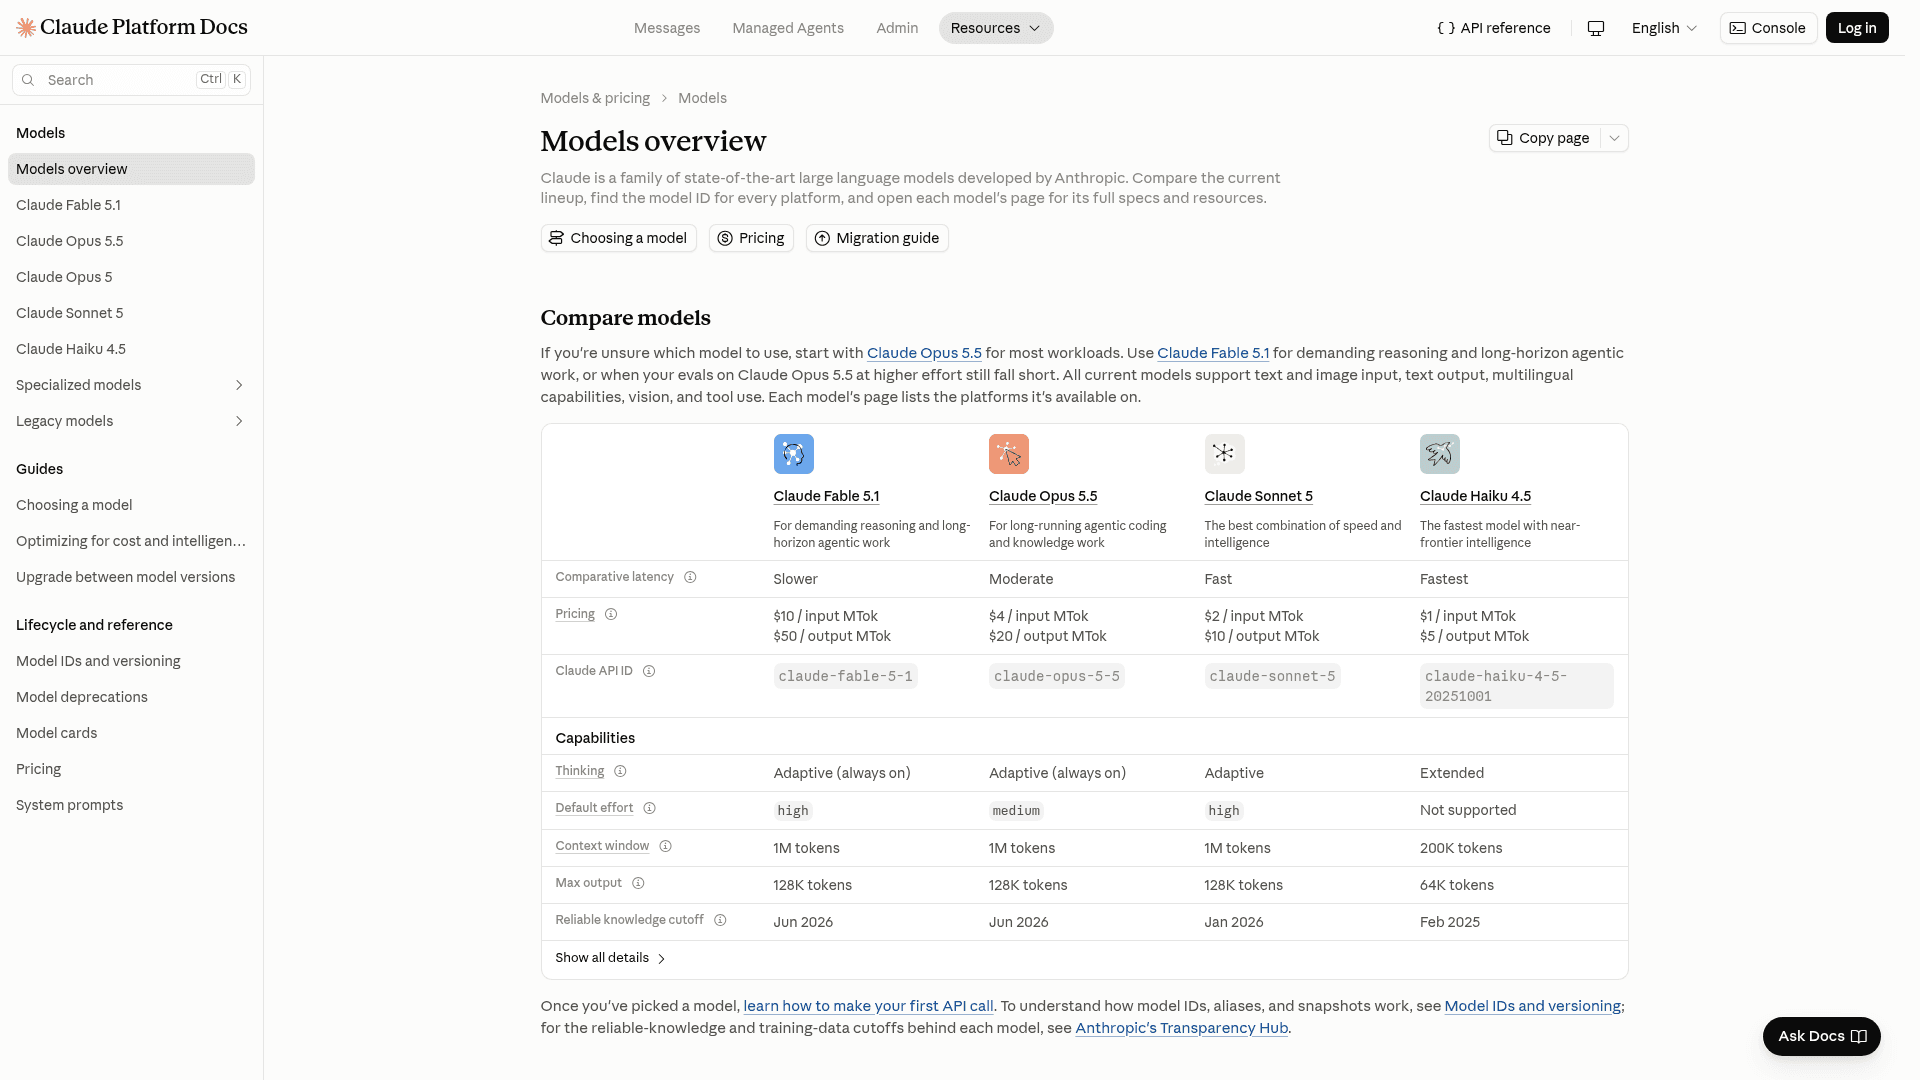
À retenir. Fable 5.1 devance Grok 4.7 sur CursorBench, Terminal-Bench et le classement AA Briefcase, et domine l'indice GDPval du travail professionnel. Les deux modèles Claude ont une fenêtre de contexte de 1M sans seuil de prix à 200k, donc le travail sur de longs documents est facturé à un tarif fixe unique. Les lectures de cache de Fable sont étonnamment bon marché à 0,25 $ par million, ce qui rend les appels agentiques répétés bien moins douloureux que le prix affiché ne le laisse penser.
Avantages. L'intelligence la plus élevée mesurée dans ce tour d'horizon. Un tarif fixe sur toute la fenêtre de contexte. Une utilisation d'outils solide et bien documentée, et un SDK mature.
Inconvénients. C'est cher. Fable 5.1 coûte environ cinq fois le tarif de Grok 4.7, et même Opus 5.5 coûte le double. Des retours de la communauté signalent aussi que les garde-fous de Fable peuvent se déclencher à tort sur votre propre code de sécurité, et il porte désormais un filigrane textuel statistique sur la sortie.
Tarifs. Fable 5.1 coûte 10 $ / 50 $ ; Opus 5.5 coûte 4 $ / 20 $ ; Sonnet 5, le petit frère moins cher, coûte 2 $ / 10 $. Les trois ont un contexte de 1M et un tarif fixe.
Mon verdict. Choisissez Claude quand les derniers points de capacité valent la dépense, ou quand vous plafonniez déjà avec Grok à effort maximal. L'article Claude Opus 5 détaille les compromis du curseur d'effort.
2. GPT-6 Sol
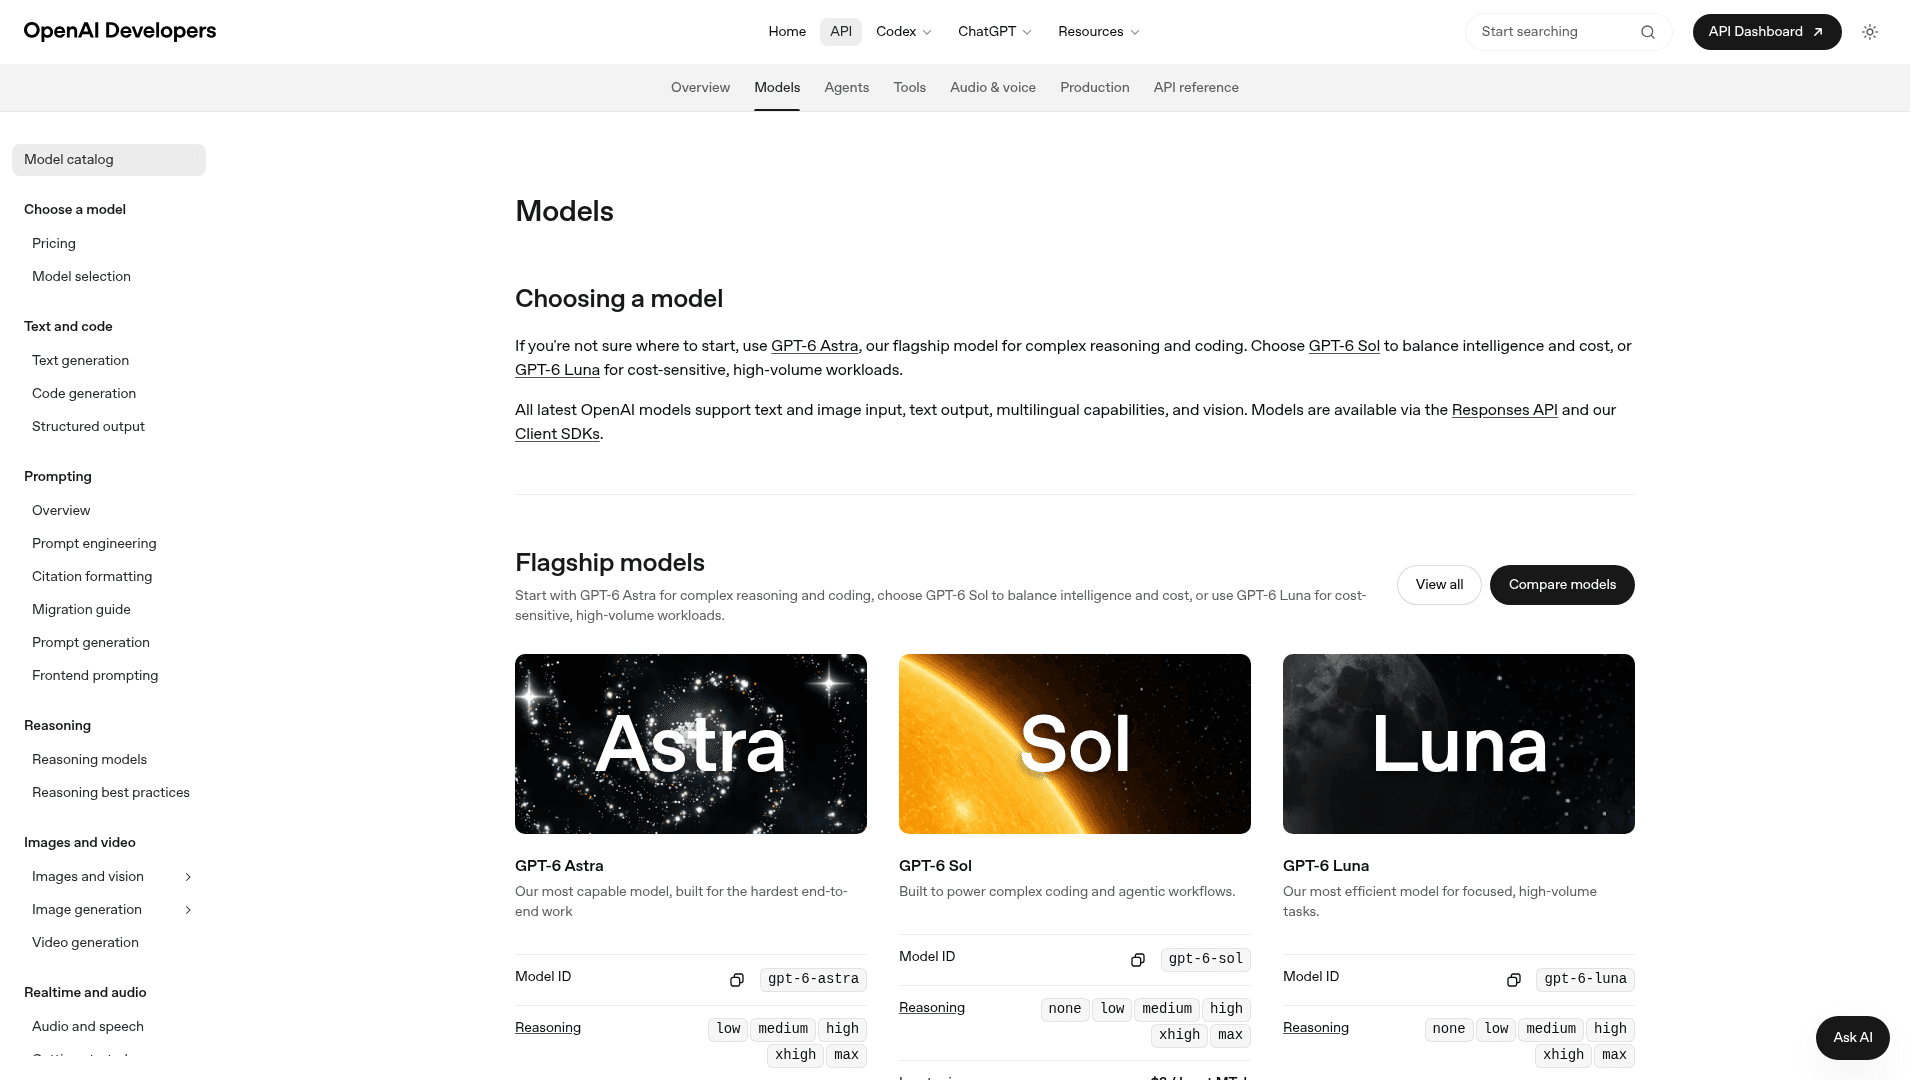
Le GPT-6 Sol d'OpenAI est le modèle que xAI poursuit avec le plus d'acharnement, et c'est le remplaçant le plus direct : un modèle fermé à prix moyen conçu, selon les propres mots d'OpenAI, « pour propulser des flux de travail complexes de codage et d'agentivité ». Il a été lancé le 22 septembre 2026, le même jour que Claude Opus 5.5.
À retenir. L'écosystème. Sol s'intègre à plus d'outils, de SDK et de produits en aval que n'importe quel autre modèle ici, ce qui est souvent la vraie raison pour laquelle les équipes le choisissent. Il est nettement moins cher à la tâche que les Claude les plus intelligents parce qu'il dépense moins de tokens de sortie pour terminer un travail, même si son tarif de sortie par token est plus élevé que celui de Grok.
Avantages. Une énorme surface d'outils et d'intégrations. Un juste milieu sensé sur le prix et l'intelligence. Un raisonnement configurable, d'aucun à maximal.
Inconvénients. Il porte le même seuil de prix à 200k que Grok, qui double sur les longues requêtes. Sur l'indice d'intelligence d'Artificial Analysis, son score à effort maximal reste derrière les meilleurs Claude. Et il coûte un cinquième de plus en sortie que Grok 4.7 au tarif de contexte court.
Tarifs. 2 $ / 10 $ pour le niveau phare Sol, avec le doublement en contexte long au-delà du seuil. Ses petits frères moins chers sont Terra et Luna ; l'ancienne génération GPT-5.6 est aussi toujours disponible.
Mon verdict. Le choix par défaut sûr si votre stack parle déjà OpenAI. Si vous êtes sensible aux coûts et repartez de zéro, Grok 4.7 ou Qwen le battent sur le prix de sortie.
3. Gemini 3.8 Flash
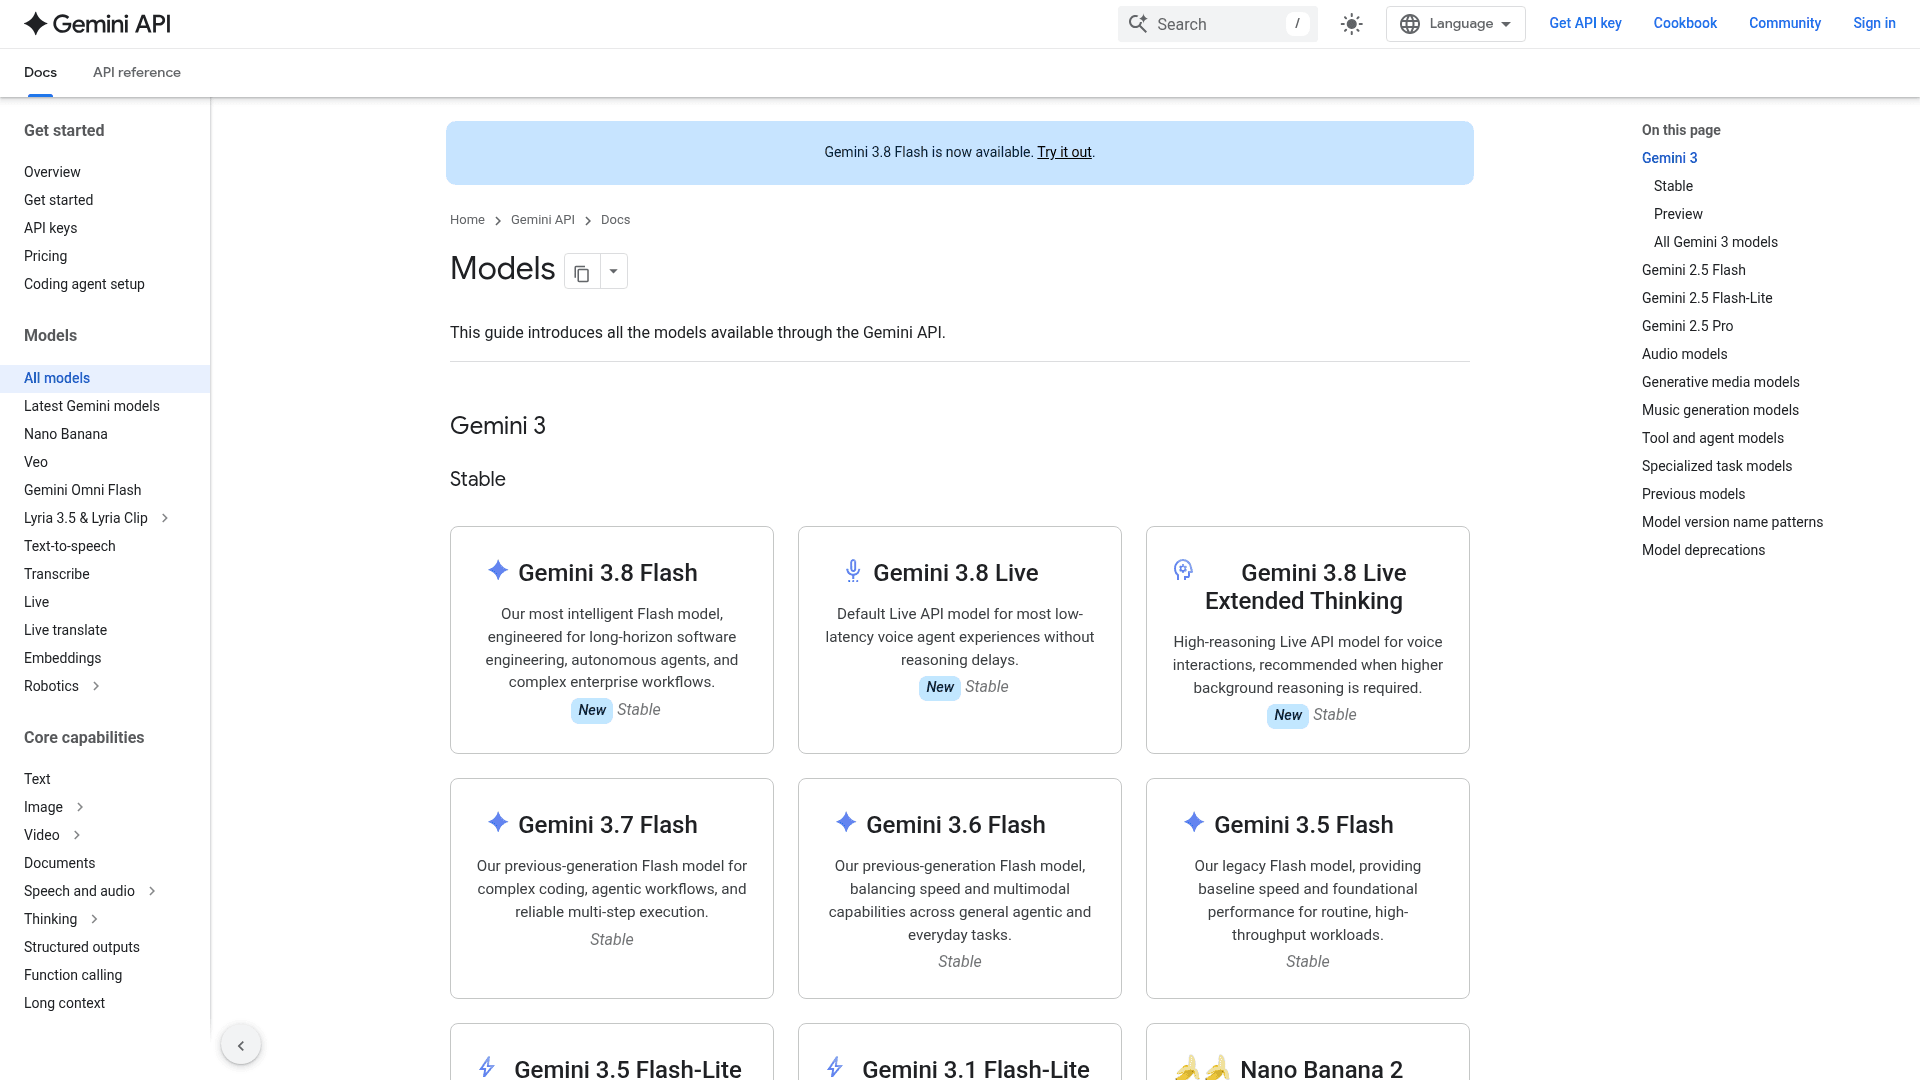
Le Gemini 3.8 Flash de Google est le coin multimodal et bon marché de ce champ. C'est le seul modèle ici qui reçoit de l'audio et de la vidéo nativement en entrée, et son prix affiché est en dessous de tout, sauf DeepSeek.
À retenir. Entrée native de texte, image, audio, vidéo et PDF, le tout via une seule API. Une fenêtre de contexte de 1M de tokens sans seuil de prix. Et à 0,75 $ / 3,75 $, c'est une fraction du coût de Grok, avec un niveau gratuit pour commencer.
Avantages. La meilleure couverture multimodale du tour d'horizon. Très bon marché pour l'intelligence obtenue ; il obtient un bon score sur l'index Artificial Analysis. Se branche directement sur le grounding de Google Search.
Inconvénients. La réactivité est le hic. Artificial Analysis mesure un délai avant premier token de 13,3 secondes contre une médiane de catégorie proche de 3 secondes, ce qui le disqualifie pour tout ce qu'un humain attend en direct, même s'il convient pour du traitement par lots de nuit. Il est aussi bavard, donc le tarif bon marché au token peut gonfler à la tâche. Et le prix promotionnel double à 1,50 $ / 7,50 $ le 1er janvier 2027. Google lui-même suggère de rester sur 3.7 Flash pour les charges de travail axées sur l'efficacité.
Tarifs. 0,75 $ / 3,75 $ jusqu'au 31 décembre 2026, puis 1,50 $ / 7,50 $. Batch et Flex coûtent moitié moins.
Mon verdict. Le choix quand vos entrées sont multimodales ou que vos tâches sont groupées et sensibles au prix. Évitez-le pour tout ce qui dépend de la latence, comme un widget de chat.
4. DeepSeek V4.1 Flash
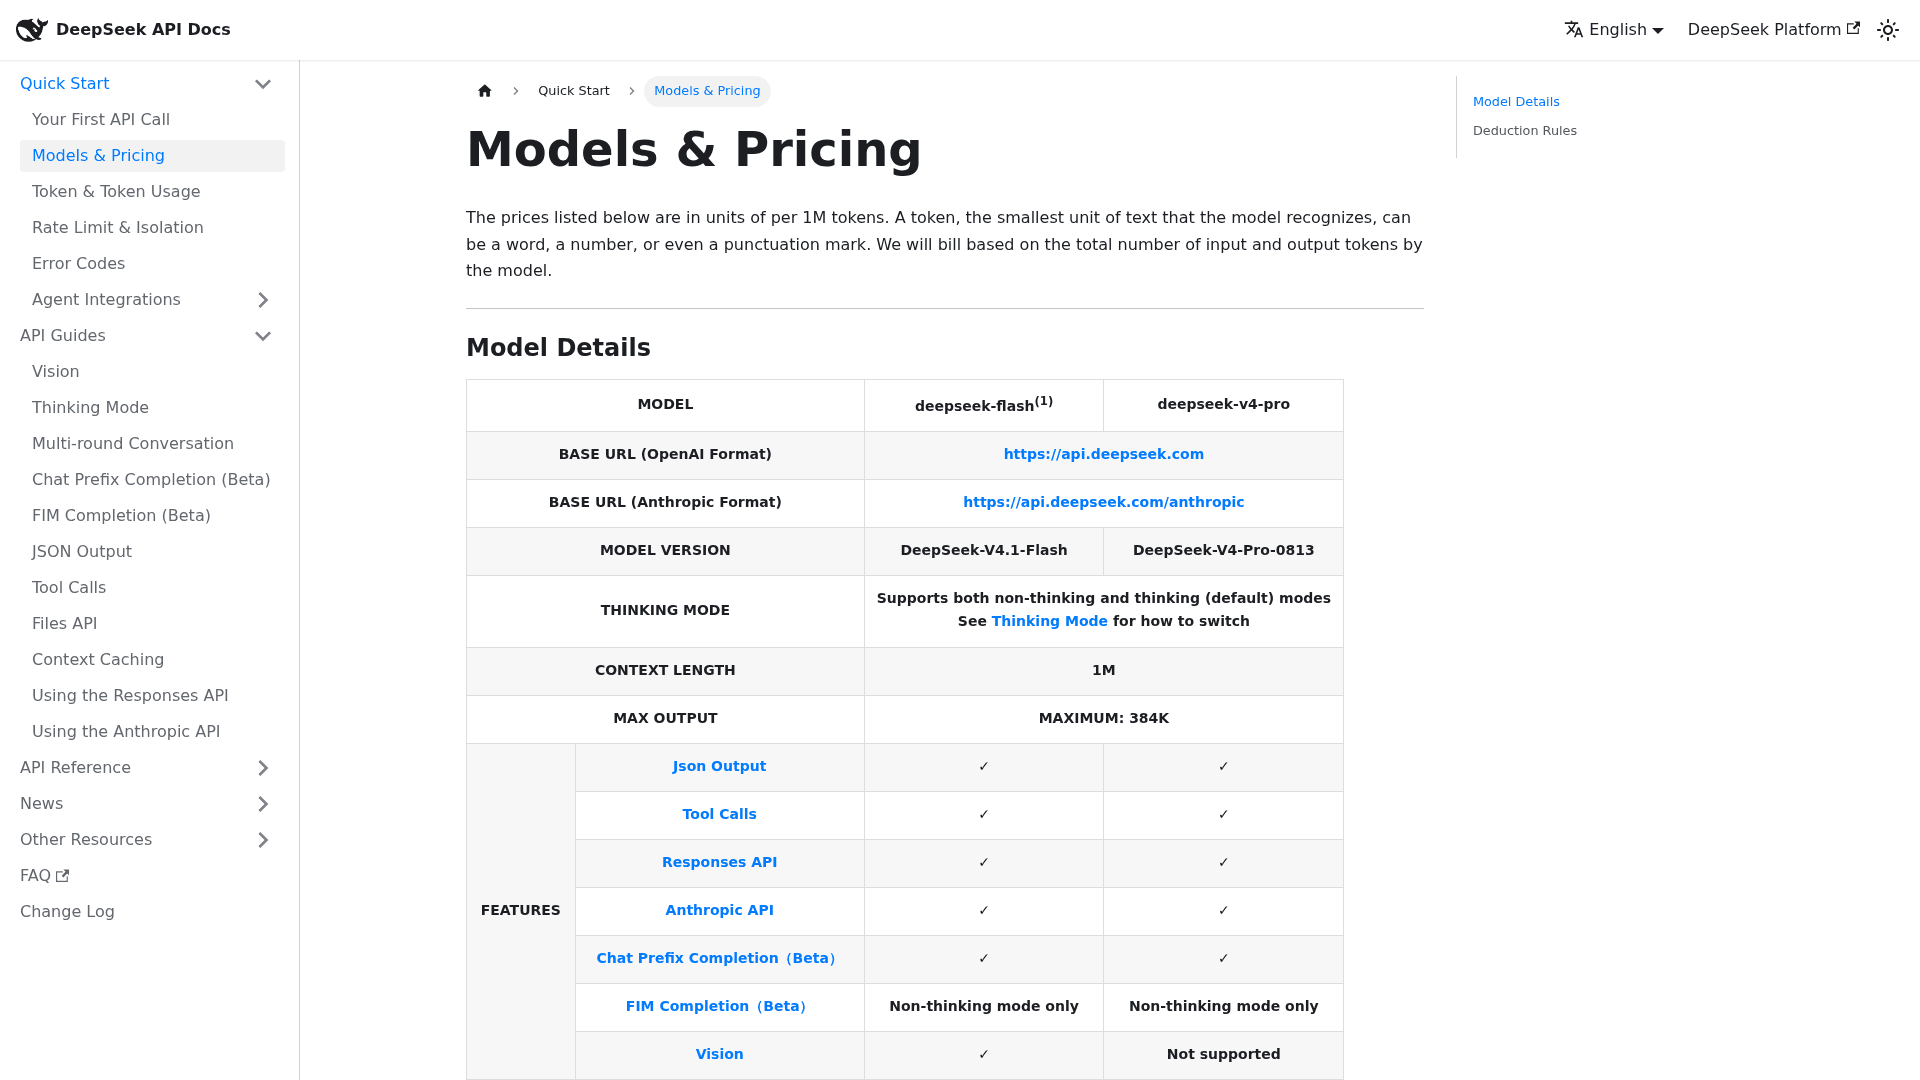
DeepSeek V4.1 Flash est la réponse économique et ouverte à Grok. Il est distribué sous licence MIT, donc vous pouvez télécharger les poids et les faire tourner vous-même, et le tarif hébergé est le moins cher de tout modèle crédible ici.
À retenir. Le prix. Hors pointe, il tourne autour de 0,22 $ en entrée et 0,66 $ en sortie par million, une fraction de Grok 4.7. Les poids ouverts MIT signifient aucune facture au token si vous vous auto-hébergez, et il conserve une fenêtre de contexte de 1M avec une sortie maximale de 384k.
Avantages. L'option crédible la moins chère, hébergée ou auto-hébergée. Une licence réellement ouverte, chose rare à ce niveau de capacité. Des points d'accès API aux formats Anthropic et OpenAI.
Inconvénients. La configuration bon marché et la bonne configuration sont des exécutions différentes des mêmes poids ; des évaluations indépendantes le situent autour de 50 à effort maximal contre 29 sans raisonnement, et les tokens de raisonnement sont facturés au tarif de sortie. Il est uniquement textuel, sans entrée image documentée. Le tarif hors pointe double à peu près pendant les heures ouvrées chinoises. Et les conditions de l'API hébergée restent muettes sur l'usage pour l'entraînement, et les données résident en RPC, donc ce n'est pas un remplacement direct pour des données clients réglementées.
Tarifs. Environ 0,22 $ / 0,66 $ hors pointe, doublant en heures de pointe (01h00 à 04h00 et 06h00 à 10h00 UTC). Pro est un cran au-dessus.
Mon verdict. Le gagnant clair sur le coût pur, surtout en auto-hébergement. Lisez les petites lignes sur la résidence des données avant de lui envoyer quoi que ce soit de sensible.
5. Kimi K3
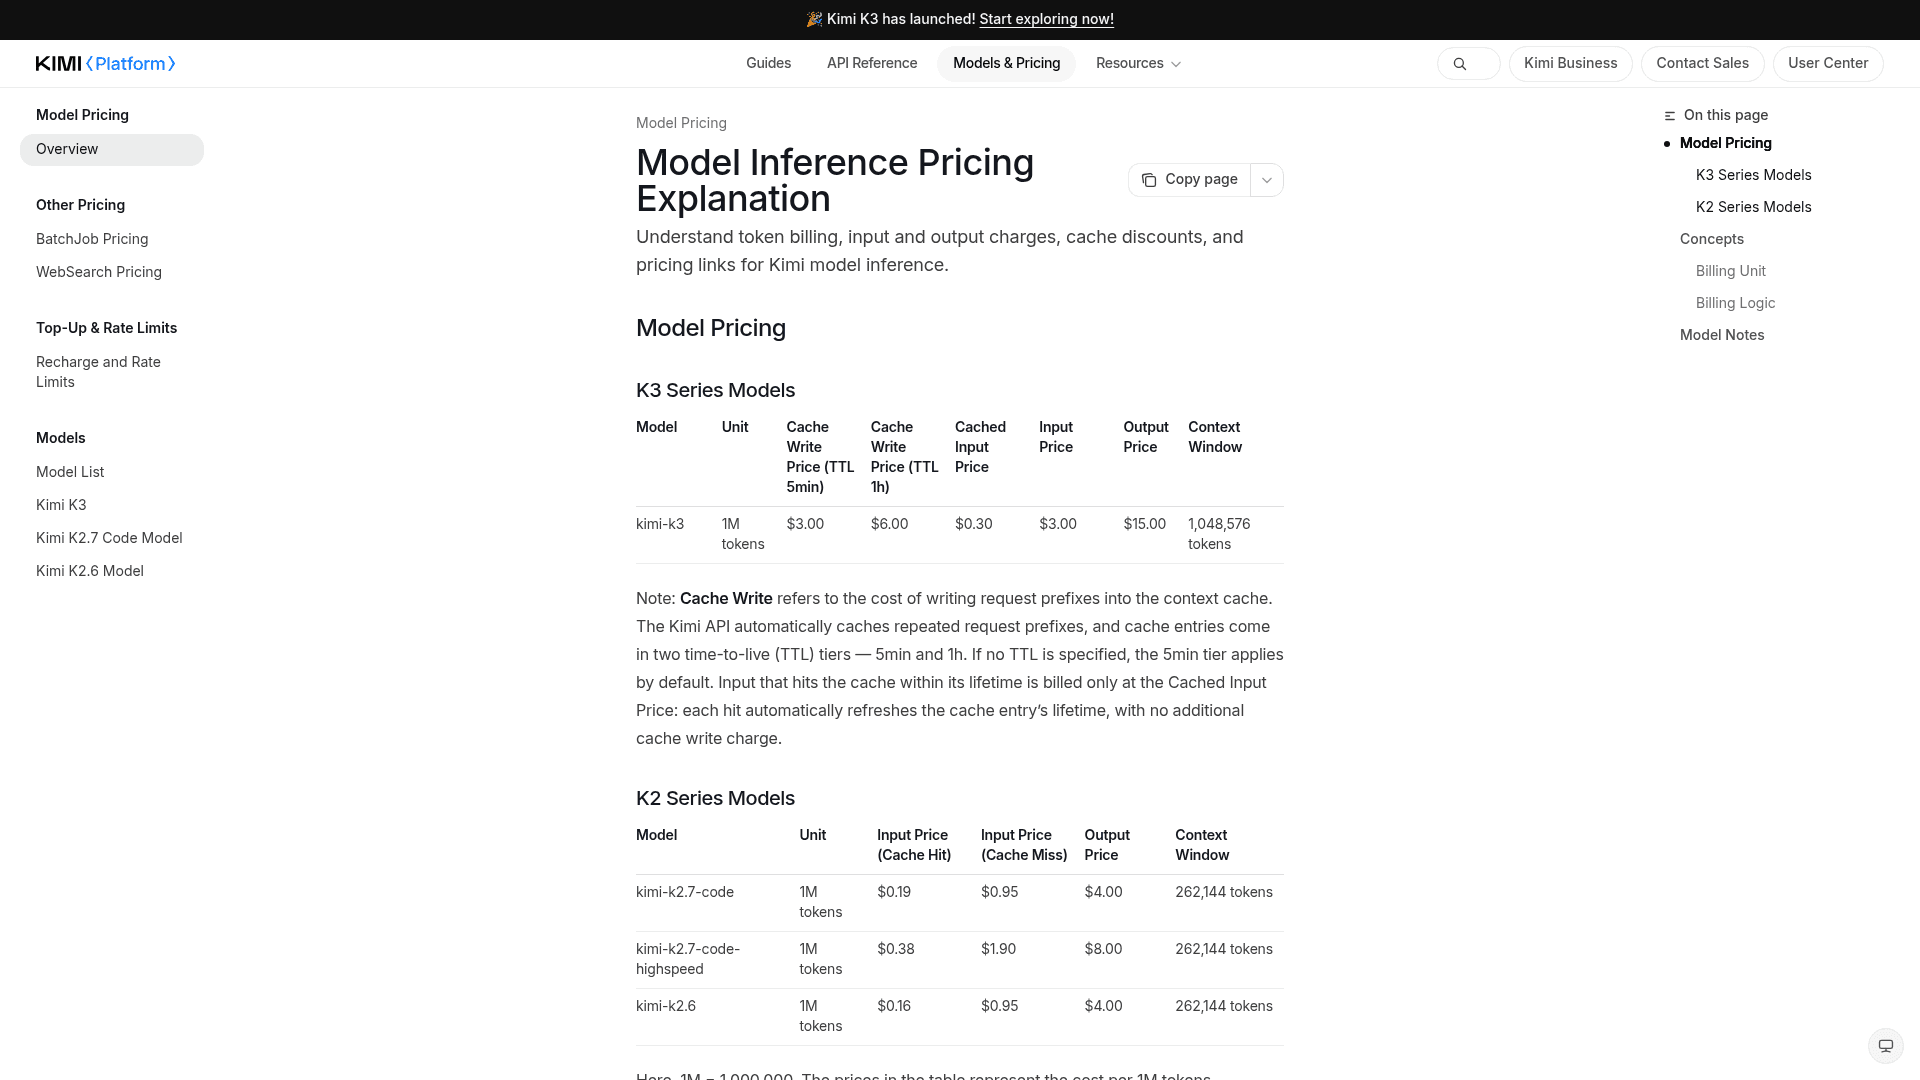
Le Kimi K3 de Moonshot est le modèle à poids ouverts qui obtient le meilleur score sur des benchmarks indépendants. C'est un modèle à mélange d'experts de 2,8 billions de paramètres avec 104 milliards actifs, et Moonshot a publié les poids sur Hugging Face comme prévu.
À retenir. Il se situe autour de 57 sur l'indice d'intelligence Artificial Analysis, devant la plupart des modèles ouverts et juste derrière la pointe fermée. Vision native, contexte de 1M de tokens et une publication de poids réellement ouverte en font le modèle le plus capable ici que vous puissiez réellement héberger.
Avantages. L'intelligence à poids ouverts la plus forte de ce tour d'horizon. Un vrai contexte de 1M avec un effort de raisonnement configurable. Les poids sont publics, avec des quantifications communautaires déjà disponibles.
Inconvénients. L'API hébergée n'est pas bon marché : 3 $ / 15 $ le place dans la catégorie de Claude Sonnet, pas dans le segment économique. Le raisonnement ne peut pas être désactivé, seulement accéléré, donc il n'y a pas de mode ultra-économique. Et les URL d'image publiques ne sont pas acceptées ; vous devez passer du base64 ou un identifiant de fichier.
Tarifs. 3 $ en entrée, 15 $ en sortie, 0,30 $ en cache, sur un contexte de 1 048 576 tokens.
Mon verdict. Le choix quand vous voulez une qualité proche de la pointe et des poids ouverts en même temps, et que vous pouvez absorber le tarif hébergé plus élevé ou le faire tourner vous-même.
6. Qwen 3.8 Max
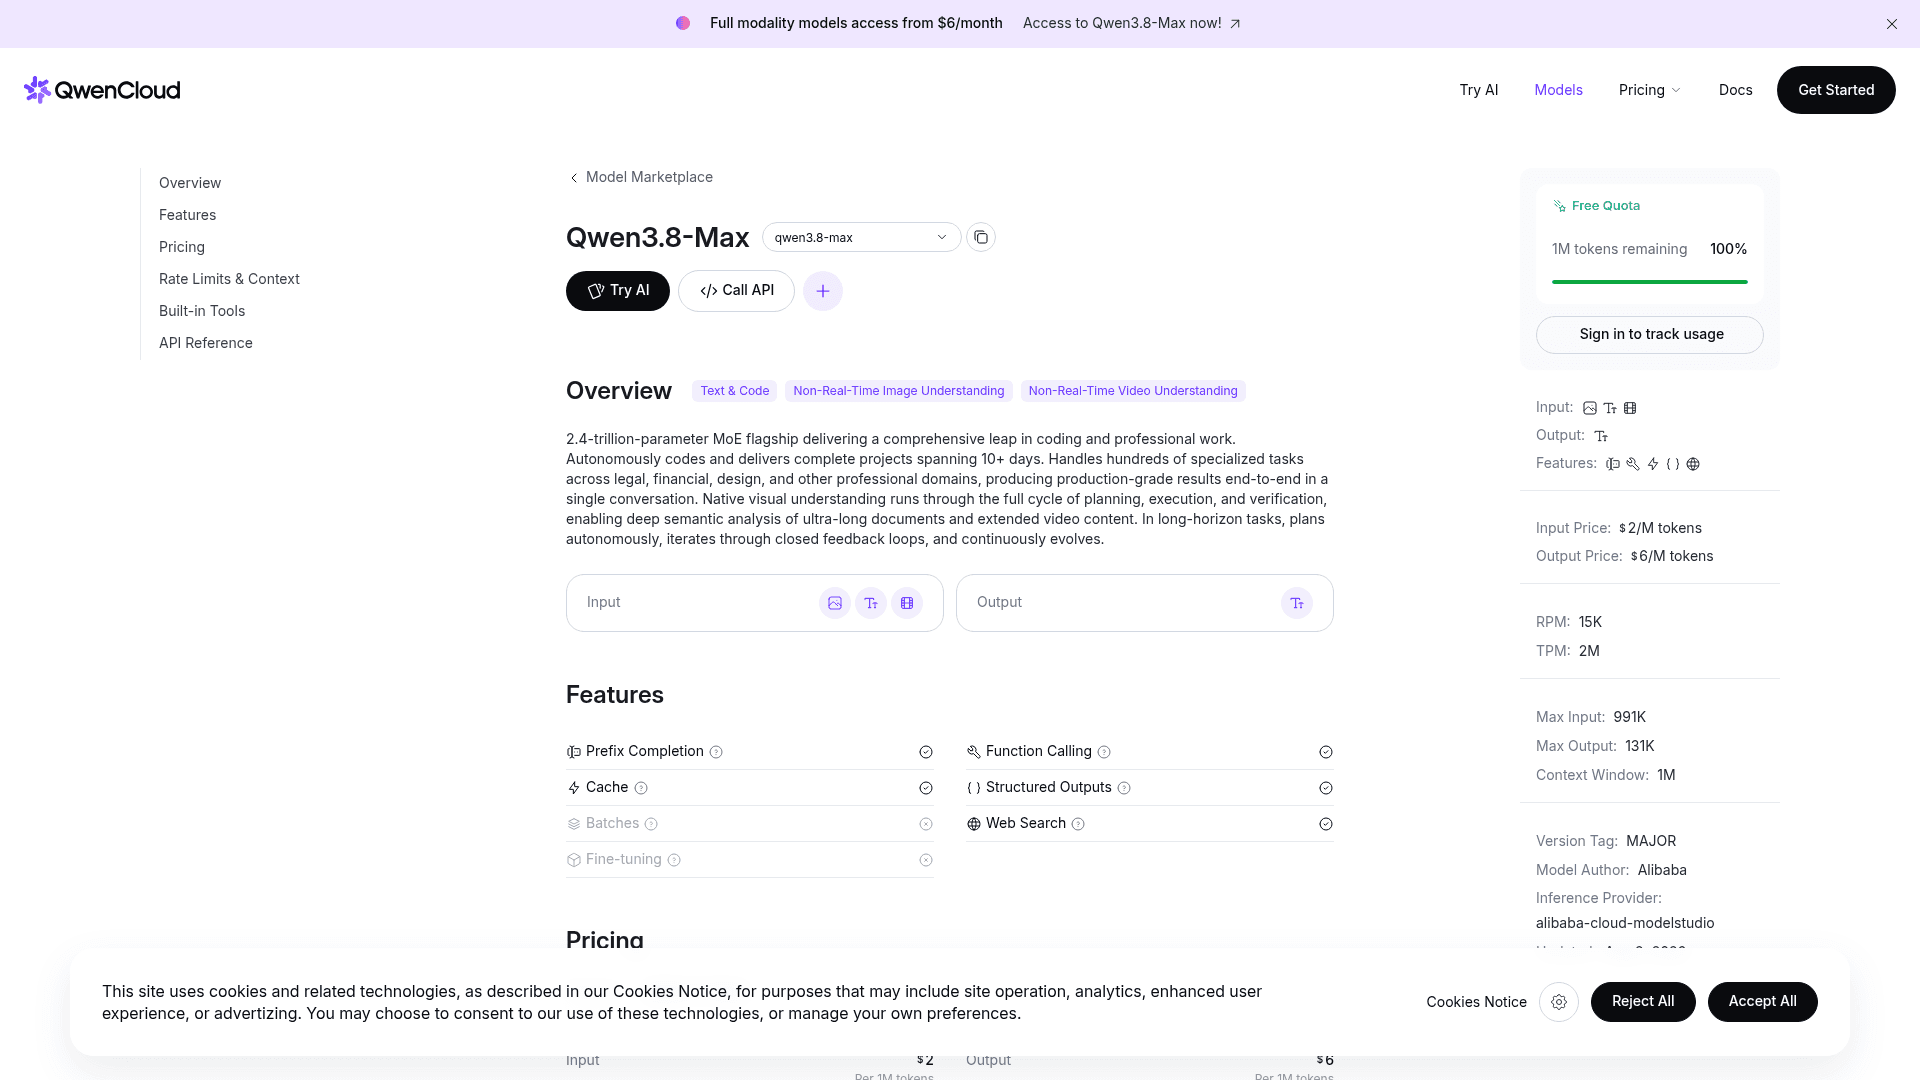
Le Qwen 3.8 Max d'Alibaba est la correspondance de prix la plus directe : il facture exactement les mêmes 2 $ / 6 $ que Grok 4.7, avec une fenêtre de contexte fixe plus grande et un modèle de base ouvert en dessous.
À retenir. Même tarif que Grok, aucun seuil à 200k, et un classement indépendant solide (environ le rang 6, indice ~58 sur Artificial Analysis). C'est un MoE de 2,4 billions de paramètres avec compréhension native de l'image et de la vidéo et des outils intégrés, et Alibaba a aussi publié un modèle de base ouvert.
Avantages. Égale le prix de Grok avec une facturation fixe sur une fenêtre de contexte de 1M. Entrée multimodale native. Une base ouverte pour les équipes qui veulent auto-héberger une partie du stack.
Inconvénients. La base ouverte n'est pas équivalente en fonctionnalités au Max hébergé : la vision, le mode sans raisonnement et les outils intégrés sont réservés à la version hébergée. Son propre harnais de codage plafonne la sortie bien en dessous du plafond de 131k, donc la limite de sortie annoncée reste théorique pour la plupart des utilisateurs. Et la licence du grand checkpoint ouvert est une licence Qwen personnalisée, pas Apache.
Tarifs. 2 $ / 6 $ par million, lecture de cache implicite autour de 0,25 $, sur un contexte de 1M avec une sortie maximale de 131k.
Mon verdict. Si vous aimez le prix de Grok mais voulez une facturation fixe en contexte long et une option multimodale, Qwen est le remplaçant le plus proche de cette liste.
7. eesel : quand vous voulez un coéquipier, pas un modèle

Voici la partie honnête. Chaque modèle ci-dessus est un moteur. Aucun d'eux, à lui seul, ne résout un ticket de support, ne rédige une réponse pour un centre d'aide, ni n'écrit un article de blog qui sera publié tel quel. Vous n'achetez pas un modèle pour faire un travail ; vous achetez un modèle pour construire quelque chose qui fait un travail, et c'est cette deuxième étape qui concentre réellement le coût et le risque.
L'un de nos clients, Karel de GENERAL BYTES, a résumé simplement le dilemme construire ou acheter :
« Nous aurions pu essayer d'écrire notre propre application LLM, mais nous ne voulions pas y investir notre temps. Nous voulions quelque chose que nous n'aurions pas à maintenir. »
Karel, GENERAL BYTES
C'est le vide que comble eesel. eesel est une plateforme de coéquipiers IA : au lieu de louer des tokens et d'assembler le reste vous-même, vous embauchez un coéquipier prêt à l'emploi pour un poste défini. L'équipe actuelle compte un coéquipier helpdesk IA et un rédacteur de blog IA. Chacun arrive déjà connecté aux intégrations, compétences et contexte d'entreprise que son poste exige, tournant sous le capot sur des modèles de pointe comme ceux de ce tour d'horizon.
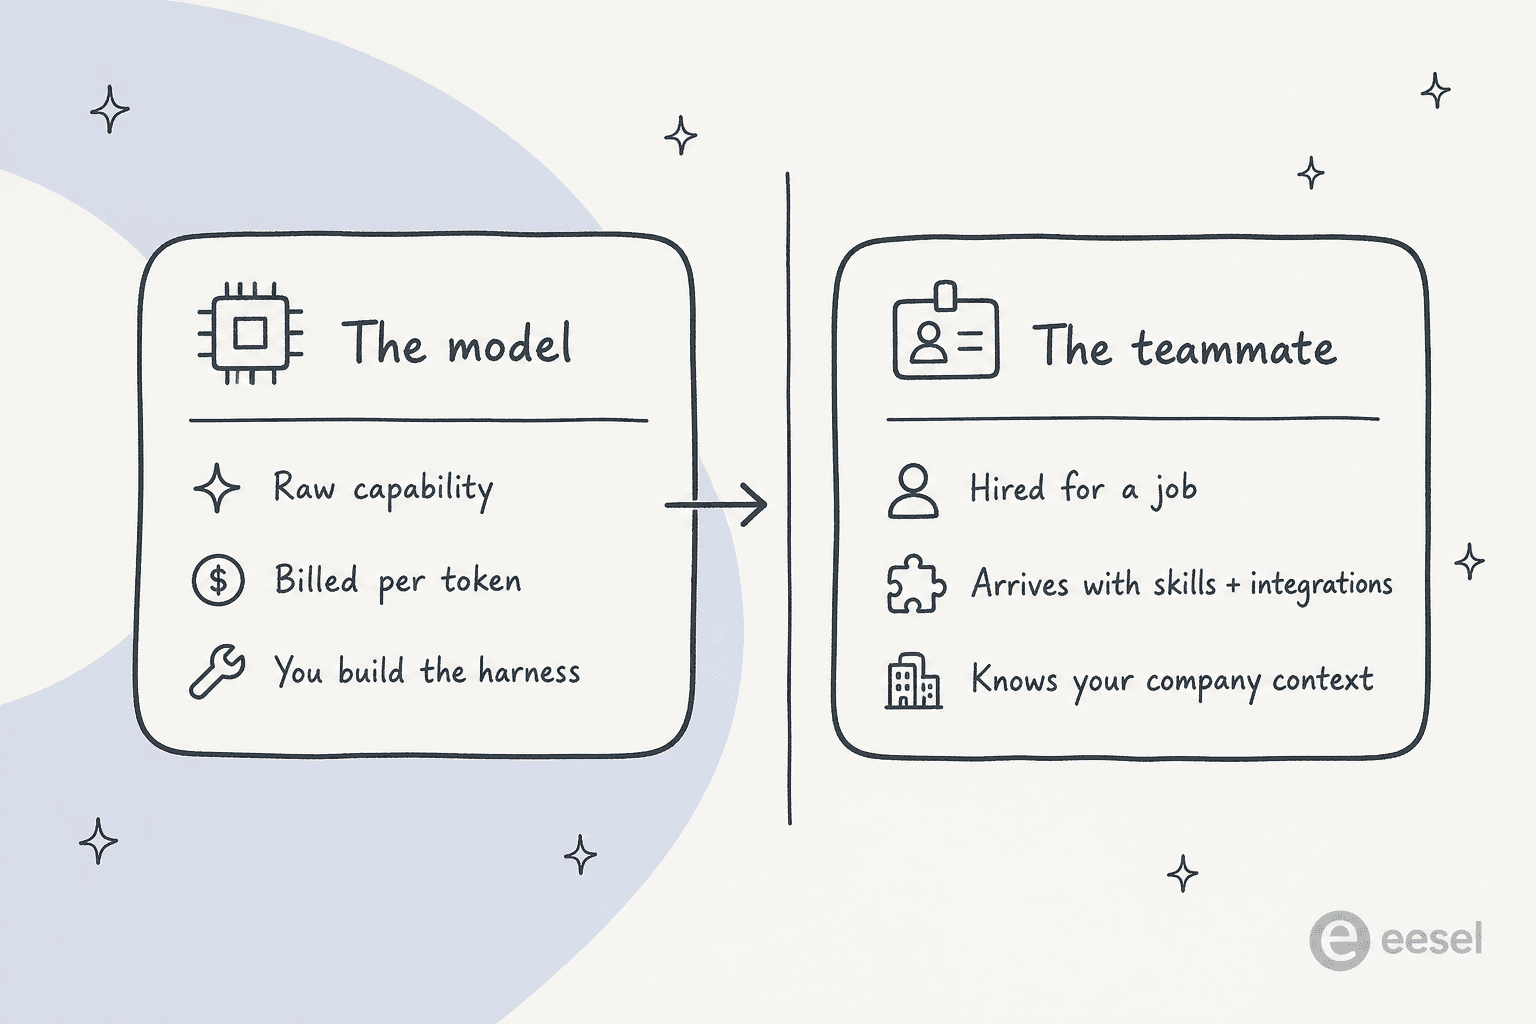
Pour les ingénieurs qui aiment la ligne de commande, ce coéquipier est scriptable. La CLI eesel vous permet d'exploiter le même coéquipier et le même espace de travail depuis un terminal, de le brancher dans des scripts, ou de le piloter depuis un agent de codage comme Claude Code, Codex ou Cursor. L'instinct « je veux un accès programmatique à un modèle » qui pousse les gens vers l'API xAI est donc satisfait un cran plus haut : vous obtenez un accès programmatique à un coéquipier qui a déjà votre contexte, pas un simple point de terminaison de complétion autour duquel vous devez encore construire un produit.
La partie qui m'importe le plus, après avoir bâti cette plomberie pendant des années, c'est que vous pouvez simuler un déploiement sur vos propres tickets historiques avant qu'il ne touche un seul client. Un score de benchmark ne peut pas vous dire si un modèle donnera une réponse fausse avec assurance sur vos données. Une simulation sur vos vrais tickets passés, si. C'est la différence entre choisir un modèle et en déployer un.
Quelle alternative à Grok 4.7 choisir ?
Choisissez la priorité qui compte le plus pour vous et lisez la recommandation.
Pour conclure
Grok 4.7 est difficile à battre sur le rapport prix-performance, donc l'alternative gagnante est celle qui correspond à votre vraie priorité. Claude pour l'intelligence, DeepSeek ou Gemini pour le coût, Kimi K3 ou Qwen pour les poids ouverts, GPT-6 Sol pour l'écosystème. Si vous hésitez entre les générations Grok 4.5, l'article Grok 4.6 couvre les précédentes.
Mais si ce dont vous avez vraiment besoin, c'est d'un travail accompli, résoudre des tickets ou livrer du contenu, aucun d'eux n'est la réponse à lui seul. C'est la différence entre louer un moteur et embaucher un coéquipier.
Comparer les modèles, c'est la partie facile
Chaque modèle de ce tour d'horizon vous vend de l'intelligence au token. La partie difficile consiste à en tirer quelque chose qui accomplit de manière fiable un vrai travail sur vos données. eesel empaquette un modèle de pointe dans un coéquipier IA qui connaît déjà votre helpdesk et vos documents, et vous permet de le simuler sur vos propres tickets passés avant qu'il ne passe en production, pour que vous ne pariiez pas une interaction client sur un score de benchmark.
Essayez eesel gratuitement, ou réservez une démo pour le voir tourner sur vos propres données.

Questions fréquentes
Quelle est la meilleure alternative à Grok 4.7 ?
Cela dépend de ce à quoi vous accordez de la valeur. Pour l'intelligence maximale, Fable 5.1 de Claude domine la plupart des classements. Pour un modèle fermé moins cher avec un immense écosystème, GPT-6 Sol est le choix sûr. Pour un modèle à poids ouverts que vous pouvez auto-héberger, DeepSeek V4.1 Flash est la moins chère des alternatives crédibles à Grok 4.7. Qwen 3.8 Max égale exactement le tarif de Grok à 2 $ / 6 $.
Existe-t-il une alternative moins chère à Grok 4.7 ?
Oui. Grok 4.7 coûte 2 $ par million de tokens en entrée et 6 $ en sortie, mais DeepSeek V4.1 Flash tourne autour de 0,22 $ / 0,66 $ en heures creuses et est à poids ouverts, et Gemini 3.8 Flash affiche 0,75 $ / 3,75 $ jusqu'à fin 2026. Les deux sont nettement moins chers que Grok 4.7, avec les compromis habituels en intelligence et, pour DeepSeek, en résidence des données.
Quelle est la meilleure alternative à poids ouverts à Grok 4.7 ?
Grok 4.7 est fermé. Si vous avez besoin de poids ouverts que vous pouvez héberger vous-même, les options les plus solides sont Kimi K3 (2,8 billions de paramètres, MoE), la base ouverte de Qwen 3.8 Max, et DeepSeek V4.1 Flash sous licence MIT. DeepSeek est le moins cher à faire tourner ; Kimi K3 obtient le meilleur score des trois sur des benchmarks indépendants.
Grok 4.7 ou Claude, lequel est le meilleur ?
Sur l'intelligence brute, Claude l'emporte. Fable 5.1 devance Grok 4.7 sur CursorBench, Terminal-Bench et le classement AA Briefcase. Mais Grok 4.7 coûte environ un cinquième du prix de Fable 5.1, donc la vraie question est de savoir si les derniers points de capacité valent la dépense. La critique de Grok 4.7 détaille cette comparaison directe.
Combien coûte Grok 4.7 par rapport à ses alternatives ?
Grok 4.7 coûte 2 $ / 6 $ par million de tokens sous 200k, exactement comme Qwen 3.8 Max. GPT-6 Sol coûte 2 $ / 10 $, Claude Opus 5.5 coûte 4 $ / 20 $, et Fable 5.1 coûte 10 $ / 50 $. Le segment économique est occupé par DeepSeek et Gemini Flash. Les chiffres complets figurent dans le guide des tarifs de Grok 4.7 et l'aperçu des tarifs xAI.
Certaines alternatives à Grok 4.7 évitent-elles le seuil de prix des 200k ?
Oui. Grok 4.7 double son tarif dès qu'une requête dépasse 200k tokens de prompt, et GPT-6 Sol fait de même. Claude et Gemini facturent un seul tarif fixe sur toute leur fenêtre de contexte, donc pour le travail sur de longs documents ou de grandes bases de code, ils peuvent finir moins chers que le prix affiché ne le laisse penser.
Quelle est la meilleure alternative à Grok 4.7 pour le support client ?
Aucun de ces modèles n'est un outil de support à lui seul ; ce sont des moteurs. Si la tâche consiste à résoudre des tickets, une plateforme d'IA pour le service client comme eesel empaquette un modèle de pointe avec votre helpdesk, votre base de connaissances et un flux d'automatisation du support, si bien que vous embauchez un coéquipier au lieu de louer des tokens.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.