Ce qu'est vraiment Exa Agent Ultra
D'abord, l'entreprise. Exa est une API de recherche conçue pour les agents IA, qui donne aux modèles un accès en temps réel au web avec des résultats structurés et cités. Ce n'est pas un petit acteur non plus : Exa affirme que 500 000 développeurs construisent dessus, avec un index qu'elle estime à 100 milliards de documents. Devin de Cognition, Cursor et Firefox s'appuient tous dessus pour la recherche d'information.
Agent Ultra repose sur cet index. L'API Exa Agent est l'« API unique pour la recherche web de pointe » d'Exa, et l'effort est le réglage qui décide de l'intensité de son travail. Les niveaux sont minimal, low, medium, high, xhigh, auto et ultra, auto étant la valeur par défaut. Ultra est le sommet de cette échelle, et le journal des modifications le date du 24 septembre 2026.
Le modèle mental qui m'a aidé : les niveaux fixes répondent à une question, Ultra mène une enquête à son terme. Exa le présente comme le mode « conçu pour les recherches les plus difficiles, où l'exhaustivité et la précision comptent le plus », c'est-à-dire la recherche approfondie, la constitution de listes et l'enrichissement d'entités, toute tâche qui doit aller jusqu'à l'épuisement.
Concrètement, cela donne des missions comme « toutes les entreprises américaines qui fabriquent des outils d'automatisation de navigateur », ou « toutes les fintechs de série A à C qui ont recruté un Head of Risk ces 12 derniers mois », ou enrichir une liste avec un champ qui demande un jugement, comme « cette entreprise vend-elle aux hôpitaux ? », chaque réponse portant une URL citée comme preuve. Si vous avez déjà essayé de monter une de ces listes à la main, vous savez exactement quelle corvée Exa vise.
Comment fonctionne Agent Ultra sous le capot
Ce qui est intéressant, c'est l'orchestration, pas un modèle en particulier. Quand vous envoyez une requête, Exa Agent divise la tâche en sous-tâches et affecte des sous-agents pour explorer plusieurs domaines à la fois. Ultra augmente simplement beaucoup le nombre de sous-agents et de sources.
Deux choix de conception font tenir l'ensemble. Le premier est un mélange de modèles : Exa dit placer « l'intelligence de pointe là où une tâche en a besoin et des modèles plus rapides là où ils suffisent », de sorte que vous ne payez pas des tarifs de pointe pour chaque sous-étape triviale. Le second est le modèle de highlights économe en tokens d'Exa, qui extrait les passages les plus pertinents d'une page au lieu de tout fourrer dans le contexte, avec des réductions annoncées jusqu'à 94 % de la consommation de tokens. C'est de là que vient une bonne part de l'avantage de coût.
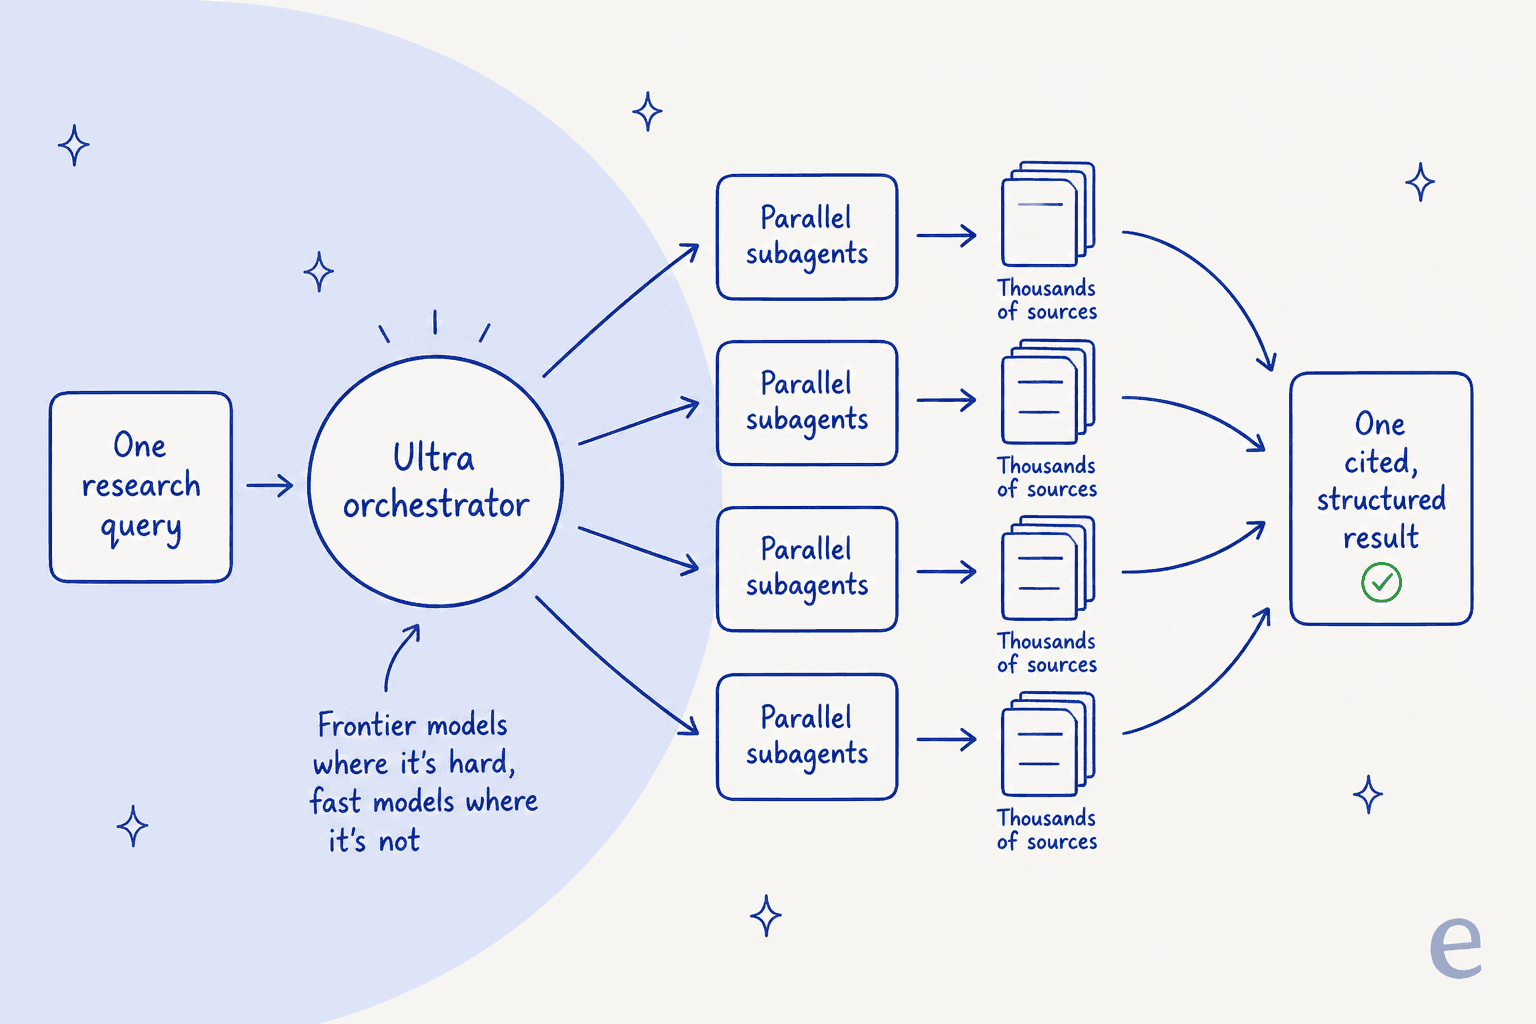
Vous récupérez la recherche assemblée sous forme d'un résultat fondé, au lieu d'orchestrer vous-même chaque appel à /search et /contents. Une exécution terminée contient output.text pour une réponse en langage naturel, output.structured pour du JSON validé par schéma quand vous passez un outputSchema, et output.grounding pour les citations au niveau des champs. Vous pouvez aussi tout piloter depuis le serveur MCP d'Exa avec l'outil agent_run, ce qui signifie qu'un agent de code comme Claude Code ou Cursor peut l'appeler directement.
Les résultats de benchmarks, et comment les lire
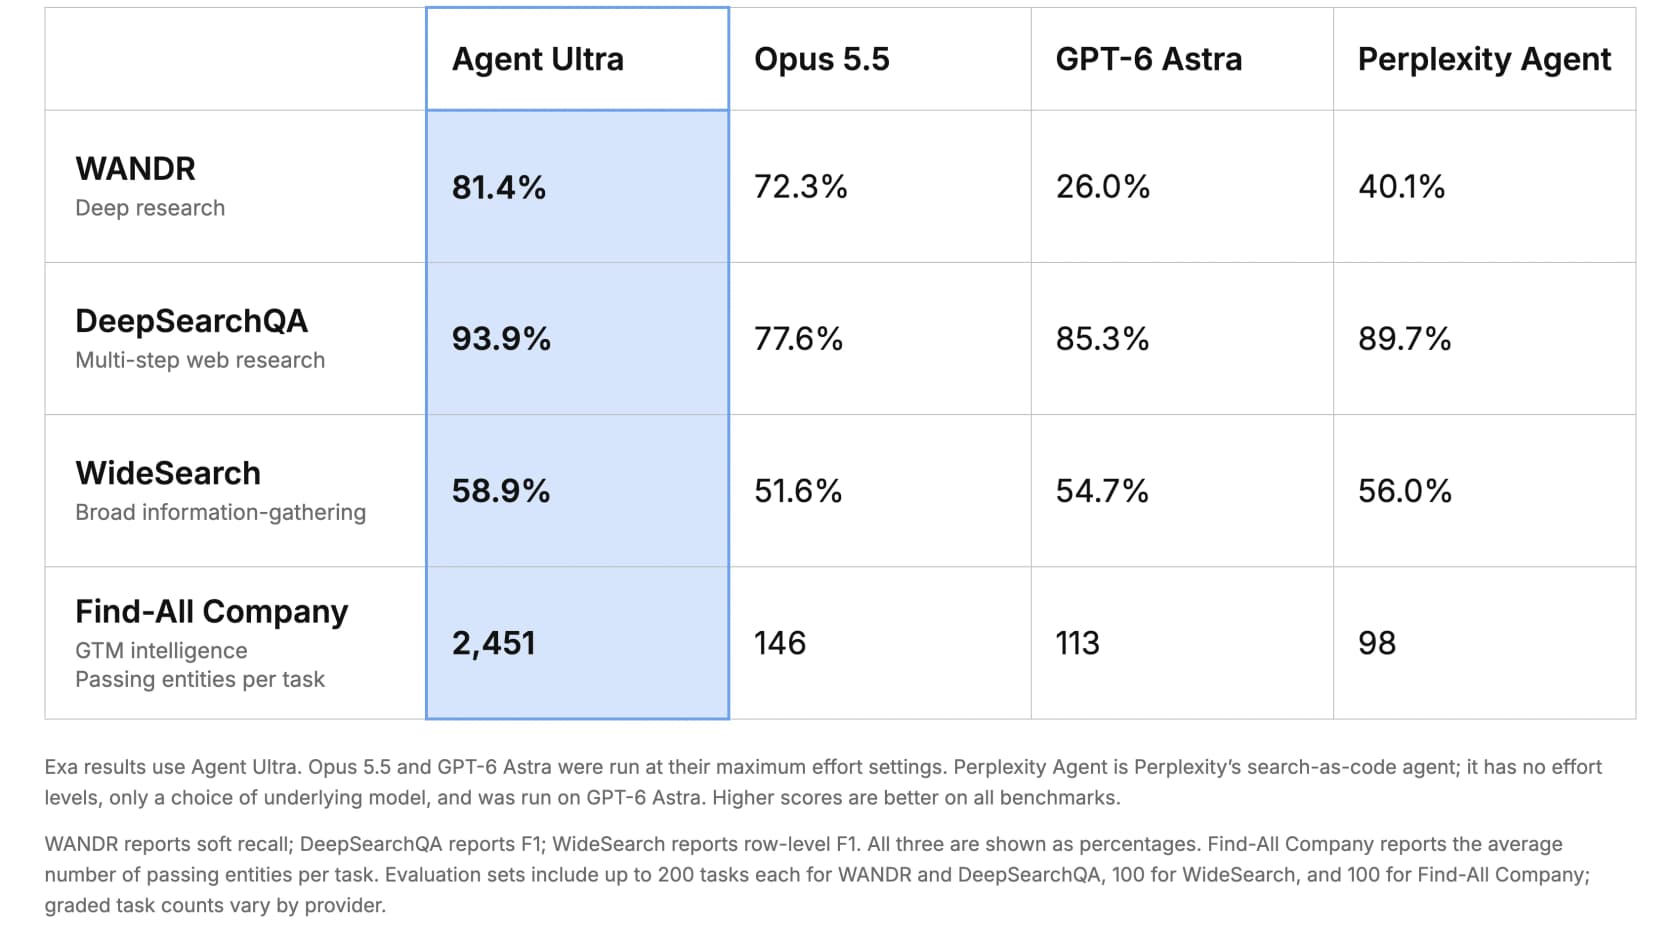
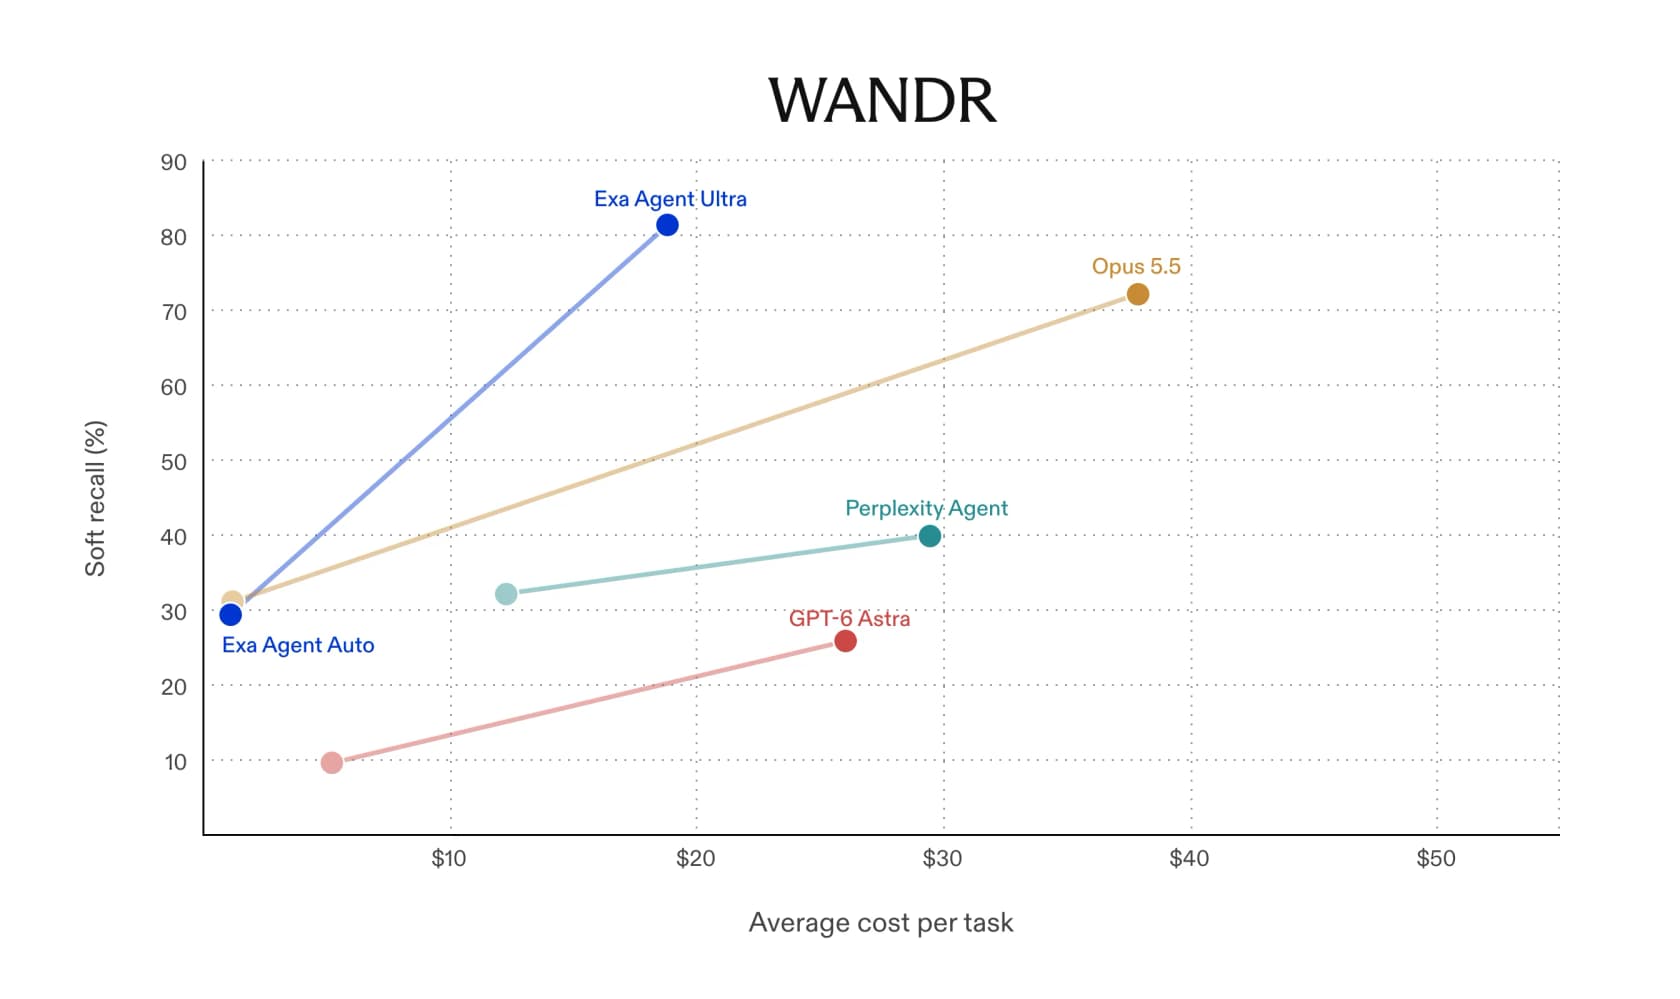
C'est ici qu'Exa voit grand. Agent Ultra, dit-elle, surpasse Opus 5.5, GPT-6 Astra et Perplexity Agent à leurs réglages d'effort maximal sur quatre benchmarks. Les chiffres bruts :
| Benchmark | Ce qu'il mesure | Agent Ultra | Opus 5.5 | GPT-6 Astra | Perplexity Agent |
|---|---|---|---|---|---|
| WANDR | Recherche approfondie (rappel souple) | 81.4% | 72.3% | 26.0% | 40.1% |
| DeepSearchQA | Recherche web en plusieurs étapes (F1) | 93.9% | 77.6% | 85.3% | 89.7% |
| WideSearch | Collecte d'information large (F1 par ligne) | 58.9% | 51.6% | 54.7% | 56.0% |
| Find-All Company | Intelligence GTM (entités validées/tâche) | 2,451 | 146 | 113 | 98 |
La ligne Find-All Company est celle qui vous arrête : une moyenne de 2 451 entités validées par tâche contre 146 pour le meilleur système suivant. C'est la conception « va jusqu'à l'épuisement » qui apparaît sous forme de chiffre. Le graphique WANDR d'Exa raconte l'histoire du coût à côté, avec Ultra autour de 81 % de rappel souple pour environ 18 $ par tâche, alors qu'Opus 5.5 atteint environ 72 % pour près de 38 $.
Passons à la lecture honnête. Ce sont les propres exécutions de benchmark d'Exa, sur un banc de test qu'Exa maintient, jugées par un modèle qu'Exa a choisi (elle utilise gpt-6-luna comme évaluateur). Exa est transparente sur la méthodologie, ce qui compte, et elle indique les chiffres publiés des concurrents quand ils existent. Mais les benchmarks d'un fournisseur flattent le fournisseur par construction, donc la position juste est : impressionnant, plausible et non vérifié. Du côté de la communauté, le lancement a fait du bruit sur X, mais surtout sous forme d'enthousiasme plutôt que de preuve concrète.
"So perplexity is dead 2x now"
Cette réponse est arrivée en tête des réponses au post de lancement d'Exa, qui a lui-même récolté près de 2 000 mentions J'aime. Quelques praticiens ont noté qu'ils l'« essayaient maintenant », ce qui correspond à peu près à l'état de la vérification indépendante deux jours après. Il est vraiment tôt, et j'attendrais des tests extérieurs avant de considérer le classement comme établi.
Ce que coûte Exa Agent Ultra
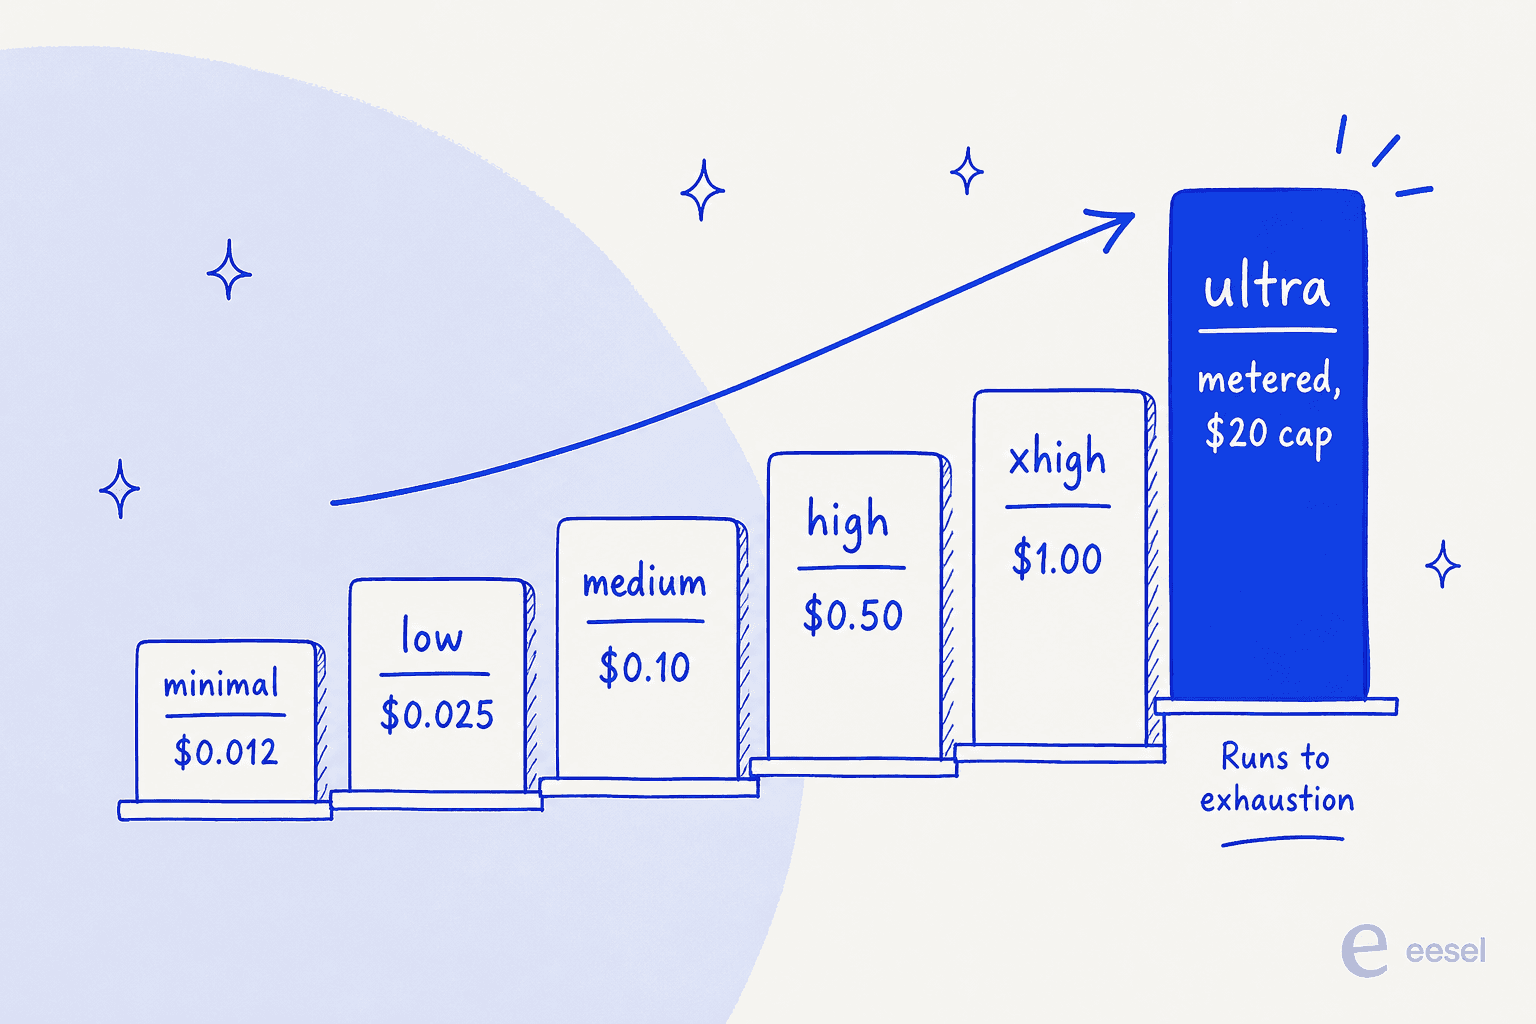
Exa fonctionne à l'utilisation sans licences par utilisateur, et les niveaux d'effort d'Agent correspondent directement au prix. Les niveaux fixes sont prévisibles par requête, et Ultra est l'exception facturée à la consommation.
| Niveau d'effort | Prix | Idéal pour |
|---|---|---|
| minimal | $0.012 / requête | Recherches légères, coût le plus bas |
| low | $0.025 / requête | Tâches factuelles simples et ciblées |
| medium | $0.10 / requête | Le point de départ par défaut |
| high | $0.50 / requête | Recherche plus difficile, exhaustivité plus stricte |
| xhigh | $1.00 / requête | Tâches à forte valeur, exigeant beaucoup de vérification |
| ultra | À la consommation, plafond par défaut de $20 | Constitution exhaustive de listes et recherche |
Sous les exécutions facturées à la consommation, Exa facture les Agent Compute Units à 0,10 $ pièce, les appels à l'outil de recherche à 0,005 $, l'enrichissement d'e-mails à 0,02 $ et celui des téléphones à 0,07 $. Le paramètre budget.maxCostDollars fixe le plafond des exécutions auto et ultra, de 1 $ à 100 $, et budget.maxDurationSeconds permet de limiter la durée de 5 minutes à 3 heures. Une exécution qui se termine plus tôt coûte moins que le plafond, et vous pouvez en arrêter une en cours de route et garder ce qu'elle a trouvé.
Le plafond par défaut de 20 $ est le chiffre sur lequel s'arrêter. Pour une cartographie de marché vraiment exhaustive, 20 $ pour une tâche de recherche qui prendrait une journée entière à une personne est une bonne affaire. Pour un flux de travail déclenché des centaines de fois, ce même plafond représente de l'argent réel, et c'est pourquoi Exa vous donne les réglages de budget. Il existe aussi un niveau Starter gratuit avec 10 $ de crédits mensuels sans carte, pour tester sur vos propres tâches avant de vous engager.
Où il se place : infrastructure de recherche, pas un recrutement pour le support
C'est la partie que je veux le plus faire passer, car la formule « une IA qui fait la recherche à votre place » invite à une mauvaise supposition. Exa Agent Ultra est une infrastructure. C'est un moteur fantastique pour un pipeline GTM qui enrichit des leads, un processus de due diligence qui cartographie un marché ou un agent de recherche que vous construisez vous-même. Dans chacun de ces cas, vous écrivez le code, vous définissez le schéma et vous possédez le flux de travail autour de l'API.
C'est un métier complètement différent de celui de mettre une IA sur votre file de support, et cette différence piège sans cesse les équipes.
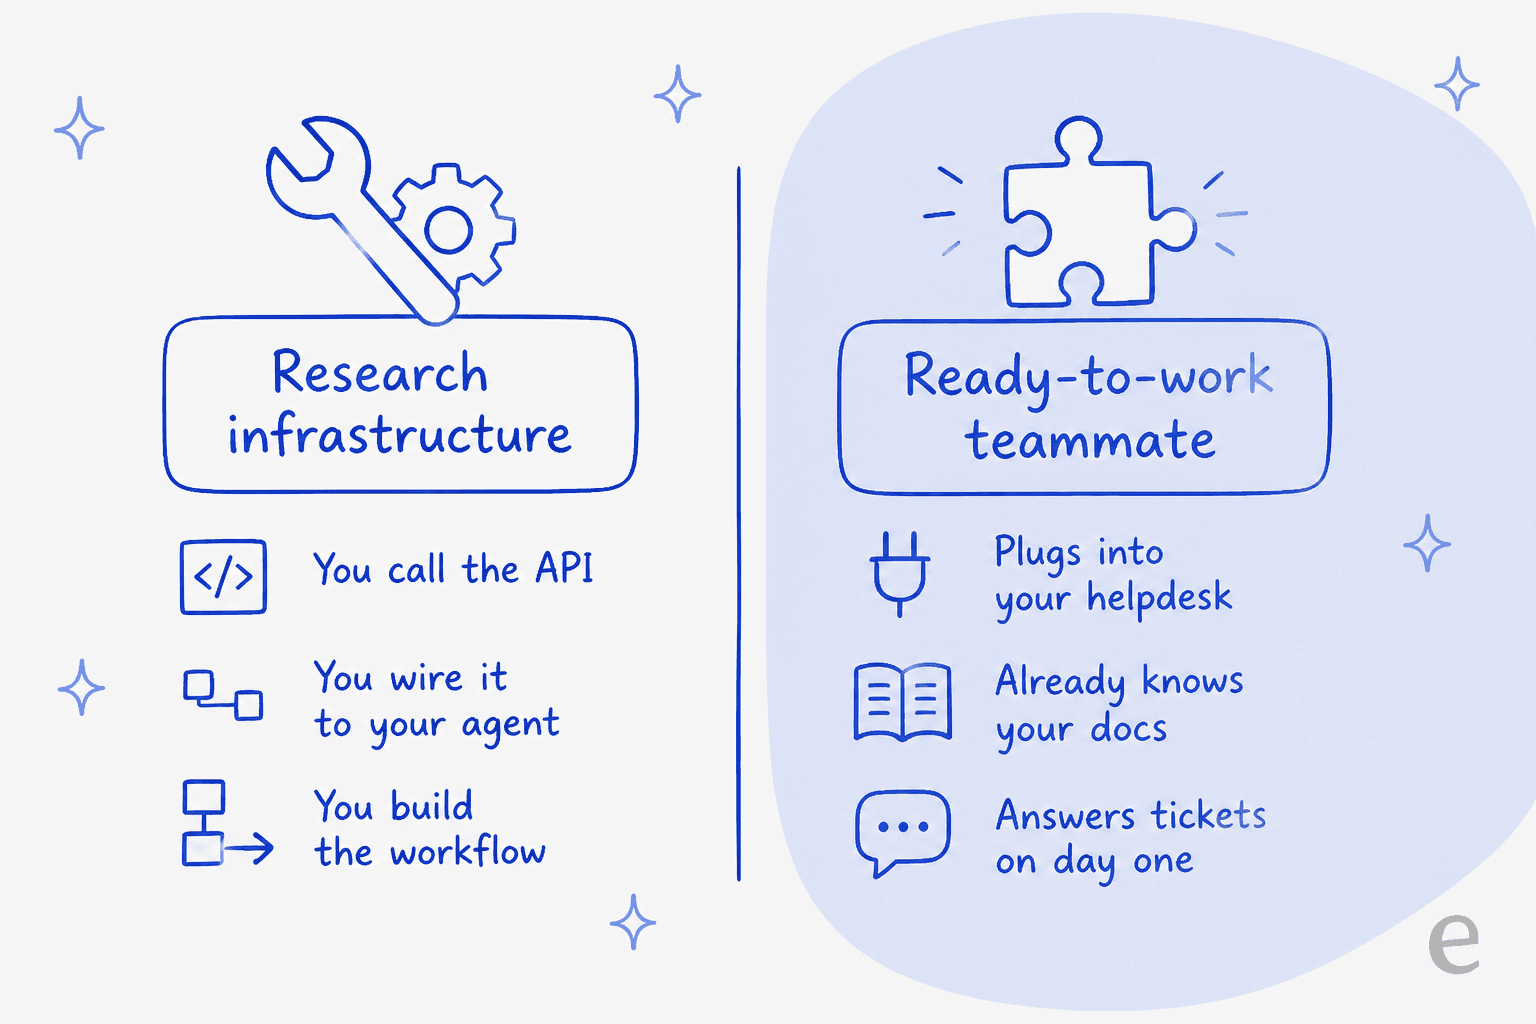
Je travaille côté produit chez eesel, et nous avons passé des années à mettre de l'IA sur des files de support en production, sur des milliers de vrais tickets et de déploiements clients. La leçon qui est restée : la qualité brute de récupération n'est pas le plus dur dans l'automatisation du support. Le plus dur, c'est la confiance, les intégrations de tickets, l'ancrage dans les connaissances internes et savoir quand passer la main à un humain. Une API de recherche, aussi bonne soit-elle, ne vous apporte rien de tout cela d'emblée. Vous devriez construire vous-même la connexion au helpdesk, la logique d'escalade et les contrôles de sécurité par-dessus.
C'est la frontière entre une infrastructure et un coéquipier, et c'est pourquoi nous voyons eesel comme une plateforme de coéquipiers IA plutôt qu'une API. Vous recrutez un coéquipier pour une mission définie, et il arrive prêt à travailler.
Essayer eesel
Si le travail que vous avez réellement est le support, pas un pipeline de recherche, c'est exactement ce pour quoi un agent IA eesel est conçu. Il se branche sur Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de vos documents d'aide, et rédige ou envoie des réponses dès le premier jour, sans code d'intégration d'API. Et comme des bots sûrs d'eux peuvent se tromper avec assurance, chaque déploiement est d'abord simulé sur vos tickets historiques, pour que vous voyiez le taux de résolution avant qu'un seul client ne le voie.
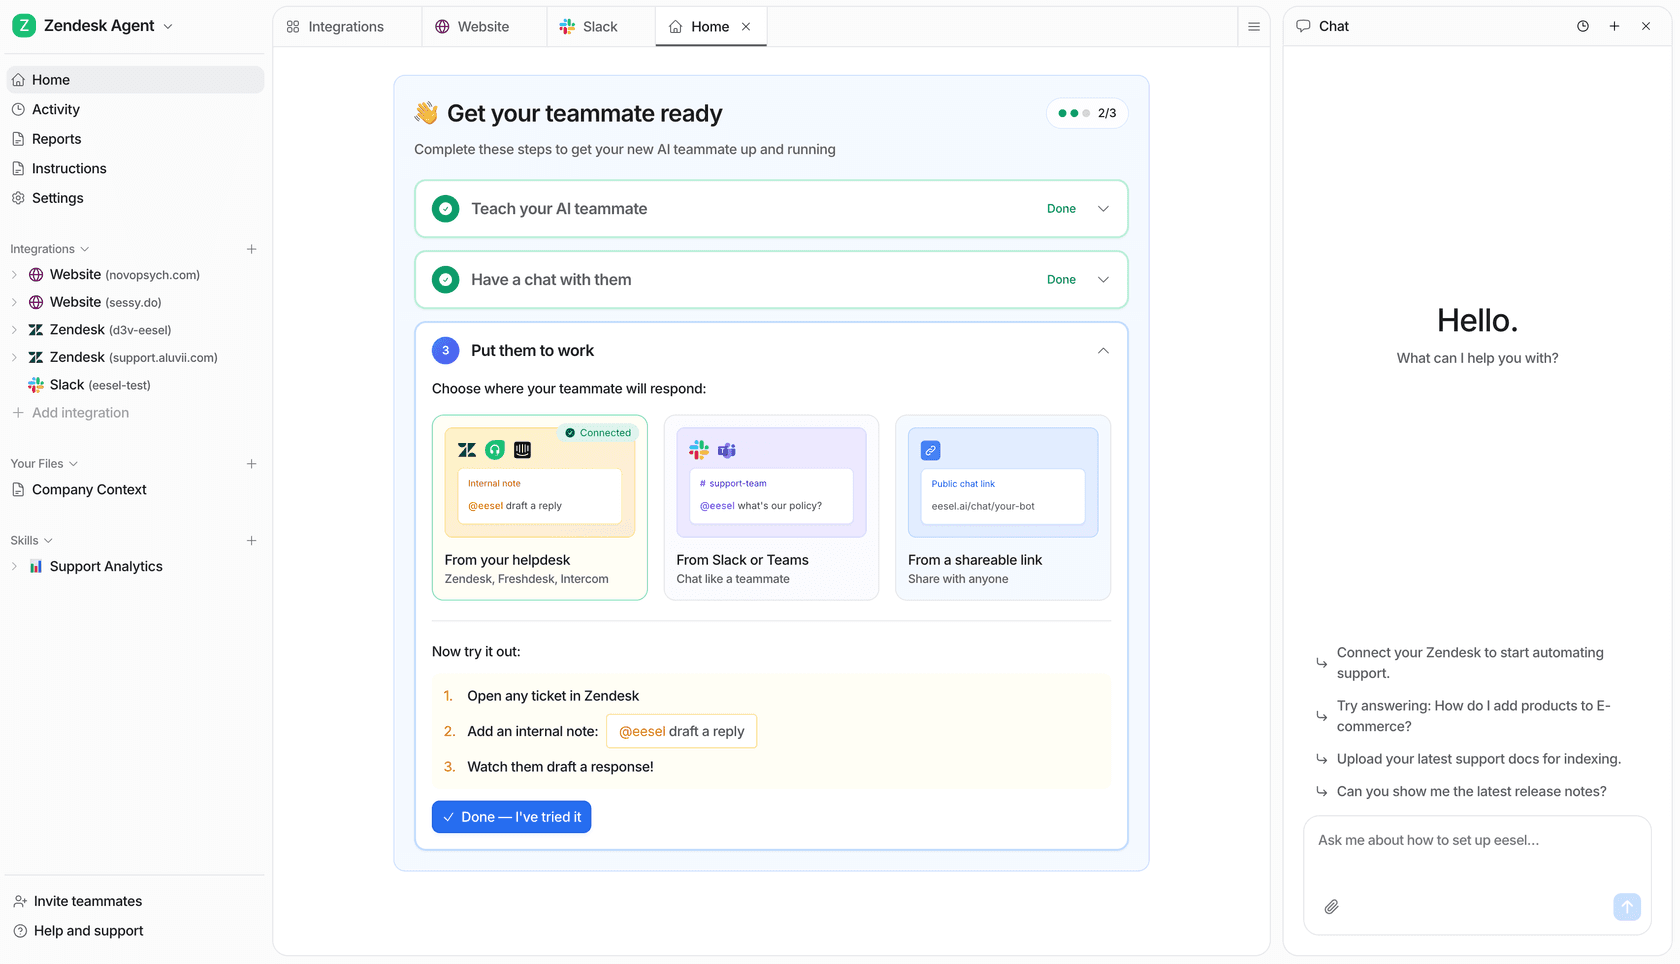
Si vous avez aimé l'idée de piloter Exa depuis un terminal ou un agent de code, eesel vous y retrouve aussi. La CLI d'eesel opère le même coéquipier et le même espace de travail que le tableau de bord, et affiche du JSON, de sorte qu'une personne peut l'exécuter à la main, qu'un script peut l'automatiser et que des agents de code comme Claude Code, Codex et Cursor peuvent la piloter directement. Vous pouvez inspecter les instructions d'un coéquipier, envoyer un prompt de test fictif, examiner la réponse exacte et les sources utilisées, puis proposer une modification d'instruction ciblée à faire approuver par un responsable. C'est le même contrôle sans interface et adapté aux agents qui attire les gens vers une API comme celle d'Exa, tourné vers le vrai travail de faire tourner le support plutôt que d'assembler une pile de recherche. Vous pouvez essayer eesel gratuitement et le voir fonctionner sur vos propres tickets.
Questions fréquentes
Qu'est-ce qu'Exa Agent Ultra ?
Exa Agent Ultra est le niveau d'effort le plus élevé de l'API Exa Agent, un point d'accès de recherche approfondie qui découpe une requête en sous-agents parallèles, lit des milliers de sources et renvoie un résultat structuré et cité. Il est conçu pour constituer des listes exhaustives et enrichir des entités, pas pour des recherches rapides. Si vous voulez ce type de recherche packagé sous forme d'agent IA de support plutôt que d'appels bruts à une API, c'est une autre catégorie de produit.
Combien coûte Exa Agent Ultra ?
Ultra est facturé à l'usage selon la tarification à l'utilisation d'Exa, aux tarifs standard d'Agent jusqu'à un plafond par défaut de 20 $ par exécution. Vous pouvez déplacer ce plafond avec budget.maxCostDollars, de 1 $ à 100 $. Les niveaux d'effort fixes sont moins chers et prévisibles : de minimal à 0,012 $ jusqu'à xhigh à 1,00 $ par requête. Les outils de support comme les tarifs d'eesel facturent plutôt par résolution, ce qui correspond mieux à une file de tickets.
En quoi Agent Ultra diffère-t-il des autres niveaux d'effort d'Exa ?
L'effort est un seul réglage sur Exa Agent : minimal, low, medium, high, xhigh, auto et ultra. Les niveaux fixes ont un prix défini par requête, alors que ultra est facturé à la consommation et pousse une tâche jusqu'à l'épuisement. Monter le réglage achète plus de sous-agents, plus de sources et plus de vérification, pour un coût plus élevé par tâche.
Exa Agent Ultra convient-il au support client ?
C'est une infrastructure de recherche d'information, donc excellente pour rassembler des recherches citées issues du web, mais elle ne se branche pas sur votre helpdesk, n'apprend pas vos documents internes et n'envoie pas de réponses d'elle-même. Pour le support de première ligne, il vous faut un coéquipier qui se connecte à votre file de tickets et répond avec vos propres connaissances, ce que fait un agent IA eesel.
Quels sont les résultats d'Exa Agent Ultra aux benchmarks ?
Exa indique qu'Agent Ultra bat Opus 5.5, GPT-6 Astra et Perplexity Agent sur quatre benchmarks de recherche : 81,4 % de rappel souple sur WANDR, 93,9 % de F1 sur DeepSearchQA, 58,9 % de F1 par ligne sur WideSearch et une moyenne de 2 451 entités validées par tâche sur Find-All Company. Ce sont les propres exécutions d'Exa, considérez-les donc comme des chiffres du fournisseur tant que des tests indépendants n'existent pas. Pour tout agent IA que vous déployez, le tester sur vos propres données compte plus que le classement.


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.