

Ce qu'est vraiment TypeSafe Jev
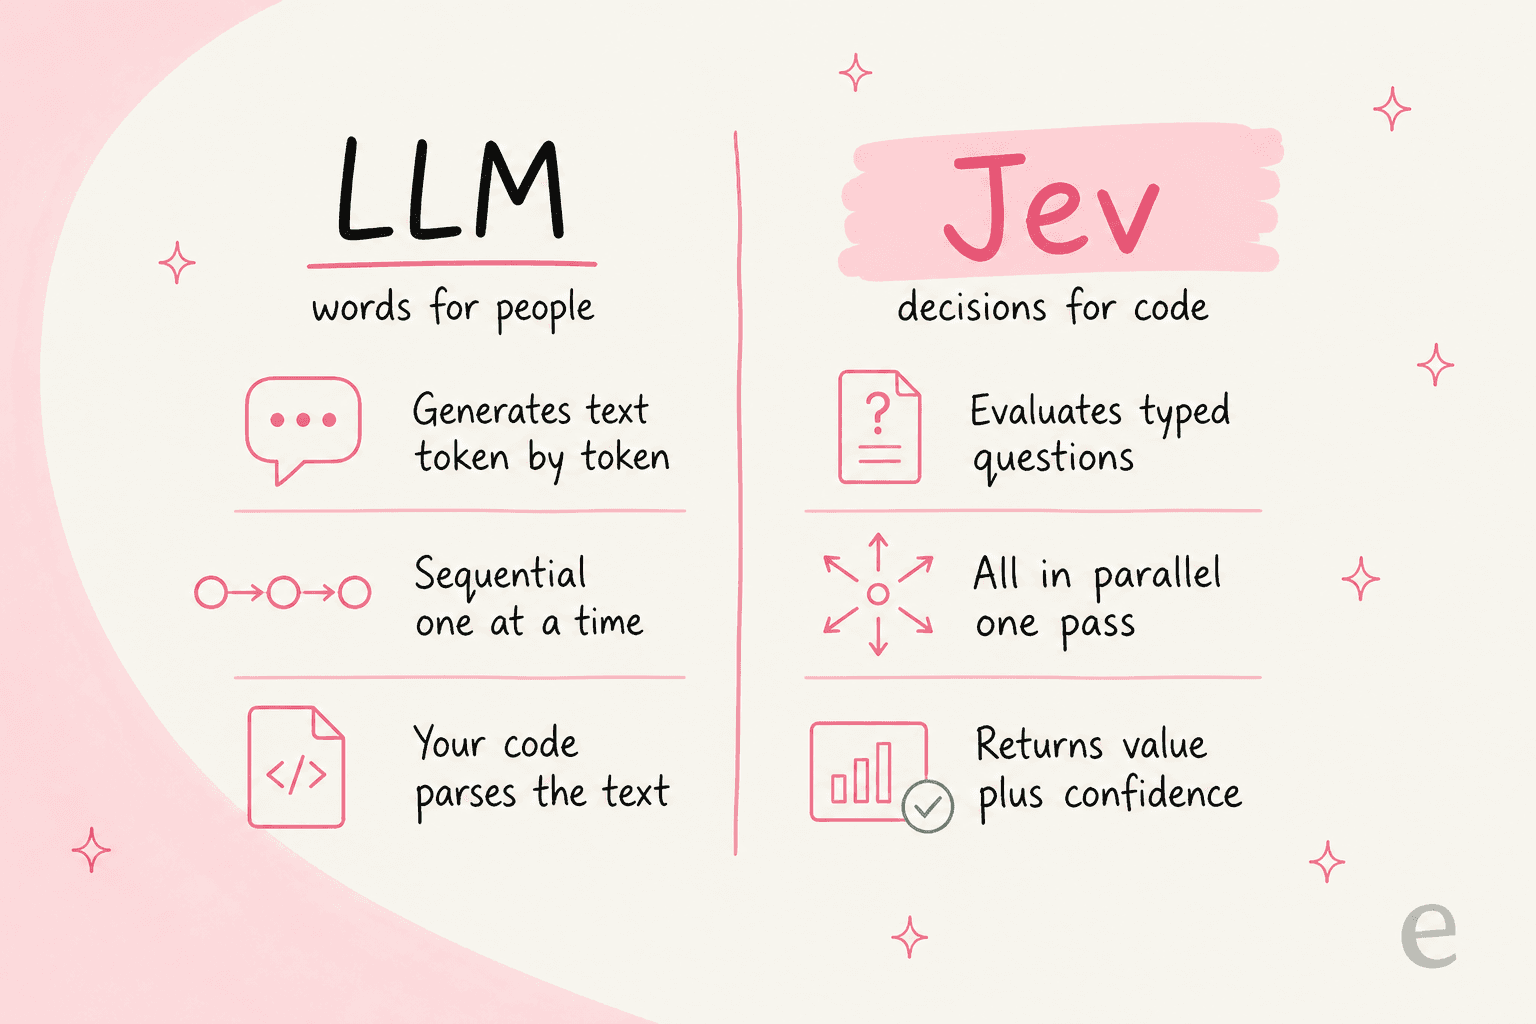
TypeSafe AI est un laboratoire de San Francisco qui a passé deux ans en mode furtif avant de lancer Jev le 15 septembre 2026. Le positionnement de la page d'accueil est délibérément provocateur : les LLM « produisent des mots pour les humains », tandis que « Jev produit des décisions typées et ressemble davantage à du code ». Le billet de lancement propose une formule plus nette encore, décrivant Jev comme « un appel de fonction à intelligence de pointe : un état non structuré en entrée, des décisions probabilistes typées en sortie ».
Le nom trahit toute la philosophie. « System One » fait un clin d'œil à la pensée rapide et intuitive du Système 1 de Daniel Kahneman, et « Jev » vient de l'économiste William Stanley Jevons, dont le paradoxe affirme que toute baisse du coût d'une ressource en démultiplie l'usage. TypeSafe parie que des décisions typées, bon marché et rapides seront utilisées partout où un appel génératif lent est aujourd'hui encore trop coûteux.
L'entreprise affirme aussi avoir pris « la direction de recherche opposée » à celle du chat. Plutôt que davantage de RLHF, elle a entraîné le modèle sur un nouvel objectif qu'elle appelle Reinforcement Learning for Calibrated Decisions (RLCD), avec une nouvelle architecture et un nouvel échantillonneur. L'argumentaire tient en trois idées : des décisions, pas des chaînes de caractères ; une confiance calibrée ; davantage comme du code. Leur slogan, « Build Prod, Not God », en dit long sur leur public cible.
Comment ça marche : un état plus des questions, évaluées en parallèle
C'est la partie qui m'a fait tilt, et elle mérite d'être comprise avant toute affirmation. La documentation décrit le décalage que Jev est censé éliminer :
"you are coercing a text-generation system into outputting structured decisions, then parsing the results back into something your code can depend on."
Quiconque a livré une fonctionnalité basée sur un LLM a ressenti exactement cette douleur. Le modèle de Jev est différent : vous envoyez un état (une chaîne de caractères, ou un objet structuré) plus un ensemble de questions typées, et il évalue chaque question par rapport à cet état, en parallèle, en une seule passe. Votre code se ramifie ensuite, trie et route en fonction des réponses typées qui reviennent.
Il n'existe que trois primitives, et elles correspondent exactement aux formes dont vous avez réellement besoin :
| Type de question | Ce qu'elle demande | Ce qu'elle renvoie |
|---|---|---|
| Noul | Cette affirmation est-elle vraie ? | une seule probabilité, de 0 à 1 |
| Choice | Choisir une option dans une liste | le choix, les probabilités par option, et une confiance |
| Score | Noter l'état selon un barème | un score numérique, les probabilités par niveau, et une confiance |
La décision de conception que je préfère : comme chaque question est évaluée indépendamment par rapport au même état, ajouter des questions supplémentaires modifie à peine la latence et ne crée jamais de « context-rot ». La recommandation de composition de TypeSafe est de garder chaque question atomique, « le genre de jugement qu'une personne compétente pourrait porter en quelques secondes », et de composer les choses difficiles dans le code plutôt que dans un unique prompt géant. Plutôt que « note ce pitch de startup », vous interrogez séparément la taille du marché, la faisabilité et la différenciation, puis combinez les scores avec votre propre formule.
La page du modèle sur Cloudflare rend cela concret avec un exemple de support qui, honnêtement, ressemble à notre propre spécification produit. Envoyez l'état "Help! My payouts have been failing for 3 days." avec trois questions, et voici ce que vous obtenez en retour :
is_urgent(Noul) :0.95department(Choice) :"billing", confiance0.8, probabilités {billing 0.87, technical 0.13}frustration(Score) :1.04sur une échelle Calm/Frustrated/Very angry, confiance0.94
C'est du triage de tickets en un seul appel. C'est aussi l'image la plus claire de ce qu'est Jev : un classificateur très rapide avec des probabilités calibrées, pas une chose qui parle.
Les affirmations, vérifiées une par une
Le marketing de TypeSafe est audacieux, alors reprenons les affirmations principales dans l'ordre et séparons ce qui tient de ce qui est exagéré.
Vitesse : rapide, sur les tâches pour lesquelles il est conçu
TypeSafe revendique 70-500 ms de bout en bout contre 3 à 329 secondes pour les LLM de pointe, présenté comme 40 à 200 fois plus rapide. La passe unique en parallèle constitue une véritable raison architecturale d'être rapide, et les preuves externes sont encourageantes. Le PDG de Vercel l'a signalé en production :
"Jev is up to 18x faster (p95) and more accurate. It's coming to @vercel AI Gateway and likely new default."
La réserve légitime, soulevée à plusieurs reprises sur Hacker News, est que la comparaison n'est pas équitable. Un modèle génératif qui produit tous les noms de type, le schéma et la prose fait plus de travail qu'un modèle qui n'émet qu'une décision contrainte. La vitesse est réelle ; le multiplicateur dépend de ce à quoi on compare.
Prix : bon marché, avec un astérisque honnête
À 0,042 $ par million de tokens en entrée avec une sortie gratuite, Jev est tarifé comme de l'infrastructure, pas comme un modèle de pointe. TypeSafe affirme que c'est 238 fois moins cher en entrée que Claude Fable 5.1. Il faut leur reconnaître ce mérite : ils abordent de front la question de la subvention plutôt que de l'esquiver.
"We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Ce qu'il faut savoir avant de planifier en fonction de cela : il n'existe pas de page de tarification (toute URL /pricing renvoie aujourd'hui une erreur 404), aucun niveau de plan ni limite de débit publiés, et l'accès est verrouillé derrière une liste d'attente. C'est un prix de lancement pour un produit en accès anticipé, à traiter donc comme indicatif. Si vous modélisez des coûts, notre guide sur les prix de Qwen montre à quelle vitesse les chiffres de lancement évoluent. La même leçon traverse notre analyse des prix de Gemini 3, et si la liste d'attente est un obstacle, notre liste des alternatives à Qwen propose des options ouvertes dès aujourd'hui.
« Ne peut pas halluciner » : à moitié vrai, et survendu
C'est la phrase qui a suscité le plus de résistance, et je trouve que c'est justifié. Jev ne peut pas commettre d'erreur de type car la sortie est mathématiquement contrainte par votre schéma. Cette partie est réelle et utile. Mais le marketing glisse de « pas d'erreurs de type » à « ne peut pas halluciner », et le sommet du fil Hacker News n'a pas accepté cela :
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

Les défenseurs avaient une réponse raisonnable : un score de confiance calibré signifie que vous pouvez voir un 0.1 et l'ignorer, ce qui est différent d'un modèle qui se trompe avec assurance. Un autre commentateur a fixé la barre à laquelle l'affirmation devrait être mesurée :
"What we would want to see is a confidence value that is in line with the actual correctness. If the value is 0.9 for 1000 different answers, then approximately 900 of those answers should be correct."
C'est le bon test, et c'est exactement ce que RLCD est censé optimiser. Ma lecture : une confiance calibrée est une véritable fonctionnalité de sécurité que j'aimerais voir davantage de modèles exposer. « Ne peut pas halluciner » est une promesse plus forte que ce que le modèle tient réellement, et TypeSafe serait sur un terrain plus solide en disant « type-safe avec une confiance calibrée ».
Le benchmark : un graphique qui mérite une lecture attentive
Les propres évaluations de workflows de TypeSafe affichent un « 193,6x plus rapide, 444,6x moins cher » saisissant, dont le blog admet lui-même qu'il se situe « dans la fourchette haute des gains observés en conditions réelles ». Le graphique en dessous est plus honnête que le titre, et c'est de loin la chose la plus utile qu'ils aient publiée.
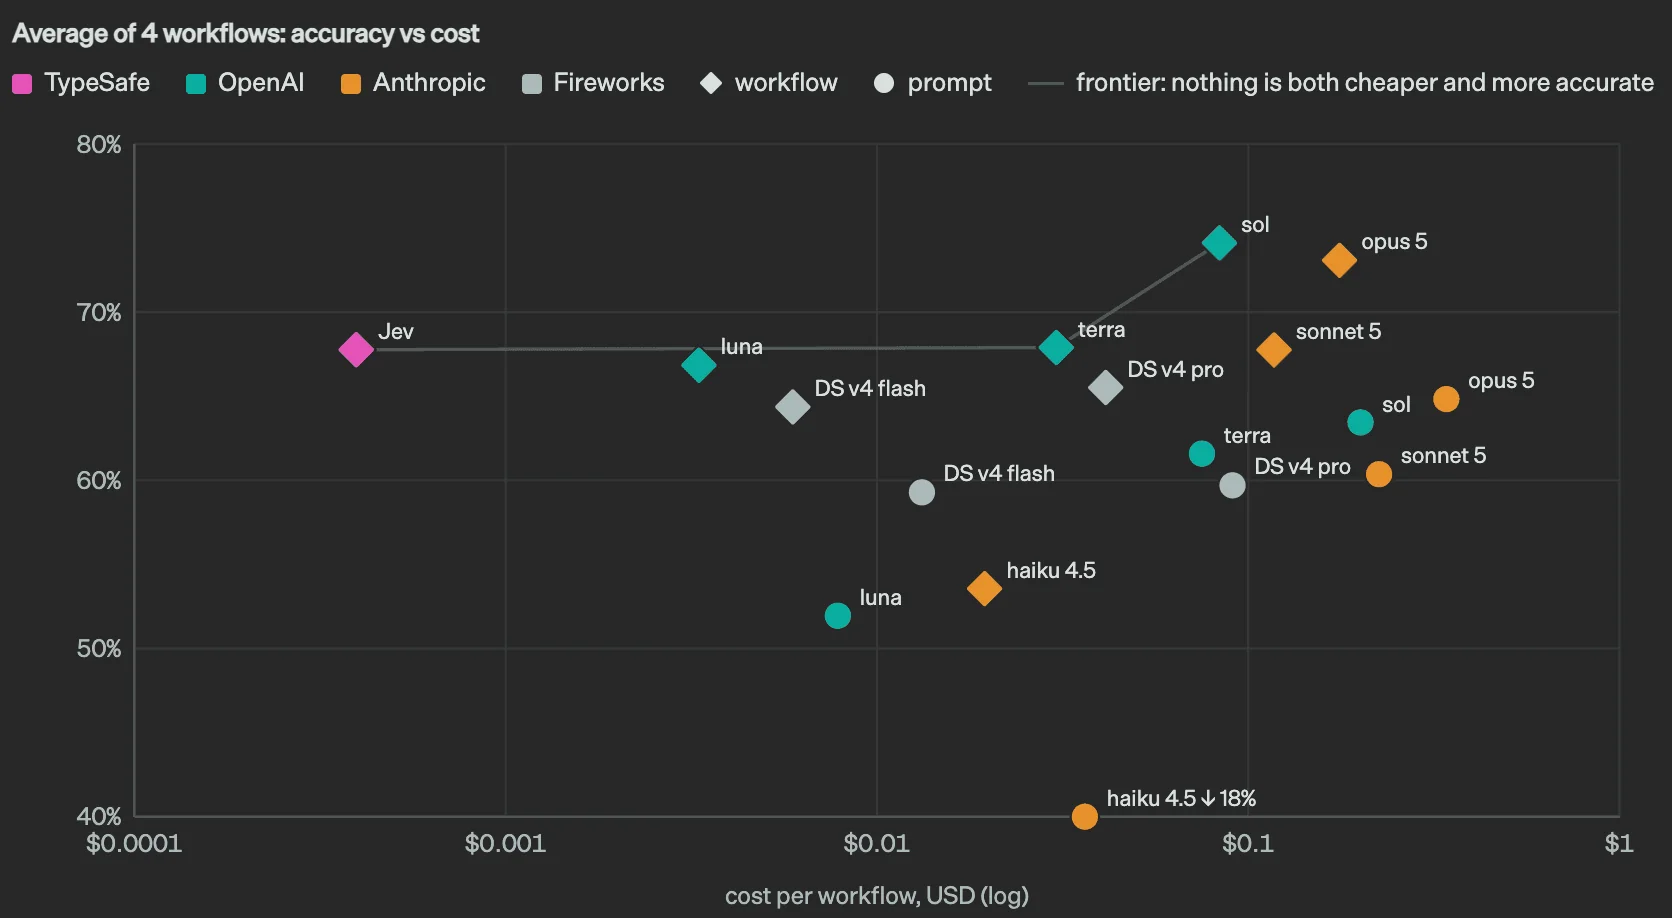
En le lisant attentivement, l'affirmation réelle se précise : Jev se situe sur la frontière avec à peu près la précision d'un modèle de raisonnement de milieu de gamme, pour une fraction du coût par workflow. Ce n'est pas le point le plus précis du graphique. C'est le point le moins cher qui reste compétitif, ce qui, pour un travail de décision à haut volume, est souvent ce qui compte. L'avis mesuré d'un commentateur en vue le résume bien :
"Seems like a more accurate title would be "Jev: Trading general purpose generation for fast typed inference"."
Ce que les développeurs en font réellement
C'est la réaction sur X qui m'a le plus convaincu qu'il y avait quelque chose de réel, car il s'agissait de démos, pas d'avis. Les deux plus gros posts portaient tous deux sur la compression du contexte des agents. Un développeur a utilisé Jev pour une compaction instantanée :
"in 2026, why is compaction still a summarization prompt? Jev can make it instant by scoring every tool call and dropping what's irrelevant"
Un autre l'a intégré à Claude comme réviseur d'appels d'outils et a rapporté avoir fait passer une session « de près de 1M à 86K tokens » en environ une seconde. C'est exactement le genre de tâche pour laquelle Jev excelle : un jugement rapide, bon marché et à haut volume qu'un grand modèle était massivement surqualifié pour effectuer. C'est le même instinct qui sous-tend les bons outils d'agent-assist, de petites vérifications qui n'ont pas besoin d'un cerveau de pointe.
Ce n'est pas un amour unanime, et les critiques méritent d'être entendues. La réponse cash du développeur Theo Browne, « Please don't do this », a capté une inquiétude bien réelle : que les gens se tournent vers un classificateur System One là où le raisonnement d'un modèle généraliste comptait vraiment. Les deux choses sont vraies en même temps. Jev est excellent pour la décision précise, qu'il s'agisse de triage de rapports de bugs ou d'une décision d'escalade, et à côté de la plaque pour la question ouverte. La discipline consiste à savoir laquelle est laquelle.
Où un modèle de décisions typées trouve sa place, et où non
Voici la limite honnête, car un avis qui dit « utilisez-le pour tout » ne sert à rien.
Jev convient lorsque la tâche est une décision que votre code consomme : routage et triage, notation de l'urgence et du sentiment, signalement de spam et d'abus, étiquetage de tickets, ou revue d'un appel d'outil avant son exécution. Partout où vous forceriez autrement un LLM à produire du JSON, un modèle de décisions typées est une primitive plus propre, et la confiance calibrée vous donne un levier réel pour décider quand agir automatiquement plutôt que d'escalader.
Il ne convient pas lorsque la sortie elle-même est l'objectif. Jev ne rédige pas la réponse, n'explique pas son raisonnement, ne tient pas de conversation et ne traite pas la longue traîne d'une question réellement inédite. Il dispose aussi d'une fenêtre de contexte de 32 000 tokens et, en tant que produit dans sa semaine de lancement, d'une liste d'attente en accès anticipé plutôt que d'une disponibilité ouverte. Pour la réponse elle-même, il vous faut toujours un modèle généraliste, du genre que nous comparons dans notre comparatif du meilleur créateur de chatbot IA, et si vous êtes une petite équipe, notre guide des agents IA pour petites entreprises.
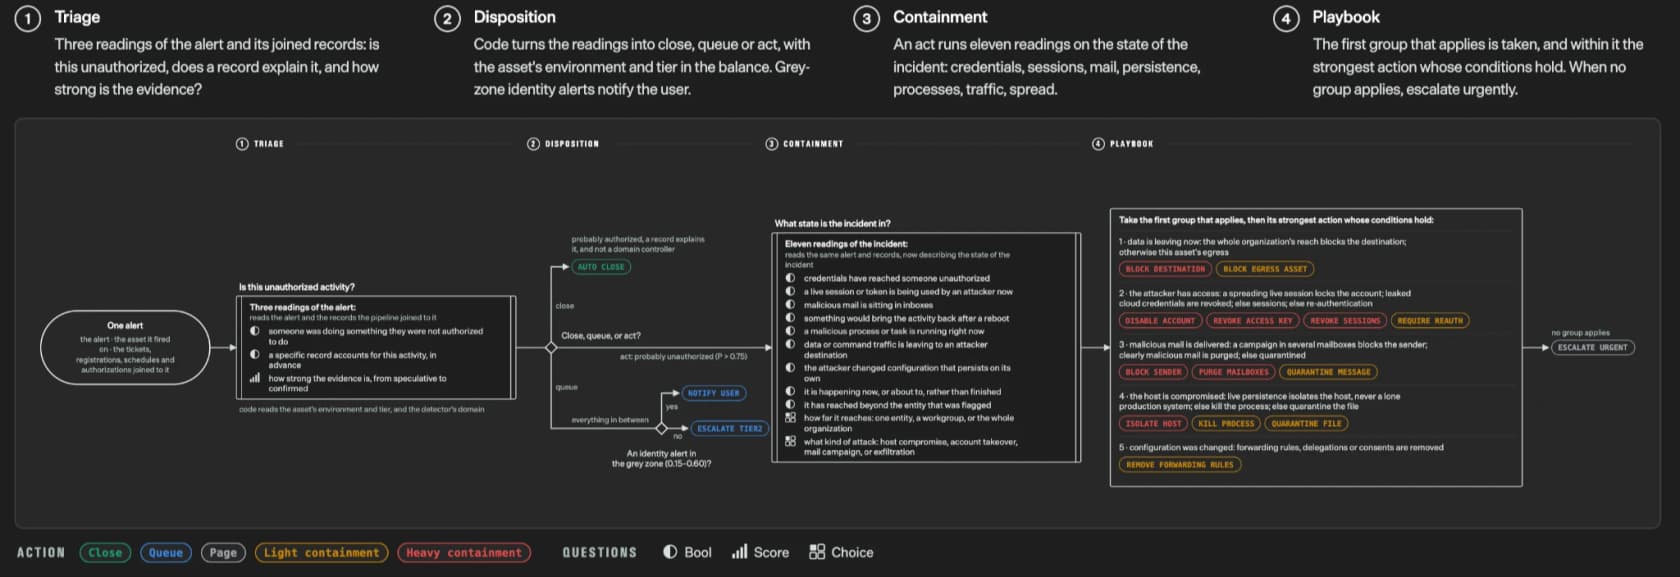
Le modèle mental le plus utile auquel je suis arrivé : Jev est le réflexe rapide, pas la délibération. Le propre diagramme de workflow de sécurité de TypeSafe illustre bien ce schéma, un pipeline de petites questions Bool, Score et Choice, votre code choisissant l'action entre elles.
Pour accélérer la décision, voici le raisonnement que je suivrais réellement :
Jev en un coup d'œil
| Modèle | Jev (jev-1.13.0), le premier modèle System One public |
| Ce qu'il renvoie | des décisions typées (Noul / Choice / Score) avec une confiance calibrée |
| Latence | 70-500 ms de bout en bout, une passe en parallèle |
| Prix | 0,042 $ / MTok en entrée, sortie gratuite (prix de lancement, sans niveaux) |
| Fenêtre de contexte | 32 000 tokens |
| Accès | liste d'attente en accès anticipé, plus typesafe/jev sur Cloudflare Workers AI |
| Idéal pour | des décisions structurées à haut volume, la revue d'appels d'outils, la compaction |
| Pas adapté pour | rédiger des réponses, raisonner en prose, une conversation ouverte |
Ce que cela signifie si vous dirigez une équipe de support
La démo phare de Jev est un ticket de support, ce qui n'est pas un hasard : le triage est la tâche d'école pour System One. J'ai passé assez de temps sur des files en direct pour connaître le piège : une excellente décision de triage n'est que le premier pouce de l'automatisation du service client. C'est une distinction de développeur à laquelle je reviens sans cesse. La classification est le domaine où l'IA est déjà fiable ; la réponse générée, et le calcul du coût agent humain vs IA, est celui où elle dérape encore.
Nous avons vu exactement cette scission lors d'un essai que j'ai aidé à mener pour une marque de biens de consommation, sur 284 échanges et une validation croisée de 100 tickets. Les décisions typées étaient excellentes, avec 93 % de précision de triage et 100 % de détection de spam sans faux positif. Les réponses rédigées présentaient encore un taux d'erreur factuelle de 7 %, et seulement 12 % étaient assez propres pour être envoyées telles quelles.
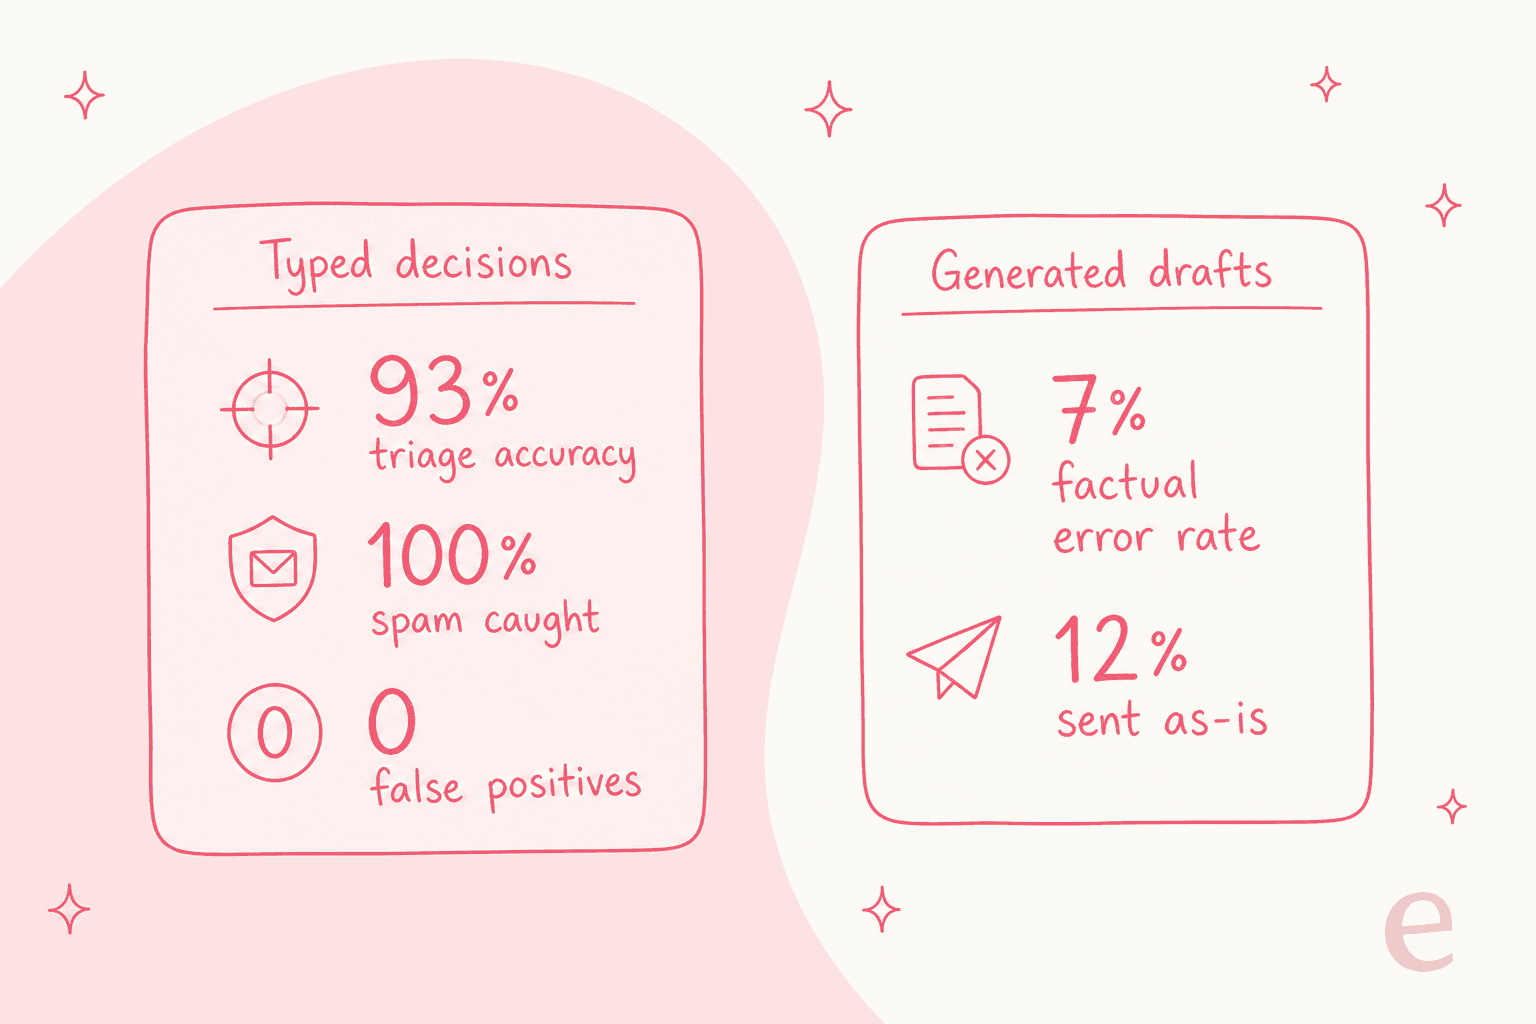
C'est là toute la raison pour laquelle un modèle comme Jev est enthousiasmant, et aussi la raison pour laquelle il n'est pas la ligne d'arrivée. Un modèle de décisions typées est de l'infrastructure. Le travail de support construit par-dessus, se connecter au helpdesk, lire votre base de connaissances, rédiger la réponse, exécuter l'action, savoir quand escalader, et prouver que cela fonctionne avant la mise en production, c'est le travail d'un employé.
C'est la ligne sur laquelle se situe eesel. Là où Jev est une brique rapide, le coéquipier IA helpdesk d'eesel est la recrue prête à l'emploi : il se connecte aux principales intégrations helpdesk (Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot), puis trie, rédige et résout sur votre file en direct.
Élément crucial, il simule sur les tickets passés avant de répondre au moindre client, de sorte que vous voyez la précision sur vos propres données plutôt que sur un graphique de lancement. Il facture par ticket traité, et non par siège, de sorte que l'économie suit le travail réel.
Et pour les développeurs auxquels cet article s'adresse vraiment, eesel ne se limite pas à un tableau de bord. Le même coéquipier peut être piloté depuis la CLI eesel (npx @eesel/cli) : une personne peut l'exécuter depuis un terminal, des scripts peuvent l'automatiser en CI avec un jeton d'API, et des agents de code comme Claude Code, Codex et Cursor peuvent l'opérer directement. Vous pouvez connecter une intégration, modifier les instructions permanentes, lister et approuver des actions avec humain dans la boucle, et lire le journal d'activité exécution par exécution, le tout en JSON, avec --dry-run pour prévisualiser une écriture avant qu'elle ne se déclenche. Chaque espace de travail est aussi un serveur MCP, de sorte que le même agent que vous pointeriez vers Jev peut pointer vers votre coéquipier support. La gamme ne s'arrête pas au support non plus ; il existe un coéquipier rédacteur de blog IA pour le contenu. Si vous aimez Jev parce qu'il traite l'intelligence comme du code, c'est la même raison d'aimer piloter un coéquipier depuis le terminal.
Mon verdict
Jev est l'un des lancements de modèle les plus intéressants de l'année précisément parce qu'il ne court pas après un meilleur chatbot. C'est une primitive réelle et utile : des décisions rapides, bon marché et type-safe avec une confiance calibrée, et un modèle mental clair pour les composer dans le code. La vitesse et le prix tiennent la route pour ce à quoi ils servent, l'affirmation « ne peut pas halluciner » est survendue, et le titre du benchmark parle plus fort que la réalité (toujours bonne) qui se cache dessous.
Si vous êtes développeur et que vous construisez des systèmes agentiques, inscrivez-vous sur la liste d'attente et utilisez-le exactement là où il est fort : les décisions à haut volume que vous forciez un grand modèle à prendre. Pour la vue d'ensemble de ce à quoi ressemblent ces systèmes en production, nos comparatifs des exemples d'agents IA et des meilleurs coéquipiers IA sont une bonne lecture suivante.
Ne confondez simplement pas le réflexe avec l'ensemble du système nerveux. La décision est le pouce facile ; le travail de bout en bout reste le mile.
Questions fréquentes
Qu'est-ce que TypeSafe Jev ?
Jev est le premier modèle System One de TypeSafe AI, lancé le 15 septembre 2026. Plutôt que de générer du texte comme un chatbot, il évalue des questions typées par rapport à un état et renvoie des décisions structurées avec des scores de confiance. Il se rapproche davantage d'un classificateur rapide que d'un LLM généraliste, ce qui est tout l'enjeu de cet avis sur TypeSafe Jev.
Jev est-il un LLM ?
Non, et TypeSafe prend soin de le préciser. Jev ne raisonne pas en prose et n'écrit pas d'explications. Il renvoie une valeur typée plus une probabilité, et tout ce qui est plus complexe est découpé en questions séparées puis recombiné dans votre propre code. Si vous avez besoin de réponses conversationnelles, un modèle généraliste ou un agent IA de support est le bon outil.
Jev ne peut-il vraiment pas halluciner ?
Il ne peut pas commettre d'erreur de type, car la sortie est contrainte par votre schéma. Il peut en revanche se tromper avec une grande confiance sur un jugement, ce qui est le point que les commentateurs de Hacker News ont le plus critiqué. La lecture honnête : un score de confiance calibré est une vraie fonctionnalité de sécurité, mais « ne peut pas halluciner » est une promesse plus forte que ce que le modèle garantit réellement.
Combien coûte Jev ?
TypeSafe fixe le prix de l'entrée à 0,042 $ par million de tokens et indique que les tokens de sortie sont gratuits. Il n'existe pas encore de page de tarification autonome ni de niveaux de plan, et l'accès passe par une liste d'attente en accès anticipé. Sur Cloudflare Workers AI, la facturation est gérée depuis le tableau de bord Cloudflare.
Que peut-on construire avec un modèle System One ?
Des décisions structurées que votre code consomme directement : classification de tickets, routage, notation de l'urgence et du sentiment, revue d'appels d'outils, et compaction de contexte. Cela convient partout où vous forciez auparavant un LLM à produire du JSON pour ensuite le reparser. Pour le travail de support de bout en bout construit sur ces décisions, voir les meilleurs agents IA pour le service client.
Jev est-il meilleur que GPT ou Claude pour le support ?
Ce sont des tâches différentes. Jev est plus rapide et moins cher pour la décision précise (est-ce urgent ? quelle file ?), tandis qu'un modèle comme le meilleur LLM pour les cas d'usage support continue de rédiger la réponse. La plupart des systèmes en production utiliseront les deux, ou confieront l'ensemble du workflow à un coéquipier qui relie déjà les éléments entre eux.


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.




Comment accéder à TypeSafe Jev ?
Inscrivez-vous à l'accès anticipé sur console.typesafe.ai, utilisez-le via l'identifiant de modèle
typesafe/jevde Cloudflare Workers AI, ou enveloppez un LLM existant avec l'adaptateur System One open source de TypeSafe. Tous les détails sont dans la documentation.