Ce qu'est vraiment Fable 5.1
Soyons précis sur ce qui a été lancé, car les noms deviennent vite confus. Claude Fable 5.1 est le successeur de Fable 5 et le sommet de la gamme d'Anthropic. L'identifiant du modèle dans l'API est claude-fable-5-1. Il existe aussi un Mythos 5.1, le même modèle sous-jacent avec des garde-fous allégés, disponible uniquement aux participants agréés du Project Glasswing (cyberdéfenseurs et scientifiques du vivant). Quand vous voyez un chiffre de benchmark, il s'agit de Fable 5.1, sauf mention explicite de Mythos.
Les spécifications sont de pointe : une fenêtre de contexte de 1M de tokens à tarif fixe par token sur toute la fenêtre, 128k de sortie maximale, et un raisonnement adaptatif toujours actif, réglable via un paramètre effort (élevé par défaut). Anthropic le positionne pour un "raisonnement exigeant et un travail agentique de longue durée", et son propre conseil est révélateur : commencer par Opus 5 pour la plupart des tâches, et ne recourir à Fable 5.1 que lorsque Opus 5 en effort élevé ne suffit toujours pas. C'est une orientation étonnamment honnête, et c'est le cadre auquel je suis sans cesse revenu pendant les tests.
En tant qu'ingénieur qui passe le plus clair de son temps à intégrer des modèles dans un vrai produit, ce qui m'importe n'est pas le classement, mais si le modèle tient sur une exécution longue, désordonnée, multi-outils, sans que j'aie à le surveiller constamment. C'est exactement là où Fable 5.1 vise.
Le seul chiffre qui a bougé : le prix
Voici les tarifs, car un avis qui se contente de dire "à partir de 10$" ne fait pas son travail.
| Poste | Fable 5.1 | Fable 5 | Changement |
|---|---|---|---|
| Entrée (par MTok) | 10$ | 10$ | inchangé |
| Sortie (par MTok) | 50$ | 50$ | inchangé |
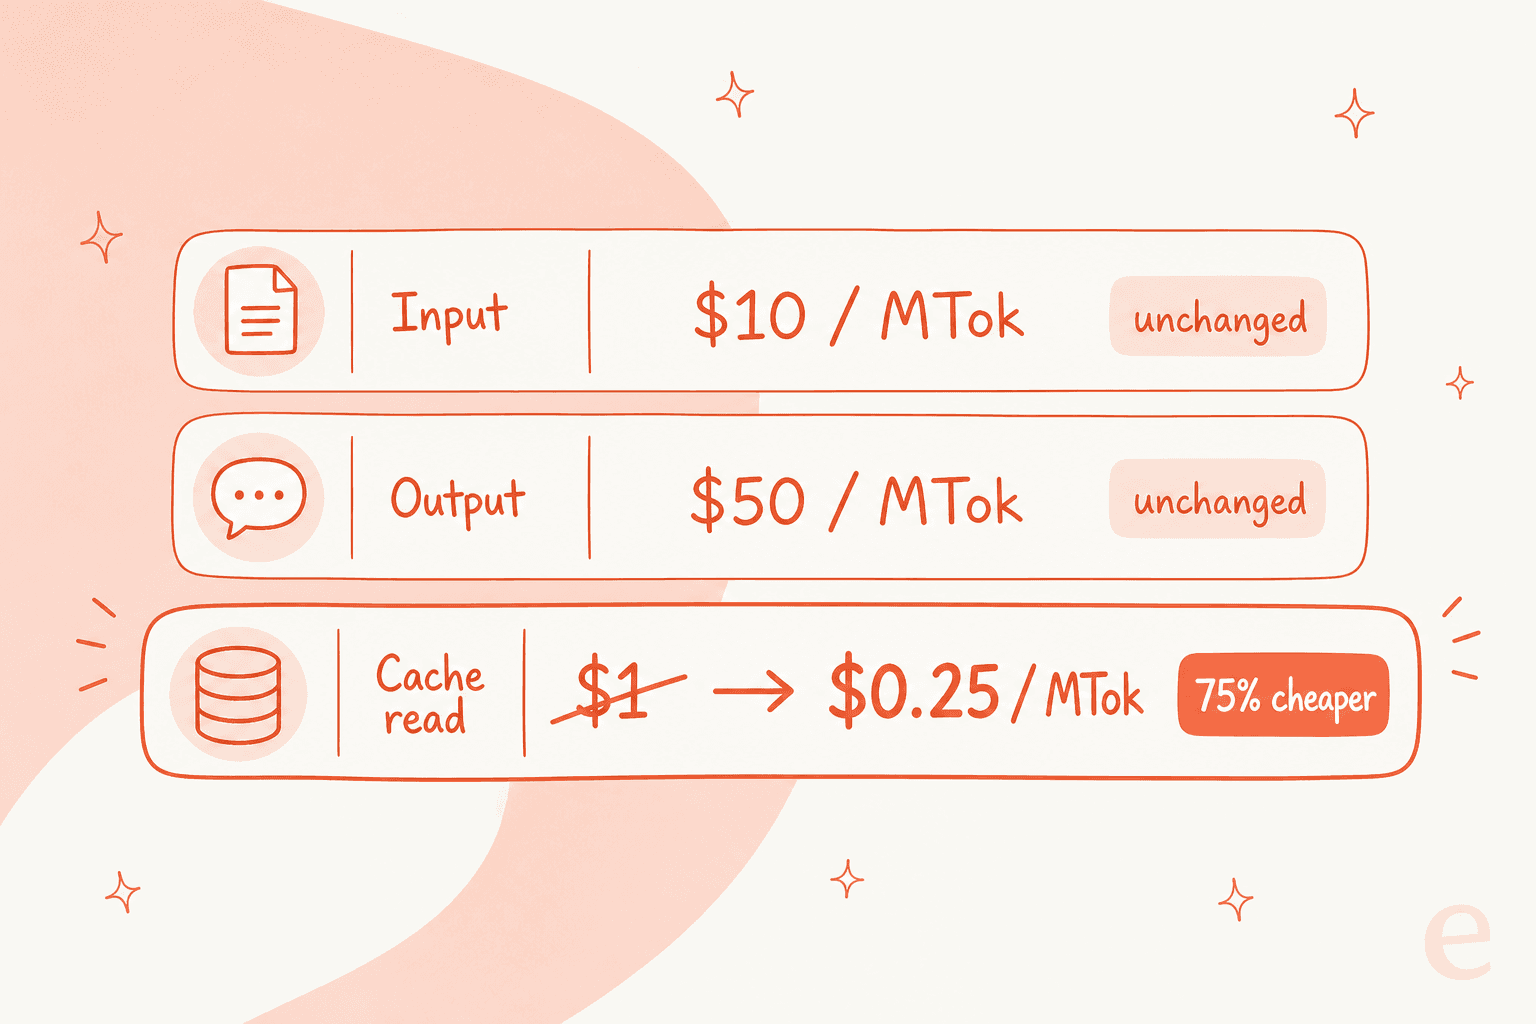
| Lecture de cache (par MTok) | 0,25$ | 1,00$ | 75% moins cher |
| Écriture de cache, 5 min (par MTok) | 12,50$ | 12,50$ | inchangé |
| Écriture de cache, 1h (par MTok) | 20$ | 20$ | inchangé |
| Entrée / sortie en lot (par MTok) | 5$ / 25$ | 5$ / 25$ | inchangé |
La baisse des lectures de cache résume à elle seule l'histoire côté coûts. Anthropic estime qu'elle réduit le coût d'une charge de travail typique d'environ 25% et celui d'une charge très agentique jusqu'à 45%, car les exécutions agentiques relisent le même contexte mis en cache à chaque tour. Pour donner un ordre d'idée, la lecture de cache à 0,25$ de Fable 5.1 revient en réalité moins cher par token que celle d'Opus 5, à 0,50$, même si l'entrée de base d'Opus 5 coûte deux fois moins cher. Si votre charge de travail sollicite beaucoup le cache, le calcul penche davantage vers Fable que ne le laissent penser les tarifs affichés.
Deux mises en garde à connaître avant de budgétiser. L'inférence exclusivement aux États-Unis comporte un multiplicateur de 1,1x, et Fable 5.1 n'est pas disponible sur le niveau gratuit, il faut un forfait Pro, Max, Team ou Enterprise. Le lancement a aussi suscité la pique inter-modèles habituelle, un compte X ayant souligné que "Fable 5.1 coûte 6 fois plus cher que GPT-5.6 Sol". C'est vrai sur le prix affiché, et c'est la mauvaise comparaison si votre tâche est une longue exécution agentique où l'efficacité des tokens et le taux de réussite déterminent la facture réelle.
Les benchmarks, et jusqu'où leur faire confiance
Sur le papier, Fable 5.1 rafle tout. Anthropic rapporte qu'il domine chaque évaluation publiée, et les deux plus grands bonds par rapport à Fable 5 méritent qu'on s'y attarde.
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
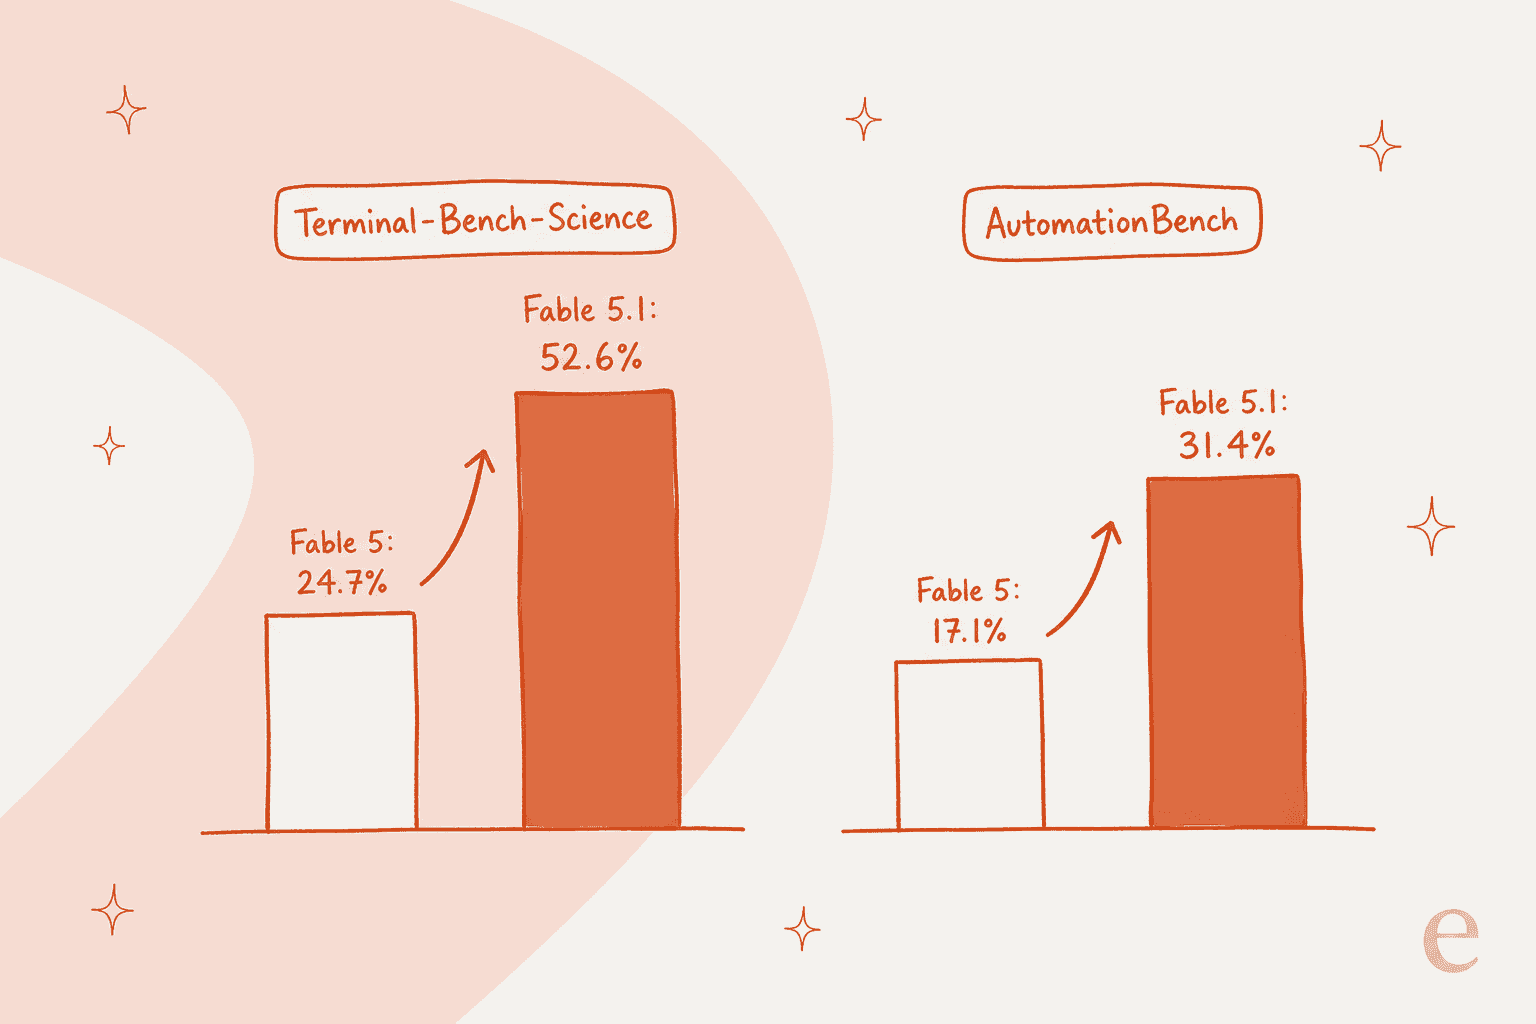
| Terminal-Bench-Science (science agentique) | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 (codage agentique) | 55,8% | 42,0% | 52,3% | 37,3% |
| GDPval-AA v2 (travail de connaissance, Elo) | 1853 | 1723 | 1824 | 1711 |
| AutomationBench (flux de travail métier) | 31,4% | 17,1% | 26,9% | 19,6% |
| CursorBench 3.2.0 (codage agentique) | 73,4% | 70,5% | 70,0% | 67,2% |
| Humanity's Last Exam (avec outils) | 65,0% | 63,8% | 63,6% | - |
| OSWorld 2.0 partial (utilisation d'ordinateur) | 77,9% | 72,9% | 75,4% | - |
Le bond de Terminal-Bench-Science, de 24,7% à 52,6%, attire l'œil : la recherche scientifique agentique a plus que doublé. Le quasi-doublement d'AutomationBench compte davantage pour l'acheteur moyen, puisqu'il sert de proxy pour les flux de travail métier désordonnés.
Passons à la partie honnête, que la page marketing enterre en grande partie. Tous ces chiffres de Fable 5.1 ont été produits avec les garde-fous de production activés, et Anthropic note que là où ces garde-fous sont intervenus, Fable 5.1 a obtenu un score nul sur ces tâches, ce qui signifie que le plafond de capacité réel (approché par Mythos 5.1, aux garde-fous plus légers, qui atteint 60,9% sur Terminal-Bench 4.0) est plus élevé. Et il y a une erreur type d'environ 3,5 à 4,5 points sur le benchmark scientifique. Les benchmarks sont ici un signal directionnel, pas une règle absolue.
Le réflexe de scepticisme de la communauté est sain, et je le partage :
"Comment est-il possible que tous les modèles de xAI, OpenAI, Anthropic, Qwen etc. remportent tous les benchmarks à chaque sortie ? Demain, tous les précédents (sauf Anthropic bien sûr) monteront leur numéro de version et seront en tête sur HN en remportant tous les benchmarks."

Je donne donc plus de poids aux retours clients divulgués par Anthropic qu'au classement. Ramp a rapporté une seule exécution non surveillée de 38 heures qui a diagnostiqué un mauvais résultat de ML comme un artefact d'étiquetage et lancé six expériences pendant la nuit. Millennium a déclaré avoir trouvé la cause d'un plantage à un sur un million qu'aucun ingénieur ni modèle n'avait résolu en quatre à cinq ans. Browserbase l'a placé à 82% des tâches sur son benchmark d'agents navigateur le plus difficile, contre 74% pour Opus 5 et 57% pour Fable 5, en utilisant moins de tokens. Ce sont le genre de résultats à long terme qu'une ligne de benchmark ne peut pas capturer.
Ce en quoi il excelle vraiment
Trois choses se sont démarquées, et une seule figure sur un classement.
L'écriture est la surprise. Pendant des années, la plainte la plus fréquente à propos de Claude était que sa prose se lisait comme une note de conformité. Fable 5.1 est la première version où cela s'inverse, et la réaction a été immédiate :
"En tant qu'utilisateur fervent de Claude Code passé à GPT 5.6 Sol plutôt qu'Opus 5 à cause d'une prose difficile à lire, ça me rend heureux. J'adore votre produit mais les modèles actuels sont très difficiles à utiliser si on doit beaucoup changer de contexte. La concision est essentielle."
Glean a indiqué que ses évaluateurs préféraient les réponses de Fable 5.1 dans une proportion d'environ 2 contre 1 par rapport à Fable 5 sur les connaissances courantes et la rédaction, et Canva a qualifié l'écriture de "point fort". Si vous vivez de l'écriture, c'est l'amélioration qui compte plus que n'importe quel score de codage.
Le codage tient la route sur de longues sessions. C'est la promesse, et elle est globalement tenue. SpaceXAI (Cursor) l'a qualifié de modèle le plus performant qu'ils aient exécuté sur CursorBench 3.2, notamment pour vérifier son propre travail, et Red Hat a déclaré qu'il avait trouvé la cause racine de chaque build cassé qu'ils ont testé. Les démonstrations en un seul coup ont envahi X le jour du lancement, amusantes mais elles prouvent moins que le travail ingrat (trouver la cause racine d'un échec de build est le vrai test).
Les exécutions agentiques restent sur les rails. Every a résumé l'angle efficacité ainsi : "intelligence Fable, prix Opus, vitesse Sonnet", le mesurant environ deux fois plus rapide qu'Opus 5 en utilisant environ moitié moins de tokens. Un développeur a résumé la version pratique :
"un prompt, 43 minutes, 2,96$ – claude fable 5.1 a écrit un monde de 1 660 lignes"
Là où le bât blesse
Un avis honnête nomme les limites, et Fable 5.1 en a deux réelles.
Les refus restent le point de friction le plus important. C'est revenu sans cesse le jour du lancement, et ce n'est pas la plainte habituelle "l'IA est trop prudente" : ce sont des développeurs incapables de faire un travail de sécurité légitime sur leur propre code :
"Fable est inutile. Moi : "Trouve les problèmes de sécurité dans mon propre code. C'est du code que je possède. Je fais ça avec l'autorisation du PDG/CTO de notre entreprise." Fable : "ouais, non.""
La position d'Anthropic elle-même est que les garde-fous cyber sont désormais plus précis, les utilisateurs de Claude Code devant voir environ 60% moins d'interventions par session que sur Fable 5, et Fable 5.1 peut désormais identifier des vulnérabilités de façon défensive. Mais les tests d'intrusion, la génération d'exploits et l'analyse de binaires sont toujours redirigés vers les modèles Opus, et les faux positifs sur votre propre code sont bien réels. Un testeur a résumé le problème de confiance sans détour : il "semble toujours totalement incapable de comprendre ses propres garde-fous et finit par se convaincre lui-même de les déclencher."
Le filigrane est un point de friction sur la confiance. Fable 5.1 ajoute un filigrane statistique de texte sur chaque sortie, pour la conformité à la loi européenne sur l'IA. Il n'ajoute ni tokens ni caractères cachés et n'encode pas votre identité, mais cela signifie qu'Anthropic peut identifier le texte produit par le modèle, ce qui met certains utilisateurs mal à l'aise :
"Attention : l'empreinte Claude (filigrane) est désormais active avec Fable 5.1. Cela signifie qu'Anthropic peut identifier le texte généré par le modèle."

Si les exigences de provenance comptent pour votre organisation, c'est un atout. Si vous comptiez sur une sortie indétectable, c'est rédhibitoire. Dans tous les cas, sachez que c'est là. Il y a aussi quelques changements d'API non rétrocompatibles par rapport à Fable 5 qui méritent d'être passés en revue si vous développez sur l'API : l'utilisation forcée d'outils a disparu (un tool_choice réglé sur any ou tool renvoie désormais une erreur 400), les blocs de réflexion sont liés au modèle, et l'appel parallèle d'outils est plus variable.
À qui il devrait vraiment s'adresser
Le verdict honnête, selon votre profil :
- Vous faites tourner des tâches d'agents longues et autonomes. Oui. C'est exactement le terrain de prédilection du modèle, et la baisse des lectures de cache est ce qui rend les exécutions de plusieurs heures abordables. Foncez.
- Vous rédigez ou faites un travail intensif de connaissance. Oui, sans hésiter, sur la qualité. Le bond dans la prose est réel et les résultats sur les présentations et les tableurs sont les meilleurs qu'Anthropic ait livrés.
- Vous faites du codage et du chat au quotidien. Probablement pas, du moins pas par défaut. Opus 5 est moins cher et Anthropic lui-même conseille de commencer par là. Passez à Fable 5.1 quand Opus 5 en effort élevé cale.
- Vous faites de la recherche en sécurité. Testez d'abord les refus sur votre véritable flux de travail. La précision s'est améliorée, mais les faux positifs sur votre propre code restent une plainte bien réelle.
- Vous voulez simplement un agent de support ou un rédacteur de contenu qui fonctionne. Vous achetez au mauvais niveau, on y revient juste après.
Un modèle n'est pas un coéquipier
Voici le recadrage que je veux que vous reteniez, car c'est là que la plupart des questions "quel modèle acheter" partent de travers. Fable 5.1 est un moteur spectaculaire. Ce n'est pas un collaborateur. Il n'a aucune idée de ce que fait votre produit, ne peut pas voir votre centre d'aide ni vos 10 000 derniers tickets, n'a aucune intégration, et aucun moyen d'être testé sur votre propre historique avant de toucher un vrai client. Acheter un accès à un modèle brut pour résoudre un problème de support ou de contenu, c'est comme embaucher la personne la plus intelligente au monde et lui donner ensuite zéro contexte, zéro outil et zéro intégration.
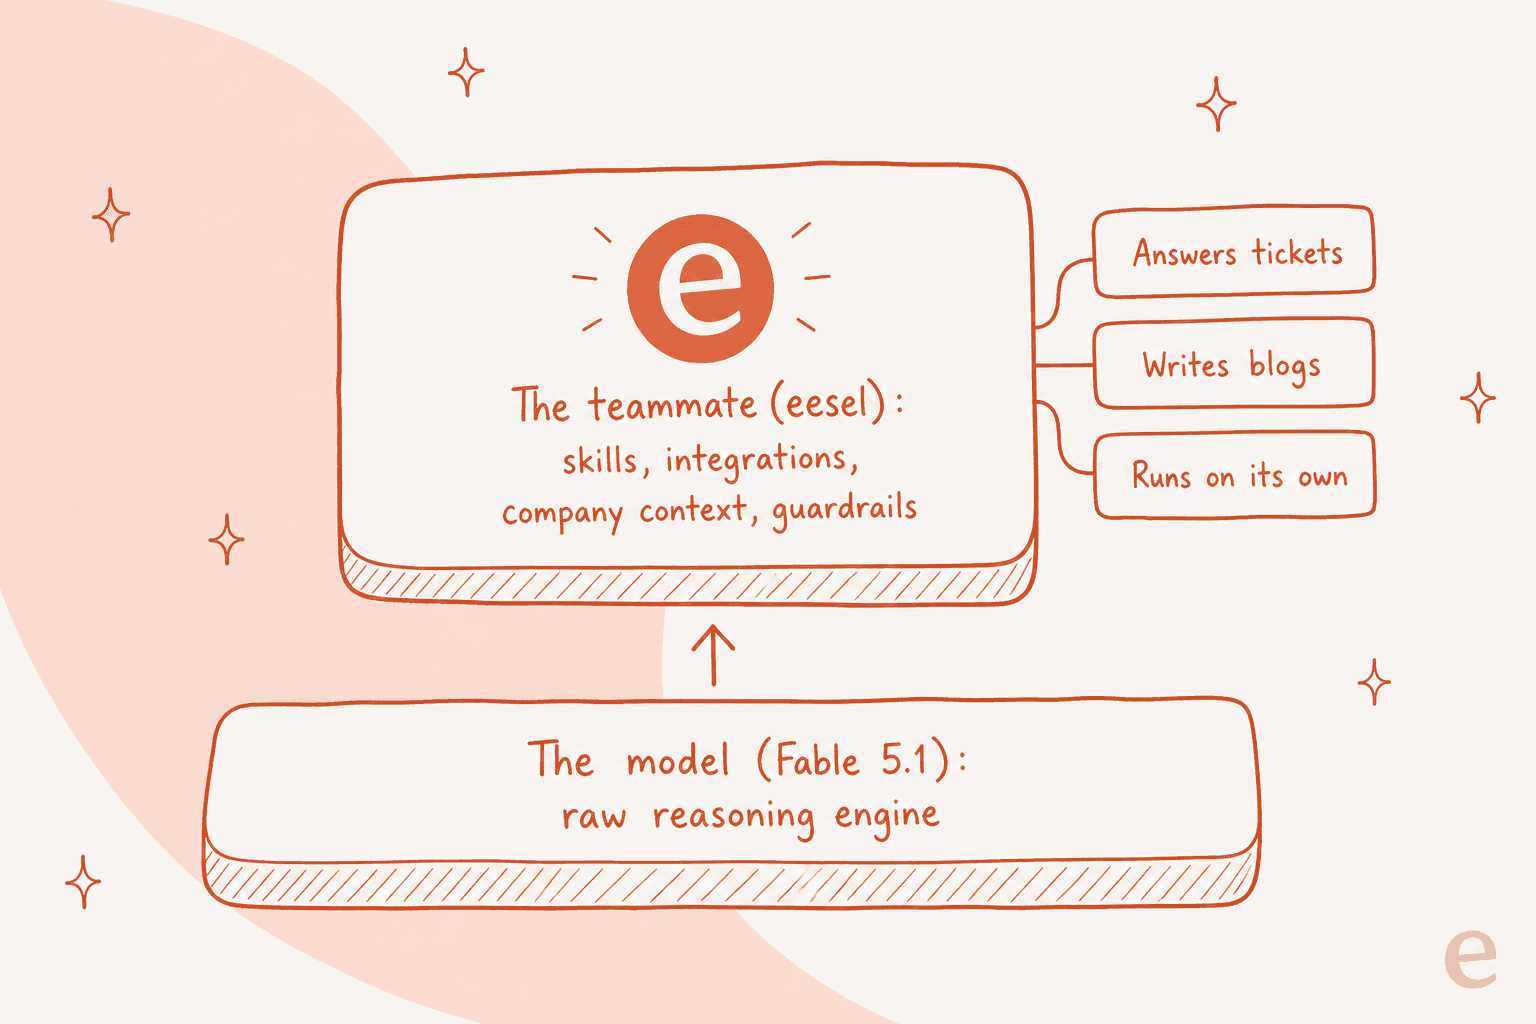
Cet écart entre "modèle brut" et "coéquipier prêt à l'emploi" est la raison d'être d'eesel. L'idée est simple : vous n'embauchez pas un modèle, vous embauchez un coéquipier prêt à travailler pour un poste précis. L'offre actuelle comprend un coéquipier de support client IA qui rejoint votre file de support existante, et un rédacteur de blog IA, chacun arrivant déjà avec les compétences, intégrations et contexte d'entreprise dont son rôle a besoin, propulsé par un modèle de pointe en dessous.
Et comme c'est pensé pour les agents de bout en bout, vous n'êtes pas coincé dans un tableau de bord. La CLI eesel permet à une personne de piloter ce même coéquipier depuis un terminal, permet à des scripts de l'automatiser, et permet à des agents de codage comme Claude Code ou Cursor de l'opérer par programmation, avec MCP et des webhooks en plus. Si ce que fait Fable 5.1 dans Claude Code vous a plu, voici comment diriger cette même énergie vers votre espace de support plutôt que vers un nouveau dépôt.
Essayez eesel
Si vous êtes arrivé ici en essayant de déterminer quel modèle utiliser pour votre support client, la meilleure question est plutôt quel coéquipier embaucher. eesel est une plateforme de coéquipiers IA : le coéquipier de support IA se branche à des outils comme Zendesk, Freshdesk ou Gorgias en quelques minutes, apprend de vos tickets passés et de votre centre d'aide, et surtout, vous permet de le simuler sur des tickets passés avant qu'il ne réponde jamais à un client, pour que vous voyiez le taux de résolution et les réponses à l'avance au lieu d'appuyer sur un bouton en espérant que ça marche.
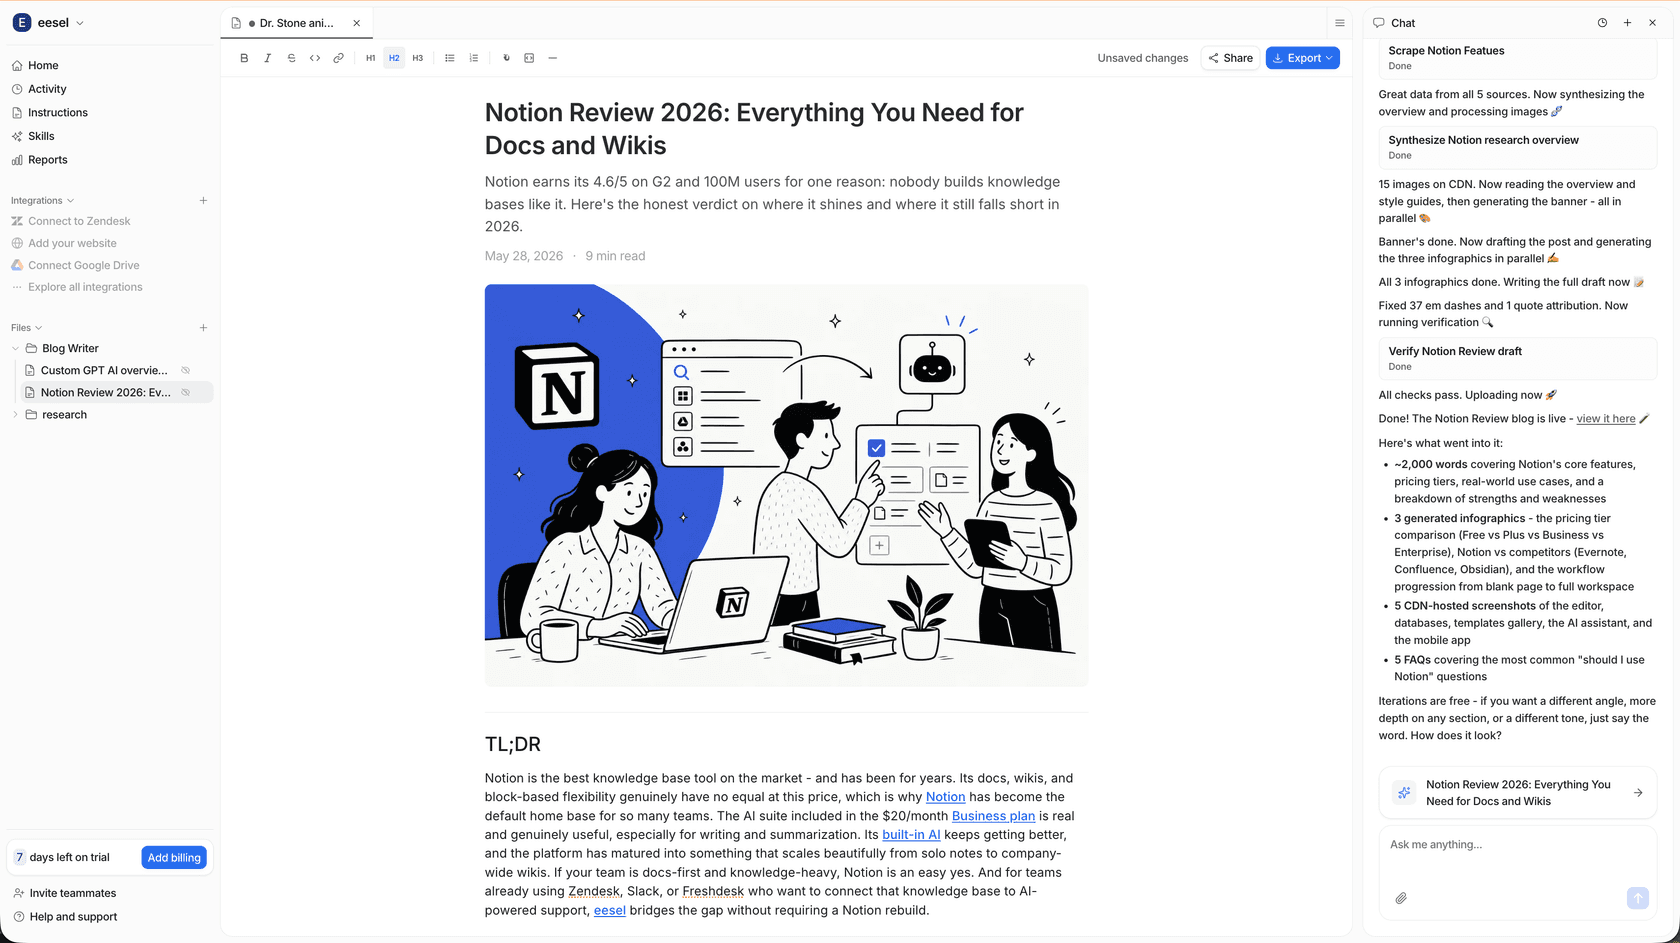
Cette étape de simulation avant mise en production est exactement ce qu'un modèle brut comme Fable 5.1 ne peut pas vous offrir, et c'est pourquoi choisir le modèle est la partie facile, tandis que choisir le coéquipier est celle qui détermine réellement votre résultat. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Combien coûte Claude Fable 5.1 ?
Claude Fable 5.1 est-il meilleur qu'Opus 5 ?
Qu'est-ce qui a changé dans Claude Fable 5.1 par rapport à Fable 5 ?
Claude Fable 5.1 refuse-t-il trop souvent ?
Ai-je besoin de Fable 5.1 pour faire tourner un agent de support IA ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.