Qu'est-ce que Claude Fable 5.1 ?
Je construis les agents IA chez eesel, donc un nouveau modèle de pointe n'est pas pour moi une course aux benchmarks abstraite, c'est le moteur sur lequel tournent mes coéquipiers. Quand Anthropic a lancé Fable 5.1 le 1er septembre 2026, la première chose que j'ai faite a été de lire ce qui avait réellement changé sous le marketing, et il y a une vraie histoire au-delà de « notre nouveau modèle domine les classements ».
Claude Fable 5.1 est le modèle en disponibilité générale le plus performant d'Anthropic, présenté sur sa page produit comme le modèle le plus avancé au monde pour le codage et le travail de connaissance. Il succède à Fable 5 et se situe tout en haut de la famille Claude 5, au-dessus de Claude Opus 5. L'identifiant du modèle dans l'API est claude-fable-5-1.
Quelques caractéristiques à retenir avant tout :
- Fenêtre de contexte : une fenêtre de 1M de tokens, à la fois par défaut et au maximum, avec une tarification uniforme par token sur toute la fenêtre (aucun palier de surcoût pour le contexte long).
- Sortie maximale : 128k tokens.
- Thinking : le thinking adaptatif est toujours actif, et vous en réglez la profondeur via un paramètre
effortqui vaut élevé par défaut. - Disponibilité : l'API, Amazon Bedrock, Google Cloud Vertex AI et Microsoft Foundry, ainsi que les plans Pro, Max, Team et Enterprise. Il n'est pas disponible sur l'offre gratuite.
Il existe aussi Claude Mythos 5.1, le même modèle sous-jacent avec des garde-fous plus permissifs, réservé aux participants du Project Glasswing (cyberdéfenseurs et chercheurs en sciences du vivant validés). Pour presque tout le monde, Fable 5.1 est celui que vous appellerez réellement.
Une remarque honnête, enfouie dans les propres conseils d'Anthropic : ils recommandent de commencer par Opus 5 pour la plupart des charges de travail et de ne recourir à Fable 5.1 que lorsqu'Opus 5 en effort plus élevé ne suffit toujours pas, ou pour les projets de long terme les plus ambitieux. C'est un « ne payez pas trop cher pour notre modèle phare » rafraîchissant, et cela devrait guider la façon dont vous pensez ce modèle. C'est un outil spécialisé, pas le choix par défaut.
Ce qui a vraiment changé depuis Fable 5
Voici la partie que je trouve vraiment habile, et ce n'est pas un chiffre de benchmark. Fable 5.1 garde chaque tarif de base de Fable 5 identique, puis rend discrètement 75% moins cher exactement le compteur qui domine les factures agentiques.
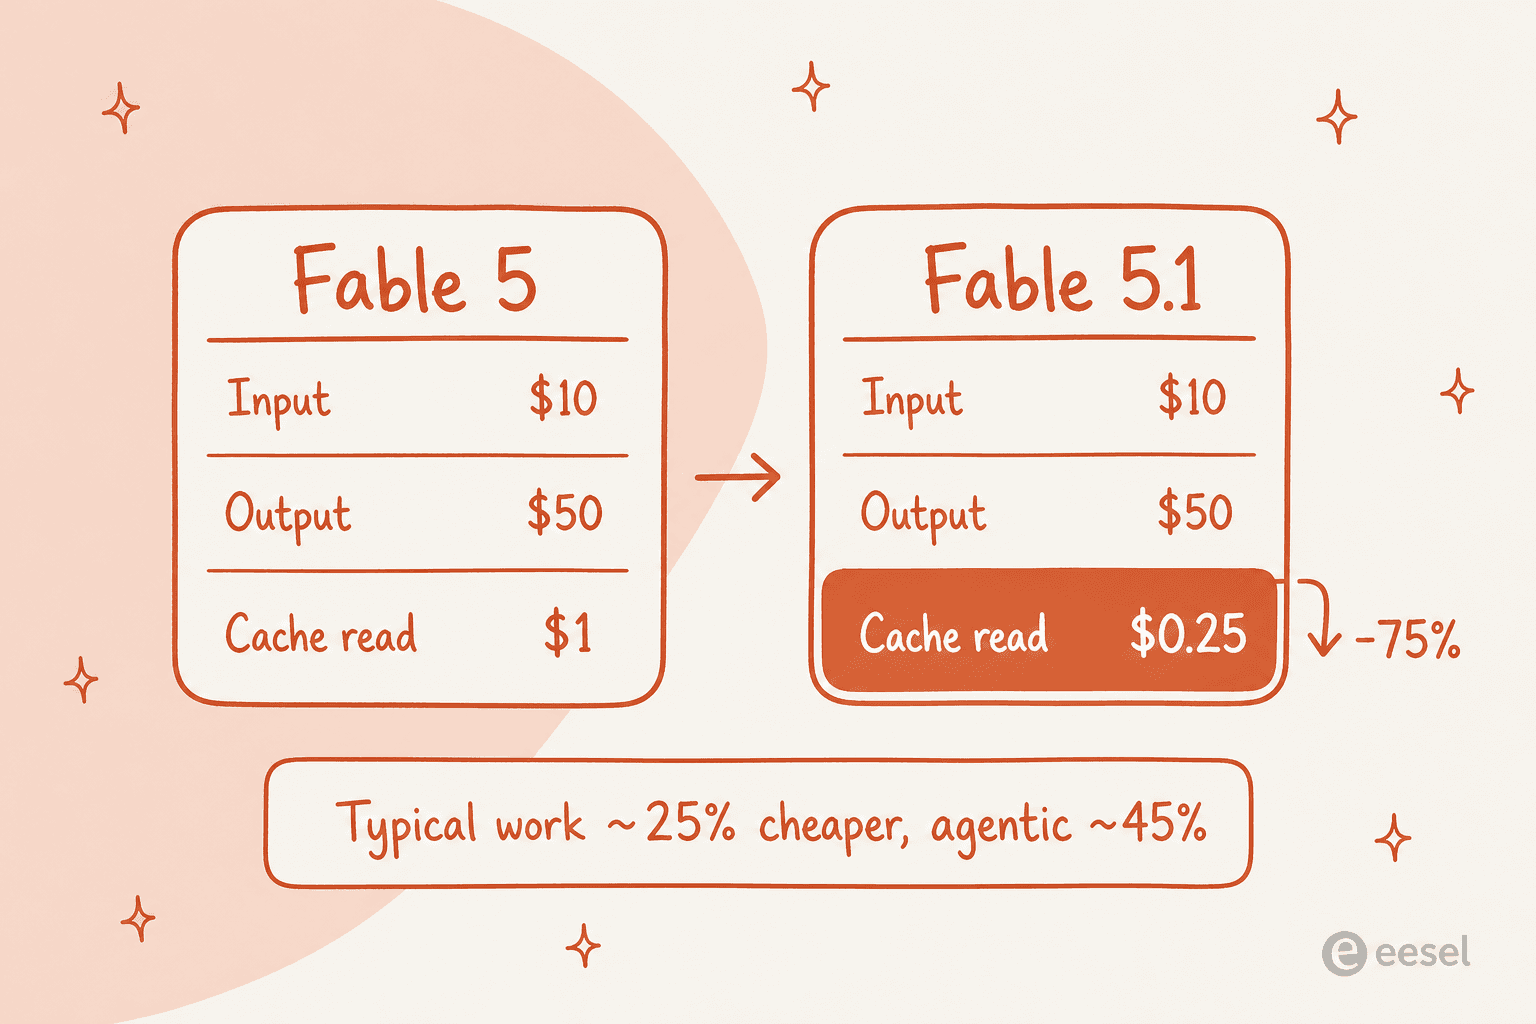
Les lectures de cache sont passées de 1 $ à 0,25 $ par million de tokens. Si vous n'avez jamais fait tourner une boucle d'agent qui compte vraiment, ça ressemble à une erreur d'arrondi. Ce n'en est pas une. Une longue session agentique relit le même préfixe mis en cache (votre prompt système, votre base de code, votre historique de tickets) à chaque étape, donc les lectures de cache s'accumulent bien plus vite que l'entrée fraîche. Anthropic a mesuré quatre semaines d'usage réel d'août 2026 et évalue l'économie effective à environ 25% sur des charges de travail classiques et jusqu'à 45% sur des charges très agentiques.
Le développeur Lance Martin a mis en avant l'angle valeur de façon très nette le jour du lancement :
"Fable 5.1 at low effort is often competitive with Opus and Sonnet on $ / task while scoring higher. on CursorBench 3.2.0, Fable 5.1 at low effort is at parity w/ Fable 5 at high effort at a third of the cost."
Au-delà du prix, les gains de capacité se concentrent sur six domaines, d'après la documentation : codage agentique sur des sessions de plusieurs heures, travail de connaissance (documents, tableurs, présentations), recherche en plusieurs étapes, vision sur des PDF denses et des graphiques, raisonnement sur toute la fenêtre de 1M, et utilisation d'ordinateur. Les performances multilingues sont au même niveau que Fable 5, ce n'est donc pas un domaine de progrès, et il est bon qu'Anthropic le dise plutôt que de laisser entendre que tout s'est amélioré.
Deux autres changements comptent pour quiconque développe dessus :
- Un filigrane de texte (nouveau). Chaque sortie de texte porte désormais le filigrane statistique de texte d'Anthropic pour la conformité à l'AI Act européen. Il n'ajoute ni tokens ni caractères cachés, mais rend bien la sortie identifiable comme générée par Claude.
- Des changements d'API cassants. L'utilisation forcée d'outils a disparu (un
tool_choiceàanyoutoolrenvoie désormais une erreur 400), les blocs de thinking sont liés au modèle, et modifier des tours précédents invalide le thinking. Si vous développez votre propre CLI de codage agentique ou boucle d'outils, lisez les notes de migration avant de mettre à jour.
Tarifs de Claude Fable 5.1
Rassemblons toute la grille tarifaire en un seul endroit. Tous les prix sont par million de tokens (MTok), en USD, tirés de la documentation tarifaire de la plateforme.
| Compteur | Claude Fable 5.1 | Claude Fable 5 (précédent) |
|---|---|---|
| Entrée de base | $10 | $10 |
| Sortie | $50 | $50 |
| Lectures de cache | $0.25 | $1 |
| Écritures de cache 5 min | $12.50 | $12.50 |
| Écritures de cache 1 heure | $20 | $20 |
| Batch (entrée / sortie) | $5 / $25 | $5 / $25 |
La seule ligne qui bouge, ce sont les lectures de cache. Tout le reste est identique à Fable 5. Il existe aussi une inférence exclusivement aux États-Unis à 1,1x pour les charges de travail qui doivent y rester.
Où cela place-t-il Fable 5.1 par rapport au reste de la gamme actuelle ?
| Modèle | Entrée | Lecture de cache | Sortie |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $0.25 | $50 |
| Claude Opus 5 | $5 | $0.50 | $25 |
| Claude Sonnet 5 | $2 | $0.20 | $10 |
Fable 5.1 reste le Claude actuel le plus cher en entrée et sortie de base, 2x Opus 5 et 5x Sonnet 5. Mais notez que sa lecture de cache à 0,25 $ est en fait moins chère par token que celle d'Opus 5 à 0,50 $. C'est tout l'intérêt du changement : rendre un modèle phare économique pour les relectures répétitives qui définissent le travail d'agents.
Un exemple chiffré. Disons qu'un agent relit un contexte en cache de 150k tokens à chacun des 1 000 appels d'outils d'une longue session. Cela fait 150M de tokens de lecture de cache. Avec Fable 5, cela coûte 150 $ ; avec Fable 5.1, le même travail coûte 37,50 $. Multipliez cela sur toute une flotte d'agents tournant toute la journée et l'astuce « même modèle, cache moins cher » cesse de ressembler à une erreur d'arrondi.
Une réserve venant de la communauté : même sur les plans grand public les plus élevés, des utilisateurs signalent atteindre rapidement des limites d'usage sur les modèles de classe Fable, ce qui est une question distincte de la grille tarifaire au token. Pour les montants exacts des abonnements Pro, Max et Team, consultez directement claude.com/pricing et notre décryptage des tarifs Claude Pro pour l'angle grand public.
Si vous comparez entre fournisseurs, nos guides sur les tarifs Gemini, les tarifs GPT-5.3 Codex et Gemini en général adoptent le même angle.
Ce que Claude Fable 5.1 sait réellement faire
Anthropic annonce que Fable 5.1 domine tous les benchmarks qu'elle liste. Voici ceux qui apprennent réellement quelque chose, tous produits avec les garde-fous de production activés (plus de détails sur cette réserve plus bas).
| Benchmark (ce qu'il mesure) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 (recherche agentique) | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 (codage agentique) | 55.8% | 42.0% | 52.3% | 37.3% |
| AutomationBench (workflows métier) | 31.4% | 17.1% | 26.9% | 19.6% |
| OSWorld 2.0, partiel (utilisation d'ordinateur) | 77.9% | 72.9% | 75.4% | - |
| Humanity's Last Exam, avec outils | 65.0% | 63.8% | 63.6% | - |
| CursorBench 3.2.0 (codage agentique) | 73.4% | 70.5% | 70.0% | 67.2% |
Les sauts les plus marquants sont Terminal-Bench-Science (de 24.7% à 52.6%, plus du double) et AutomationBench (de 17.1% à 31.4%). Les deux vont dans la même direction : ce modèle s'est beaucoup amélioré sur le travail long et autodirigé.
Voici maintenant la partie honnête, car les tableaux de benchmarks du jour de lancement méritent toujours un grain de sel. Un commentateur de Hacker News a dit tout haut ce que beaucoup pensent tout bas :
"There are hundreds of benchmarks. You just need to pick a favorable dozen on release day."

Juste. Ce qui m'a plus convaincu que le tableau, ce sont les véritables exécutions de long horizon, vérifiables, présentées dans l'annonce. Ramp l'a laissé tourner sans surveillance pendant 38 heures sur un problème de machine learning, où il a diagnostiqué un résultat précédent comme un artefact d'étiquetage, l'a corrigé et a lancé six expériences nocturnes en parallèle. Millennium a rapporté qu'il avait trouvé la cause d'un plantage survenant une fois sur un million d'exécutions, qu'aucun ingénieur ni modèle n'avait résolu en quatre à cinq ans. Et sur le benchmark d'agents navigateur le plus difficile de Browserbase, il a terminé 82% des tâches contre 74% pour Opus 5 et 57% pour Fable 5, avec moins de tokens. C'est le genre de résultat qu'un score de benchmark ne rend pas tout à fait.
Les praticiens qui l'ont testé ont fait écho à l'histoire du codage :
"I've tested Claude Fable 5.1 over the last week. Everyone should try this model... this model is delight to work with and has the depth of the Fable models. I really trust this model"
Si vous le comparez directement à d'autres modèles de codage, notre comparatif des meilleurs assistants de codage IA, du top des agents IA et des alternatives à GPT-5.3 Codex est un bon point de départ pour calibrer vos attentes.
Comment fonctionne le réglage effort
La chose la plus utile à comprendre sur Fable 5.1 en pratique n'est pas un benchmark, c'est le curseur effort.
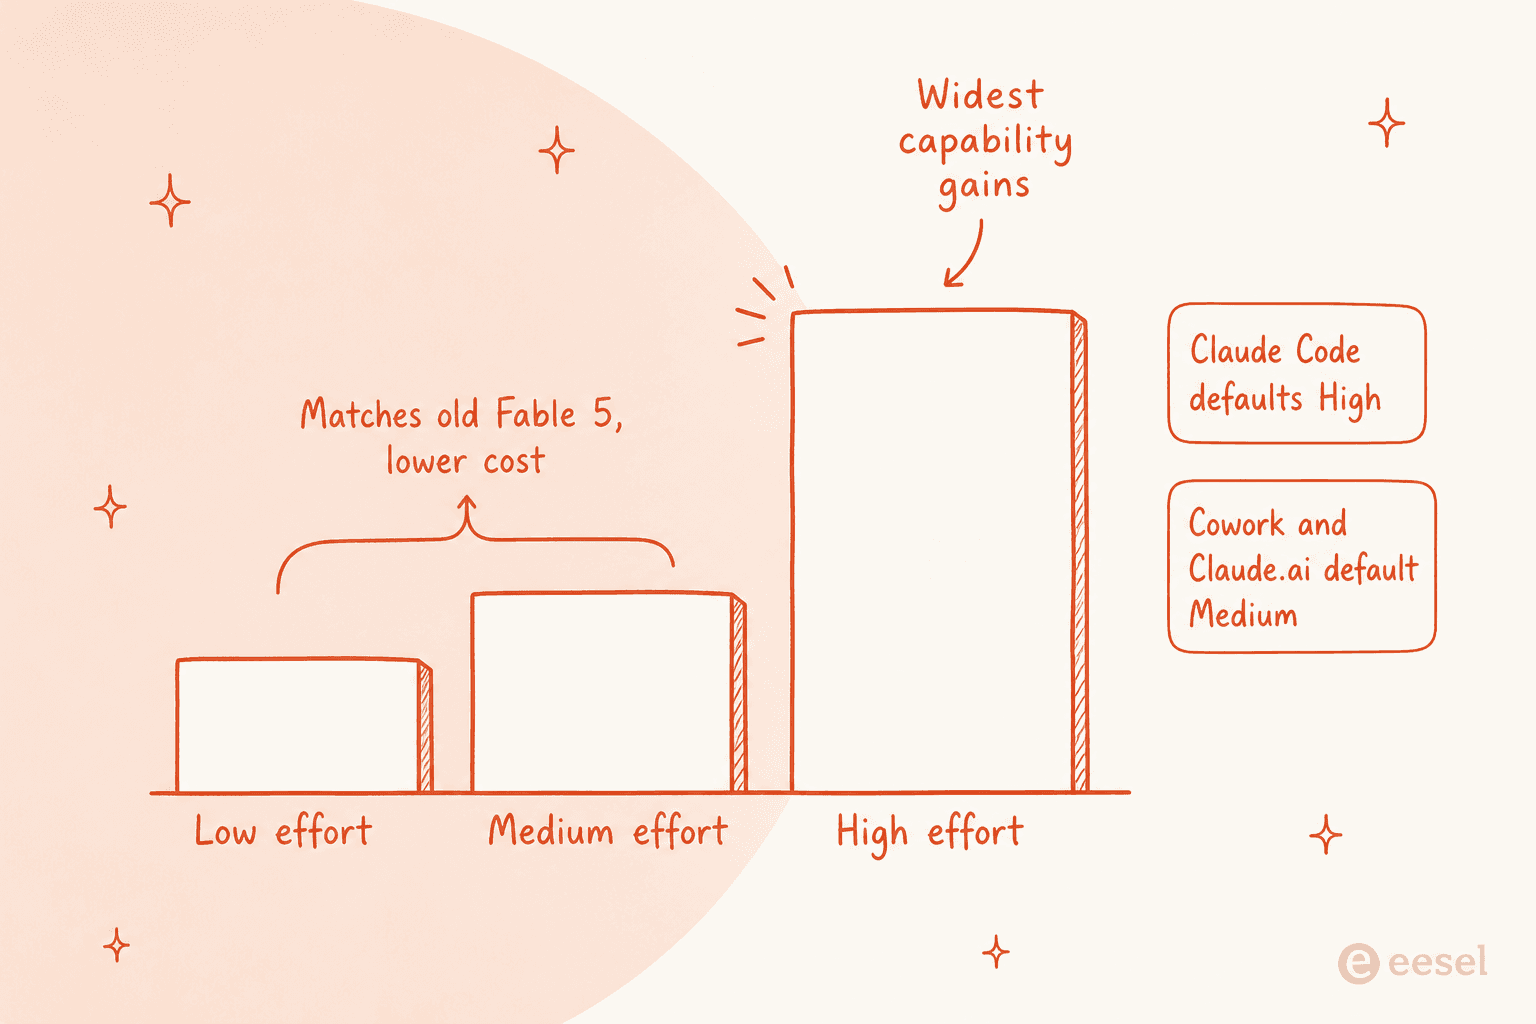
Le thinking adaptatif est toujours actif, et effort contrôle la quantité que vous en obtenez. L'objectif de conception affiché par Anthropic est qu'à effort faible ou moyen, Fable 5.1 égale ou dépasse Fable 5 à un coût bien moindre ; l'écart avec Fable 5 est maximal à effort élevé. Les valeurs par défaut varient selon la surface : élevé dans Claude Code, moyen dans Claude Cowork et sur Claude.ai. Le même modèle peut donc être un cheval de bataille économique ou un spécialiste de profondeur maximale selon un seul paramètre, ce qui est exactement ce qui permet aux lectures de cache moins chères de faire mouche.
Ce n'est cependant pas une victoire nette pour tout le monde. Un développeur qui travaille dans des langages moins courants a répondu :
"I write a lot of Rust and Lean, Fable 5 is in my experience better at both. Cost/performance is a different story."
C'est un rappel utile : « domine tous les benchmarks » reste une moyenne, et votre charge de travail pourrait se trouver dans la queue de distribution où le modèle précédent l'emporte encore en qualité brute. Testez sur vos propres tâches avant de migrer, de la même façon que vous aborderiez toute décision d'optimisation LLM.
Le revers de la médaille : garde-fous et confiance
J'essaie d'être juste envers chaque outil dont je parle, et ça vaut dans les deux sens : la plainte récurrente la plus importante sur Fable 5.1 le jour du lancement ne portait pas sur la capacité, mais sur les refus.
Anthropic a bien rendu les garde-fous plus précis. Les utilisateurs de Claude Code peuvent s'attendre à environ 60% d'interventions de garde-fou cyber en moins par session par rapport à Fable 5, et les garde-fous biologiques se déclenchent désormais 85% moins souvent sur des questions scolaires anodines. Quand une requête est tout de même signalée, elle est redirigée vers un modèle Opus et vous n'êtes pas facturé au tarif Fable pour cela. Ce sont de vraies améliorations mesurables.
Mais les développeurs rencontrent encore des faux positifs, parfois sur leur propre code :
"Fable is useless. Me: 'Find my security problems in my own code. This is code I own. I'm doing this under authorization of the CEO/CTO of our company.' Fable: 'yeah, no.'"
"The main issue was that Fable was unpredictable and prone to false positives by the safeguards... it still seems completely unable to understand its own guardrails and will readily reason itself into triggering them."
Ajoutez le nouveau filigrane et les blocs de thinking liés au modèle, et il existe un vrai courant de gens qui ont le sentiment que le modèle se méfie davantage d'eux à mesure qu'il devient plus capable. Que ce compromis en vaille la peine dépend entièrement de votre travail ; une équipe de sécurité défensive le ressent bien plus qu'une personne qui rédige des documents. C'est un fait à peser, pas un facteur rédhibitoire pour la plupart.
Où Fable 5.1 se positionne si vous gérez le support ou rédigez du contenu
Voici le recadrage que je défendrais, et c'est ce que plus de trois ans à déployer de l'IA sur des files de support en direct nous ont appris chez eesel : vous n'embauchez pas un modèle, vous embauchez un coéquipier qui en utilise un.
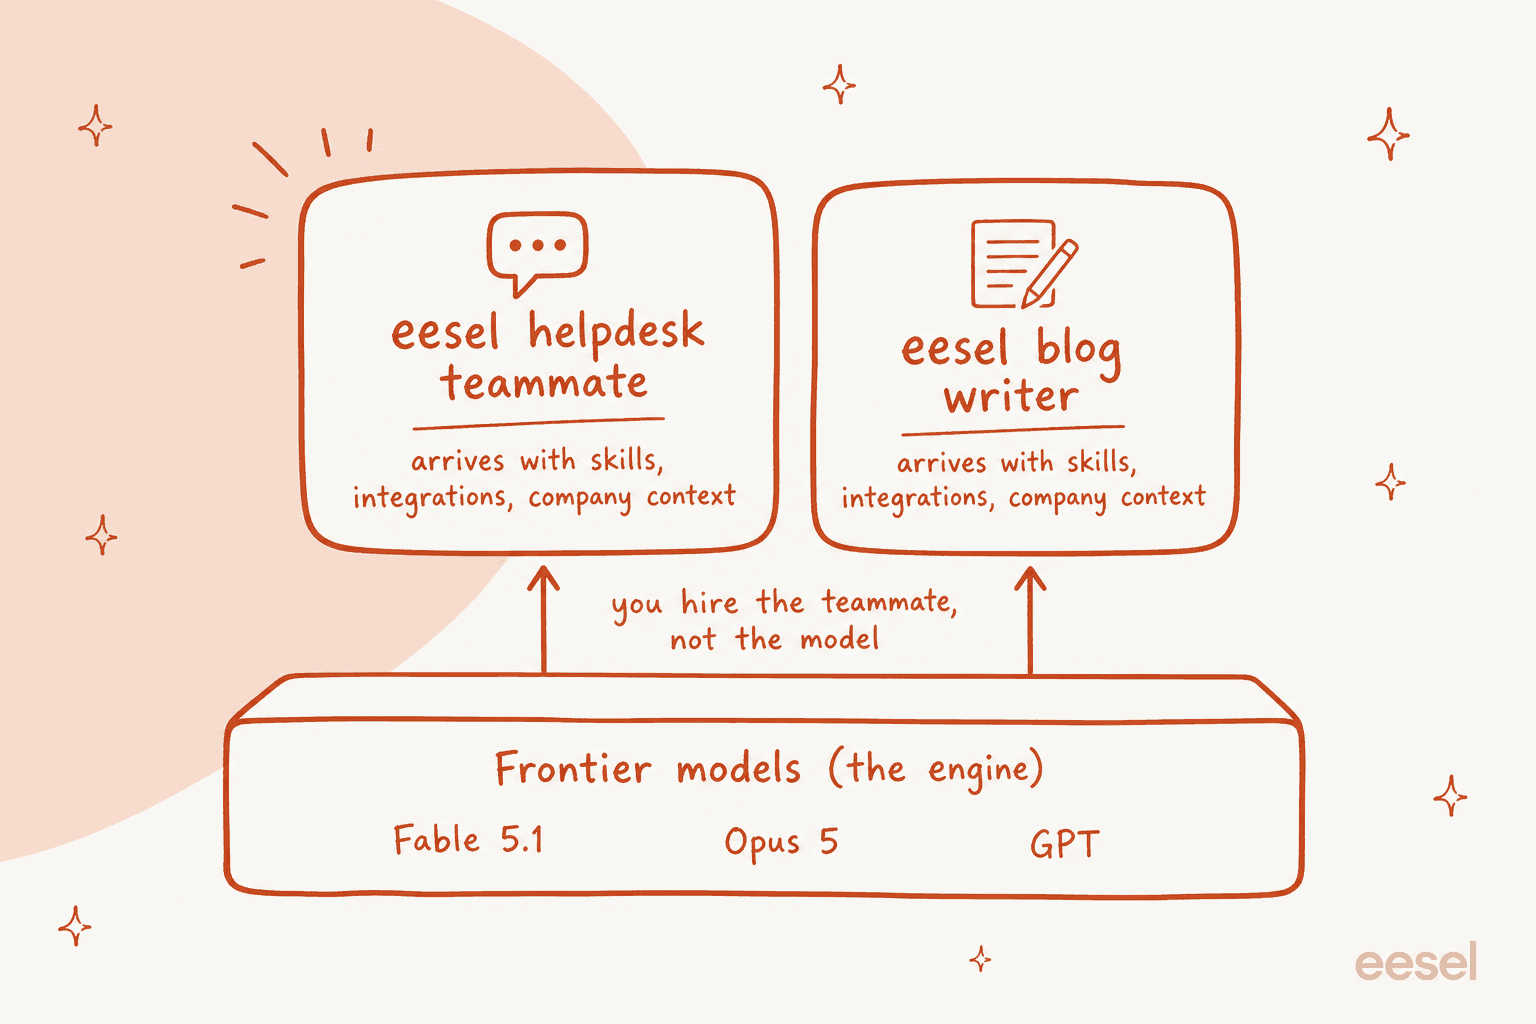
Fable 5.1 est de l'infrastructure, le moteur brut. Un responsable support ne veut pas écrire une boucle d'outils, brancher une recherche sur d'anciens tickets, gérer les refus et administrer un budget de tokens, il veut des tickets résolus. Cet écart entre un modèle de pointe et une solution qui fonctionne, c'est exactement là que vit un produit comme eesel. Notre agent de helpdesk IA tourne sur des modèles de pointe comme celui-ci, mais il arrive déjà entraîné sur votre centre d'aide et vos anciens tickets, connecté au helpdesk que vous utilisez déjà.

Et parce que nous avons vu des bots à la voix assurée donner tranquillement de mauvaises réponses, chaque déploiement eesel est simulé sur vos tickets historiques avant de toucher un client réel, pour que vous voyiez comment il va réellement se comporter. C'est une proposition très différente d'appeler vous-même claude-fable-5-1. Si vous pesez vos options, nos guides sur la meilleure IA de service client et l'automatisation de l'IA pour le service client détaillent ce qu'il faut rechercher, et construire un GPT support sur mesure montre la voie DIY si vous préférez rester brut.
Si vous cartographiez d'abord la catégorie, nos guides sur les meilleurs logiciels de helpdesk IA, les chatbots de service client IA et un copilote IA pour le support dressent le paysage.
Le volet contenu suit la même logique. L'écriture de Fable 5.1 s'est vraiment améliorée, Canva a estimé que « ce qui se distingue, c'est l'écriture », et les évaluateurs de Glean ont préféré ses réponses environ 2 fois sur 3 par rapport à Fable 5. Mais une meilleure prose venant d'un modèle brut ne fait toujours pas de recherche de mots-clés, ne place pas de liens internes et ne va pas chercher de vraies sources.
Cet échafaudage, c'est le vrai travail, ce qui explique pourquoi un rédacteur de blog IA surpasse une simple fenêtre de chat pour le travail de publication, et pourquoi notre comparatif d'outils de rédaction de blog IA existe.
Concernant le workflow lui-même, nous avons creusé l'automatisation de blog IA, la rédaction IA longue forme et le vrai coût d'un rédacteur de blog IA.
Essayez eesel pour le support et le contenu
eesel est une plateforme de coéquipiers IA : au lieu d'un modèle brut, vous embauchez des coéquipiers prêts à l'emploi pour des tâches précises. Le coéquipier helpdesk IA rejoint votre file de support, et le rédacteur de blog IA recherche et rédige du contenu SEO, tous deux tournant sur des modèles de pointe comme Fable 5.1 mais arrivant avec les compétences, les intégrations et le contexte de l'entreprise adaptés au poste.
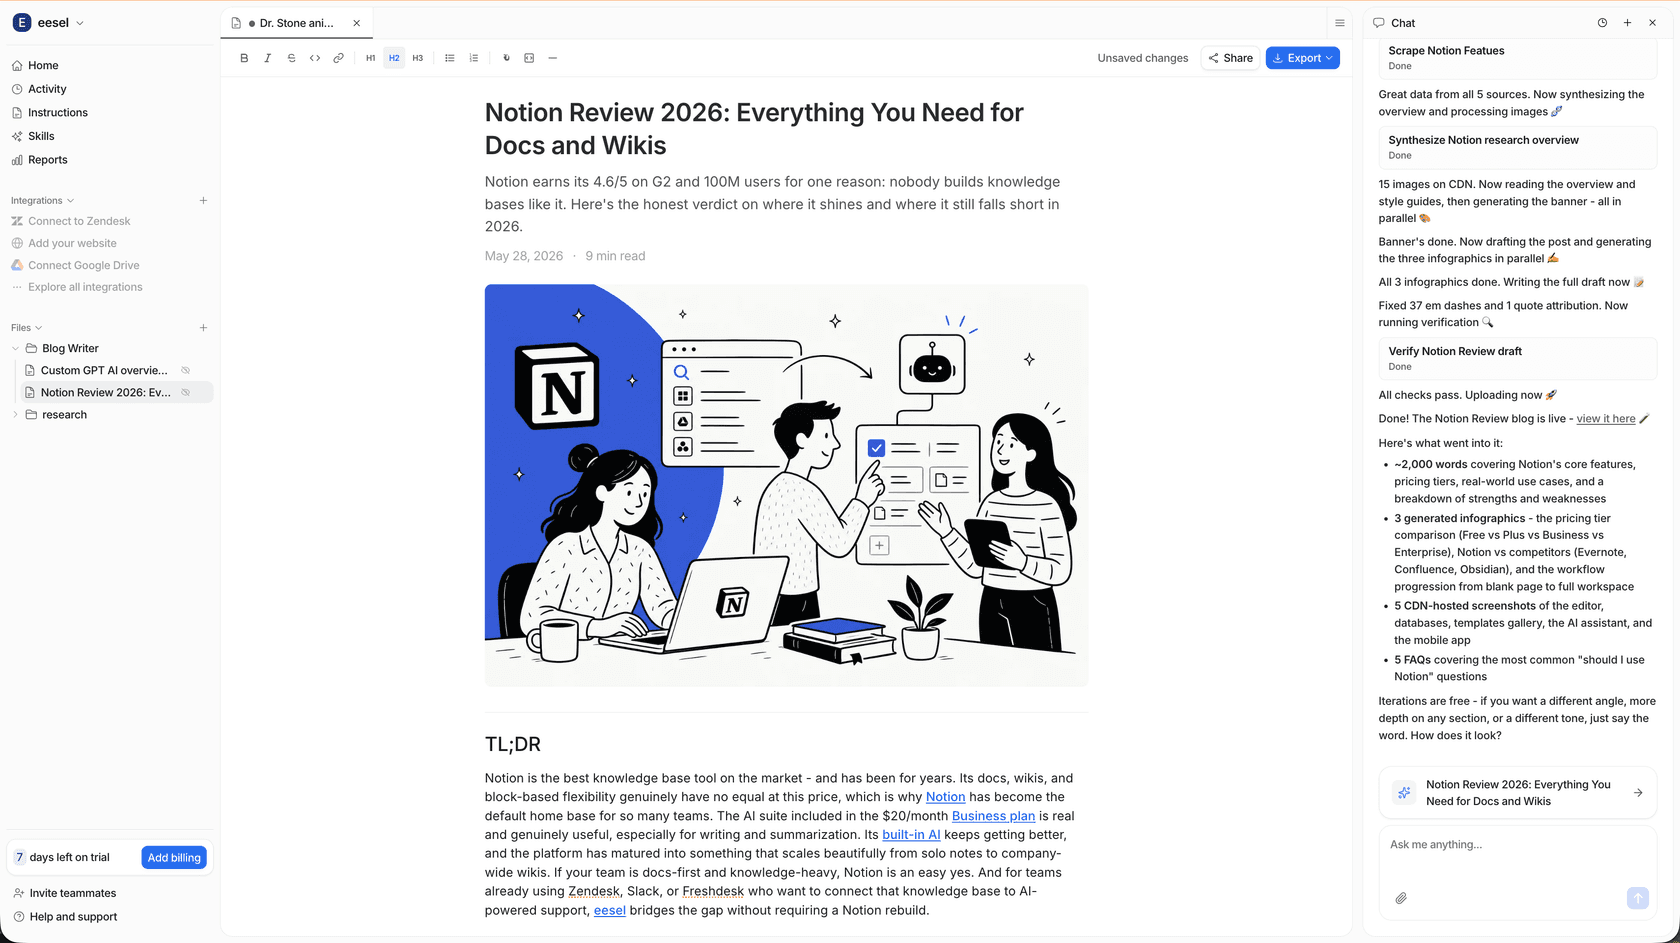
La différence par rapport à brancher un modèle vous-même, c'est qu'eesel se met en ligne en quelques minutes sur les outils que vous utilisez déjà, s'entraîne sur vos connaissances existantes, et vous laisse simuler un coéquipier sur de vraies données passées avant la mise en production. Vous pouvez essayer eesel gratuitement, sans carte bancaire ni appel commercial, et voir comment il répond à vos propres tickets ou rédige vos propres articles avant de vous engager.
Fable 5.1 est un moteur remarquable. La plupart des équipes veulent juste le travail fini qu'il rend possible, et c'est cette partie-là que nous construisons.
Questions fréquentes
Combien coûte Claude Fable 5.1 ?
Quelle est la différence entre Claude Fable 5.1 et Fable 5 ?
Claude Fable 5.1 est-il meilleur que Claude Opus 5 ?
Puis-je utiliser Claude Fable 5.1 pour le support client ?
Claude Fable 5.1 filigrane-t-il ses écrits ?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.