Alternatives à TypeSafe Jev : 8 façons d'obtenir des décisions IA rapides et typées

Alicia Kirana Utomo

Katelin Teen
Dernière modification September 21, 2026
Qu'est-ce qui compte vraiment comme une alternative à TypeSafe Jev ?
La proposition de Jev est étroite et précise : envoyez-lui un état non structuré plus des questions typées, récupérez rapidement des décisions typées avec des probabilités calibrées. Sur Hacker News, le lancement a récolté 1 929 points, et le commentaire le plus incisif a reformulé tout cela très clairement :
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference'... Jev can only generate structured output, right?"

Cette reformulation est le bon angle pour comparer les alternatives. Tout ce qui transforme la sortie d'un modèle en une forme garantie entre en concurrence avec Jev sur la partie typée. Ce qui est réellement difficile à copier, c'est la partie calibrée, sans génération, et c'est pourquoi la liste se divise selon la proximité de chaque option avec cela.
J'ai regroupé les huit options dans les trois familles ci-dessus. Voici l'ensemble en un coup d'œil avant de passer outil par outil.
| Outil | Type | Ce qu'il renvoie | Garantie de schéma | Score de confiance | Hébergement | Tarif | Idéal pour |
|---|---|---|---|---|---|---|---|
| eesel | Coéquipier de support | Un ticket résolu, pas seulement une décision | Actions sur votre helpdesk | Simulé sur des tickets passés | SaaS (SOC 2, RGPD) | À l'usage, ~$0,40/ticket | Faire tourner le support de bout en bout |
| TypeSafe Jev | Modèle System One | Décision typée + probabilité | Oui, natif | Oui, calibré par RLCD | API + Cloudflare | ~$0,042/MTok en entrée, sortie gratuite | Décisions rapides et étroites à grande échelle |
| OpenAI Structured Outputs | Fonctionnalité d'API managée | JSON conforme à votre schéma | Oui, JSON Schema | Via les logits (approximatif) | API OpenAI | Tarif normal de tokens du modèle | Équipes déjà sur OpenAI |
| Gemini structured output | Fonctionnalité d'API managée | JSON conforme à votre schéma | Oui, JSON Schema | Via les logits (approximatif) | API Google | Tarif normal de tokens du modèle | Classification bon marché sur Flash-Lite |
| Cloudflare Workers AI | Passerelle de modèles | Mode JSON / appels de fonction | Oui, selon le modèle | Dépend du modèle | Edge + serverless | À l'usage (Neurons), palier gratuit | Apps en edge, et faire tourner Jev lui-même |
| BAML | DSL de schéma + bibliothèque | Objets typés depuis n'importe quel LLM | Oui, à l'analyse | Dépend du modèle | Auto-hébergé / OSS | Gratuit (open source) | Meilleure DX pour prompt-vers-type |
| Instructor | Bibliothèque (Pydantic) | Objets typés validés | Oui, avec relances | Via les logits (approximatif) | Auto-hébergé / OSS | Gratuit (open source) | Extraction en Python, démarrage rapide |
| Outlines | Bibliothèque de génération | Structure imposée pendant le décodage | Oui, au moment du décodage | Dépend du modèle | Auto-hébergé / OSS | Gratuit (OSS) + API hébergée | Modèles locaux, grammaires strictes |
| Hugging Face AutoTrain | Classificateur entraîné | Étiquette de classe + probabilité | Ensemble d'étiquettes fixe | Oui, softmax | HF Hub / auto-hébergé | Coût de calcul | Classification étroite et à fort volume |
Une remarque sur le ton avant la liste : aucun de ces outils n'est mauvais, et certains sont même excellents. Quand je pointe une limite, c'est un constat sur le périmètre, pas une critique. Passons-les en revue.
1. eesel : la couche coéquipier, pas une primitive de décision
Je vais être direct : c'est un type de réponse différent. Beaucoup de gens qui recherchent un modèle de décision typée essaient en réalité de résoudre un problème de support ou d'exploitation, et se sont tournés vers une primitive parce que c'était la nouveauté brillante du moment. Si c'est votre cas, la recommandation honnête est de sauter la primitive.

Ce que c'est. eesel est une plateforme de coéquipiers IA. Les clients embauchent des coéquipiers prêts à travailler pour un poste précis, et l'équipe actuelle comprend un coéquipier IA pour le helpdesk et un rédacteur de blog IA. Le coéquipier helpdesk rejoint votre file existante, lit votre centre d'aide et vos tickets passés, et prend les mêmes décisions de triage, de routage et d'escalade qu'un modèle de décision, puis il rédige et résout.
Où ça s'applique. Quand la décision est un moyen et que la fin est un ticket résolu. Jev vous donne « urgent, facturation, 0,94 ». eesel prend ce jugement et répond réellement, étiquette, route et clôture, intégré à votre workflow de service client avec IA. Il se comporte moins comme une astuce de décodage et plus comme un agent IA avec votre contexte chargé, et il se trouve à l'intérieur de votre logiciel de service client plutôt qu'à côté.
Points de vigilance. eesel n'est pas une API de décision généraliste. Si vous voulez une primitive brute à intégrer dans un produit sans rapport, il vous faut l'un des outils ci-dessous, pas un coéquipier.
Si vous vivez dans un terminal : eesel propose aussi une CLI publique plus un serveur MCP, pour que le même coéquipier et le même espace de travail soient pilotables depuis des scripts et depuis des agents de code comme Claude Code, Codex et Cursor. C'est le même agent que le tableau de bord, pas un gadget séparé, ce qui compte si votre instinct avec Jev était de tout scripter. Voyez comment cela se compare à une intégration MCP Claude Code.
Tarifs. À l'usage, environ $0,40 par ticket résolu, sans surtaxe IA par siège. Vous pouvez simuler sur vos tickets historiques avant la mise en production, l'étape de calibration que tous les autres outils de cette page sautent.
2. OpenAI Structured Outputs
Si votre stack est déjà sur OpenAI, c'est l'alternative à Jev avec le moins de friction, car c'est une fonctionnalité, pas un nouveau fournisseur.
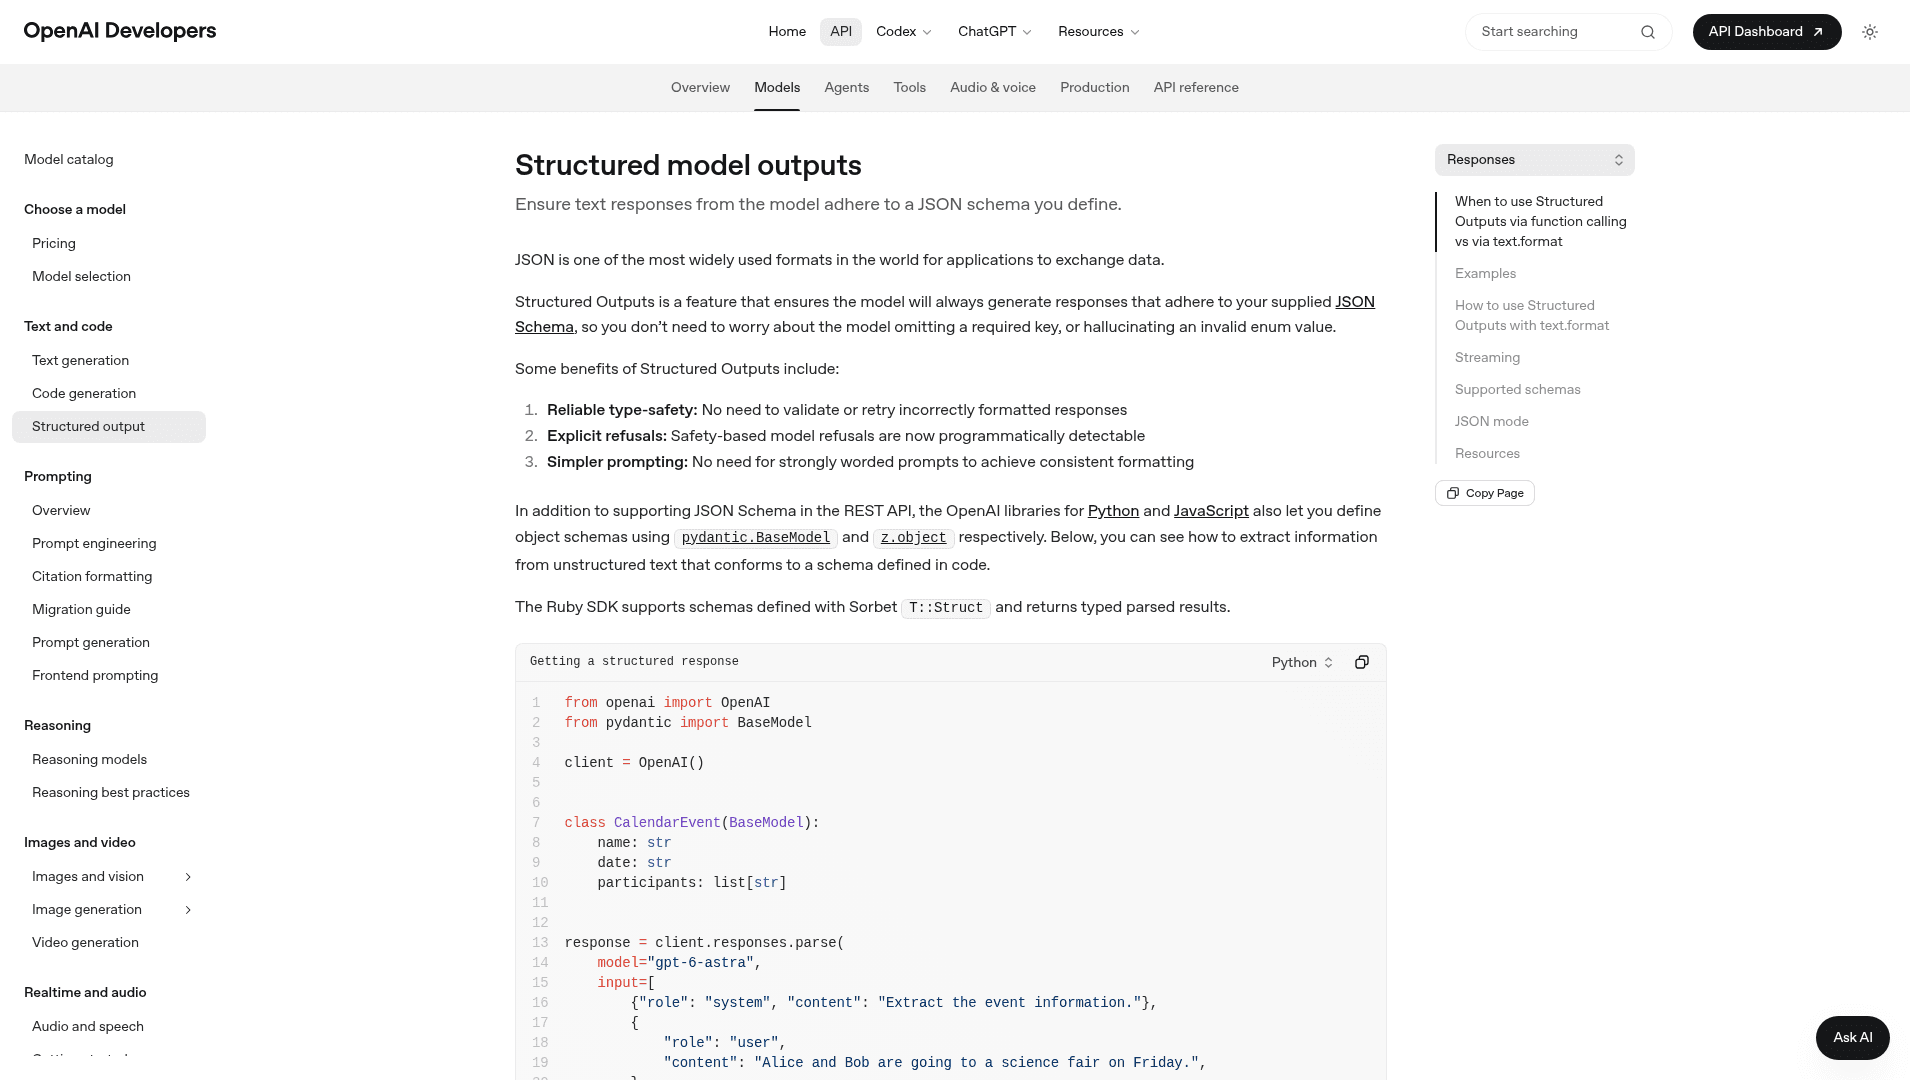
Ce que c'est. Structured Outputs fait en sorte qu'un modèle renvoie toujours des réponses conformes à un JSON Schema que vous définissez, donc il n'omettra pas une clé obligatoire ni n'inventera une valeur d'énumération invalide. Cela rend aussi les refus de sécurité détectables par programme, et accepte des schémas définis avec pydantic.BaseModel ou z.object.
Où ça s'applique. Extraction de données, classification des tickets et routage quand vous voulez tout le raisonnement du modèle derrière la décision, et que vous pouvez vivre avec la latence de génération. C'est une base solide pour un pipeline d'automatisation des tickets maison.
Points de vigilance. C'est une contrainte posée sur un modèle génératif, donc vous payez toujours la génération de tokens et vous l'attendez. Cela vous donne une forme valide, pas un score de confiance calibré, donc si vous voulez spécifiquement la calibration pour laquelle Jev est entraîné, vous devez la dériver vous-même à partir des logits.
Tarifs. Fonctionnalité gratuite ; vous payez le tarif normal de tokens du modèle que vous appelez.
3. Gemini structured output
La version de Google, et celle vers laquelle je me tourne quand la tâche est une classification bon marché et à fort volume.
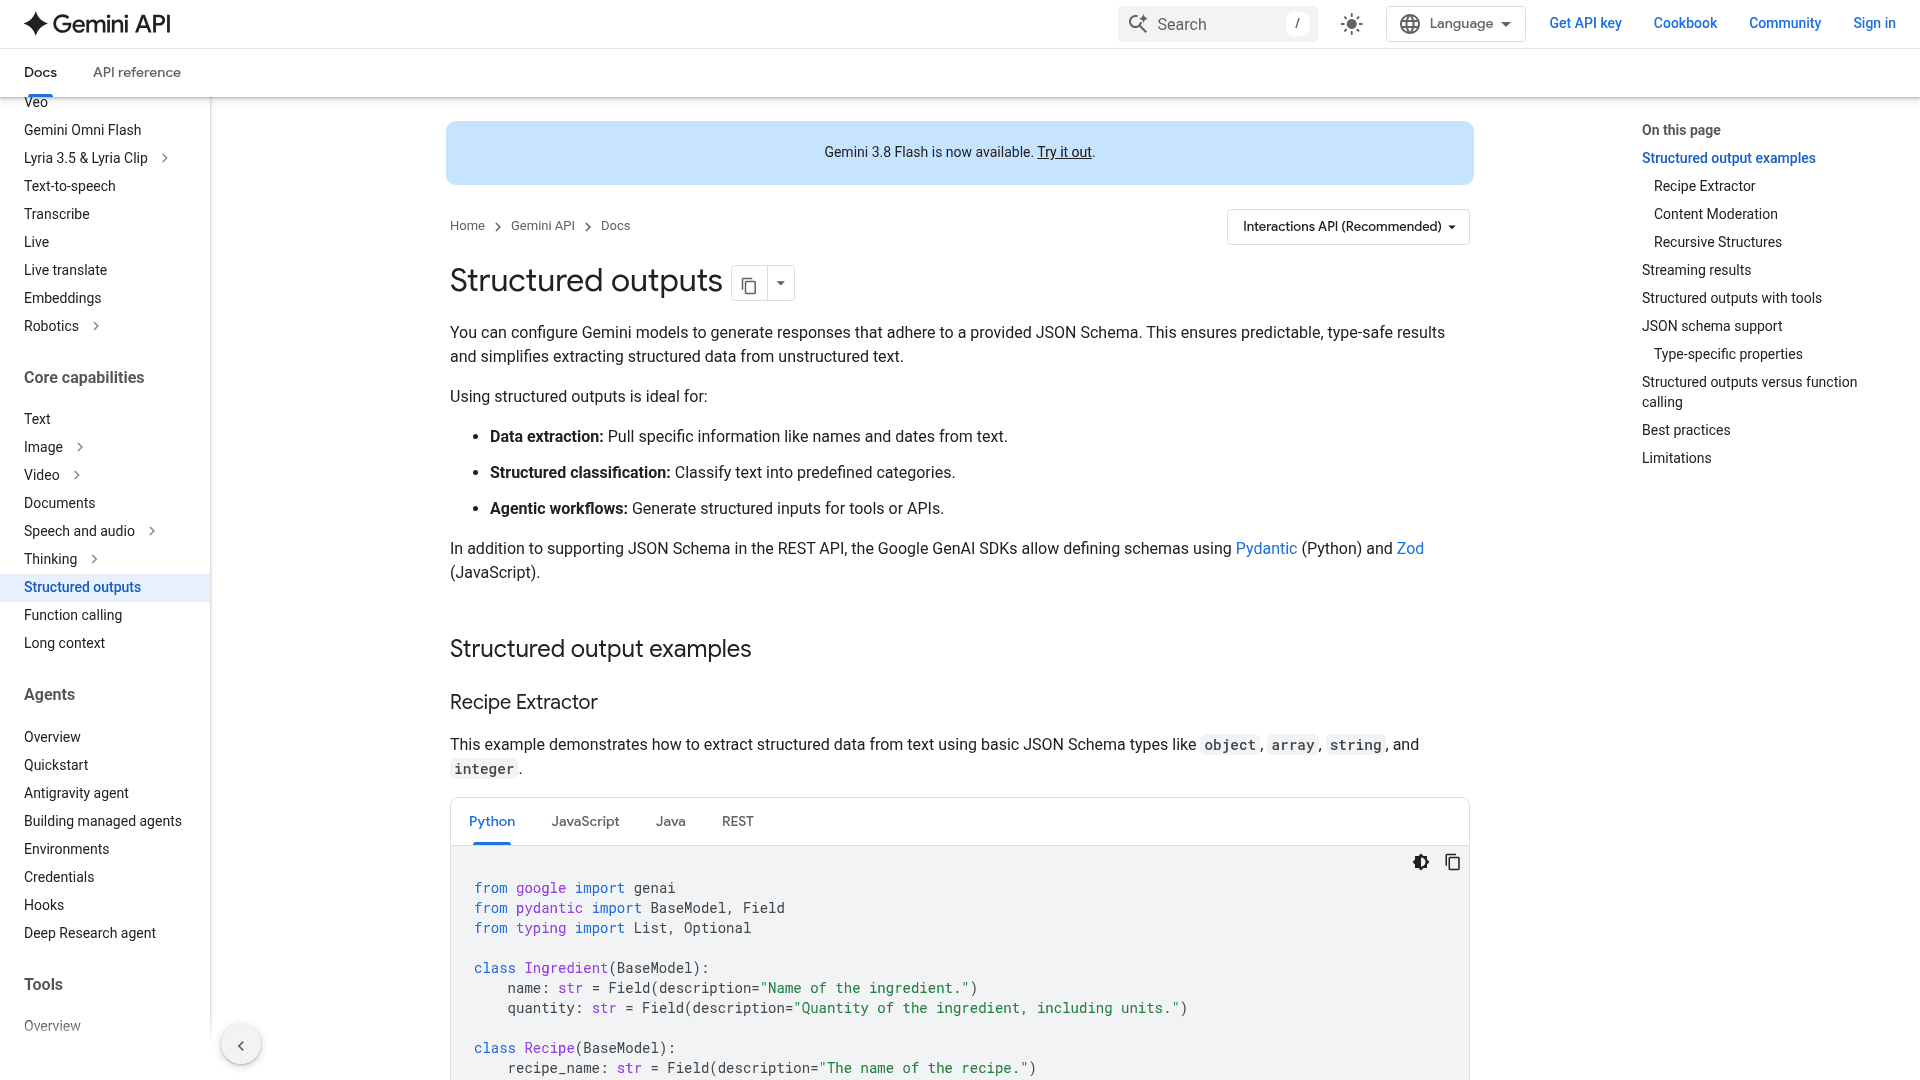
Ce que c'est. Gemini structured output configure les modèles Gemini pour générer des réponses conformes à un JSON Schema, et la documentation nomme trois usages idéaux : extraction de données, classification structurée, et génération d'entrées structurées pour des workflows agentiques. Il prend en charge les schémas Pydantic et Zod.
Où ça s'applique. Classification et extraction en volume, y compris le type d'automatisation des tickets de support qui nécessitait autrefois un moteur de règles réglé à la main. Sur le palier le moins cher (Flash-Lite), le coût par appel se rapproche du territoire de Jev, ce qui est le véritable angle concurrentiel ici.
Points de vigilance. Même réserve de fond que pour OpenAI : c'est de la génération avec une contrainte de schéma, pas un moteur de décision conçu sur mesure, donc la latence et la confiance se comportent comme celles d'un LLM, pas comme celles de Jev.
Tarifs. Fonctionnalité gratuite ; vous payez les tarifs de tokens Gemini, et choisir le bon palier de modèle est l'endroit où se trouve le coût réel.
4. Cloudflare Workers AI
Le rebondissement intéressant : c'est à la fois une alternative à Jev et l'endroit où Jev tourne réellement.
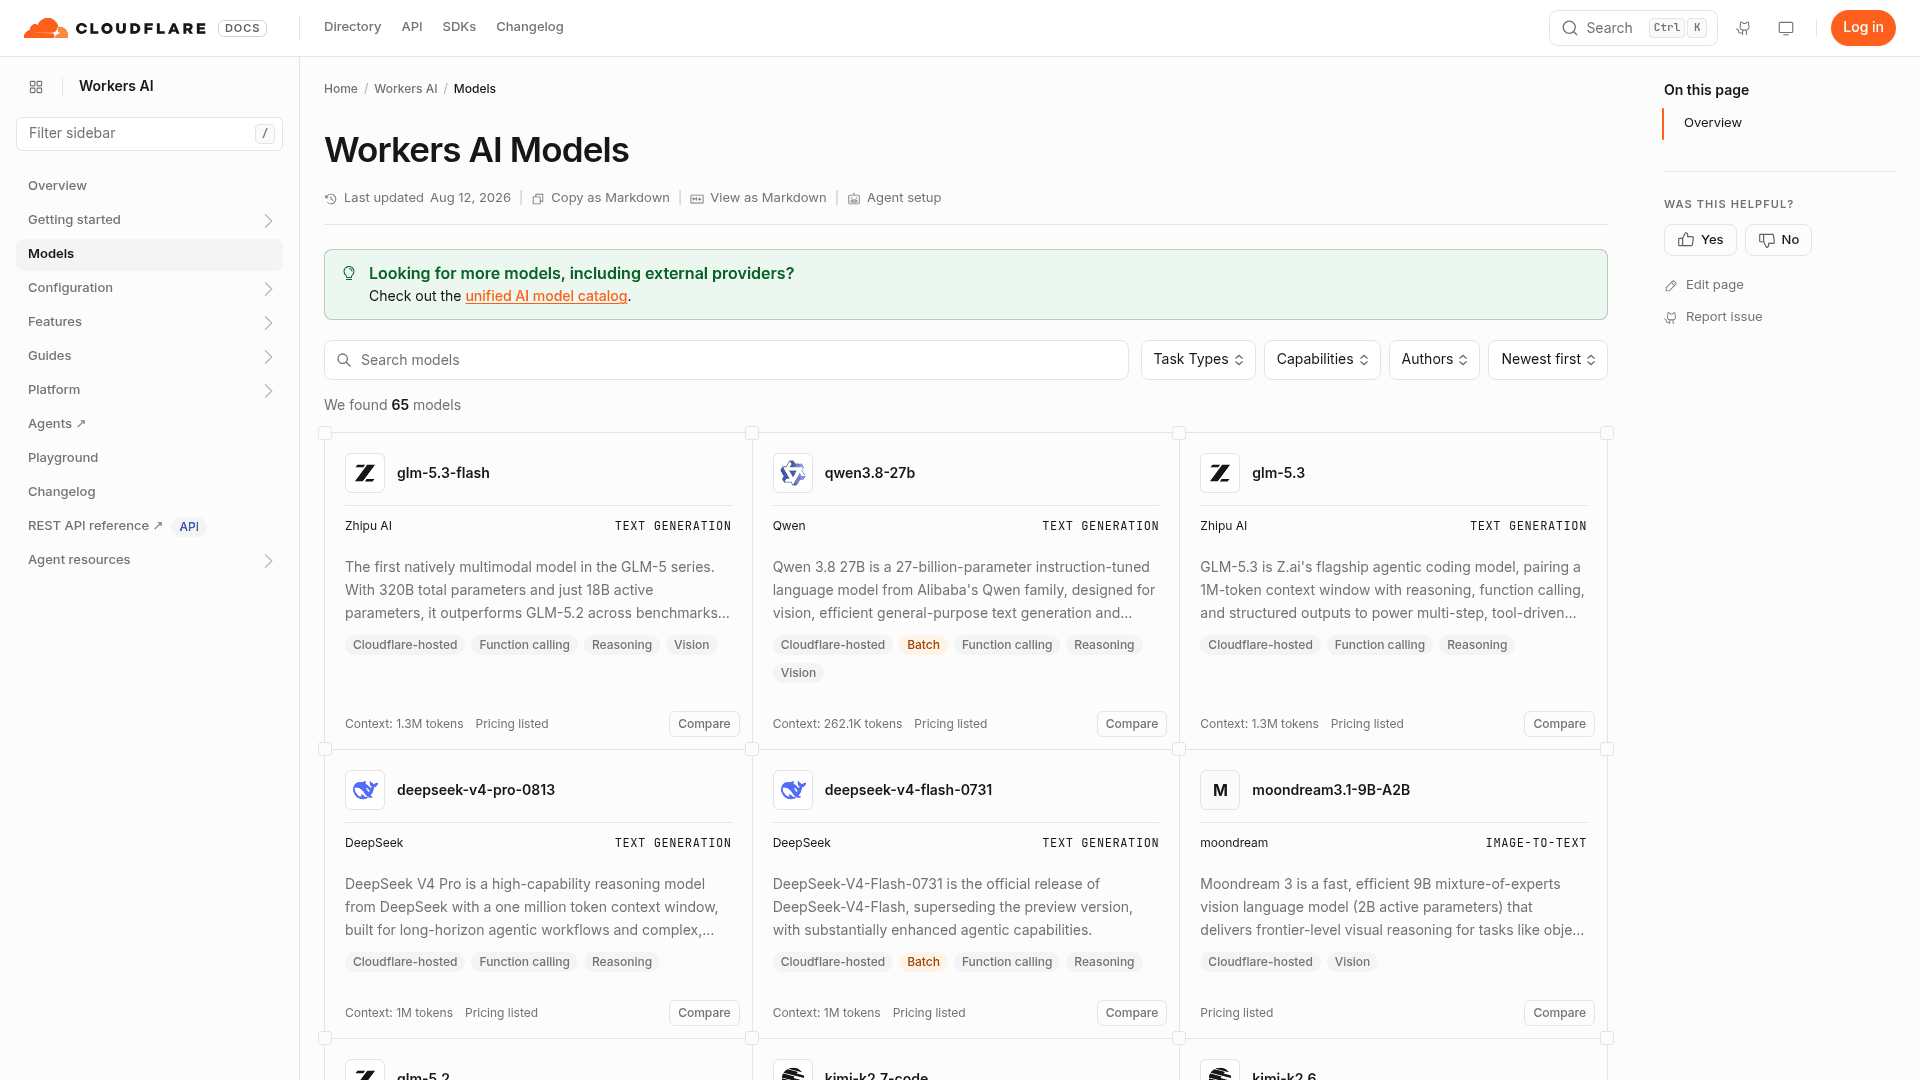
Ce que c'est. Workers AI est la passerelle de modèles serverless de Cloudflare, avec un catalogue de plus de 65 modèles, beaucoup étiquetés pour l'appel de fonction et les sorties structurées, tournant en edge. Jev y est également répertorié, sous l'identifiant de modèle typesafe/jev.
Où ça s'applique. Les applications en edge qui veulent un petit modèle rapide près de l'utilisateur, et les équipes qui veulent une seule surface de facturation à la fois pour un modèle général et des décisions façon Jev.
Points de vigilance. La garantie de sortie structurée dépend du modèle précis choisi, pas de Workers AI lui-même. Traitez-le comme une couche de distribution et choisissez le modèle sur ses mérites.
Tarifs. À l'usage (facturé en « Neurons ») avec une allocation quotidienne gratuite, et la facturation de Jev sur Cloudflare se règle via le tableau de bord Cloudflare.
5. BAML
La meilleure expérience développeur parmi les options de bibliothèque, et celle que je confierais à une équipe qui déteste bricoler des prompts.
Ce que c'est. BAML est un langage dédié pour générer des sorties structurées à partir de LLM. Il livre des sorties entièrement type-safe (même en streaming), un terrain de jeu VSCode interactif, et fonctionne avec n'importe quel LLM, n'importe quel langage et n'importe quel schéma. Il compte environ 9 200 étoiles sur GitHub.
Où ça s'applique. Les équipes qui veulent passer du prompt à l'objet typé avec une vraie autocomplétion et une boucle d'édition serrée, quel que soit le modèle choisi. Si vous construisez votre propre agent IA pour helpdesk, BAML est la couche qui garde la sortie du modèle fidèle à vos types.
Points de vigilance. BAML vous donne une sécurité de type à l'analyse, mais le comportement de confiance est hérité du modèle sous-jacent, donc ce n'est pas un moteur de décision calibré comme Jev prétend l'être.
Tarifs. Gratuit et open source.
6. Instructor
La bibliothèque la plus adoptée dans ce domaine, et la façon la plus rapide de faire fonctionner l'extraction typée en Python.
Ce que c'est. Instructor extrait des données structurées depuis n'importe quel LLM avec sécurité de type, validation et relances automatiques. Il est construit sur Pydantic, en v1.17.0, avec environ 14 000 étoiles, 3 millions de téléchargements mensuels, plus de 100 contributeurs, et plus de 15 fournisseurs pris en charge dont Ollama et DeepSeek. Il fonctionne en Python, TypeScript, Go, Ruby, Elixir et Rust.
Où ça s'applique. Une extraction rapide et centrée sur le schéma, où vous voulez de la validation et des relances sans traîner un framework d'agents.
Points de vigilance. La documentation d'Instructor elle-même est agréablement honnête sur le fait qu'il est fait pour l'extraction ; pour des runtimes d'agents plus lourds, elle vous renvoie vers PydanticAI. Et comme toute bibliothèque ici, elle standardise la forme de la sortie, pas la véracité de la réponse.
Tarifs. Gratuit, sous licence MIT.
7. Outlines
L'option vers laquelle se tourner quand vous faites tourner vos propres modèles et voulez une structure imposée au niveau du token.
Ce que c'est. Outlines garantit des sorties structurées pendant la génération, directement depuis n'importe quel LLM, plutôt que d'analyser ou de corriger par regex une mauvaise sortie après coup. Il fonctionne avec OpenAI, Ollama et vLLM, prend en charge JSON Schema, les expressions régulières et les grammaires hors-contexte, en est à la v1.3.0 avec environ 15 900 étoiles, et se combine avec une API Dottxt hébergée pour une génération 100 % conforme au schéma sans faire tourner vos propres modèles.
Où ça s'applique. Les modèles locaux et auto-hébergés, et les cas où vous avez besoin d'une grammaire stricte, pas seulement de JSON.
Points de vigilance. Imposer la structure au moment du décodage est puissant mais plus bas niveau ; vous êtes plus proche du matériel qu'avec une fonctionnalité managée, ce qui est soit exactement le but, soit une charge, selon votre équipe.
Tarifs. Open source et gratuit ; l'API Dottxt hébergée est l'option payante.
8. Hugging Face AutoTrain
Si votre décision est vraiment étroite et à fort volume, la réponse la moins chère sur le long terme pourrait être un modèle que vous entraînez et possédez.
Ce que c'est. AutoTrain est la méthode no-code de Hugging Face pour entraîner, évaluer et déployer des modèles en téléversant des données. Sa liste de tâches inclut Text Classification et Token Classification, et les modèles obtenus se trouvent sur le Hugging Face Hub, prêts à servir.
Où ça s'applique. Un ensemble d'étiquettes fixe et bien défini pour lequel vous avez des données d'entraînement, comme étiqueter les tickets par code de motif ou router par file. C'est l'option vers laquelle les commentateurs de HN revenaient sans cesse, en soutenant que Jev est proche d'un petit classificateur que l'on pourrait reproduire :
"It's a heavily constrained, tiny model that can only produce a probability score or a yes/no answer over pre-defined selections... I suspect someone will be able to recreate this within a week."
Points de vigilance. Vous possédez tout le cycle de vie : étiquetage, entraînement, dérive, redéploiements. Un classificateur entraîné vous donne une probabilité softmax propre, mais il ne connaît que les classes que vous lui avez apprises, et le réentraînement est à votre charge.
Tarifs. Vous payez du temps de calcul ; il n'y a pas de licence par décision.
Laquelle devriez-vous vraiment choisir ?
Voici la décision telle que je la présenterais à un coéquipier.
Ce que chacune de ces options vous doit encore
Quel que soit l'outil choisi, surveillez l'écart entre une réponse valide et une réponse correcte. C'était le point le plus débattu dans le fil de lancement de Jev, et il s'applique aux huit alternatives :
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"
La reformulation utile issue du même fil est qu'un score de confiance ne vaut quelque chose que s'il est calibré :
"What we would want to see is a confidence value that is in line with the actual correctness. If the value is 0.9 for 1000 different answers, then approximately 900 of those answers should be correct."
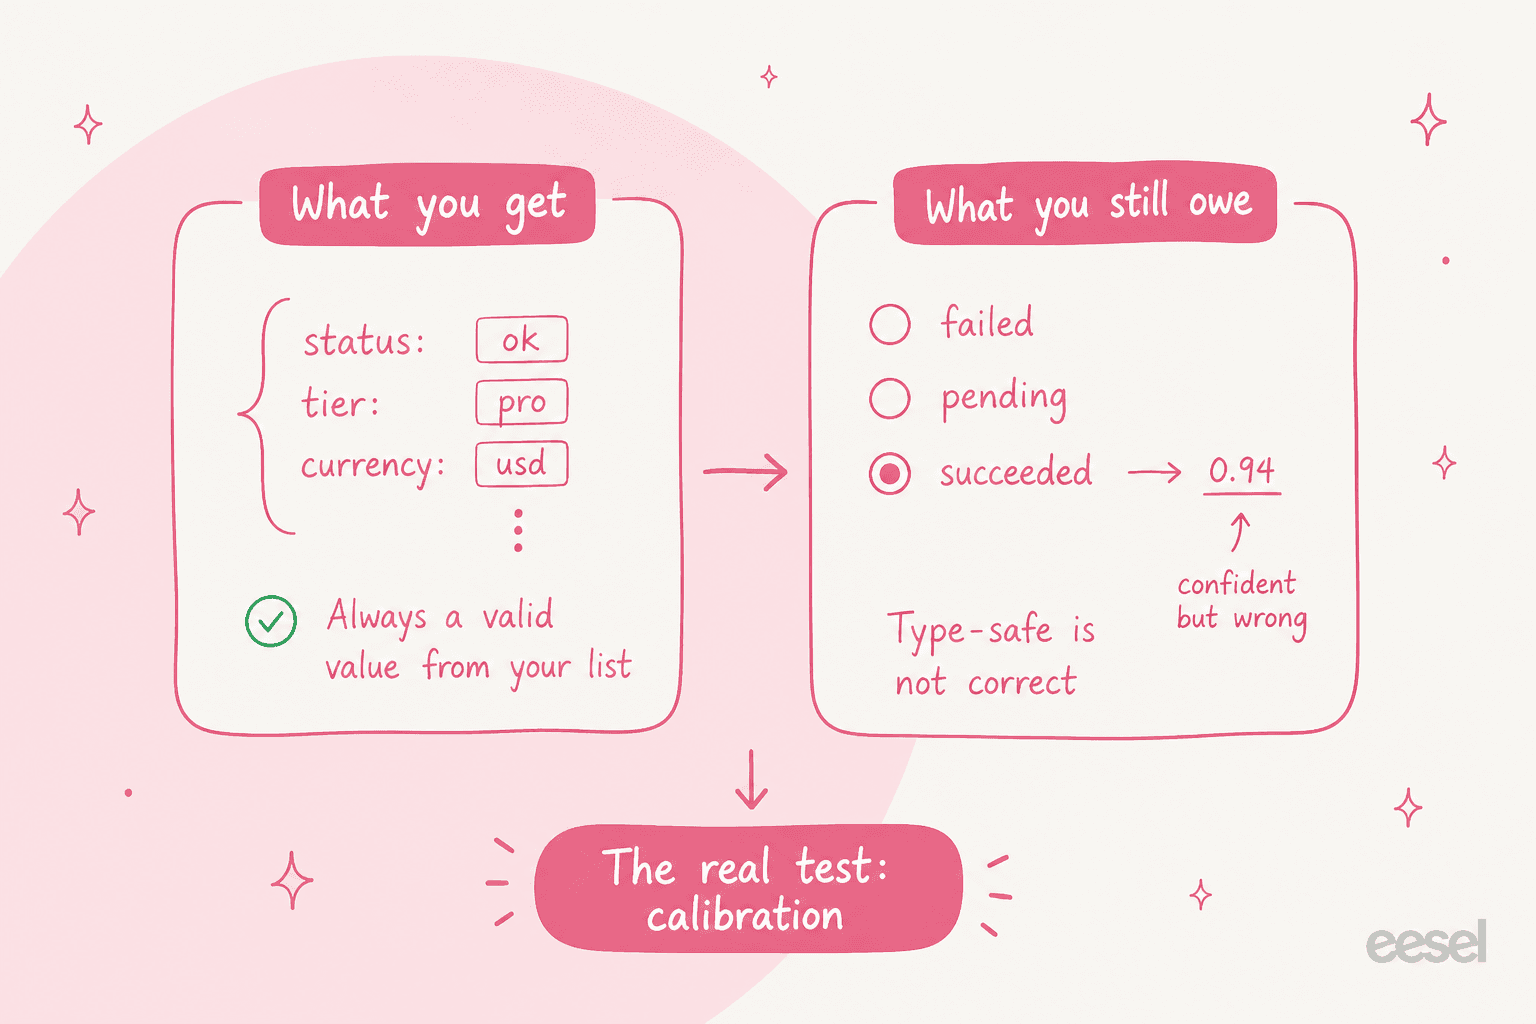
C'est pourquoi, côté support, je ne fais confiance à aucune couche de décision tant qu'elle n'a pas été testée sur les propres tickets passés d'une équipe, la même discipline que j'appliquerais pour choisir un LLM pour le support ou pour présélectionner les meilleurs agents de support IA. Un modèle qui affiche 0,94 sur un appel de routage ne veut rien dire tant que vous n'avez pas vérifié que les appels à 0,94 de confiance sont effectivement corrects 94 % du temps sur vos données. L'enthousiasme est réel malgré tout, et là où il retombe, les gens sont francs à ce sujet :
"After much fumbling around with prompts and evals, this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... I think this is going to quickly become the new standard approach for agentic systems."
Et en production, la vitesse n'est pas du battage. Le PDG de Vercel a rapporté des chiffres réels :
"Jev is up to 18x faster (p95) and more accurate. It's coming to Vercel AI Gateway and likely new default."
La place d'eesel dans tout ça
Chaque outil de cette page est de l'infrastructure. Ils remettent à votre code une décision typée, et c'est ensuite à votre code de faire quelque chose avec. C'est la bonne forme si vous construisez un produit. C'est la mauvaise forme si votre travail est de faire tourner une file de support et que vous espériez qu'un modèle de décision s'en charge.
eesel est l'employé, pas la primitive. Le coéquipier IA pour helpdesk lit votre centre d'aide et vos tickets passés, prend les mêmes décisions de triage et de routage que Jev prendrait, puis rédige, étiquette, route et résout à l'intérieur de votre helpdesk IA existant. Vous pouvez le pointer sur votre historique et simuler le déploiement avant qu'il ne réponde à un seul client en direct, donc la calibration est une étape que vous franchissez, pas une affirmation à laquelle vous faites confiance. Et si votre instinct est de tout scripter, le même coéquipier est pilotable depuis la CLI eesel et MCP.
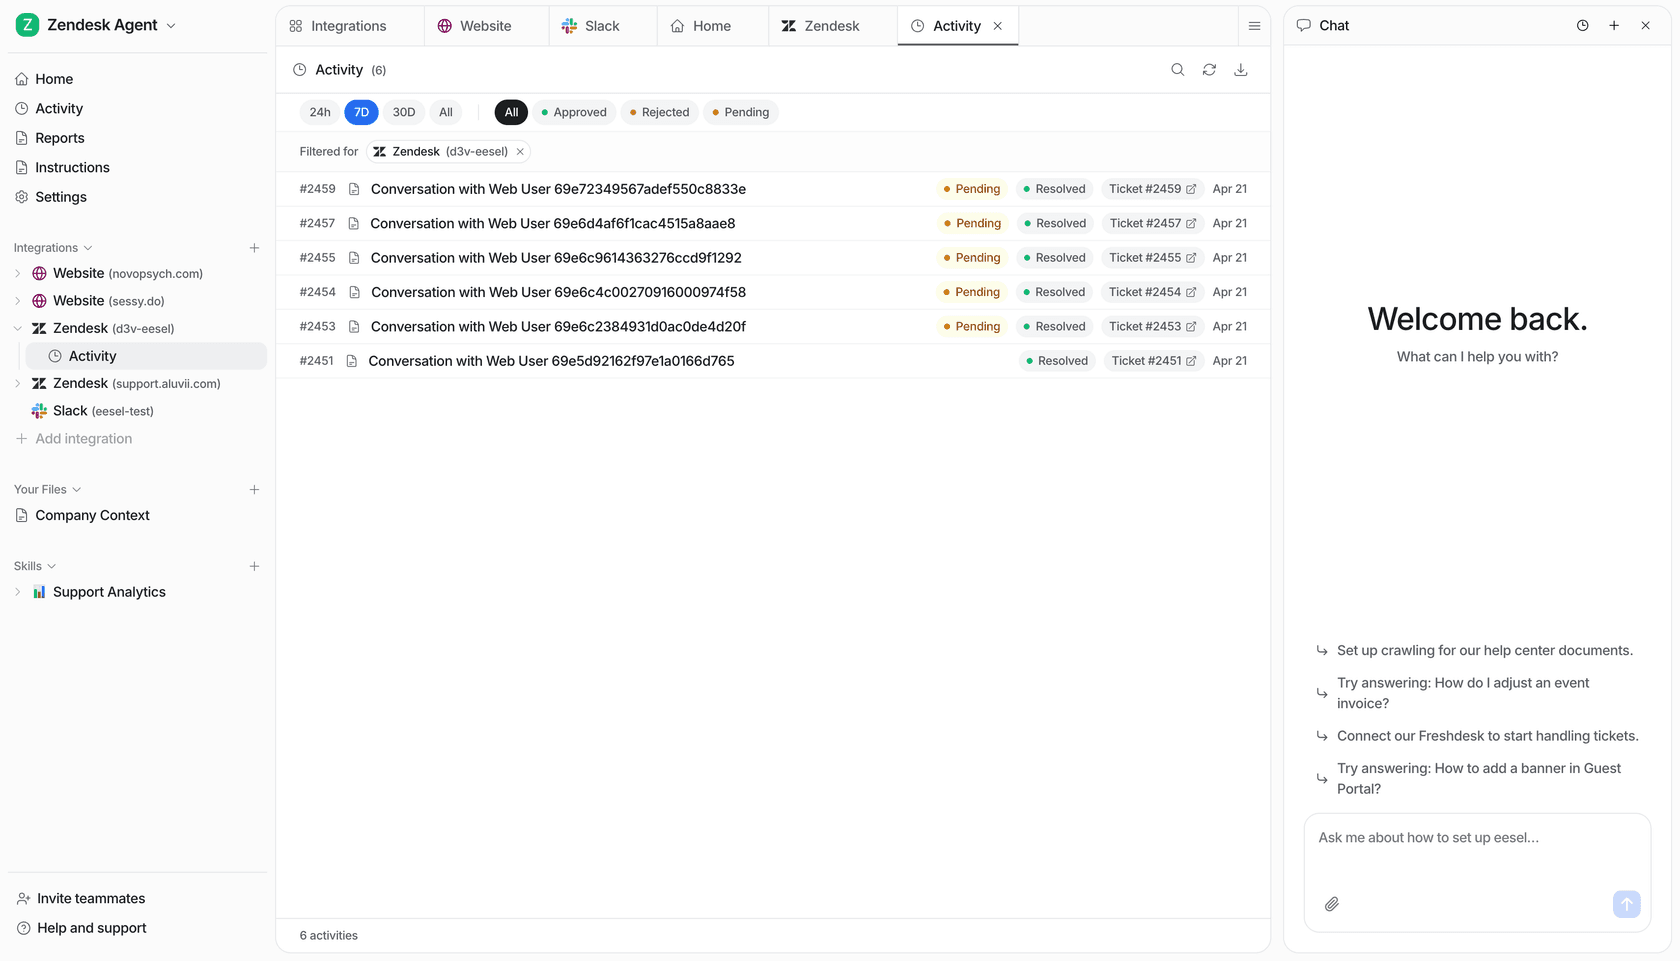
Si vous hésitez entre Jev ou l'une de ses alternatives parce que vous voulez des décisions de support plus rapides et plus fiables, le chemin le plus court est d'essayer la couche qui transforme déjà ces décisions en tickets résolus, de la même façon qu'un copilote IA rédige aux côtés de vos agents. Essayez eesel gratuitement, ou réservez une démo et regardez-le fonctionner sur vos propres tickets.
Questions fréquentes
Questions fréquentes
Quelles sont les meilleures alternatives à TypeSafe Jev ?
Les alternatives les plus proches de TypeSafe Jev sont des fonctionnalités de sortie structurée managées comme OpenAI Structured Outputs et Gemini structured output, des bibliothèques open source comme BAML, Instructor et Outlines, et un classificateur entraîné via Hugging Face AutoTrain. Si vous voulez à la fois la décision et l'action sur un helpdesk, un agent IA pour le service client est la couche au-dessus de tous ces outils.
Existe-t-il une alternative gratuite à TypeSafe Jev ?
Oui. Instructor (MIT) et Outlines (Apache-2.0) sont des bibliothèques open source gratuites, et les sorties structurées sur OpenAI et Gemini sont une fonctionnalité gratuite en plus de la tarification normale par token. Vous payez tout de même le modèle qui tourne en dessous, donc « gratuit » désigne la couche de schéma, pas l'inférence.
Quelle est la différence entre Jev et OpenAI Structured Outputs ?
Jev est un modèle System One conçu sur mesure qui saute la génération de texte et renvoie une décision typée plus un score de confiance calibré en une seule passe parallèle. OpenAI Structured Outputs est une contrainte posée sur un modèle génératif classique, donc vous payez toujours la latence et le coût de génération, mais vous obtenez le raisonnement complet d'un LLM de pointe. Jev échange ce raisonnement contre de la vitesse.
Combien coûtent les alternatives à TypeSafe Jev ?
Cela dépend du type. Les bibliothèques open source sont gratuites et vous ne payez que le tarif par token du modèle sous-jacent. Les fonctionnalités managées comme Gemini structured output coûtent le tarif normal des tokens Gemini (Flash-Lite est le palier le moins cher). Un classificateur entraîné sur Hugging Face coûte du temps de calcul. À titre de comparaison, Jev lui-même affiche $0,042 par million de tokens en entrée, avec une sortie gratuite.
Ces alternatives peuvent-elles faire tourner le support client comme Jev ?
Aucune d'entre elles ne fait tourner le support toute seule, et Jev non plus. Elles renvoient toutes une décision sur laquelle votre propre code doit agir. Pour transformer « ce ticket est urgent, à router vers la facturation » en un ticket résolu, il vous faut une couche qui lit aussi votre classification des tickets, rédige la réponse et effectue l'action. C'est le travail d'un agent IA pour helpdesk, pas d'une primitive de décision.
Toutes les alternatives à TypeSafe Jev donnent-elles des scores de confiance ?
Pas de la même façon. Jev est entraîné avec le RLCD (Reinforcement Learning for Calibrated Decisions) afin que ses probabilités reflètent la précision réelle. Les options basées sur des LLM exposent des logits de tokens que vous pouvez lire comme une confiance approximative, et un classificateur entraîné vous donne une probabilité softmax. Le vrai test pour n'importe laquelle d'entre elles est la calibration sur vos propres données, pas le chiffre en lui-même.
Quelle alternative à TypeSafe Jev est la meilleure pour la classification ?
Pour une classification étroite et à fort volume, un classificateur Hugging Face affiné est le moins cher à l'appel, tandis que Gemini structured output sur Flash-Lite est le plus rapide à mettre en place. Pour un travail spécifique au support comme le triage et le routage, un workflow de service client avec IA qui relie déjà la classification à des actions vous évite le code de liaison.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.