Les 8 meilleures alternatives à Gemini 3.8 Flash en 2026

Rama Adi Nugraha

Katelin Teen
Dernière modification September 8, 2026
Pourquoi seulement regarder au-delà de Gemini 3.8 Flash ?
Gemini 3.8 Flash est un bon modèle. Il se classe #3 sur 196 en vitesse de sortie à 302 tokens/seconde et obtient 59 points à l'Intelligence Index d'Artificial Analysis, bien au-dessus de la médiane. Pour un job en lot nocturne qui écoule un gros arriéré, il est difficile de le battre au prix.
Le piège, c'est ce que ce « travail plus dur » vous coûte. La propre note de lancement de Google est inhabituellement franche à ce sujet :
« Ces gains de performance découlent d'un choix de conception fondamental : 3.8 Flash travaille plus dur. Sur les tâches complexes, il fait preuve d'une plus grande diligence, exécute des étapes de raisonnement supplémentaires et appelle des outils de manière itérative. Parfois, le modèle peut utiliser plus de tokens pour maximiser les performances, en particulier à des niveaux d'effort plus élevés. »
Puis vient la phrase qui devrait décider de votre mise à niveau : Google recommande aux développeurs soucieux de l'efficacité de calcul de « continuer à s'appuyer sur Gemini 3.7 Flash, qui reste entièrement pris en charge pour les charges de travail axées sur l'efficacité. » Un fournisseur qui vous dit que son modèle précédent est toujours le bon choix est suffisamment rare pour être pris au sérieux.
Deux chiffres transforment cela en une véritable raison de chercher ailleurs. Premièrement, Artificial Analysis mesure 13,3 secondes jusqu'au premier token contre une médiane de catégorie d'environ 3 secondes. Le débit n'est pas la même chose que la réactivité, et 13 secondes de silence mort sont un facteur décisif pour un widget de chat ou une réponse de support. Deuxièmement, il consomme 120M de tokens de sortie pour terminer l'AA Index contre une médiane de 71M, ce que AA elle-même signale comme « très verbeux ». Une sortie plus prolixe signifie une facture plus élevée sur exactement le tarif de sortie qui double en janvier 2027.
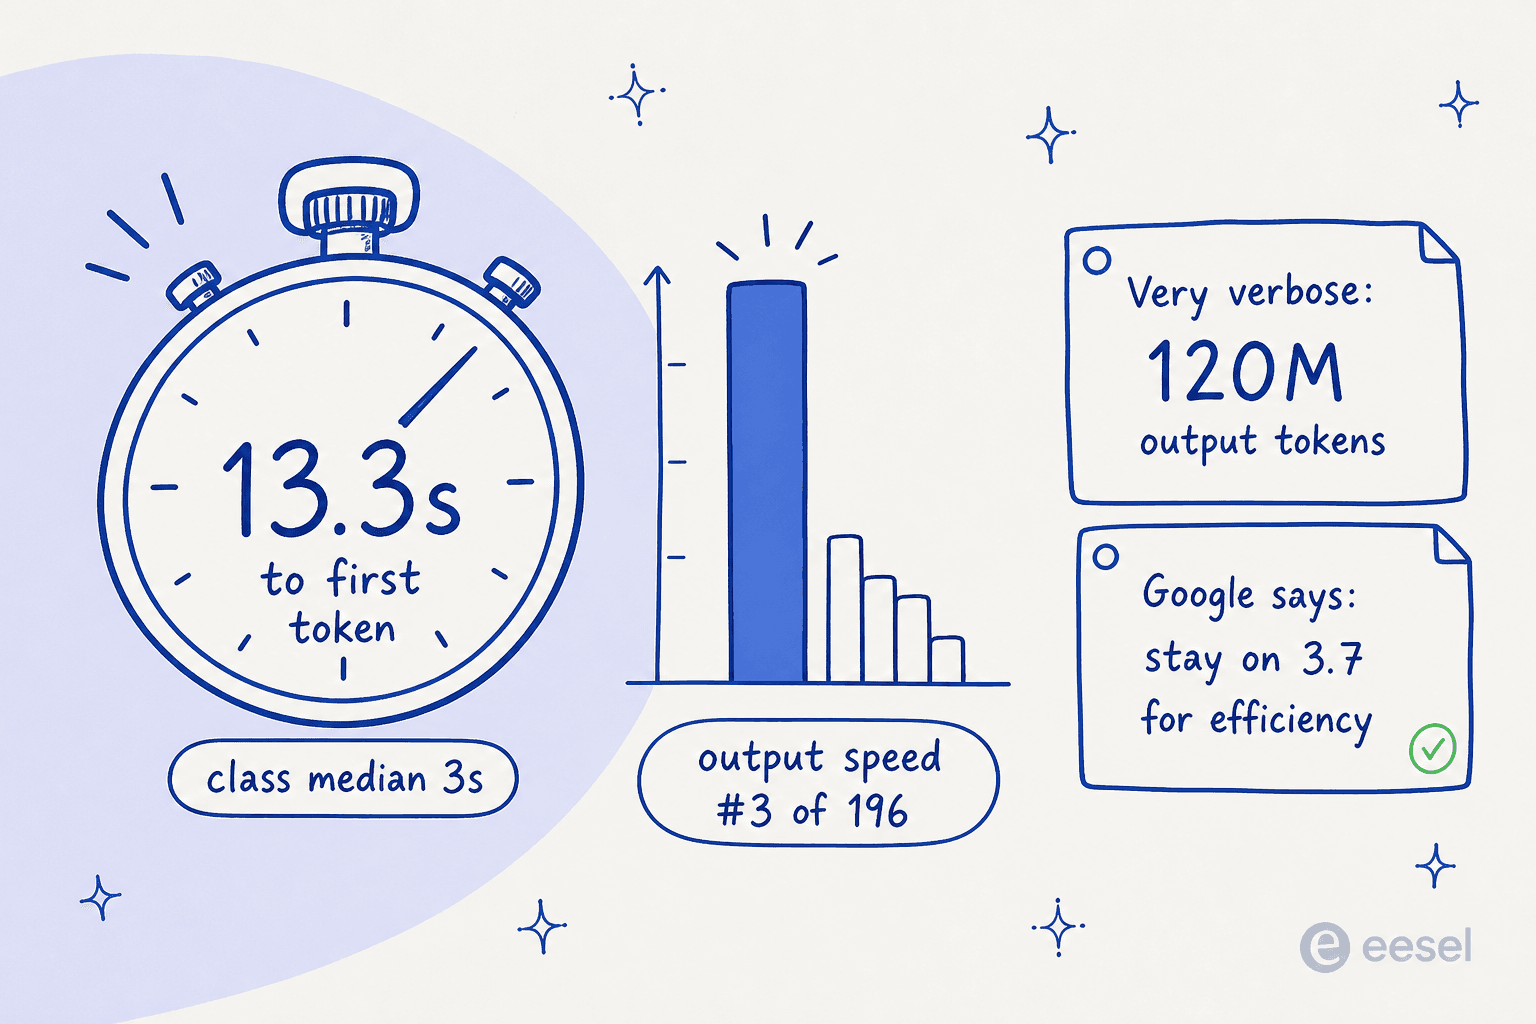
Ce n'est donc pas que « 3.8 Flash est mauvais ». C'est que « rapide et bon marché » cache un mur de latence et une taxe de gonflement de tokens, et pour beaucoup de charges de travail, un autre modèle, parfois l'ancien modèle de Google lui-même, est le meilleur compromis.
Comment j'ai choisi ces alternatives
J'ai limité la liste aux modèles qui font réellement le même travail que Flash : des chevaux de labeur rapides, abordables et à haut volume vers lesquels vous vous tourneriez pour faire tourner un agent, un classificateur ou un assistant de code, pas des modèles phares à 30 $ par million. Pour chacun, j'ai pesé quatre choses :
- Le coût réel par tâche, pas seulement le tarif affiché. Un modèle qui coûte moitié moins par token mais qui est deux fois plus prolixe n'est pas moins cher. La verbosité, c'est là que beaucoup de modèles « économiques » récupèrent discrètement l'argent.
- Une latence supportable. Le temps jusqu'au premier token compte plus que le débit maximal dès qu'un humain est à l'autre bout.
- Ouvert vs fermé. Plusieurs d'entre eux proposent des poids ouverts que vous pouvez auto-héberger, ce qui change complètement le calcul de résidence des données et de coûts.
- Ce que rapportent les vrais utilisateurs, tiré des fils Hacker News et Reddit, pas des posts de benchmark du jour de lancement.
Les prix ci-dessous sont par 1M de tokens, palier standard, tels que listés sur la page de tarification de chaque fournisseur. Les tokens de raisonnement et de réflexion sont facturés au tarif de sortie sur tous les modèles ici, donc la colonne de sortie est généralement celle qui décide de votre facture.
Alternatives à Gemini 3.8 Flash en un coup d'œil
| Modèle | Idéal pour | Entrée / Sortie ($/1M) | Poids ouverts | Contexte | Le principal piège |
|---|---|---|---|---|---|
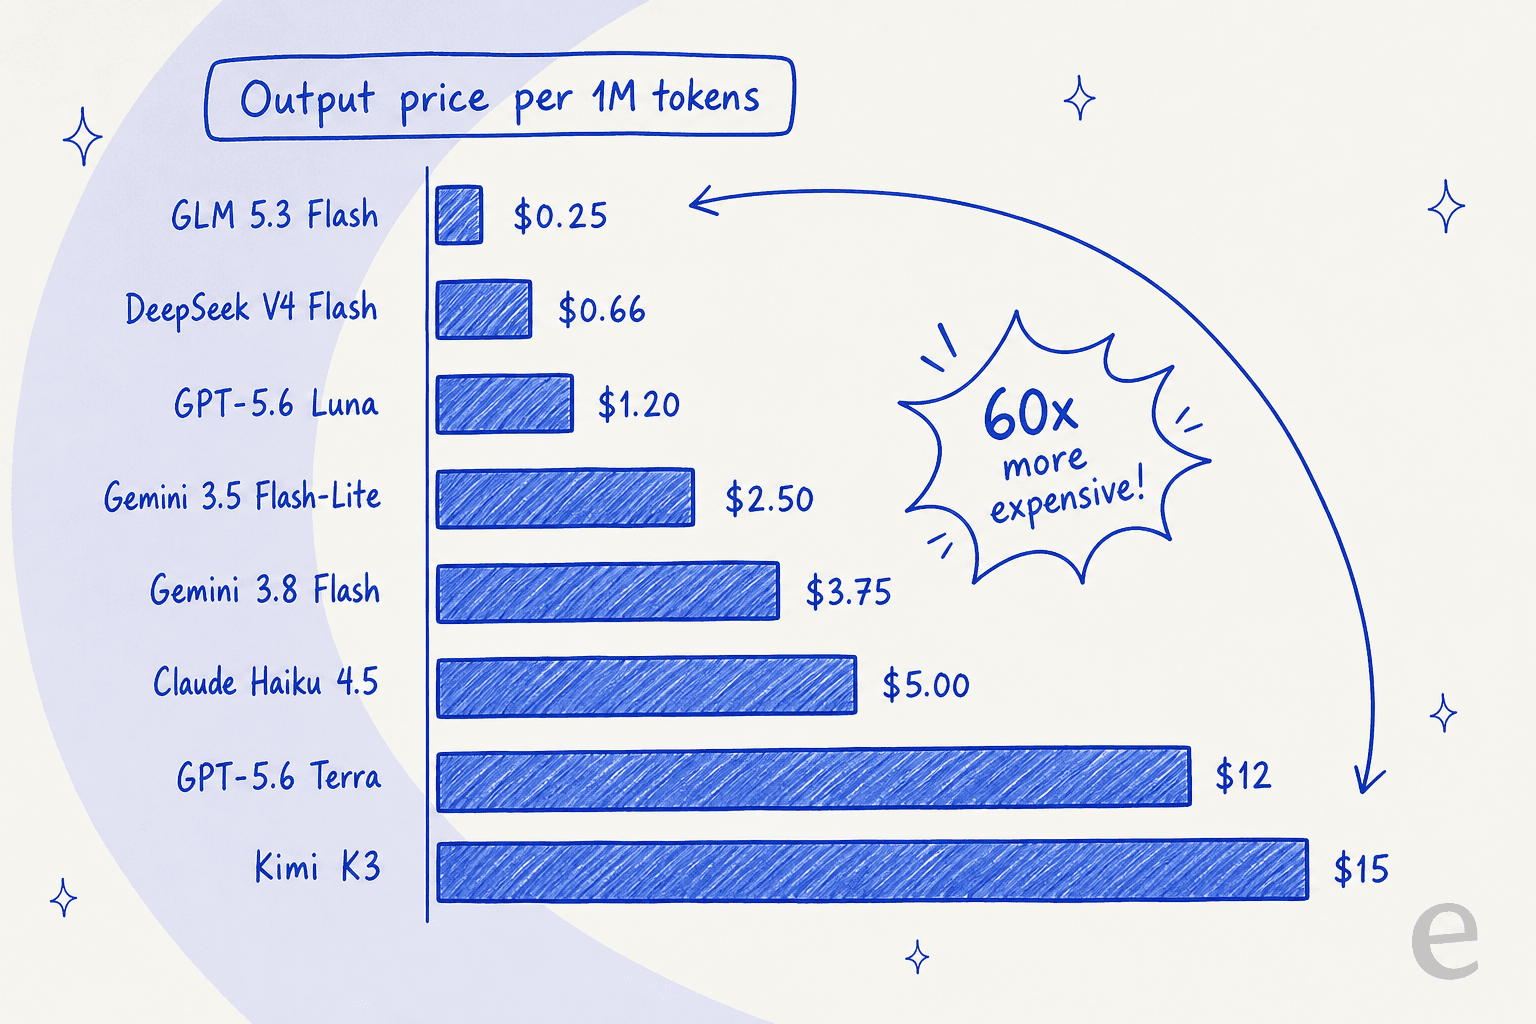
| Gemini 3.7 Flash | Axé efficacité, même prix | $0.75 / $3.75 | Non | 1M | Double en jan. 2027 ; a abandonné minimal |
| OpenAI GPT-5.6 (Terra) | Alternative frontière plus sobre | $2.00 / $12.00 | Non | 400K | Le palier contexte long coûte 2x |
| DeepSeek V4 Flash | Coût réel le plus bas | $0.22 / $0.66 (heures creuses) | Oui (MIT) | 1M | Surcoût aux heures de pointe ; hallucine ; texte seul |
| Kimi K3 | Raisonnement à poids ouverts | $3.00 / $15.00 | Oui | 1M | Cher par token ; ne peut pas arrêter de réfléchir |
| Qwen 3.8 Flash-Next | Contexte long, aperçu ouvert | ~$0.03-$0.20 en entrée / $0.13-$0.80 en sortie | Oui | 1M | Aperçu sous-entraîné ; fournisseur unique |
| Claude Haiku 4.5 | Fiabilité + sécurité | $1.00 / $5.00 | Non | 200K | Plus cher que le pack économique |
| GLM 5.3 Flash | Multimodal le moins cher | $0.075 / $0.25 (promo) | Oui | 200K | La promo se termine ; écosystème plus restreint |
| Gemini 3.5 Flash-Lite | OCR / classification à haut volume | $0.30 / $2.50 | Non | 1M | Plus faible sur le raisonnement difficile |
L'écart sur la colonne de sortie résume toute l'histoire : de 0,25 $ à 15 $ par million, un écart de 60x pour des modèles qui se situent tous à peu près dans la même catégorie « rapide et bon marché ».
1. Gemini 3.7 Flash
Idéal pour : les équipes qui veulent tout ce dans quoi Flash excelle, moins la dépense de tokens supplémentaire, au même prix.
L'alternative la plus honnête à Gemini 3.8 Flash est le modèle sur lequel il a été construit, et c'est Google lui-même qui vous le dit. Comme 3.8 est simplement 3.7 Flash entraîné plus loin, ils sont facturés de manière identique, et la seule vraie différence est que 3.8 fait plus de travail (et consomme plus de tokens) par tâche. Si vous ne cherchez pas les derniers points sur un benchmark de raisonnement difficile, 3.7 Flash vous donne la même vitesse pour une facture plus petite.
Les développeurs qui l'utilisent comme auditeur bon marché et infatigable le notent très bien :
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus."

Avantages : prix identique à 3.8 Flash, moins de gonflement de tokens, une fenêtre de contexte complète de 1M de tokens, et la même large entrée multimodale (texte, image, audio, vidéo, PDF).
Inconvénients : le tarif d'introduction double à 1,50 $/7,50 $ le 1er janvier 2027, comme pour 3.8. Et 3.7 a abandonné le niveau de réflexion minimal, donc le plancher le moins cher pour l'OCR et la classification de tickets a disparu ; low est maintenant le nouveau plancher.
Tarifs : 0,75 $ en entrée / 3,75 $ en sortie par 1M jusqu'à la fin de 2026.
Verdict : si vous vous tournez déjà vers 3.8 Flash, testez d'abord 3.7 Flash sur vos propres prompts. Neuf fois sur dix, il fait le travail pour moins cher, et c'est exactement pourquoi Google continue de le recommander.
2. OpenAI GPT-5.6
Idéal pour : les équipes qui veulent un modèle frontière non-Google qui arrive à la réponse avec moins de tokens.
GPT-5.6 existe en trois variantes, et le palier qui rivalise réellement avec Flash est Terra, pas le moins cher Luna. La raison de le considérer face à Gemini est l'efficacité : les modèles GPT ont tendance à arriver à la même réponse avec beaucoup moins de sortie, ce qui compense un tarif affiché plus élevé sur tout travail intensif en sortie. Un développeur a résumé le compromis simplement :
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens."
C'est toute la décision GPT contre Gemini Flash en une phrase. Les tokens/seconde bruts favorisent Gemini ; les tokens par tâche terminée favorisent souvent OpenAI. Si votre facture est dominée par la sortie, faites le calcul pour les deux. Pour le détail complet des paliers, notre liste des modèles OpenAI les décompose.
Avantages : un vrai raisonnement frontière, un immense écosystème d'outils, et moins de verbosité que Gemini Flash sur des tâches comparables. Luna (0,20 $/1,20 $) est un vrai plancher économique si vous voulez descendre en gamme.
Inconvénients : OpenAI facture un palier contexte long qui double le tarif au-delà de la fenêtre de contexte court, la même falaise type 200K qu'utilise xAI. Gemini et Anthropic ne le font pas. Surveillez aussi vos limites de débit si vous opérez à haut volume.
Tarifs : Terra 2,00 $ en entrée / 12,00 $ en sortie ; Luna 0,20 $ / 1,20 $ ; Sol 5,00 $ / 30,00 $ par 1M (contexte court).
Verdict : l'alternative généraliste la plus solide si vous n'êtes pas lié à Google, en particulier quand votre charge de travail est intensive en sortie et que le nombre de tokens, pas le prix par token, est ce qui vous coûte cher.
3. DeepSeek V4 Flash
Idéal pour : le coût réel par token le plus bas de tous les modèles hébergés ici, et pour quiconque veut des poids ouverts.
DeepSeek V4 Flash est le disrupteur de prix. Un modèle de mélange d'experts avec 284B au total / 13B actifs et des poids sous licence MIT (~167 Go, fonctionne à la maison pour moins de 10 000 $), il est affiché à 0,22 $ en entrée / 0,66 $ en sortie en heures creuses, une fraction de Gemini Flash. Et il tient la route sur du vrai travail, pas seulement sur le coût :
"I benched DS4 flash and Pro vs opus 4.8 xhigh on 16 work-related tasks a month ago across 4 days. Opus 4.8 came out as a winner by 1 task only [...] But flash performed as well or better (as in being more thorough) in 13 out if 16."
Il y a deux véritables pièges. DeepSeek a revu ses prix en août 2026 et applique désormais un surcoût heures de pointe/heures creuses, avec des heures de pointe de 01h00-04h00 et 06h00-10h00 UTC, donc une file américaine ou européenne facture surtout en heures creuses, mais un job en lot programmé pendant les heures ouvrées chinoises paie le double. Et il hallucine plus que vous ne le souhaiteriez :
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
Encore une chose à savoir : Flash est uniquement textuel, sans entrée image documentée, donc si votre charge de travail implique des captures d'écran, cela règle la question. Et côté données, les conditions de l'API payante de DeepSeek sont silencieuses sur l'usage pour l'entraînement plutôt que protectrices, et les données résident en RPC sous le droit chinois, donc ce n'est pas un remplacement direct pour des données clients réglementées.
Avantages : le coût réel par token le plus bas ici, des poids ouverts MIT, un solide profil d'utilisation d'outils, et un texte de raisonnement entièrement visible que vous pouvez piloter.
Inconvénients : le surcoût aux heures de pointe, un vrai taux d'hallucination, aucune entrée image, et une résidence des données en RPC.
Tarifs : 0,22 $ en entrée / 0,66 $ en sortie par 1M en heures creuses (le double aux heures de pointe). Le palier Pro coûte plus.
Verdict : le meilleur pari coût pur de cette liste, et plus solide que ce que « bon marché veut dire faible » suggérerait. Associez-le à de la recherche documentaire (retrieval) et à des tests intensifs pour garder les hallucinations sous contrôle, comme vous le feriez avec n'importe quelle configuration basée sur le RAG.
4. Kimi K3
Idéal pour : un raisonnement à poids ouverts qui rivalise avec les modèles phares, si vous pouvez absorber le coût par token.
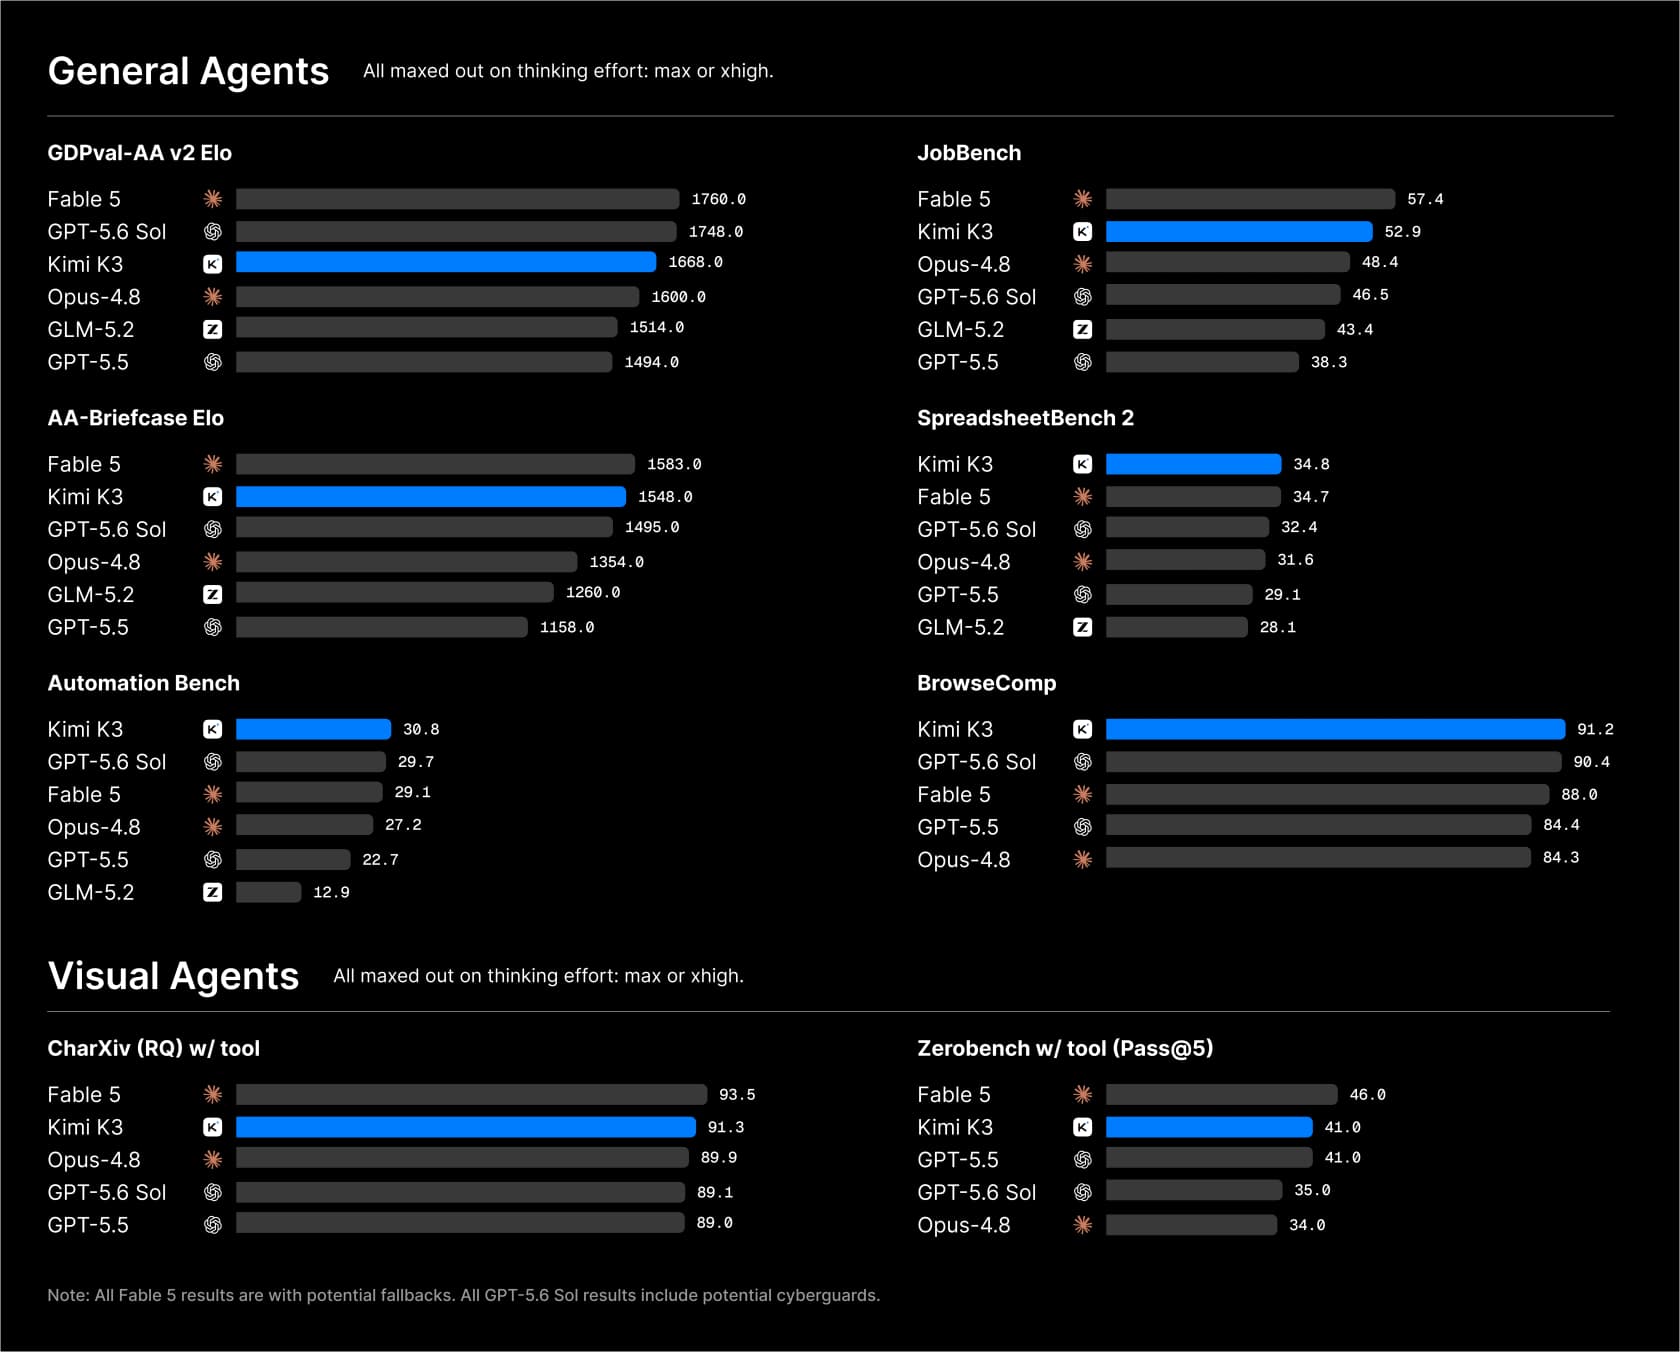
Kimi K3 de Moonshot AI est le poids lourd du raisonnement dans le monde des poids ouverts : 2,8T au total / 104B paramètres actifs, un contexte de 1M de tokens, une vision native, et des poids ouverts livrés à temps. Sur Artificial Analysis, il atteint un Intelligence Index de 57, un territoire de top 5, et il domine clairement plusieurs benchmarks d'agents comme BrowseComp.
Le problème, c'est le prix et la réflexion. À 3 $ en entrée / 15 $ en sortie, il se situe dans la fourchette de Claude Sonnet, environ 50x le tarif de sortie de DeepSeek Flash, et il ne peut pas arrêter de raisonner. Il existe un réglage low, mais c'est un contrôle de latence, pas un palier de coût, et il obtient un moins bon score que DeepSeek Flash tout en coûtant 8x plus. Les utilisateurs ressentent la lenteur :
"Faster iterations are way better for me, I hate waiting for 5-10 minutes on small changes. I tried to use recent versions of Kimi and GLM, but they use too much thinking for no reason and are pretty slow because of it."
Avantages : un raisonnement de niveau modèle phare, une entrée native image et vidéo, une fenêtre de 1M de tokens, et des poids ouverts avec des quants communautaires déjà disponibles.
Inconvénients : cher par token, aucune façon de désactiver le raisonnement, et plus lent qu'on ne l'attendrait d'un concurrent « Flash » (ce n'en est pas un ; c'est un modèle frontière). Les URLs d'images publiques ne sont pas non plus acceptées, seulement le base64 ou un identifiant de fichier téléversé.
Tarifs : 3,00 $ en entrée / 15,00 $ en sortie par 1M (0,30 $ en entrée avec cache-hit).
Verdict : le choix quand vous avez besoin d'un vrai raisonnement et voulez la possibilité d'auto-héberger, pas quand vous avez besoin de bon marché et rapide. Si votre référence est « aussi bon qu'un modèle phare mais je possède les poids », K3 la franchit ; si votre référence est « remplacer Flash sur le coût », il n'y arrive pas. Analyse complète dans notre avis sur Kimi K3.
5. Qwen 3.8 Flash-Next
Idéal pour : les charges de travail à contexte long et à cache élevé où le débit à grande échelle compte, en poids ouverts.
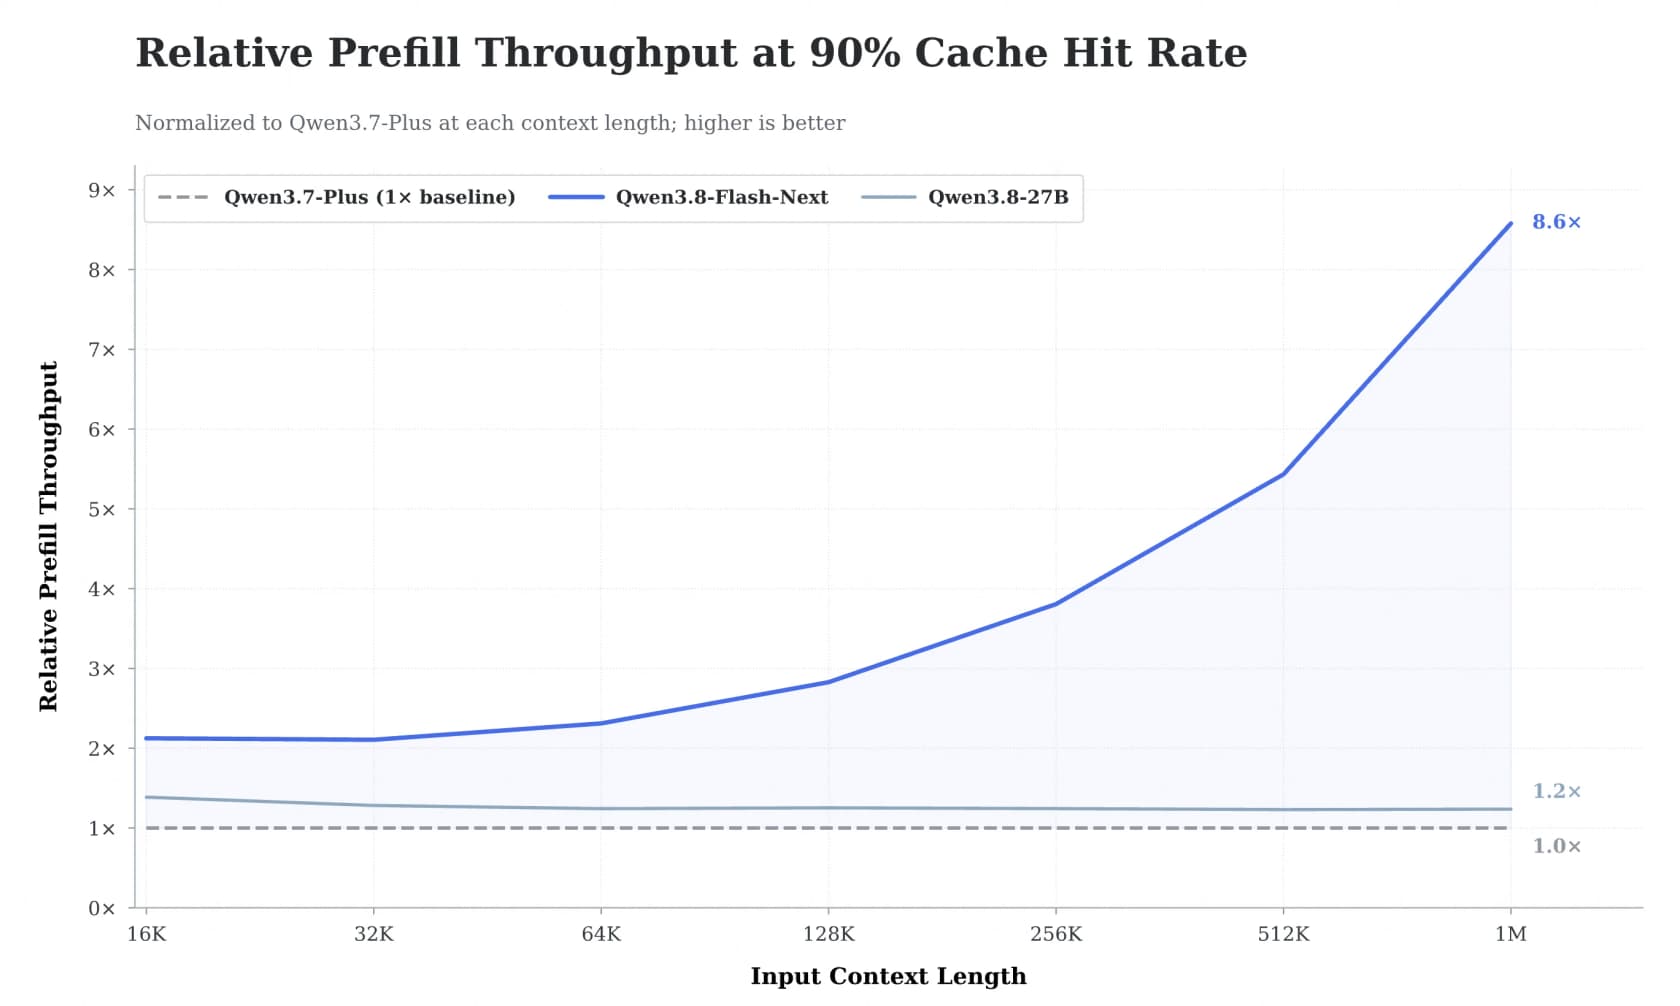
Le Qwen 3.8 Flash-Next d'Alibaba est la curiosité la plus intéressante ici. C'est un aperçu de la prochaine architecture de Qwen, et son tour de force est le débit de préremplissage : avec Qwen Sparse Attention, il atteint 8,6x le débit de Qwen3.7-Plus à un contexte de 1M de tokens. Pour une charge de travail lourde à contexte long avec un taux de succès de cache élevé, cette mise à l'échelle est réelle et difficile à égaler. Il propose des poids ouverts et facture par paliers, d'environ 0,03 $/0,13 $ par 1M sur les prompts courts jusqu'à 0,20 $/0,80 $ sur les plus longs.
Le piège, c'est ce que signifie « aperçu ». Il est délibérément inachevé :
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."
En plus de cela, Simon Willison l'a testé et a fini par préférer un modèle dense plus petit, attribuant cela à la quantification bas-bit nécessaire pour le faire tenir, et l'API hébergée n'a actuellement qu'un seul fournisseur, donc il n'y a pas de basculement (failover). Artificial Analysis le signale aussi comme « très verbeux », 200M de tokens de sortie pour terminer son Index contre une médiane de 110M.
Avantages : un débit exceptionnel en contexte long, des poids ouverts, très bon marché sur les prompts courts, et un aperçu de la direction que prend Qwen. Notre guide des tarifs Qwen contient le tableau complet des paliers.
Inconvénients : délibérément sous-entraîné, une baisse de qualité due à la quantification, un hébergement à fournisseur unique, et une sortie verbeuse qui gonfle la facture.
Tarifs : par paliers, environ 0,03 $-0,20 $ en entrée / 0,13 $-0,80 $ en sortie par 1M selon la taille du prompt.
Verdict : un aperçu de niveau recherche, pas un choix par défaut pour la production. Tournez-vous vers lui si le débit en contexte long est votre goulot d'étranglement et que vous pouvez auto-héberger ; sinon, attendez la lignée Qwen4 finalisée. Plus d'options dans notre tour d'horizon des alternatives à Qwen.
6. Claude Haiku 4.5
Idéal pour : les équipes qui échangeront un prix légèrement plus élevé contre de la fiabilité et un bilan de sécurité plus propre.
Claude Haiku 4.5 est le modèle rapide et petit d'Anthropic, et c'est celui vers lequel je me tourne quand la priorité est un modèle qui se comporte de manière prévisible plutôt que le token absolument le moins cher. À 1 $ en entrée / 5 $ en sortie, il coûte plus que le pack économique, mais il vient avec la tarification fixe d'Anthropic (pas de surcoût contexte long), un solide profil de suivi des instructions, et la maturité d'outillage de l'écosystème Claude plus large.
Cela compte ici parce que deux métriques de sécurité ont réellement régressé sur Gemini 3.8 Flash : la sécurité multilingue et les refus injustifiés se sont tous deux déplacés dans la mauvaise direction par rapport à 3.7, et Google a noté que la sécurité non anglophone a « légèrement régressé ». Si vous servez un public multilingue ou réglementé, un modèle avec un bilan de sécurité plus stable vaut la prime.
Avantages : une tarification fixe sans falaise de contexte, un suivi fiable des instructions, un écosystème mature, et une posture de sécurité solide. Bon choix pour quiconque construit déjà sur Claude.
Inconvénients : plus cher que DeepSeek Flash, GLM, ou la lignée Gemini Flash, des poids fermés, et une fenêtre de contexte plus petite de 200K par rapport aux modèles à 1M de tokens ici.
Tarifs : 1,00 $ en entrée / 5,00 $ en sortie par 1M.
Verdict : le choix « la taxe de fiabilité en vaut la peine ». Si vous avez déjà été échaudé par un modèle bon marché qui hallucine devant des clients, Haiku 4.5 rachète beaucoup de tranquillité d'esprit. Voyez comment il se compare dans notre guide des alternatives à Claude.
7. GLM 5.3 Flash
Idéal pour : le modèle multimodal véritable le moins cher ici.
Le GLM 5.3 Flash de Z.ai est le premier modèle multimodal natif de la série GLM-5, et pendant sa promotion de lancement, c'est le modèle payant le moins cher ici : 0,075 $ en entrée / 0,25 $ en sortie par 1M (tarif liste 0,15 $/0,50 $). Il propose des poids ouverts et, contrairement à DeepSeek Flash, accepte réellement les images. Les premiers testeurs évaluent très favorablement le rapport qualité-prix :
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Il existe aussi un GLM Coding Plan (18 $/80 $/168 $ par mois) qui fonctionne dans Claude Code, Cursor, Cline et plus de 20 autres outils d'agents, ce qui en fait un backend de code très bon marché si vous vivez dans un IDE.
Avantages : une qualité de niveau production à un prix plancher, une entrée multimodale native, des poids ouverts, et un abonnement dédié au code. Les paliers gratuits GLM-4.7-Flash et 4.5-Flash sont une bonne rampe d'entrée.
Inconvénients : la remise de lancement de 50 % prend fin, après quoi le tarif double à 0,15 $/0,50 $ (toujours bon marché). L'écosystème est plus restreint que celui d'OpenAI ou de Google, et le modèle de raisonnement phare GLM-5.3 est un SKU séparé et plus cher.
Tarifs : 0,075 $ en entrée / 0,25 $ en sortie par 1M en promo ; 0,15 $/0,50 $ au tarif liste.
Verdict : le champion de la valeur pour le travail multimodal. Si la limite texte seul de DeepSeek Flash l'exclut pour vous, GLM 5.3 Flash est la manière la moins chère de garder une entrée image sans payer les tarifs de Gemini Flash.
8. Gemini 3.5 Flash-Lite
Idéal pour : la classification à haut volume, l'étiquetage, et l'OCR où le Flash complet est surdimensionné.
Parfois, la bonne alternative à Gemini 3.8 Flash est un Gemini plus petit. Gemini 3.5 Flash-Lite est le modèle économique et à haut débit de Google : 0,30 $ en entrée / 2,50 $ en sortie, un contexte de 1M de tokens, et une entrée multimodale. C'est la réponse quand vous faites beaucoup de travail bon marché et bien délimité, extraire des champs, étiqueter des tickets, exécuter de l'OCR, où vous n'avez pas besoin d'un raisonneur poids lourd dépensant 120M de tokens pour y réfléchir.
C'est aussi le modèle qui a conservé le plancher économique que 3.7 et 3.8 Flash ont abandonné. Flash-Lite prend toujours en charge les réglages de réflexion ultra-bas qui font fonctionner l'économie de la classification, exactement la charge de travail devenue plus coûteuse quand les modèles Flash plus récents ont abandonné minimal.
Avantages : moins cher que le Flash complet, un immense contexte de 1M de tokens, un débit solide (~490 tokens/seconde), une entrée multimodale, et il reste dans l'écosystème Google/Vertex que vous utilisez peut-être déjà.
Inconvénients : plus faible sur le raisonnement difficile et les tâches agentiques que les modèles Flash complets, aucune utilisation d'ordinateur, et le même schéma de tarification introductive-puis-plus-élevée sur toute la lignée Gemini 3.x.
Tarifs : 0,30 $ en entrée / 2,50 $ en sortie par 1M (standard).
Verdict : la bonne rétrogradation, pas un compromis. Pour les travaux à haut volume et faible complexité, Flash-Lite fait le travail pour un tiers du prix et vous garde sur l'infrastructure Google.
Le niveau où vous achetez réellement
Voici ce à quoi je reviens toujours, parce que je construis cela pour gagner ma vie. Si vous choisissez un modèle rapide et bon marché pour faire tourner un agent de support client, comparer Flash à DeepSeek à GLM est la mauvaise question. Le modèle est le moteur. Ce n'est pas la voiture.
Une API de modèle brut vous donne un point d'accès texte-entrant, texte-sortant. Pour transformer cela en quelque chose qui résout des tickets, vous devez encore intégrer votre base de connaissances, construire de la recherche documentaire (retrieval) pour qu'il arrête d'halluciner, écrire des règles d'escalade, le tester sur des cas réels avant qu'il ne touche un client, et le surveiller et le réentraîner pour toujours. Ce sont des semaines d'ingénierie, et vous en êtes propriétaire, y compris l'échange du modèle toutes les six semaines quand le prochain Flash sort.
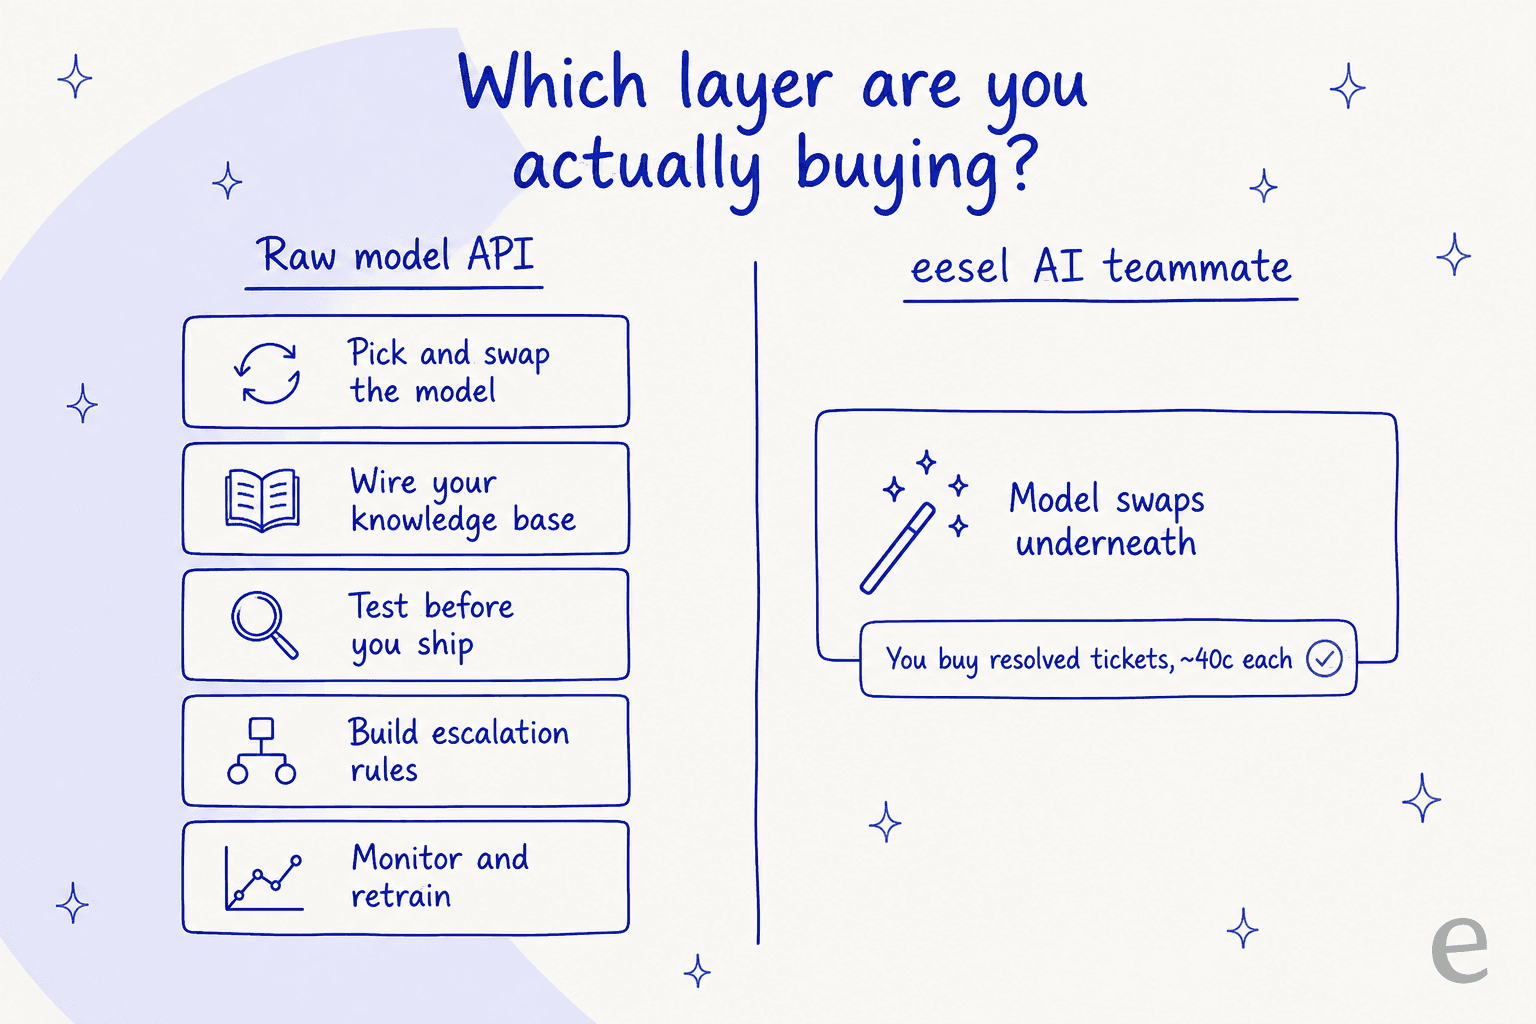
Voici la distinction qui mérite d'être retenue : un modèle est une infrastructure ; un coéquipier est l'employé. Si votre objectif est un assistant de code IA qui fonctionne ou un pipeline de recherche, alors oui, choisissez le meilleur modèle et construisez. Mais si votre objectif est de « bien répondre aux tickets de support », la voie la plus rapide et la moins chère est d'acheter le coéquipier fini et de laisser quelqu'un d'autre s'obséder sur quel Flash gagne ce mois-ci.
Essayez eesel pour le support client
Si vous êtes arrivé ici parce que vous voulez un modèle rapide et bon marché pour gérer le support, eesel est la couche au-dessus du modèle qui fait réellement le travail. C'est une plateforme de coéquipiers IA, et le coéquipier prêt à l'emploi pour cela est l'agent de helpdesk IA : il rejoint votre file existante, s'entraîne sur vos tickets passés et votre base de connaissances, et commence à résoudre des conversations, sans bricolage de modèle nécessaire.
Deux choses en font une solution adaptée exactement à ce problème. D'abord, il est agnostique au modèle par conception, donc la question « Gemini 3.8 Flash ou DeepSeek Flash est-il meilleur ? » devient le problème d'eesel, pas le vôtre ; nous choisissons et échangeons le modèle sous-jacent au fur et à mesure qu'ils s'améliorent. Deuxièmement, et c'est la cicatrice que chacun de ces modèles rapides vous enseigne, eesel simule chaque déploiement sur vos tickets historiques avant sa mise en ligne, donc vous voyez le vrai taux de résolution et repérez les réponses sûres-mais-fausses avant qu'un client ne le fasse. Vous préférez le piloter depuis un terminal ou un script ? Il existe un CLI eesel complet pour que les agents de code et les pipelines CI puissent opérer le même coéquipier. La facturation est basée sur l'usage, environ 40 centimes par ticket résolu, donc vous payez pour des résultats, pas pour des tokens. C'est gratuit à essayer.
Questions fréquentes
Quelle est la meilleure alternative à Gemini 3.8 Flash pour un coût réduit ?
Gemini 3.7 Flash est-il une bonne alternative à Gemini 3.8 Flash ?
Combien coûte Gemini 3.8 Flash par rapport aux alternatives ?
Quelle alternative à Gemini 3.8 Flash est la meilleure pour le support client ?
Existe-t-il des alternatives à poids ouverts à Gemini 3.8 Flash ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.