

Les tarifs réels de TypeSafe Jev
Voici chaque chiffre publié, réuni en un seul endroit. TypeSafe n'a pas de page tarifs dédiée, et chaque variante d'URL que j'ai testée (typesafe.ai/pricing, docs.typesafe.ai/pricing, typesafe.ai/docs/pricing) renvoie une erreur 404. Les chiffres ci-dessous viennent directement de la page d'accueil et du billet de lancement.
| Poste | Jev | Notes |
|---|---|---|
| Tokens en entrée | 0,042 $ / MTok | 42 $ par milliard de tokens en entrée |
| Tokens en sortie | Gratuit | TypeSafe parle de "trop bon marché pour être facturé" |
| Argument de comparaison | Entrée 238 fois inférieure | Face au tarif d'entrée de Claude Fable 5.1 |
| Paliers tarifaires | Aucun publié | Pas de formules nommées ni de grille par palier |
| Palier gratuit | Non précisé | Accès via liste d'attente d'accès anticipé |
| Limites de débit | Non publiées | Une démo de lancement a tourné à ~10 requêtes/sec pour ~7 $/heure |
| Fenêtre de contexte | 32 000 tokens | Version du modèle jev-1.13.0 |
| Cloudflare | Facturé dans le tableau de bord | Identifiant de modèle typesafe/jev |
La comparaison illustrative de la page d'accueil place un seul appel Jev à 0,000081 $, contre 0,013880 $ pour un LLM effectuant le même type de travail. C'est le chiffre que TypeSafe veut vous voir capturer en capture d'écran, et pour un appel de décision pur, la comparaison est honnête.
Pourquoi la sortie gratuite compte
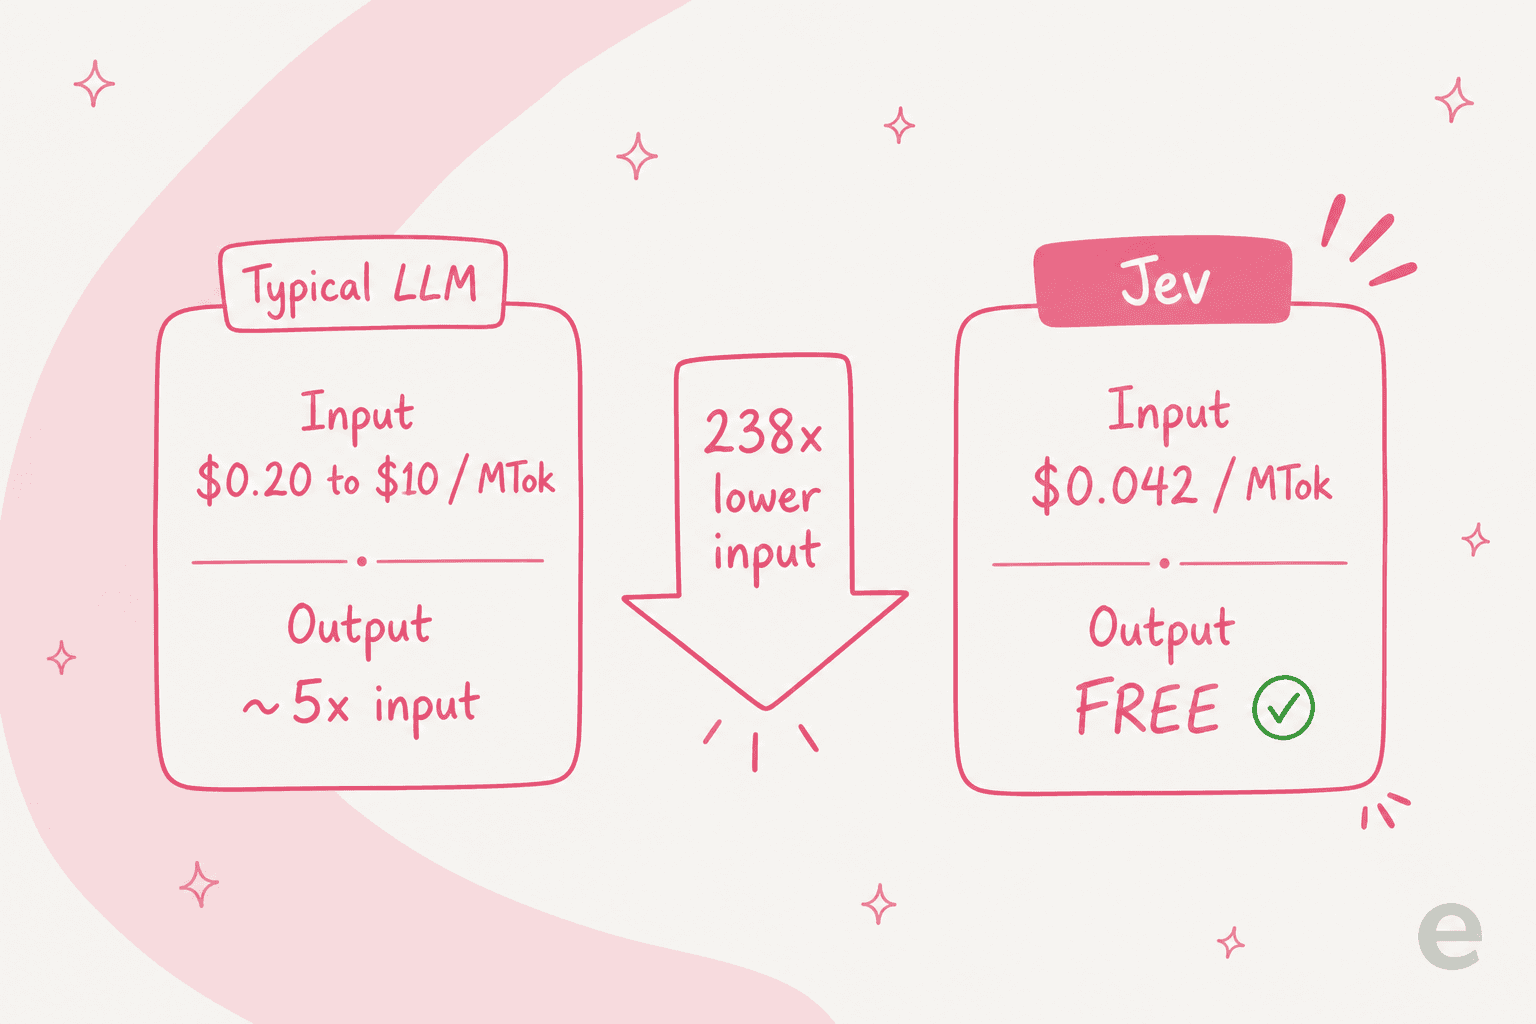
Dans la plupart des modèles de tarification des LLM, la sortie est la moitié la plus chère, souvent environ 5 fois le tarif d'entrée. C'est parce que la valeur d'un chatbot, c'est le paragraphe qu'il rédige, et les paragraphes représentent beaucoup de tokens. Jev inverse cela. Un modèle System One ne génère pas de prose, il renvoie une décision typée plus un score de confiance, donc la charge de sortie tient en une poignée d'octets. La tarifer à zéro ne coûte quasiment rien à TypeSafe et supprime la ligne la plus inquiétante de votre facture.
En pratique : si votre charge de travail est vraiment un flux de petites questions typées, "est_urgent", "quel service", "à quel point ce client est frustré", alors le compteur de Jev tourne presque entièrement sur l'état d'entrée que vous envoyez, et cet état est généralement petit. C'est exactement la forme du travail de triage de tickets que Cloudflare utilise lui-même comme exemple pour Jev, et ce n'est pas un hasard.
Modélisez votre propre facture
Les chiffres d'une page d'accueil sont une chose, votre volume mensuel réel en est une autre. Indiquez combien de décisions vous exécutez par mois et la taille moyenne d'entrée, et l'outil compare Jev à un LLM typique dans la fourchette même que TypeSafe cite. Les tarifs du LLM sont modifiables, parce que "typique" dépend du modèle que vous utilisez.
Une mise en garde sur la lecture de ce multiplicateur : c'est une comparaison de coût de tokens pour l'étape de décision seule. Ce n'est pas un chiffre de coût total de possession, car un flux de support réel fait plus que décider.
Ce que le prix ne couvre pas
C'est là qu'un article tarifaire prouve son utilité. Le tarif de 0,042 $ est réel et bas, mais il n'achète qu'une chose étroite. Voici ce qui reste hors du compteur :
- Génération. Jev ne peut pas rédiger la réponse. Il renvoie une décision, pas une phrase. Si votre flux de support a besoin d'une réponse rédigée, vous payez toujours un LLM pour cette moitié-là.
- Orchestration. Vous devez construire la boucle qui envoie l'état, lit la décision et agit dessus. Le coût en tokens est négligeable, l'ingénierie ne l'est pas.
- Actions. Décider "escalader ceci" est quasi gratuit. Vraiment escalader, étiqueter, rembourser ou router le ticket reste votre travail d'intégration.
- Un prix par siège ou par résolution prévisible. Il n'existe ni formule, ni palier de SLA, ni remise à l'engagement publiée. Pour une équipe qui doit projeter un budget face au coût humain, "un tarif d'entrée et une liste d'attente" est mince.
Rien de tout cela ne fait de Jev une mauvaise affaire. Cela en fait un composant. Le bon modèle mental, c'est que Jev tarife la brique de décision, et le reste de votre budget d'automatisation du service client vit ailleurs.
Est-ce subventionné ? TypeSafe répond : peut-être
Des tarifs d'IA bon marché soulèvent toujours la question "brûlent-ils de l'argent de VC", et TypeSafe y répond de front. Extrait du billet de lancement :
"We make our pricing transparent. We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
C'est plus honnête que la plupart des textes de lancement. La contre-preuve est technique : sur Hacker News, un commentateur a fait de la rétro-ingénierie sur le prix pour estimer la taille.
"At 0.042-per-million price they have, Astra estimates the model to be 3bn parameters."

Un modèle d'environ 3 milliards de paramètres coûte peu cher à servir, donc un prix bas et durable est plausible, pas fantaisiste. Le commentaire le mieux noté du fil a quand même contesté ce cadrage, en avançant que les comparaisons de vitesse et de coût flattent Jev parce qu'il saute entièrement la génération :
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference'... the speed comparison seems misleading?"
L'enthousiasme tarifaire sur X était réel lui aussi, et venait d'un opérateur identifié. Le PDG de Vercel a rapporté que Jev battait GPT Luna sur un correcteur de production :
"Jev is up to 18x faster (p95) and more accurate. It's coming to @vercel AI Gateway and likely new default."
En lisant tout cela ensemble, le verdict tarifaire est le suivant : le tarif est réel et bas, le "238 fois" est une comparaison optimiste sur un seul appel, et l'usage honnête concerne les décisions, pas tout le reste.
Ce que cela signifie pour une équipe de support
Si vous gérez un helpdesk, la question intéressante n'est pas "à quel point les tokens sont bon marché", c'est "combien coûte l'automatisation finie et que fait-elle". Un flux de déflexion de niveau 1 qui trie, rédige et résout a besoin de génération et d'actions en plus de la décision. Jev peut être le cerveau de triage rapide et bon marché à l'intérieur de ça, mais ce n'est pas l'agent IA lui-même.
C'est la distinction à laquelle je reviens sans cesse : Jev est de l'infrastructure, une brique de décision avec laquelle on construit. eesel est l'employé. Notre coéquipier IA pour helpdesk rejoint votre file existante, prend la décision de triage-routage-escalade et rédige la réponse et effectue l'action, puis simule l'ensemble sur vos tickets historiques avant sa mise en production. Nous facturons à la résolution, pas au token, donc le chiffre sur la facture correspond au travail réellement effectué, pas au nombre d'appels oui/non survenus sous le capot. C'est l'un des quelques coéquipiers IA prêts à l'emploi, pas un modèle brut que vous devez assembler vous-même.

Et si vous vivez dans un terminal, ce même coéquipier se pilote depuis la CLI eesel. Ce n'est pas un second produit greffé, c'est le même espace de travail et le même agent eesel exposés pour le scripting : une personne peut le lancer à la main, un cron job peut l'automatiser, et un agent de code comme Claude Code ou Cursor peut le piloter via la CLI et le serveur MCP d'eesel. Donc si la raison pour laquelle vous chiffriez Jev était de brancher un modèle de décision sur un pipeline agentique depuis la ligne de commande, vous pouvez diriger ce même pipeline vers un coéquipier qui connaît déjà votre centre d'aide et peut agir sur le ticket, pas seulement le noter.
Vous voulez voir le coût final, pas le coût en tokens ? eesel tourne sur vos propres tickets dans un essai gratuit, pour que vous observiez ce que coûte réellement une résolution avant de vous engager.
L'essentiel sur les tarifs de TypeSafe Jev
Jev coûte 0,042 $ par million de tokens en entrée, sortie gratuite, et pour une charge de travail purement décisionnelle, c'est un chiffre très bas. Il est encadré par une vraie réserve : pas de paliers tarifaires, pas de palier gratuit public, une liste d'attente pour l'accès, et un prix dont l'entreprise admet elle-même ne pas encore pouvoir prouver la viabilité. Modélisez-le comme une brique de décision bon marché, pas comme un remplacement direct du LLM qui rédige vos réponses, et l'histoire des tarifs de TypeSafe Jev devient facile à raisonner. Faut-il construire toute votre stack de support dessus est une autre question, et elle mérite d'être tranchée avec le test complet ouvert à côté.
Questions fréquentes
Combien coûte TypeSafe Jev ?
TypeSafe tarife Jev à 0,042 $ par million de tokens en entrée, sortie gratuite, ce que l'entreprise présente comme un prix d'entrée 238 fois inférieur à celui de Claude Fable 5.1. Il n'existe pas encore de grille de paliers tarifaires publiée, donc ce seul tarif d'entrée constitue aujourd'hui, dans les faits, toute la politique tarifaire de TypeSafe Jev.
Existe-t-il un palier gratuit pour TypeSafe Jev ?
Pas de palier gratuit en libre-service. L'accès passe par une liste d'attente d'accès anticipé, plutôt que par une inscription publique avec des crédits gratuits. Les tokens de sortie sont gratuits une fois que vous avez accès, mais le tarif d'entrée s'applique toujours, et TypeSafe n'a publié aucun quota mensuel gratuit. Si vous voulez tester l'IA sur votre propre classification de tickets dès aujourd'hui, eesel propose un véritable essai gratuit.
Pourquoi la sortie de Jev est-elle gratuite ?
Un modèle System One ne génère pas de texte long. Sa sortie est une décision typée, une probabilité et un score de confiance, donc la charge de sortie est minuscule comparée à la réponse d'un chatbot. TypeSafe qualifie le tarif de sortie de "trop bon marché pour être facturé" et ne tarife que l'état d'entrée que vous envoyez. C'est une vraie lacune dans la plupart des modèles de tarification des LLM, où la sortie est généralement la moitié la plus chère.
Le tarif de TypeSafe Jev est-il subventionné ?
TypeSafe est inhabituellement direct là-dessus. Dans son billet de lancement, l'entreprise dit ne pas pouvoir prouver que le prix n'est pas subventionné et qu'il faudra du temps pour prouver la viabilité de sa tarification, en ajoutant qu'elle s'attend à ce que les prix baissent, pas augmentent. Des estimations de la communauté sur Hacker News situent le modèle à environ 3 milliards de paramètres, ce qui rend plausible un faible coût de service.
Où puis-je acheter ou accéder à Jev ?
Deux voies. Directement via la console TypeSafe depuis la liste d'attente, ou via Cloudflare Workers AI avec l'identifiant de modèle typesafe/jev, où la facturation est gérée depuis le tableau de bord Cloudflare.
Le faible coût de Jev signifie-t-il que je peux remplacer mon LLM de support par lui ?
Seulement pour les étapes de décision. Jev peut trier, noter et router un ticket à bas coût, mais il ne peut pas rédiger la réponse. Un flux de support en production a toujours besoin de génération, d'actions et d'escalade. C'est ce que prend en charge un coéquipier comme eesel au-dessus du modèle brut, et eesel facture à la résolution, pas au token.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.





Comment le tarif de Jev se compare-t-il aux tarifs des LLM ?
Selon TypeSafe lui-même, les LLM de pointe coûtent entre 0,20 $ et 10 $ par million de tokens en entrée, avec une sortie environ 5 fois plus chère que l'entrée. Jev facture 0,042 $ en entrée et rien en sortie. Pour une tâche de classification ou de routage, l'écart est important, mais il ne tient que lorsque la tâche est une décision typée, pas une génération de texte. Pour un exemple plus complet côté modèles de pointe, voir les tarifs de Google Gemini 3.