Pourquoi regarder au-delà de Fable 5.1
Laissez-moi d'abord être juste envers le titulaire, car Fable 5.1 est un modèle solide. Il a été lancé le 1er septembre 2026, se trouve au sommet de la famille Claude 5, et sur les propres évaluations d'Anthropic, il est en tête de tous les benchmarks publiés, avec les plus gros bonds sur le travail agentique et scientifique à long terme. Il offre une fenêtre de contexte de 1M de tokens à tarif fixe par token sur toute la fenêtre, 128k de sortie maximale, et un raisonnement adaptatif toujours activé. Le seul changement de prix en 2026 était une bonne nouvelle : les lectures de cache ont baissé de 75 %, passant de 1 $ à 0,25 $ par million de tokens, ce qui réduit les coûts habituels d'environ 25 % et jusqu'à 45 % pour les usages fortement agentiques.
Alors pourquoi comparer les options ? Quelques raisons concrètes reviennent souvent.
- Le prix. Le tarif de base reste à 10 $/50 $, le plus élevé de ce tour d'horizon. Si votre charge de travail n'est pas du type long, complexe et multi-outils pour lequel Fable est conçu, vous payez une prime pour une marge que vous n'utiliserez pas.
- Les refus. Plusieurs développeurs sur Hacker News ont signalé des refus faussement positifs, y compris lors de la revue de sécurité de leur propre code. Anthropic affirme que les utilisateurs de Claude Code devraient constater environ 60 % moins d'interventions liées à la cybersécurité que sur Fable 5, mais c'est une plainte réelle et actuelle.
- Le filigrane. Chaque sortie de Fable 5.1 porte un filigrane textuel statistique pour la conformité à la loi européenne sur l'IA. C'est acceptable pour la plupart des gens et une question de confiance pour certains, et cela a suscité le plus de réactions lors du lancement.
- Vous n'avez peut-être pas besoin d'un modèle brut. C'est le point majeur, et j'y reviendrai. Si l'objectif final est un agent de support ou un rédacteur de contenu, acheter un modèle de pointe signifie qu'il vous faut tout de même construire l'employé autour de lui.
En tant qu'ingénieur qui passe la plupart de ses journées à connecter des modèles à un vrai produit chez eesel, ce que je remarque sans cesse, c'est que la question « quel modèle » est généralement secondaire par rapport à une question « quelle couche » que les gens ont sautée. On en reparle après la liste.
Comment j'ai choisi ces alternatives
Il n'y a pas de « meilleur » modèle unique, donc cette liste est organisée selon la tâche que vous effectuez réellement. J'ai pesé quatre facteurs pour chaque option : le tarif réel publié (les tarifs de base, pas le « à partir de » marketing), les scores indépendants lorsqu'ils existent (principalement l'Artificial Analysis Intelligence Index, qui est agnostique par rapport au modèle), si les poids sont ouverts, et le compromis honnête que le classement cache. Chaque modèle ici est une option réelle, généralement disponible, que vous pouvez utiliser dès aujourd'hui, pas un aperçu.
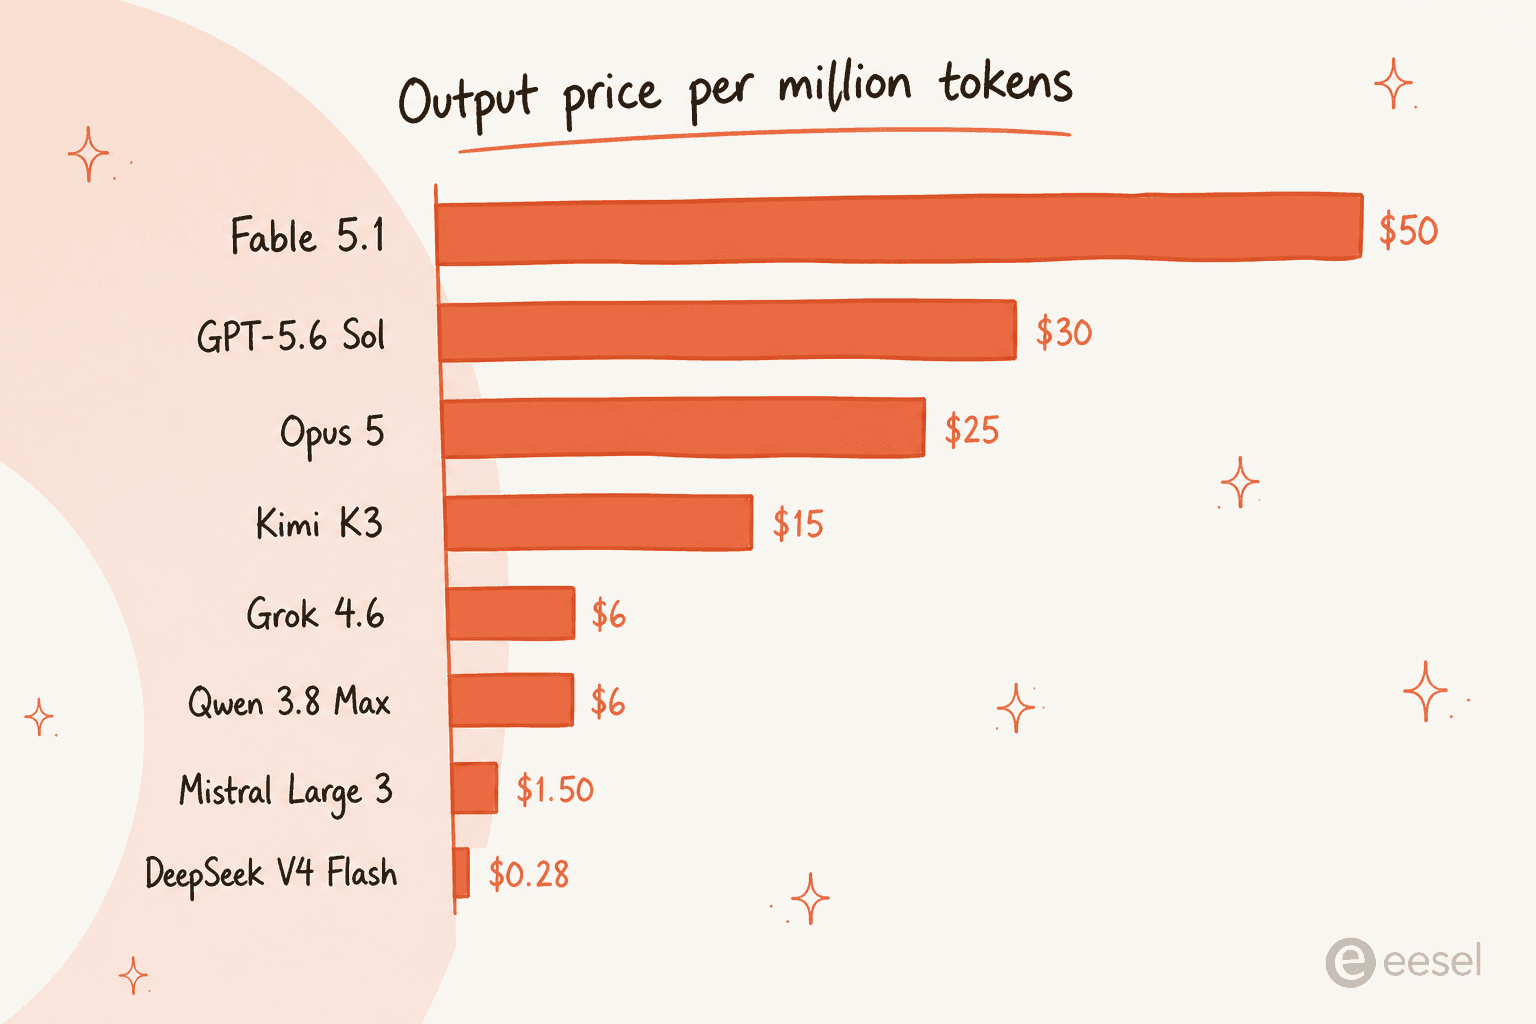
Une remarque sur les chiffres : les prix sont par million de tokens (MTok), entrée et sortie listées séparément, car c'est la sortie qui coûte cher dans le travail génératif. J'ai vérifié chaque chiffre sur la page principale de chaque fournisseur.
Les 8 meilleures alternatives à Claude Fable 5.1 en 2026
Voici la liste courte en un coup d'œil, puis le détail de chacune.
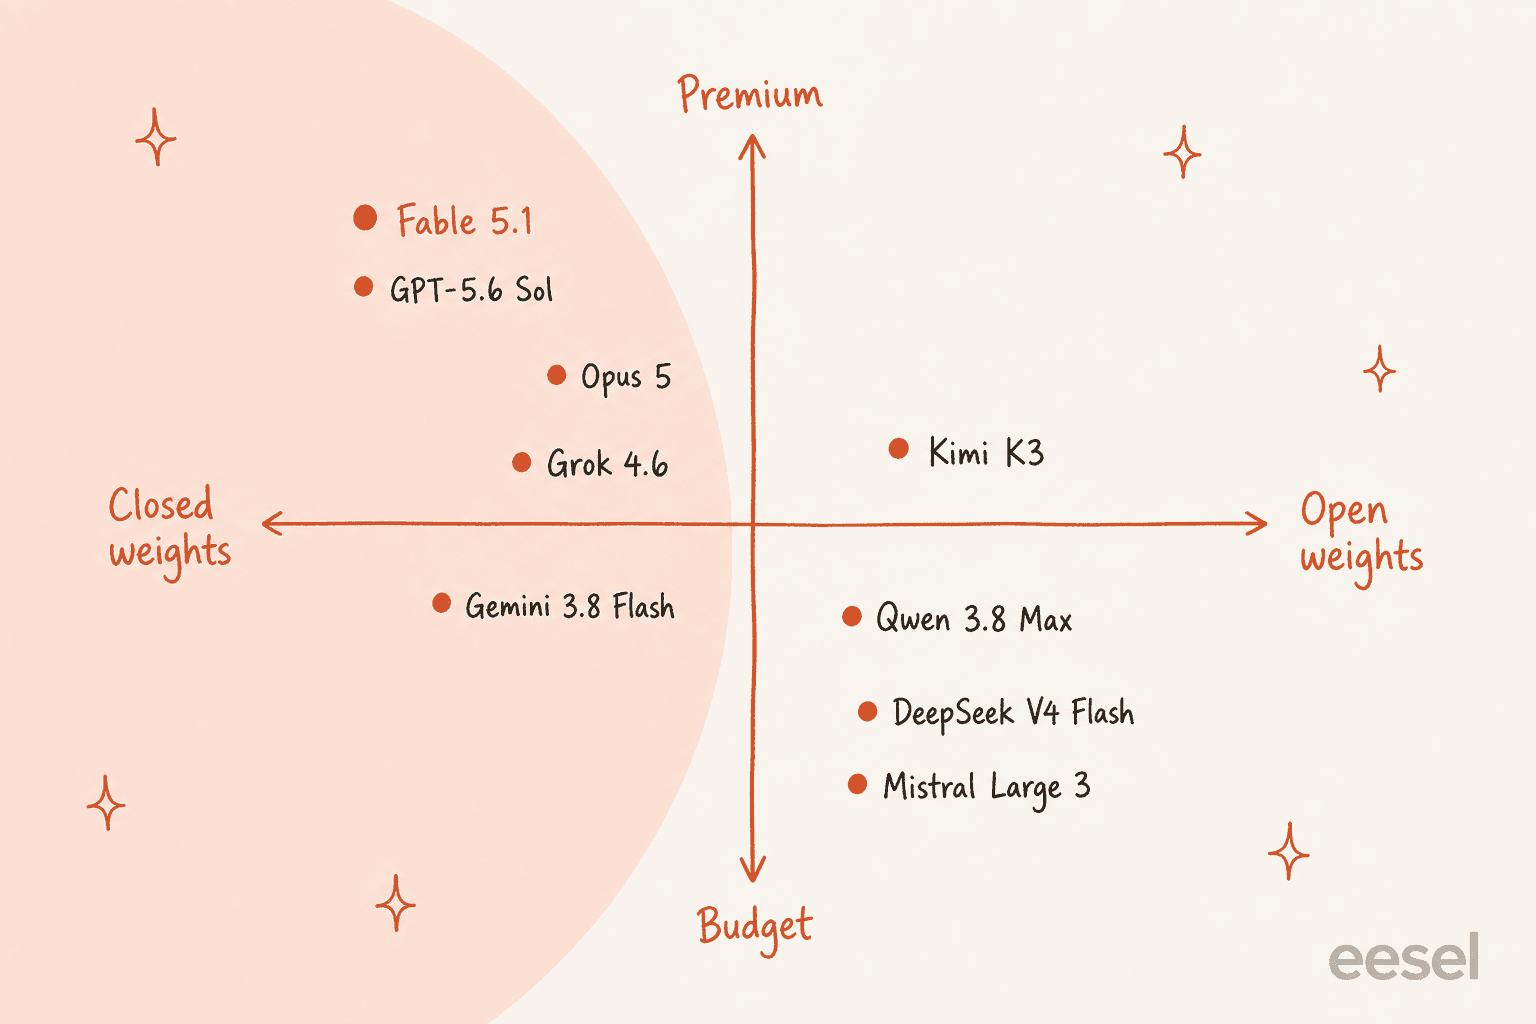
| Modèle | Idéal pour | Prix (entrée/sortie, $/MTok) | Contexte | Poids ouverts ? | vs. Fable 5.1 |
|---|---|---|---|---|---|
| Claude Opus 5 | Le remplacement par défaut | 5 $ / 25 $ | 1M | Non | Moitié prix, point de départ recommandé par Anthropic |
| OpenAI GPT-5.6 Sol | Stacks natifs OpenAI | 5 $ / 30 $ (contexte court) | 400k | Non | Base moins chère, mais le palier long contexte double au-delà de 200k |
| Google Gemini 3.8 Flash | Lots à haut débit et bon marché | 0,75 $ / 3,75 $ | 1M | Non | Bien moins cher, mais 13,3s de délai avant le premier token et prix doublé en janvier 2027 |
| Kimi K3 | Modèle phare à poids ouverts | 3 $ / 15 $ | 1M | Oui | Score presque au sommet, auto-hébergeable, moitié du prix de sortie de Fable |
| Qwen 3.8 Max | Multilingue + forte préférence humaine | 2 $ / 6 $ | 1M | Poids de base | Top 5 sur LMArena Text, un cinquième du coût de sortie |
| DeepSeek V4 Flash | Le choix économique | 0,14 $ / 0,28 $ | 128k | Oui (MIT) | Sortie ~180x moins chère, sous licence MIT |
| xAI Grok 4.6 | Temps réel + données X | 2 $ / 6 $ (contexte court) | 500k | Non | Base moins chère, mais des frais par appel d'outil et un seuil à 200k |
| Mistral Large 3 | Résidence des données en UE, économique | 0,50 $ / 1,50 $ | 256k | Oui | Fournisseur européen, prix de sortie le plus bas du haut de gamme ici |
1. Claude Opus 5
Idéal pour : tous ceux qui veulent un Claude de classe Fable sans la facture de classe Fable.
L'alternative la plus honnête à Fable 5.1 est le modèle situé juste en dessous dans la propre gamme d'Anthropic. Opus 5 a été lancé le 24 juillet 2026, fonctionne à 5 $/25 $ par million de tokens, et la recommandation d'Anthropic est inhabituellement directe : commencez par Opus 5 pour la plupart des tâches, et ne passez à Fable 5.1 que lorsqu'Opus 5 en effort élevé reste insuffisant. C'est le fournisseur lui-même qui vous dit que le modèle moins cher est le choix par défaut.
Il partage les meilleures caractéristiques structurelles de Fable : une fenêtre de 1M de tokens à tarif fixe, aucune surtaxe de contexte long, et des lectures de cache à 0,50 $ (toujours bon marché, même si ce n'est pas les 0,25 $ de Fable). Sur l'Artificial Analysis Intelligence Index indépendant, il se situe tout en haut du peloton, à peine derrière les tout derniers modèles.
Le hic à connaître : les tests de la communauté ont montré qu'Opus 5 a tendance à dépenser environ deux fois plus de tokens de sortie que l'Opus précédent à effort égal, donc le coût par tâche peut augmenter même si le tarif affiché est plus bas, et son taux d'hallucination sur un jeu de données indépendant a nettement augmenté par rapport aux Claude plus anciens. Il est brillant et un peu bavard. Pour les équipes déjà sur Claude qui veulent une vraie baisse de coût sans quitter la famille, c'est cependant le choix évident.
Notre avis : le choix par défaut. Si vous êtes sur Fable 5.1 « juste au cas où », essayez d'abord Opus 5, vous ne remarquerez probablement jamais la différence sur le travail quotidien.
2. OpenAI GPT-5.6 Sol
Idéal pour : les équipes dont la stack est déjà construite sur OpenAI.
GPT-5.6 Sol est le modèle phare à haut raisonnement d'OpenAI et l'équivalent naturel entre fournisseurs pour Fable. Le tarif de base est de 5 $ en entrée / 30 $ en sortie pour le palier de contexte court, ce qui est moins cher que Fable en entrée et proche en sortie. OpenAI propose aussi des modèles moins chers dans la même famille : GPT-5.6 Terra à 2 $/12 $ et Luna à 0,20 $/1,20 $, vous pouvez donc ajuster le coût au sein d'une seule API.
Voici le compromis qu'Anthropic n'a pas : OpenAI facture un palier de contexte long. Au-delà de 200k tokens, Sol repasse à 10 $/45 $, et cela s'applique à toute la requête, pas seulement au dépassement. Une exécution agentique avec un gros prompt peut donc discrètement coûter le double du tarif affiché. Fable et Opus facturent l'intégralité de leur fenêtre à tarif fixe, ce qui est un réel avantage pour le travail à contexte long.
Notre avis : le bon choix si vous êtes natif OpenAI et que vos prompts restent sous 200k. Si votre travail est fortement axé sur le contexte long, faites le calcul de ce seuil avant de changer.
3. Google Gemini 3.8 Flash
Idéal pour : les tâches de lot à haut débit et bon marché où personne n'attend la réponse.
Gemini 3.8 Flash est l'histoire de prix de cette liste. À 0,75 $ en entrée / 3,75 $ en sortie, il est plus d'un ordre de grandeur moins cher que Fable, offre une fenêtre de 1M de tokens, et obtient un score respectable de 59 sur l'Artificial Analysis Index. Pour l'enrichissement nocturne, la classification ou la génération en masse, cette combinaison est difficile à contester.
Deux réserves honnêtes. Premièrement, la réactivité : Artificial Analysis mesure un délai avant premier token de 13,3 secondes contre une médiane de classe de 2,99 secondes. Le débit est excellent (dans le top trois pour la vitesse de sortie), mais le modèle est lent à démarrer, ce qui l'exclut de tout ce qu'un humain attend, comme une réponse de chat en direct, et n'est pas un problème pour un agent en lot. Deuxièmement, le prix double : le tarif de 0,75 $/3,75 $ tient jusqu'au 31 décembre 2026, puis passe à 1,50 $/7,50 $ le 1er janvier 2027. Google suggère même de rester sur l'ancien 3.7 Flash pour les charges de travail axées sur l'efficacité, car 3.8 « pourrait utiliser plus de tokens pour maximiser la performance ».
Notre avis : le choix rapport qualité-prix pour le travail hors ligne à fort volume. Ne le mettez pas derrière un widget de chat, et notez le changement de prix de janvier.
4. Kimi K3 (Moonshot AI)
Idéal pour : les équipes qui veulent un score de haut niveau avec des poids ouverts qu'elles peuvent vraiment télécharger.
Kimi K3 est le modèle phare de Moonshot AI, un modèle à mélange d'experts de 2,8 billions de paramètres (104B actifs) avec une fenêtre de contexte de 1M de tokens. Il fonctionne à 3 $ en entrée / 15 $ en sortie, sa sortie coûte donc moins d'un tiers de celle de Fable, et il se classe #4 sur l'Artificial Analysis Intelligence Index, devant les générations précédentes de Claude et GPT. La particularité est que Moonshot a publié les poids ouverts à temps, vous pouvez donc l'auto-héberger.
Une particularité à anticiper : le raisonnement ne peut pas être désactivé. K3 propose des niveaux reasoning_effort (bas, élevé, et le maximum par défaut), mais même le réglage bas continue de raisonner, et tous les niveaux sont facturés au même tarif, donc le curseur contrôle la latence, pas le coût. Cela le rend plus cher que son tarif affiché pour les appels simples, sans raisonnement, où un modèle moins cher suffirait.
Notre avis : le modèle phare à poids ouverts le plus solide pour les équipes qui doivent s'auto-héberger pour des raisons de conformité ou de contrôle. Si vous voulez juste une API hébergée sans vous soucier des poids, Qwen et DeepSeek le battent sur le prix.
5. Qwen 3.8 Max (Alibaba)
Idéal pour : le travail multilingue et ceux qui font davantage confiance à la préférence humaine à l'aveugle qu'aux scores automatisés.
Qwen 3.8 Max est devenu généralement disponible le 2 août 2026. C'est un MoE de 2,4 billions de paramètres (95B actifs) avec une fenêtre de 1M de tokens, au tarif de 2 $ en entrée / 6 $ en sortie avec une lecture de cache implicite à 0,25 $. C'est environ un cinquième du coût de sortie de Fable pour un modèle qui se classe près du sommet des classements de préférence humaine.
Le point intéressant est que les classements automatisés et humains ne concordent pas pour Qwen. Sur LMArena il est #5 en Text et #2 en Vision, c'est-à-dire que les gens aiment ses réponses ; sur l'Intelligence Index automatisé, il se situe en milieu de tableau, autour de 58. Aucun des deux n'a tort, ils mesurent des choses différentes, donc ne tirez pas un verdict d'un seul chiffre. Alibaba publie aussi un modèle plus petit sous licence permissive, bien que le Max hébergé ajoute la vision, les outils et un contexte par défaut plus long que la base ouverte n'offre pas.
Notre avis : un choix solide et économique pour le texte multilingue et destiné au grand public, là où son avantage de préférence humaine se manifeste. Pour l'usage agentique d'outils, vérifiez sur vos propres tâches plutôt que sur le classement.
6. DeepSeek V4 Flash
Idéal pour : la gamme économique, quand le coût par token est la contrainte.
Si le prix est toute la décision, DeepSeek V4 Flash clôt la discussion. À 0,14 $ en entrée / 0,28 $ en sortie, sa sortie est environ 180 fois moins chère que celle de Fable, et il est distribué sous licence MIT, la plus permissive de tous les modèles ici. Il a été ré-entraîné le 31 juillet 2026, et cette nouvelle version bat en fait le propre V4 Pro plus coûteux de DeepSeek sur tous les benchmarks agentiques publiés par l'entreprise.
Il n'égalera pas Fable sur le raisonnement à long terme le plus difficile ou sur le rappel profond dans un contexte immense, et sa fenêtre (128k) est plus petite que celle des modèles à 1M de tokens ci-dessus. Mais sur l'Artificial Analysis Index, il affiche un vrai score pour environ 0,03 $ par tâche, le genre de chiffre qui rend à nouveau viable toute une catégorie d'idées « trop chères pour être exécutées ».
Notre avis : le choix par défaut quand vous exécutez quelque chose à grande échelle et que le niveau de pointe est excessif. Testez-le d'abord avant de supposer que vous avez besoin d'un modèle à 50 $ en sortie.
7. xAI Grok 4.6
Idéal pour : les produits qui vivent des données en temps réel et de X.
Grok 4.6 fonctionne à 2 $ en entrée / 6 $ en sortie pour son palier de contexte court à 500k tokens, moins cher que Fable sur l'ensemble des tokens, avec un usage d'outils solide et un accès natif aux données X en temps réel qu'aucun autre modèle ici ne propose.
Mais lisez le compteur avant de vous engager. Comme OpenAI, xAI facture un palier de contexte long : au-delà de 200k tokens, chaque token de la requête est facturé à 4 $/12 $. Et Grok ajoute des frais par appel que le tarif au token dissimule, la recherche web et X coûte 5 $ pour 1 000 appels, la recherche de fichiers 10 $ pour 1 000, donc un agent qui effectue beaucoup de recherches coûte plus cher que le tarif affiché ne le suggère. Un piège côté achats : si vous êtes contraint au cloud, Azure et Bedrock plafonnent à Grok 4.3, vous ne pouvez donc pas acheter le 4.6 par ce biais du tout.
Notre avis : intéressant lorsque le temps réel ou les données X sont réellement la fonctionnalité recherchée. Si ce n'est pas le cas, les compteurs d'appels d'outils rendent un modèle de pointe classique plus simple à budgétiser.
8. Mistral Large 3
Idéal pour : la résidence des données en Europe et une facture haut de gamme légère.
Mistral Large 3 est l'entrée européenne, et c'est le modèle « de classe phare » le moins cher de cette liste à 0,50 $ en entrée / 1,50 $ en sortie. Pour les équipes qui ont besoin d'un fournisseur basé dans l'UE pour des raisons de résidence des données ou réglementaires, c'est souvent la seule option quasi-pointe qui passe les achats, et elle propose en plus des poids ouverts.
Le compromis est direct : il ne se bat pas pour le sommet des classements d'intelligence comme le font Fable, Opus 5 ou GPT-5.6 Sol. Pour le travail agentique et de raisonnement le plus difficile, il est en retrait, et son contexte de 256k est plus petit que celui des modèles à 1M de tokens. Mais pour beaucoup de génération et d'extraction pratiques, à ce prix et avec un hébergement en UE, c'est un plancher très raisonnable. L'assistant grand public de Mistral, désormais sous la marque Vibe, repose sur les mêmes modèles si vous voulez une interface de chat.
Notre avis : le choix pragmatique pour l'UE. Choisissez-le pour la résidence et le coût, pas pour gagner un benchmark.
La reformulation : un modèle est un moteur, pas un employé
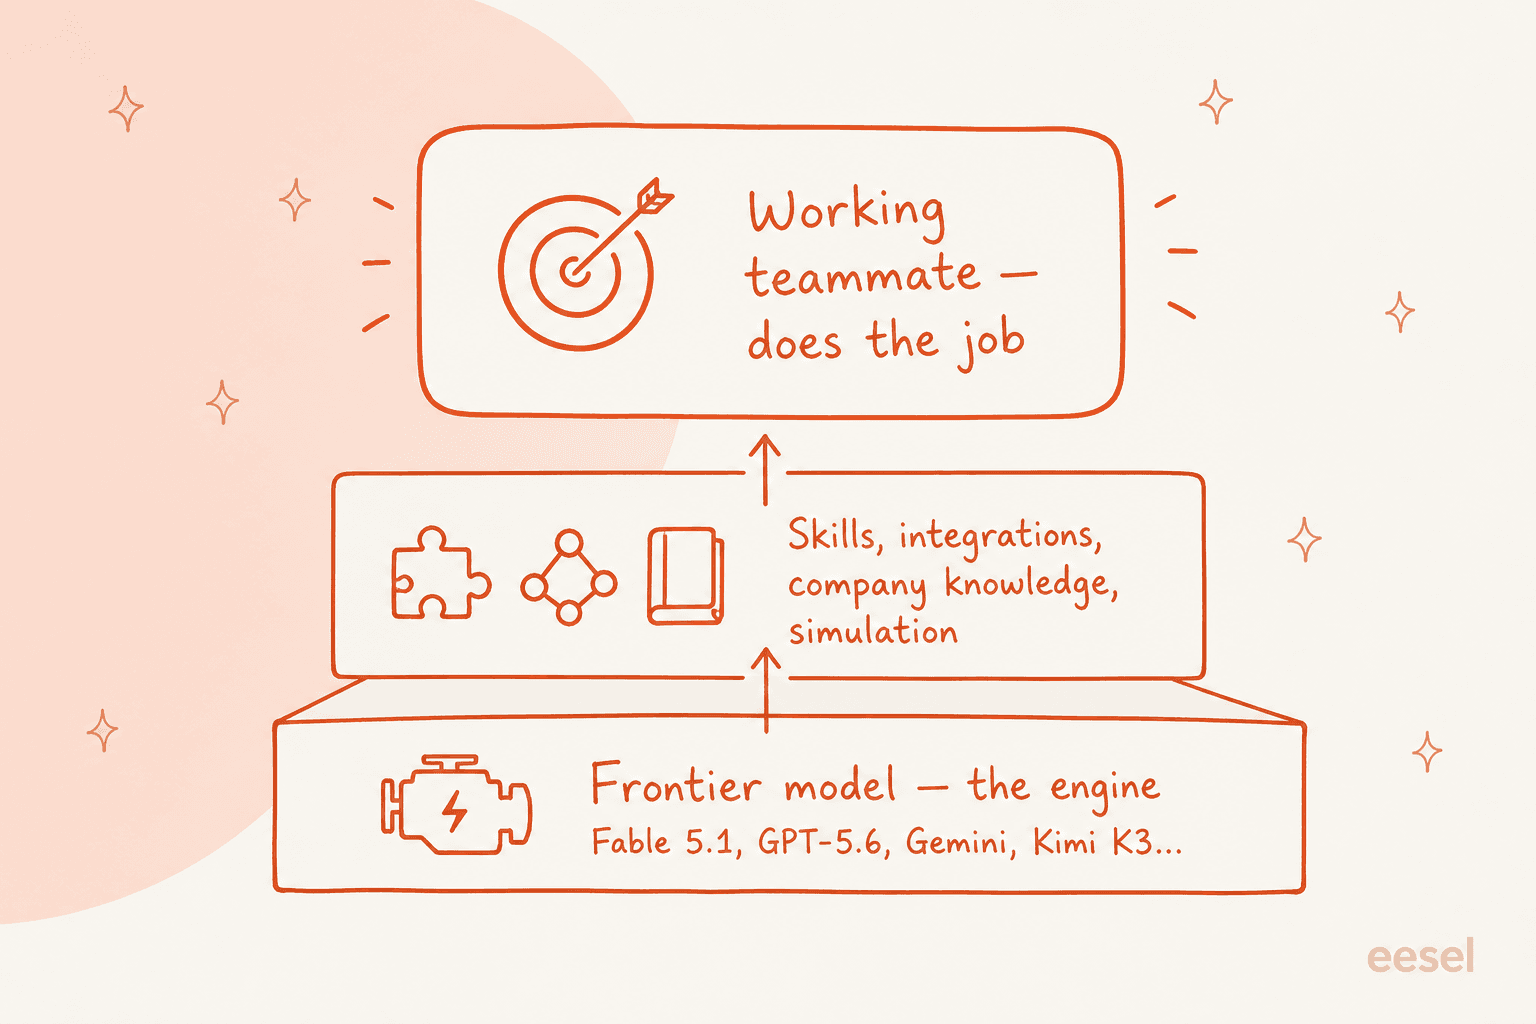
Voici ce que toute liste de « meilleur modèle » dissimule. Choisir entre Fable 5.1 et ces huit alternatives n'est la bonne question que si le modèle lui-même est ce que vous livrez. Pour la plupart des équipes, ce n'est pas le cas. Vous ne voulez pas des tokens, vous voulez des tickets résolus ou des articles rédigés.
Un modèle de pointe brut est une infrastructure. Il arrive sans rien connaître de votre produit, connecté à rien, ne se souvenant de rien entre les appels. Pour le transformer en agent de support, il faut encore construire la recherche documentaire sur votre centre d'aide, le connecter à votre helpdesk, écrire les garde-fous, ajouter la logique d'escalade et, si vous êtes prudent, trouver un moyen de le tester avant qu'il ne parle à un vrai client. Cela représente des mois de travail, et le choix du modèle n'en est qu'une petite partie.
C'est là que j'ai gagné quelques cicatrices. Je construis les intégrations et les API chez eesel, et nous avons passé les trois dernières années et plus à déployer des agents IA sur des files de support en direct, sur des milliers de tickets réels. La leçon qui reste : le modèle est rarement ce qui casse. Ce qui casse, c'est un bot au ton confiant qui donne une mauvaise réponse parce que personne ne l'a testé face à la réalité au préalable, c'est exactement pourquoi chaque déploiement est désormais simulé sur les tickets historiques d'une entreprise avant d'approcher un vrai client. Aucune quantité de « Fable est-il meilleur qu'Opus » ne répond à cela.
Alors, avant de passer une semaine à comparer des modèles, demandez-vous quelle couche vous achetez réellement. Si vous construisez une plateforme et que le modèle est votre produit, cette liste est pour vous, choisissez selon la tâche. Si vous voulez un employé, achetez l'employé.
Essayez eesel
Si la tâche que vous essayez réellement d'accomplir est le support ou le contenu, eesel est la couche qui se situe au-dessus de tous ces modèles. eesel est une plateforme de coéquipiers IA : au lieu de vous donner un modèle et une page blanche, vous embauchez un coéquipier prêt à travailler pour une tâche définie. L'équipe actuelle comprend un coéquipier IA pour le helpdesk qui rejoint votre file de support existante, et un rédacteur de blog IA, chacun arrivant avec les compétences, les intégrations et le contexte d'entreprise dont son rôle a besoin.
La partie qui compte pour un tour d'horizon de modèles : eesel est agnostique par rapport au modèle en interne, vous obtenez donc la capacité d'un modèle de pointe sans avoir à en choisir, en tarifer ou en connecter un vous-même, et sans refaire ce travail chaque fois qu'un nouveau Fable ou Opus sort. Avant de répondre au moindre ticket réel, vous pouvez simuler le coéquipier sur vos tickets passés pour voir exactement comment il les aurait traités, l'étape de test que la plupart des constructions à partir d'un modèle brut sautent et regrettent plus tard.
Et si vous vivez dans un terminal, la CLI eesel pilote le même coéquipier et le même espace de travail de manière programmatique. Elle est conçue pour être compatible avec les agents : une personne peut l'exécuter à la main, des scripts peuvent l'automatiser, et des agents de codage comme Claude Code, Codex et Cursor peuvent l'utiliser directement, vous pouvez donc gérer les instructions, lancer des simulations, déclencher l'agent et lire son activité sans jamais ouvrir le tableau de bord. C'est le même coéquipier, exposé comme une surface qu'une automatisation ou une IA peut piloter. L'essayer est gratuit, et vous pouvez voir comment il fonctionne sur vos propres données avant de vous engager.
Quelle alternative choisir concrètement
Pour boucler la boucle, la version courte par tâche :
- Rester dans la famille Claude, dépenser moins : Opus 5. C'est le choix par défaut d'Anthropic lui-même.
- Natif OpenAI ou Google : GPT-5.6 Sol (attention au seuil des 200k) ou Gemini 3.8 Flash (lot seulement, prix doublé en janvier).
- Poids ouverts : Kimi K3 pour un modèle phare auto-hébergeable, Qwen 3.8 Max pour le multilingue, DeepSeek V4 Flash pour le plancher économique.
- Temps réel ou UE : Grok 4.6 pour les données X, Mistral Large 3 pour la résidence européenne.
- Vous vouliez un employé, pas un modèle : eesel.
Les modèles continueront de se dépasser les uns les autres, et les prix affichés continueront de bouger. Ce qui ne change pas, c'est la question de la couche, décidez d'abord si vous achetez un moteur ou un employé, et le reste du choix devient bien plus simple.
Foire aux questions
Quelle est la meilleure alternative à Claude Fable 5.1 ?
Combien coûte Claude Fable 5.1 par rapport aux alternatives ?
Existe-t-il une alternative moins chère à Claude Fable 5.1 qui reste performante ?
Existe-t-il des alternatives à poids ouverts à Claude Fable 5.1 ?
Ai-je besoin de Claude Fable 5.1 pour créer un agent de support IA ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.