8 meilleures alternatives à Claude Opus 5.5 en 2026 (moins chères, plus rapides, ouvertes)

Kurnia Kharisma Agung Samiadjie

Katelin Teen
Dernière modification September 23, 2026
Pourquoi les gens regardent au-delà de Claude Opus 5.5
D'abord, la partie honnête. Opus 5.5 mérite sa réputation. Il est conçu pour le codage agentique de longue durée et le travail de connaissance, gère l'ambiguïté sans trop d'accompagnement, et occupe la première place de l'Artificial Analysis Intelligence Index avec un score de 58. Anthropic a même baissé le prix des $5/$25 d'Opus 5 à $4/$20, une véritable concession non forcée envers les acheteurs. Si vous êtes déjà bien installé dans Claude Code et que le travail est vraiment difficile, rester est un choix défendable.
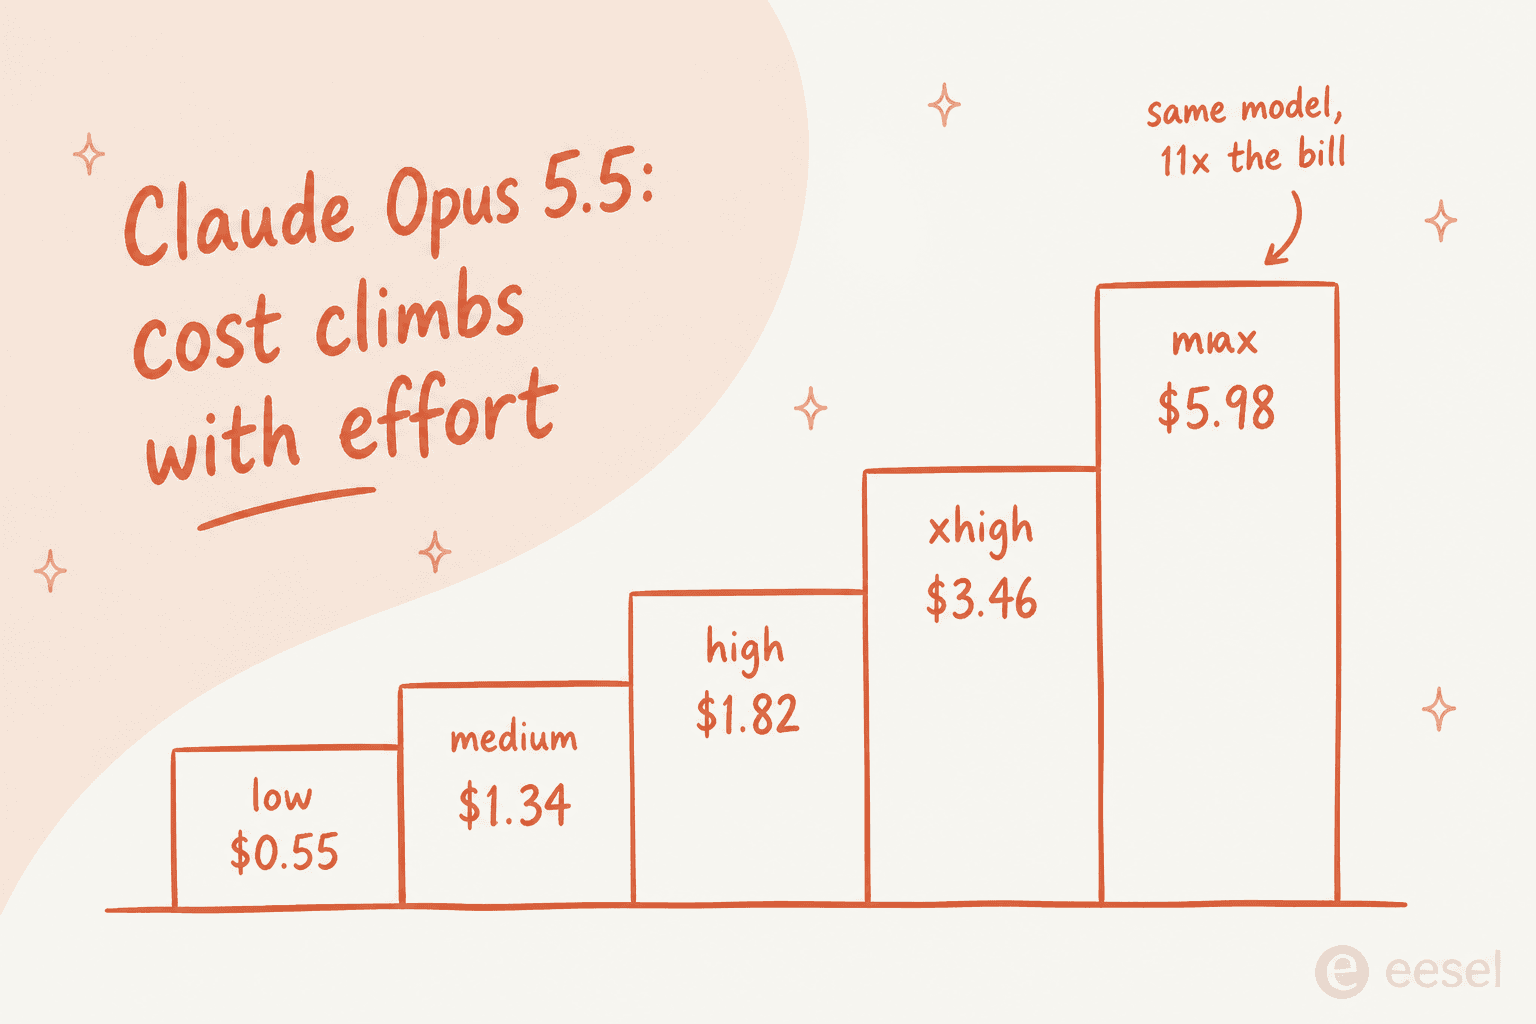
J'ai passé les dernières années à déployer l'IA sur des files de support client en direct, et ce qui m'a le plus surpris dans les modèles de pointe, ce n'était pas la qualité, c'était que la facture suit bien plus le curseur d'effort que le prix affiché. Opus 5.5 en est un exemple parfait. Le tarif par token est dans la moyenne, mais le coût par tâche oscille entre environ $0.55 à faible effort et $5.98 à effort maximal, car à effort élevé il raisonne plus longtemps et émet plus de tokens.
Les raisons pour lesquelles on part magasiner sont généralement l'une de ces quatre :
- Coût par tâche terminée. Un modèle qui obtient quelques points de moins mais coûte cinq fois moins cher par tâche est le meilleur achat pour la plupart des charges de travail.
- Vitesse. Opus est méthodique. Pour tout ce qu'un humain attend, comme une réponse de chat, la latence compte plus qu'un benchmark.
- Poids ouverts. Certaines équipes doivent s'auto-héberger pour la confidentialité, la souveraineté ou le contrôle des coûts.
- Étendue multimodale ou contexte. L'audio, la vidéo, ou une fenêtre de contexte vraiment immense peuvent être la caractéristique décisive.
Voici comment se comparent les huit alternatives que j'envisagerais vraiment, avant qu'on ne détaille chacune d'elles.
Les alternatives à Claude Opus 5.5 en un coup d'œil
| Modèle | Idéal pour | Prix /1M (entrée / sortie) | Contexte | Poids ouverts | Vision native |
|---|---|---|---|---|---|
| Claude Opus 5.5 (en place) | Codage agentique le plus difficile | $4 / $20 | ~1M | Non | Oui |
| GPT-6 Sol | Qualité de pointe, moins cher par tâche | $2 / $10 | 1,05M | Non | Oui |
| Gemini 3.8 Flash | Multimodal bon marché à grande échelle | $0.75 / $3.75 | 1M | Non | Oui (+ audio/vidéo/PDF) |
| Grok 4.7 | Boucles d'agents à fort volume | $2 / $6 | 500K | Non | Oui |
| Qwen 3.8 Max | Valeur multimodale, base ouverte | $2 / $6 | 1M | Base seulement | Oui |
| Kimi K3 | Poids ouverts avec vision | $3 / $15 | 1M | Oui | Oui |
| DeepSeek V4 Flash | Le plancher de coût | ~$0.22 / $0.66 | 1M | Oui (MIT) | Non |
| GPT-6 Luna | Le moins cher à grande échelle | $0.10 / $0.50 | 1,05M | Non | Oui |
| Claude Sonnet 5 | Rester dans la famille Claude | $2 / $10 | ~1M | Non | Oui |
Les prix sont les tarifs standard pour contexte court par million de tokens, vérifiés en septembre 2026. Le chiffre de DeepSeek correspond au tarif hors pic pour l'entrée avec échec de cache et au tarif de sortie standard. Le tarif de Gemini 3.8 Flash est promotionnel jusqu'au 31 décembre 2026, puis double.
Une note rapide sur ma méthode de sélection. C'est une liste courte, pas un catalogue, donc j'ai pondéré trois éléments : un prix réel et vérifiable (par token et, quand Artificial Analysis l'a mesuré, par tâche), la façon dont le modèle se comporte réellement par rapport à son marketing, et s'il comble un vide qu'Opus 5.5 laisse ouvert. Tout ce qui n'était que « Opus mais légèrement moins bon au même prix » n'a pas été retenu.
1. GPT-6 Sol : le rival de pointe le plus proche, à un cinquième du coût
Idéal pour : les équipes qui veulent une qualité proche de la pointe mais ne peuvent pas encaisser la facture par tâche d'Opus 5.5.
GPT-6 Sol a été lancé le 23 septembre 2026, un jour après Opus 5.5, et c'est la comparaison la plus directe de cette liste. Il dispose d'une fenêtre de contexte de 1 050 000 tokens, d'une entrée d'image native, et de l'ensemble complet des outils OpenAI Responses, incluant la recherche web, l'interpréteur de code, le shell hébergé, l'utilisation d'ordinateur et le MCP.
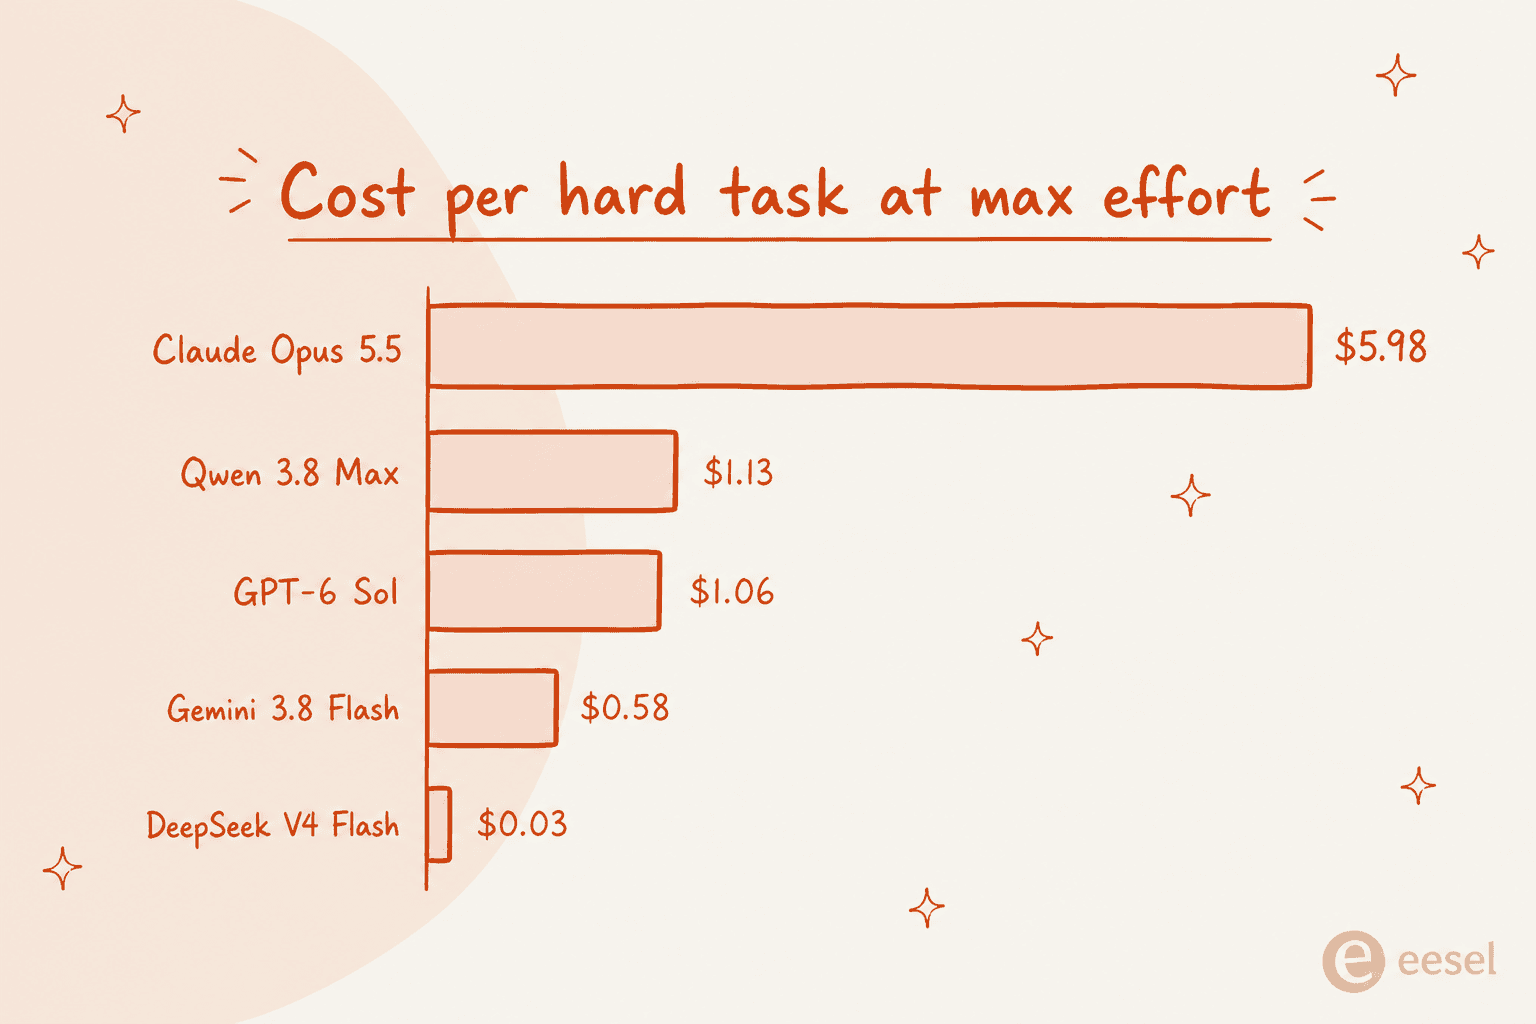
En intelligence brute, Opus gagne : Artificial Analysis attribue à Sol un score de 48 sur son Intelligence Index contre 58 pour Opus 5.5. Mais regardez ce que coûte chaque point. Sol coûte $2/$10 par million de tokens, moitié moins qu'Opus, et à effort maximal, il termine une tâche difficile pour environ $1.06 contre $5.98 pour Opus, en partie parce qu'il émet bien moins de tokens de sortie. C'est le chiffre le plus frappant de tout cet article.
Il y a un vrai débat sur la question de savoir si cet écart en vaut la peine, et la communauté est partagée. Voici un testeur expérimenté sur le fil de lancement :
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

Avantages : environ 5 fois moins cher par tâche à effort maximal, une prose par défaut plus nette, une immense fenêtre de contexte, et une véritable amélioration de la factualité (OpenAI rapporte environ moitié moins d'erreurs que le Sol précédent ; le taux d'hallucination à effort maximal est passé de 92 % à 60 % selon Artificial Analysis).
Inconvénients : un plafond de raisonnement plus bas qu'Opus 5.5, et il n'est pas disponible sur le forfait gratuit de ChatGPT, donc un accès occasionnel implique un forfait payant.
Verdict : pour la plupart des charges de travail de construction d'agent, Sol est l'achat le plus judicieux. Vous sacrifiez une part du raisonnement de pointe et en récupérez l'essentiel en vitesse et en budget. Si vous exécutez de nombreuses tâches et surveillez la facture, commencez ici.
2. Gemini 3.8 Flash : l'option bon marché et vraiment multimodale
Idéal pour : les travaux à haut débit qui nécessitent une entrée audio, vidéo ou PDF avec un budget serré.
Gemini 3.8 Flash est la troisième version Flash de Google en six semaines, et elle fait quelque chose d'étonnant : elle dépasse Opus 5.5 sur l'Artificial Analysis Intelligence Index (59 contre 58) tout en coûtant une fraction du prix, à $0.75/$3.75 par million de tokens jusqu'à fin 2026. C'est aussi le seul modèle ici qui ingère nativement image, audio, vidéo et PDF, avec une fenêtre d'entrée de 1M de tokens.
Les bémols honnêtes comptent cependant. Le temps jusqu'au premier token est de 13,30s contre une médiane de catégorie proche de 3s, donc il est disqualifié pour tout ce qu'un humain attend en direct et parfait pour un traitement par lots nocturne. Il est aussi verbeux, et Google lui-même indique dans le billet de lancement que les charges de travail privilégiant l'efficacité devraient rester sur 3.7 Flash. Sur le prix et la portée multimodale, il excelle ; sur la réactivité, non.
Avantages : un score Intelligence Index de niveau frontière, les types d'entrée les plus larges de la liste, très bon marché, et un forfait gratuit pour tester.
Inconvénients : premier token lent, sortie verbeuse qui grignote l'avantage prix, et un doublement de prix à $1.50/$7.50 déjà planifié pour le 1er janvier 2027.
Verdict : si votre charge de travail est asynchrone et multimodale, c'est sans doute le meilleur rapport qualité-prix de la page. Ne le placez juste pas derrière un widget de chat en direct où le délai de 13s avant le premier token se remarquera. Pour la différence entre un agent asynchrone et un agent temps réel, notre article sur les agents IA face aux chatbots à base de règles est un cadre utile.
3. Grok 4.7 : tarifé pour vivre dans des boucles d'agents
Idéal pour : le codage agentique à haut volume et de plusieurs heures où le coût par token s'accumule.
Grok 4.7 est sorti le 21 septembre 2026, construit sur un modèle de base plus grand que 4.6 avec un entraînement par renforcement plus long orienté vers les tâches de plusieurs heures. Il coûte $2/$6 par million de tokens en dessous d'un prompt de 200K, le tarif de sortie le moins cher de tous les modèles de niveau frontière présentés ici, et dispose d'une fenêtre de contexte de 500K plus une nouvelle API de Context Compaction pour les longues sessions.
L'histoire des benchmarks se résume à « proche de la frontière aux prix de l'an dernier ». Sur le propre tableau de xAI, Grok 4.7 affiche un Terminal-Bench 4.0 de 37.6 (près du double des 20.3 de 4.6), un EEBench de 64.0, et un score Harvey Legal Agent de 19.6 qui bat en réalité à la fois Sol et les modèles de classe Opus. Il ne gagne cependant pas partout. Sur HealthBench Professional, il obtient 56.7, derrière à la fois GPT-6 Sol et le haut de gamme d'Anthropic.
Avantages : le faible tarif de sortie le rend bien adapté aux boucles qui consomment des tokens, un véritable bond sur les benchmarks de codage et de terminal, et la pile de sécurité xAI la plus solide à ce jour.
Inconvénients : une fenêtre de contexte de 500K qui fait la moitié de celle des rivaux à 1M de tokens, la surtaxe de contexte long ($4/$12) s'applique à chaque token de la requête dès que l'on dépasse 200K, et il perd face à la frontière en santé et sur certaines évaluations de raisonnement.
Verdict : si vous montez un agent de codage qui tourne pendant des heures et que le compteur par token vous importe plus que les derniers points de raisonnement, Grok 4.7 est un choix solide et honnête. Il existe aussi une CLI xAI si vous voulez le piloter depuis le terminal.
4. Qwen 3.8 Max : Intelligence Index de niveau frontière, moitié prix
Idéal pour : les équipes qui veulent un score Intelligence de classe Opus avec une base téléchargeable en repli.
Qwen 3.8 Max est devenu généralement disponible le 2 août 2026, et c'est discrètement l'un des modèles de pointe offrant le meilleur rapport qualité-prix. C'est un modèle de mélange d'experts de 2,4T au total / 95B actifs avec un contexte de 1M de tokens, tarifé $2/$6 par million de tokens sur le cloud d'Alibaba. Sur le classement d'Artificial Analysis, il occupe désormais la sixième place avec un Intelligence Index de 58,08, pratiquement au niveau du chiffre phare d'Opus 5.5, pour une fraction du coût.
La nuance est que les indices automatisés et la préférence humaine divergent ici. Sur LMArena, Qwen 3.8 Max est fort en préférence à l'aveugle : Texte #5, WebDev #4 et Vision #2. Mais l'indice composite et les votes humains pointent dans des directions légèrement différentes, donc je ne rendrais jamais un verdict à chiffre unique sur ce modèle. Notez aussi que les poids de base ouverts existent mais ne sont pas équivalents en fonctionnalités au Max hébergé, qui ajoute la vision, un mode sans raisonnement et des outils intégrés.
Avantages : un Intelligence Index de niveau frontière à $2/$6, d'excellents classements multimodaux sur LMArena, et une base ouverte pour les équipes qui veulent une option d'auto-hébergement.
Inconvénients : les poids ouverts portent une licence non-Apache et n'ont pas les fonctionnalités du modèle hébergé, et l'écart entre score automatisé et humain signifie que vous devriez tester sur vos propres tâches.
Verdict : un choix sous-estimé. Si vous voulez quelque chose qui se rapproche des benchmarks d'Opus 5.5 pour moins cher, et que vous êtes à l'aise pour faire vos propres évaluations plutôt que de faire confiance à un seul score, Qwen 3.8 Max mérite une place dans votre présélection.
5. Kimi K3 : des poids ouverts qui voient vraiment
Idéal pour : les équipes qui veulent un modèle de pointe vraiment ouvert et capable de vision.
Kimi K3 est le vaisseau amiral de Moonshot AI, un modèle de mélange d'experts de 2,8T au total / 104B actifs avec un contexte de 1M de tokens et une vision native (image et vidéo). Fait crucial, les poids ouverts sont sortis dans les temps, le 27 juillet 2026, et l'index safetensors confirme le nombre de paramètres de 2,8T indépendamment du communiqué de presse. Sur l'Artificial Analysis Intelligence Index, il se situe à 57, dans le même voisinage qu'Opus 5.5.
La tarification est de $3/$15 par million de tokens, ce qui correspond à la tranche de Claude Sonnet plutôt qu'au niveau bas de gamme. Une particularité à connaître : le raisonnement ne peut pas être désactivé. Le paramètre reasoning_effort a désormais des niveaux low et high, mais ce sont des réglages de latence, pas des niveaux de coût, puisque chaque niveau est facturé de la même façon. Une URL d'image publique n'est pas non plus acceptée ; il faut passer du base64 ou un identifiant de fichier.
Avantages : des poids vraiment ouverts avec vision, un score Intelligence proche de la frontière, et de solides résultats agentiques et sur BrowseComp.
Inconvénients : tarifé comme Sonnet plutôt que comme les modèles ouverts bon marché, un raisonnement qu'on ne peut pas désactiver, et une gestion des images qui nécessite du base64 plutôt que des URL.
Verdict : le choix quand « poids ouverts » et « gère les images » doivent être vrais tous les deux. Si vous n'avez besoin que de l'un des deux, DeepSeek est moins cher et Qwen obtient de meilleurs scores, donc Kimi K3 est un choix spécifique plutôt qu'une option par défaut.
6. DeepSeek V4 : le plancher de coût, avec un astérisque
Idéal pour : le coût par token le plus bas absolu, et les équipes qui veulent des poids sous licence MIT.
DeepSeek V4 Flash est le moyen le moins cher d'exécuter un modèle performant sur cette liste, point final. C'est un modèle de mélange d'experts de 284B au total / 13B actifs avec un contexte de 1M de tokens et des poids ouverts sous licence MIT, et sur Artificial Analysis, il obtient un Intelligence Index de 50 pour environ $0.03 par tâche à effort maximal, ce qui n'est pas une coquille.
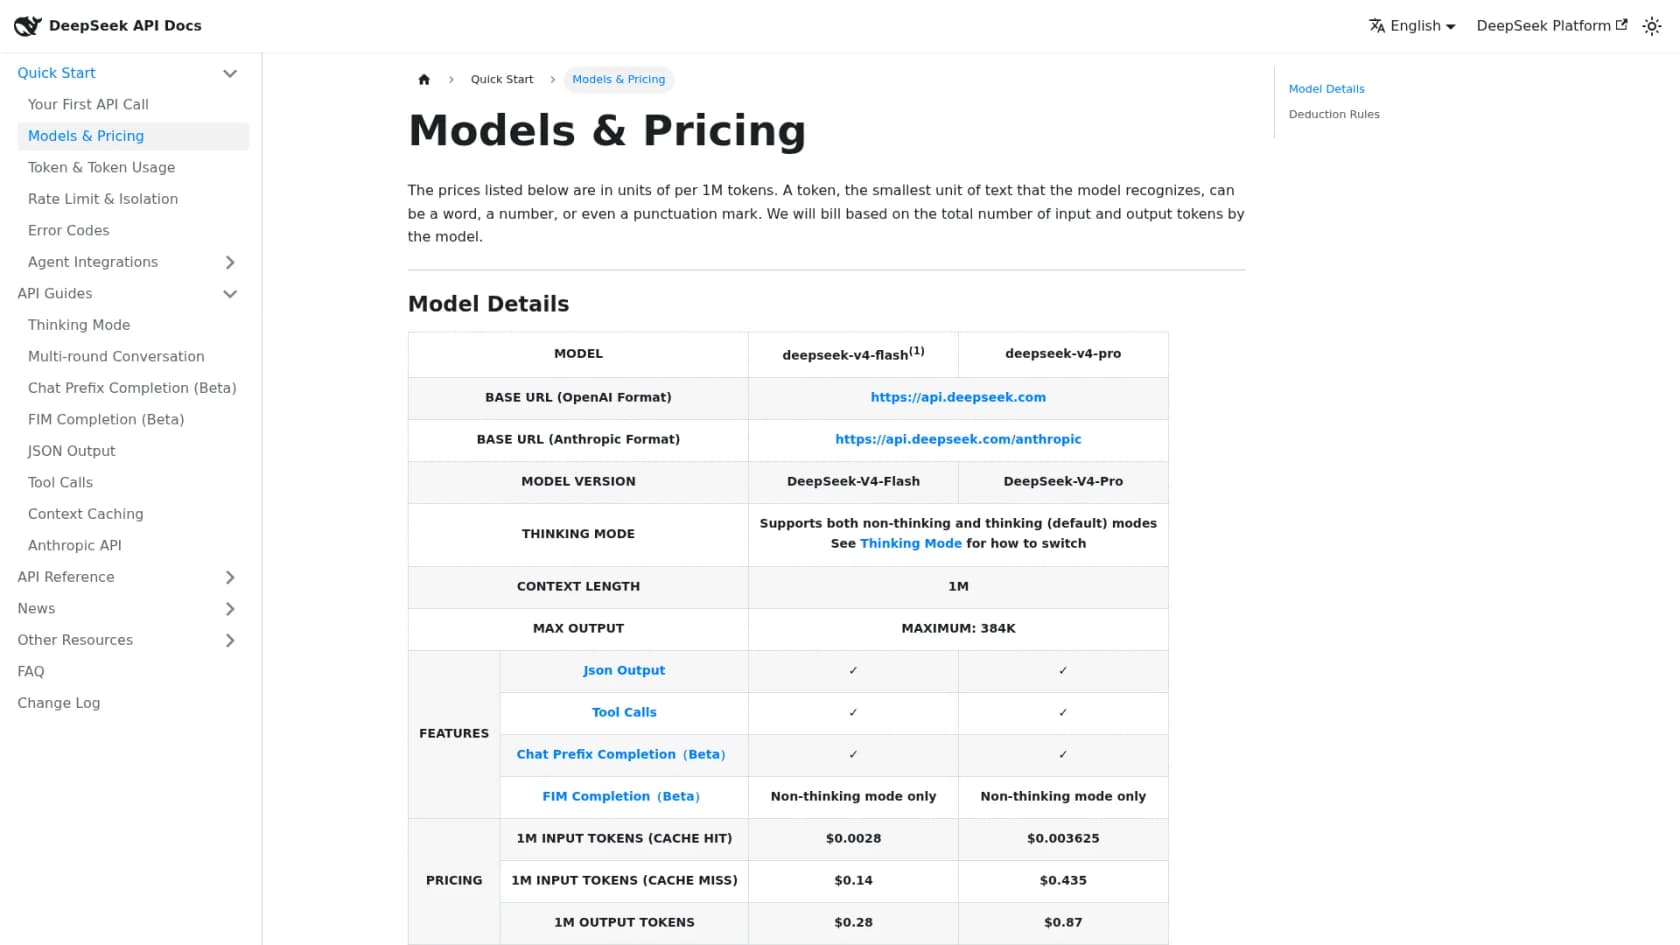
Les astérisques sont réels et méritent d'être posés clairement. La tarification comporte une surtaxe pic/hors pic : l'entrée avec échec de cache est de $0.22/$0.44 et la sortie de $0.66/$1.32 par million (hors pic / pic), le pic correspondant aux heures ouvrées chinoises, donc une file américaine ou européenne est majoritairement facturée hors pic. Le modèle est uniquement textuel, sans entrée image documentée. Et ses données résident en RPC sous droit de la RPC, tandis que les conditions de l'API payante restent silencieuses, sans autorisation explicite, sur l'usage à des fins d'entraînement. Cette combinaison en fait une mauvaise option de substitution directe pour des données clients réglementées, même s'il s'agit d'un moteur fantastique pour le code et les outils internes. Un développeur a résumé le cas d'usage pratique sans détour :
I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it. I use it as a coding assistant in my IDE so the results end up at the same quality I would write by hand.
Avantages : le coût par tâche le plus bas de tous, des poids ouverts sous licence MIT, et un contexte de 1M de tokens.
Inconvénients : uniquement textuel, verbeux avec un taux d'hallucination élevé, une particularité fragile de tarification en heures de pointe, et une résidence des données en RPC qui l'exclut pour les données clients sensibles.
Verdict : le champion du rapport qualité-prix pour le code et le travail interne où les données ne sont pas sensibles. Associez-le à notre guide sur les hallucinations de l'IA avant de le pointer vers quoi que ce soit en contact avec les clients.
7. GPT-6 Luna : la façon la moins chère de passer à l'échelle
Idéal pour : le travail à haut volume et à faibles enjeux où quelques points d'intelligence ne changent pas le résultat.
GPT-6 Luna est le niveau économique d'OpenAI, et il est agressivement bon marché à $0.10/$0.50 par million de tokens, une baisse nette de 50 % par rapport à GPT-5.6 Luna. Il partage le contexte de 1 050 000 tokens de Sol et l'entrée d'image native, et c'est le seul modèle GPT-6 disponible sur les forfaits Free et Go ($8) de ChatGPT. Le positionnement même d'OpenAI est « construisez avec Sol, passez à l'échelle avec Luna », et le marché semble d'accord ; le Luna précédent était déjà le modèle le plus utilisé sur OpenRouter.
6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model.
Le contrepoint honnête est que « le moins cher par token » et « le moins cher par tâche » ne sont pas la même chose. Sur des flux de codage fortement mis en cache, certains développeurs trouvent que des modèles ouverts comme DeepSeek reviennent finalement moins chers grâce au différentiel de lecture de cache, alors faites vos propres calculs si le cache domine votre usage.
Avantages : l'option la moins chère de la famille frontière fermée, une large fenêtre de contexte, et un accès gratuit pour tester.
Inconvénients : le plafond de raisonnement le plus bas de la lignée GPT-6, et des calculs par tâche qui peuvent perdre face aux modèles ouverts sur des travaux à forte mise en cache.
Verdict : le bon outil pour le volume, la classification, la traduction et les étapes d'agent simples. Ce n'est pas le modèle auquel vous confiez votre tâche de raisonnement la plus difficile, mais c'est un excellent cheval de bataille et un formidable choix par défaut pour les 80 % de tâches ennuyeuses.
8. Claude Sonnet 5 : restez dans la famille, payez moitié prix
Idéal pour : les équipes qui aiment le tooling et l'écosystème Claude mais n'ont pas besoin d'Opus à chaque appel.
Si la raison pour laquelle vous êtes sur Opus 5.5 est l'écosystème Claude, Claude Sonnet 5 est l'alternative maison évidente. Il coûte $2/$10 par million de tokens, exactement la moitié d'Opus, et Anthropic le positionne comme le meilleur équilibre entre vitesse et intelligence. Vous gardez la même API, la même intégration Claude Code et le même écosystème d'outils ; vous arrêtez simplement de payer des tarifs Opus pour des tâches qui n'ont pas besoin du raisonnement d'Opus.
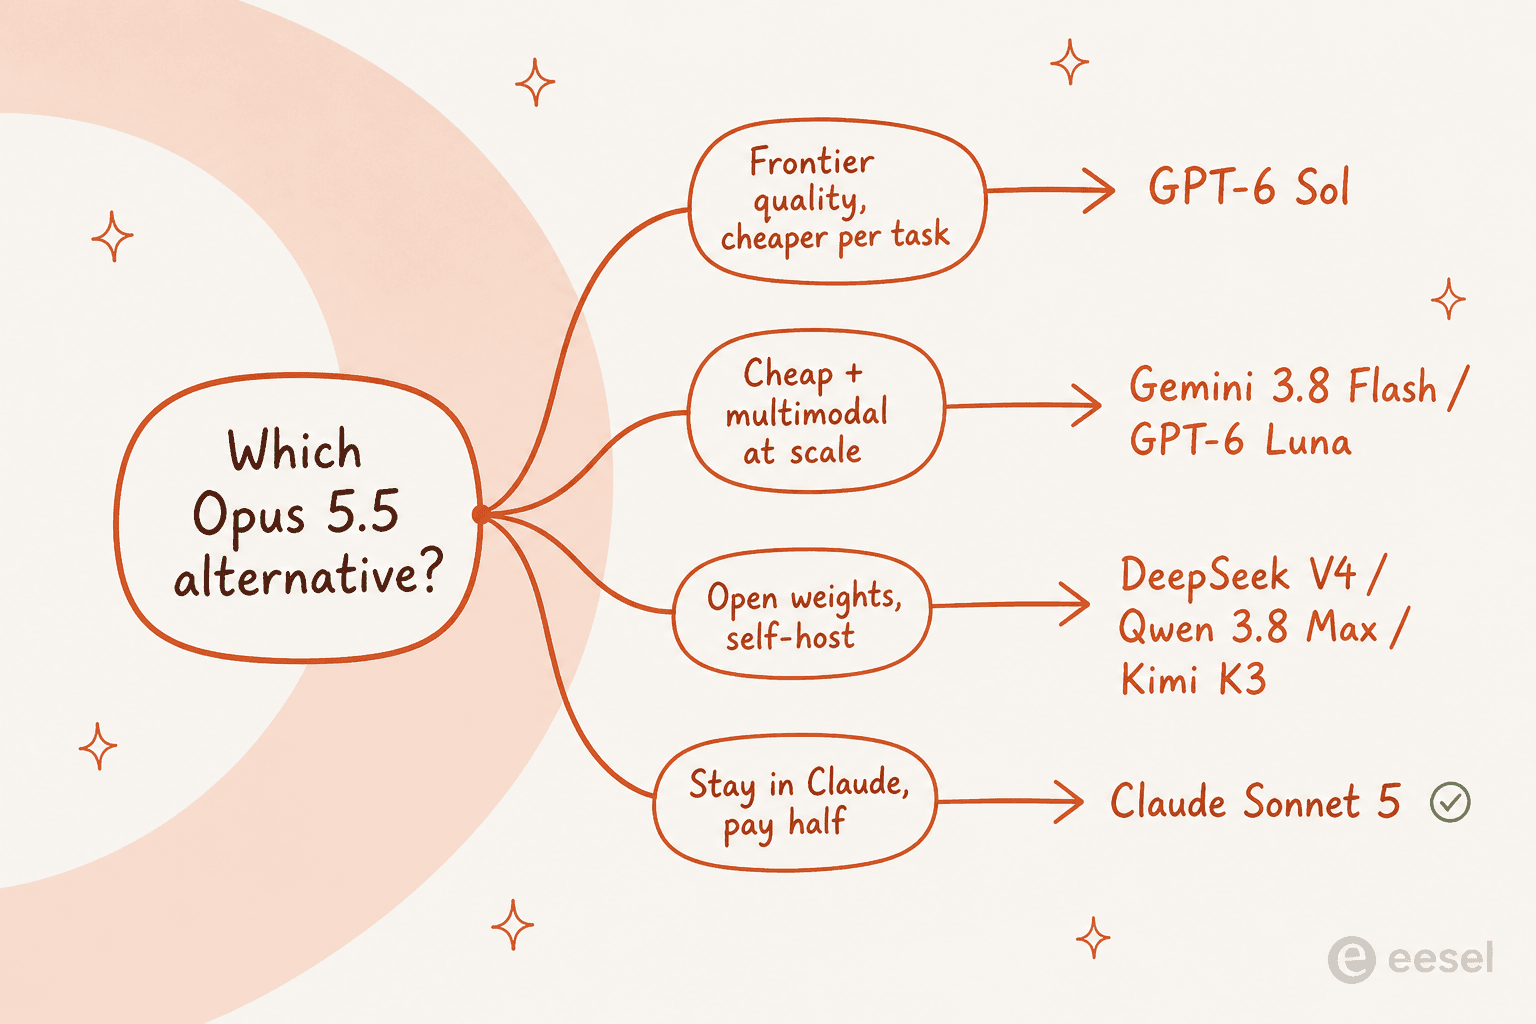
Le schéma le plus sensé que j'aie vu est une configuration à deux modèles : orienter les tâches difficiles et ambiguës vers Opus 5.5 et tout le reste vers Sonnet 5. Cela capte l'essentiel du plafond d'Opus sur les tâches qui en ont besoin, tout en réduisant la facture sur celles qui n'en ont pas besoin.
Avantages : moitié prix d'Opus, aucun changement d'écosystème, et le niveau d'Anthropic optimisé pour la vitesse.
Inconvénients : un plafond de raisonnement plus bas qu'Opus 5.5, et vous restez tout de même dans la tarification d'un seul fournisseur.
Verdict : l'alternative la moins contraignante de cette liste. Si vous êtes satisfait de Claude et voulez simplement dépenser moins, c'est le changement à faire avant d'aller chercher ailleurs.
Comment je choisirais vraiment
Retirez le classement, et la décision se résume à quelques questions honnêtes. Il n'y a pas de gagnant unique, car « le meilleur » dépend de la forme de votre charge de travail.
- Vous voulez ce qui se rapproche le plus d'Opus pour bien moins cher ? GPT-6 Sol. Une qualité proche de la pointe, environ un cinquième du coût par tâche.
- Vous exécutez des travaux asynchrones et multimodaux à grande échelle ? Gemini 3.8 Flash pour la portée et le prix, ou GPT-6 Luna pour le tarif par token le plus bas.
- Vous avez besoin de poids ouverts ? DeepSeek V4 pour le plancher de coût, Qwen 3.8 Max pour le meilleur benchmark, Kimi K3 si vous avez aussi besoin de vision.
- Satisfait de Claude ? Sonnet 5 à moitié prix, idéalement orienté aux côtés d'Opus pour les tâches difficiles.
Et il y a un point plus discret derrière tout cela, sur lequel les développeurs expérimentés reviennent sans cesse. Les benchmarks sont un coup d'envoi, pas un verdict :
Only hands-on experience matters in the end, and these days it's very easy to switch models.
Cette dernière phrase, « very easy to switch models », est la vraie histoire de 2026. Ce qui amène à la question que la plupart de ces comparatifs évitent.
Essayez eesel : le coéquipier qui tourne sur n'importe lequel de ces modèles
Voici ce que tout article modèle contre modèle suppose silencieusement : que votre travail consiste à choisir un modèle, à câbler son API, à gérer le prompt engineering, à le connecter à vos outils, et à empêcher tout cela d'halluciner sur de vrais clients. Pour la plupart des équipes, ce n'est pas le travail. Le travail, c'est un taux de résolution plus élevé, ou des articles publiés. Le modèle n'est que le moteur.
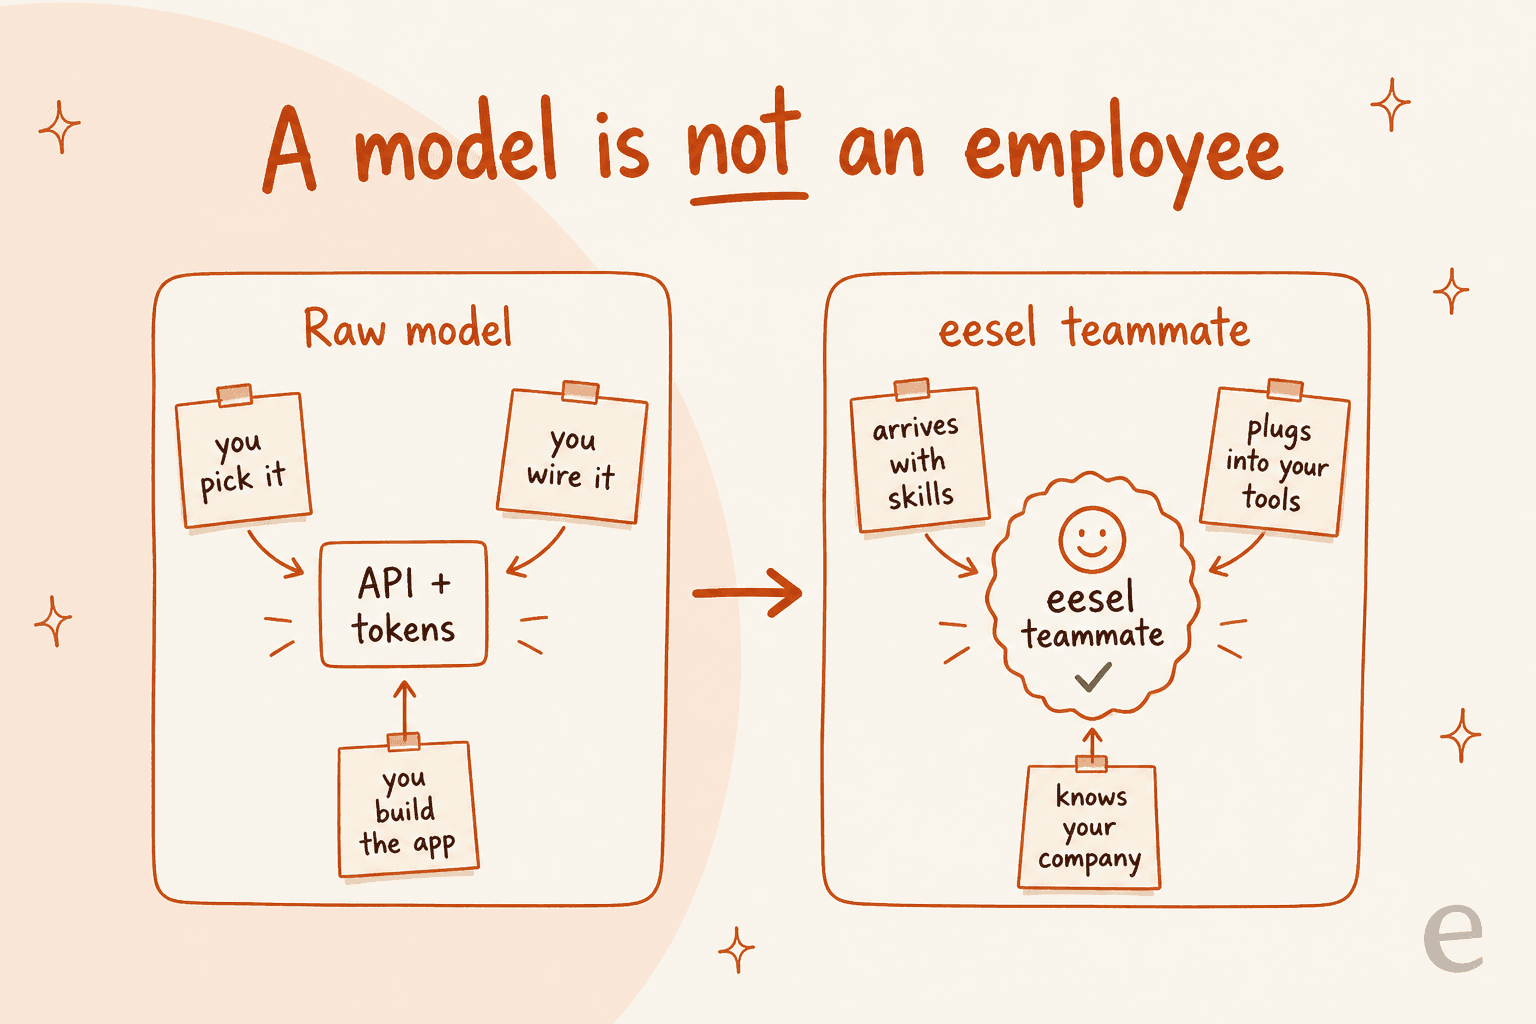
C'est ainsi que je présenterais eesel. C'est une plateforme de coéquipiers IA, et vous embauchez des coéquipiers prêts à travailler pour des tâches spécifiques. L'équipe actuelle comprend un coéquipier IA de helpdesk qui rejoint votre file de support existante et un rédacteur de blog IA qui rédige des articles documentés. Chacun arrive déjà en sachant faire son travail, branché sur vos outils, et ancré dans le contexte de votre entreprise, si bien que ce n'est pas vous qui choisissez entre Opus 5.5 et Sol en surveillant un prompt. Comme le modèle se trouve en dessous du coéquipier, un modèle moins cher ou meilleur qui sort le mois prochain est une mise à niveau gratuite, pas une reconstruction.

Si vous êtes le genre de personne qui lit un article d'alternatives de modèles, vous allez aimer cette partie : le tout se pilote depuis le terminal. La CLI eesel (npx @eesel/cli) vous permet de connecter des intégrations, de modifier les instructions permanentes de l'agent, de simuler un déploiement sur vos tickets historiques, d'approuver des actions, et de lire le journal d'activité de chaque exécution, le tout en JSON, avec un flag --dry-run qui affiche l'appel exact qu'une écriture ferait avant de l'envoyer. Chaque espace de travail est aussi un serveur MCP, donc des agents de codage comme Claude Code, Codex et Cursor peuvent piloter le même coéquipier. C'est le même produit que le tableau de bord, mis à disposition des personnes et des agents qui vivent dans un terminal. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Quelle est la meilleure alternative à Claude Opus 5.5 ?
Combien coûte Claude Opus 5.5, et les alternatives sont-elles moins chères ?
Existe-t-il des alternatives open source à Claude Opus 5.5 ?
Quelle alternative à Claude Opus 5.5 convient le mieux aux agents de codage ?
Dois-je choisir un seul modèle pour construire un agent de support IA ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.