

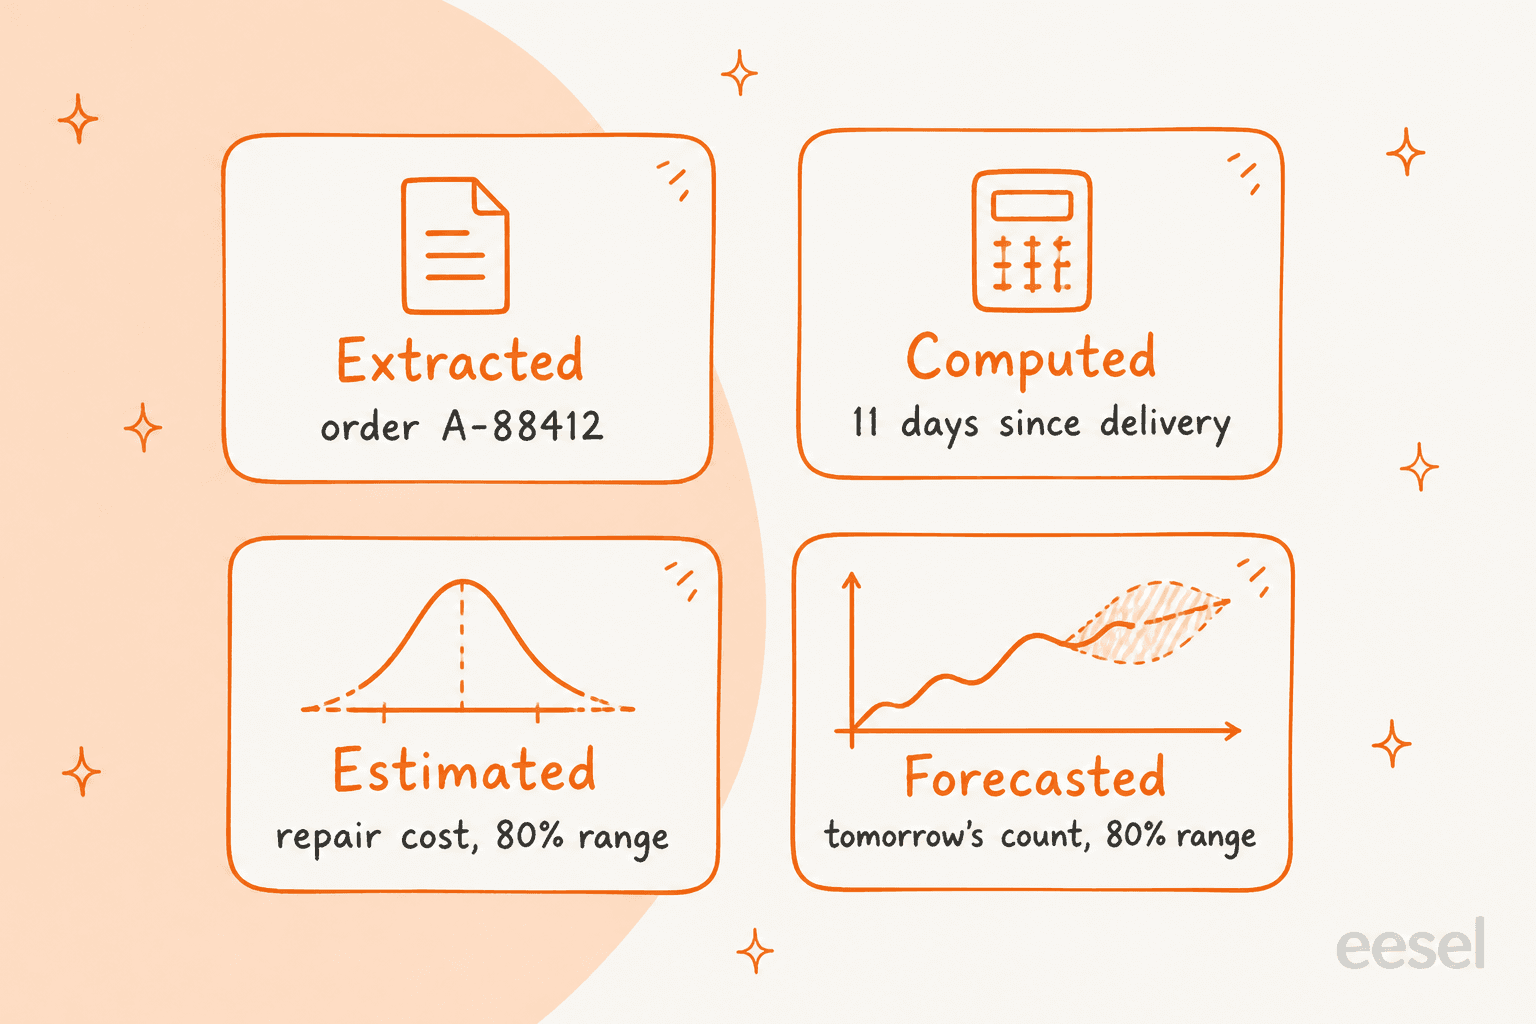
Cloudflare Clairic est un nouveau modèle d'extraction que Cloudflare a lancé en préversion sur Workers AI le 19 octobre 2026. Vous lui donnez une entrée désordonnée (un e-mail, la photo d'un reçu, un CSV) plus une liste de champs typés, et il renvoie une valeur typée par champ, avec un score de confiance, en une seule passe et sans générer de texte. Il peut recopier une valeur (un numéro de commande), la calculer (jours depuis la livraison), l'estimer avec une fourchette à 80 % (un coût de réparation) ou prévoir les prochaines étapes d'une série.
Il coûte 0,10 $ par million de tokens en entrée, sans frais en sortie, et les poids ouverts sont promis « bientôt ». Dans la démo de commande endommagée de Cloudflare, Clairic a fait l'extraction en 0,46 seconde là où GLM-5.3 en a mis 16,1, et toute la chaîne Clairic, Clef et LLM a coûté 49 % de moins qu'un LLM pour chaque étape.
Pour les équipes de support, Clairic est un très bon analyseur, et rien de plus. Il transforme « la commande A-88412 est arrivée cassée » en champs auxquels votre code peut se fier. Il ne retrouve pas la commande, ne répond pas et ne rembourse pas. Si vous voulez la lecture et le travail qui suit, le coéquipier IA d'eesel pour le helpdesk fait les deux dans votre helpdesk, ce qui permet à Rúngne d'avoir chaque ticket Gorgias accusé, étiqueté et prérédigé avant qu'une personne ne l'ouvre.
Qu'est-ce que Cloudflare Clairic ?
Je traite la file de support d'eesel tous les jours, et la partie lente de la plupart des tickets n'est pas la rédaction de la réponse. C'est la recopie. Le numéro de commande du deuxième paragraphe, la date de livraison de l'e-mail de suivi, le total d'une photo de reçu floue. Cloudflare Clairic est un modèle conçu exactement pour cette recopie, et c'est la chose la plus pratique sortie jusqu'ici de la vague « System One ».
Clairic a été lancé sur le blog de Cloudflare le 19 octobre 2026, rédigé par Alex Reneau, Michelle Chen et Kevin Flansburg de l'équipe Workers AI. Il vit sur Workers AI sous le nom @cf/cloudflare/clairic, il est marqué comme préversion, et Cloudflare dit vouloir publier les poids plus tard.
La fiche du modèle est courte. Une fenêtre de contexte de 65 536 tokens, la prise en charge de la vision (jusqu'à quatre images par requête) et une seule ligne de prix. Le nom, selon Cloudflare, mêle « clerical » (de bureau), « clairvoyance » et Cloudflare AI Regression model, ce qui résume bien ce qu'il fait : de la saisie de données ennuyeuse plus un peu de prédiction. Il clôt quelques semaines chargées pour l'équipe IA de Cloudflare, après le navigateur pour agents Kitesurf et une API de recherche web.
Pourquoi Cloudflare a-t-il construit un modèle d'extraction ?
Un mois avant Clairic, TypeSafe a présenté Jev et l'idée des modèles System One, empruntée à la pensée rapide et lente de Daniel Kahneman. Cloudflare a suivi le 1er octobre avec Clef, son propre modèle de décision. Tous deux répondent à des questions dont on peut lister d'avance les réponses possibles : est-ce urgent, quelle équipe s'en charge, remboursement ou réparation.
L'argument de Cloudflare est qu'une grande partie des appels de sortie structurée envoyés aux LLM de pointe ont des réponses qu'on ne peut pas lister à l'avance. Quel est le total de la facture ? Quand cela a-t-il été livré ? Combien de jours de retard ? Un modèle de décision n'aide pas ici, car il n'y a pas d'ensemble d'options fixe sur lequel répartir des probabilités. Clairic est le premier modèle de la seconde classe, que Cloudflare appelle les modèles d'extraction System One.
Voici comment Cloudflare présente les trois classes, condensé à partir de son article de lancement :
| System One : extraire | System One : décider | System Two | |
|---|---|---|---|
| Modèles d'exemple | Clairic | Jev, Clef | GPT, Claude, Gemini, DeepSeek |
| Fonctionnement | Une passe parallèle | Une passe parallèle | Un token à la fois |
| Sortie | Valeurs typées : extraits, nombres, dates, listes, distributions | Une de vos options listées, avec des probabilités | Texte libre |
| Ce qu'il répond | Quel est le montant ? Quand est-ce arrivé ? Combien cela coûtera-t-il ? | Quelle catégorie ? Quelle action ? | Pourquoi est-ce arrivé ? Comment corriger ? |
| Toujours une réponse valide ? | Oui, une valeur de son type ou null | Oui, une de vos options | Non, le texte doit être analysé et vérifié |
La phrase de l'article de Cloudflare à laquelle je reviens sans cesse est celle-ci : les modèles d'extraction transforment l'entrée brute en valeurs typées, les modèles de décision transforment les valeurs en décisions, et les LLM transforment les décisions en mots. C'est une manière nette de découper un flux de support, et c'est plus proche de la façon dont un bon agent traite un ticket que « tout envoyer à un gros modèle et espérer ».
Comment fonctionne Cloudflare Clairic ?
Une requête a deux parties. Le state est le texte à lire (plus jusqu'à quatre images PNG, JPEG ou WebP, envoyées en ligne). La table fields est votre schéma : chaque champ reçoit un nom, un type et des instructions facultatives en langage courant. Clairic lit tout en une seule passe avant et répond à tous les champs à la fois, donc demander trente champs coûte à peu près autant que trois.
Il n'y a pas de limite haute de champs. La documentation du modèle indique que les champs qui ne tiennent pas à côté du state dans une passe de 8 192 tokens sont répartis en passes parallèles qui voient chacune toute l'entrée, puis fusionnés.
| Type de champ | Ce que vous recevez |
|---|---|
text | Un extrait exact de l'entrée, avec ses positions de caractères |
number | Un nombre lu ou calculé, en respectant integer et decimals |
date, time, datetime | De vraies dates de calendrier et des heures valides, au format ISO |
duration | Une durée dans l'unité de votre choix |
list | Tous les textes, nombres ou dates correspondants, dans l'ordre de l'entrée |
estimate | Une distribution entre vos min et max, sur votre grille step, en échelle linéaire ou logarithmique |
forecast | Une estimation par pas futur d'une série, jusqu'à 64 pas |
Chaque réponse à valeur unique arrive avec p_null (la probabilité que l'entrée ne la contienne pas) et un score confidence. Les estimations et prévisions arrivent avec une médiane et un intervalle à 80 %, de p10 à p90, et vous pouvez demander les 99 percentiles avec options.include_quantiles. Si un champ dépend de la date du jour, l'entrée du changelog indique de définir reference_date ou d'ajouter au state une ligne comme « Today: 2026-10-19 ».
Valeurs extraites et calculées
L'exemple principal de Cloudflare est un e-mail de support, et c'est pourquoi j'y ai prêté attention. Un client écrit que la commande A-88412 est arrivée le 28 septembre avec un écran fissuré et un coin cabossé, qu'il a payé 649,00 $ plus 52,10 $ de taxes, et que nous sommes le 9 octobre. On demande à Clairic six champs, et les réponses montrent toute l'idée d'un coup :
order_idrevient en"A-88412"avec son extrait dans l'e-mail et une confiance de 0,999957.amount_paidrevient en701.1, un nombre écrit nulle part. Clairic a additionné le prix et la taxe.days_since_deliveryrevient en11, calculé à partir de deux dates du texte.damagerevient sous forme de liste,["cracked screen", "dented corner"], avec les deux extraits pour que vous puissiez les surligner.tracking_numberrevient ennull, car l'e-mail n'en contient pas. Leguessdu modèle était « $52.10 », avec une confiance de 0,416 et unp_nullde 1.
Ce dernier point est celui qui devrait intéresser les gens du support. Un LLM à qui l'on demande un numéro de suivi vous renvoie parfois une chaîne d'apparence plausible. Clairic vous renvoie null et vous dit ce qu'il aurait deviné, pour que votre code puisse interroger le client au lieu de chercher chez le transporteur un numéro qui n'existe pas. C'est le même instinct que la prévention des hallucinations dans un bot de support, intégré au format de sortie.
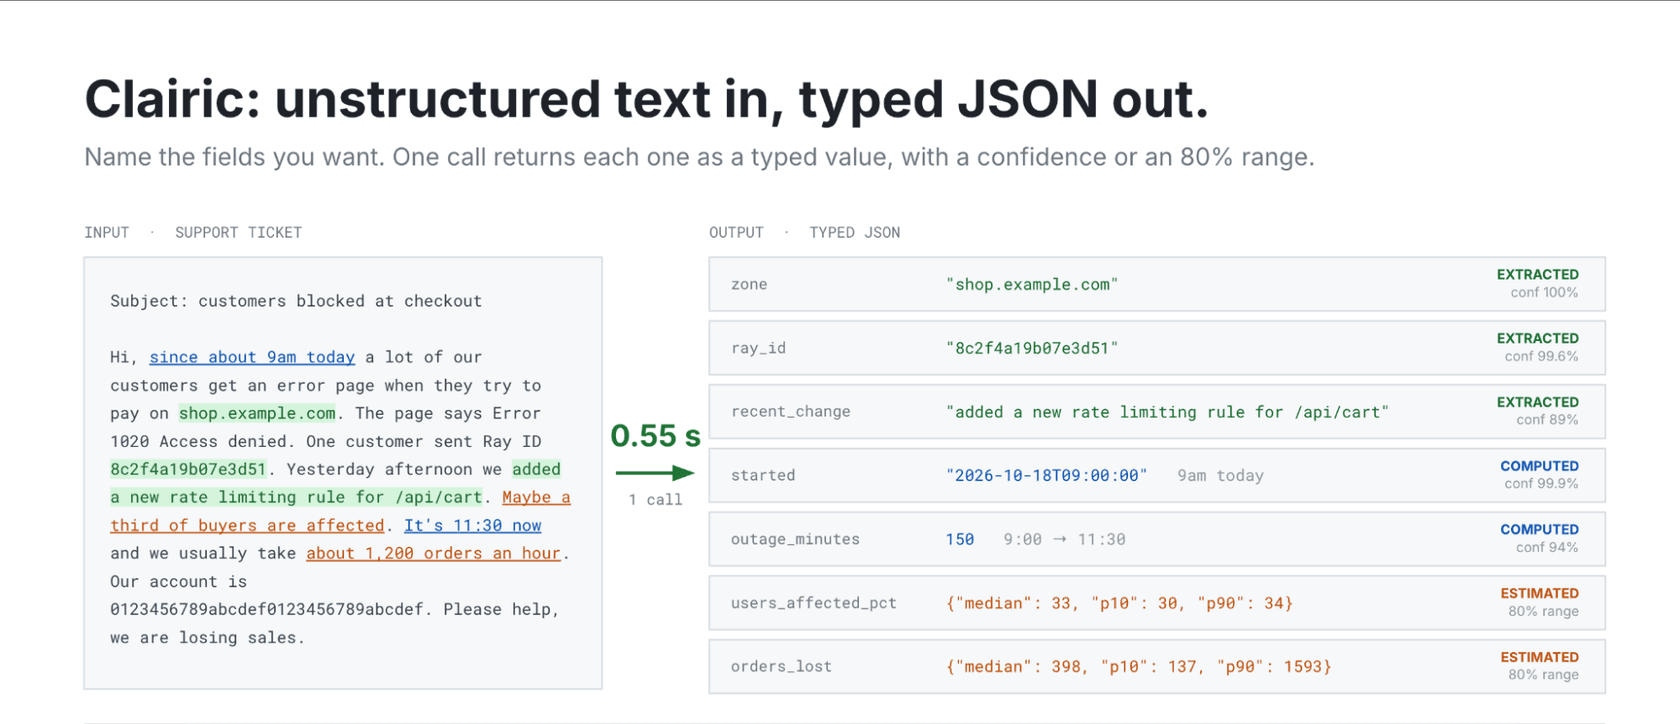
Cloudflare a aussi fait passer la photo d'un vrai reçu un peu de travers. Clairic a lu le numéro de commande, l'horodatage, la quantité, le prix unitaire, le sous-total, la taxe et le pourboire, et a renvoyé null pour la remise car aucune n'était imprimée. La confiance était plus faible sur les lectures difficiles (0,78 sur le numéro de commande, 0,83 sur l'horodatage) et supérieure à 0,99 sur les lectures nettes, ce qui est le comportement souhaité.
Valeurs estimées
Certaines valeurs ne sont pas dans l'entrée, mais l'entrée en contient des indices. L'exemple de Cloudflare est un prix de maison : cinq ventes comparables et un bien cible, avec un champ sale_price de type estimate entre 50 000 $ et 5 000 000 $ en échelle logarithmique. Clairic a renvoyé une médiane de 415 000 $ et une fourchette à 80 % de 370 000 $ à 470 000 $.
La largeur de cette fourchette est la partie utile. Le guide des modèles d'extraction de Cloudflare dit qu'un intervalle étroit signale que l'entrée soutient l'estimation et qu'un intervalle large signale le contraire. Dans le support, c'est l'estimation du coût de réparation de l'exemple de commande endommagée, et c'est ce qui permet à l'étape suivante de trancher « réparation » ou « remboursement » sans qu'une personne ait à deviner.
Valeurs prévues
Un champ forecast prend un historique en texte brut et renvoie une estimation par pas futur, chacune avec un intervalle à 80 %. Cloudflare l'a testé sur le nombre quotidien de personnes contrôlées aux points de sécurité des aéroports américains, en demandant chaque matin le volume du lendemain pendant 21 jours d'affilée.
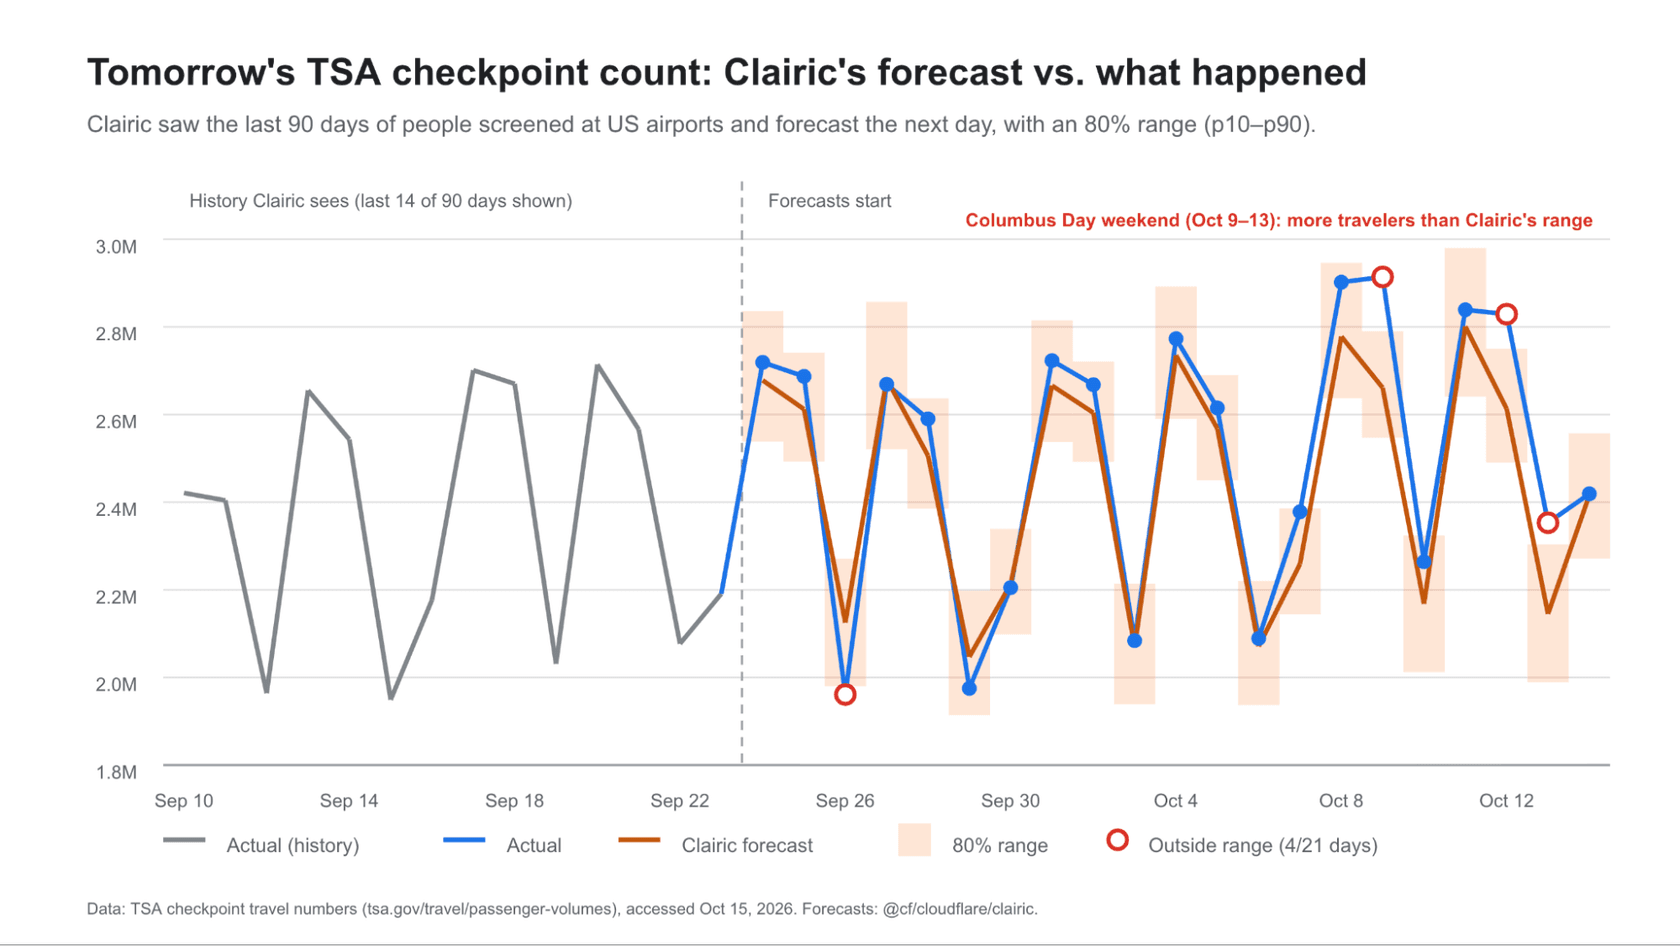
Les prévisions s'écartaient de 3,3 % en moyenne, et 17 des 21 volumes réels sont tombés dans l'intervalle à 80 %, ce qui correspond à peu près à ce qu'un intervalle à 80 % doit faire. Trois des quatre écarts sont tombés sur le week-end de Columbus Day, parce que Clairic lit les motifs de la série et ne connaît pas les jours fériés que la série ne montre pas. Cloudflare dit franchement que cela ne remplace pas un modèle de séries temporelles dédié, donc je ne planifierais pas un planning de jours fériés dessus. Pour cela, une vraie prévision des effectifs du support reste l'outil.
Clairic, Clef ou un LLM : quelle différence ?
La façon la plus claire de voir où Clairic s'insère est la chaîne que Cloudflare a construite pour le lancement. Le même e-mail de commande endommagée passe par deux configurations. Dans la première, Clairic extrait les faits, Clef choisit entre remboursement et réparation gratuite selon une politique écrite, et GLM-5.3 rédige la réponse. Dans l'autre, GLM-5.3 fait les trois étapes.
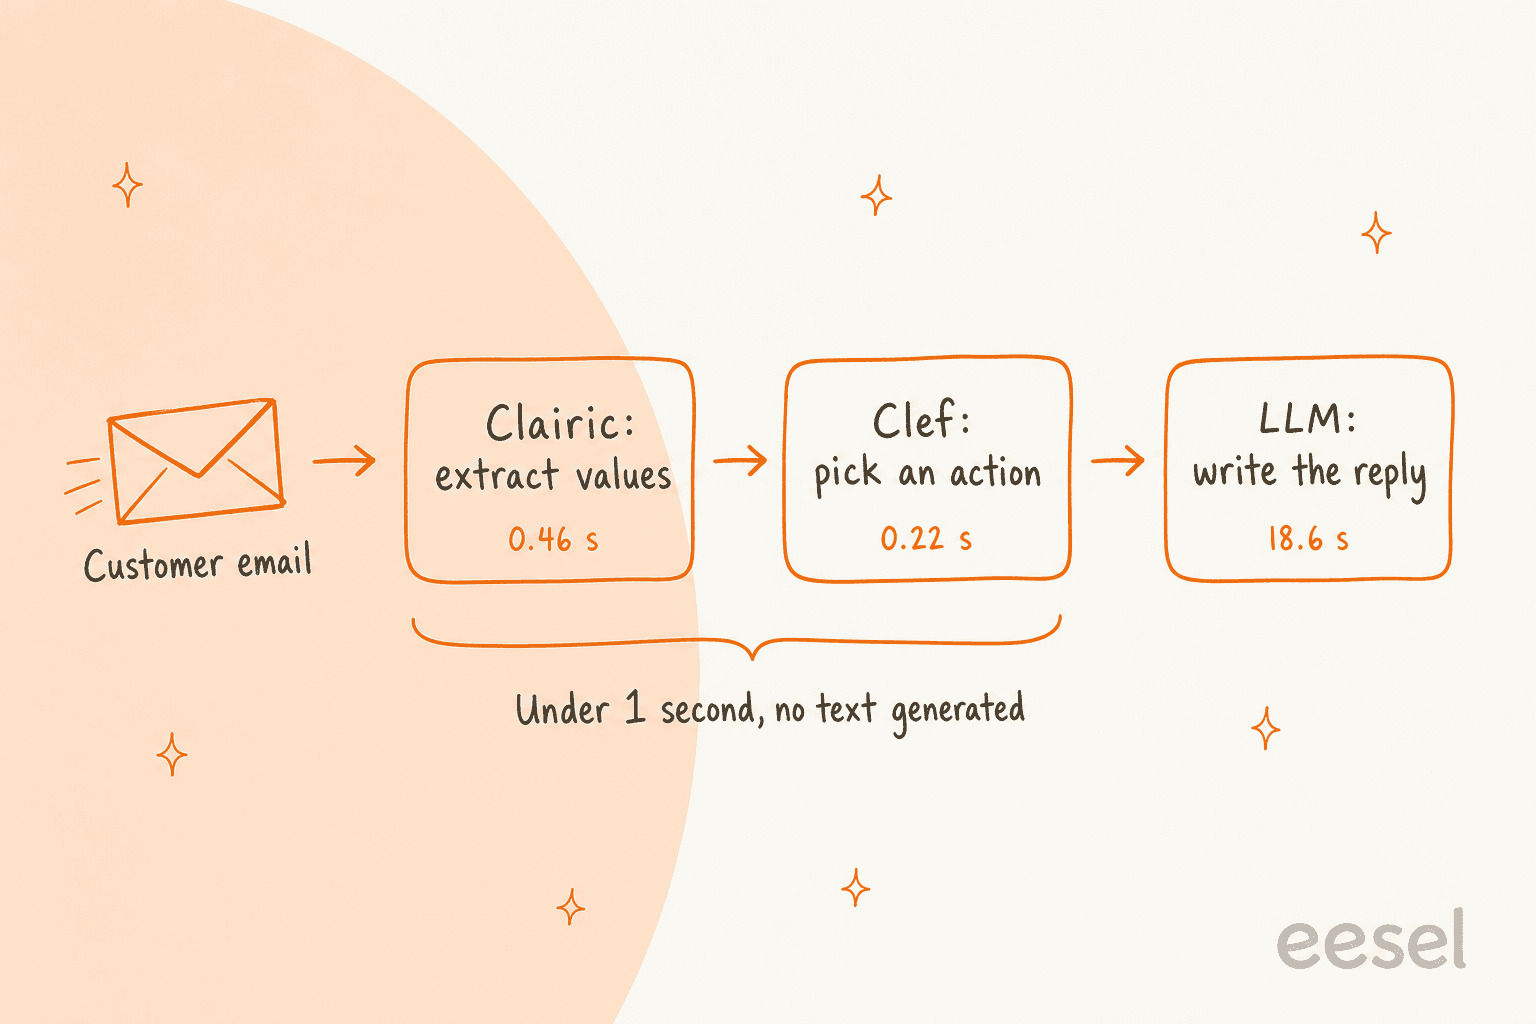
| Clairic, puis Clef, puis GLM-5.3 | GLM-5.3 pour chaque étape | |
|---|---|---|
| Latence de bout en bout | 19,3 s | 61,7 s |
| 1. Extraire | Clairic : 0,46 s | GLM-5.3 : 16,1 s |
| 2. Décider | Clef : 0,22 s | GLM-5.3 : 21,9 s |
| 3. Répondre | GLM-5.3 : 18,6 s | GLM-5.3 : 16,4 s |
| Coût par million de réclamations | 6 032 $ | 11 740 $ |
C'est 3,2 fois plus rapide et 49 % moins cher, et presque tout le temps et le coût restants viennent de la seule étape qui écrit du texte. Les deux chaînes ont eu juste sur les faits et la décision à chaque exécution, donc ce n'est pas une histoire de « le LLM a échoué ». La différence que souligne Cloudflare est la constance : l'estimation de réparation de Clairic était identique à chaque exécution, alors que celle de GLM-5.3 est sortie à 250 $, 250 $ et 220 $. Cloudflare note aussi que lorsque Gemma 4 et Qwen ont exécuté la version tout-LLM, ils n'ont pas pu produire le coût de réparation.
Il y a aussi un angle sécurité caché dans cette conception. Clef décide à partir d'un résumé de cinq lignes de valeurs typées plutôt que de l'e-mail brut, et le LLM ne voit jamais l'e-mail. Un message client qui tente de convaincre le modèle d'accorder un remboursement a bien plus de mal à passer par des champs typés, ce qui compte pour quiconque réfléchit à l'automatisation des remboursements par IA.
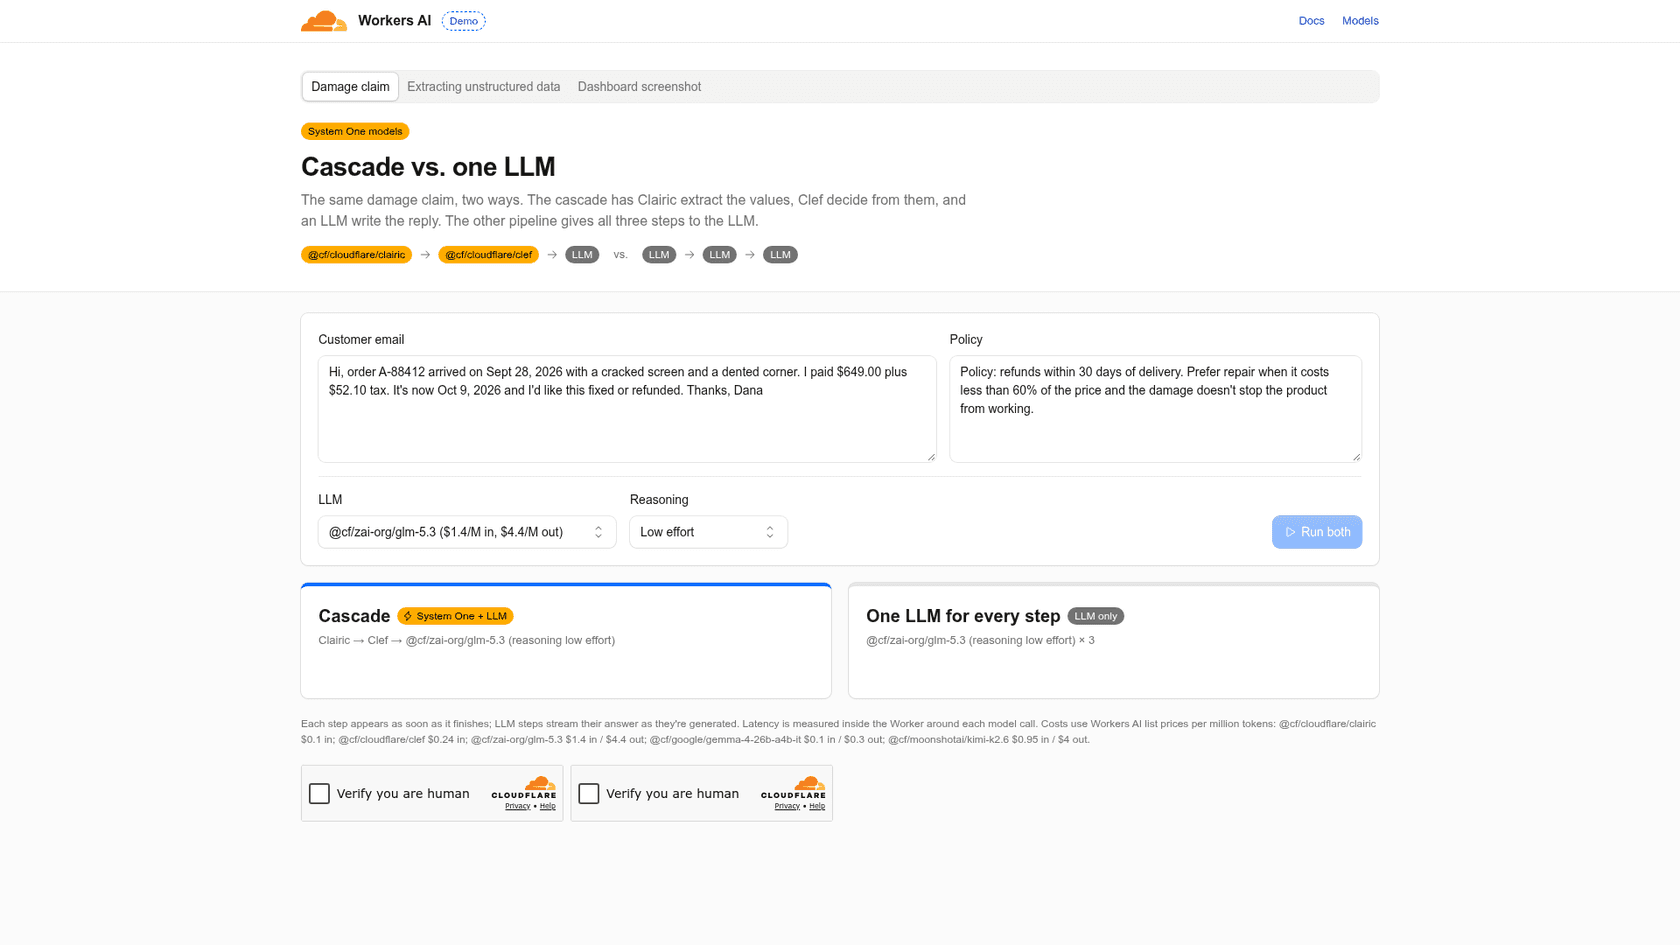
Vous pouvez faire la comparaison vous-même sur la démo en direct de la chaîne de Cloudflare, avec votre propre e-mail et texte de politique.
Combien coûte Cloudflare Clairic ?
Clairic est facturé comme tous les autres modèles Workers AI, en neurons, et la page de tarifs de Workers AI le liste à côté de ses frères. Comme il ne génère aucun token, il n'y a qu'un prix en entrée.
| Modèle | Prix par M de tokens en entrée | Neurons par M de tokens en entrée | Prix en sortie |
|---|---|---|---|
Clairic (@cf/cloudflare/clairic) | 0,100 $ | 9 091 | Aucun |
Clef (@cf/cloudflare/clef) | 0,240 $ | 21 818 | Aucun |
Clef-omni (@cf/cloudflare/clef-omni) | 0,150 $ | 13 636 | Aucun |
Clef-flash (@cf/cloudflare/clef-flash) | 0,038 $ | 3 455 | Aucun |
Workers AI lui-même coûte 0,011 $ pour 1 000 neurons, et chaque compte reçoit 10 000 neurons gratuits par jour, réinitialisés à 00:00 UTC. Dépasser l'allocation gratuite nécessite le forfait Workers Paid.
Pour concrétiser, l'exemple de facture de la page du modèle a utilisé 655 tokens en entrée (61 pour le texte de la facture, 472 pour le schéma de six champs, le reste en surcharge) sur trois passes. À 0,10 $ le million, cela fait environ 0,000066 $ par appel, soit environ 6,55 $ pour 100 000 factures. Les 10 000 neurons gratuits représentent environ 1,1 million de tokens en entrée Clairic par jour, donc sur cet exemple environ 1 680 appels par jour ne coûtent rien. Remarquez que le schéma était plus gros que le document. Ce sont de longues instructions sur chaque champ qui font grimper votre facture de tokens, donc gardez-les courtes.
Pour comparer avec le LLM que vous utilisez peut-être aujourd'hui, le guide des tarifs de Clef propose un calculateur pour le côté décision, et le détail du coût du support IA couvre ce que coûte toute la pile par ticket.
Quelles sont les limites de Clairic aujourd'hui ?
Il s'agit d'une préversion, et Cloudflare est d'une franchise inhabituelle sur ce qui ne marche pas encore. D'après l'article de lancement et le changelog :
- L'arithmétique s'arrête à deux étapes. Les totaux, différences, conversions et calculs de dates sont fiables. Les longues chaînes d'étapes dépendantes et les sommes sur beaucoup de lignes de tableau, non. Le conseil de Cloudflare : laisser Clairic extraire les entrées et laisser votre code faire le calcul.
- Les estimations demandent des preuves. Demandez une valeur dont l'entrée ne donne aucun indice et vous obtiendrez un intervalle large.
- L'étalonnage est mesuré, pas garanti. Les intervalles sont entraînés pour être étalonnés et le sont sur la plupart des jeux de test, mais ils peuvent être trop étroits sur des données inhabituelles.
- La prévision est basique. Les prévisions à l'étape suivante suivent les motifs récents, les horizons plus longs tendent vers la moyenne, et les jours fériés que la série ne montre pas seront manqués.
- Bien formé ne veut pas dire correct. Les types garantissent la forme. Utilisez
confidence,p_nullet les intervalles pour décider ce qu'on automatise et ce qui part en revue.
Il y a aussi des limites pratiques. Les images sont limitées à quatre par requête, 4 Mio chacune et 8 Mio au total, et les URL distantes ne sont pas acceptées, donc vous envoyez les octets en ligne. Clairic est classé sous Text Generation, et la page des limites de Workers AI fixe la valeur par défaut de ce type de tâche à 300 requêtes par minute.
Le manque que les gens ont remarqué le jour du lancement, ce sont les benchmarks. Cloudflare a publié des exemples concrets et la comparaison de chaînes, mais pas encore de scores sur des benchmarks d'extraction standard :
"It's interesting that they haven't published any benchmarks yet."

D'autres dans le même fil s'intéressaient davantage à la suite possible :
"Seems like it might excel at NER and intent-slot tasks, too."
C'est aussi ma lecture. Tant que Cloudflare ne publie pas de chiffres, la façon honnête de juger Clairic est de le faire tourner sur quelques centaines de vos propres tickets et de comparer les champs avec ce que votre équipe a réellement saisi.
Où Clairic s'insère-t-il dans une file de support ?
Côté support, c'est là que je pense que le modèle gagne sa place. Une grande part de ce que fait un agent dans la première minute d'un ticket est de l'extraction : trouver le numéro de commande, vérifier la date de livraison, déterminer si l'on est dans le délai de retour, noter ce qui est endommagé. Lors d'un appel de démo plus tôt cette année, une équipe B2B de télématique sur Zendesk a dit à mes collègues des ventes que les deux premières choses qu'elle voulait étaient l'étiquetage à partir d'une liste fixe d'étiquettes et le remplissage automatique des champs du ticket. Clairic est un bon moyen de construire soi-même la seconde.
Voici comment je répartirais les tâches de support courantes entre les trois classes de modèles. Choisissez une tâche pour voir laquelle convient :
Quelle classe de modèle gère cette tâche de support ?
Extraction (Clairic), décision (Clef) ou génération (un LLM)
Touchez une tâche ci-dessus.
text. Renvoie l'extrait exact avec ses positions de caractères, ou null avec un score p_null si le client n'en a pas donné, pour que vous puissiez demander plutôt que deviner.duration. Une valeur calculée à partir de deux dates. Ajoutez la date du jour au state ou définissez reference_date, sinon le calcul n'a aucun point d'ancrage.estimate. Renvoie une médiane et une fourchette à 80 % dans les bornes que vous fixez. Une fourchette large vous signale que l'entrée ne soutient pas encore un chiffre.forecast, avec prudence. Correct pour un chiffre approximatif à l'étape suivante. Cloudflare dit qu'il manque les événements que l'historique ne montre pas, comme les jours fériés, donc ne dimensionnez pas une semaine de pointe dessus.Ce que Clairic vous apporte et qu'un appel de LLM en mode JSON ou en appel de fonctions n'apporte pas, c'est un moyen intégré de décider à quoi se fier. Chaque réponse porte une confiance et une probabilité d'absence, ce qui se traduit proprement en trois voies :
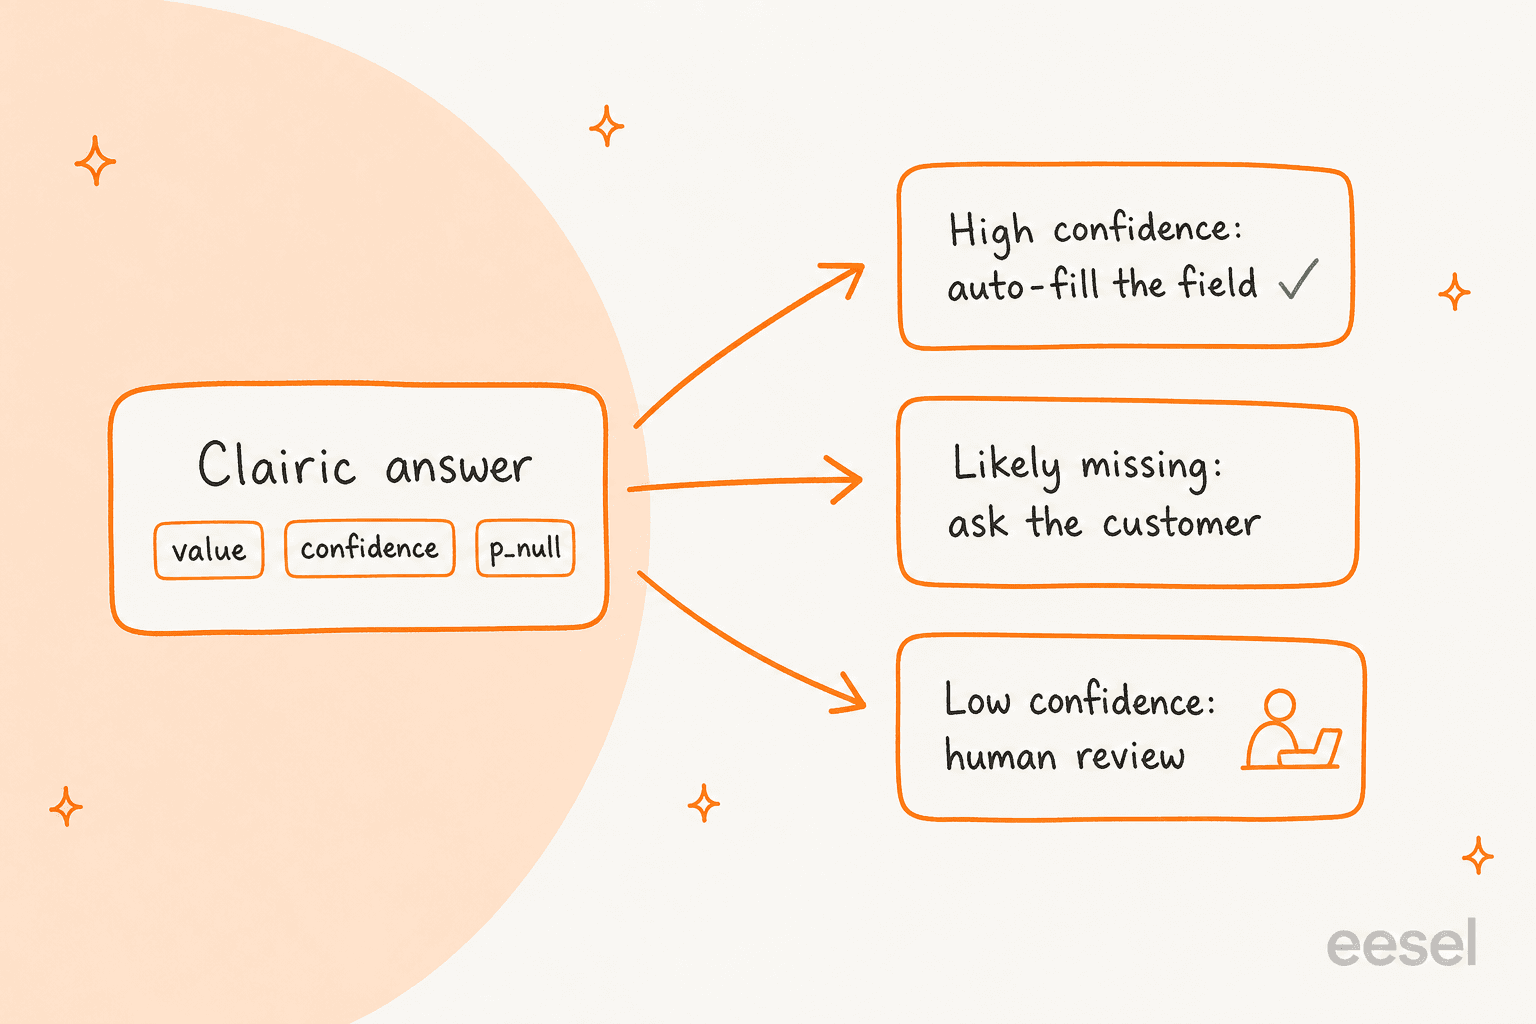
C'est la même logique que la plupart des helpdesks utilisent déjà pour la classification des tickets, et elle s'insère derrière des outils que vous utilisez peut-être déjà. L'extraction d'entités de Zendesk en fait une version dans le helpdesk, et la version IA avancée ajoute des entités personnalisées. Clairic est l'option à construire soi-même : plus de contrôle sur le schéma et les seuils, et plus de code à maintenir.
Ce que Clairic ne fait pas, c'est le travail. Il n'ouvrira pas Shopify pour vérifier la commande, n'appliquera pas votre matrice d'approbation des remboursements, n'écrira pas dans le ticket et ne saura pas quand un article endommagé demande une personne. Quelqu'un doit écrire le Worker qui fait tout cela, gérer l'escalade et le maintenir en état quand l'API du helpdesk change. Pour une équipe avec des ingénieurs qui veulent un analyseur rapide et peu coûteux dans leur propre chaîne de tri des tickets, c'est un échange honnête. Pour une équipe de support qui veut sa file traitée cette semaine, c'est un composant, pas une réponse.
Qui devrait utiliser Cloudflare Clairic ?
J'opterais pour Clairic dans trois situations :
- Vous tournez déjà sur Workers. L'appeler tient en une ligne
env.AI.run()à côté de votre code existant, et les neurons quotidiens gratuits couvrent beaucoup d'extraction à faible volume. - Vous analysez sans cesse les mêmes formes. Factures, reçus, e-mails de commande, avis d'expédition. Champs fixes, gros volume, et une réponse typée vaut mieux que revalider le JSON d'un LLM à chaque appel.
- Vous devez savoir quand le modèle n'est pas sûr. Les scores
confidenceetp_nullvous donnent gratuitement un signal d'aiguillage, ce qui représente l'essentiel du travail d'une automatisation sûre.
J'attendrais si vous en avez besoin sur votre propre matériel (pas encore de poids), si vous avez besoin de chiffres de précision audités avant une revue de lancement (pas encore de benchmarks) ou si la tâche est surtout du calcul à plusieurs étapes sur de grands tableaux (Cloudflare dit lui-même de le faire en code). Et si ce que vous voulez vraiment, c'est moins de tickets dans la file plutôt que des champs plus propres, un agent IA de helpdesk prêt à l'emploi vous y mène sans développement.
eesel pour le ticket après l'extraction
Clairic est de l'infrastructure. eesel est l'employé. eesel est une plateforme de coéquipiers IA, et le coéquipier qui compte ici est le coéquipier IA pour le helpdesk. Il rejoint votre file Zendesk, Freshdesk, Gorgias ou Front, apprend de vos anciens tickets et de votre centre d'aide, et fait la lecture que fait Clairic en travaillant le ticket : trouver la commande, vérifier les dates, repérer ce qui est endommagé. Ensuite il agit. Il étiquette, rédige, répond ou passe la main, et tout ce que vous marquez « demander d'abord » attend l'approbation d'une personne.
Rúngne, une marque norvégienne de vêtements d'escalade sur Gorgias et Shopify, fait tourner trois agents eesel : un accuse réception et étiquette chaque ticket, un recherche la commande, le suivi et le stock dans Shopify et laisse un brouillon, et un répond directement aux questions simples. Entre le 8 août et le 8 septembre 2026, cela a représenté environ 2 100 tickets traités, 580 brouillons laissés à l'équipe et 150 recherches de commande. Les articles endommagés, colis perdus et annulations vont directement à des personnes, ce qui est la même ligne que je tracerais pour toute automatisation basée sur l'extraction. Dokument 24 fait la version plus légère sur Zendesk : chaque premier message reçoit une étiquette de produit et un brouillon en danois en note interne.

Si Clairic vous attire parce qu'il est programmable, regardez la CLI eesel. C'est le même coéquipier que le tableau de bord, piloté depuis un terminal, et chaque commande affiche du JSON, donc un script ou un agent de code comme Claude Code, Cursor ou Codex peut exécuter toute la configuration. Pour un flux de type extraction, cela donne :
npx @eesel/cli initdémarre un espace de travail sans compte nécessaire (Node 18.17 ou plus récent), eteesel loginle conserve.eesel integrations connect <platform>connecte Zendesk, Freshdesk ou Gorgias, eteesel integrations <platform> actionsliste chaque action que le coéquipier peut y effectuer avec son réglage d'approbation.eesel instructionscontient les règles permanentes en langage courant, comme « remplis le champ du numéro de commande ; s'il n'y en a pas, demande-le ».eesel approvals listeteesel approvals approve <id>débloquent les actions retenues depuis un script, et--dry-runaffiche l'appel exact qu'une écriture ferait avant qu'elle n'ait lieu.eesel activitymontre ce que le coéquipier a fait, du plus récent au plus ancien, ce qui constitue votre piste d'audit.
L'espace de travail est aussi un serveur MCP (eesel mcp token affiche la ligne claude mcp add), et l'article de mon collègue sur la CLI d'agent IA détaille comment piloter le support depuis un terminal.
L'unité de prix est différente parce qu'elle achète autre chose. Les tarifs d'eesel commencent par 100 crédits gratuits, puis des forfaits mensuels fixes à partir de 299 $ pour 500 crédits, où un crédit couvre un ticket ou un chat entier quel que soit le nombre de recherches et d'actions nécessaires. Si vous voulez construire vous-même la couche d'extraction, Clairic est un composant rapide, peu coûteux et honnête. Si vous voulez que les e-mails de commande soient lus, recherchés et traités dans votre helpdesk cette semaine, essayez eesel sur votre propre file et lisez les brouillons avant de payer quoi que ce soit.
Questions fréquentes
Qu'est-ce que Cloudflare Clairic ?
Cloudflare Clairic est un modèle d'extraction que Cloudflare a lancé en préversion sur Workers AI le 19 octobre 2026, sous le nom @cf/cloudflare/clairic. Vous lui envoyez du texte (plus jusqu'à quatre images) et une liste de champs typés, et il renvoie une valeur typée par champ avec un score de confiance. Il se place à côté des modèles de décision comme Clef dans ce que Cloudflare appelle les modèles System One.
En quoi Cloudflare Clairic diffère-t-il de Clef ?
Clef choisit parmi les options que vous listez et renvoie une probabilité pour chacune, donc il répond à « quelle équipe ? » ou « remboursement ou réparation ? ». Clairic répond avec des valeurs qu'on ne peut pas lister à l'avance, comme un numéro de commande, une date, un total ou un coût de réparation estimé. La démo de Cloudflare les enchaîne : Clairic extrait, Cloudflare Clef décide, un LLM rédige la réponse.
Combien coûte Cloudflare Clairic ?
Clairic coûte 0,10 $ par million de tokens en entrée, sans frais de tokens en sortie, car il ne génère pas de tokens. Il est facturé en neurons Workers AI (9 091 par million de tokens en entrée) et chaque compte reçoit 10 000 neurons gratuits par jour. Pour le tableau complet de Workers AI, consultez le guide des tarifs de Clef.
Cloudflare Clairic est-il open source ?
Pas encore. Au lancement, Clairic est une préversion hébergée uniquement sur Workers AI, et Cloudflare dit vouloir publier le modèle avec des poids ouverts bientôt. Si vous avez besoin d'un modèle que vous pouvez héberger vous-même dès aujourd'hui, les petits modèles de langage sur Hugging Face sont la voie habituelle.
Cloudflare Clairic peut-il halluciner ?
Il peut se tromper, mais il ne peut pas inventer une réponse mal formée. Chaque valeur revient dans le type demandé ou sous forme de null, et les réponses textuelles sont des extraits de votre entrée avec leurs positions de caractères. La documentation de Cloudflare est claire : bien formé ne veut pas dire correct, donc utilisez les scores confidence et p_null comme vous utiliseriez des seuils de confiance ailleurs.
Puis-je utiliser Cloudflare Clairic pour des tickets de support client ?
Oui, les exemples de lancement de Cloudflare sont un e-mail de commande endommagée et un ticket de panne de paiement. Clairic extrait l'ID de commande, les dates, les montants et la liste des dommages du message pour que votre code ou un modèle comme Clef puisse agir. Il ne répond pas et ne touche pas à votre helpdesk, et c'est là qu'intervient un agent IA de helpdesk comme eesel.
Cloudflare Clairic est-il bon en prévision ?
Pour un chiffre rapide sur l'étape suivante, oui : lors du test TSA sur 21 jours de Cloudflare, ses prévisions s'écartaient de 3,3 % en moyenne. Cloudflare juge toutefois la prévision basique et dit qu'elle ne remplace pas un modèle de séries temporelles entraîné sur vos données. Pour dimensionner une équipe de support, une vraie prévision des effectifs reste le meilleur outil.
Comment appeler Cloudflare Clairic ?
Depuis un Worker, appelez
env.AI.run("@cf/cloudflare/clairic", { model: "clairic", state, fields }). Depuis n'importe où ailleurs, envoyez le même corps en POST à/accounts/{account_id}/ai/run/@cf/cloudflare/clairicavec un jeton d'API. Si vous l'intégrez dans une pile de support, l'article de mon collègue sur l'API de helpdesk IA couvre la plomberie autour.