

TorchNeuron est le backend PyTorch open source d'AWS pour ses puces Trainium, en bêta publique depuis le 20 octobre 2026. Il enregistre Trainium comme un device PyTorch normal appelé neuron, si bien que pour la plupart des codes, le portage consiste vraiment à transformer .to('cuda') en .to('neuron'). La bibliothèque est gratuite sous Apache 2.0, et vous payez le temps Trainium : 2,235 $ par heure de puce Trainium2 dans EC2 Capacity Blocks, contre 5,970 $ pour une H100.
Le titre cache le piège. Le mode eager est la voie simple et facile à déboguer, mais la vitesse en production vient de torch.compile, qui sur Neuron exige des formes statiques et échoue sur tout opérateur qu'il ne sait pas traduire. Il ne fonctionne en outre que sur Trainium2 et Trainium3 : les utilisateurs de Trainium1 et d'Inferentia restent donc sur l'ancienne pile.
Si vous entraînez ou servez vos propres modèles sur AWS, c'est la semaine pour lancer un pilote. Si vous voulez simplement une IA qui fait un travail, comme répondre aux tickets, laissez de côté la question de la puce : un coéquipier IA eesel gère la couche modèle, et SE Ranking en fait tourner un sur trois produits, avec environ 4 650 conversations par mois.
Qu'est-ce que TorchNeuron ?
TorchNeuron est un backend PyTorch natif pour AWS Trainium, la famille de puces d'IA personnalisées qu'Amazon développe depuis le rachat d'Annapurna Labs en 2015. Il a été annoncé sur le blog PyTorch le 19 octobre 2026 et mis en ligne en bêta publique open source à la PyTorch Conference North America le 20 octobre. Le code se trouve sur aws-neuron/torch-neuronx sous licence Apache 2.0.
Je construis des intégrations et des API pour eesel, et « ça marche avec un changement d'une ligne » est l'affirmation en laquelle j'ai le moins confiance, surtout parce que je l'ai moi-même écrite sur nos propres pages. J'ai donc lu la documentation, le dépôt et le matériel de lancement avant d'y croire. En bref : l'affirmation tient pour le mode eager, et le vrai travail d'ingénierie se déplace vers l'étape de compilation.
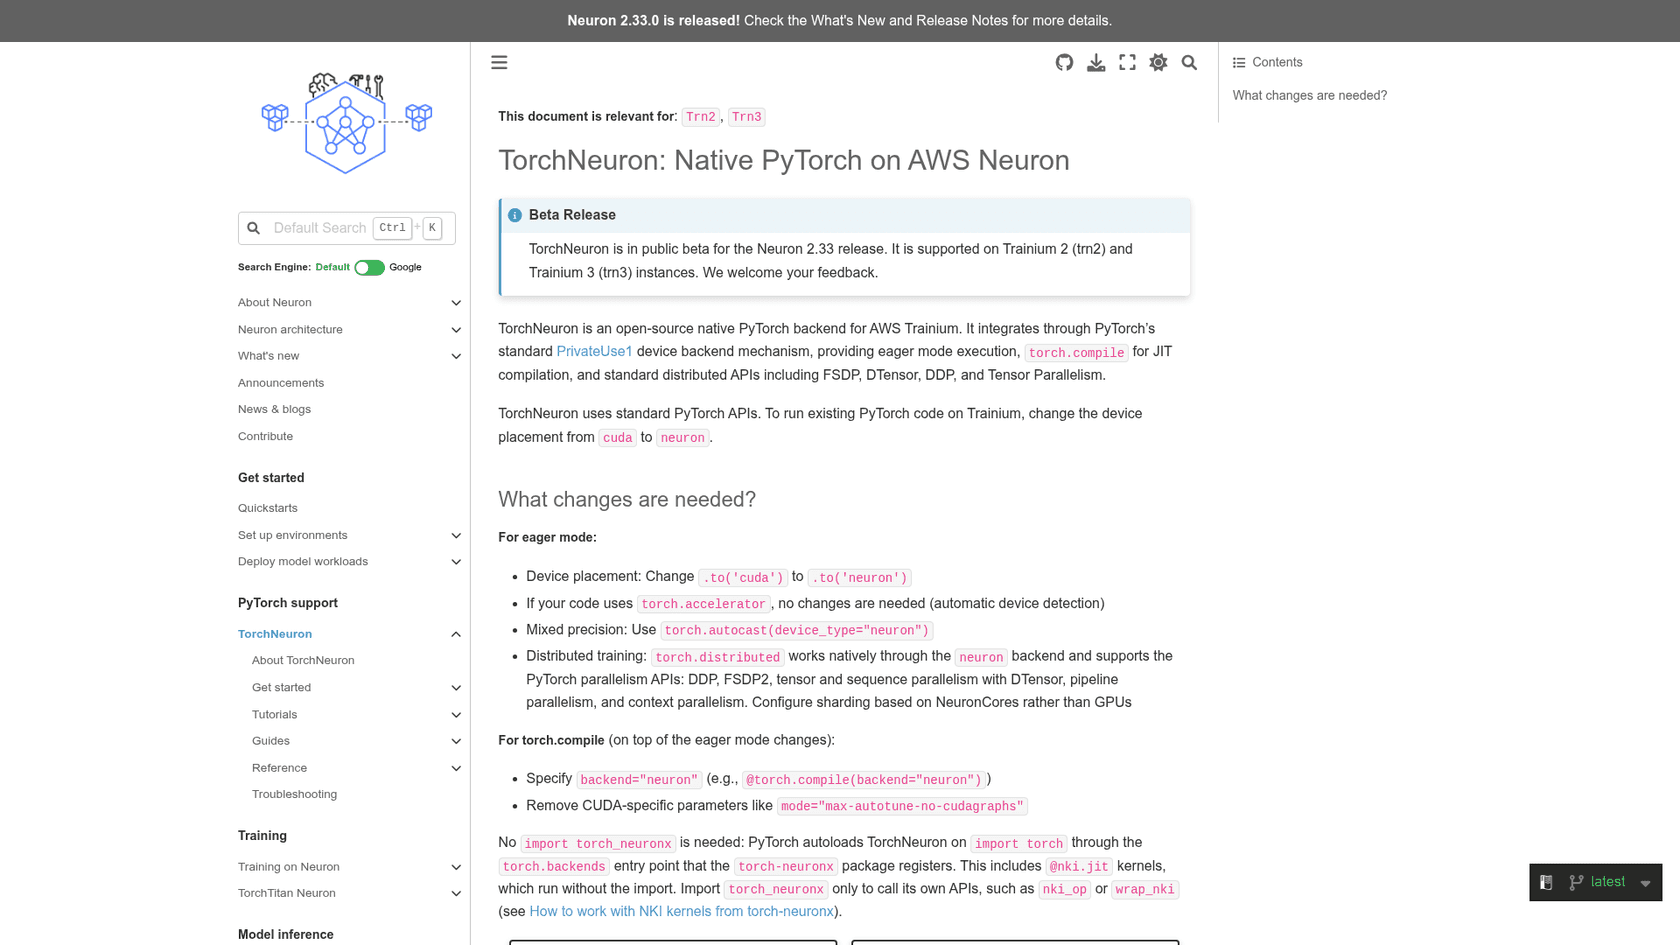
La documentation officielle est claire : TorchNeuron est en bêta publique pour la version Neuron 2.33 et fonctionne sur les instances Trainium2 (trn2) et Trainium3 (trn3). Le discours d'Amazon sur About Amazon est que 85 % des chercheurs et développeurs en IA écrivent leur code en PyTorch, et que jusqu'ici, porter ce code vers de nouvelles puces signifiait des mois de réécriture et de revalidation.
Andy Jassy, PDG d'Amazon, a présenté l'argument économique sur X le même jour :
"Trying a new AI chip used to be a lot of work. You often had to rewrite your code, revalidate it, and sink many weeks in, betting this new chip is the right one for your workload."
Ce qui est réellement nouveau
Trainium exécute PyTorch depuis des années, on peut donc se demander ce qui a changé. La réponse tient à la plomberie sous-jacente. Jusqu'à PyTorch 2.9, Neuron exécutait PyTorch via PyTorch/XLA, qui utilisait des tenseurs paresseux : rien ne s'exécutait tant qu'un graphe n'était pas tracé et compilé, d'où des prints, des points d'arrêt et un flux de contrôle Python au comportement étrange. AWS a annoncé que PyTorch 2.9 serait la dernière version basée sur XLA, la 2.10 et les suivantes passant à la prise en charge native.
TorchNeuron se branche sur PrivateUse1, le point d'extension officiel de PyTorch pour le matériel personnalisé. Pour PyTorch, Trainium devient simplement un device de plus à côté du CPU et de CUDA. C'est pourquoi l'article de lancement peut affirmer que torch.nn, torch.autocast, torch.distributed et torch.profiler fonctionnent tous sur le device neuron tels qu'ils sont écrits.
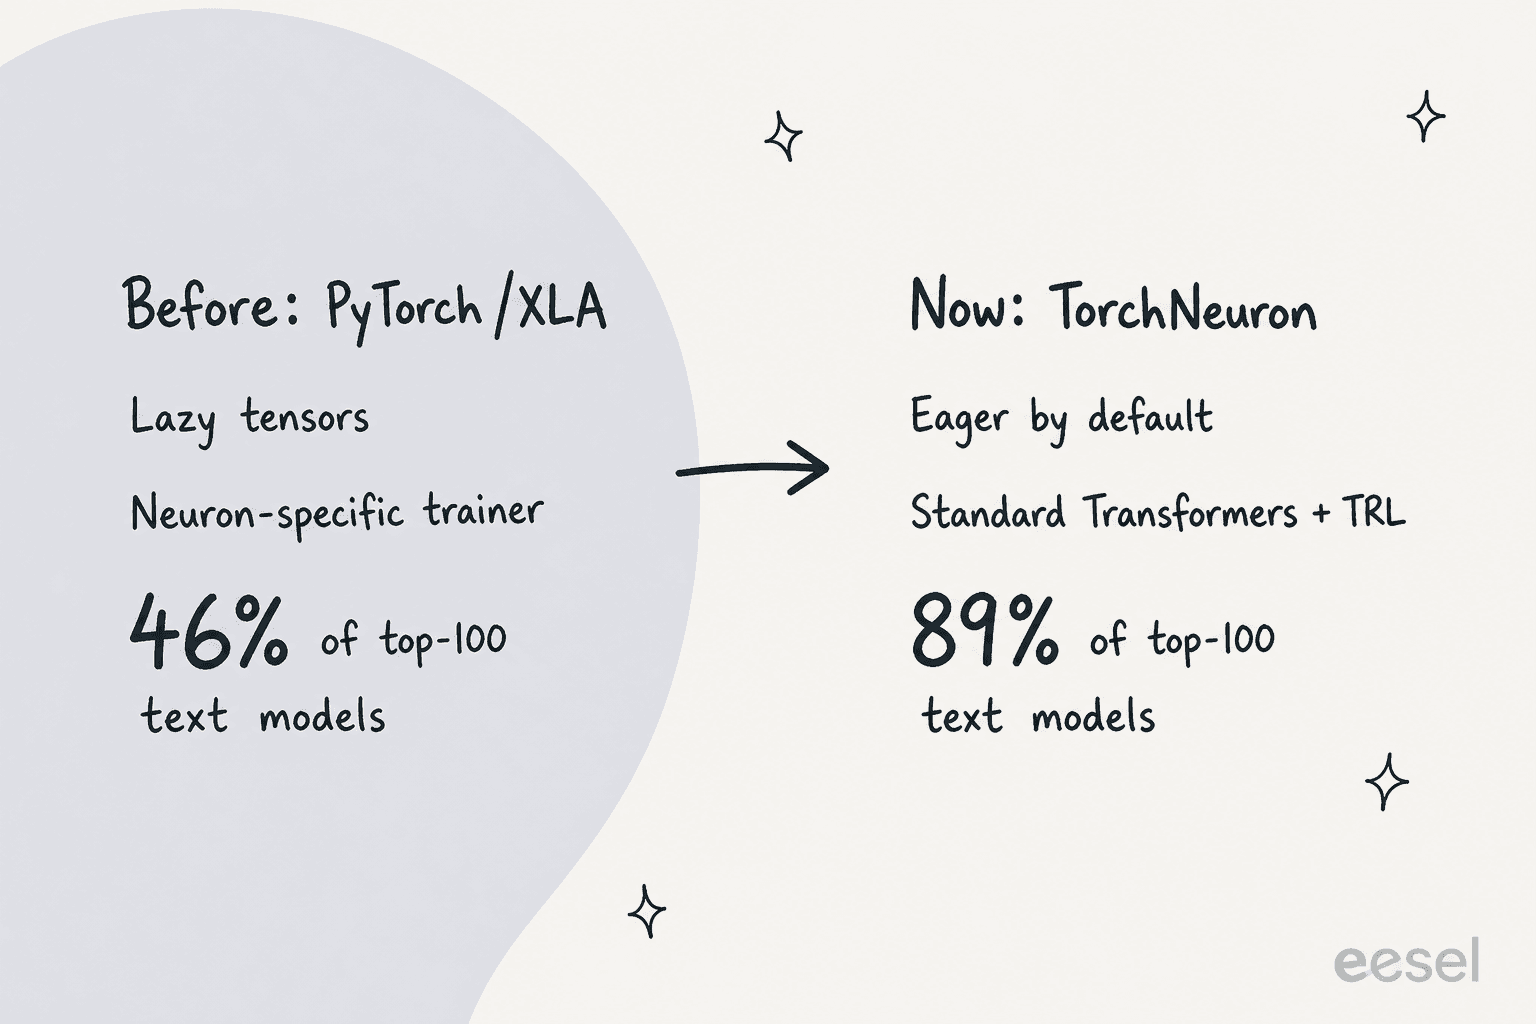
La mesure la plus claire du changement vient de Hugging Face. Dans son article de lancement, Hugging Face indique que 89 % des 100 principales architectures de génération de texte fonctionnent désormais sans modification, contre 46 % avec son ancienne bibliothèque Optimum Neuron v0.4.5. Il recommande désormais d'utiliser Transformers, Diffusers, Accelerate, PEFT et TRL directement sur Trainium plutôt que de passer par Optimum Neuron.
Voici l'avant et l'après dans un tableau :
| PyTorch/XLA (torch-neuronx avant 2.14) | TorchNeuron (torch-neuronx 2.14+) | |
|---|---|---|
| Exécution | Tenseurs paresseux, graphes tracés | Eager par défaut, torch.compile en option |
| Débogage | Au niveau du graphe, prints retardés | Les prints et points d'arrêt Python fonctionnent |
| Chemin Hugging Face | Wrapper Optimum Neuron | Transformers, TRL, Diffusers directement |
| Distribué | API propres à Neuron | DDP, FSDP2, DTensor, TP, PP |
| Puces | Trn1, Trn2, Inferentia | Trn2 et Trn3 uniquement |
| Versions de PyTorch | Jusqu'à 2.9 | 2.14 dans la version actuelle |
Cette dernière ligne compte plus que ne le suggère la couverture du lancement, et j'y reviens dans la section sur les limites.
Comment fonctionne TorchNeuron
Sous le capot, TorchNeuron a deux backends : l'un enregistré auprès du dispatcher de PyTorch pour le mode eager, l'autre enregistré auprès de TorchDynamo pour torch.compile. Tous deux confient le travail au compilateur Neuron, qui produit des fichiers NEFF (Neuron Executable File Format) que le runtime Neuron exécute sur la puce.
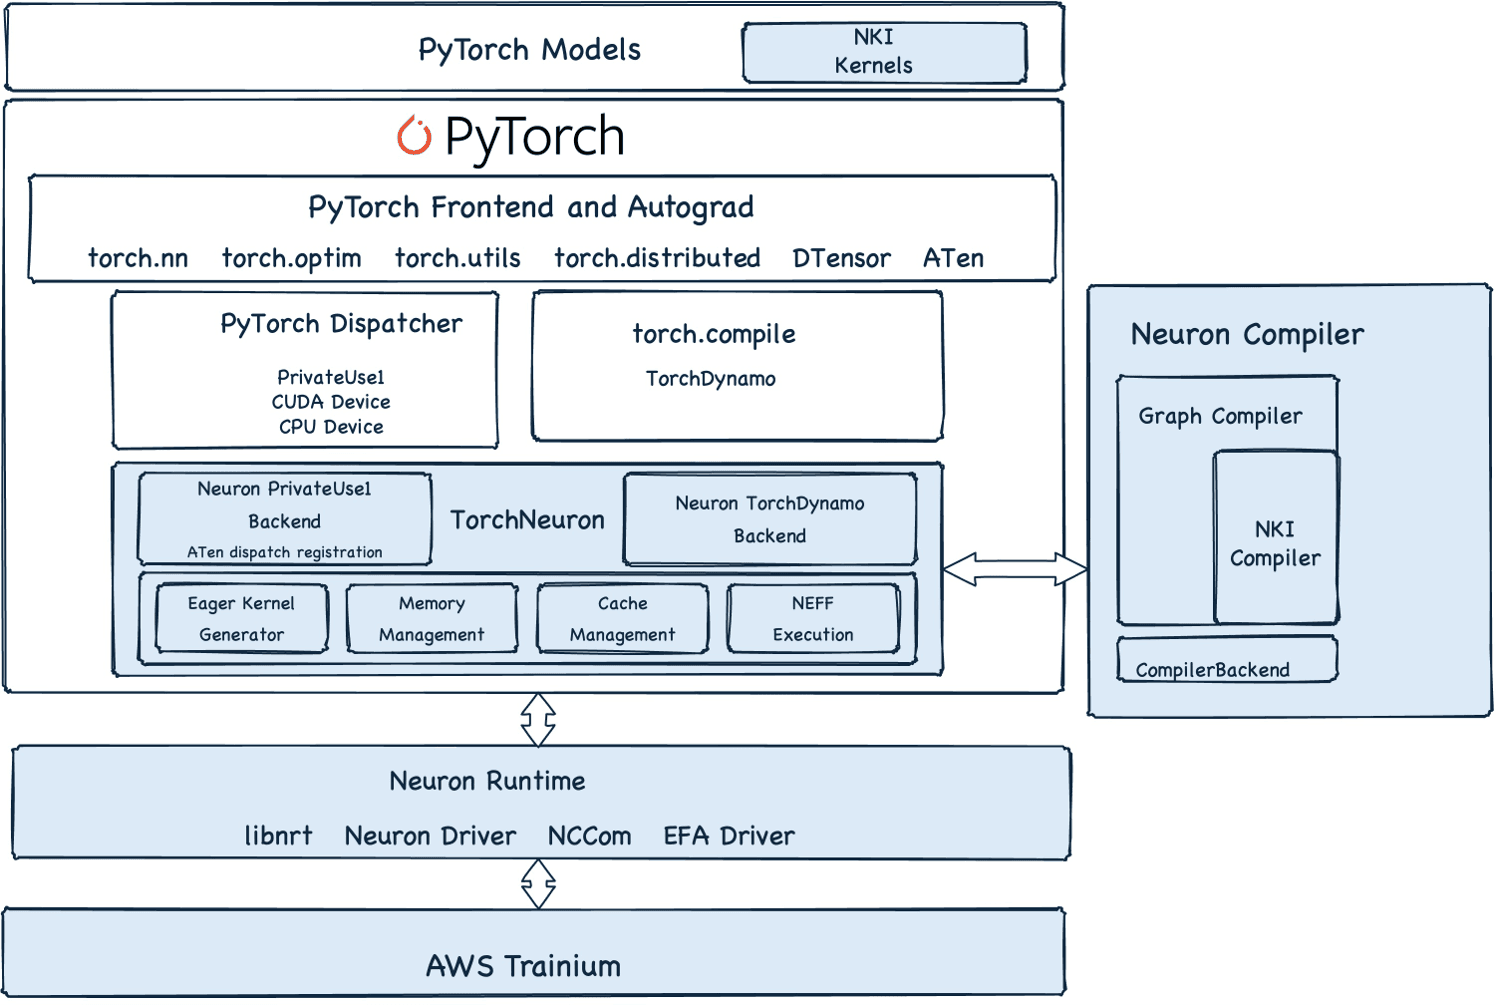
La page About TorchNeuron détaille les deux chemins. Ils se comportent de façon assez différente pour que je les traite comme deux produits.
Le mode eager exécute chaque opération dès que vous l'appelez. La première fois qu'un opérateur s'exécute, il est compilé dans son propre NEFF et placé dans un cache sur disque ; ensuite, il est servi depuis le cache. Si un opérateur n'a pas d'implémentation Neuron, il bascule sur le CPU avec un avertissement, et le modèle tourne donc quand même. Il existe aussi un mode eager adaptatif expérimental (activez TORCH_NEURONX_ENABLE_CONCATENATION=1) qui fusionne les opérations éligibles pour réduire le surcoût de lancement.
torch.compile capture le modèle dans un graphe via TorchDynamo et AOTAutograd, le convertit en StableHLO via Torch-MLIR et compile le graphe entier dans un seul NEFF. C'est le chemin de production. La contrepartie est la rigueur : d'après le README GitHub, dynamic doit valoir False, mode n'accepte que "default", les tenseurs doivent être contigus et chaque nouvelle forme d'entrée déclenche une nouvelle compilation. Un opérateur capturé que le backend ne sait pas traduire fait échouer la compilation par défaut.
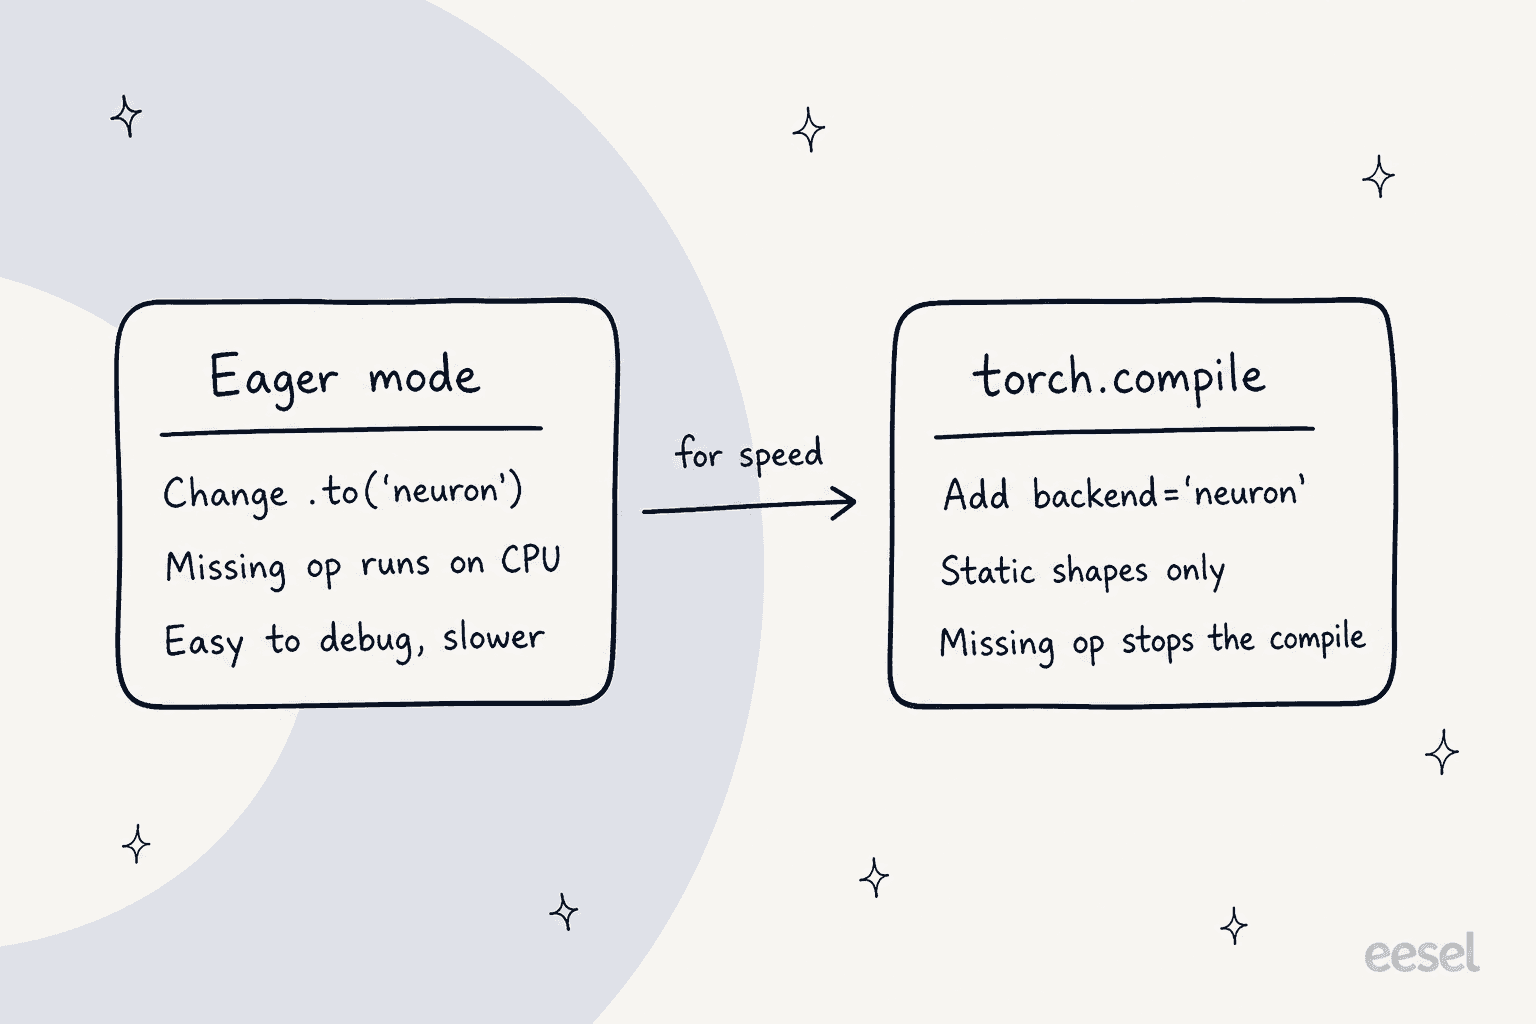
La lecture honnête de « un seul changement de configuration » est donc : un changement pour démarrer, puis un second tour de travail pour aller vite. En pratique, ce second tour consiste surtout à compléter ou regrouper les entrées en quelques formes fixes, et à pointer TORCH_NEURONX_NEFF_CACHE_DIR vers un stockage partagé (la documentation suggère Amazon FSx) pour qu'une flotte ne recompile pas les mêmes graphes sur chaque instance.
Au-dessus des deux modes se trouve NKI, la Neuron Kernel Interface, pour écrire des noyaux personnalisés quand le compilateur ne suffit pas. Vous enregistrez un noyau NKI comme un opérateur PyTorch normal avec nki_op, et il fonctionne en mode eager comme dans un graphe compilé. AWS a aussi publié en open source NKI-lib, un ensemble de noyaux optimisés comprenant FlashAttention et des noyaux blockwise pour MoE.
À quoi ressemble le changement de code
Pour une boucle d'entraînement, l'article de lancement montre tout le diff en une seule ligne :
model = MyModel().to('neuron')   # the only change
optimizer = torch.optim.AdamW(model.parameters())
for batch in dataloader:
    optimizer.zero_grad()
    loss = criterion(model(batch), targets)
    loss.backward()
    optimizer.step()
Pour la version compilée, vous nommez le backend une fois avec torch.compiler.set_default_backend("neuron"), ou à chaque appel avec torch.compile(model, backend="neuron"). Le code écrit avec torch.accelerator, l'API de PyTorch indépendante du matériel, n'a besoin d'aucun changement. Il n'est même pas nécessaire d'écrire import torch_neuronx : le paquet s'enregistre via le point d'entrée torch.backends et se charge avec import torch.
La liste complète des modifications tirée de la documentation est courte :
- Remplacez
.to('cuda')par.to('neuron'), ou appuyez-vous surtorch.accelerator. - Utilisez
torch.autocast(device_type="neuron")pour la précision mixte. - Pour les jobs distribués, configurez le sharding par NeuronCores plutôt que par GPU.
- Pour
torch.compile, ajoutezbackend="neuron"et supprimez les réglages propres à CUDA commemode="max-autotune-no-cudagraphs".
Pour les modèles Hugging Face, c'est encore plus court. Charger un modèle avec device_map="neuron" place les poids sur Trainium, et device_map="auto" trouve le device tout seul. L'exemple Hugging Face fait un fine-tuning avec un script TRL SFTTrainer standard sur 8 puces Trainium2 (une demi trn2.48xlarge), avec un seul réglage propre à Neuron : HF_DEACTIVATE_ASYNC_LOAD=1, car le chargement asynchrone des poids n'est pas encore pris en charge. Le checkpoint enregistré est un checkpoint Transformers normal, que vous pouvez charger sur n'importe quel matériel.
C'est le genre de portage mécanique où les agents de code excellent. Si vous déplacez un dépôt, un outil comme Claude Code ou OpenAI Codex peut repérer les appels spécifiques à CUDA et les remplacer, à condition de vérifier vous-même les journaux de compilation.
Combien coûte TorchNeuron ?
La bibliothèque est gratuite. TorchNeuron est sous Apache 2.0, s'installe avec pip install torch-neuronx depuis le dépôt pip de Neuron, et est préinstallé dans la Neuron Deep Learning AMI et les Deep Learning Containers. Le coût, c'est le temps Trainium.
AWS publie les prix de Trainium sur sa page de tarification Capacity Blocks, où vous réservez de la capacité d'accélérateurs pour une période fixe. Voici les tarifs horaires effectifs affichés le 20 octobre 2026, et AWS indique que la prochaine mise à jour des prix est prévue en janvier 2027 :
| Instance | Accélérateurs | Par heure d'instance | Par heure de puce | Fonctionne avec TorchNeuron ? |
|---|---|---|---|---|
| trn2.48xlarge (US East, Ohio) | 16 x Trainium2 | 35,7608 $ | 2,235 $ | Oui |
| trn2.3xlarge (régions sélectionnées) | 1 x Trainium2 | 2,235 $ | 2,235 $ | Oui |
| trn1.32xlarge | 16 x Trainium | 9,532 $ | 0,596 $ | Non |
| p5.48xlarge | 8 x H100 | 47,757 $ | 5,970 $ | GPU, pas Neuron |
| p5e.48xlarge | 8 x H200 | 54,924 $ | 6,866 $ | GPU, pas Neuron |
| p5en.48xlarge | 8 x H200 | 63,158 $ | 7,895 $ | GPU, pas Neuron |
Linux n'entraîne aucun supplément de système d'exploitation sur ces blocs. Les Trn3 UltraServers, qui montent jusqu'à 144 puces Trainium3, n'ont pas de tarif horaire public sur cette page.
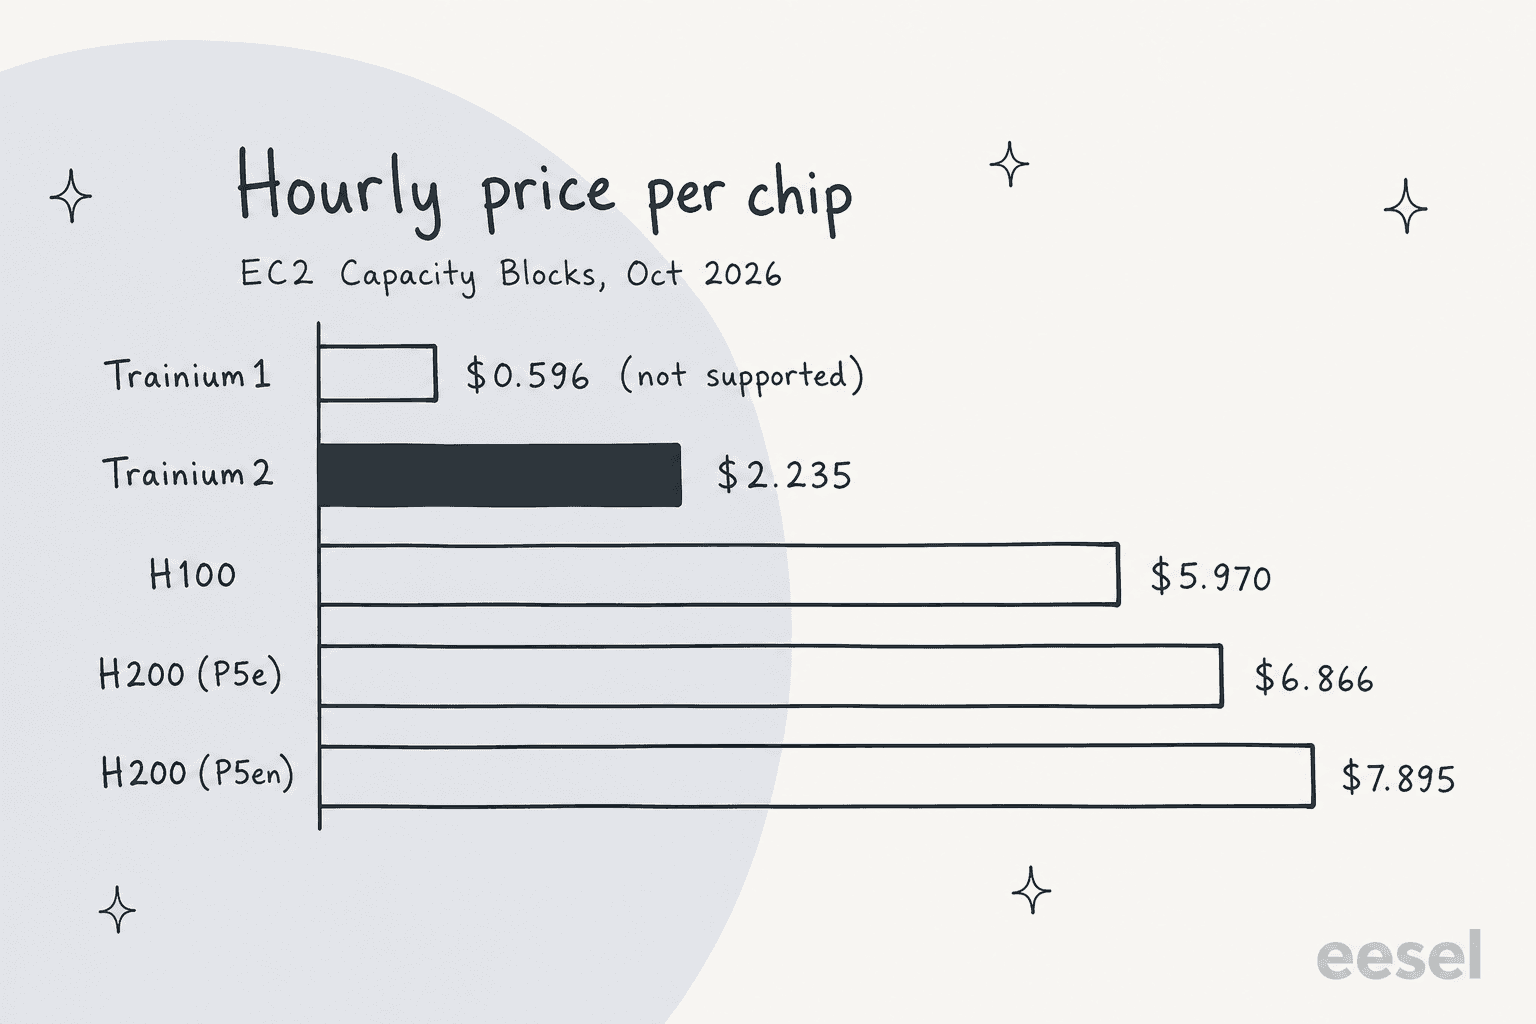
Par puce, une heure de Trainium2 coûte environ 37 % d'une heure de H100. Cela ne veut pas dire que votre job coûte 37 % du prix, car une puce Trainium2 et une H100 ne font pas la même quantité de travail. L'affirmation d'AWS sur la page Trn2 est plus restreinte : les instances Trn2 offrent "30-40% better price performance than GPU-based EC2 P5e and P5en instances." Une trn2.48xlarge embarque 16 puces Trainium2, 1,5 To de HBM et jusqu'à 20,8 pétaflops FP8.
Le seul chiffre client du lancement vient de Deepgram, l'entreprise de reconnaissance vocale :
"In the benchmarks we evaluated, Trainium processes about 60% more input audio seconds per dollar than our existing GPU baselines, which helps us bring better models to customers at lower prices."
Adam Sypniewski, CTO de Deepgram, sur le blog PyTorch
Notez le contexte derrière ce chiffre : Deepgram a porté son modèle lors d'un accompagnement de plusieurs mois avec l'AWS Generative AI Innovation Center. C'est un vrai résultat, mais c'est une migration accompagnée, pas un changement de week-end. Pour comparer les clouds GPU, mes analyses des tarifs de CoreWeave et des tarifs de Lambda couvrent l'autre côté du tableau, et le guide des tarifs AWS couvre le reste de la facture.
Benchmarks et couverture de tests
AWS n'a pas publié de classement de vitesse des modèles avec le lancement. Ce qu'il a publié, ce sont des tests de couverture, qui me semblent le chiffre le plus utile pour une bêta. D'après l'article de lancement, AWS exécute en continu environ 100 000 modèles Hugging Face, choisis pour couvrir 99,9 % de l'usage réel selon le nombre de téléchargements, dans une configuration réduite sur Trainium. Chaque exécution vérifie si le modèle se charge, si les passes forward et backward fonctionnent et s'il compile.
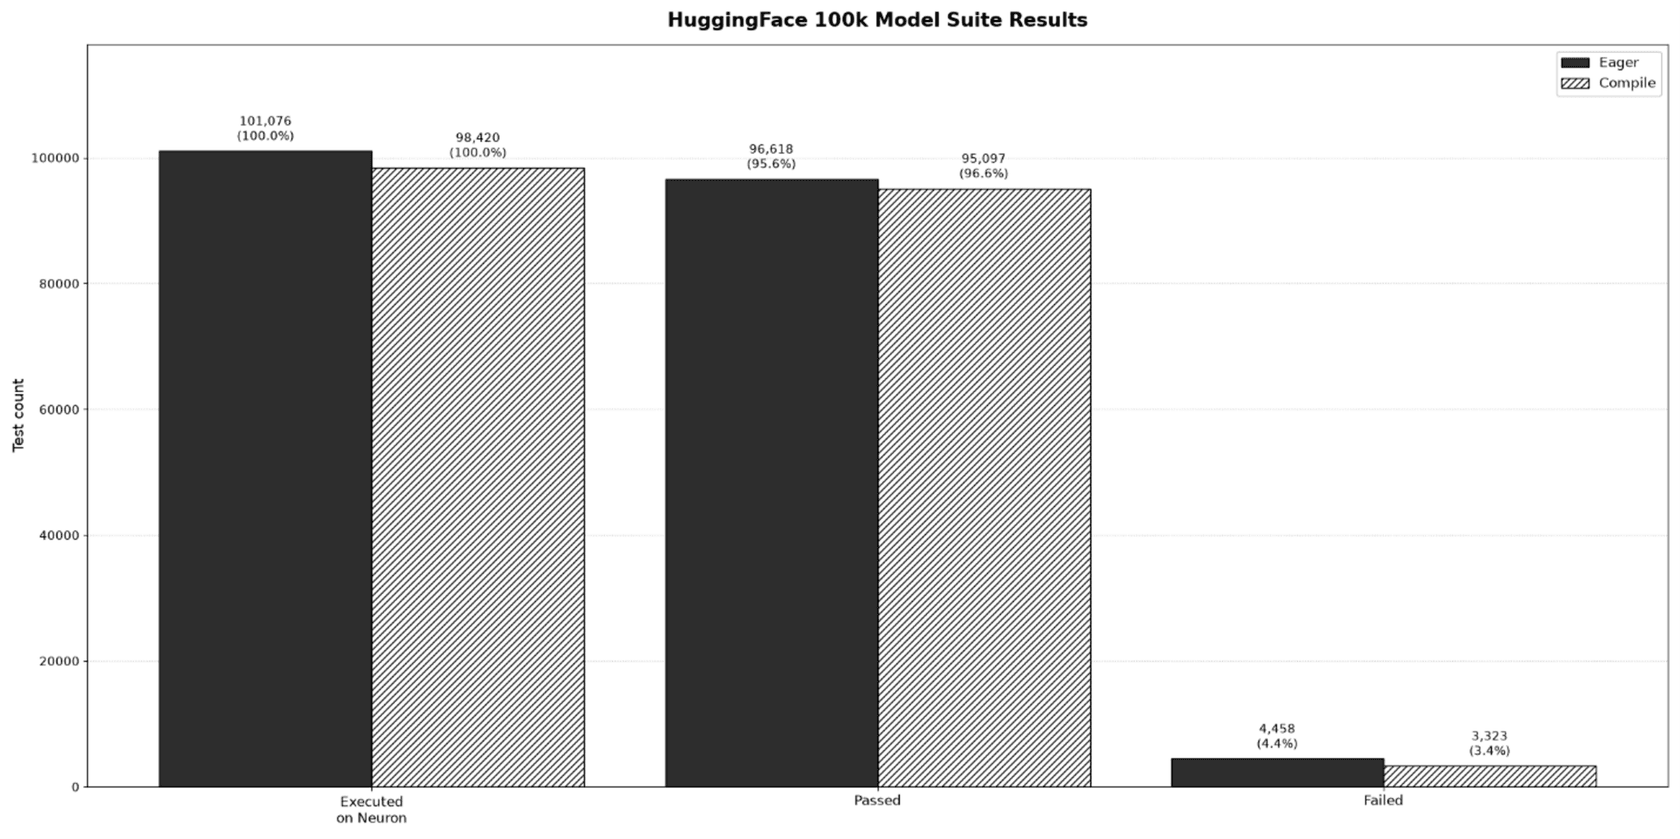
Les résultats de septembre 2026 : 95,6 % réussissent en mode eager et 96,6 % sous torch.compile, avec respectivement 4 458 et 3 323 échecs. C'est un excellent chiffre pour une bêta, et c'est le bon type de test. Chez eesel, j'ai appris la même leçon dans l'autre sens : un agent de support qui brille en démo peut tout de même donner des réponses fausses avec aplomb sur des tickets réels, c'est pourquoi nous simulons chaque déploiement sur les tickets historiques d'un client avant sa mise en service. Un balayage de 100 000 vrais modèles, c'est l'équivalent pour AWS appliqué à un compilateur.
La suite de tests PyTorch en amont indique où sont les lacunes. L'exécution d'août 2026 a produit environ 154 000 résultats de test, dont environ 69 000 ignorés. Environ 30 000 l'ont été par les contrôles d'éligibilité propres à PyTorch (tests réservés à CUDA et au CPU). Les ~39 000 autres étaient des omissions volontaires de Neuron, le plus gros groupe étant ~22 000 tests pour des opérateurs qui n'ont pas encore de traduction native vers Neuron.
Côté matériel, la page Trn3 affirme que les Trn3 UltraServers offrent jusqu'à 4,4 fois les performances et 4 fois les performances par watt des Trn2 UltraServers, avec jusqu'à 362 pétaflops MXFP8 sur 144 puces. Ce sont les chiffres d'AWS pour la puce, pas des résultats TorchNeuron, et je n'ai pas encore vu de benchmarks indépendants ni pour l'un ni pour l'autre.
Ce que TorchNeuron ne fait pas encore
C'est une première version, et AWS est étonnamment direct sur ce qu'il a laissé de côté. D'après l'article de lancement et le README :
- Puces plus anciennes. Seuls Trn2 et Trn3 sont pris en charge. Trainium1, qui à 0,596 $ par heure de puce est l'accélérateur le moins cher du tableau ci-dessus, et Inferentia restent sur la ligne torch-neuronx basée sur XLA (versions antérieures à 2.14).
- Formes dynamiques.
torch.compileexige des formes statiques. Des entrées de longueur variable impliquent du remplissage ou du regroupement, et chaque nouvelle forme recompile. - Précision. float64 s'exécute en float32, ce qui peut modifier des résultats nécessitant une précision 64 bits. La prise en charge d'int64 dépend de l'opération.
- Fonctionnalités volontairement omises. Tenseurs creux, NestedTensor, autograd en mode forward, masques d'attention arbitraires dans l'attention multi-têtes native (sans masque et causal fonctionnent), quantification par canal et suréchantillonnage bilinéaire/bicubique ne sont pas dans cette version.
- FP8 et TorchAO. Ils sont en bêta privée, avec une disponibilité générale prévue pour la prochaine version. La prise en charge de FlexAttention est limitée.
- Temps de compilation au premier lancement. Le premier appel d'une opération ou d'un graphe compilé inclut la compilation, qui "can be significant for a large model", selon le README.
La réaction de la communauté est pour l'instant un optimisme prudent de la part de gens qui ont déjà fait ce genre de portage. En réponse à Jassy, un ingénieur l'a formulé ainsi :
"Big if this works flawlessly. I have been on the other end, it's not been pretty."
Une autre réponse sous le message du PDG d'AWS, Matt Garman, a nommé le test à plus long terme : si AWS continue de remonter ses changements dans PyTorch lui-même.
"Open sourcing is the easy half, upstreaming is the harder promise."
AWS a commencé : l'article de lancement liste 26 pull requests vers PyTorch et TorchTitan, ouvertes pour améliorer la qualité des tests et supprimer les hypothèses CUDA codées en dur.
Avant de réserver un Capacity Block, mieux vaut confronter votre code à cette liste. Cochez ce qui s'applique :
Cochez ce que votre charge de travail utilise pour voir la solution à chaque blocage, tirée de la documentation et du README de TorchNeuron.
Comment TorchNeuron se compare aux autres façons d'exécuter des modèles
Le vrai rival de TorchNeuron, c'est le GPU. Pour une équipe qui entraîne ou sert ses propres modèles, le choix ressemble à ceci :
| Option | Ce que vous gérez | Changements de code | Idéal pour |
|---|---|---|---|
| TorchNeuron sur Trainium | Instances, cache de compilation, formes | Nom du device, formes statiques pour compiler | Équipes engagées sur AWS avec des jobs importants et réguliers |
| GPU NVIDIA sur AWS (P5, P5e, P5en) | Instances | Aucun pour le code CUDA | Code avec noyaux CUDA personnalisés, démarrage le plus rapide |
| Clouds GPU (CoreWeave, Lambda) | Instances ou clusters | Aucun pour le code CUDA | Capacité GPU en dehors des grands clouds |
| GPU serverless (Modal, Baseten) | Le code de votre modèle | Petits wrappers | Inférence en rafales sans planification de capacité |
| API de modèles hébergés (Together AI, Groq) | Rien | Appels d'API uniquement | Modèles ouverts sans toucher au matériel |
Ce qui est intéressant, c'est que la première ligne affichait autrefois « réécrire votre pile d'entraînement » dans la colonne des changements de code. Elle se rapproche maintenant des lignes GPU, et c'est tout l'objet du lancement. AWS cite des partenaires qui construisent déjà dessus, dont Anyscale, Modular et Nota AI, et grâce à la prise en charge de Hugging Face, la plupart des modèles ouverts traités dans mes articles sur Kimi K3 ou DeepSeek V4 Flash ne sont qu'un device_map de Trainium.
Côté serving, TorchNeuron alimente le même backend torch.compile dans vLLM Neuron, un plugin qui ajoute un serveur compatible OpenAI, du batching continu et un cache KV paginé. Si votre objectif final est un agent géré sur AWS plutôt que votre propre pile de serving, Bedrock Managed Agents se situe une couche au-dessus de tout cela.
Pour commencer
Il vous faut une instance Trn2 ou Trn3 et Python 3.12, 3.13 ou 3.14. Sur la Neuron Deep Learning AMI, TorchNeuron est déjà installé. Sur une autre instance Linux, le README vous demande d'installer le pilote et le runtime Neuron, puis de figer les versions :
pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
pip install "torch-neuronx==2.14.*" "neuronx-cc==2.*" "nki>=0.6" --extra-index-url https://pip.repos.neuron.amazonaws.com
python -m torch_neuronx.collect_env
Gardez les versions figées : les versions antérieures de torch-neuronx sont le produit basé sur XLA, avec le même nom de paquet, ce qui facilite l'installation de la mauvaise chose. La vérification collect_env devrait indiquer que le device est utilisable depuis torch.
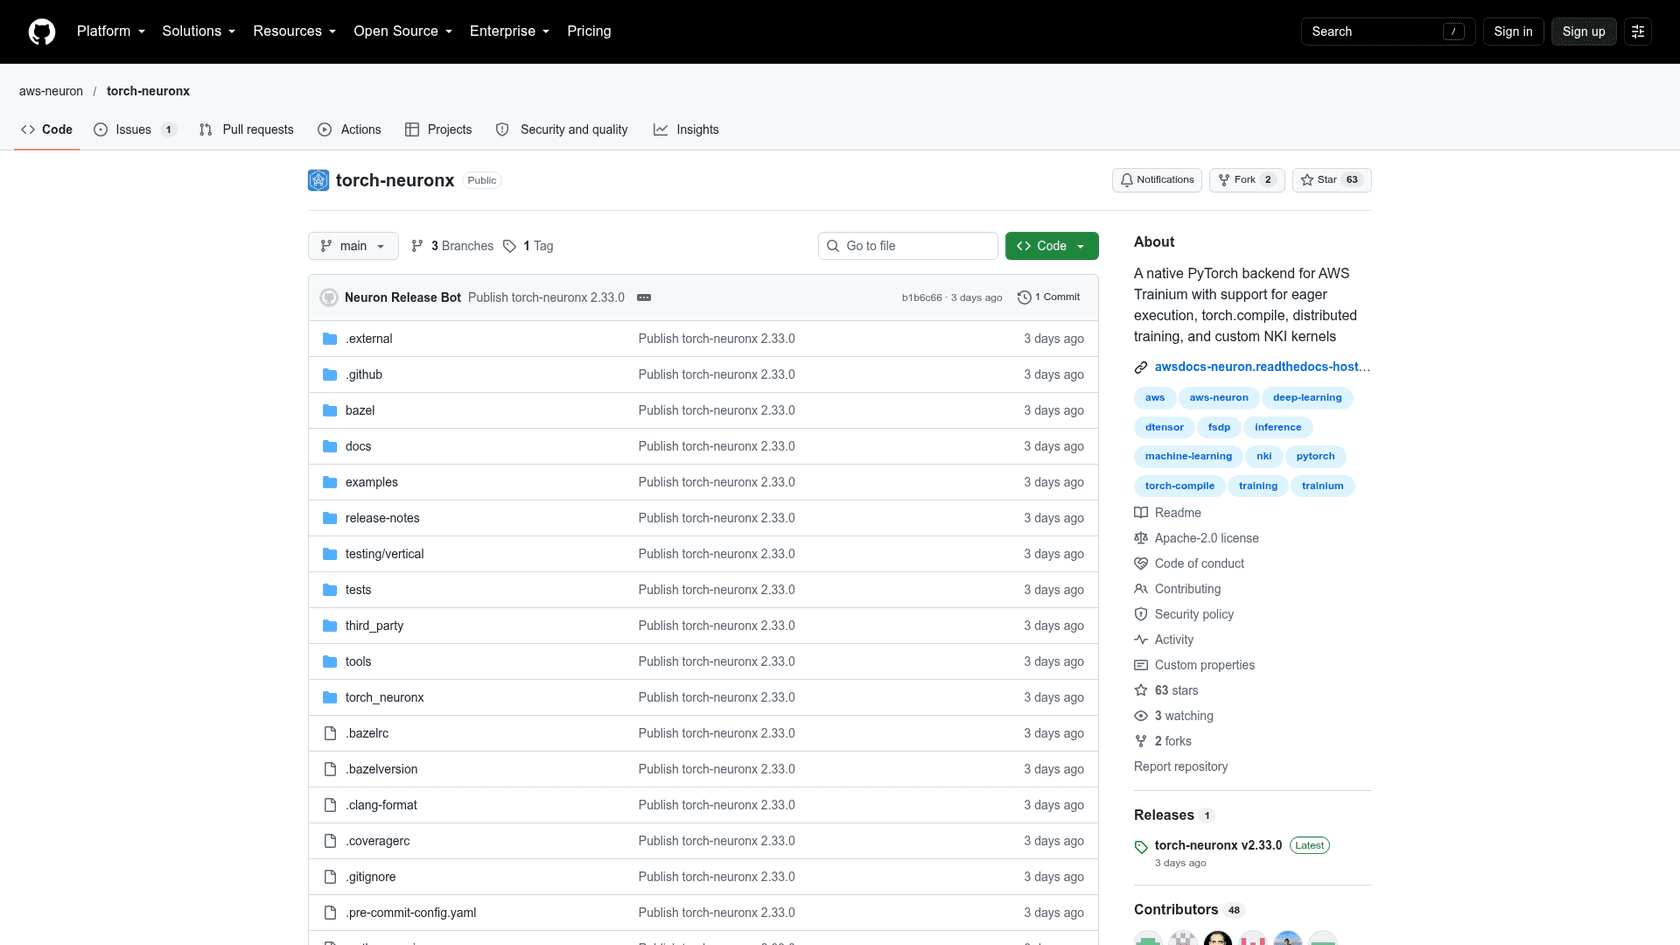
Le dépôt comptait 63 étoiles et 48 contributeurs quand je l'ai capturé le jour du lancement, avec des exemples couvrant Llama, Whisper, Qwen2, un modèle à mélange d'experts, l'entraînement de GPT-2 et des exécutions multi-nœuds. Pour l'entraînement à grande échelle, torchtitan-neuron fournit des recettes TorchTitan optimisées pour Trainium. L'article de lancement détaille l'entraînement de Llama 3 8B avec SimpleFSDP et torch.compile sur une seule trn2.48xlarge.
Mon ordre conseillé pour un pilote :
- Exécutez votre modèle en mode eager sur une trn2.3xlarge ou une trn2.48xlarge et lisez chaque avertissement de bascule sur CPU.
- Corrigez les formes, puis passez le chemin critique à
torch.compileavecfullgraph=True. - Partagez le cache NEFF entre les instances avant de monter en charge.
- Comparez le coût par étape d'entraînement ou par token à celui de vos GPU actuels, pas le coût par heure.
À qui s'adresse TorchNeuron
TorchNeuron s'adresse aux équipes qui entraînent ou servent leurs propres modèles PyTorch, qui tournent déjà sur AWS et qui dépensent assez en accélérateurs pour qu'un écart de 30 à 40 % de rapport performance/prix vaille un sprint d'ingénierie. Les équipes de recherche profitent surtout du mode eager, puisque le débogage fonctionne enfin comme sur n'importe quel autre device. Les équipes de production profitent surtout du côté coût, une fois les formes et le cache réglés.
Ce n'est pas pour vous si votre code repose sur des noyaux CUDA personnalisés que vous ne pouvez pas encore réécrire, si vous avez besoin de Trainium1 ou d'Inferentia, ou si vous ne touchez jamais aux poids d'un modèle. La plupart des entreprises qui utilisent l'IA, y compris la plupart de celles que je rencontre chez eesel, font partie de ce dernier groupe : elles veulent que l'IA fasse un travail, et la puce sur laquelle elle tourne est le problème de quelqu'un d'autre.
Où eesel se place : ceci est de l'infrastructure, eesel est l'employé
TorchNeuron rend la couche matérielle moins chère et plus facile à changer. C'est une bonne nouvelle pour tous ceux qui construisent des modèles, et cela fait baisser avec le temps le coût des produits d'IA qui reposent dessus. Mais cela ne répond pas à un ticket, ne rédige pas une réponse et n'écrit pas un article de blog. Ce sont des tâches, et les tâches demandent du contexte : votre centre d'aide, vos conversations passées, vos règles de remboursement.
C'est la couche sur laquelle eesel travaille. eesel est une plateforme de coéquipiers IA : vous embauchez des coéquipiers prêts à travailler sur des tâches précises, aujourd'hui un coéquipier IA pour helpdesk et un rédacteur de blog IA. Le coéquipier helpdesk rejoint votre file existante, apprend de votre centre d'aide et de vos tickets passés, puis est simulé sur vos conversations historiques avant de répondre à un vrai client.
SE Ranking est un bon exemple pour un public technique. L'entreprise fait tourner un agent eesel par produit pour SE Ranking, Planable et SE Visible sur Zendesk, et entre le 8 août et le 8 septembre 2026, eesel a traité environ 4 650 conversations, dont environ 2 100 chats en direct. Les questions sur l'API et Looker Studio sont orientées vers un groupe de niveau 2 avec les éléments déjà rassemblés, plutôt que de laisser le bot deviner.
Si vous faites partie des lecteurs qui viennent d'installer un backend PyTorch depuis un index pip figé, vous préférerez sans doute aussi configurer ceci depuis un terminal. La CLI eesel pilote le même coéquipier et le même espace de travail que le tableau de bord : tout ce que vous y configurez apparaît dans l'interface, et inversement. npx @eesel/cli init chat-bubble --site https://your-site.com crée un agent, ajoute une bulle de chat au site web et commence à lire votre site, sans compte requis ; eesel login conserve ensuite l'espace de travail. À partir de là, eesel chat dialogue avec l'agent, eesel files upload ajoute des connaissances, eesel integrations connect branche votre helpdesk, eesel automations définit ce qu'il fait seul et eesel approvals vous permet d'approuver les actions en attente.
Chaque commande affiche du JSON, les erreurs reviennent sous la forme {error, hint, retryable} et --dry-run montre l'appel serveur exact qu'une écriture effectuerait. C'est ce qui le rend utilisable par des agents de code comme Claude Code ou Cursor : l'agent peut exécuter la configuration et lire ses propres résultats. Chaque espace de travail est aussi un serveur MCP, et eesel mcp token affiche une ligne de configuration prête à coller.

Le même journal que vous voyez ci-dessus dans le tableau de bord est ce qu'eesel activity affiche dans le terminal, du plus récent au plus ancien.
Essayer eesel
TorchNeuron vous permet de choisir la puce la moins chère pour vos modèles. eesel vous permet d'éviter cette décision pour le travail de support : un coéquipier helpdesk qui se branche sur Zendesk, Freshdesk ou Gorgias, s'entraîne sur vos tickets passés et fait ses preuves sur des conversations historiques avant de toucher à une conversation réelle. Pour les équipes SaaS avec des questions très orientées API, l'API helpdesk IA et la CLI permettent de scripter toute la configuration. Essayez eesel gratuitement, ou démarrez depuis le terminal avec npx @eesel/cli.
Questions fréquentes
Qu'est-ce que TorchNeuron ?
neuron à PyTorch standard, de sorte que le mode eager, torch.compile et torch.distributed fonctionnent sur Trainium2 et Trainium3. Il a été lancé en bêta publique le 20 octobre 2026. Si vous cherchez une IA qui fait un travail plutôt qu'une puce pour exécuter des modèles, un coéquipier IA se trouve à l'autre bout de la pile.TorchNeuron est-il gratuit ?
TorchNeuron ne demande-t-il vraiment de changer qu'une seule ligne de code ?
.to('cuda') par .to('neuron'), ou ne changez rien si votre code utilise déjà torch.accelerator. Pour la vitesse en production, vous ajoutez aussi backend="neuron" à torch.compile, utilisez des formes statiques et supprimez les options réservées à CUDA. Des outils agentiques comme Claude Code savent bien gérer ce genre de portage mécanique.
Comment TorchNeuron se compare-t-il à PyTorch sur GPU NVIDIA ?