

GLM-5.3-Flash est le premier modèle nativement multimodal de Z.ai dans la famille GLM-5, lancé le 26 août 2026. C'est un modèle à mélange d'experts de 320B paramètres dont seulement 18B actifs, avec une fenêtre de contexte de 1M de tokens, des entrées image et vidéo et des poids ouverts sur HuggingFace.
Le point fort, c'est le prix. Il obtient 57 à l'Artificial Analysis Intelligence Index pour environ 0,045 $ par tâche, et les tarifs de l'API démarrent à 0,075 $ par million de tokens en entrée (une promotion de lancement jusqu'au 9 septembre 2026 ; tarif public 0,15 $/0,50 $). C'est à peu près l'intelligence de GLM-5.2 pour un dixième du coût.
Ne le confondez pas avec le modèle phare GLM-5.3. Flash est le petit frère économique, multimodal et à haut débit ; le modèle phare est le modèle texte seul pour la programmation et la cybersécurité, à 1,40 $/4,40 $ par million de tokens.
Pour les équipes de support et de contenu, le modèle est le moteur, pas le produit fini. Un modèle bon marché et capable a encore besoin de recherche documentaire, d'intégrations, des connaissances de votre entreprise et de tests avant de pouvoir répondre sans risque à un client. Ce dernier kilomètre, c'est exactement ce que gère eesel.
Ce qu'est vraiment GLM-5.3-Flash
Je construis des agents IA pour vivre, et presque chaque semaine un nouveau modèle de « niveau frontière pour une fraction du coût » apparaît. GLM-5.3-Flash est l'un des rares récents pour lesquels l'affirmation tient largement la route quand on regarde les chiffres.
Z.ai (l'entreprise anciennement connue sous le nom de Zhipu AI, basée à Pékin) l'a publié dans le lancement de GLM-5.3-Flash le 26 août 2026, avec le slogan « Frontier Intelligence, Flash Cost ». C'est le premier modèle de la série GLM-5 qui soit nativement multimodal : l'image et la vidéo entrent avec le texte, et du texte ressort. Sous le capot, c'est un modèle à mélange d'experts avec 320B paramètres au total mais seulement 18B actifs par token, l'astuce qui le garde rapide et peu coûteux à servir.
Quelques caractéristiques à retenir avant tout, toutes issues de la documentation du modèle de Z.ai :
- Fenêtre de contexte : 1M de tokens, avec 128K de sortie maximale.
- Entrées : texte, image, vidéo et fichiers. La sortie est uniquement du texte.
- Raisonnement : le mode de réflexion est toujours actif et, contrairement aux anciens modèles GLM, on ne peut pas le désactiver.
- Outils : appel de fonctions, sortie JSON structurée, streaming et mise en cache du contexte sont pris en charge.
- Poids : publics sur HuggingFace, auto-hébergeables via SGLang, vLLM ou TokenSpeed.
Le graphique qui résume pourquoi tout le monde parle de ce modèle est celui d'Artificial Analysis qui oppose coût et intelligence. GLM-5.3-Flash se place dans le coin supérieur gauche « bon marché et intelligent », que presque aucun autre modèle n'occupe.
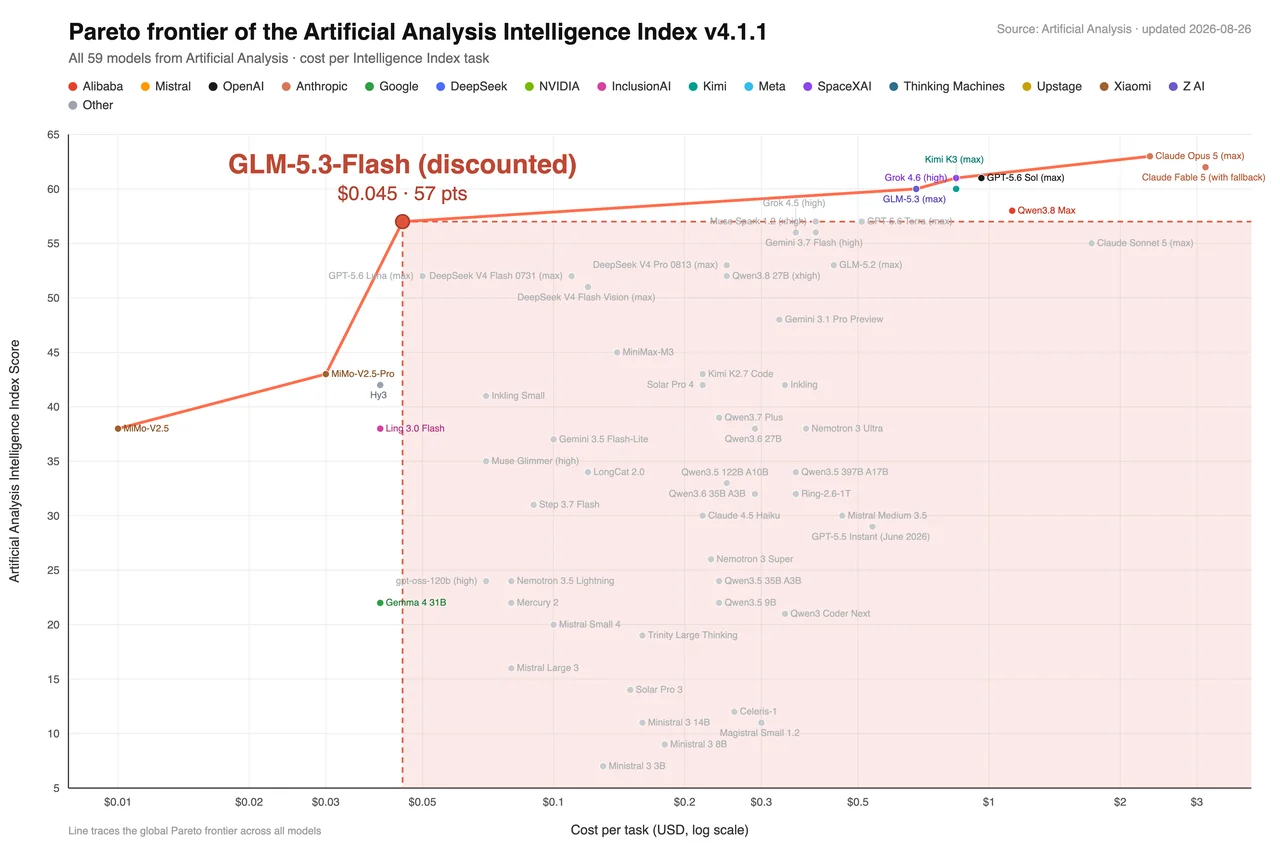
Le discours de Z.ai est qu'il offre « un niveau d'intelligence auparavant disponible seulement à environ 10 fois le coût ». Ce qui est intéressant, c'est qu'il ne s'agit pas d'un argument marketing d'un agrégateur, mais du chiffre d'un agrégateur de benchmarks indépendant, ce qui est bien plus difficile à truquer.
Le lancement discret « Ox Alpha »
Voici le détail que j'ai trouvé le plus parlant. Avant la sortie officielle, Z.ai l'a fait tourner anonymement sur OpenCode et OpenRouter sous le nom « ox-alpha » pour recueillir des retours d'usage réels. Il est discrètement devenu le modèle le plus utilisé de la semaine, traitant plus du double de tokens que le modèle suivant, le tout servi sur des puces d'IA chinoises plutôt que sur du matériel Nvidia.
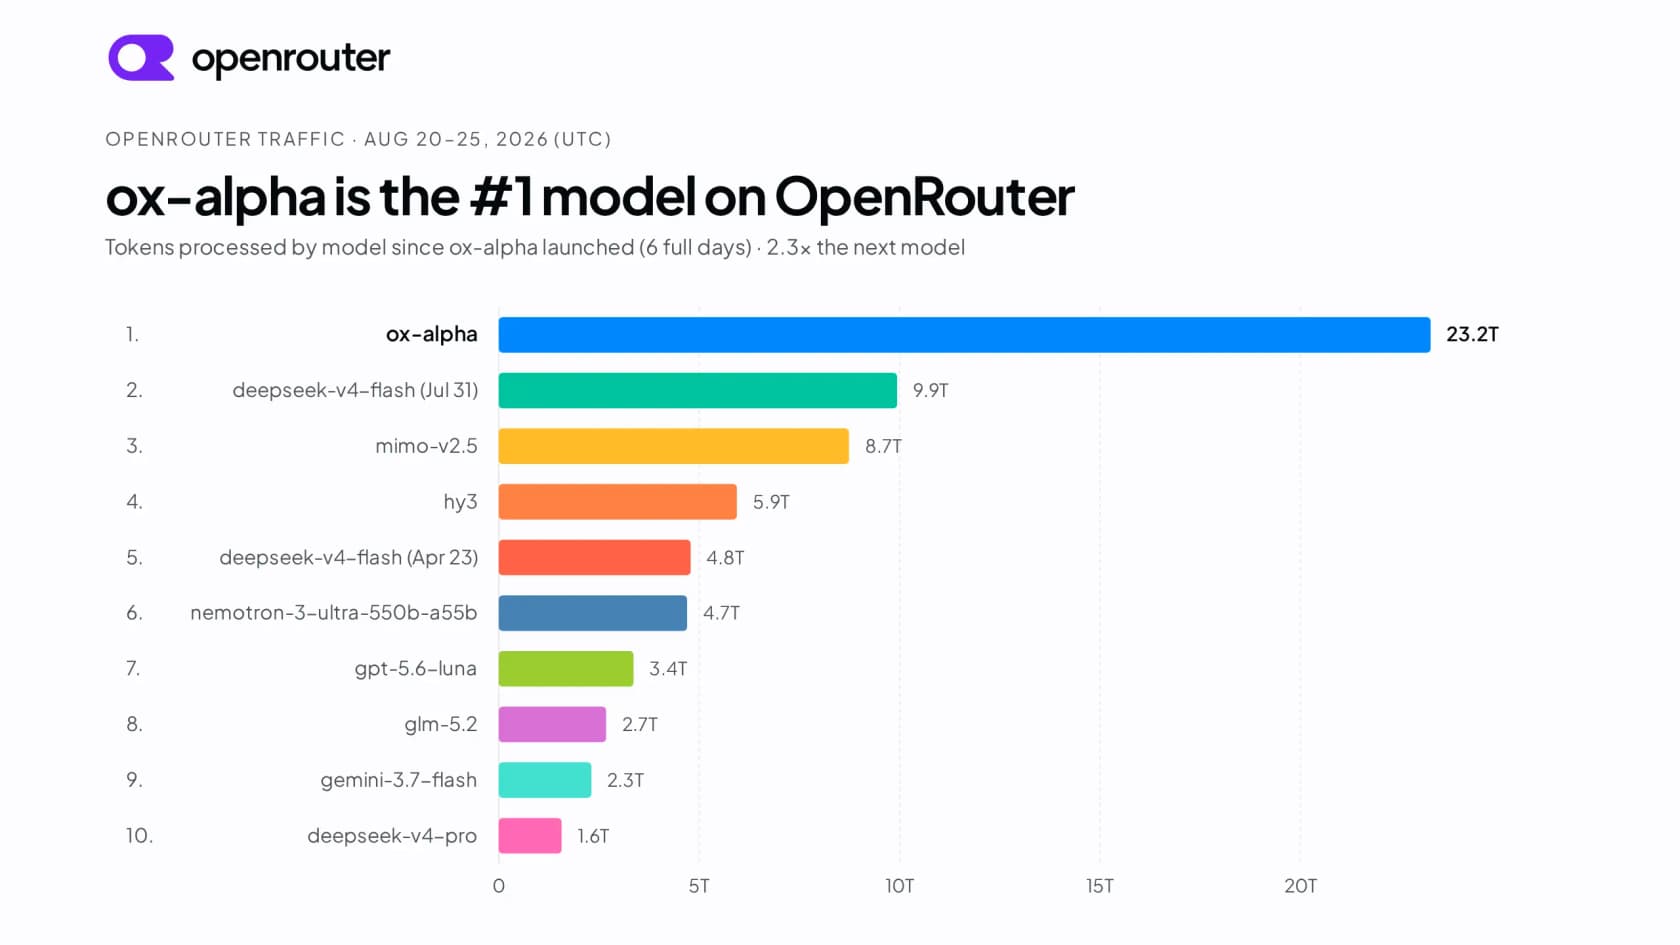
Deux choses comptent ici. D'abord, un test en aveugle sur des plateformes publiques est à peu près le signal le plus honnête qu'un laboratoire puisse produire, car personne ne choisissait le modèle pour sa marque. Ensuite, l'angle des puces chinoises est une vraie histoire. Z.ai affirme que cela « démontre que les puces chinoises peuvent soutenir l'inférence de modèles de frontière de façon efficace et économique à grande échelle », ce qui, si cela se confirme, change le calcul pour une grande partie du marché qui supposait que l'inférence de frontière passait par les GPU d'un fournisseur très précis.
Comment GLM-5.3-Flash garde les coûts bas
C'est la partie qui m'intéresse vraiment, car « c'est bon marché » n'a d'intérêt que si le faible coût est structurel et non une subvention qui disparaît dans six mois.
Z.ai répartit les économies en trois couches, et le schéma d'architecture mérite qu'on s'y arrête un instant.
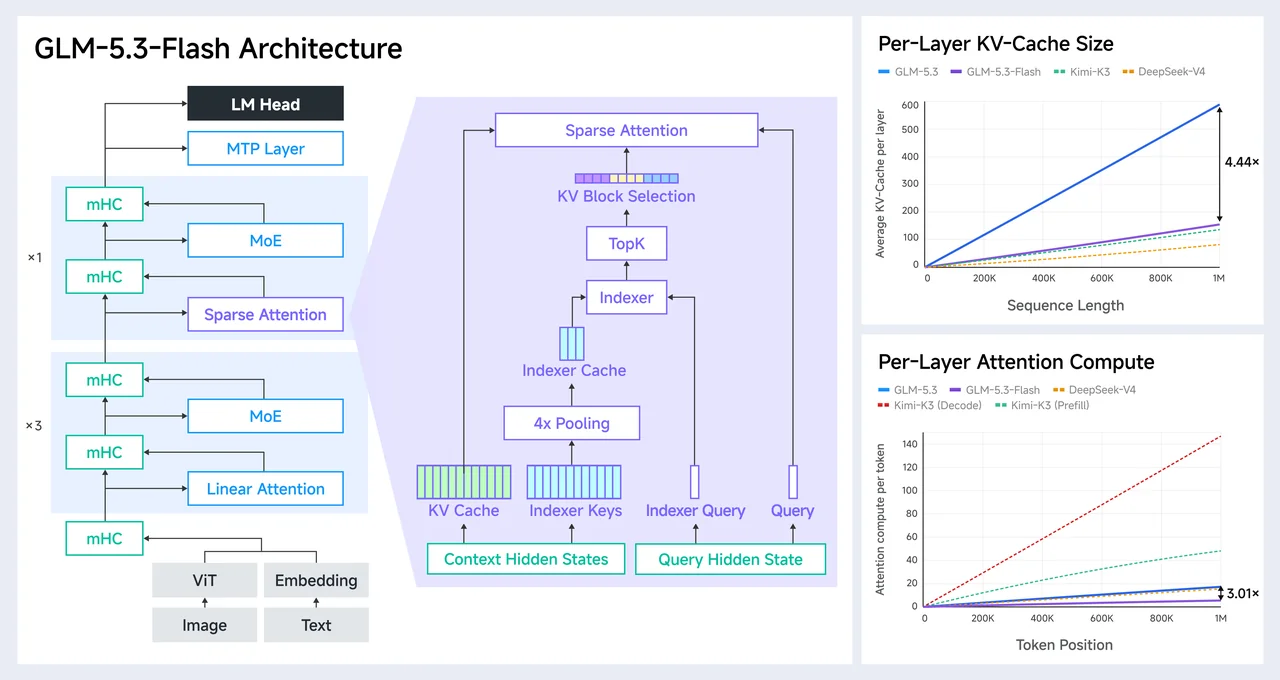
La première couche est la conception de l'attention. GLM-5.3-Flash combine l'attention éparse et linéaire : l'attention linéaire traite le contexte local par modélisation d'état, et un indexeur léger récupère le contexte global qui compte vraiment. Le gain est concret : par rapport au modèle phare GLM-5.3, il réduit le calcul d'attention de 3,0x et la taille du cache KV de 4,4x. Le contexte long est là où les coûts de service explosent généralement, donc réduire le cache KV fait la différence entre une fenêtre de 1M de tokens qui n'est qu'une démo et une fenêtre abordable.
La deuxième couche, ce sont les données d'entraînement, un corpus multimodal de 30 billions de tokens qui intègre dès le départ la compréhension de l'image et de la vidéo plutôt que d'ajouter un encodeur de vision après coup. La troisième est la co-conception de l'ensemble avec le matériel d'inférence sur lequel il tourne.
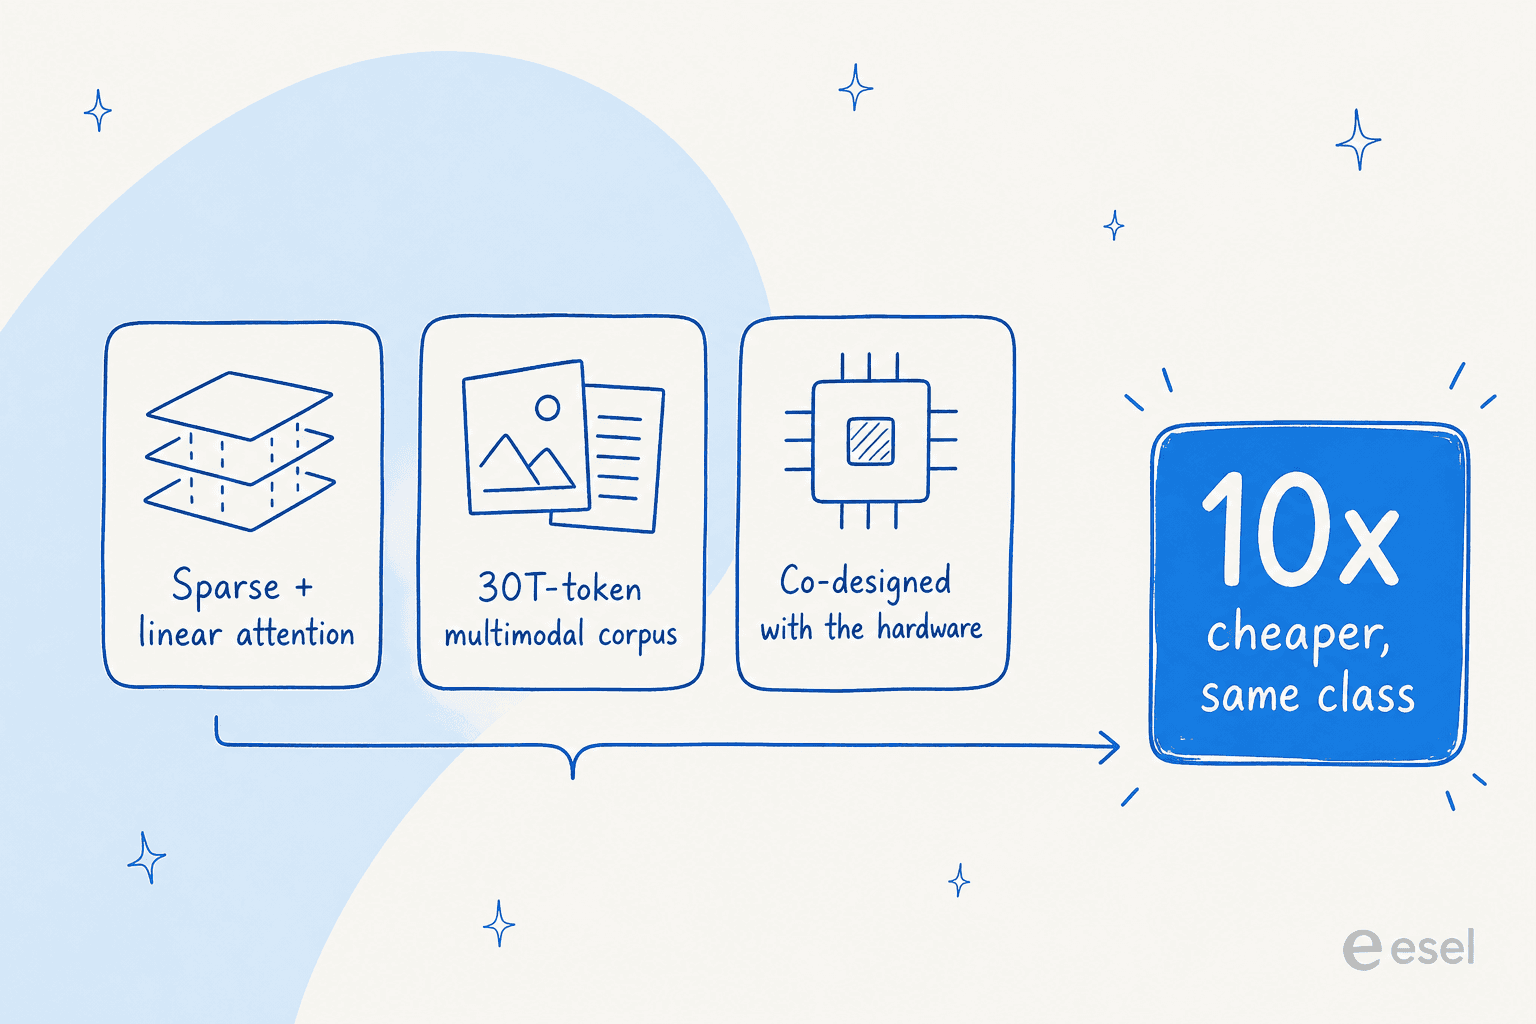
À titre de comparaison, GLM-5.3-Flash divise presque par deux à la fois le nombre de paramètres actifs (18B contre 32B) et le nombre de couches (45 contre 92) de l'ancienne série GLM-4.5, tout en gardant une taille totale similaire. Moins de paramètres actifs par token est le levier le plus direct sur le coût, et c'est pourquoi un modèle de 320B peut être tarifé comme un petit.
Benchmarks de GLM-5.3-Flash
C'est avec les benchmarks que le « bon marché » se fait généralement démasquer, donc c'est la section que je lirais deux fois. La comparaison de Z.ai oppose GLM-5.3-Flash à GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra et Gemini 3.7 Flash.
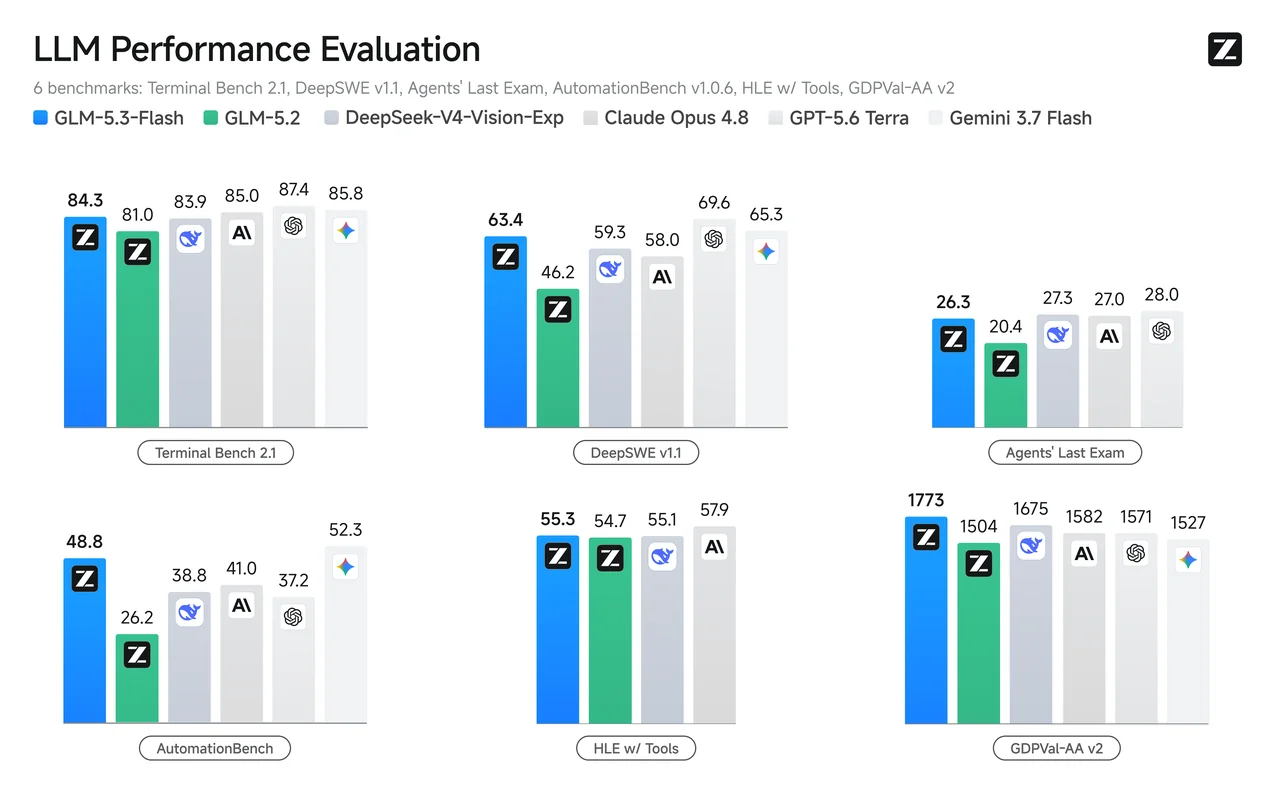
Le bond par rapport à la génération précédente est le vrai sujet :
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Opus 4.8 | GPT-5.6 Terra |
|---|---|---|---|---|
| DeepSWE v1.1 (programmation) | 63.4 | 46.2 | 58.0 | 69.6 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | 41.0 | 37.2 |
| Toolathlon Verified | 78.4 | 59.9 | 76.2 | 74.9 |
| Terminal Bench 2.1 | 84.3 | 81.0 | 85.0 | 87.4 |
| GDPval-AA v2 | 1773 | 1504 | 1582 | 1571 |
Source : benchmarks de GLM-5.3-Flash par Z.ai.
Lu honnêtement, deux choses sont vraies à la fois. GLM-5.3-Flash bat GLM-5.2 sur toute la ligne, souvent avec des écarts énormes (presque le double sur AutomationBench), et il dépasse Claude Opus 4.8 sur plusieurs tâches d'agents. Il reste aussi derrière les meilleurs modèles fermés de frontière comme GPT-5.6 Terra en programmation pure. Sur le Code Bench de Z.ai à effort maximal, il a obtenu 29,0 contre 29,5 pour Opus 4.8, donc « égale presque Opus 4.8 » est une description juste, pas une exagération. Pour un modèle à un dixième du prix, égaler les modèles phares de la génération précédente est tout l'intérêt.
Côté multimodal, le tableau est plus nuancé. Il affiche de bons scores en raisonnement sur graphiques et documents (89,4 sur CharXiv, 78,0 sur Chartography) mais se place derrière Gemini 3.7 Flash sur les benchmarks de vidéo pure comme MVbench et MMVU. Si votre charge de travail est la compréhension de documents et d'interfaces, c'est encourageant ; si c'est de l'analyse vidéo intensive, testez-le d'abord face à Gemini.
Tarifs de GLM-5.3-Flash
Voici la grille tarifaire complète, directement de la documentation tarifaire de Z.ai. Les prix sont par million de tokens.
| Modèle | Entrée | Entrée en cache | Sortie | Remarques |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 (public $0.15) | $0.015 | $0.25 (public $0.50) | 50 % de promo de lancement jusqu'au 9 sept. 2026 |
| GLM-5.3 (modèle phare) | $1.40 | $0.26 | $4.40 | Programmation et cyber |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Contexte de 1M |
| GLM-4.7-FlashX | $0.07 | $0.01 | $0.40 | Texte |
| GLM-4.7-Flash | Gratuit | Gratuit | Gratuit | Texte, entièrement gratuit |
Quelques points à signaler pour que personne ne soit surpris. Le prix d'entrée de 0,075 $ est une promotion de lancement qui se termine à minuit le 9 septembre 2026 (heure de Singapour), après quoi il repasse à 0,15 $. Même au tarif public, c'est de loin le modèle payant le moins cher de la série GLM-5. L'entrée en cache bénéficie d'environ 80 % de remise supplémentaire, ce qui compte beaucoup pour les charges d'agents qui renvoient le même prompt système à chaque tour. La recherche web intégrée est facturée à part, 0,01 $ par appel.
Il existe aussi une option par abonnement. Le GLM Coding Plan démarre à 18 $/mois (Lite), 80 $/mois (Pro) et 168 $/mois (Max), fonctionne dans Claude Code, Cline, OpenCode, Cursor et plus de 20 autres outils, et donne à GLM-5.3-Flash 3 fois le quota du modèle phare. Les heures creuses (qui incluent tout le week-end) sont facturées à moitié du taux de crédits.
Pour rendre le côté API concret, voici un petit calculateur. Saisissez votre volume quotidien de tokens et comparez la facture mensuelle au modèle phare.
GLM-5.3-Flash vs le modèle phare GLM-5.3 (et les offres gratuites)
Les noms prêtent à confusion, alors je vais être clair sur le modèle à choisir.
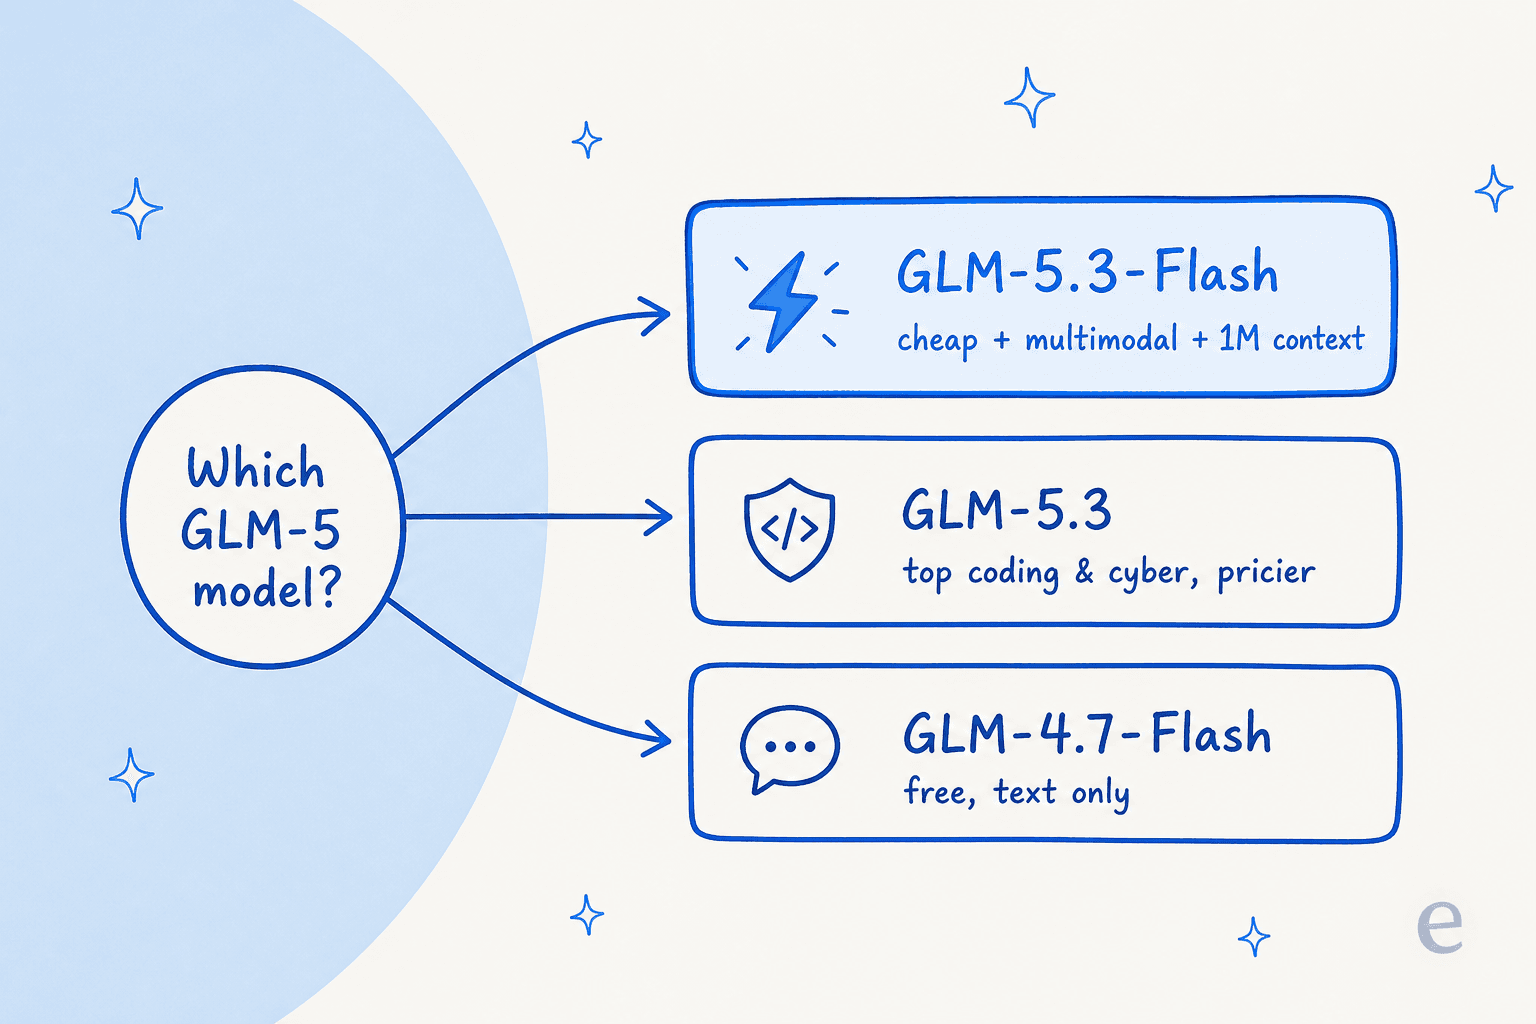
- GLM-5.3-Flash est celui à choisir par défaut : économique, multimodal, contexte de 1M, haut débit chez les hébergeurs tiers. Idéal pour les charges à gros volume, les tâches de vision et de documents, et tout ce qui se décide au coût par token.
- GLM-5.3 (le modèle phare) est un modèle réellement différent, texte seul, conçu pour la programmation et la cybersécurité. Il domine sa catégorie sur CyberGym et, dans une étude de sécurité de Z.ai, a repéré 2 436 vulnérabilités réelles dans 269 projets, dont certaines passaient inaperçues depuis des décennies. Si vous faites du travail difficile de type SWE-bench ou de la revue de sécurité, payez la différence.
- GLM-4.7-Flash et GLM-4.6V-Flash sont entièrement gratuits (texte et vision respectivement), mais plus anciens et moins capables. Bien pour prototyper, pas pour une qualité de production.
Une réserve qui revient sans cesse : la vitesse dépend de l'endroit où vous l'exécutez. Sur l'API de Z.ai elle-même, GLM-5.3-Flash est lent (~49 tokens/seconde), et des membres de la communauté ont été francs à ce sujet. Chez des hébergeurs tiers, c'est une autre bête, Databricks ayant mesuré 272,9 tokens/seconde sur Artificial Analysis. Si le débit compte, choisissez votre fournisseur délibérément.
Ce que disent les gens
La réaction de la communauté a été bruyante et se regroupe autour de deux choses : l'incrédulité face au prix et les grincements de dents sur la vitesse du fournisseur d'origine.
Sur le coût, la comparaison qui revient est celle avec les autres modèles à poids ouverts bon marché auprès desquels il se place désormais, comme Qwen et Kimi K2.5. Extrait d'un fil Reddit très partagé :
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Les chercheurs en sécurité ont été parmi les plus rapides à faire de vrais tests. L'un d'eux a publié un chiffre concret de coût par résultats, exactement le genre de résultat précis auquel je fais plus confiance qu'à une impression :
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Et sur la nouvelle capacité de vision, un testeur indépendant l'a soumise à un échantillon conséquent :
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
Le contrepoids honnête, c'est la vitesse. Un fil sur r/opencode a qualifié le point d'accès d'origine de « one of the slowest models AA [has ever seen] », ce qui concorde avec le chiffre d'environ 49 t/s de Z.ai lui-même. C'est une vraie limite, propre au fournisseur et non une propriété des poids.
Où s'arrête un modèle brut et où commence un coéquipier
C'est la partie qu'on passe sous silence à chaque lancement de « modèle de frontière économique », et c'est ce que j'ai appris à la dure en plus de trois ans à mettre de l'IA sur des files de support en direct : un modèle n'est pas une solution.
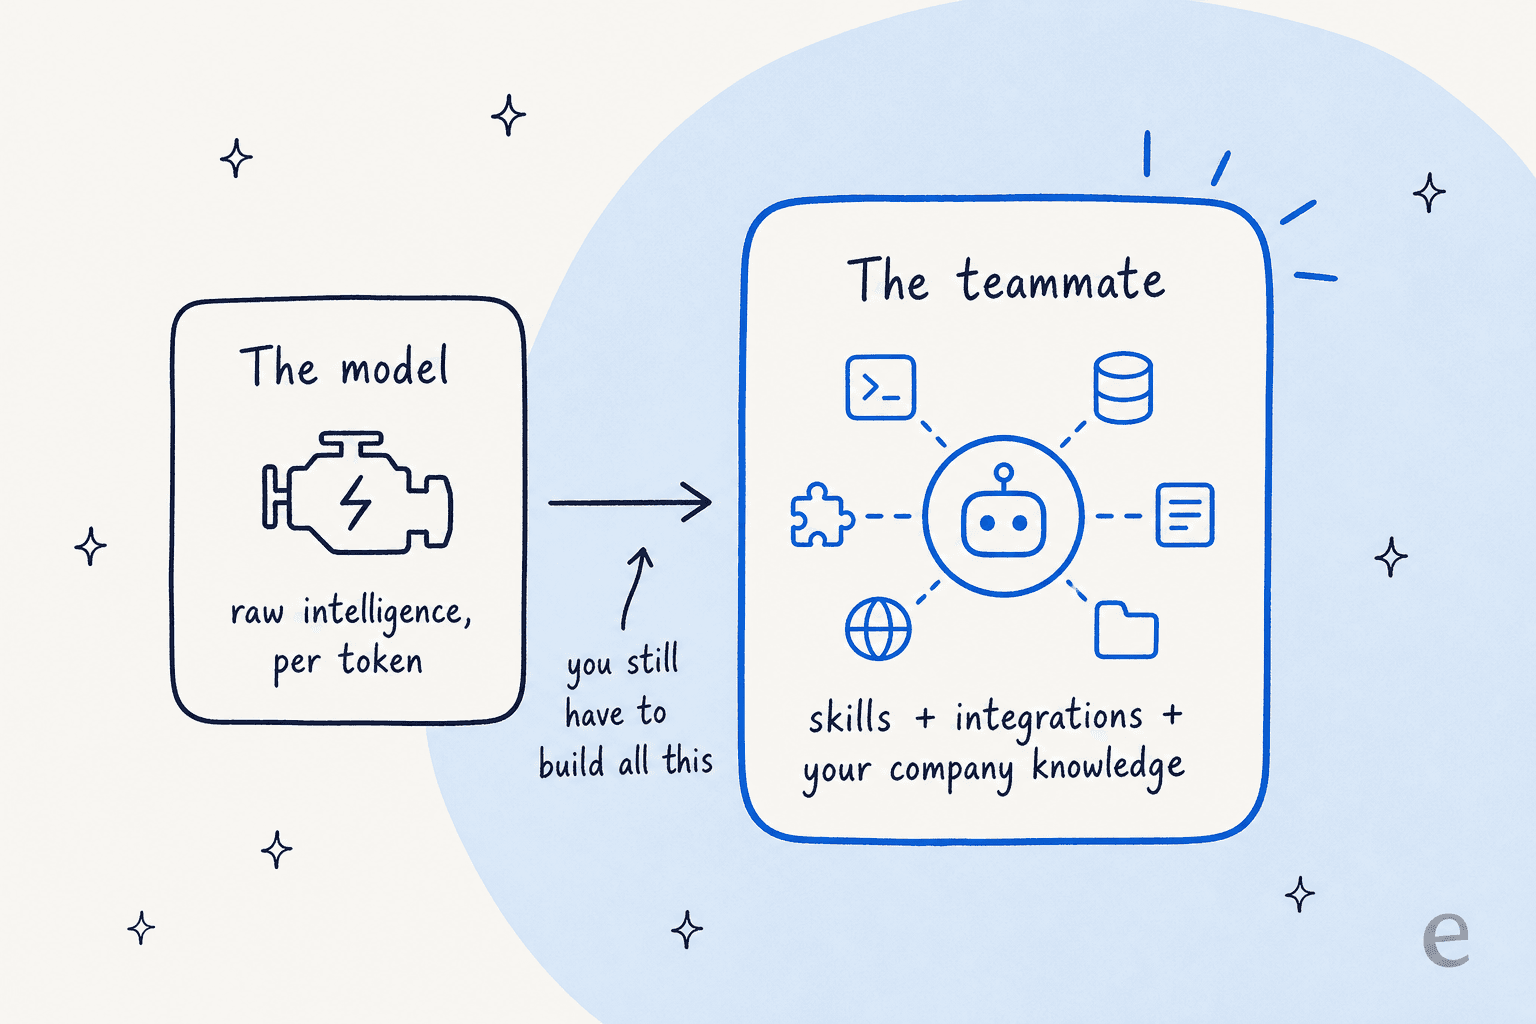
GLM-5.3-Flash vous donne une intelligence bon marché et capable au token. Il ne vous donne pas un système qui connaît votre politique de remboursement, sait lire l'historique Zendesk d'un client, retrouve le bon document d'aide via le RAG, effectue une action dans votre helpdesk et est testé avant de parler à une vraie personne. Chacun de ces points est un projet. Nous avons construit tout notre produit autour de cet écart, et l'habitude la plus importante que nous avons prise est simple : ne faites jamais confiance à un modèle sur des tickets en direct avant de l'avoir simulé sur votre propre historique. Une réponse qui sonne juste mais qui est silencieusement fausse coûte plus cher qu'une réponse lente.
Donc, si vous êtes un développeur qui veut de l'intelligence brute à brancher sur sa propre stack, GLM-5.3-Flash est un excellent choix économique, et je l'utiliserais volontiers. Si vous êtes une équipe de support ou de contenu qui veut simplement le résultat, le modèle est la partie facile et le dernier kilomètre est le vrai travail. C'est là qu'une plateforme d'agents IA justifie sa place. C'est la même raison pour laquelle nous conseillons de comparer des agents finis, pas des modèles bruts, quand on évalue l'IA pour l'automatisation du support client.
Essayer eesel
Si vous aimez ce que représente GLM-5.3-Flash (des réponses de niveau frontière sans factures de niveau frontière) mais que vous voulez qu'il fasse un vrai travail plutôt que de rester derrière une API, c'est ce qu'est eesel. Vous embauchez un coéquipier IA, le branchez à vos applications, et il se met au travail dès le premier jour : un coéquipier IA pour le helpdesk qui rejoint votre file existante dans Zendesk, Freshdesk ou Gorgias, et un rédacteur de blog IA qui livre des articles documentés et prêts à publier.
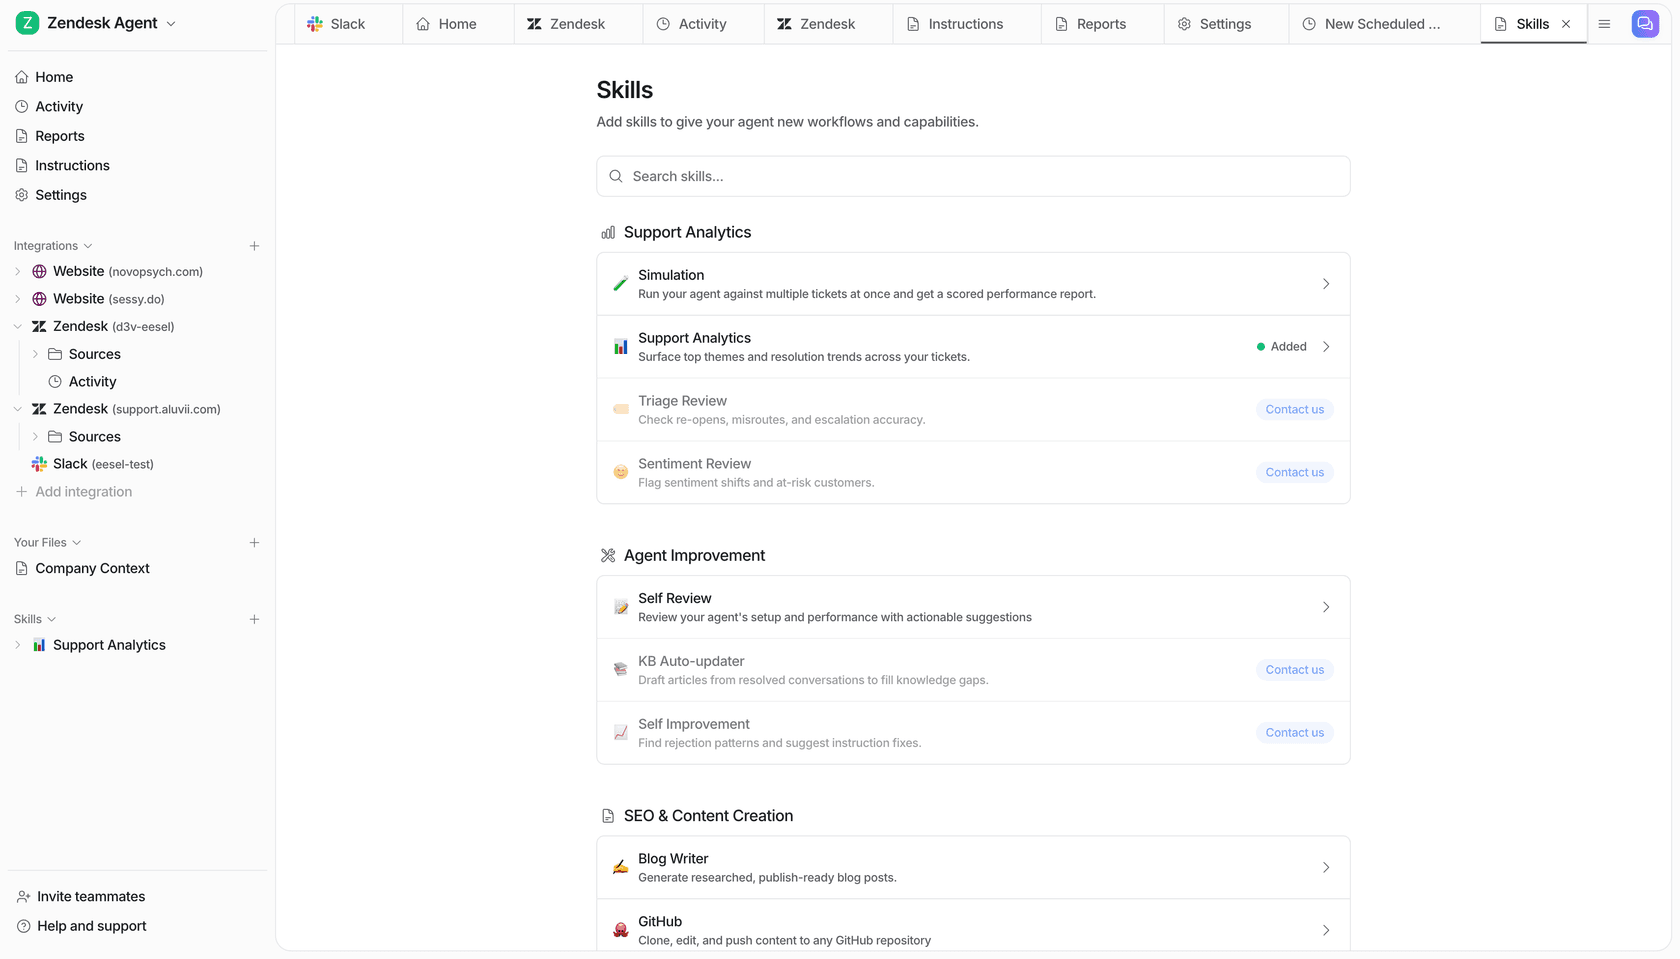
La différence avec un modèle brut, c'est la plomberie déjà faite : il lit votre base de connaissances et vos anciens tickets, il vient avec les intégrations et les compétences du poste, et (ce qui m'importe le plus) vous pouvez le simuler sur des milliers de vos tickets historiques avant qu'il ne réponde à un seul ticket en direct. Vous obtenez l'intelligence du modèle avec le filet de sécurité qu'une API brute ne fournit pas. C'est gratuit à essayer, sans appel commercial.
Questions fréquentes
Qu'est-ce que GLM-5.3-Flash ?
GLM-5.3-Flash est le premier modèle nativement multimodal de la série GLM-5 de Z.ai, un modèle à mélange d'experts de 320B paramètres dont 18B actifs, avec une fenêtre de contexte de 1M de tokens et des poids ouverts sur HuggingFace. Z.ai le présente comme une intelligence de niveau GLM-5.2 pour environ un dixième du prix.
Combien coûte GLM-5.3-Flash ?
Le prix de l'API GLM-5.3-Flash est une promotion de lancement de 0,075 $ par million de tokens en entrée et 0,25 $ par million de tokens en sortie jusqu'au 9 septembre 2026, puis un tarif public de 0,15 $/0,50 $, d'après la documentation tarifaire de Z.ai. Il est aussi inclus dans le GLM Coding Plan à partir de 18 $/mois. Si vous comparez les coûts de modèles pour le support, notre guide du modèle d'IA pour les tickets de support détaille les calculs.
GLM-5.3-Flash est-il open source ?
Les poids sont téléchargeables publiquement sur HuggingFace et vous pouvez l'héberger vous-même avec SGLang, vLLM ou TokenSpeed : c'est donc une publication à poids ouverts. Consultez le fichier de licence pour connaître les conditions exactes avant tout usage commercial. Si les poids ouverts comptent pour vous, notre tour d'horizon des plateformes de chatbot open source couvre les outils qui gravitent autour.
GLM-5.3-Flash vs GLM-5.3 : quelle différence ?
Ce sont deux modèles différents. GLM-5.3-Flash est le petit frère économique, multimodal et à haut débit (entrée image et vidéo, contexte de 1M). Le modèle phare GLM-5.3 est le modèle texte seul, puissant en programmation et en cybersécurité, au prix de 1,40 $/4,40 $ par million de tokens. Choisissez Flash pour le coût et la vision, le modèle phare pour les tâches de programmation les plus difficiles.
Puis-je utiliser GLM-5.3-Flash pour le support client ?
Vous le pouvez, mais un modèle brut n'est pas un agent de support. Il n'a pas accès à votre base de connaissances, à votre helpdesk ni à vos anciens tickets tant que quelqu'un n'a pas tout branché. eesel vous donne un coéquipier IA pour le helpdesk qui fait déjà cette plomberie : vous profitez de l'intelligence du modèle sans construire vous-même la recherche, les intégrations et les tests.