

GLM-5.3-Flash est le modèle GLM-5 le moins cher de Z.ai, et le prix fait la une. Avec une promo de lancement de 50 %, il coûte $0.075 par million de tokens en entrée et $0.25 par million de tokens en sortie, avec l'entrée en cache à $0.015. L'unité facturée est le simple token, donc pas de mauvaise surprise par résolution ou par siège. Deux points piègent les gens : la promo se termine le 9 septembre 2026, après quoi tous les tarifs doublent pour atteindre le prix catalogue de $0.15/$0.50, et GLM-5.3-Flash n'est pas le modèle phare. Le GLM-5.3 texte uniquement est un modèle distinct à $1.40/$4.40, environ dix fois plus cher.
Si vous préférez vous abonner plutôt que de mesurer les tokens, le GLM Coding Plan démarre à $18/mois (Lite) et monte jusqu'à $168/mois (Max) pour un usage dans Claude Code, Cursor et des outils similaires.
Un bémol qui ne figure pas sur l'étiquette : sur l'API de Z.ai elle-même, le modèle est lent (~49 tokens/s). Des hébergeurs tiers comme Databricks servent les mêmes poids à 273 tokens/s, donc l'endroit où vous l'exécutez change votre coût réel autant que la grille tarifaire. Et n'oubliez pas qu'une grille tarifaire vous achète des tokens, pas un système qui fonctionne. Si vous voulez une IA qui répond vraiment aux tickets ou rédige des articles dans vos propres outils, c'est la couche de coéquipier d'eesel, qui se place au-dessus de modèles comme celui-ci.
Le reste de cet article passe en revue la grille complète, la falaise de la promo, les plans de codage et quelques exemples chiffrés pour que vous voyiez ce que coûte une charge de travail réelle.
GLM-5.3-Flash est arrivé en août 2026 comme le premier modèle nativement multimodal de la gamme GLM-5 de Z.ai (Zhipu AI), et la réaction en ligne a surtout tourné autour d'une chose : l'incrédulité face au coût. Artificial Analysis l'a estimé à environ $0.045 par tâche, et des fils Reddit le comparaient favorablement à des modèles plusieurs fois plus chers. Faisons donc ce que les articles de lancement n'ont pas fait : détailler exactement ce que vous payez, où sont les pièges et ce que ce chiffre achète vraiment.
Voici la grille réelle telle qu'elle apparaît dans la documentation tarifaire de Z.ai.
Les tarifs de GLM-5.3-Flash en un coup d'œil
Le modèle est facturé à l'usage, par million de tokens, réparti entre entrée, entrée en cache et sortie. Voici le tableau complet, tarifs promo d'abord, prix catalogue à côté.
| Élément | Tarif promo | Tarif catalogue | Remarques |
|---|---|---|---|
| Entrée | $0.075 / M | $0.15 / M | Tokens de prompt standard |
| Entrée en cache | $0.015 / M | $0.03 / M | ~80 % de moins que l'entrée standard |
| Stockage de l'entrée en cache | Gratuit | Gratuit | "Limited-time free" |
| Sortie | $0.25 / M | $0.50 / M | Inclut les tokens de raisonnement |
| Recherche web | $0.01 / usage | $0.01 / usage | Outil intégré en option |
Source : la documentation tarifaire de l'API Z.ai.
Quelques points méritent d'être soulignés. Les tokens de sortie coûtent environ 3,3 fois plus que l'entrée, et comme GLM-5.3-Flash est un modèle qui réfléchit toujours (on ne peut pas désactiver le raisonnement), chaque requête dépense des tokens de sortie en raisonnement interne avant de répondre. C'est normal pour un modèle de raisonnement, mais cela signifie que votre facture se joue sur la sortie. Budgétez selon le tarif de sortie, pas selon le tarif d'entrée mis en avant.
L'autre détail, c'est ce qu'est GLM-5.3-Flash : un modèle à mélange d'experts de 320B de paramètres au total et 18B actifs, avec une fenêtre de contexte de 1M de tokens et la vision native. Pour un modèle qui lit des images et tient un million de tokens de contexte, un quart de dollar par million de tokens de sortie est étonnamment bas.
Flash n'est pas le modèle phare (et l'écart de prix est énorme)
C'est la confusion la plus fréquente, alors soyons francs. GLM-5.3 et GLM-5.3-Flash sont deux modèles différents qui partagent par hasard un numéro de version.
- GLM-5.3-Flash est le petit frère économique, multimodal et à haut débit. C'est celui à $0.075/$0.25.
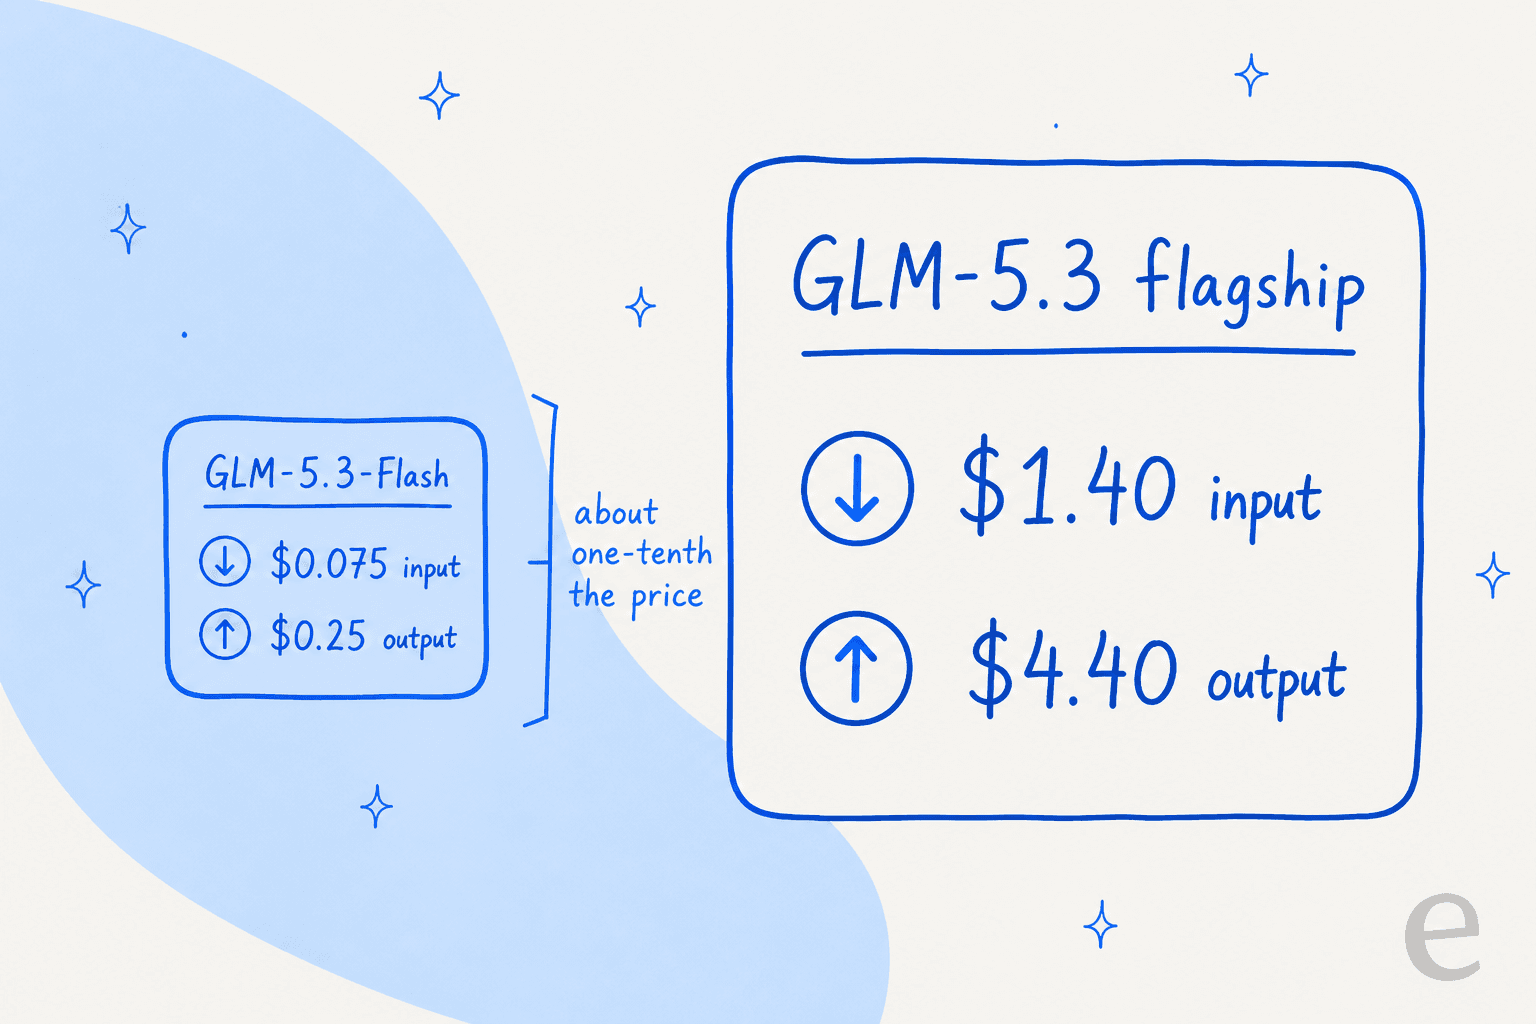
- GLM-5.3 (le modèle phare) est un modèle texte uniquement pour le code et la cybersécurité, facturé $1.40 en entrée / $4.40 en sortie par million.
Cela fait un écart d'environ dix fois. Si vous copiez un prix « GLM-5.3 » d'un endroit et une estimation de tokens d'un autre, vous pouvez vous tromper d'un ordre de grandeur. La formule de Cloudflare sur Flash est le meilleur résumé : il "outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price."
Ainsi, quand vous chiffrez une charge de travail, la première question n'est pas « combien de tokens ? » mais « quel GLM-5.3 est-ce que j'appelle vraiment ? ». Pour la plupart des tâches hors code (chat, extraction, vision, résumé), Flash est celui qu'il vous faut, et celui dont parle cet article. Pour du code de pointe ou de la recherche en sécurité, le modèle phare existe, mais vous payez des tarifs de modèle phare.
La falaise de la promo : les prix doublent le 9 septembre
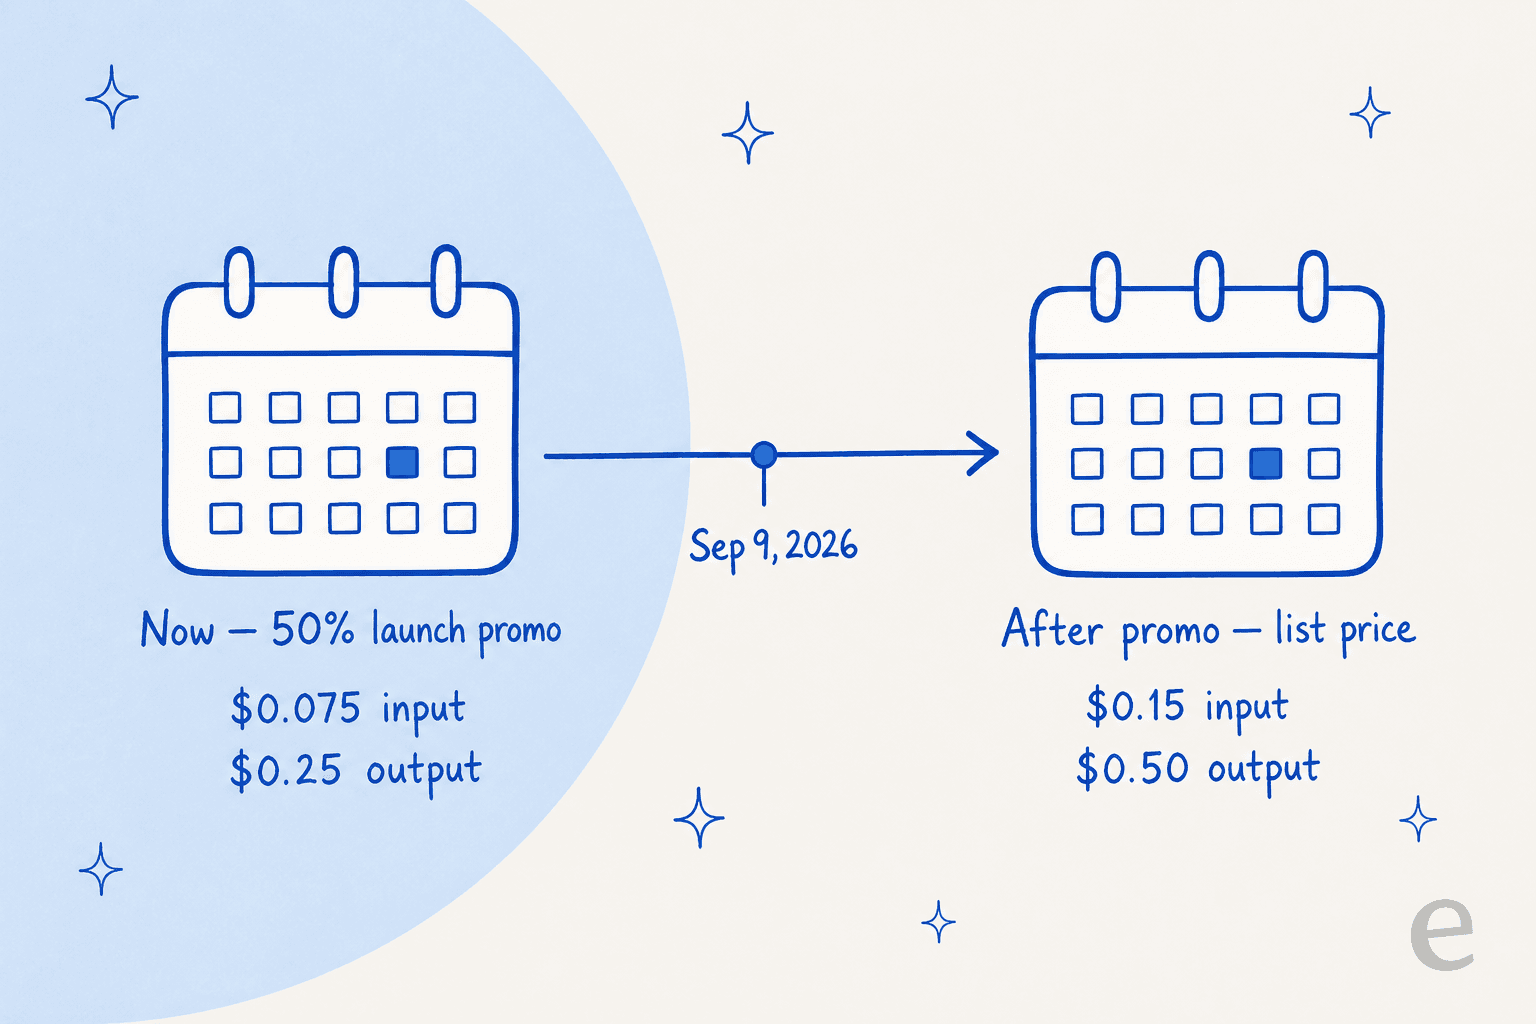
Les chiffres $0.075/$0.25 correspondent à une remise de lancement de 50 %, pas au prix permanent. Selon la documentation tarifaire de Z.ai, la promotion se termine à 24:00 le 9 septembre 2026 (UTC+8, heure de Singapour). Ensuite, la grille revient à $0.15 en entrée / $0.50 en sortie.
Même doublé, GLM-5.3-Flash reste bon marché selon tout critère raisonnable, donc pas de panique. Mais si vous construisez un modèle de coûts pour un produit qui sort après septembre, utilisez les prix catalogue, pas les prix promo. Un budget bâti sur $0.075 qui exige discrètement $0.15 paraît correct dans un tableur et pique à la première facture après la promo.
Entrée en cache et option de recherche web
Deux leviers plus modestes modifient votre tarif effectif.
L'entrée en cache est le plus important. Si vos prompts partagent un long préfixe stable (un prompt système, une base de connaissances, un long document sur lequel vous posez de nombreuses questions), la partie répétée est facturée au tarif de cache de $0.015/M pendant la promo, environ 80 % sous le tarif d'entrée standard. Sur des charges avec beaucoup de réutilisation de prompts, c'est la différence entre une bonne facture et une excellente. Le stockage de l'entrée en cache est aussi gratuit pour l'instant.
La recherche web est un outil intégré facturé séparément à $0.01 par usage. C'est peu, mais c'est compté à chaque appel, donc un agent qui cherche à chaque tour s'additionne d'une façon que les tarifs par token ne montrent pas. À surveiller si vous l'intégrez dans une boucle.
Le GLM Coding Plan : un abonnement plutôt que la mesure des tokens
Si vous utilisez surtout GLM dans un outil de codage, Z.ai vend un abonnement forfaitaire qui évite entièrement la mesure des tokens. Le GLM Coding Plan exécute GLM-5.3 et GLM-5.3-Flash dans Claude Code, Cline, OpenCode, Cursor, Roo Code, Kilo Code et plus de 20 autres outils d'agents.
Voici les niveaux individuels, avec le tarif mensuel effectif si vous payez à l'année.
| Plan | Mensuel | Annuel (effectif /mois) | Crédits hebdomadaires | Usage relatif |
|---|---|---|---|---|
| Lite | $18/mois | $12.60/mois | 10,000 | 1x |
| Pro | $80/mois | $56.00/mois | ~60,000 | 6x Lite |
| Max | $168/mois | $117.60/mois | ~140,000 | 14x Lite |
Il existe aussi deux niveaux pour les équipes : un Standard Seat à $88/siège/mois (66,000 crédits hebdomadaires) et un Premium Seat à $188/siège/mois (155,000 crédits hebdomadaires, plus un accès anticipé aux modèles), d'après la page d'abonnement de Z.ai.
La mécanique récompense la patience. Les crédits se dépensent via un multiplicateur par modèle (GLM-5.3-Flash coûte beaucoup moins par token que le modèle phare), et l'usage en heures creuses est facturé à 50 % du taux de crédits standard. Les heures de pointe ne sont que du lundi au vendredi, de 14:00 à 18:00 heure de Singapour, donc la majeure partie de la semaine est en heures creuses. Z.ai affirme qu'en s'appuyant sur les heures creuses, on peut économiser jusqu'à 92 % par rapport aux appels d'API du modèle phare payés à l'usage. C'est un chiffre du fournisseur, donc à prendre comme un plafond et non une promesse, mais la direction est réelle : l'abonnement vise clairement un usage de codage intensif et quotidien.
Les plans de codage sont ce que la plupart imaginent quand ils pensent à GLM en action : un modèle qui avale des refactorisations et des migrations dans un agent.
Le coût caché : quel hébergeur vous choisissez
Voici ce que la grille ne dit pas. GLM-5.3-Flash a des poids ouverts, donc vous pouvez l'exécuter à de nombreux endroits, et le débit varie énormément de l'un à l'autre. Sur l'API de Z.ai, la sortie tourne autour de 49 tokens par seconde, ce qu'un fil Reddit a qualifié de "one of the slowest models AA has ever" testé. Les hébergeurs tiers racontent une autre histoire.
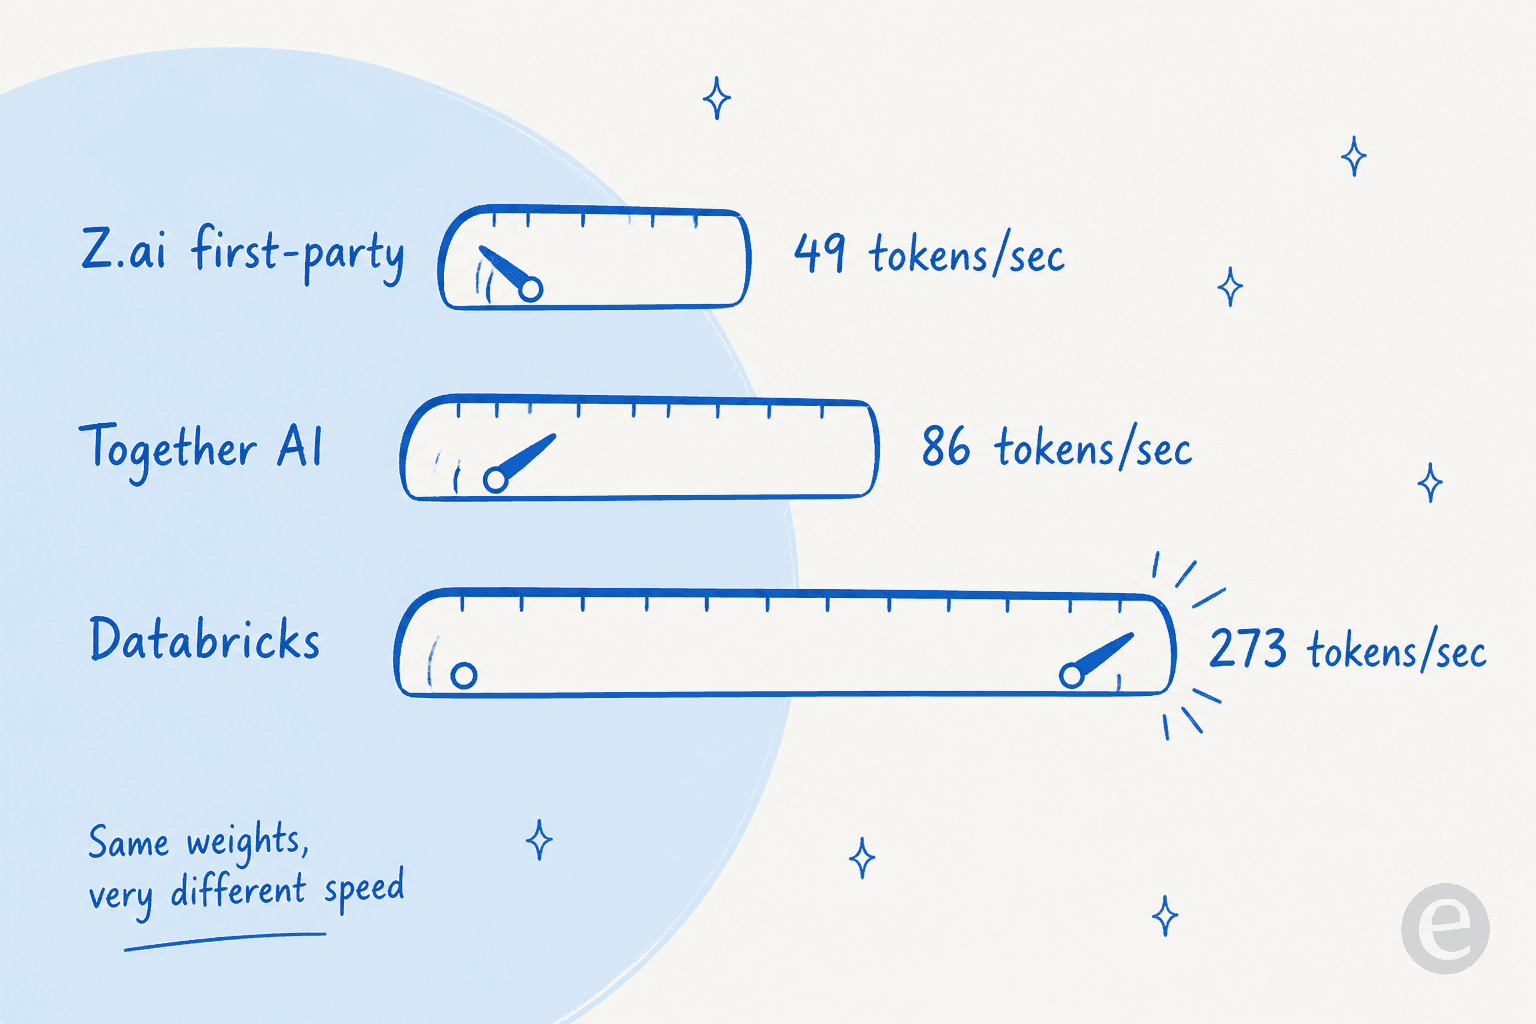
Selon Artificial Analysis, parmi onze fournisseurs d'API, Databricks sert GLM-5.3-Flash à 272.9 tokens/s avec la latence la plus basse (8 secondes jusqu'au premier token), tandis que les prix catalogue les plus bas viennent de GMI et Bitdeer, autour de $0.05. Le but n'est pas de désigner un meilleur hébergeur. C'est de montrer que les « tarifs de GLM-5.3-Flash » sont en réalité une matrice de prix et de vitesse, et que pour tout ce qui est exposé aux utilisateurs, le débit est aussi un coût. Un modèle deux fois moins cher mais cinq fois plus lent peut finir plus cher une fois comptée la latence que subissent vos utilisateurs (ou vos agents).
Si vous voulez le plancher de prix pur, l'API directe ou GMI. Si vous voulez de la vitesse à un tarif raisonnable, un hébergeur comme Databricks. Choisissez l'hébergeur selon que votre goulot d'étranglement est en dollars ou en secondes.
Ce que le prix bas achète réellement
Bon marché n'est bien que si le résultat est utilisable, il faut donc ancrer le chiffre dans ce que le modèle sait faire. Sur l'Artificial Analysis Intelligence Index, GLM-5.3-Flash obtient 57, contre 60 pour le GLM-5.3 complet, ce qui le place pile sur la frontière prix-intelligence. Les testeurs l'ont confirmé sur des cas précis.
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Sur sa nouvelle capacité de vision, un testeur a lancé 1,500 échantillons et rapporté 81 % de précision, la jugeant correcte pour une première version multimodale. Et la réaction sur le prix face aux concurrents a été le thème le plus bruyant de tous.
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Pour un tour plus complet des capacités, notre présentation de GLM-5.3-Flash approfondit l'architecture et les benchmarks, et si vous établissez une présélection par le coût, elle vaut le détour à côté de nos analyses des tarifs de DeepSeek et des tarifs de Kimi K2.5. Mais pour ce qui est du prix, l'enseignement est simple : le modèle n'est pas bon marché parce qu'il est faible. Il est bon marché parce que Z.ai a fixé un prix agressif à un MoE de 18B actifs et subventionne en plus le lancement.
Un exemple chiffré : ce que coûte une charge de travail réelle
Les tarifs par million de tokens sont difficiles à se représenter, alors saisissez vos propres chiffres. Ce calculateur utilise les tarifs promo ($0.075 en entrée, $0.25 en sortie) ; basculez l'interrupteur pour voir le prix catalogue après septembre.
Pour situer les valeurs par défaut : un assistant de taille moyenne traitant 500M de tokens en entrée et 150M en sortie par mois tombe autour de $75/mois aux tarifs promo, ou environ $150/mois une fois le prix catalogue appliqué. Même au catalogue, c'est une erreur d'arrondi à côté des outils d'IA facturés par siège, et c'est exactement pourquoi le modèle a fait du bruit. Ce qu'il faut retenir, c'est que votre volume de sortie, gonflé par le raisonnement obligatoire, est le cadran qui fait vraiment bouger le chiffre. Si votre objectif est du contenu plutôt que des tokens bruts, notre avis sur le meilleur LLM pour rédiger des articles de blog pèse qualité et coût de la même façon.
Essayez eesel : le modèle est le moteur, eesel est le coéquipier
Voici le cadrage honnête. GLM-5.3-Flash est une infrastructure fantastique. Mais un tarif de $0.075 par million de tokens n'est pas une réponse à un ticket de support ni un article fini, pas plus qu'un baril de pétrole n'est un road trip. L'accès brut à un modèle vous laisse encore construire la récupération d'informations, les garde-fous, les intégrations, les tests et toute la plomberie du « que se passe-t-il quand il se trompe ».
eesel se place une couche au-dessus. Au lieu de tokens, vous recrutez des coéquipiers IA prêts à travailler : un coéquipier IA de helpdesk qui rejoint votre file Zendesk, Freshdesk ou Gorgias existante et rédige ou envoie des réponses, et un rédacteur de blog IA qui recherche et rédige des articles SEO de bout en bout. Chacun arrive en connaissant déjà votre centre d'aide et vos anciens tickets, et passe en production en quelques minutes plutôt qu'après un sprint de code de liaison.
Le différenciateur qui compte le plus pour ceux qui hésitent à confier des tickets à une IA : eesel vous permet de simuler un coéquipier sur vos vrais tickets historiques avant qu'il ne touche un client en direct, de sorte que vous voyez le taux de résolution et les réponses à l'avance, au lieu d'actionner un interrupteur en espérant. Des modèles comme GLM-5.3-Flash rendent les tokens bon marché ; eesel est ce qui les transforme en coéquipier auquel vous pouvez vraiment faire confiance dans la file. C'est gratuit à essayer, sans carte bancaire et sans appel commercial pour démarrer.
Comment les tarifs de GLM-5.3-Flash se comparent-ils à Gemini et DeepSeek ?